Résumé : DeepSeek Harness peut se connecter à des passerelles telles qu’APIYI via « Custom Model API ». Les développeurs configurent un fournisseur distinct pour chaque protocole, renseignent l’ID de modèle effectivement pris en charge par la passerelle et ajoutent, selon les besoins de la tâche, un outil de recherche web séparé.
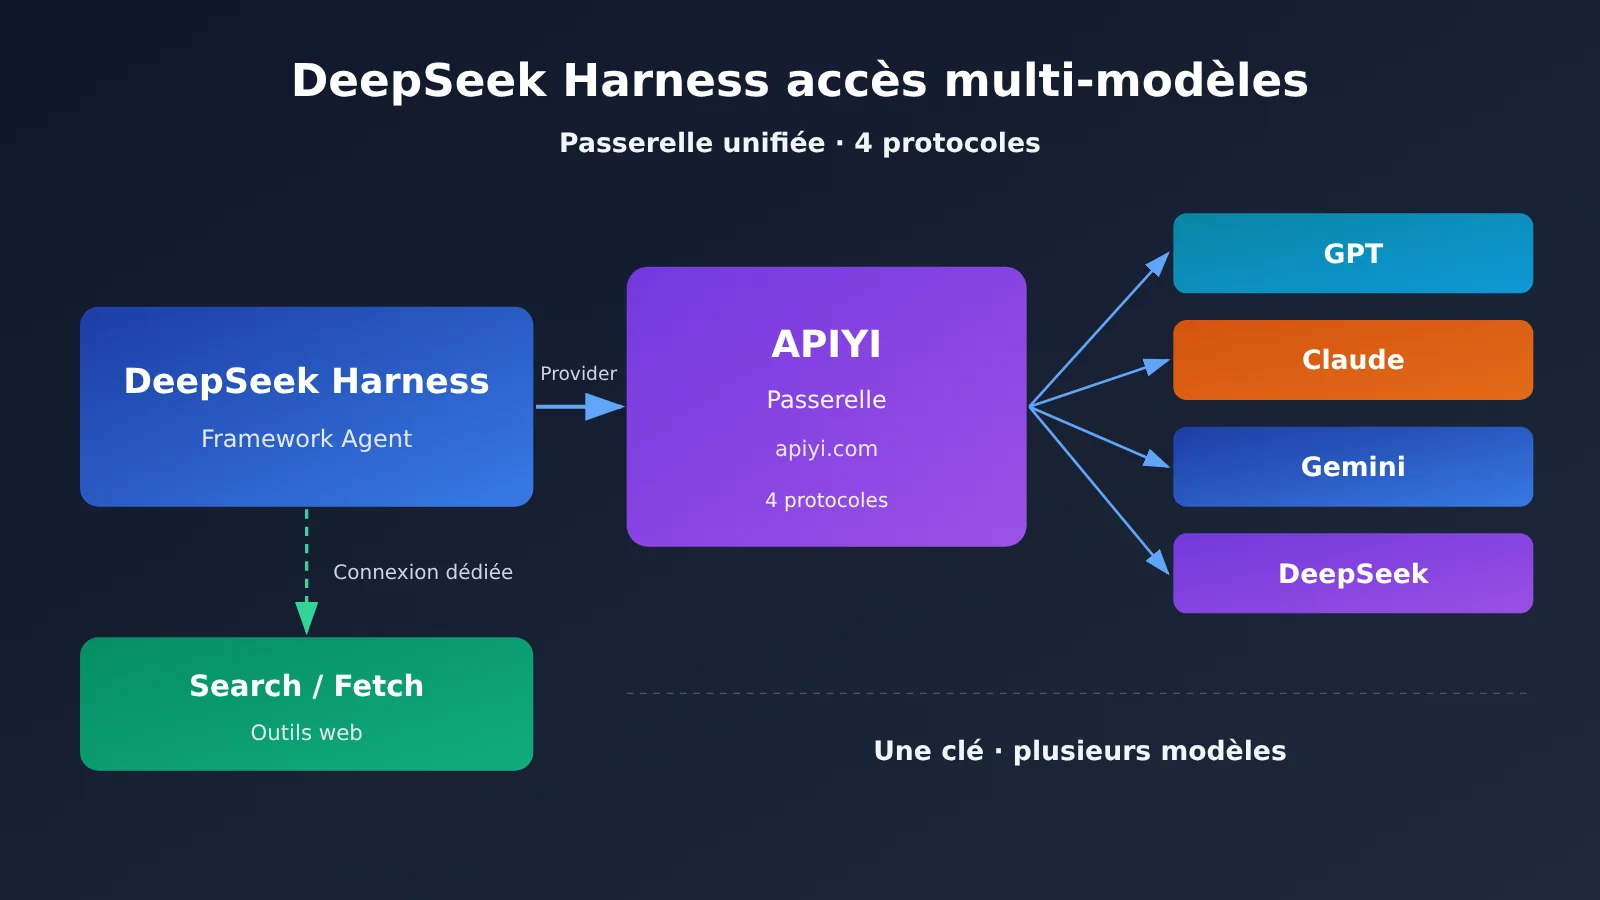
DeepSeek Harness permet d’ajouter une passerelle API tierce comme fournisseur de modèles personnalisé, avec quatre protocoles au choix : OpenAI Chat Completions, OpenAI Responses, Anthropic Messages et Gemini API. Une instance Harness peut donc appeler en même temps les modèles de plusieurs fournisseurs via une passerelle unifiée comme APIYI apiyi.com. La réussite de l’intégration tient à quatre points : l’adéquation entre le protocole et la Base URL, la cohérence entre l’ID de modèle et la passerelle, la compatibilité des paramètres de raisonnement et de sortie, et une planification séparée des outils web.
La suite explique d’abord le mécanisme d’adaptation des modèles dans Harness et la place qu’y occupe la passerelle, puis détaille pas à pas la configuration d’un fournisseur personnalisé dans l’interface de réglages, avec un modèle de fichier de configuration pour APIYI. Nous passerons ensuite en revue les problèmes de compatibilité et les codes d’erreur les plus fréquents lorsque l’interface répond mais que l’appel échoue, puis nous distinguerons les deux routes web — la recherche intégrée côté serveur DeepSeek et les Search / Fetch indépendants d’APIYI — avant de conclure par une conception multi-modèles en couches pour un Agent et des recommandations de déploiement.
À savoir : terminologie de l’intégration multi-modèles de DeepSeek Harness
| Terme | Explication |
|---|---|
| Harness | Le cadre d’exécution de l’Agent, chargé de l’accès aux modèles, de l’appel des outils, du contexte, des sessions et de la boucle d’exécution des tâches |
| API Gateway | Une passerelle qui relaie et gère de manière unifiée les requêtes vers les API de plusieurs modèles, en offrant un point d’entrée unique vers l’extérieur |
| Base URL | L’adresse de base des requêtes API ; selon le protocole, le préfixe de chemin de l’adresse diffère |
| Provider | Un fournisseur de service de modèle configuré dans Harness, qui correspond à un ensemble d’adresses, de protocoles et de clés |
| Model ID | L’identifiant du modèle indiqué dans la requête, qui doit correspondre exactement au nom réellement proposé par la passerelle |
| Chat Completions | L’interface de complétion de conversation au style OpenAI, le protocole le plus courant pour une passerelle compatible |
| Responses API | L’interface de réponse structurée d’OpenAI, destinée à l’appel d’outils et aux interactions multi-tours |
| Anthropic Messages | L’interface de messages au style Anthropic, le protocole natif des modèles de la série Claude |
| Reasoning Effort | Le paramètre du niveau de réflexion du modèle, par exemple off, low, medium, high, max |
| Tool Calling | Le modèle ou l’Agent décide d’appeler un outil externe et d’exploiter le résultat dans la suite du raisonnement |
| Search / Fetch | Search effectue une recherche web et renvoie une liste de résultats ; Fetch récupère le contenu texte d’une page web donnée |
| API Key | L’identifiant d’authentification, qui détermine quels modèles et quelles interfaces une requête peut atteindre |
1 Pourquoi DeepSeek Harness convient à l’accès multi-modèles via API
1.1 Le mécanisme de fournisseur de modèles dans DeepSeek Harness
DeepSeek Harness est open source depuis le 13 août 2026 en version developer preview, sous licence MIT, avec une architecture centrale reposant sur le principe « Everything is a Plugin ». Les adaptateurs de modèles, les outils, les Skills, le stockage et la gestion des sessions sont tous des plugins remplaçables. L’intégration de modèles devient donc un élément de configuration ouvert, et non plus un lien figé à un fournisseur inscrit en dur dans le produit.
Au niveau des modèles, Harness permet d’ajouter plusieurs fournisseurs et de changer de modèle en cours de session. Chaque fournisseur peut se voir configurer une clé API, une Base URL, un nom de modèle, un protocole API, une longueur de contexte, un nombre maximal de tokens en sortie, la capacité d’entrée d’images et un niveau de raisonnement. Les services proxy API, les passerelles internes d’entreprise et les services de modèles auto-hébergés peuvent tous être intégrés comme fournisseurs indépendants.
Il faut garder en tête que Harness est encore en developer preview, et que l’équipe officielle prévient que des changements incompatibles pourraient survenir dans les versions futures. Avant toute utilisation en production, mieux vaut figer la version et sauvegarder la configuration.
1.2 Le rôle de la passerelle API dans DeepSeek Harness
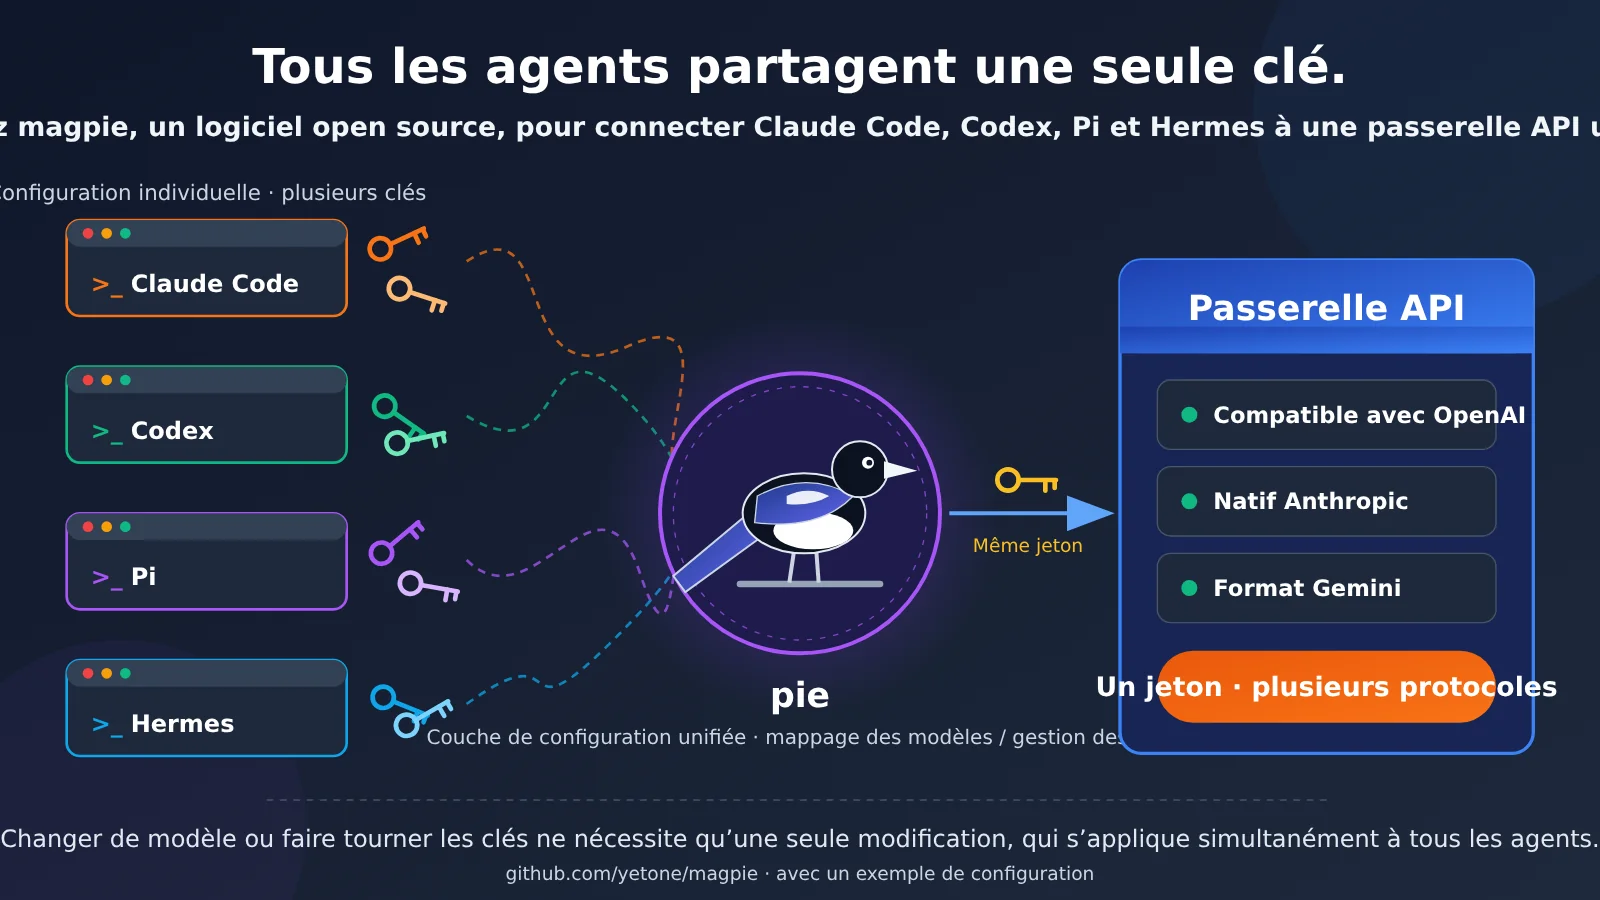
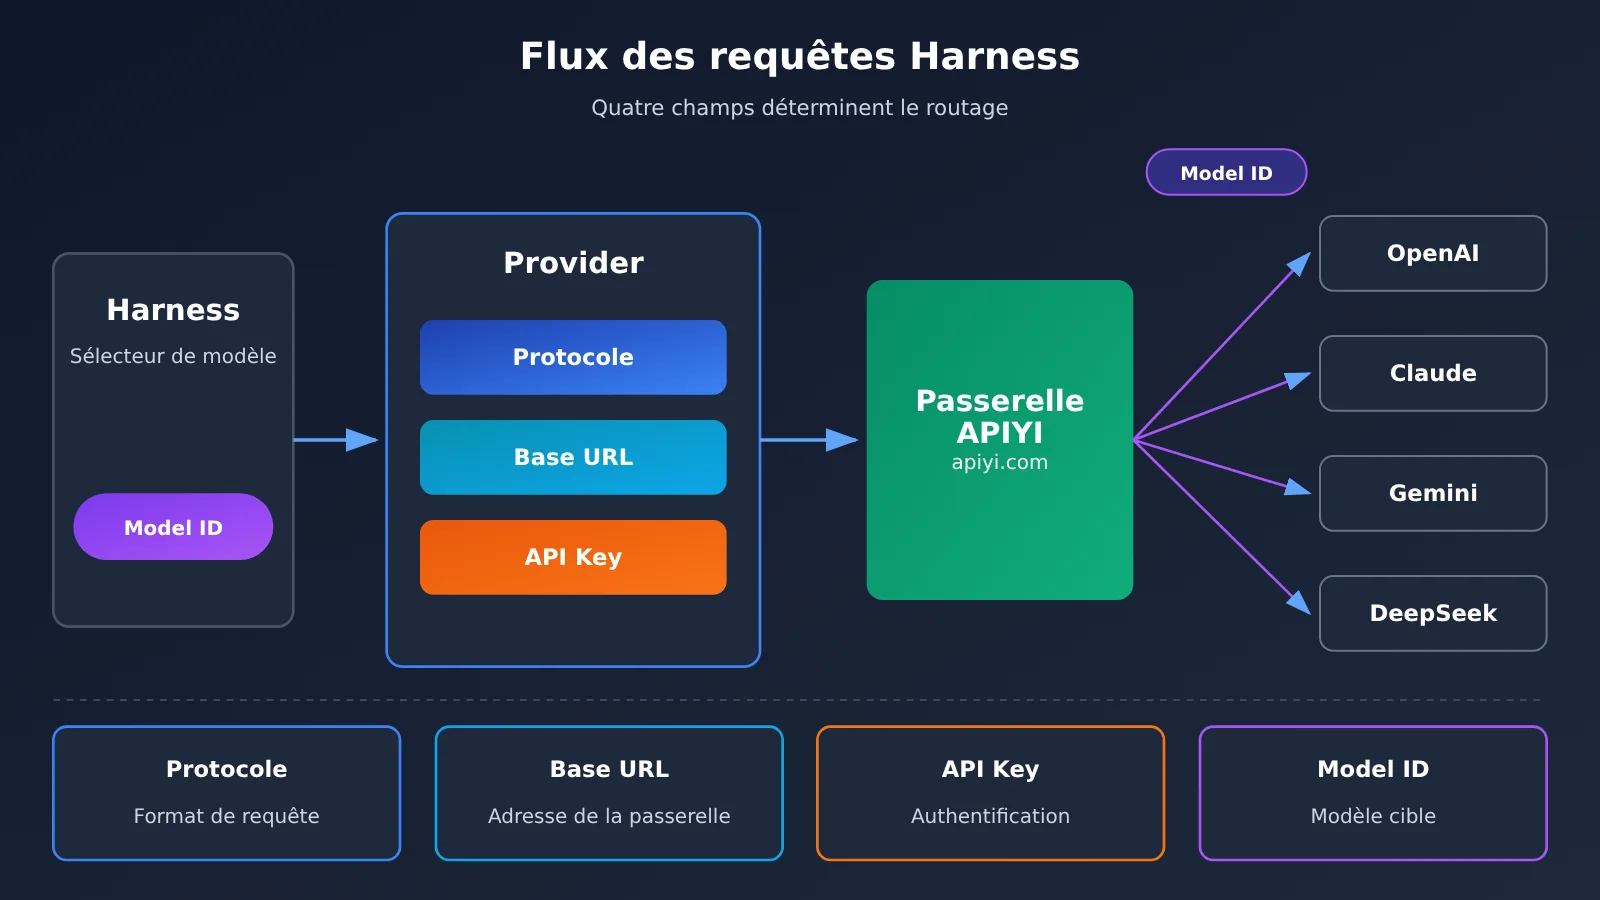
Du point de vue de Harness, une passerelle est un Provider. Quatre champs déterminent la destination d’une requête : la Base URL pointe vers l’adresse de la passerelle, le protocole définit le format de la requête et de la réponse, la clé API prouve l’identité de l’appelant, et le Model ID indique à la passerelle vers quel modèle transmettre la requête.
Prenons APIYI (apiyi.com) : la plateforme fournit avec une seule clé API l’accès à des modèles comme OpenAI, Claude, Gemini et DeepSeek, et expose trois points d’entrée protocolaires : compatible OpenAI, Anthropic natif et Gemini. Dans Harness, il suffit de créer le fournisseur correspondant au bon protocole ; changer de modèle revient alors à modifier le Model ID, sans avoir à ouvrir un compte et à maintenir une clé séparée pour chaque fournisseur.
2 DeepSeek Harness : configurer un fournisseur de modèle personnalisé depuis zéro
2.1 Ouvrir l’interface de configuration des modèles de DeepSeek Harness
Le moyen le plus rapide de lancer Harness en local, c’est la commande npm officielle — il faut au préalable avoir installé Node.js :
npx @deepseek-ai/dsh web
# ouvre par défaut l'interface Web locale : http://127.0.0.1:3080
Une fois dans l’interface, cliquez successivement sur Réglages → Modèles → Ajouter un fournisseur de modèle → API de modèle personnalisé : le formulaire de configuration du fournisseur apparaît. La version desktop officielle propose des paquets d’installation pour macOS Apple Silicon et Windows 64 bits, avec un chemin de configuration identique.
2.2 Renseigner les informations du fournisseur DeepSeek Harness
| Paramètre | Rôle | À renseigner |
|---|---|---|
| Provider ID | Identifiant unique du fournisseur | Doit être en minuscules ; ne peut pas être renommé après création, par ex. apiyi |
| Nom d’affichage | Nom affiché dans le menu des modèles | Vous pouvez mettre « APIYI compatible OpenAI » |
| Protocole API | Format des requêtes et des réponses | Doit correspondre au Base URL, voir 2.3 |
| Base URL | Adresse du service API | Attention au préfixe de version, voir 2.4 |
| API Key | Justificatif d’authentification | Stockée dans le fichier d’identifiants ; l’interface n’affiche qu’un aperçu masqué |
| Model ID | Nom du modèle réellement appelé | Doit être strictement identique à la liste des modèles de la passerelle |
| Context Window / Max Output Tokens | Longueur du contexte et de la sortie maximale | À renseigner selon les spécifications réelles du modèle |
| Input Type | Entrée texte ou image | Cochez « image » uniquement pour les modèles de vision |
| Reasoning Effort | Niveau de réflexion et mappage des paramètres | Ajoutez uniquement les niveaux réellement pris en charge par le modèle |
Le Provider ID ne peut pas être renommé, car la configuration du modèle, les sessions historiques et les références aux identifiants pointent toutes vers cet ID. Si vous devez le remplacer, créez d’abord un nouveau fournisseur, puis supprimez l’ancien.
Le bouton « Obtenir les modèles disponibles » du formulaire tente de lire la liste des modèles depuis la passerelle. Si la passerelle ne fournit pas de liste standard, ou si le format renvoyé n’est pas reconnu par Harness, ajoutez simplement le Model ID manuellement : le résultat sera identique.
2.3 Choisir le protocole API de DeepSeek Harness
L’API de modèle personnalisé de Harness prend en charge quatre protocoles : OpenAI Chat Completions, OpenAI Responses, Anthropic Messages et Gemini API. Un fournisseur ne peut être associé qu’à un seul protocole ; si une même passerelle expose trois points d’entrée de protocole, il faut créer trois fournisseurs.
Le choix du protocole dépend de la famille de modèles. Pour GPT, DeepSeek et la plupart des modèles chinois, OpenAI Chat Completions est l’option la plus sûre ; pour la série Claude, on peut choisir Anthropic Messages afin de conserver les fonctionnalités natives ; la série Gemini utilise Gemini API. Le protocole Responses convient aux scénarios qui nécessitent des réponses structurées et des appels d’outils, à condition que la passerelle et le modèle cible prennent en charge cette interface.
2.4 Utiliser APIYI pour configurer une instance DeepSeek Harness
Voici la correspondance entre les protocoles et les Base URL donnée par la documentation officielle d’APIYI :
| Protocole | Base URL APIYI | Modèles compatibles | Plateformes disponibles |
|---|---|---|---|
| Compatible OpenAI (Chat Completions) | https://api.apiyi.com/v1 |
GPT, DeepSeek, etc. | APIYI apiyi.com, API officielles des fournisseurs |
| Anthropic natif | https://api.apiyi.com |
Gamme Claude | APIYI, API officielle Anthropic |
| Gemini | https://api.apiyi.com/v1beta |
Gamme Gemini | APIYI, API officielle Google |
Le protocole Anthropic utilise le domaine racine ; l’adaptateur ajoute lui-même les chemins suivants. Si vous ajoutez /v1 après le domaine racine, le chemin risque d’être dupliqué et une erreur 404 peut être renvoyée. Pour l’intégration du protocole Responses, consultez la documentation APIYI Responses API et vérifiez les informations avant de remplir le formulaire.
En plus de la configuration via l’interface, Harness permet aussi de modifier manuellement le fichier de configuration, situé à l’emplacement $DSH_HOME/profiles/web/cordis.patch.yml. Voici un modèle de fournisseur compatible OpenAI d’APIYI, rédigé selon la structure de configuration officielle :
- id: llm-pi-ai
  config:
    providers:
      apiyi:
        apiKeyEnv: APIYI_API_KEY          # Lire la clé depuis la variable d’environnement
        api: openai-completions           # Protocole OpenAI Chat Completions
        baseURL: https://api.apiyi.com/v1 # Point d’entrée compatible OpenAI d’APIYI
        models:
          - id: MODEL_ID_FROM_APIYI       # Remplacer par l’ID de modèle réellement disponible sur le compte
Voici les étapes à suivre :
- Définissez la variable d’environnement
APIYI_API_KEY; - Remplacez
MODEL_ID_FROM_APIYIpar le nom du modèle réellement disponible dans la console APIYI ; - Enregistrez la configuration, puis dans le sélecteur de modèles Harness, choisissez le fournisseur
apiyiet le modèle correspondant ; - Lancez une conversation simple pour confirmer que l’API fonctionne correctement.
Ce modèle présente la structure de configuration officielle ; pour les noms de modèles, fiez-vous à la liste des modèles appelables depuis votre propre compte. Les modifications de configuration des modèles prennent généralement effet à la requête suivante ; nul besoin de redémarrer l’interface Web. La configuration via l’interface convient pour ajouter des modèles et modifier les clés au quotidien ; le fichier de configuration est plutôt adapté aux réglages avancés tels que les paramètres de compatibilité, le mode de raisonnement, les délais d’attente et les nouvelles tentatives.
Avant d’intégrer Harness, il est conseillé de vérifier séparément la clé et le Model ID avec un script, pour diagnostiquer séparément deux problèmes : « la passerelle est disponible » et « la configuration Harness est correcte » :
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["APIYI_API_KEY"],
    base_url="https://api.apiyi.com/v1"  # Point d’entrée compatible OpenAI d’APIYI apiyi.com
)

resp = client.chat.completions.create(
    model="MODEL_ID_FROM_APIYI",  # Conserver le même Model ID que celui renseigné dans Harness
    messages=[{"role": "user", "content": "用一句话介绍你自己"}],
    max_tokens=100
)
print(resp.choices[0].message.content)
🚀 Conseil pour démarrer rapidement : les nouveaux utilisateurs peuvent s’inscrire sur APIYI apiyi.com et recevoir un crédit d’essai gratuit. Commencez par vérifier avec le script ci-dessus que l’ID de modèle est disponible, puis renseignez-le dans la configuration Harness : le dépannage sera bien plus rapide.
3 L’interface DeepSeek Harness répond, mais pourquoi l’invocation du modèle échoue-t-elle encore ?
La documentation officielle de Harness le dit clairement : même lorsque l’adresse de l’API et la clé sont correctes, la passerelle peut quand même rejeter la requête. En cause : les différentes interfaces compatibles n’ont pas les mêmes exigences concernant les rôles des messages, la longueur de sortie et les paramètres de réflexion. Les trois paramètres compat ci-dessous servent justement à régler ce type de problème ; activez-les selon les erreurs réellement renvoyées par l’interface.
3.1 Compatibilité du rôle Developer
La nouvelle spécification OpenAI introduit role: developer, alors que certaines passerelles compatibles ne reconnaissent que system. Si vous voyez que « toutes les requêtes échouent » ou que « seuls les modèles de raisonnement échouent », vous pouvez désactiver le rôle developer :
compat:
  supportsDeveloperRole: false
Une fois cette option activée, l’adaptateur ajuste la manière dont les rôles sont traités dans la requête, pour que celle-ci respecte le format accepté par la passerelle.
3.2 Compatibilité du paramètre de sortie maximale
La nouvelle interface OpenAI utilise max_completion_tokens pour indiquer la sortie maximale, alors que certains gateways n’acceptent que le traditionnel max_tokens. Les deux ont la même signification, mais un nom de champ différent entraîne un échec de validation des paramètres. La configuration correspondante est la suivante :
compat:
  maxTokensField: max_tokens
3.3 Compatibilité du mode réflexion de DeepSeek
Certains modèles DeepSeek activent la réflexion par défaut. Dans Harness, lorsque le niveau de raisonnement est réglé sur off, certains protocoles compatibles se contentent d’omettre les paramètres de raisonnement : le modèle continue alors de réfléchir selon son comportement par défaut, ce qui donne l’impression que « off ne désactive rien ». C’est pourquoi l’officiel propose un format de réflexion spécifique à DeepSeek :
compat:
  thinkingFormat: deepseek
Une fois activé, l’adaptateur envoie explicitement {"thinking": {"type": "disabled"}} lorsque la réflexion est désactivée, et {"thinking": {"type": "enabled"}} lorsqu’elle est activée. L’exemple officiel concerne le modèle DeepSeek V4 derrière un gateway compatible OpenAI. Dans un gateway multi-modèles, on peut définir ce paramètre uniquement pour les modèles DeepSeek, tandis que GPT, Claude et les autres conservent les valeurs par défaut.
Côté niveaux de raisonnement, Harness permet de mapper les valeurs off, low, medium, high et max de l’interface vers les valeurs de paramètres réellement acceptées par l’API. En n’ajoutant à la configuration que les paliers réellement pris en charge par le modèle, on évite que l’utilisateur sélectionne un palier invalide et provoque une erreur de requête. Voici un exemple complet après fusion des trois paramètres de compatibilité :
- id: llm-pi-ai
  config:
    providers:
      apiyi:
        apiKeyEnv: APIYI_API_KEY
        api: openai-completions
        baseURL: https://api.apiyi.com/v1
        compat:
          supportsDeveloperRole: false
          maxTokensField: max_tokens
        models:
          - id: MODEL_ID_FROM_APIYI
3.4 Dépannage rapide des erreurs courantes de DeepSeek Harness
| Erreur ou symptôme | Cause probable | Solution |
|---|---|---|
| MISSING_CREDENTIAL | Clé non configurée | Vérifier la clé API et le nom de la variable d’environnement |
| UNKNOWN_MODEL | ID de modèle non enregistré | Ajouter l’ID de modèle correct sous le fournisseur |
| HTTP 401 | Clé invalide ou permissions insuffisantes | Vérifier le contenu de la clé ainsi que le groupe auquel elle appartient |
| HTTP 404 | Chemin de Base URL incorrect | Vérifier le protocole et le préfixe de version (/v1, domaine racine, /v1beta) |
| Liste de modèles vide | La passerelle ne prend pas en charge l’interface standard de liste des modèles | Ajouter l’ID de modèle manuellement |
| Toutes les requêtes échouent | Conflit de rôle ou de format de paramètre | Vérifier les paramètres de compatibilité compat |
| Seuls les modèles de raisonnement échouent | Rôle Developer incompatible | Définir supportsDeveloperRole: false |
| Impossible de désactiver la réflexion (off) | Le modèle active la réflexion par défaut | Définir thinkingFormat: deepseek |
| L’interface de recherche renvoie 503 | Le groupe du jeton n’a pas les permissions d’outil | Changer pour un jeton des groupes default ou svip |
| Le dialogue fonctionne mais pas l’accès web | L’outil de recherche n’est pas intégré ou le protocole n’est pas pris en charge | Vérifier les capacités de l’outil et la configuration du client |
Les huit premières entrées s’appuient sur la documentation officielle de configuration de Harness ; les problèmes liés aux groupes proviennent de la documentation officielle d’APIYI. Pour le dépannage, je vous conseille de suivre l’ordre du tableau, du haut vers le bas : d’abord les identifiants, puis l’ID du modèle, ensuite le chemin, et enfin la compatibilité des paramètres.
4 Ajouter une capacité de recherche web au DeepSeek Harness
4.1 Bien distinguer la recherche intégrée au modèle et l’API de recherche indépendante
Une simple invocation de dialogue réussie ne prouve que trois choses : la clé API est valide, l’ID du modèle est correct et le protocole de dialogue est globalement compatible. Pour la recherche web, il faut en plus que le modèle prenne en charge l’outil concerné, que la requête déclare correctement cet outil, que le service API supporte le protocole de l’outil, que le Harness sache traiter la réponse de l’outil — ou bien que le développeur intègre la recherche séparément côté application. Le succès d’un chat et le succès d’une recherche web sont donc deux étapes de validation distinctes.
Dans l’écosystème DeepSeek, la capacité de recherche web se décline en deux approches techniques :
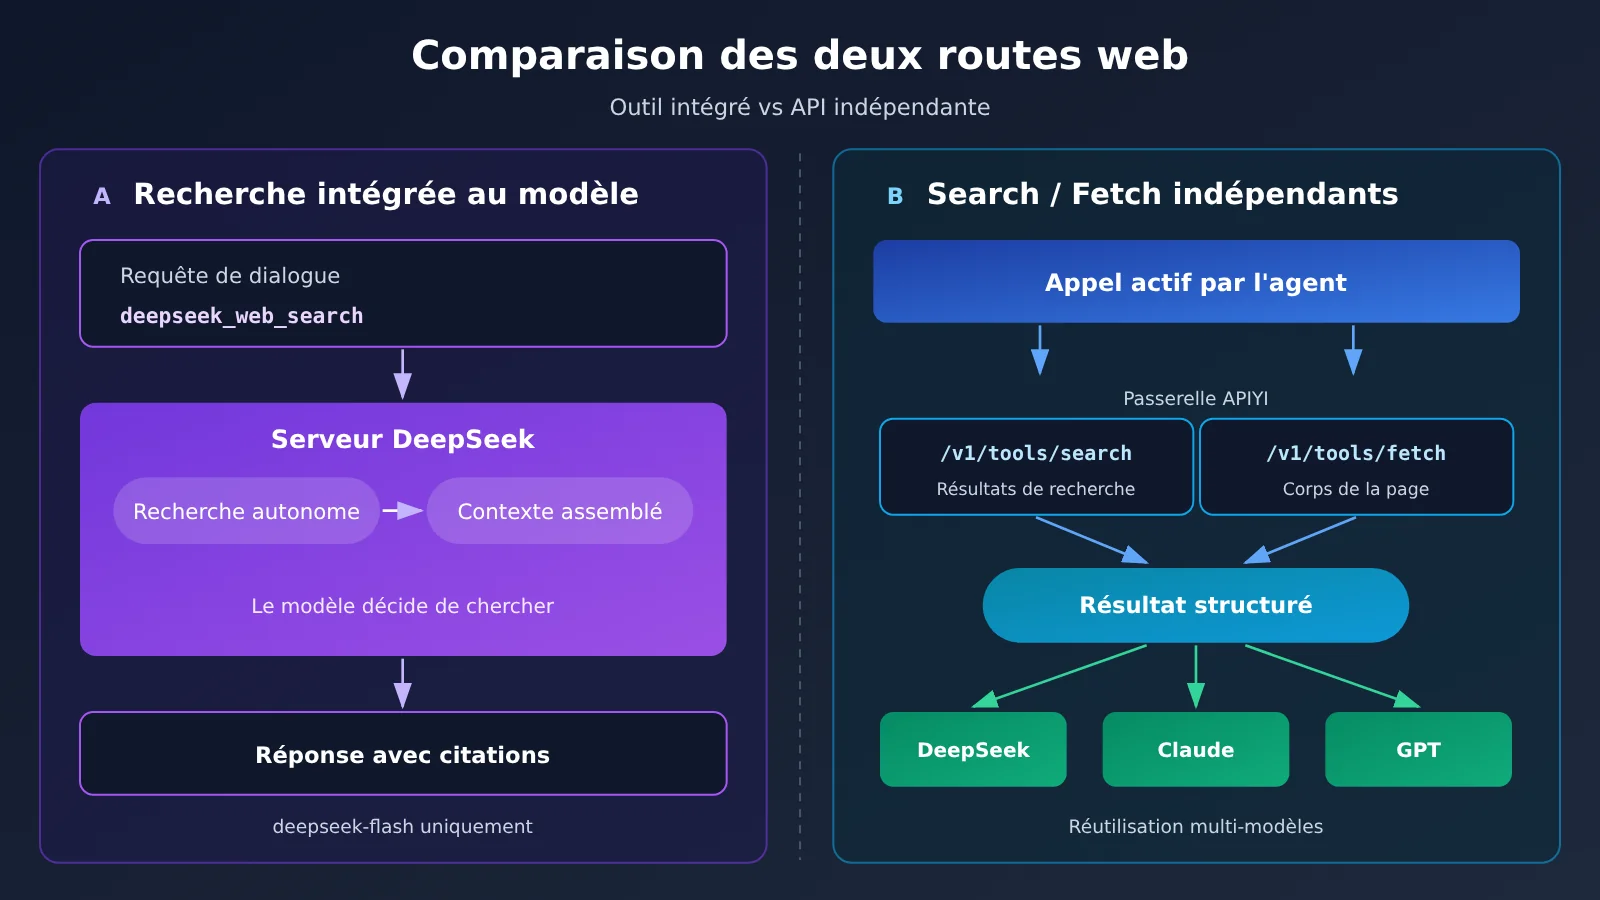
| Dimension | Approche A : outils serveur intégrés au modèle | Approche B : API Search / Fetch indépendantes |
|---|---|---|
| Mode d’appel | Déclarer deepseek_web_search et deepseek_read_url dans la requête de dialogue |
Le programme appelle activement /v1/tools/search et /v1/tools/fetch |
| Qui déclenche la recherche | Le modèle décide de lui-même | Le développeur ou la logique d’outil de l’Agent |
| Exécution de l’outil | Le service DeepSeek effectue la recherche et assemble le contexte | Le client traite lui-même les résultats une fois reçus |
| Périmètre de modèles | L’annonce officielle cible explicitement deepseek-flash |
Indépendant du modèle ; n’importe quel modèle peut réutiliser les résultats |
| Base de facturation | Facturé selon le nombre réel de termes recherchés, de pages récupérées, etc. | Facturé au nombre de requêtes réussies, sans consommer de tokens du modèle |
| Canaux actuellement disponibles | API officielle DeepSeek | API officielle DeepSeek, APIYI |
4.2 Comment fonctionne la recherche intégrée au modèle
Le 13 novembre 2026, DeepSeek a ouvert plusieurs des capacités applicatives qui sous-tendent son App, parmi lesquelles la recherche web et la lecture de liens, proposées sous forme d’outils côté serveur. Il suffit de les déclarer dans la liste d’outils de la requête :
[
  {"type": "deepseek_web_search", "name": "deepseek_web_search"},
  {"type": "deepseek_read_url", "name": "deepseek_read_url"}
]
Une fois déclarés, le modèle décide lui-même s’il doit accéder au web et génère les termes de recherche ; c’est le serveur DeepSeek qui exécute la recherche et renvoie une réponse accompagnée des sources citées. Lorsque le mode réflexion est activé, la recherche passe à un processus en plusieurs étapes : le modèle peut chercher plusieurs mots-clés, ouvrir des pages web, effectuer une recherche dans la page et recouper les informations. La documentation officielle indique qu’il répond après un maximum d’environ 20 appels d’outils. deepseek_read_url ne prend en compte que les URL présentes dans le dernier message de l’utilisateur, avec un maximum de 10 liens différents.
Les développeurs doivent toutefois gérer les blocs de contenu renvoyés, les informations de citation, les événements en streaming et l’historique sur plusieurs tours. Selon l’annonce officielle, cette intégration complète d’outils au niveau de la conversation est portée par deepseek-flash (DeepSeek-V4.1-Flash). D’après la documentation d’APIYI, le travail de compatibilité permettant d’appeler ce type de recherche intégrée via la passerelle depuis des clients comme Harness ou Claude Code est encore en cours de planification. Pour utiliser aujourd’hui la route A, il faut donc se connecter directement à l’API officielle de DeepSeek.
4.3 Accès autonome aux outils Search / Fetch d’APIYI
APIYI a mis en ligne le 21 octobre 2026 des interfaces d’outils autonomes DeepSeek Search & Fetch, correspondant à deepseek-search et deepseek-fetch. Search renvoie des résultats de recherche structurés, tandis que Fetch récupère la page web indiquée et en renvoie le corps en Markdown. Les requêtes ne demandent aucun ID de modèle et ne consomment pas de tokens de modèle ; la facturation se fait au nombre d’appels réussis.
L’exemple suivant lance d’abord une recherche, puis récupère la page classée en première position :
import os
import requests

BASE = "https://api.apiyi.com/v1/tools"  # Interface d’outils autonomes APIYI
headers = {"Authorization": f"Bearer {os.environ['APIYI_API_KEY']}"}

search = requests.post(
    f"{BASE}/search",
    headers=headers,
    json={"query": "DeepSeek Harness 插件", "count": 5},
    timeout=60,
)
search.raise_for_status()
results = search.json()["results"]

if results:
    url = results[0]["url"]
    fetch = requests.post(
        f"{BASE}/fetch",
        headers=headers,
        json={"url": url},
        timeout=60,
    )
    if fetch.ok:
        print(fetch.json()["content"])
Il faut faire particulièrement attention aux groupes de jetons : les groupes default et svip peuvent appeler ces deux interfaces, mais un jeton du groupe ClaudeCode ne peut pas les appeler directement ; la documentation mentionne d’ailleurs un cas où une réponse 503 a été renvoyée. Les autotests de la documentation APIYI indiquent que Search renvoie 5 résultats en environ 1,8 seconde et que 20 requêtes simultanées ont toutes renvoyé un code 200 ; lorsque Fetch accède à une page inaccessible, l’appel échoue sans être facturé. Ces chiffres proviennent des tests de la plateforme elle-même ; les performances réelles dépendent du réseau et du site cible. Côté tarifs, la documentation indique un prix interne de 0,90 $ pour 1000 appels ; après cumul des bonus de recharge, le montant réellement payé est plus faible. Le tarif applicable est celui affiché dans la console.
Pour que l’agent de Harness utilise cette logique de manière autonome, il faut l’encapsuler dans un plugin d’outils. Les plugins Harness sont écrits en TypeScript et enregistrent des outils via l’objet de contexte ctx ; lorsqu’un plugin est déchargé, le framework nettoie automatiquement les outils et événements enregistrés. Lors de l’encapsulation, il est conseillé d’enregistrer search et fetch comme deux outils distincts, pour que le modèle récupère d’abord la liste des résultats, puis décide quelles pages récupérer.
💡 Conseil technique : les outils Search / Fetch autonomes sont découplés du modèle ; un même ensemble de résultats de recherche peut être confié à différents modèles, comme GPT, Claude ou DeepSeek. Avec APIYI apiyi.com, une seule clé permet de gérer à la fois les invocations de modèles et les outils de recherche, ce qui facilite la comparaison dans Harness de la qualité des réponses de différents modèles à partir des mêmes informations.
5 Comment concevoir un Agent multi-modèles avec DeepSeek Harness
5.1 Choisir un modèle différent selon la tâche
Tout l’intérêt d’intégrer plusieurs modèles, c’est de répartir les modèles en fonction des tâches. Un Agent de programmation peut utiliser un modèle à l’aise avec le code ; les tâches à haute fréquence comme la mise en forme de documents ou la réécriture de résumés se contentent de modèles moins coûteux ; l’analyse de captures d’écran et la compréhension de graphiques exigent en revanche un modèle de vision capable de traiter des images, avec la case image cochée dans Input Type.
Prenons les modèles officiels DeepSeek : DeepSeek-V4.1-Flash comprend les images, DeepSeek-V4-Pro non, et leurs prix diffèrent d’un facteur plusieurs. En les configurant dans Harness comme deux Model ID d’un même fournisseur, puis en basculant de l’un à l’autre selon la tâche au fil de la session, on concilie qualité et coût.
5.2 Gérer séparément l’invocation du modèle DeepSeek Harness et la capacité de recherche
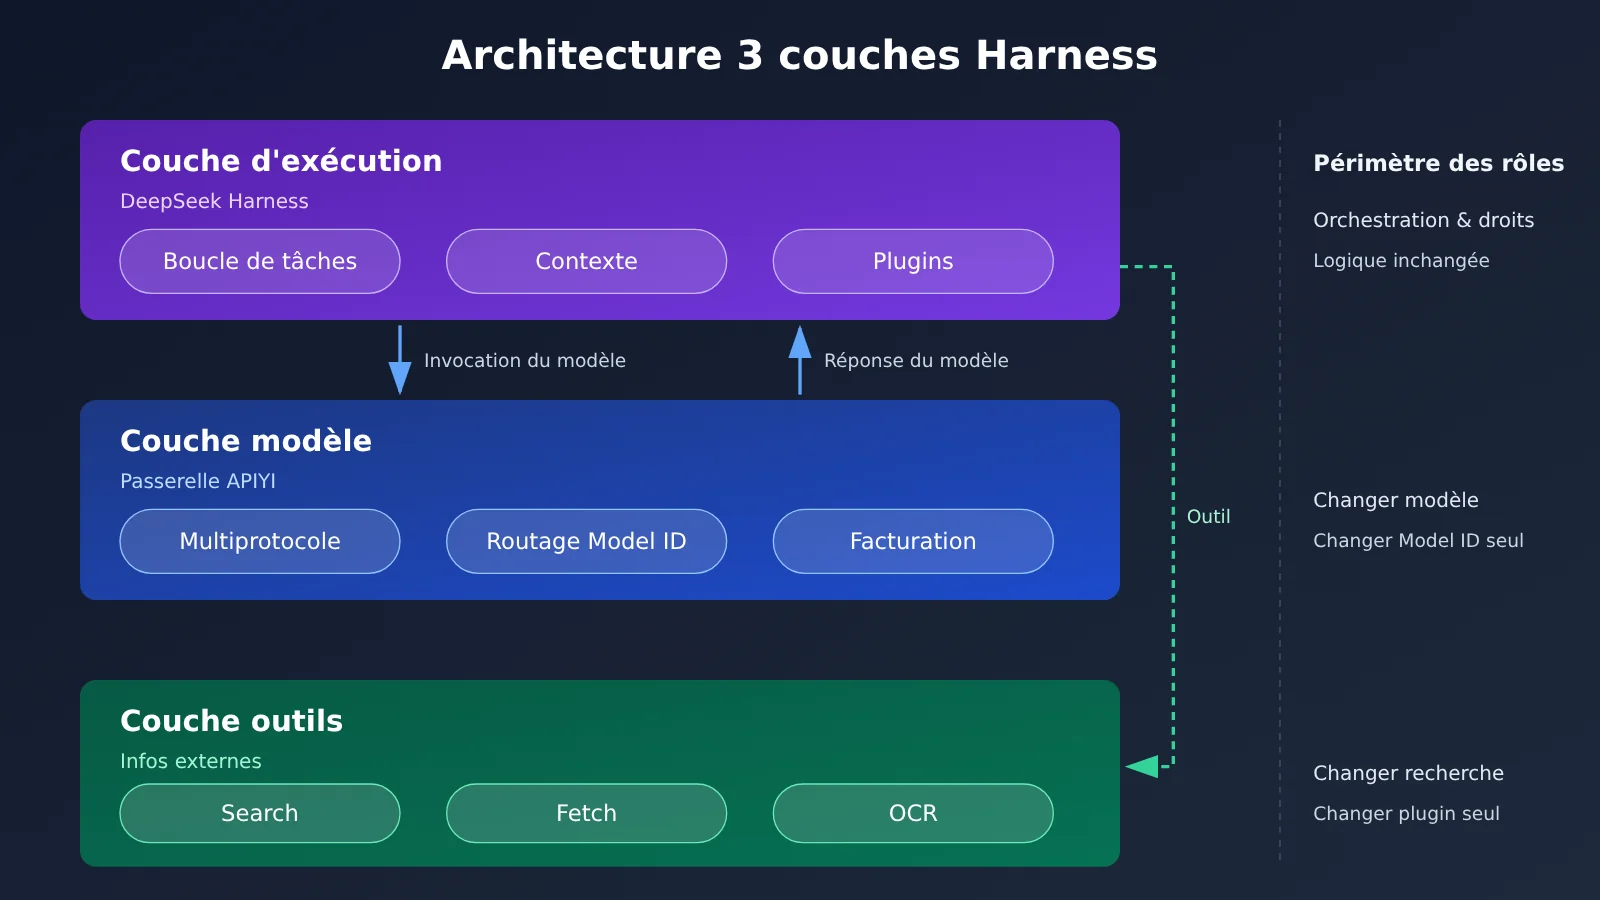
La structure recommandée se divise en trois couches. La couche d’exécution confie à Harness la boucle de tâches, la compression du contexte, le chargement des plugins et le contrôle des permissions ; la couche de modèles confie à la passerelle d’API la conversion de protocoles, le routage des modèles et la facturation ; la couche d’outils apporte l’information externe via des interfaces indépendantes comme Search / Fetch. Chacune des trois couches est remplaçable : changer de modèle ne touche que le Model ID, changer de service de recherche ne touche que le plugin d’outil, et la logique d’exécution reste identique.
La séparation en couches apporte aussi des bénéfices côté sécurité. L’évaluation contrôlée du Harness menée par le laboratoire Tencent Zhuque montre que des contenus non fiables — pages web, fichiers, Skills — peuvent influencer le comportement de l’Agent via une injection indirecte d’invites. Une fois la couche d’outils séparée de la couche d’exécution, on peut insérer un filtrage et une étape de confirmation uniformes avant que les résultats de recherche n’entrent dans le contexte et avant l’exécution d’outils sensibles.
5.3 Recommandations de déploiement concret de DeepSeek Harness
- Configuration des modèles : un protocole correspond à un fournisseur, le Provider ID s’écrit en minuscules et se fixe une fois pour toutes ; les ID de modèle se copient toujours depuis la console de la passerelle.
- Gestion des clés : Harness stocke les clés dans
$DSH_HOME/.credentials.yaml, et le fichier de configuration ne référence que des variables d’environnement, pour éviter qu’une clé en clair n’arrive dans une configuration partagée ou dans un dépôt de code. - Tests de compatibilité : à chaque intégration d’un nouveau modèle, vérifier successivement la conversation normale, la désactivation du raisonnement, les sorties longues et l’entrée d’images, puis activer les paramètres
compaten fonction des erreurs remontées. - Appels d’outils : limitez le nombre de plugins. Les retours de la communauté montrent qu’au-delà d’une dizaine de plugins installés, un débordement de contexte et une hausse de la consommation de tokens peuvent apparaître ; garder des descriptions concises pour les outils de recherche reste plus stable.
- Suivi des coûts : les tokens de modèle et les appels d’outils sont facturés séparément, mieux vaut les comptabiliser séparément dans l’interface d’administration de la passerelle. La console APIYI apiyi.com permet de consulter l’usage par clé, ce qui convient bien pour attribuer une clé distincte à chaque Agent et isoler les coûts.
Autre point : avant de mettre à jour Harness, sauvegardez la configuration sous $DSH_HOME. La communauté a documenté un cas où, après une mise à jour de version, la configuration de plugins tiers avait été perdue, avec plusieurs heures nécessaires pour la restaurer.
FAQ – Questions fréquentes
Q1 : DeepSeek Harness ne peut utiliser que les modèles DeepSeek ?
Harness permet, via une API de modèle personnalisée, de se connecter à n’importe quel service compatible avec l’un des quatre protocoles, y compris les séries OpenAI, Claude, Gemini, ainsi que divers passerelles API et services de modèles auto-hébergés. Les modèles officiels DeepSeek ne sont qu’une option parmi d’autres.
Q2 : Pourquoi créer plusieurs fournisseurs pour une même passerelle ?
Harness impose qu’un fournisseur ne soit lié qu’à un seul protocole. APIYI ouvre simultanément trois points d’entrée : compatible OpenAI, Anthropic et Gemini. Si vous voulez appeler GPT, Claude et Gemini chacun avec leur protocole natif, vous devez créer trois fournisseurs, avec des Base URL respectivement `/v1`, le domaine racine et `/v1beta`.
Q3 : Comment savoir quel ID de modèle renseigner ?
Essayez d’abord la fonction « Obtenir les modèles disponibles » ; si la lecture échoue, copiez le nom exact depuis la liste des modèles de la console APIYI apiyi.com et ajoutez-le manuellement. Les ID de modèle sont sensibles à la casse et au suffixe de version ; la moindre différence déclenchera une erreur UNKNOWN_MODEL ou une erreur de passerelle.
Q4 : Après avoir connecté via APIYI, puis-je utiliser directement deepseek_web_search ?
Actuellement, APIYI prend en charge les interfaces Search / Fetch autonomes de DeepSeek ; la compatibilité permettant d’appeler la recherche intégrée au modèle via des clients comme Harness est encore en cours de planification. À ce stade, nous recommandons d’utiliser `/v1/tools/search` et `/v1/tools/fetch` d’APIYI en les encapsulant comme outils d’Agent ; si vous avez besoin de la recherche intégrée, connectez-vous directement à l’API officielle DeepSeek.
Q5 : L’interface de recherche renvoie une 503, mais les conversations fonctionnent parfaitement : quelle en est la cause ?
La cause la plus fréquente est le groupe du jeton. Un jeton du groupe ClaudeCode ne peut pas appeler directement les interfaces d’outils autonomes ; il suffit d’utiliser une clé des groupes default ou svip. Vous pouvez créer dans le back-office APIYI apiyi.com un jeton dédié du groupe correspondant pour l’outil de recherche, et le gérer séparément de la clé d’invocation du modèle.
Q6 : Quelles sont les limites de l’intégration multi-modèles de DeepSeek Harness ?
Harness reste en version préliminaire pour développeurs (developer preview), et la structure de configuration peut évoluer selon les versions ; chaque passerelle transmet plus ou moins fidèlement les Responses, les paramètres de raisonnement et le protocole d’outils, ce qui nécessite une validation modèle par modèle. Trop de plugins augmentent le coût en contexte et en Tokens, et la qualité de livraison sur des tâches complexes dépend aussi de la configuration des plugins et de la gestion du processus d’exécution.
Résumé
Le mécanisme d’adaptation des modèles ouverts de DeepSeek Harness permet à un framework d’Agent d’appeler les modèles de plusieurs fournisseurs via un gateway unifié. Voici les points clés à retenir pour une mise en production :
- Le protocole détermine le fournisseur : un protocole = un Provider, et le préfixe de version de la Base URL doit correspondre strictement au protocole ;
- Copier l’ID de modèle depuis le gateway : récupérez-le depuis la console, et si la liste n’est pas accessible, ajoutez-le manuellement ;
- Activer les paramètres de compatibilité en fonction des erreurs : le rôle developer, le champ
max_tokenset le format de raisonnement DeepSeek couvrent la plupart des problèmes de type « ça se connecte mais ça ne marche pas » ; - Planifier séparément les capacités web : la recherche intégrée passe par l’API officielle DeepSeek, tandis que les Search / Fetch indépendants peuvent être appelés via le gateway et encapsulés sous forme d’outils ;
- Séparation des couches et gouvernance : distinguez la couche d’exécution, la couche modèle et la couche outils, et gérez séparément les clés, les versions et les coûts.
Nous recommandons de commencer par faire tourner un seul modèle de bout en bout — « validation du script → configuration Harness → conversation simple » — avant d’ajouter progressivement d’autres modèles et des outils de recherche. Nous vous conseillons de récupérer un quota de test gratuit via APIYI apiyi.com, afin de valider l’ensemble (multi-modèles et Search / Fetch) avec une seule clé.
📚 Références
- Documentation de configuration des modèles DeepSeek Harness : champs de fournisseur personnalisé et paramètres de compatibilité compat
- Lien :
deepseek-harness.github.io/deepseek-harness/guide/providers -
Description : documentation officielle de supportsDeveloperRole, maxTokensField, thinkingFormat
-
Dépôt GitHub DeepSeek Harness : code source, Releases et méthode de démarrage
- Lien :
github.com/deepseek-ai/deepseek-harness -
Description : mises à jour de version et notes sur la phase de prévisualisation développeur
-
Documentation des outils web DeepSeek : deepseek_web_search et deepseek_read_url
- Lien :
api-docs.deepseek.com/zh-cn/guides/web_tools/ -
Description : mode de déclaration de la recherche intégrée, limites et règles de facturation
-
Guide de configuration de la Base URL APIYI : explication des trois chemins de protocole
- Lien :
help.apiyi.com/apiyi-base-url-v1-claude-gemini-endpoint-config-guide.html -
Description : cas d’usage de
/v1, du domaine racine et de/v1beta -
Documentation APIYI DeepSeek Search & Fetch : interfaces d’outils indépendants et exigences de regroupement
- Lien :
docs.apiyi.com/api-capabilities/deepseek-search-fetch/overview - Description : paramètres de requête, groupes de jetons et informations de facturation
Auteur : équipe technique APIYI
Échanges techniques : en cas de problème lors de la configuration, n’hésitez pas à nous contacter via la page d’accueil APIYI apiyi.com ; pour plus de détails sur les interfaces, consultez le centre de documentation docs.apiyi.com