Note de l’auteur : vous appelez gpt-6.1-sol avec succès, mais vous récupérez un texte vide ? La documentation indique completion_tokens 300, tous en reasoning_tokens, et pas un seul mot de texte. Cet article explique clairement la cause et deux solutions.
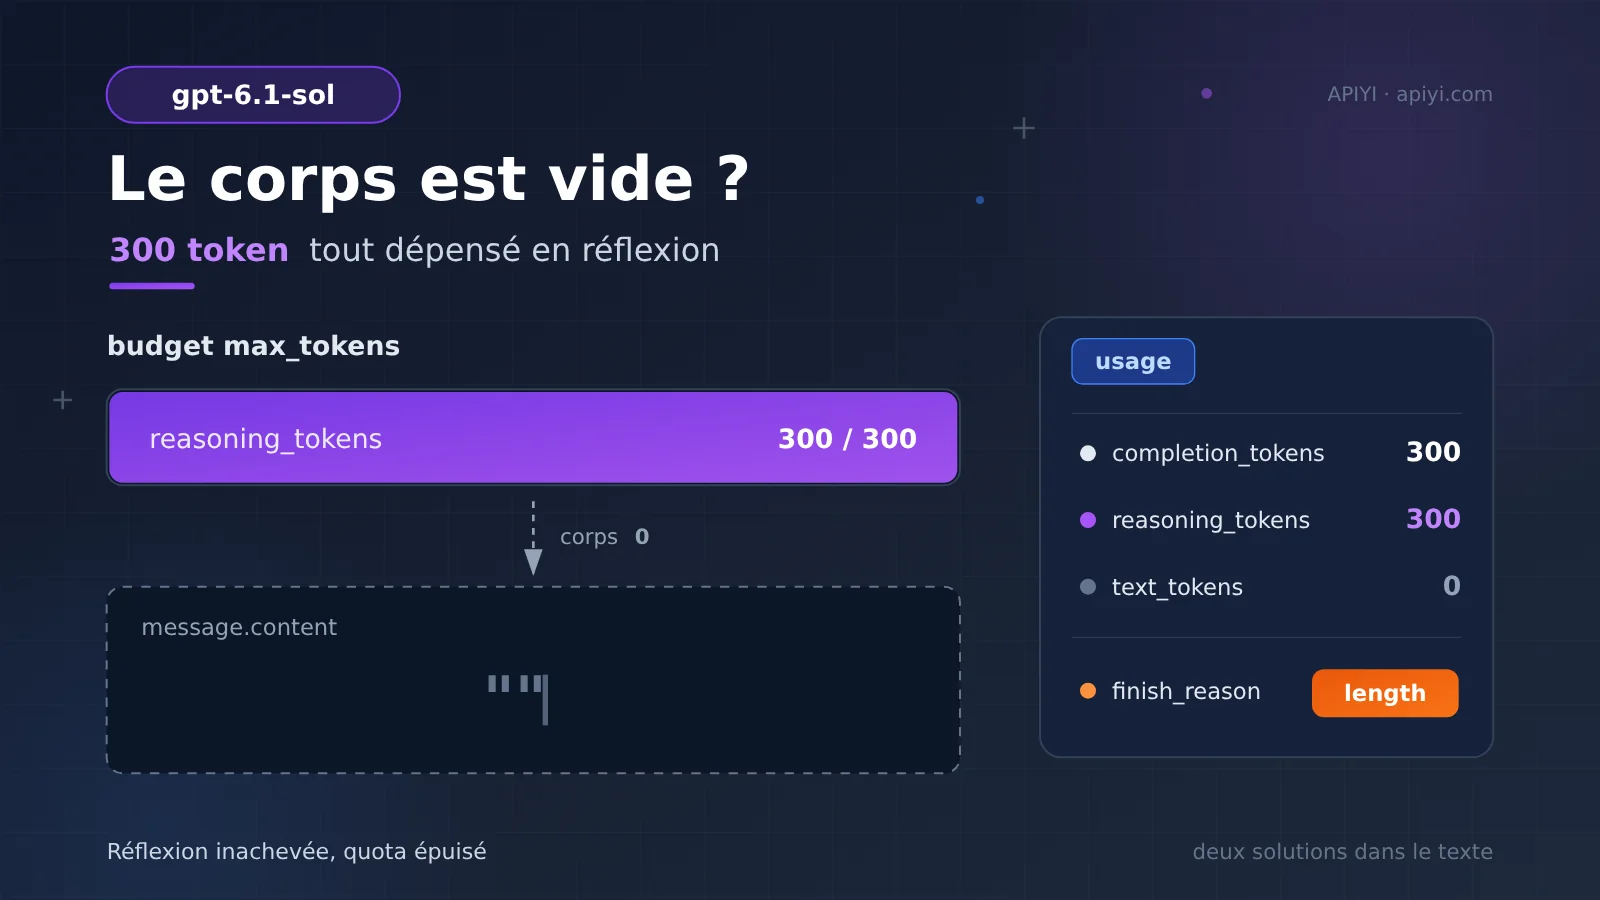
Si vous venez d’appeler gpt-6.1-sol, que l’interface n’a renvoyé aucune erreur mais que le message.content obtenu est une chaîne vide, ne suspectez pas tout de suite le réseau ou un modèle défaillant. Jetez plutôt un œil au champ usage de la réponse : completion_tokens vaut 300, reasoning_tokens aussi 300, et text_tokens 0. Autrement dit, ces 300 tokens ont tous servi à la réflexion, et pas un seul caractère de texte n’a été écrit.
Ce n’est ni un problème mystérieux et sporadique, ni le modèle qui tire au flanc. La documentation indique que le processus de réflexion de gpt-6.1-sol et le texte final partagent le même quota max_tokens : quand la réflexion n’est pas terminée et que le quota est déjà épuisé, le texte est tronqué dans son ensemble. Beaucoup de développeurs qui appellent gpt-6.1-sol via APIYI (apiyi.com) ont cru, la première fois qu’ils rencontraient ce phénomène, que la plateforme était en panne.
Ce n’est pas un énième article de vulgarisation sur les modèles de raisonnement, mais un guide de diagnostic ciblé sur ce symptôme précis : « le texte est vide ». Après lecture, vous saurez lire ce que racontent ces chiffres dans le champ usage, et grâce à deux modifications au niveau des paramètres, vous ferez sortir le texte normalement.
gpt-6.1-sol et le corps de réponse vide : l’essentiel
Commençons par la conclusion, les détails viendront ensuite. Quelques informations clés consignées dans la documentation déterminent la manière dont vous allez devoir mener le diagnostic :
| Point clé | Explication documentée | Ce que cela vous apporte |
|---|---|---|
| Le raisonnement et le texte final partagent le même quota | Le processus de raisonnement et la réponse finale de gpt-6.1-sol sont tous deux prélevés sur max_tokens |
Comprendre la cause profonde du corps vide |
| 300 tokens entièrement consacrés au raisonnement | completion_tokens à 300 égale reasoning_tokens à 300, et text_tokens vaut 0 |
Identifier le type de problème d’un coup d’œil |
| Deux manifestations externes | Un code d’erreur empty_response, ou un HTTP 200 avec un corps qui est une chaîne vide |
Ne pas se laisser tromper par un « faux succès » |
| Le nouvel envoi est quasiment inutile | Même invite, même max_tokens : un second envoi donne à peu près le même résultat |
Éviter les fausses pistes |
Où sont passés ces 300 tokens
Pour comprendre le corps vide, il faut d’abord comprendre la façon dont gpt-6.1-sol répond. C’est un modèle de raisonnement : avant de rédiger pour de bon, il « prend des notes » en interne — décomposer le problème, essayer des pistes, s’autocontrôler. Ces notes, c’est exactement la part comptabilisée dans reasoning_tokens.
Le point crucial, c’est que, d’après la documentation, les notes préparatoires et le corps du texte ne disposent pas de deux quotas indépendants : ils partagent le même max_tokens. Quand max_tokens est réglé dans une fourchette d’environ 200 à 500 et que la tâche exige vraiment du raisonnement, le quota a vite fait d’être épuisé pendant la phase de réflexion : la réflexion n’est pas terminée, le corps du texte n’a pas commencé, et le quota est déjà à sec. Ce qui vous revient, c’est tout naturellement un corps de réponse vide.
Le groupe de chiffres présent dans la documentation est on ne peut plus explicite :
completion_tokens: 300 — la totalité de la génération produite pour cette requêtereasoning_tokens: 300 — la part consacrée au raisonnementtext_tokens: 0 — la part réellement rédigée pour le corps du textefinish_reason:length— l’arrêt vient d’un butoir sur la limite de longueur, pas d’une fin normale
L’égalité parfaite entre completion_tokens et reasoning_tokens, avec text_tokens à zéro, c’est quasiment la signature standard d’un « quota entièrement absorbé par le raisonnement ». Combiné à finish_reason qui vaut length, cela confirme que le modèle ne « veut pas répondre », mais qu’il « n’a pas de quota pour répondre ». La limite atteinte cette fois tombe d’ailleurs pile dans cette fourchette de 200 à 500 que la documentation décrit comme facile à épuiser.
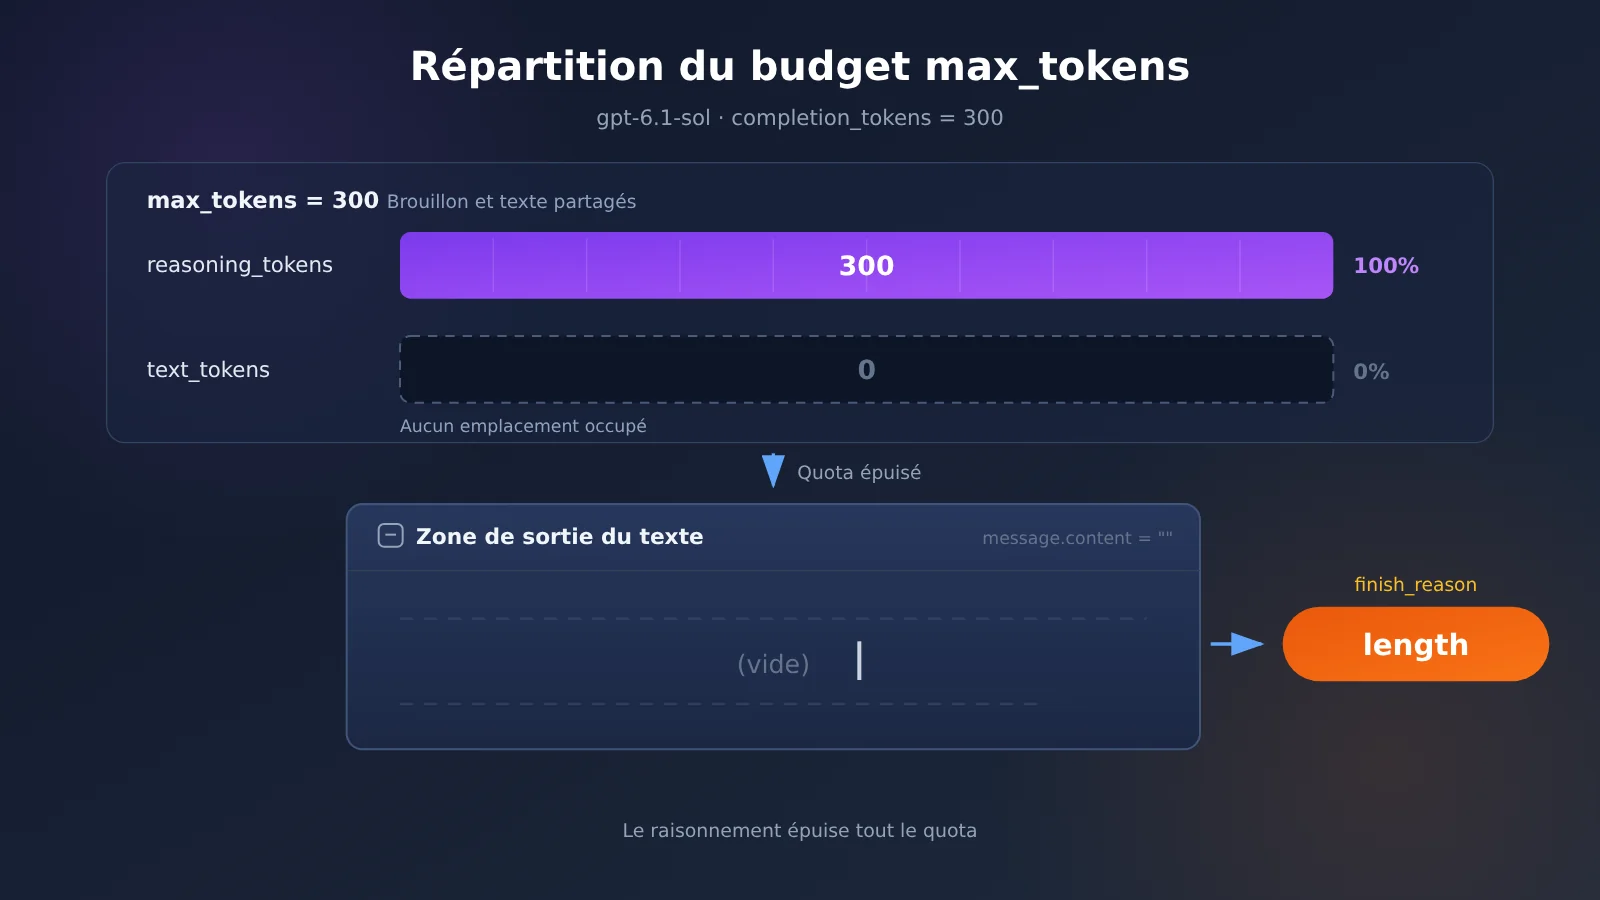
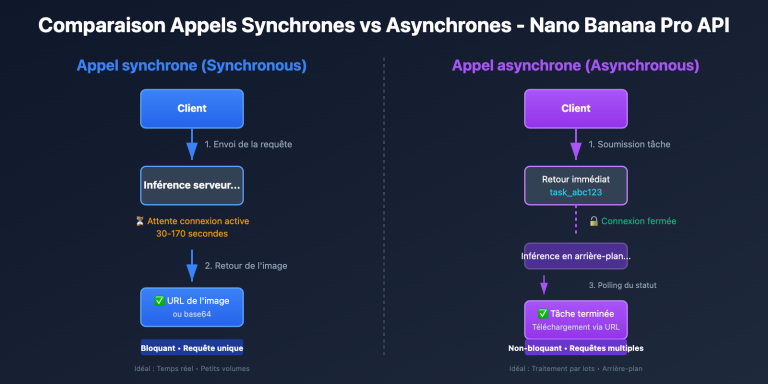
L’image ci-dessus décrit précisément la répartition du budget pour cet appel. Le texte intégral de la signification des champs est disponible dans le centre de documentation APIYI ; je vous conseille de le consulter pour vérifier les détails, histoire de ne pas modifier les paramètres de mémoire.
Contenu vide : deux manifestations possibles
Une même cause peut se traduire de deux façons au niveau de l’interface, et la documentation décrit les deux. La première : une erreur franche, avec le code empty_response, la requête étant clairement marquée comme anormale. La seconde : un « faux succès ». HTTP 200, tout semble normal, mais message.content est une chaîne vide.
La seconde est bien plus trompeuse. Le code de statut indique un succès, la durée est normale, et sans aller regarder le champ usage, on ne découvre jamais que le contenu est vide. Donc face à un « appel réussi mais contenu vide », le premier réflexe doit être de consulter usage, pas de chercher un problème réseau.
| Manifestation | Contenu retourné | Comment le repérer |
|---|---|---|
| Erreur franche | Code d’erreur empty_response |
Visible immédiatement |
| Faux succès | HTTP 200, message.content est une chaîne vide |
Il faut vérifier usage et finish_reason |
Comment confirmer la cause d’un contenu vide avec gpt-6.1-sol
Le diagnostic n’a rien de compliqué : quatre étapes suffisent, et il vaut mieux commencer par usage.
- Vérifiez si
completion_tokensetreasoning_tokenssont égaux. S’ils le sont, c’est que toute la génération est partie dans le raisonnement et que le contenu n’a reçu aucun quota. - Vérifiez si
text_tokensvaut 0. Un zéro signifie qu’aucun mot de contenu n’a été écrit : c’est la preuve la plus directe. - Vérifiez si
finish_reasonvautlength. Si c’estlengthau lieu d’une fin normale, c’est que le modèle a été coupé par la limite. - Repensez à votre réglage de
max_tokens. S’il tombe entre 200 et 500 et que la tâche demande du raisonnement, vous avez quasiment la réponse.
Une fois le diagnostic posé, inutile de perdre du temps sur une chose : réessayer à l’identique. La documentation le dit : avec la même invite et le même max_tokens, réessayer ne sert à peu près à rien. Ce n’est pas un hoquet du réseau, mais la conséquence logique de la répartition du quota — renvoyez la requête, le budget reste le même, et le raisonnement le dépensera encore en premier.
Si vous appelez gpt-6.1-sol via une plateforme d’agrégation, les points d’entrée pour le diagnostic ressemblent généralement à ceci :
- Adresse de la plateforme : APIYI apiyi.com
- URL de l’API :
https://api.apiyi.com/v1 - Nom du modèle :
gpt-6.1-sol - Spécification : compatible OpenAI, sémantique des paramètres identique à l’API officielle
Conseil : récupérez un quota de test gratuit via APIYI apiyi.com, puis comparez les réponses obtenues avec la même invite et différents
max_tokens. En quelques minutes, vous saurez si le problème vient de la répartition du quota et non du modèle lui-même.
Correction rapide du corps vide de gpt-6.1-sol : augmenter max_tokens ou réduire reasoning_effort
La cause est désormais claire, donc la solution coule de source : il n’y a que deux directions possibles. Soit on laisse de la place au corps du texte, soit on demande à la réflexion de consommer un peu moins. Ces deux solutions correspondent à des tâches différentes — ne les mélangez pas.
Solution 1 : augmenter max_tokens. Les valeurs de référence données dans la documentation : à partir de 2000 pour une conversation ordinaire, 16000 ou plus pour un raisonnement complexe ou une tâche de rédaction longue. Ces ordres de grandeur ne sont pas sortis de nulle part — le brouillon de raisonnement peut déjà être conséquent, et le corps du texte a besoin d’espace supplémentaire. Les 2000 ne sont qu’un point de départ pour une conversation ordinaire.
Solution 2 : réduire reasoning_effort. Si la tâche ne demande pas de raisonnement approfondi — une reformulation simple, une conversion de format, une question-réponse en une phrase — on peut demander au modèle de « réfléchir un peu moins ». La consommation de la phase de réflexion baisse, et le même quota suffit alors.
| Option | Mise en œuvre | Cas d’usage | Effet attendu |
|---|---|---|---|
Augmenter max_tokens |
À partir de 2000 pour une conversation ordinaire ; 16000 et plus pour un raisonnement complexe ou un texte long | Tâches qui exigent une qualité de raisonnement complète | Corrige le problème à la racine |
Réduire reasoning_effort |
Baisser l’intensité du raisonnement | Tâches légères, peu exigeantes en profondeur de raisonnement | Diminue la consommation de réflexion |
| Réessayer avec les mêmes paramètres | Renvoyer la requête sans rien changer | Quasiment inefficace | Déconseillé |
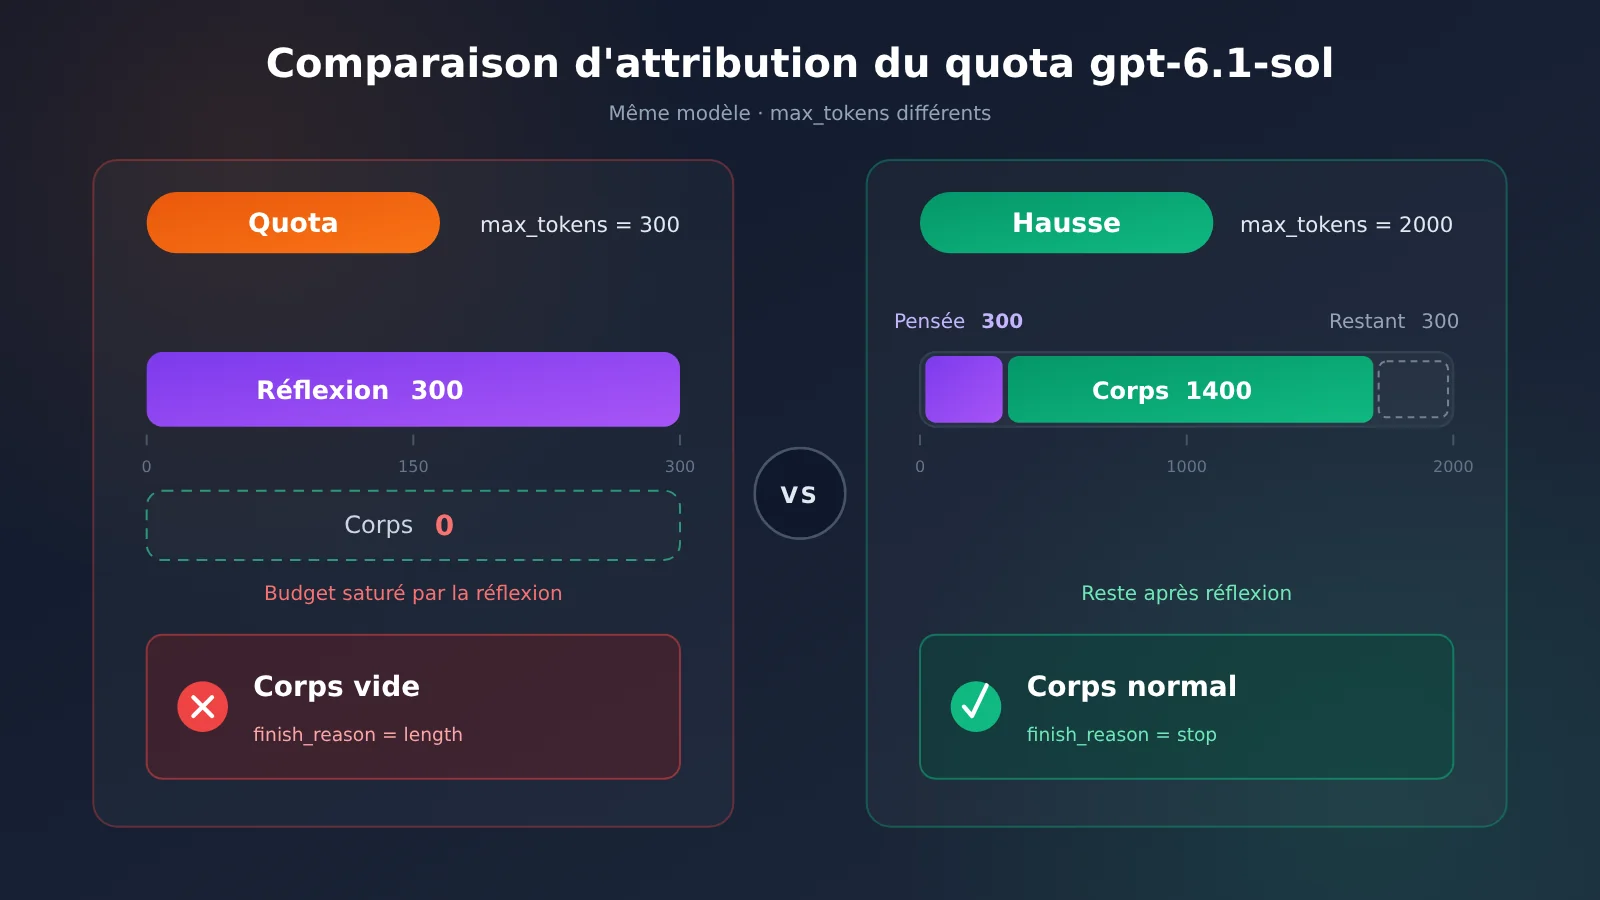
Décryptage comparatif des solutions
Augmenter max_tokens est l’option à privilégier. Elle ne change pas la façon dont le modèle réfléchit : on agrandit simplement la « feuille de brouillon », sans affecter la qualité du raisonnement. Une fois la limite relevée, la réflexion se déroule comme d’habitude et le corps du texte dispose lui aussi de son propre quota — text_tokens n’est donc plus à 0.
Réduire reasoning_effort convient à un autre type de situation : la tâche n’a pas besoin d’une réflexion poussée, mais le modèle fait quand même tourner un raisonnement complet par défaut. Après la baisse, la consommation de réflexion diminue et la réponse est plus rapide. En revanche, mieux vaut éviter ça sur les tâches complexes : une profondeur de raisonnement compressée peut dégrader la qualité de la réponse.
Réessayer avec les mêmes paramètres, on en parle à part parce que c’est la réaction erronée la plus fréquente. La documentation le note : avec la même invite et le même max_tokens, réessayer ne sert quasiment à rien — ce n’est pas une question de chance, c’est une question d’arithmétique. La différence entre les deux scénarios du schéma ci-dessus peut d’ailleurs être reproduite sur la plateforme APIYI apiyi.com avec la même invite ; deux minutes suffisent pour voir le résultat comparatif.
Augmenter max_tokens coûte-t-il plus cher ?
Beaucoup n’osent pas augmenter max_tokens par peur de faire exploser la facture. La documentation contient ici une précision essentielle : max_tokens est une limite, pas la consommation réelle — la facturation se fait sur les tokens réellement générés.
Autrement dit, passer max_tokens de 300 à 2000 ne signifie pas que chaque appel sera facturé sur la base de 2000. On compte ce que la réflexion a consommé et ce que le corps du texte a écrit, point. La partie non utilisée de la limite ne génère aucun frais. Augmenter la limite, c’est essentiellement laisser un espace vital au corps du texte, pas avancer une dépense plus importante. APIYI apiyi.com fonctionne en facturation à l’usage ; les tarifs précis sont à consulter sur la page des prix de la plateforme — cet article ne cite pas de chiffres.
FAQ sur le corps de réponse vide de gpt-6.1-sol
Q1 : Qu’est-ce que le « corps de réponse vide » de gpt-6.1-sol ?
Quand on appelle `gpt-6.1-sol`, le raisonnement et le corps de la réponse partagent le même `max_tokens`. Le raisonnement épuise le quota en premier, le corps est tronqué dans son intégralité, et le résultat est vide. Dans les chiffres documentés, les 300 `completion_tokens` sont tous des `reasoning_tokens`, et `text_tokens` vaut 0.
Q2 : Un HTTP 200 peut-il quand même être anormal ?
Oui. D’après la documentation, un corps vide se manifeste de deux façons : soit le code d’erreur `empty_response`, soit un HTTP 200 avec un `message.content` qui est une chaîne vide. Un code de statut en succès ne garantit pas un contenu normal : il faut croiser avec les `text_tokens` et le `finish_reason` présents dans le usage.
Q3 : Pourquoi réessayer ne sert-il à rien ?
D’après la documentation, avec la même invite et le même `max_tokens`, réessayer ne change quasiment rien. L’allocation du quota est déterministe : à budget constant, le raisonnement sera de toute façon consommé en premier. Pour changer le résultat, il faut toucher aux paramètres, pas à la chance.
Q4 : Le modèle n’a-t-il pas répondu ?
Ce n’est pas un refus de répondre, c’est un manque de quota pour répondre. Un `finish_reason` à `length` indique que le modèle a été stoppé par la limite, et non qu’il s’est arrêté de lui-même. En augmentant `max_tokens`, la même question obtient bien un corps de réponse.
Q5 : Quels réglages sont les plus piégeux ?
D’après la documentation, avec un `max_tokens` réglé autour de 200 à 500 et une tâche qui demande de la réflexion, le budget s’épuise dès la phase de raisonnement. Cette plage peut suffire à un modèle de chat classique, mais pour un modèle de raisonnement comme `gpt-6.1-sol`, elle ne permet souvent même pas d’écrire un brouillon.
Q6 : Comment vérifier rapidement que le correctif fonctionne ?
Je conseille de faire une vérification comparative sur APIYI apiyi.com : créez un compte pour obtenir un quota de test gratuit, renseignez l’adresse d’API `https://api.apiyi.com/v1`, choisissez le modèle `gpt-6.1-sol`, puis :
1. Avec la même invite, relancez une requête avec `max_tokens` à 2000
2. Vérifiez que `text_tokens` est supérieur à 0
3. Vérifiez que `message.content` contient bien du texte
Même plateforme, même invite : une seule variable change, et la conclusion est la plus nette.
Q7 : Augmenter max_tokens fait-il grimper la facture ?
Non, on ne paie pas sur la limite. D’après la documentation, `max_tokens` est un plafond, pas la consommation réelle : la facturation se fait sur les tokens réellement générés. Ce qui est produit (raisonnement + corps) est ce qui est facturé, et les tarifs précis sont à consulter sur la page de prix d’APIYI.
Q8 : Les modèles non-raisonnement font-ils pareil ?
D’après la documentation, non : les modèles non-raisonnement ne produisent pas de corps vide. Comme il n’y a pas de phase de raisonnement, tout le `max_tokens` est réservé au corps ; avec un petit quota, la réponse est simplement tronquée, pas entièrement vide. C’est d’ailleurs l’un des critères pour décider s’il faut changer de modèle.
Points clés à retenir sur le corps vide de gpt-6.1-sol
- Origine du corps vide : la réflexion et le texte de réponse partagent
max_tokens, et la réflexion épuise le quota en premier - Signature de diagnostic :
completion_tokenségalereasoning_tokens,text_tokensvaut 0 - Deux manifestations : le code d’erreur
empty_response, ou un HTTP 200 avec une chaîne vide - Solution privilégiée : à partir de 2000 pour une conversation normale, 16000 et plus pour un raisonnement complexe ou un texte long
- Alternative légère : réduire
reasoning_effortpour compresser la consommation de réflexion - Ne pas s’acharner : réessayer avec les mêmes paramètres ne sert quasiment à rien
- Logique de facturation :
max_tokensest un plafond, la facturation se fait sur ce qui est réellement généré
En résumé
Les points clés du corps vide de gpt-6.1-sol, avec le recul, sont en fait très clairs :
- La cause : la réflexion et le texte de réponse partagent
max_tokens; dans ce cas, ces 300 tokens sont tous desreasoning_tokens,text_tokensvaut 0 etfinish_reasonvautlength. - La correction : augmenter
max_tokens(à partir de 2000 pour une conversation normale, 16000 et plus pour un raisonnement complexe), ou réduirereasoning_effort; réessayer avec les paramètres d’origine ne donne presque rien. - La facturation :
max_tokensest un plafond, pas une consommation ; vous êtes facturé sur les tokens réellement générés, donc l’augmenter ne coûte rien de plus.
La prochaine fois que vous tomberez sur un « appel API réussi mais texte vide », commencez par regarder le champ usage, puis finish_reason : en dix secondes, vous aurez identifié le problème. Pour vérifier rapidement l’effet de la correction, je recommande de passer par APIYI apiyi.com : la plateforme offre des crédits de test gratuits et une interface unifiée pour plusieurs modèles, il suffit de changer un paramètre pour comparer immédiatement.
Références
- Centre de documentation APIYI : explication sur le corps vide des modèles de raisonnement
- Lien :
docs.apiyi.com/faq/reasoning-model-empty-response.md -
Contenu : les raisons du corps vide, les deux manifestations possibles et les solutions, telles que documentées à l’origine
-
Flash documentation APIYI : cas de corps vide avec gpt-6.1-sol (2026-11)
- Lien :
docs.apiyi.com/live/2026-11/reasoning-model-empty-response.md - Contenu : la source des chiffres de
completion_tokensà 300 et des valeurs recommandées pourmax_tokens
Auteur : équipe technique APIYI
Contact technique : n’hésitez pas à nous contacter depuis la page d’accueil du site APIYI ; pour plus de ressources, consultez le centre de documentation docs.apiyi.com