Note de l’auteur : cet article compare Gemini 4 Argon et Carbon sur l’effort de raisonnement, la vitesse de réponse et le coût par tâche, pour aider les développeurs à choisir le modèle selon la difficulté de la tâche.
Google a lancé Gemini 4 Argon le 13 octobre 2026, dévoilé Carbon pour la première fois le 28 octobre, puis ouvert Carbon aux développeurs, aux entreprises et au grand public le 10 novembre. Beaucoup de développeurs se sont immédiatement demandé si Carbon remplaçait Argon. Cet article compare les deux modèles sur 5 axes : effort de raisonnement, latence de réponse, coût par tâche, cas d’usage, niveaux de réflexion.
Ce n’est pas une analyse du type « le modèle haut de gamme est forcément meilleur ». La documentation officielle de Google pour les développeurs indique qu’Argon reste le choix recommandé pour la plupart des travaux d’ingénierie et de gestion des connaissances. Carbon vise les tâches qui exigent un raisonnement plus poussé et des cycles de vérification plus longs. Cet article s’appuie surtout sur la documentation officielle de Google. Pour les données tierces, nous indiquons la version de l’évaluation et le niveau de raisonnement utilisé.
Ce que vous allez en retirer : vous saurez quelles tâches confier à Argon, lesquelles méritent Carbon, et comment piloter qualité, vitesse et coût avec le Thinking Level.
7 termes à connaître avant de comparer Gemini 4 Argon et Carbon
Quand on compare deux modèles de raisonnement, plusieurs notions se mélangent facilement. Autant les distinguer dès maintenant pour ne pas mal interpréter les chiffres qui suivent :
- Niveau de raisonnement (Thinking Level) : le réglage qui contrôle l’effort de réflexion du modèle. Carbon propose trois niveaux : LOW, MEDIUM et HIGH.
- Tokens de réflexion : les tokens produits quand le modèle raisonne. Ils sont facturés comme des tokens de sortie.
- Coût de tâche : le coût de l’ensemble des invocations du modèle nécessaires pour accomplir une tâche. Il ne correspond pas au coût d’une seule requête.
- Latence de raisonnement : le temps écoulé entre la réception de la requête et la production du résultat. Ici, on s’intéresse surtout à la latence du premier token de la réponse.
- Lecture du cache : un mode de facturation qui réutilise un contexte d’entrée existant, à un prix bien inférieur à celui d’une entrée normale.
- Agent : un agent capable d’exécuter des tâches en plusieurs étapes à l’aide d’outils, par exemple écrire du code, lancer des tests, puis corriger les erreurs.
- Benchmark : une méthode qui évalue et compare des modèles à partir d’un ensemble de tâches fixes. Ses conclusions ne valent que pour la configuration de test utilisée.
Pourquoi Google lance à la fois Gemini 4 Argon et Carbon
D’après la fiche modèle de Carbon publiée par Google DeepMind, Gemini 4 Carbon est construit à partir de Gemini 4 Argon. Autrement dit, les deux partagent la même base : Carbon en est une version renforcée pour le raisonnement difficile, l’ingénierie logicielle complexe, les workflows d’agents de longue durée, la recherche scientifique et la défense en cybersécurité. À noter : Google n’a pas divulgué le nombre de paramètres de Carbon, ni les différences d’architecture de calcul interne entre les deux modèles. Affirmer que « Carbon est X fois plus gros qu’Argon » n’a donc aucun fondement.
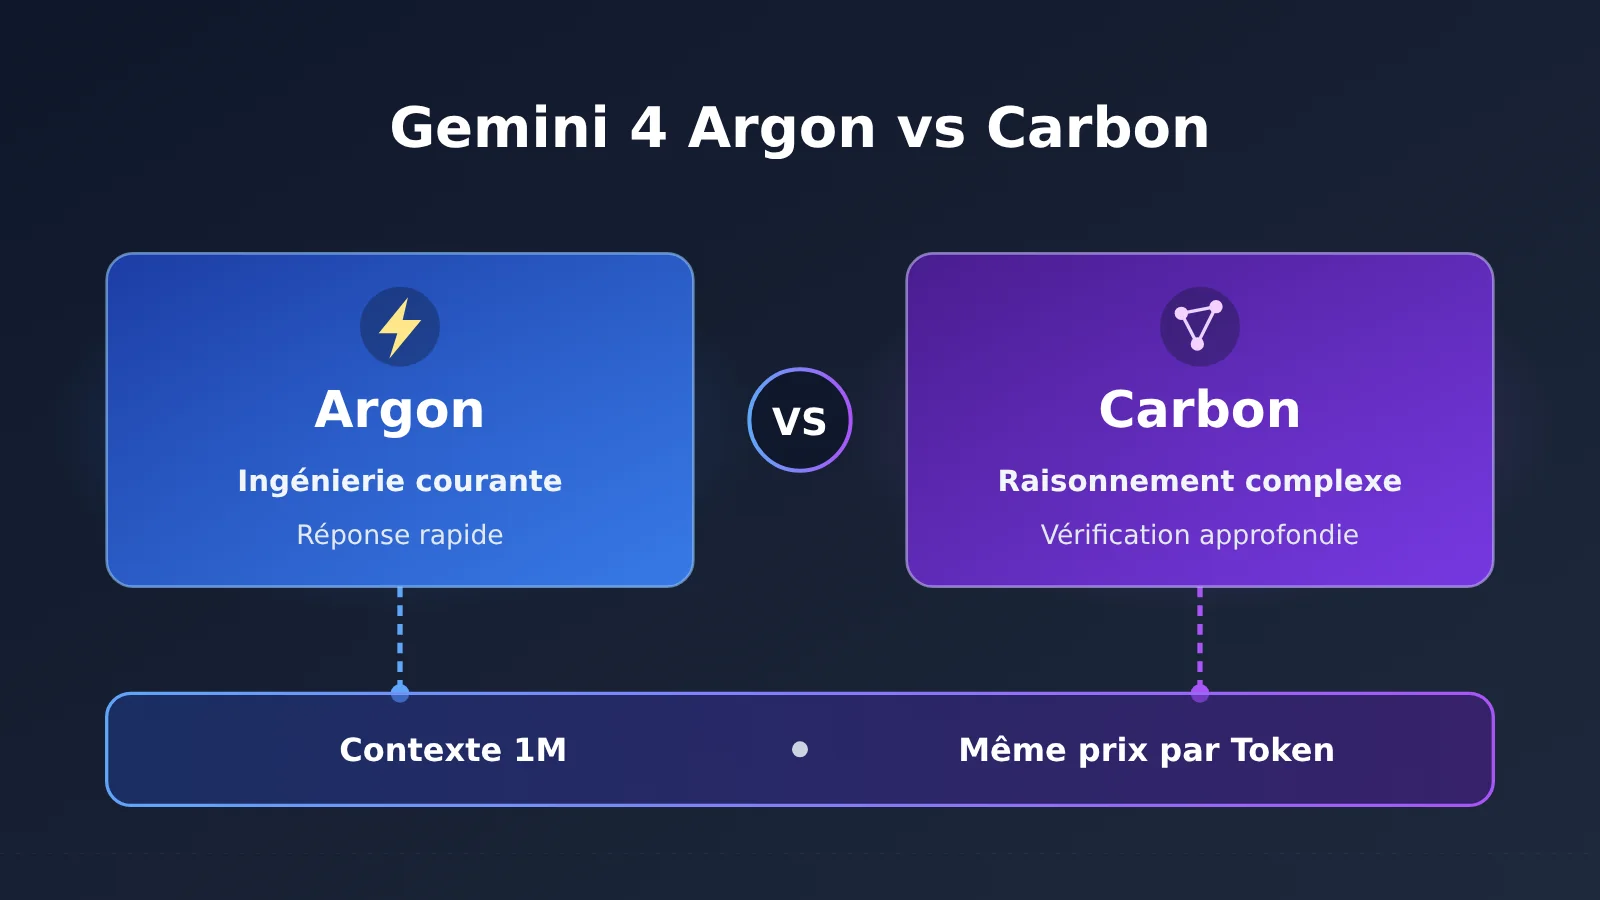
Si Carbon est plus puissant, pourquoi ne remplace-t-il pas simplement Argon ? Parce que les deux modèles répondent à des types de travail différents. Pour le développement de fonctionnalités au quotidien et les modifications de code très interactives, on privilégie la rapidité de réponse et le nombre de tokens consommés à chaque tour. À l’inverse, pour la conception d’architecture, l’enquête sur la cause racine à travers plusieurs sous-systèmes ou les preuves scientifiques, ce qui compte, c’est la capacité du modèle à formuler des hypothèses, les vérifier et se corriger à répétition. Dans la documentation pour développeurs, Google recommande d’ailleurs une répartition des rôles plutôt qu’un remplacement : Argon pour l’essentiel de l’ingénierie courante, Carbon pour les tâches de raisonnement plus difficiles et de plus longue haleine.
On retrouve cette répartition dans les produits de Google eux-mêmes. Dans la fonctionnalité multi-agents /swarm d’Antigravity (en préversion), Google conseille de confier à Carbon la conception de l’architecture globale, la coordination des tâches et la revue de sécurité, tandis que l’implémentation du code courant et les modifications de fichiers en parallèle sont déléguées à des modèles plus rapides et plus légers. Même logique côté grand public : les avantages de l’abonnement Google AI Pro portent principalement sur Argon, et seul l’abonnement Ultra inclut Carbon.
Principale différence entre Gemini 4 Argon et Carbon : l’effort de raisonnement à chaque tour
Dans la section « Choosing between Carbon and Argon » du guide développeur de Carbon, Google donne l’explication la plus directe : Carbon dépense davantage de jetons de réflexion à chaque tour pour explorer et vérifier son travail plus en profondeur, tandis qu’Argon privilégie des réponses plus rapides et une consommation de jetons plus faible par tour, ce qui convient bien à la programmation interactive et au développement de fonctionnalités au quotidien. Les deux modèles partagent la même fenêtre de contexte unifiée de 1M de jetons (1 048 576 jetons, entrée et sortie comprises), les mêmes outils intégrés et le même prix par jeton.
| Critère de comparaison | Gemini 4 Argon | Gemini 4 Carbon | Le plus adapté |
|---|---|---|---|
| Positionnement | Modèle de raisonnement généraliste, performant et efficace | Modèle de raisonnement plus approfondi pour les tâches complexes | Selon la tâche |
| Jetons de réflexion par tour | Relativement peu | Davantage à chaque tour | Argon est plus économe |
| Vitesse de réponse | Plus rapide | Plus lent sur les tâches complexes | Argon |
| Développement interactif | Plus adapté | Utilisable pour les tâches très difficiles | Argon |
| Développement de fonctionnalités au quotidien | Recommandé | Généralement inutile | Argon |
| Conception d’architecture, recherche de cause racine | Capable de s’en charger | Plus adapté aux enquêtes très complexes et approfondies | Carbon |
| Preuves scientifiques, audits de sécurité | Capable de s’en charger / pris en charge | Plus adapté au raisonnement complexe et à la vérification | Carbon |
| Contexte et prix par jeton | Contexte partagé de 1M, même prix | Contexte partagé de 1M, même prix | Égalité |
Ce tableau montre que la frontière entre Gemini 4 Argon et Carbon ne tient pas à « est-ce possible ou non », mais à « est-ce que ça vaut le coup de réfléchir plus longtemps ». Argon peut aussi s’occuper de conception d’architecture et de recherche de cause racine. Mais quand le problème devient assez complexe pour demander plusieurs cycles d’hypothèses et de vérifications, Carbon est prêt à investir davantage de jetons de réflexion pour obtenir un résultat plus fiable.
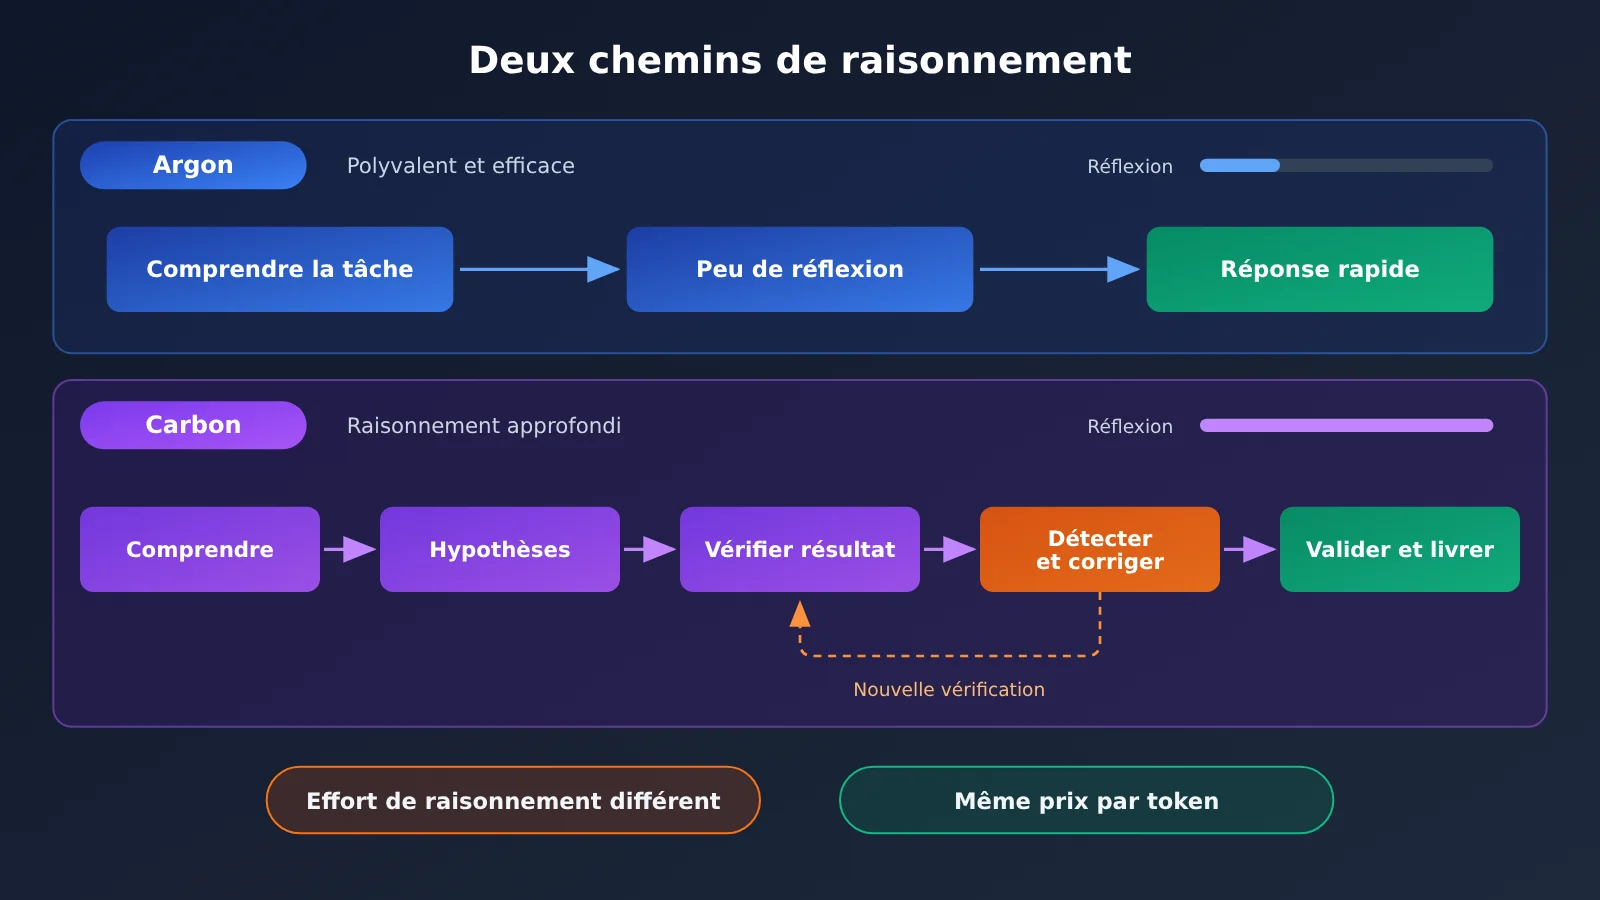
Le fonctionnement de Carbon ressemble davantage à une boucle d’exécution complète : comprendre l’objectif et les contraintes, décomposer la tâche, établir un plan, appeler les outils, vérifier les résultats intermédiaires, repérer les erreurs, corriger et revalider, puis livrer. Cette boucle lui donne l’avantage sur les tâches de longue durée, et explique aussi pourquoi le temps d’attente avant sa première réponse est plus long.
Comparaison indépendante de Gemini 4 Argon et Carbon
Les affirmations officielles ont besoin de données indépendantes pour être vérifiées. Artificial Analysis propose, dans son Intelligence Index v5.0.1, une page de comparaison directe entre Carbon et Argon. Toutes les données ci-dessous correspondent à la configuration de raisonnement High.
| Indicateur (AA v5.0.1, raisonnement High) | Carbon High | Argon High | Écart |
|---|---|---|---|
| Indice de capacité globale | 60 | 50 | Carbon +10 |
| AutomationBench-AA | 77.8% | 77.5% | Quasi à égalité |
| Terminal-Bench 4.0 | 65.2% | 57.1% | Carbon devant |
| FrontierCode 2.0 | 40.6% | 25.7% | Carbon nettement devant |
| AA-Omniscience (score de fiabilité des connaissances) | 54 | 46 | Carbon devant |
| HLE-Diamond | 69.1% | 56.7% | Carbon devant |
| Coût par tâche | $7.76 | $9.95 | Carbon moins cher |
| Durée par tâche | 25.6 minutes | 28.9 minutes | Carbon plus court |
| Latence du premier token de la réponse | environ 68 s | environ 37 s | Argon plus rapide |
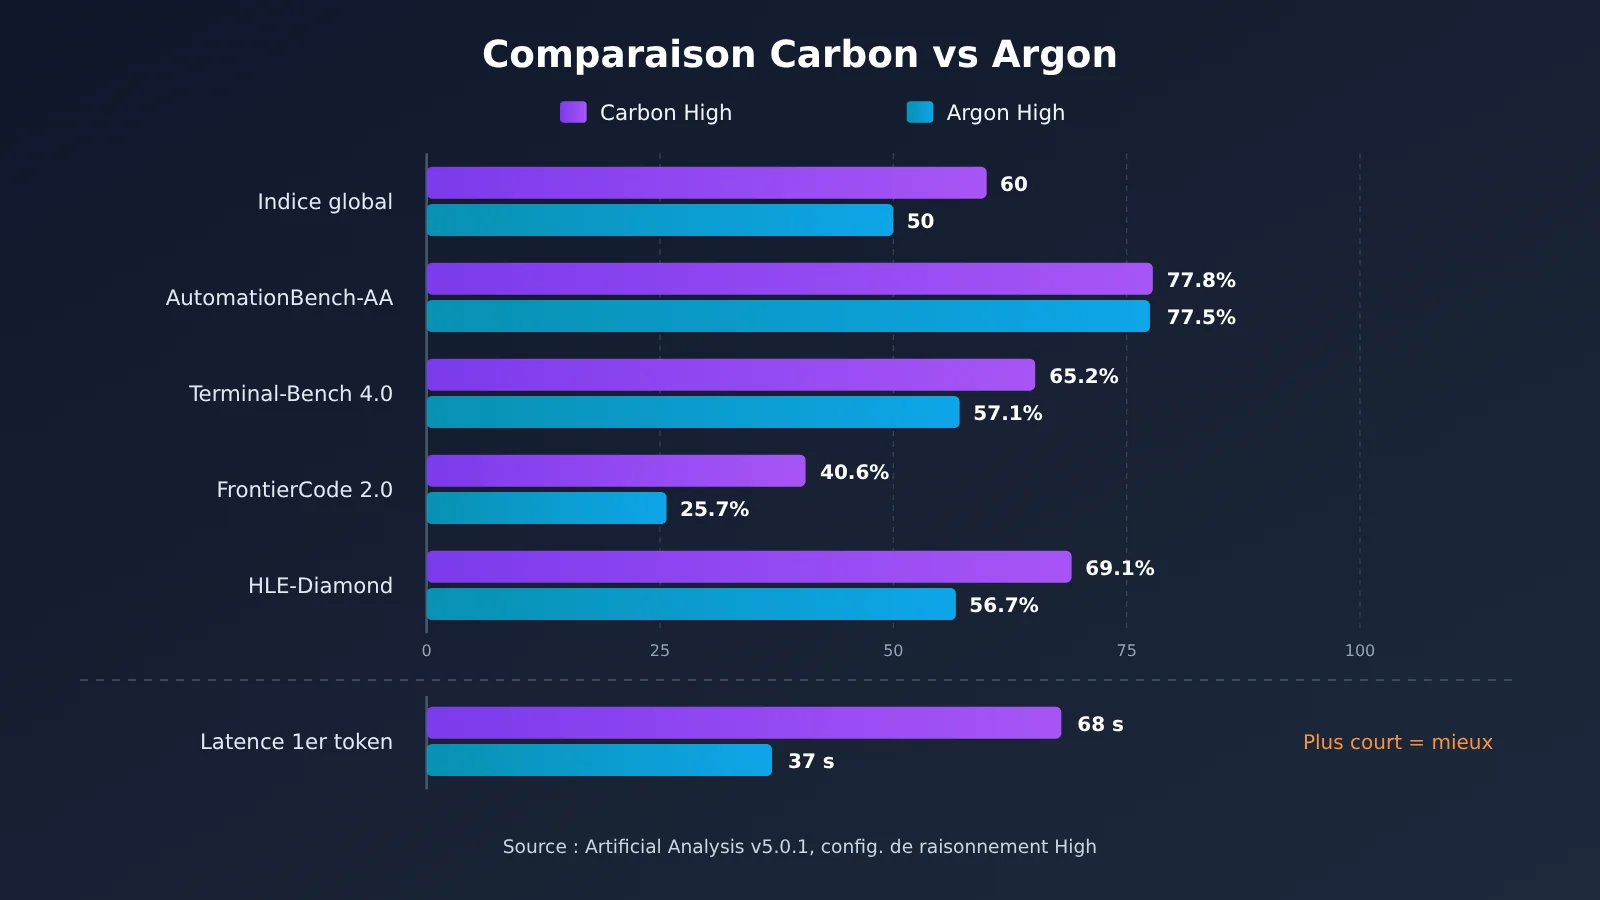
Voici les principaux enseignements :
- L’écart est le plus marqué sur l’ingénierie complexe et le raisonnement complexe : Carbon devance Argon de près de 15 points de pourcentage sur FrontierCode 2.0, d’environ 12 points sur HLE-Diamond et d’environ 8 points sur Terminal-Bench 4.0.
- Les tâches d’automatisation courantes sont presque à égalité : seulement 0.3 point d’écart sur AutomationBench-AA. Pour les tâches automatisées orientées processus, Argon suffit donc largement.
- La fiabilité des connaissances progresse : 54 contre 46 sur AA-Omniscience. La fiche du modèle publiée par Google montre aussi, sur l’Agentic Honesty Benchmark, 92 % pour Carbon contre 70 % pour Argon.
- Argon répond nettement plus vite au départ : environ 37 secondes contre environ 68 secondes. C’est le prix direct du raisonnement supplémentaire de Carbon.
La fiche officielle du modèle publiée par Google (évaluation datée d’octobre 2026, généralement en Pass@1 et avec le niveau de raisonnement le plus élevé disponible) confirme la même tendance : sur SWE-sweep, Carbon obtient 9.6 % contre 4.3 % pour Argon ; sur GraphWalks (256k–1M, BFS F1), 96.2 % contre 84.2 % ; sur Terminal-Bench Science 0.1, 64.8 % contre 52.9 %. La fiche officielle et Artificial Analysis relèvent de systèmes d’évaluation et de moments différents : mieux vaut donc ne pas mélanger leurs classements. Par ailleurs, la page du modèle Carbon indique une durée par tâche de 24.9 minutes en High, légèrement différente des 25.6 minutes de la page de comparaison. Dans cet article, le tableau comparatif s’appuie sur les données de la page de comparaison.
Les résultats de benchmarks ne disent pas tout. Dans l’évaluation MKA du travail intellectuel multimodal, lancée conjointement par Google DeepMind et Artificial Analysis, aucun modèle ne domine les 10 secteurs : Argon est en tête en sciences, Carbon en santé. Autrement dit, ce n’est pas parce que Carbon obtient un meilleur score global qu’il surpasse Argon dans chaque domaine précis.
💡 Remarque sur la comparaison : les benchmarks ne reflètent les performances que sur un ensemble de tâches figé. Pour savoir si votre cas d’usage a vraiment besoin de Carbon, le plus fiable est de lancer les deux modèles sur vos propres tâches. Avec APIYI (apiyi.com), vous pouvez passer d’un modèle à l’autre avec la même clé API et le même code compatible OpenAI, ce qui facilite les petits tests comparatifs.
Pourquoi Gemini 4 Carbon consomme plus de tokens par tour, sans forcément coûter plus cher
C’est le point le plus souvent mal compris. Gemini 4 Argon et Carbon ont le même prix par token : jusqu’au 30 novembre 2026, le tarif de lancement est de 2 $ par million de tokens en entrée et de 10 $ par million de tokens en sortie. À partir du 1er décembre, les prix passent à 4 $ et 20 $. Les tokens en entrée mis en cache bénéficient d’une réduction de 95 % par rapport au prix d’entrée. Les tokens de réflexion sont facturés comme des tokens de sortie : comme Carbon réfléchit davantage à chaque tour, la facture d’un tour est donc généralement plus élevée.
Mais la facture d’une tâche n’est pas celle d’un tour. Dans la comparaison Artificial Analysis v5.0.1 en configuration High, Carbon coûte 7,76 $ par tâche contre 9,95 $ pour Argon : Carbon revient donc environ 22 % moins cher, et finit aussi environ 3 minutes plus tôt. Une explication plausible : le coût d’une tâche complète dépend du nombre de tours nécessaires, des détours pris en route et du nombre de retours en arrière. Si Carbon réfléchit davantage au départ et fait moins d’erreurs, il y aura moins de tentatives et de tours de correction par la suite.
| Configuration (AA v5.0.1) | Score global | Coût par tâche | Durée par tâche | Latence de la première réponse |
|---|---|---|---|---|
| Carbon Low | 54 | 7,19 $ | 22,3 min | 12,37 s |
| Carbon Medium | 58 | 6,59 $ | 23,3 min | 23,16 s |
| Carbon High | 60 | 7,76 $ | 24,9 min | 67,54 s |
| Argon High | 50 | 9,95 $ | 28,9 min | environ 37 s |
Ces chiffres révèlent aussi un résultat contre-intuitif : le coût par tâche de Carbon Medium est inférieur à celui de Low. Plus le niveau de raisonnement est bas, plus chaque tour est économique, mais il peut falloir plus de tours pour terminer la tâche. Il faut toutefois bien garder en tête les limites de la comparaison :
- Ces coûts sont le coût moyen par tâche dans ce système d’évaluation, calculé au tarif standard de 4 $/20 $ ; ce n’est pas le prix d’une requête API ordinaire. Au tarif de lancement, pour la même consommation de tokens, le coût serait environ divisé par deux.
- Des durées comme 24,9 minutes sont des durées pondérées pour des tâches d’évaluation d’agents. Cela ne veut pas dire qu’une question ordinaire vous fera attendre 25 minutes.
- Les conclusions ne valent que pour l’ensemble de tâches de l’AA Index. Si vos tâches sont très simples et se règlent en un ou deux tours, l’avantage par tour d’Argon (ou d’un niveau de raisonnement plus bas) se traduira directement par une facture plus basse.
💰 Conseil budget : quand vous évaluez un modèle, notez « le total de tokens et la durée totale pour accomplir une tâche » plutôt que de comparer uniquement les prix unitaires. APIYI (apiyi.com) facture à l’usage et sa console affiche le détail de consommation de chaque appel, ce qui permet de calculer le coût réel d’Argon et de Carbon sur vos propres tâches.
Quand choisir Gemini 4 Argon, quand choisir Carbon
En croisant le positionnement officiel de Google et les données ci-dessus, on peut répartir les tâches selon leur difficulté. Le principe de base : se demander d’abord si la tâche mérite un raisonnement plus poussé, puis choisir le modèle et le niveau adaptés.
| Type de tâche | Modèle recommandé | Niveau recommandé | Justification |
|---|---|---|---|
| Développement de fonctionnalités courantes, modifications de code classiques | Argon | Par défaut ou moyen | Réponse rapide, coût par tour faible, adapté aux interactions fréquentes |
| Programmation interactive, assistance en temps réel dans l’IDE | Argon | Moyen | Latence de première réponse nettement plus faible |
| Projets complexes multi-fichiers, conception d’architecture | Carbon | HIGH | Écart net sur FrontierCode et Terminal-Bench |
| Investigation approfondie de causes racines entre sous-systèmes | Carbon | MEDIUM / HIGH | Nécessite d’explorer plusieurs hypothèses et de vérifier à plusieurs reprises |
| Raisonnement scientifique difficile, preuves formelles | Carbon | HIGH | Google classe officiellement les preuves formelles parmi les usages HIGH |
| Audit de sécurité, découverte de vulnérabilités | Carbon | HIGH | Positionnement officiel plus adapté aux audits complexes |
| Classification simple, résumé, extraction de métadonnées | Niveau de raisonnement bas | LOW | Sensible au coût, pas besoin de raisonnement approfondi |
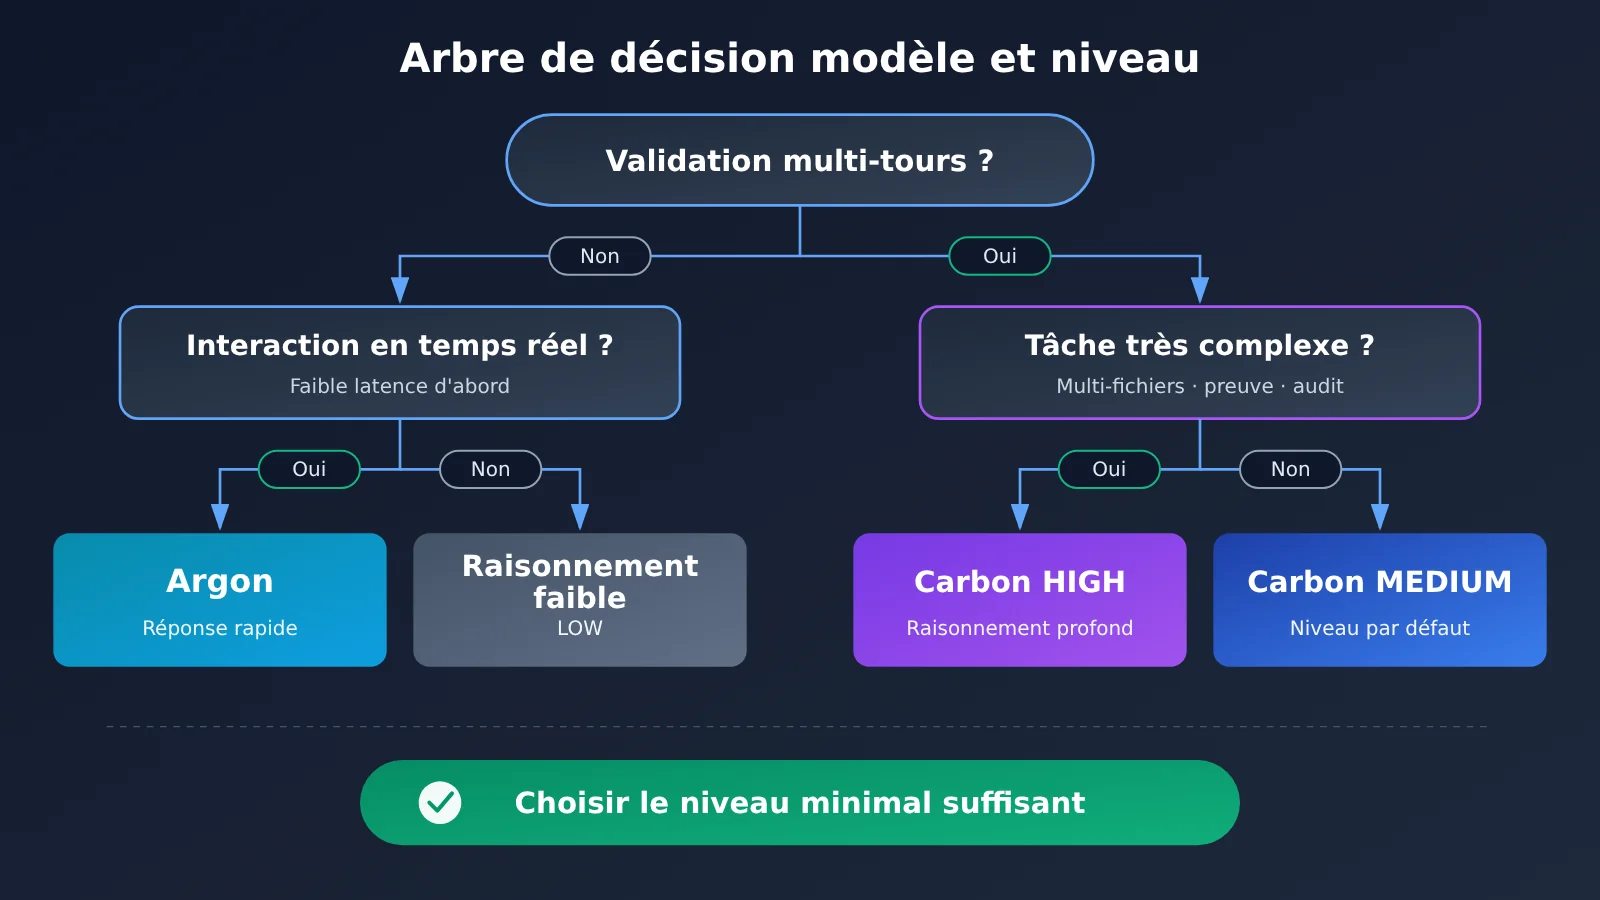
Les cas où choisir Gemini 4 Argon
- Développement avec beaucoup d’interactions : écrire une fonction, retoucher un style, ajouter des tests… attendre 37 secondes ou 68 secondes, la différence se ressent vraiment.
- Travail de connaissance courant et flux d’automatisation : sur AutomationBench-AA, les deux modèles sont quasiment à égalité, inutile de payer pour un écart qui n’existe pas.
- Travail de connaissance dans le domaine scientifique : dans l’évaluation MKA, Argon est en tête sur les sciences, c’est donc un bon premier choix à tester.
Les cas où choisir Gemini 4 Carbon
- Tâches d’agent longues exécutées en arrière-plan : la latence de première réponse importe peu, l’essentiel est de réussir du premier coup.
- Ingénierie complexe et décisions d’architecture : migrations multi-fichiers, refonte de système, audit de code complexe.
- Tâches exigeant des résultats vérifiables : raisonnement scientifique, audit de sécurité, rapports d’analyse nécessitant une auto-vérification.
Les premiers retours de la communauté confirment cette répartition. Sur Hacker News et Reddit, certains développeurs estiment que Carbon repère des problèmes que d’autres modèles ont laissé passer, tandis que d’autres se plaignent d’une attente trop longue avant la première réponse et d’une consommation rapide du quota. Un utilisateur de Reddit a utilisé Carbon Medium sur un projet Go pour migrer une bibliothèque de 230 fichiers, et la migration a fonctionné dès le premier lancement. Son auteur précise toutefois que l’échantillon ne compte que 4 étapes et que ce n’est pas une expérience contrôlée : à prendre comme simple exemple.
Comment utiliser Thinking Level pour contrôler la qualité, la vitesse et le coût de Gemini 4 Carbon
Carbon propose trois niveaux de raisonnement : LOW, MEDIUM et HIGH. Le modèle public gemini-4-carbon utilise MEDIUM par défaut. Voici les usages recommandés officiellement : LOW pour la classification, le résumé et l’extraction de métadonnées ; MEDIUM pour le code courant, l’appel d’outils, les questions-réponses sur documents et la compréhension vidéo ; HIGH pour le génie logiciel multi-fichiers, la conception d’architecture, la preuve formelle et la détection de vulnérabilités.
Ce choix de MEDIUM par défaut s’explique bien. Dans AA v5.0.1, Carbon Medium obtient un score global de 58, soit seulement 2 points de moins que High, tout en affichant le coût par tâche le plus bas et une latence de première réponse environ trois fois plus courte que celle de High. Dans le test de fiabilité factuelle AA-Omniscience, la proportion de réponses inventées de Medium est de 4,2 %, contre 11,4 % pour High et 20,0 % pour Low (il s’agit d’un indicateur propre à ce test, pas d’un taux d’hallucination général). Google recommande lui aussi aux développeurs de tester les différents niveaux et de choisir le niveau le plus bas qui satisfait vos exigences de qualité, plutôt que d’utiliser systématiquement HIGH.
Lors de l’invocation, quelques limitations techniques de Carbon sont à connaître : thinking_budget n’est pas pris en charge et renvoie une erreur HTTP 400 ; le niveau MINIMAL n’existe pas ; temperature, top_p et top_k sont ignorés ; le Context Caching explicite n’est pas pris en charge, mais un préfixe d’invite commun d’au moins 4096 tokens peut déclencher un cache implicite automatique.
Exemple minimaliste
Voici comment appeler Gemini 4 Carbon via l’interface compatible OpenAI, en une dizaine de lignes de code :
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Interface unifiée APIYI
)

response = client.chat.completions.create(
    model="gemini-4-carbon",  # L'ID du modèle dépend de la liste des modèles de la plateforme
    messages=[{"role": "user", "content": "分析这段服务超时日志的可能根因"}]
)
print(response.choices[0].message.content)
Voir le code complet : router Argon et Carbon selon la difficulté de la tâche
import time
import openai
from typing import Literal

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

# Les noms de modèles sont donnés à titre d'exemple : utilisez les ID réels de la liste des modèles de la plateforme
ARGON_MODEL = "gemini-4-argon"
CARBON_MODEL = "gemini-4-carbon"

Difficulty = Literal["simple", "daily", "complex", "extreme"]

def route(difficulty: Difficulty) -> tuple[str, str]:
    """Retourne (modèle, niveau de raisonnement) selon la difficulté de la tâche"""
    if difficulty == "simple":
        return CARBON_MODEL, "low"      # Classification, résumé, extraction de métadonnées
    if difficulty == "daily":
        return ARGON_MODEL, "medium"    # Développement courant, interactions fréquentes
    if difficulty == "complex":
        return CARBON_MODEL, "medium"   # Recherche de cause racine, tâches d'agent classiques
    return CARBON_MODEL, "high"         # Ingénierie multi-fichiers, preuves, audit de sécurité

def run_task(prompt: str, difficulty: Difficulty) -> dict:
    model, effort = route(difficulty)
    start = time.time()
    resp = client.chat.completions.create(
        model=model,
        messages=[{"role": "user", "content": prompt}],
        # Pour la correspondance du paramètre de niveau de raisonnement,
        # référez-vous à la documentation de la plateforme ;
        # Carbon ne prend pas en charge thinking_budget : le passer renvoie une erreur 400
        reasoning_effort=effort,
    )
    usage = resp.usage
    return {
        "model": model,
        "effort": effort,
        "seconds": round(time.time() - start, 1),
        "prompt_tokens": usage.prompt_tokens,
        "completion_tokens": usage.completion_tokens,  # Inclut les tokens de réflexion
        "answer": resp.choices[0].message.content,
    }

if __name__ == "__main__":
    result = run_task("为订单服务设计分库分表迁移方案,并列出验证步骤", "extreme")
    print(result["model"], result["effort"], result["seconds"], "s")
    print("输出 Token:", result["completion_tokens"])
🚀 Pour démarrer rapidement : nous vous conseillons de vous inscrire sur APIYI (apiyi.com) et de récupérer le crédit de test gratuit. Avec la fonction de routage ci-dessus, confiez le même lot de tâches réelles à Argon puis à Carbon, à différents niveaux de raisonnement, et notez la durée ainsi que
completion_tokens. Une seule clé API suffit pour toutes les comparaisons : inutile d’intégrer plusieurs SDK distincts.
Recommandations de décision : Gemini 4 Argon ou Carbon
Si vous ne deviez retenir qu’une seule règle : utilisez Argon par défaut, et passez à Carbon quand la tâche mérite vraiment de réfléchir en profondeur. Concrètement, vous pouvez procéder en trois étapes :
- Définir des règles de répartition : classez vos tâches en quatre catégories (simples, courantes, complexes, très difficiles) à l’aide du tableau des scénarios plus haut. Les tâches courantes passent par Argon par défaut.
- Comparer sur un petit échantillon : pour chaque catégorie, choisissez 10 à 20 tâches réelles et comparez Argon et Carbon, niveau par niveau, sur le taux de réussite, le nombre total de tokens et le temps total.
- Choisir le niveau selon le coût de la tâche : retenez le niveau le plus bas qui atteint votre seuil de qualité, et refaites des tests régulièrement, car les modèles, les tarifs et les classements peuvent évoluer.
Pour les systèmes multi-agents, vous pouvez aussi vous inspirer de l’approche /swarm de Google : confiez à Carbon la planification, la coordination et la relecture, et laissez Argon (ou un modèle encore plus léger) s’occuper de l’exécution en masse. Vous profitez ainsi du raisonnement poussé de Carbon, sans que chaque étape en subisse la latence.
💡 Notre conseil : les deux modèles ont le même prix par token, c’est donc la structure de vos tâches qui fera vraiment la différence. Nous vous recommandons d’utiliser l’interface compatible OpenAI sur APIYI (apiyi.com) pour accéder à Argon et à Carbon en même temps, et de basculer de l’un à l’autre via un routage dans votre code. Ainsi, quand vous ajusterez votre stratégie, vous n’aurez pas à toucher à votre code métier.
FAQ : questions fréquentes
Q1 : Quelle est la relation entre Gemini 4 Argon et Carbon ?
D’après la fiche de modèle de Google DeepMind, Gemini 4 Carbon est construit sur Gemini 4 Argon. Les deux appartiennent à la même famille de modèles de raisonnement Gemini 4 et partagent une fenêtre de contexte de 1M de tokens ainsi que des outils intégrés. Carbon consacre davantage de tokens de réflexion à chaque tour pour explorer et vérifier, tandis qu’Argon privilégie la rapidité de réponse et l’efficacité sur un tour unique. Google n’a pas communiqué le nombre de paramètres ni les différences d’architecture entre les deux.
Q2 : Carbon va-t-il remplacer complètement Argon ?
Non. Google indique clairement qu’Argon reste le choix idéal pour la plupart des tâches d’ingénierie et de travail intellectuel, alors que Carbon convient aux tâches plus difficiles et plus longues. Les chiffres le confirment : les deux modèles sont quasiment à égalité sur AutomationBench-AA, et Argon est en tête dans le domaine scientifique sur MKA. Argon reste donc compétitif dans de nombreux scénarios.
Q3 : Les deux modèles ont-ils le même prix ? Quand les tarifs changent-ils ?
La documentation développeur de Google indique que les deux modèles appliquent le même prix par token. Le tarif de lancement est de 2/10 dollars par million de tokens en entrée/sortie, valable jusqu’au 30 novembre 2026. À partir du 1er décembre, il passera à 4/20 dollars. Les tokens de réflexion sont comptés dans la sortie : à prix unitaire identique, le coût d’une tâche n’est donc pas forcément le même.
Q4 : Carbon met beaucoup de temps à donner sa première réponse. Convient-il à une application de chat ?
Pas vraiment, si vous avez de fortes exigences de temps réel. Dans AA v5.0.1, la latence avant le premier token de réponse est d’environ 68 secondes pour Carbon High, 37 secondes pour Argon High et 12 secondes pour Carbon Low. Pour les interactions en temps réel, nous recommandons Argon. Carbon est plus adapté aux analyses complexes en arrière-plan et aux tâches d’agent de longue durée.
Q5 : Comment comparer rapidement Argon et Carbon via l’API ?
Le plus simple est d’utiliser une plateforme d’agrégation d’API qui prend en charge plusieurs modèles :
1. Rendez-vous sur APIYI (apiyi.com), créez un compte et récupérez votre clé API ainsi qu’un crédit de test gratuit ;
2. Définissez `base_url` sur `https://api.apiyi.com/v1` dans votre code ;
3. Modifiez uniquement le paramètre `model` pour passer d’un modèle à l’autre, puis combinez avec les niveaux de raisonnement pour comparer.
Q6 : Peut-on utiliser Carbon sans abonnement Google AI Ultra ?
Oui. L’abonnement Ultra détermine seulement si les utilisateurs grand public (application Gemini, etc.) peuvent sélectionner Carbon directement, alors qu’AI Pro inclut principalement Argon. Les développeurs peuvent appeler Carbon via le niveau payant de l’API Gemini, sans acheter Ultra. Attention toutefois : l’API officielle de Google ne propose pas de niveau gratuit pour Carbon.
Q7 : Quelles sont les limites connues de Carbon ?
La fiche de modèle mentionne : des hallucinations toujours possibles, une consommation potentiellement très élevée de tokens aux niveaux de raisonnement élevés, des réponses parfois lentes ou des timeouts, une date limite de connaissances fixée à mars 2026, et une protection contre l’injection d’invite (prompt injection) encore à améliorer. De plus, `thinking_budget` n’est pas pris en charge et les paramètres d’échantillonnage sont ignorés : pensez à le vérifier si vous migrez du code existant.
Gemini 4 Argon et Carbon : l’essentiel à retenir (Key Takeaways)
- Positionnement : Carbon est construit sur Argon. Les deux modèles se complètent avec une vraie répartition des rôles, ce n’est pas une version haut de gamme qui en remplace une autre d’entrée de gamme.
- Différence principale : Carbon réfléchit davantage à chaque tour et vérifie plus soigneusement ses réponses. Argon répond plus vite et coûte moins cher par tour.
- Performances sur les benchmarks : avec la configuration High d’AA v5.0.1, Carbon obtient un score global de 60 points, contre 50 pour Argon.
- La vérité sur les coûts : le prix unitaire est identique. Sur les tâches AA, Carbon High revient même moins cher par tâche qu’Argon High.
- Choix du niveau : Carbon est réglé par défaut sur MEDIUM. Appliquez la règle du « niveau minimal suffisant » pour choisir entre LOW, MEDIUM et HIGH.
- Prise en main : avec APIYI (apiyi.com), un seul code compatible OpenAI permet de tester les deux modèles.
Conclusion
Les différences entre Gemini 4 Argon et Carbon se résument en trois points :
- Un effort de raisonnement différent : Argon mise sur l’efficacité, tandis que Carbon mobilise davantage de tokens de réflexion pour repousser les limites du raisonnement complexe.
- Latence et coût sont deux sujets distincts : Carbon met plus de temps à produire sa première réponse, mais, dans certaines évaluations, le coût total d’une tâche complète peut être plus bas.
- C’est la difficulté de la tâche qui décide : pour l’ingénierie courante, privilégiez Argon. Gardez Carbon pour l’ingénierie complexe, le raisonnement scientifique et les audits de sécurité.
Ne confiez pas toutes vos requêtes au niveau de raisonnement maximal. Mesurez d’abord, sur vos vraies tâches, le « niveau suffisant » pour chaque type de travail : c’est la clé pour maîtriser à la fois qualité, vitesse et coûts. Nous vous recommandons de passer par APIYI (apiyi.com) pour vérifier rapidement comment les deux modèles se comportent sur votre cas d’usage. La plateforme propose une facturation à l’usage et une interface unifiée pour de nombreux modèles.
📚 Références
- Gemini 4 Carbon Model Card : fiche officielle du modèle publiée par Google DeepMind
- Lien :
deepmind.google/models/model-cards/gemini-4-carbon -
Description : Carbon est construit sur Argon ; on y trouve les spécifications de contexte, les évaluations officielles et les limites connues
-
Choosing between Carbon and Argon : documentation développeur de Google AI Studio
- Lien :
aistudio.google.com/docs/whats-new-gemini-4-carbon -
Description : les différences de positionnement officielles entre les deux modèles et des conseils pour choisir le Thinking Level
-
Gemini 4 Carbon Developer Guide : guide développeur de Google Cloud
- Lien :
docs.cloud.google.cn/gemini-enterprise-agent-platform/models/guides/gemini-4-carbon -
Description : niveaux de raisonnement, limites des paramètres de l’API et explications sur le décodage long
-
Tarification de l’API Gemini : Google AI for Developers
- Lien :
ai.google.dev/gemini-api/docs/pricing -
Description : prix de lancement, ajustement tarifaire de décembre, règles de facturation du cache et des tokens de réflexion
-
Gemini 4 Carbon vs Gemini 4 Argon : page de comparaison d’Artificial Analysis
- Lien :
artificialanalysis.ai/zh/models/comparisons/gemini-4-carbon-vs-gemini-4-argon -
Description : comparaison des capacités, des coûts et de la latence avec la configuration High de l’AA Index v5.0.1
-
Évaluation MKA des tâches de travail intellectuel multimodal : Artificial Analysis
- Lien :
artificialanalysis.ai/zh/evaluations/mka - Description : modèles en tête par secteur et données de coût par tâche
Auteur : l’équipe technique d’APIYI
Échanges techniques : n’hésitez pas à nous contacter depuis la page d’accueil du site APIYI. Pour plus de ressources sur l’intégration des modèles, consultez le centre de documentation docs.apiyi.com