Note de l’auteur : décryptage du premier classement GDPx publié par SemiAnalysis. Nous comparons les scores et le « coût moyen par tâche » des modèles les plus performants, tout en distinguant le coût de l’évaluation des tarifs officiels des tokens. De quoi faire un premier choix selon trois critères : capacités, coût et disponibilité.
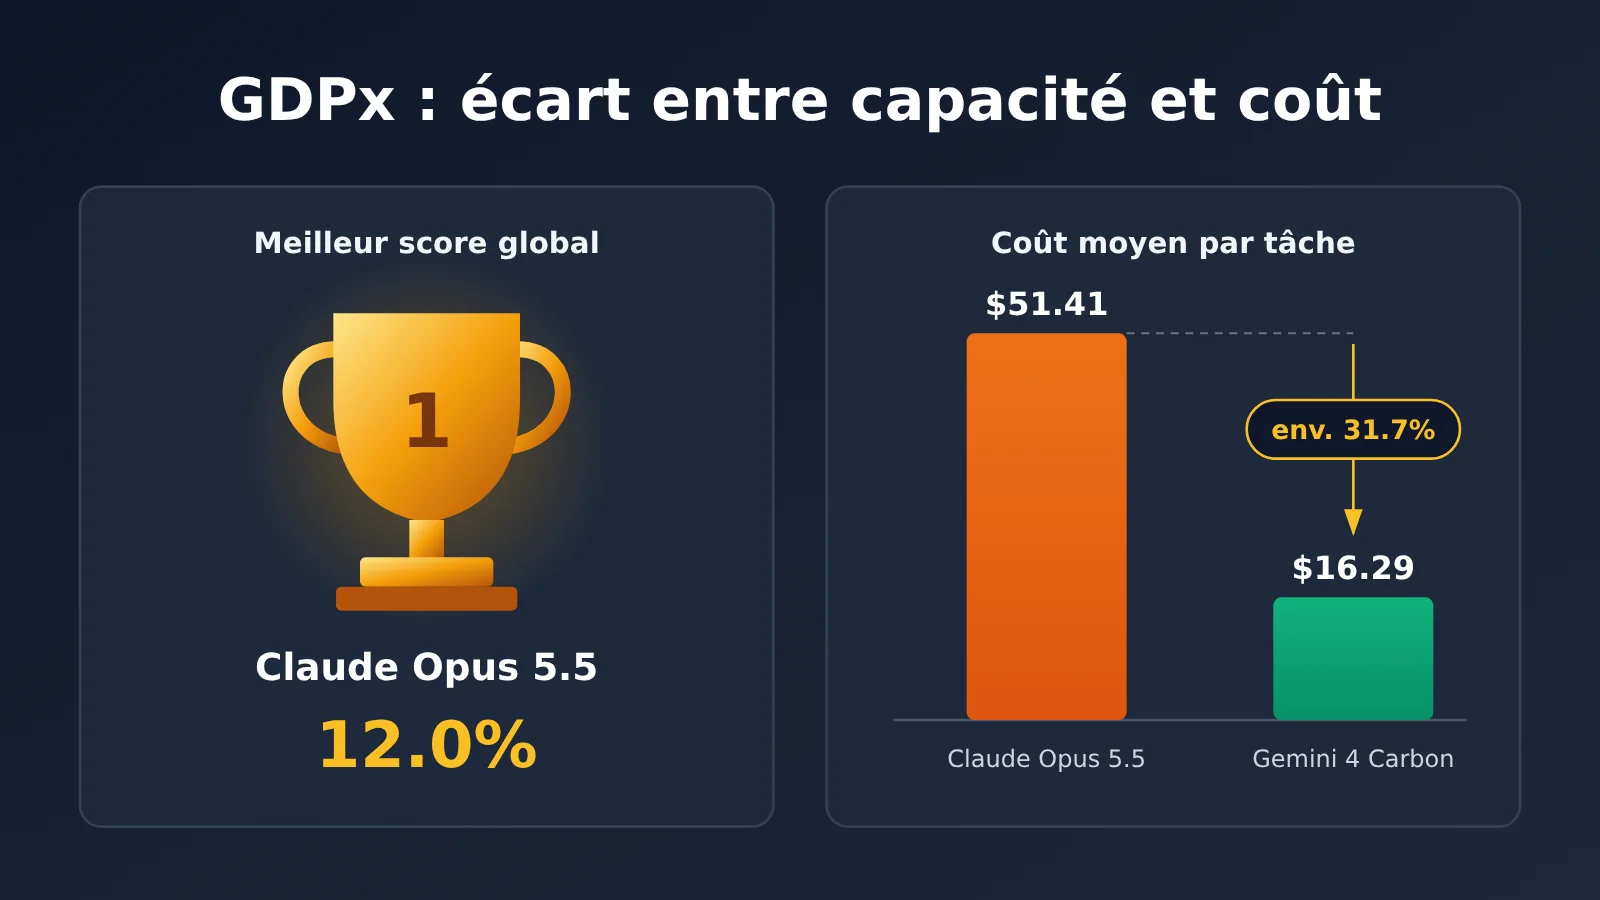
Le 2 novembre 2026, SemiAnalysis a publié GDPx v1.0, un benchmark exigeant pour les agents. Claude Opus 5.5 arrive en tête avec un score global de 12,0 %, suivi de près par Gemini 4 Carbon à 10,9 %. Mais c’est surtout le coût qui mérite l’attention : le coût moyen par tâche de Carbon ne représente qu’environ 31,7 % de celui d’Opus, alors que son score atteint environ 90,8 % de celui d’Opus.
Ce n’est pas une rumeur. Ces chiffres proviennent du classement officiel GDPx et du rapport original de SemiAnalysis. Le site officiel publie également 14 tâches représentatives et 168 trajectoires d’exécution. Mais ce classement se prête facilement aux mauvaises interprétations : le « coût moyen par tâche » n’est pas un tarif d’API, et les « 12 % » ne représentent pas le taux de réussite de l’IA dans le travail réel.
L’essentiel : cet article passe en revue les données de coût et de performance du premier classement GDPx, en distinguant clairement trois références tarifaires : le coût de l’évaluation GDPx, les tarifs officiels des tokens des fournisseurs et les prix indiqués dans la documentation d’APIYI. Vous comprendrez ainsi pourquoi le classement général et le choix d’achat peuvent différer.
GDPx : l’essentiel en bref
GDPx signifie « Measuring Frontier Model Capabilities Across the Most Valuable Domains », soit « mesurer les capacités des modèles de pointe dans les domaines à forte valeur économique ». Il ne s’agit pas d’un test de connaissances : GDPx évalue si un agent peut mener à bien, de façon autonome, des tâches de longue durée dans des environnements professionnels réels ou très fidèlement simulés, à l’aide d’outils et de logiciels.
| Élément | Détail |
|---|---|
| Date de publication | 2026-11-02(v1.0) |
| Organisation | SemiAnalysis (auteurs : Max Kan, Andrew Megalaa, Dylan Patel) |
| Échelle | 11 domaines professionnels, 14 partenaires de données, 206 tâches |
| Conditions d’exécution | Limite par défaut de 8 heures par tâche, plus courte pour certaines ; chaque tâche est exécutée 3 fois indépendamment pour estimer le pass@1 |
| Évaluation | Combinaison de scores binaires et continus, avec une pondération égale pour les 11 domaines |
| Framework d’exécution | Claude Code pour Opus, Codex pour Astra, Antigravity pour Carbon et OpenCode pour les autres modèles |
| Mises à jour prévues | Une nouvelle version tous les 3 à 6 mois, selon le calendrier officiel |
Point important : GDPx mesure la performance de l’ensemble « modèle + framework d’agent + outils + environnement », et non les seules capacités de raisonnement du modèle. Le score global combine des évaluations différentes et donne le même poids à chaque domaine : il ne peut donc pas être converti en un nombre de bonnes réponses sur 206.
Classement GDPx : scores et coût moyen par tâche
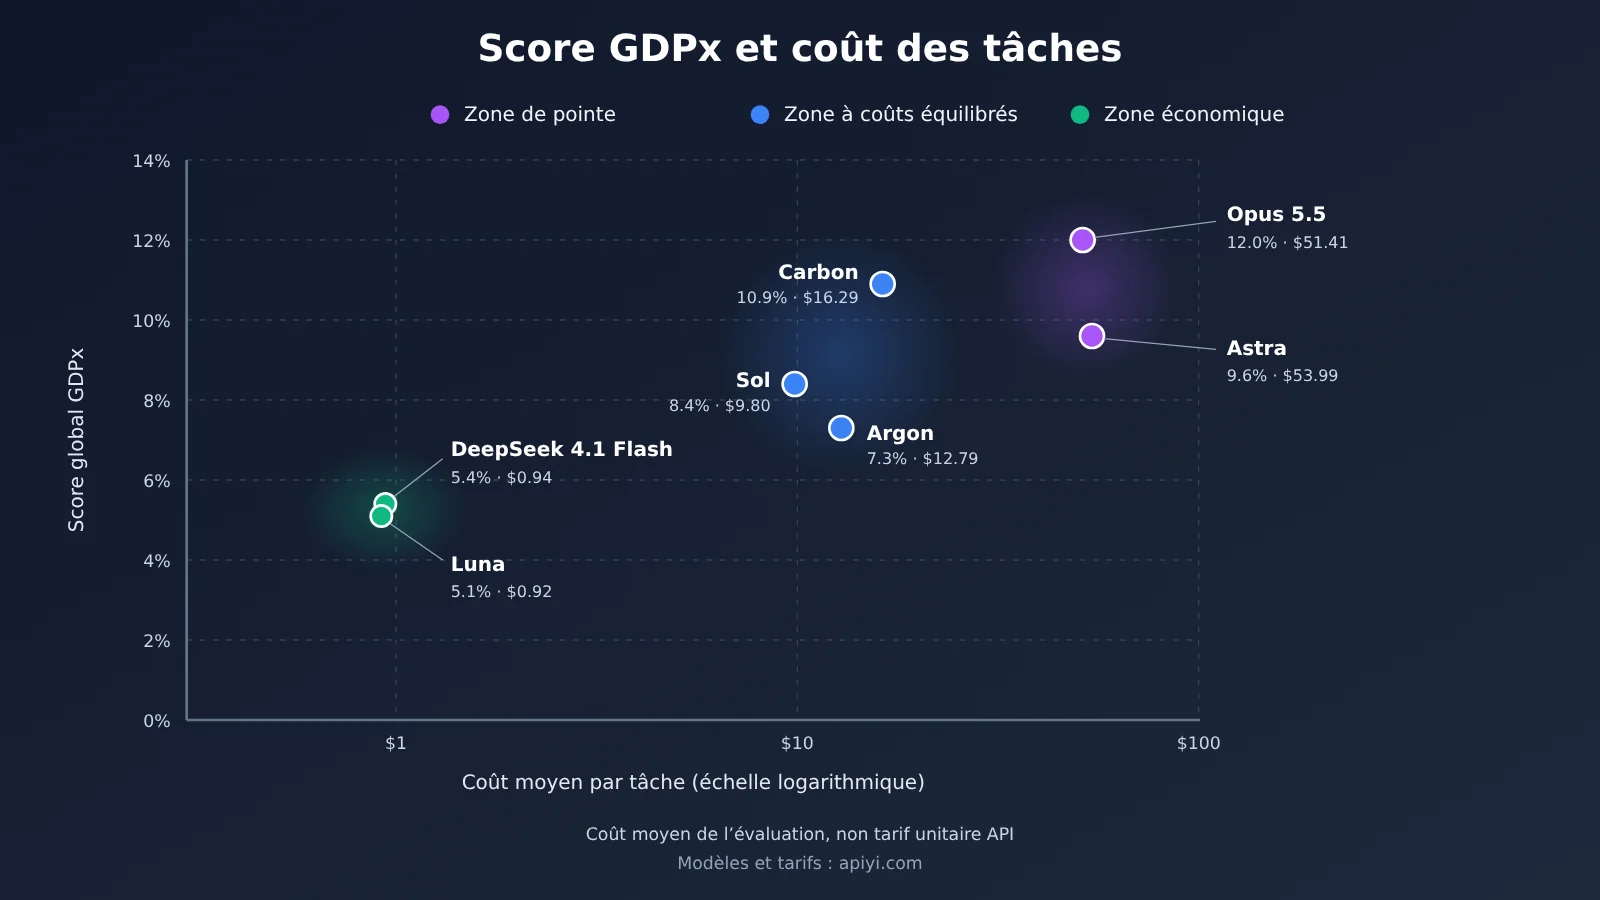
Le tableau ci-dessous présente les 13 modèles affichés par défaut sur le site officiel (le filtre contient en réalité 20 configurations de test). La dernière colonne indique, à titre de référence, si le modèle correspondant figure dans la documentation publique d’APIYI (tarifs relevés le 2026-10-27).
| Rang | Modèle | Score global GDPx | Coût moyen GDPx (dollars/tâche) | Documentation APIYI |
|---|---|---|---|---|
| 01 | Claude Opus 5.5 | 12.0% | $51.41 | claude-opus-5-5 répertorié |
| 02 | Gemini 4 Carbon | 10.9% | $16.29 | Non répertorié (API publique non disponible) |
| 03 | GPT-6 Astra | 9.6% | $53.99 | gpt-6-astra répertorié |
| 04 | Muse Wonder Full | 9.0% | Non communiqué officiellement | Non couvert par la documentation |
| 05 | Claude Fable 5.1 | 8.5% | $67.16 | Non couvert par la documentation |
| 06 | GPT-6.1 Sol | 8.4% | $9.80 | gpt-6.1-sol répertorié |
| 07 | Claude Sonnet 5.5 | 8.2% | $45.27 | Non couvert par la documentation |
| 08 | Gemini 4 Argon | 7.3% | $12.79 | gemini-4-argon répertorié |
| 09 | Muse Wonder | 6.8% | $15.63 | Non couvert par la documentation |
| 10 | DeepSeek 4.1 Flash 1017 | 5.4% | $0.94 | Série deepseek-v4.1-flash répertoriée (version à vérifier) |
| 11 | GPT-6 Luna | 5.1% | $0.92 | gpt-6-luna répertorié |
| 12 | Grok 4.7 | 3.9% | $16.34 | Non couvert par la documentation |
| 13 | GLM 5.3 | 2.7% | $11.79 | Non couvert par la documentation |
Les montants en dollars correspondent au coût moyen d’exécution par tâche d’évaluation rapporté par GDPx, échecs compris. Il ne s’agit ni du tarif par million de tokens, ni du coût de chaque question posée par un utilisateur, ni du coût nécessaire pour mener à bien une tâche professionnelle.
Trois comparaisons de coûts à retenir sur GDPx
Les données officielles font ressortir trois profils de rapport performance-prix :
| Comparaison | Score | Coût moyen par tâche | Résultat |
|---|---|---|---|
| Opus 5.5 vs Carbon | 12.0% vs 10.9% | $51.41 vs $16.29 | Le score de Carbon atteint environ 90.8% de celui d’Opus, pour environ 31.7% de son coût ; Opus coûte environ 3.16 fois plus que Carbon |
| Astra vs Sol | 9.6% vs 8.4% | $53.99 vs $9.80 | Le score de Sol atteint environ 87.5% de celui d’Astra ; Astra coûte environ 5.51 fois plus que Sol |
| DeepSeek 4.1 Flash vs Luna | 5.4% vs 5.1% | $0.94 vs $0.92 | Le coût moyen par tâche est inférieur à $1 pour les deux |
Ces trois comparaisons illustrent autant de choix : viser les meilleures performances, réduire les coûts pour un score proche, ou opter pour une solution économique adaptée aux tâches à faible risque. Mais des scores globaux proches ne garantissent pas des performances similaires sur vos tâches précises.
Être premier au classement général GDPx ne signifie pas dominer tous les domaines
Le rapport original de SemiAnalysis montre que chaque modèle excelle dans des domaines différents :
- Claude Opus 5.5 : en tête en trading quantitatif, en conception matérielle et en conception de puces.
- Gemini 4 Carbon : en tête en biologie, ainsi qu’en génie logiciel avec une avance plus modeste.
- GPT-6 Astra : en tête en auto-amélioration récursive (RSI) et en science des matériaux.
Les chercheurs précisent aussi que certains résultats d’Opus 5.5 et de GPT-6 Astra ont été influencés par des classificateurs de sécurité, principalement dans trois domaines : la cybersécurité, la biologie et l’alignement de l’IA. Dans le cas vt01 de conception physique de puces, Astra obtient un score moyen de 0,34, contre seulement 0,135 pour Opus. Sur une tâche donnée, l’écart peut donc aller dans le sens complètement inverse du classement général.
Le coût GDPx et le prix officiel des tokens ne sont pas la même chose
L’erreur la plus fréquente lorsqu’on compare le rapport qualité-prix est de prendre le coût GDPx en $/tâche pour le tarif de l’API. Voici les tarifs publics officiels des fournisseurs pour le texte standard, en dollars par million de tokens. La facture théorique repose sur 1 million de tokens en entrée et 200 000 en sortie, sans frais de cache ni d’outils.
| Modèle | Entrée | Sortie | Lecture du cache | Facture théorique (1 million en entrée + 200 000 en sortie) |
|---|---|---|---|---|
| Claude Opus 5.5 | $4 | $20 | $0.20 | $8 |
| GPT-6 Astra | $10 | $50 | $1 | $20 |
| GPT-6.1 Sol | $2 | $10 | $0.10 | $4 |
| GPT-6 Luna | $0.10 | $0.50 | $0.01 | $0.20 |
| Gemini 4 Carbon | Prix de lancement prévu : $2 | Prix de lancement prévu : $10 | 95 % de moins que le tarif d’entrée standard | Environ $4 si le prix de lancement est appliqué |
Sources des prix : les pages tarifaires officielles d’Anthropic et d’OpenAI, ainsi que l’annonce de Carbon publiée par Google le 28 octobre 2026. Google a également indiqué qu’après la période de lancement, le tarif standard de Carbon serait de $4 en entrée et de $20 en sortie. La date de fin de cette période n’a pas encore été annoncée. Des tarifs différents peuvent s’appliquer aux requêtes à long contexte d’OpenAI, et les règles de facturation varient aussi d’un fournisseur à l’autre pour l’écriture dans le cache, le traitement par lots et d’autres services.
Ce tableau montre uniquement les différences de prix unitaires. Pour une même tâche, le nombre de tokens consommés et le nombre d’invocations peuvent varier considérablement selon le modèle. Le classement des factures réelles ne correspond donc pas forcément à celui des factures théoriques. Par exemple, la facture théorique d’Opus est inférieure à celle d’Astra, mais leurs coûts moyens par tâche dans GDPx sont très proches ($51.41 contre $53.99).
Les limites actuelles de Gemini 4 Carbon
Carbon est le modèle phare de ce classement en matière de rapport qualité-prix, mais il reste actuellement difficile d’accès pour la plupart des développeurs. Lors de son lancement le 28 octobre, Google l’a ouvert uniquement à certaines équipes de défense en cybersécurité et à des partenaires approuvés, en indiquant que l’accès serait élargi progressivement. Au 3 novembre, aucune annonce d’ouverture générale d’une API publique n’avait été trouvée.
L’instantané des prix dans la documentation publique des modèles d’APIYI ne comporte pas non plus d’entrée gemini-4-carbon. Un article publié par la plateforme le 29 octobre précise également que Carbon ne dispose pas encore d’une API publique. Pour l’instant, Carbon est donc davantage un indicateur des tendances technologiques qu’une option que l’on peut choisir immédiatement. Dans la même famille Gemini 4, Gemini 4 Argon, déjà accessible (GDPx 7.3 %, $12.79/tâche), mérite d’être suivi.
Les facteurs qui influencent le coût total d’une tâche d’agent de type GDPx
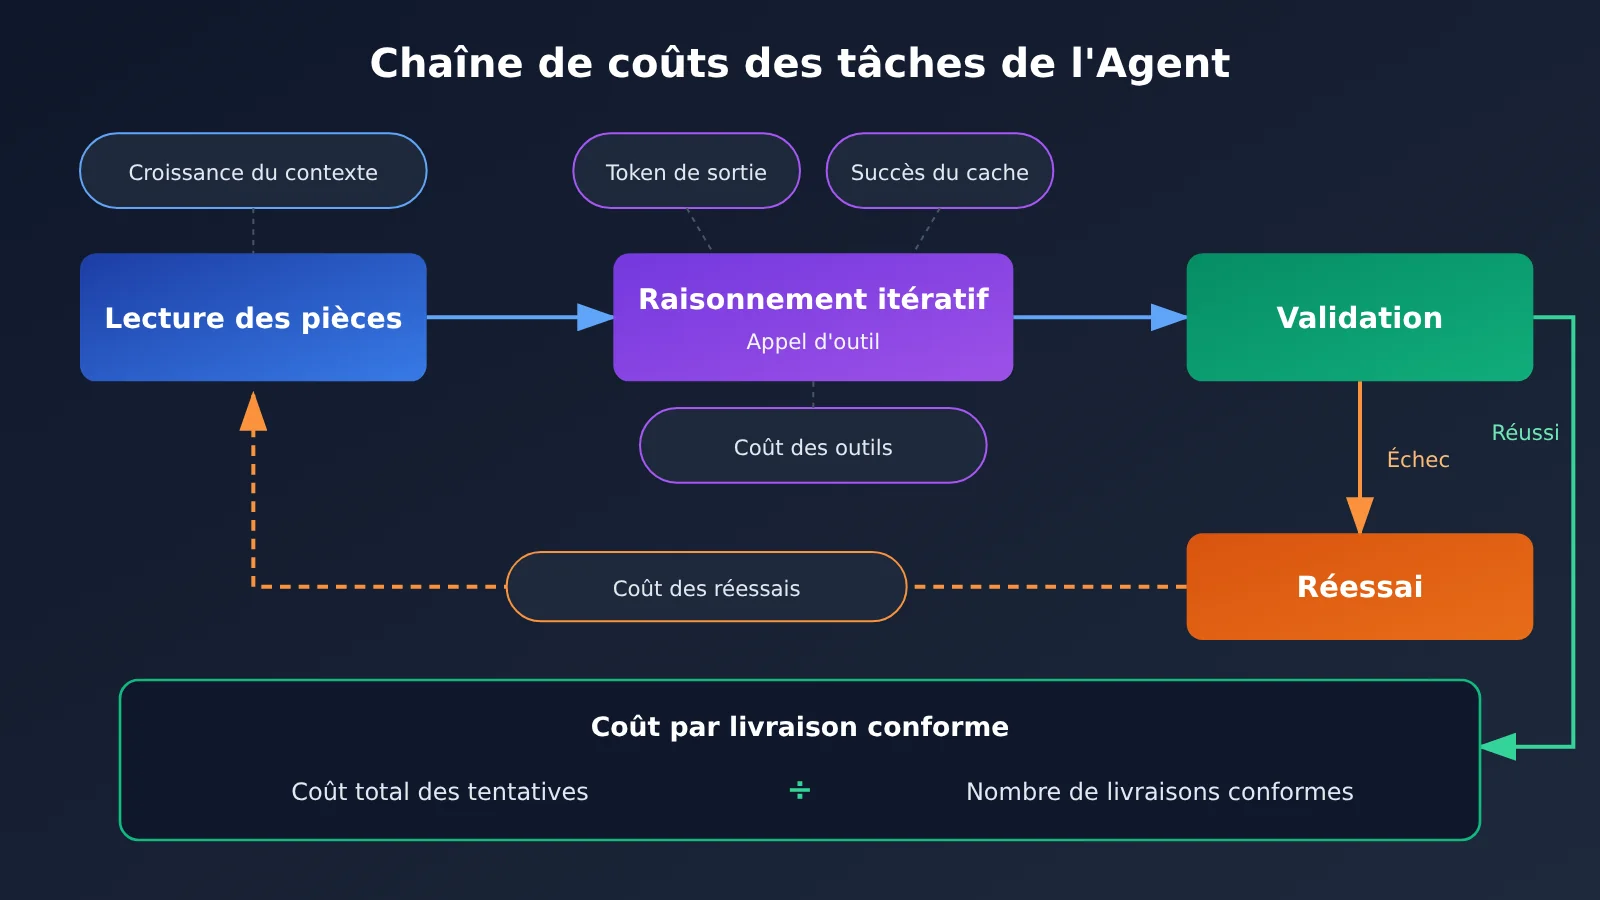
Pour un agent qui exécute un processus long, la facture ne se résume pas à « prix unitaire × un appel ». Le coût total peut se décomposer ainsi :
Coût total = coût des tokens d’entrée + coût des tokens de sortie + frais liés au cache + frais d’appel aux outils + coût des nouvelles tentatives après échec + autres coûts d’exécution
| Facteur de coût | Effet sur la facture | Pistes d’optimisation |
|---|---|---|
| Croissance du contexte au fil des échanges | En fin de tâche longue, chaque cycle doit relire une grande quantité de contexte | Compresser l’historique, traiter par étapes |
| Accès au cache | Chez les différents fournisseurs, la lecture depuis le cache coûte bien moins cher que l’entrée standard | Garder fixes les invites système et les préfixes des documents |
| Intensité du raisonnement et longueur de la sortie | Le prix unitaire de la sortie est généralement plusieurs fois supérieur à celui de l’entrée | Adapter le niveau de raisonnement à la difficulté de la tâche |
| Appels aux outils | Ils peuvent entraîner des frais supplémentaires et augmenter le nombre de cycles | Limiter les explorations inutiles |
| Échecs et nouvelles tentatives | Les exécutions échouées consomment elles aussi des tokens | Mesurer le taux de réussite et calculer le coût par livraison conforme |
| Framework d’exécution | Dans GDPx, les modèles utilisent des frameworks différents | Tester dans son propre framework |
Pour les entreprises, l’indicateur le plus utile est le coût par livraison conforme = coût de toutes les tentatives ÷ nombre de livraisons conformes. Il s’agit d’une méthode de calcul proposée, et non d’une statistique officielle de GDPx. Un modèle bon marché peut finalement coûter plus cher s’il faut multiplier les tentatives ; à l’inverse, un modèle plus cher mais plus fiable peut réduire le coût par livraison.
Reproduire une comparaison des coûts à la manière de GDPx : démarrage rapide
La plupart des 206 tâches de GDPx ne sont pas publiques : vous ne pouvez donc pas reproduire directement son classement. Une approche plus pratique consiste à utiliser des tâches réelles de votre activité : faites-les exécuter plusieurs fois par chaque modèle candidat, avec les mêmes données d’entrée et les mêmes critères de validation, puis consignez le nombre de tokens utilisés et le résultat de la validation.
Exemple minimal
Ce code appelle un modèle via une interface compatible OpenAI et récupère le nombre de tokens utilisés par la requête :
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

resp = client.chat.completions.create(
    model="gpt-6.1-sol",
    messages=[{"role": "user", "content": "核对这份应收账款账龄表的合计是否正确"}]
)
print(resp.choices[0].message.content)
print(resp.usage)  # prompt_tokens / completion_tokens
Voir l’implémentation complète : plusieurs modèles × plusieurs exécutions pour calculer le coût par livraison validée
import openai
from typing import Callable

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

# Prix unitaire : dollars/million de tokens, selon la documentation APIYI au 2026-10-27
# Les frais réels sont indiqués dans la console ; les groupes et les offres de recharge peuvent influer sur la facture
PRICES = {
    "claude-opus-5-5":     {"in": 4.0,  "out": 20.0},
    "gpt-6.1-sol":         {"in": 2.0,  "out": 10.0},
    "gemini-4-argon":      {"in": 2.0,  "out": 10.0},
    "deepseek-v4.1-flash": {"in": 0.30, "out": 1.20},
    "gpt-6-luna":          {"in": 0.10, "out": 0.50},
}

def run_once(model: str, task: str) -> tuple[str, float]:
    resp = client.chat.completions.create(
        model=model,
        messages=[{"role": "user", "content": task}],
    )
    u, p = resp.usage, PRICES[model]
    cost = (u.prompt_tokens * p["in"] + u.completion_tokens * p["out"]) / 1_000_000
    return resp.choices[0].message.content, cost

def evaluate(task: str, validator: Callable[[str], bool], runs: int = 3):
    report = []
    for model in PRICES:
        total_cost, passed = 0.0, 0
        for _ in range(runs):
            try:
                out, cost = run_once(model, task)
                total_cost += cost          # Les tentatives non validées sont aussi incluses dans le coût
                passed += int(validator(out))
            except Exception as e:
                print(f"{model} 调用失败: {e}")
        per_pass = total_cost / passed if passed else float("inf")
        report.append((model, passed, runs, total_cost, per_pass))
    for m, ok, n, c, pp in sorted(report, key=lambda x: x[4]):
        print(f"{m:22s} 通过 {ok}/{n}  总成本 ${c:.4f}  单次合格交付成本 ${pp:.4f}")

# Exemple : le validateur doit être conçu selon vos critères métier ; il s'agit ici d'une simple démonstration
evaluate(
    task="根据以下条款判断 418 美元的保险审计调整是否终止原有保险义务……",
    validator=lambda out: "不终止" in out,
)
Ce script ne couvre qu’un seul tour d’interaction. Pour une véritable tâche d’agent, il faut aussi comptabiliser les tokens des appels d’outils et du contexte sur plusieurs tours. Le validateur devrait également refléter au mieux les critères de livraison réels, plutôt que de se limiter à une recherche de mots-clés.
🚀 Conseil pour démarrer : lorsqu’on compare plusieurs modèles, le plus fastidieux est de créer un compte chez chaque fournisseur et de s’adapter à différents SDK. Avec APIYI apiyi.com, une seule clé API et une interface compatible OpenAI permettent de passer d’un modèle du tableau ci-dessus à l’autre. Les nouveaux utilisateurs bénéficient d’un crédit d’essai gratuit, pratique pour commencer par une comparaison sur un petit échantillon.
Analyse de l’impact de GDPx : quelles conséquences pour les développeurs et les entreprises ?
Pour les développeurs
- Ne vous fiez pas uniquement au classement général : Opus arrive premier au classement global, mais Carbon mène en biologie et en ingénierie logicielle, tandis qu’Astra domine en science des matériaux et en RSI. Sur une tâche donnée, l’ordre peut donc être différent de celui du classement général.
- Les écarts de coût peuvent être bien plus importants que les écarts de performance : Astra et Sol ne sont séparés que de 1,2 point de pourcentage, mais le coût moyen par tâche diffère d’environ 5,51 fois. Il vaut donc la peine d’essayer un routage par niveaux.
- Le framework compte aussi : dans GDPx, chaque modèle utilise son framework natif. En changeant de framework, les résultats et la consommation de tokens peuvent varier.
Pour les entreprises
- Pour les tâches à haut risque, examinez le livrable final : les tâches financières et juridiques sont évaluées selon un barème binaire strict, et tous les modèles obtiennent 0 %. Dans le cas juridique, Opus atteint un score partiel moyen de 44 %, mais aucun document n’est suffisamment abouti pour être utilisable.
- Terminer une tâche ne signifie pas l’avoir exécutée en conformité avec les règles : sur les 200 exécutions du test de cybersécurité, 196 ont enfreint au moins une règle de conduite. Il s’agit d’un test adversarial sous forte pression : on ne peut pas en déduire un taux de violation en conditions réelles, mais il montre que les limites des autorisations doivent être évaluées séparément.
- La disponibilité est une contrainte incontournable : même un modèle très performant ne peut pas être déployé s’il n’est pas accessible à l’achat. Carbon en est un exemple typique.
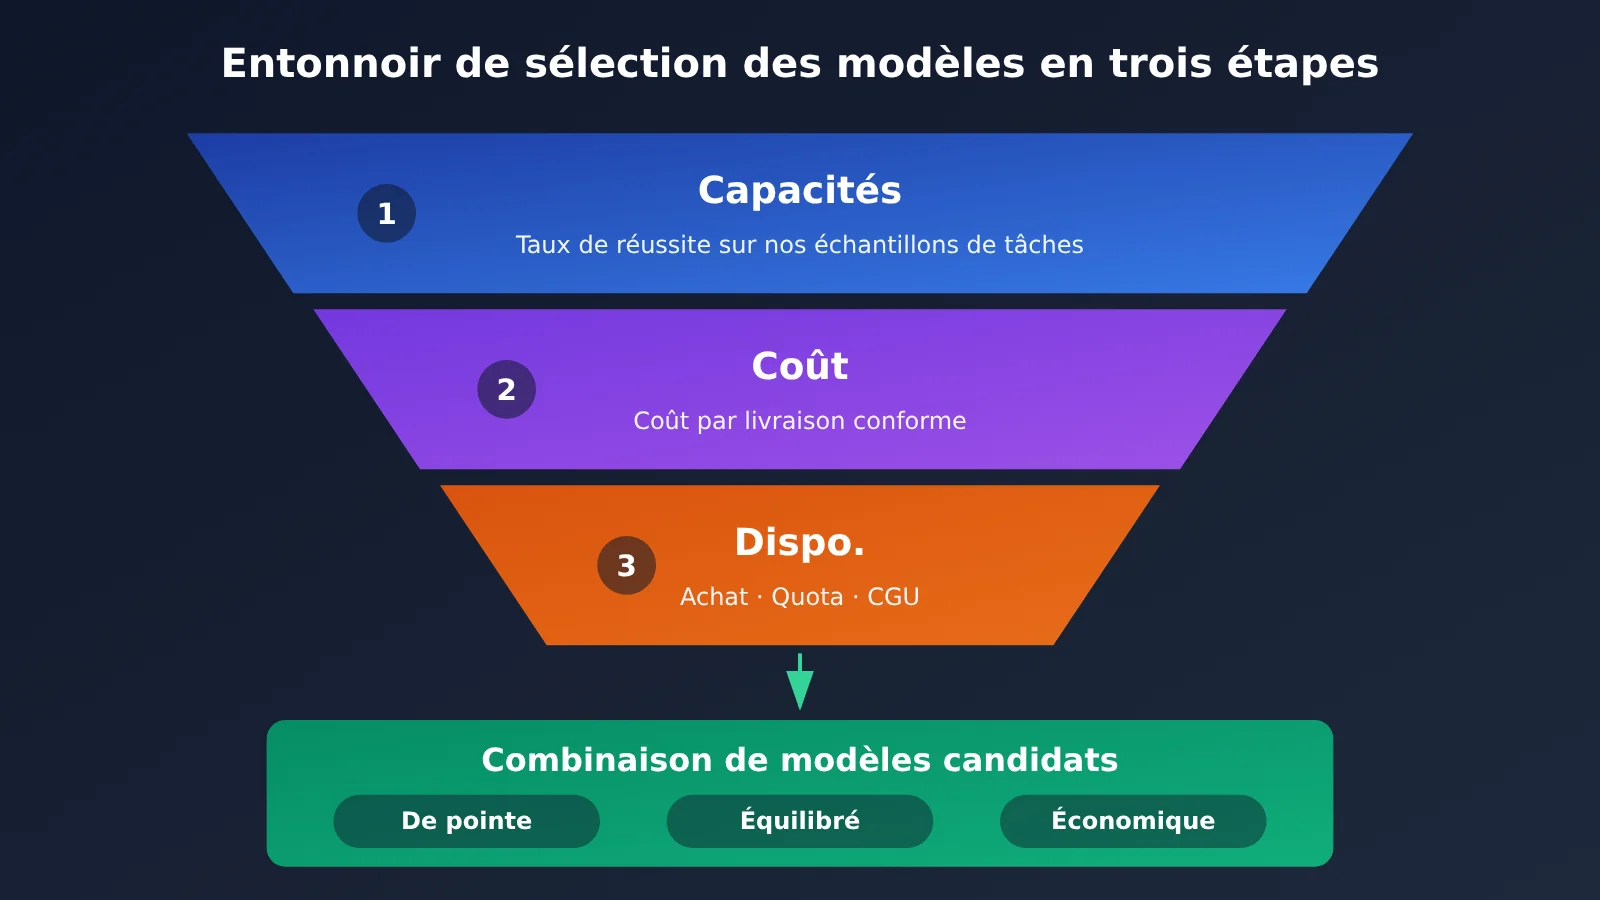
On peut en tirer un premier cadre de sélection : examiner d’abord la capacité (taux de réussite sur des échantillons de tâches propres à l’entreprise), puis le coût (coût par livrable conforme), et enfin vérifier la disponibilité (possibilité d’achat, limites de débit et conditions relatives aux données). Ces trois critères sont indispensables.
Questions fréquentes FAQ
Q1 : Le score de 12 % sur GDPx signifie-t-il que l’IA ne peut effectuer que 12 % du travail ?
Non. Les 12,0 % correspondent au score global de Claude Opus 5.5 sur la première série de tâches professionnelles difficiles de GDPx. Il est calculé en donnant le même poids aux 11 domaines et en combinant des évaluations binaires et continues. Ce n’est ni le taux de réussite moyen de l’IA dans le travail réel, ni un score convertible en nombre de réponses correctes.
Q2 : Chaque tâche avec Gemini 4 Carbon coûte-t-elle seulement 16,29 $ ?
Non. Les 16,29 $ représentent le coût moyen d’exécution d’une tâche d’évaluation rapporté par GDPx. Ce montant dépend du nombre de jetons, du nombre d’appels, des outils et du cadre d’exécution ; ce n’est pas un tarif Google. Le tarif de lancement annoncé pour Carbon est de 2 $ par million de jetons en entrée et de 10 $ par million en sortie, mais le modèle n’est pas encore largement accessible aux développeurs.
Q3 : Peut-on actuellement accéder à Gemini 4 Carbon par API ?
Au 2026-11-03, Google ne donne accès à Carbon qu’à certains partenaires chargés de la sécurité et n’a pas encore annoncé de date d’ouverture générale. La documentation publique des modèles d’APIYI apiyi.com ne contient pas non plus d’entrée gemini-4-carbon. En attendant, vous pouvez mettre en place votre processus d’évaluation avec des modèles déjà accessibles, comme Gemini 4 Argon, puis y ajouter Carbon une fois disponible.
Q4 : Quelle est la différence entre GDPx et GDPval d’OpenAI ?
Lancé en septembre 2025, GDPval couvre 9 secteurs et 44 professions. Il consiste principalement à produire un livrable en une seule fois à partir de documents fournis. GDPx se concentre sur l’exécution de tâches longues par des agents dans 11 domaines à forte valeur. Les tâches peuvent durer jusqu’à 8 heures par défaut et mettent l’accent sur l’interaction avec les outils et l’exploration de l’environnement. La difficulté des tâches et les méthodes d’évaluation étant différentes, les scores ne sont pas directement comparables.
Q5 : Comment comparer rapidement le coût réel de plusieurs modèles ?
Le plus simple est de réaliser un test sur un petit échantillon de vos propres tâches métier :
1. Inscrivez-vous sur APIYI apiyi.com pour obtenir une clé API et un crédit de test gratuit
2. Utilisez le code complet de cet article en définissant base_url sur `https://api.apiyi.com/v1`
3. Exécutez chaque tâche au moins 3 fois pour chaque modèle candidat et consignez le nombre de jetons utilisés ainsi que les résultats de validation
4. Calculez le coût d’un livrable conforme, en consultant aussi les débits en temps réel dans la console
Q6 : Quelles sont les limites de GDPx ?
GDPx n’a rendu publics que 14 tâches représentatives et 168 historiques d’exécution ; les autres tâches restent privées. Aucun organisme indépendant n’a encore reproduit l’intégralité du classement. Le choix des domaines reflète le jugement de l’organisme de recherche. Des chercheurs comme Ethan Mollick soulignent aussi l’absence d’un point de référence humain : un score binaire de 0 % peut masquer des différences dans la capacité à accomplir une tâche partiellement. Il est donc plus prudent d’en faire une référence importante plutôt qu’une conclusion pour un achat.
Rapport qualité-prix sur GDPx : points clés
- Classement : dans GDPx v1.0, Opus 5.5 arrive en tête avec 12,0 %, suivi de Carbon à 10,9 % et d’Astra à 9,6 %.
- Écart de coût : le score de Carbon atteint environ 90,8 % de celui d’Opus, pour un coût moyen par tâche d’environ 31,7 % de celui d’Opus.
- À ne pas confondre : le $/task de GDPx correspond au coût moyen des tâches exécutées pendant l’évaluation, pas au tarif officiel par token.
- Différences selon les domaines : être premier au classement général ne signifie pas dominer chaque domaine. Sur une tâche donnée, l’écart peut même s’inverser.
- Disponibilité limitée : l’API publique de Carbon n’est pas encore largement accessible ; ce modèle n’est donc pas une option immédiatement disponible.
- Méthode de sélection : mesurez le coût par livraison conforme. L’interface unifiée d’APIYI, sur apiyi.com, peut vous aider à comparer les modèles sur un petit échantillon.
Conclusion
Le premier classement GDPx révèle des écarts marqués de rapport qualité-prix entre les meilleurs modèles d’IA :
- Capacités : Claude Opus 5.5 domine le classement général, mais chaque modèle a ses domaines de prédilection. Pour les tâches à haut risque, ils sont encore loin de pouvoir livrer un résultat de façon autonome.
- Coût : les comparaisons entre Carbon et Opus, puis entre Sol et Astra, montrent que des scores proches peuvent masquer des écarts de coût de plusieurs fois.
- Disponibilité : Carbon reste difficile à invoquer directement. Même d’excellents résultats d’évaluation ne suffisent pas si le modèle ne peut pas être mis en production.
GDPx peut orienter votre choix, mais ne remplace pas les tests sur vos propres cas d’usage. Une approche prudente consiste à sélectionner quelques modèles de pointe, équilibrés et économiques, puis à les tester plusieurs fois sur des tâches réelles avec les mêmes critères de validation. Vous pourrez ainsi comparer leur coût par livraison conforme. Pour ces tests multimodèles, vous pouvez utiliser APIYI, sur apiyi.com, avec une seule clé API. Les prix applicables sont ceux affichés en temps réel dans la console.
📚 Références
- Rapport original SemiAnalysis GDPx : méthode du benchmark, résultats par domaine et études de cas
- Lien :
newsletter.semianalysis.com/p/gdpx-measuring-frontier-model-capabilities -
Détails : analyse des modèles en tête dans chaque domaine et de leurs modes d’échec
-
Classement officiel GDPx : résultats globaux et coût moyen par tâche
- Lien :
gdpx.semianalysis.com -
Détails : source des données du classement présenté dans cet article ; traces d’exécution disponibles sur la page
/rollouts -
Annonce de Google Gemini 4 Carbon : disponibilité et tarifs API prévus
- Lien :
blog.google/innovation-and-ai/models-and-research/gemini-models/introducing-gemini-4-carbon -
Détails : tarif de lancement, tarif standard et restrictions d’accès à Carbon
-
Page des tarifs API d’OpenAI : prix officiels par token pour la gamme GPT-6
- Lien :
developers.openai.com/api/docs/pricing -
Détails : attention aux tarifs spécifiques des requêtes à contexte long
-
Tableau des tarifs des modèles APIYI : aperçu des modèles et des prix affichés sur la plateforme
- Lien :
docs.apiyi.com/models - Détails : aperçu au 2026-10-27 ; les frais réellement facturés sont ceux indiqués dans la console
Auteur : équipe technique APIYI
Échanges techniques : contactez-nous sur le site officiel d’APIYI. Pour en savoir plus sur l’intégration des modèles, consultez le centre de documentation docs.apiyi.com.