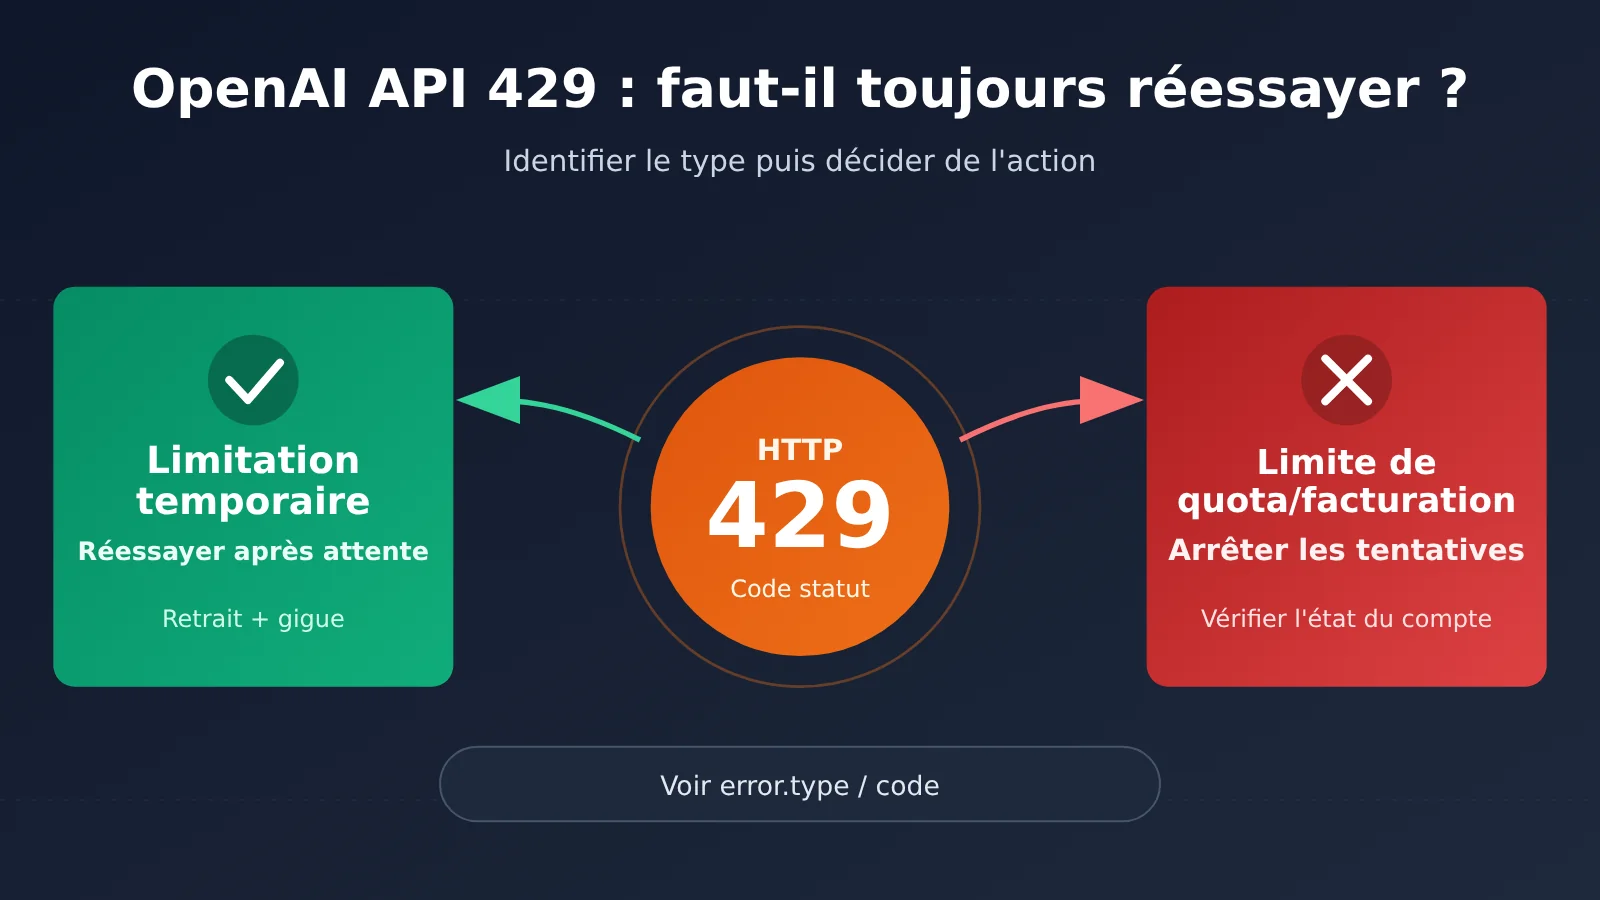
Il ne faut pas réessayer sans fin. Un code 429 renvoyé par l’API OpenAI ne signifie pas « attendez un peu, ça va passer ». Seules les limitations de débit temporaires méritent qu’on attende avant de réessayer. Quand le quota est épuisé, qu’il y a une anomalie de facturation ou une restriction d’usage au niveau de l’organisation, réessayer ne rétablit rien : vous risquez surtout de boucher la file d’attente.
La bonne démarche : commencez par examiner le message d’erreur, error.type et, s’il est présent, error.code, pour savoir à quelle catégorie de 429 vous avez affaire. S’il s’agit d’une limitation temporaire, attendez selon un Retry-After valide s’il y en a un ; sinon, appliquez un backoff exponentiel avec gigue aléatoire, en fixant une limite au nombre de tentatives.
Qu’allez-vous retenir de cet article ?
- Quelles sont les grandes catégories de 429 renvoyées par l’API OpenAI, et comment traiter chacune d’elles.
- Quel est le lien entre
Retry-After, le backoff exponentiel et la gigue aléatoire, et quand utiliser l’un ou l’autre. - Pourquoi l’empilement du retry automatique du SDK officiel, d’une file de tâches et d’un bouton « Réessayer » manuel amplifie les 429.
- Les solutions diffèrent selon que le goulet d’étranglement vient du nombre de requêtes ou des tokens, ainsi que les précautions à prendre lorsqu’une requête en streaming échoue en cours de route.
Index : Avant le corps de l’article, un tableau des concepts et un aperçu des impacts vous aident à harmoniser le vocabulaire et à repérer les parties qui vous concernent. La section « Faits objectifs » rassemble ce que la documentation officielle OpenAI dit des 429 : classification des erreurs, règles de retry et comportement du SDK. La section « Analyse et jugement » aborde la mise en œuvre terrain : adapter la stratégie au type de goulet d’étranglement, concevoir les états d’une file d’attente, diagnostiquer l’empilement des retries, et les différences de sémantique à surveiller lors d’une migration vers une autre passerelle.
À savoir : les concepts à comprendre pour l’erreur 429 de l’API OpenAI
| Concept | Explication courte |
|---|---|
| HTTP 429 | Code de statut « Too Many Requests ». L’API OpenAI l’utilise pour signaler une limitation de débit, mais aussi pour les limites de quota ou d’usage |
| Limitation de débit (Rate Limit) | Plafond du nombre de requêtes qu’on peut lancer sur une période donnée. OpenAI compte séparément le nombre de requêtes et le volume de tokens |
| RPM / TPM | Requêtes par minute et tokens par minute. Atteindre le plafond de l’un ou de l’autre peut déclencher un 429 |
error.type / error.code |
Champs structurés dans le corps de la réponse d’erreur ; ils permettent de distinguer la cause précise d’un 429, ce qui est plus fiable que le seul code de statut |
| Retry-After | Champ d’en-tête de réponse indiquant au bout de combien de temps le serveur conseille de réessayer. Quand la valeur est valide, c’est elle qu’il faut suivre en priorité |
| Backoff exponentiel (Exponential Backoff) | Après chaque échec, le temps d’attente augmente par multiples, par exemple 1 s, 2 s, 4 s, avec un plafond défini |
| Jitter | Ajouter une part d’aléatoire au temps d’attente pour éviter qu’un grand nombre de clients réessaient tous au même moment |
| Sortie en streaming (Streaming) | Le modèle renvoie le contenu au fur et à mesure qu’il le génère. Une fois la sortie commencée, une erreur en cours de route empêche de simplement rejouer la requête en entier |
| Cumul des tentatives | Le SDK, la file d’attente métier et les actions manuelles de l’utilisateur réessaient chacun de leur côté, ce qui multiplie le volume réel de requêtes |
Aperçu des impacts : ce que signifie une erreur 429 de l’API OpenAI selon le rôle
| Rôle | Impact principal | Points à surveiller |
|---|---|---|
| Développeur backend | Une logique de nouvelle tentative mal écrite transforme une limitation passagère en panne persistante | Distinguer les types de 429 et centraliser les tentatives dans une seule couche |
| Responsable des tâches batch et de données | Les tâches en gros volume heurtent facilement les deux limites en même temps : nombre de requêtes et tokens | Rythme de soumission, taille du contexte, conception de l’état de la file d’attente |
| Produit et front-end | Un utilisateur qui clique plusieurs fois sur « Réessayer » génère encore de nouveaux 429 | Indiquer à l’utilisateur quand réessayer, ou préciser qu’il s’agit d’un problème de compte |
| Ops et gestionnaires de compte | Les 429 liés au quota ou à la facturation ne se réparent pas tout seuls via le code | Détecter et traiter rapidement l’état du compte, plutôt que de laisser tourner les tentatives automatiques |
Faits objectifs : comment la documentation officielle d’OpenAI décrit le 429
Cette section s’appuie sur les documents maintenus publiquement par OpenAI : le guide des codes d’erreur, le guide des limites de débit et l’article du centre d’aide consacré au diagnostic des 429. La vérification a été effectuée le 2026-11-17. Il s’agit de documents de maintenance mis à jour en continu ; nous ne pouvons pas vérifier quand leur contenu a été publié pour la première fois. Nous ne les traitons donc pas comme une actualité du jour, mais comme une description des règles actuellement en vigueur.
Les différentes origines des erreurs 429 de l’API OpenAI
La position de fond de la documentation officielle est la suivante : un même 429 peut avoir des significations différentes. Il faut se baser sur le message d’erreur, error.type et, si disponible, error.code pour trancher. Une limitation de taux temporaire, une limite de quota, de facturation ou d’utilisation au niveau de l’organisation ne se traitent pas de la même manière.
Dans le premier cas, il s’agit de « trop de requêtes, ou trop rapidement, dans la fenêtre actuelle » : il suffit d’attendre que la fenêtre se rafraîchisse pour que ça reparte. Dans le second, c’est l’état du compte lui-même qui est en cause : quota épuisé, problème de paiement, plafond d’utilisation au niveau de l’organisation. Ce genre de problème ne disparaît pas avec le temps.
| Type de 429 | Signaux typiques | Attendre suffit-il ? | Action recommandée |
|---|---|---|---|
| Limitation sur le nombre de requêtes | Le message d’erreur pointe vers un plafond de requêtes, code souvent rate_limit_exceeded |
Généralement oui | Respecter Retry-After, ou utiliser un backoff exponentiel avec jitter |
| Limitation sur le volume de tokens | Le message d’erreur pointe vers un plafond de tokens | Généralement oui, mais facilement réenclenché | Réduire le nombre de tokens par requête en même temps que le backoff |
| Limite de quota/facturation/organisation | Le message d’erreur pointe vers le quota ou la facturation, code souvent insufficient_quota |
Non | Arrêter les tentatives automatiques, prévenir le responsable pour qu’il traite le compte |
Un point à souligner : la valeur concrète de error.code doit toujours être vérifiée au regard du contenu réellement renvoyé et de la documentation officielle. Les codes du tableau ne sont que des exemples courants ; dans le code, ne vous fiez pas uniquement à des chaînes codées en dur pour décider, et conservez aussi le message d’erreur original pour le diagnostic dans les logs.
Le nombre de requêtes et le volume de tokens peuvent être limités séparément
Le guide sur les limites de débit explique que celles-ci sont mesurées selon plusieurs dimensions, les plus fréquentes étant le nombre de requêtes et le volume de tokens, qui s’appliquent indépendamment. Autrement dit, même si vous êtes encore très loin du plafond de requêtes, vous pouvez d’abord heurter la limite de tokens parce que chaque requête transporte un contexte très long. Inversement, une masse de très petites requêtes peut épuiser le quota de requêtes avant tout le reste.
OpenAI expose dans ses en-têtes de réponse des informations liées aux limites de débit, comme le nombre de requêtes restantes, les tokens restants et le délai de réinitialisation de chacun. Ces champs aident à savoir, avant de vraiment déclencher un 429, de quelle limite on est le plus proche.
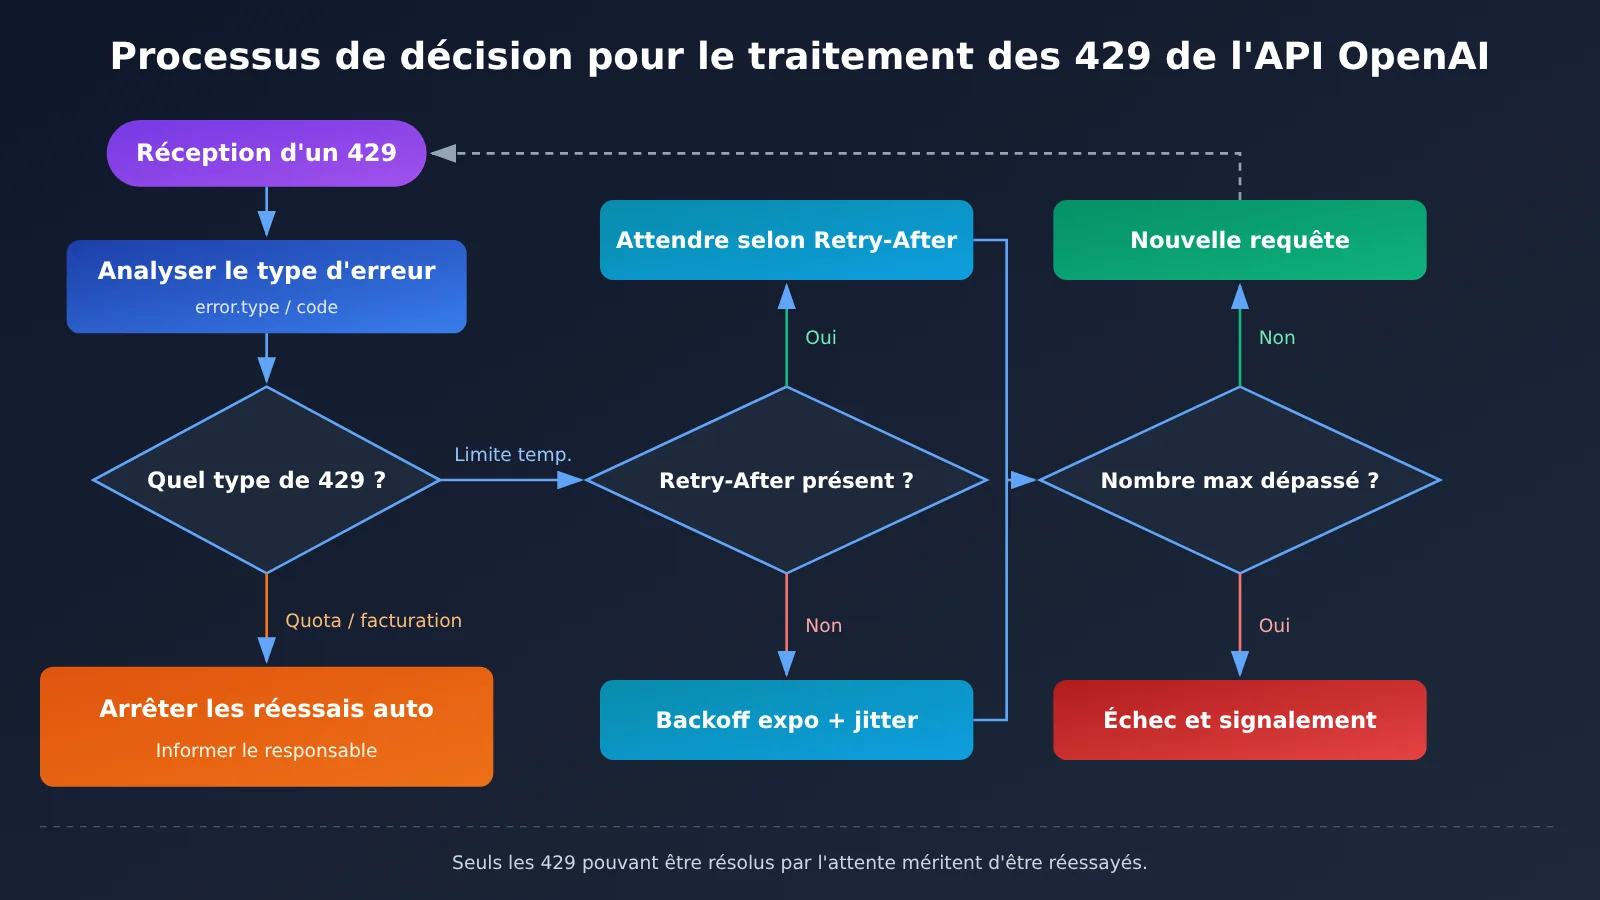
Les méthodes de retry recommandées par OpenAI pour les erreurs 429
Pour les limitations de débit temporaires qui méritent une nouvelle tentative, la recommandation officielle se résume en deux points :
- Si un en-tête Retry-After valide est présent, respectez-le. C’est le signal le plus direct envoyé par le serveur, plus fiable que les estimations côté client.
- Sans Retry-After, utilisez un backoff exponentiel avec du jitter aléatoire. Le temps d’attente augmente à chaque échec, auquel on ajoute une part aléatoire pour éviter que tous les clients réessaient exactement au même moment.
Ces deux règles partent du principe que « ce 429 fait partie des cas qu’une attente peut résoudre ». S’il s’agit d’un problème de quota ou de facturation, même l’algorithme de backoff le plus précis ne fera que tourner à vide.
Le comportement de retry automatique des SDK officiels
Les SDK officiels d’OpenAI réessaient automatiquement les erreurs de limite de débit qui remplissent les conditions, et ce comportement dépend de la configuration du client. Avec le SDK Python, par exemple, on peut l’ajuster via le paramètre max_retries, ou le mettre à 0 pour désactiver le retry automatique.
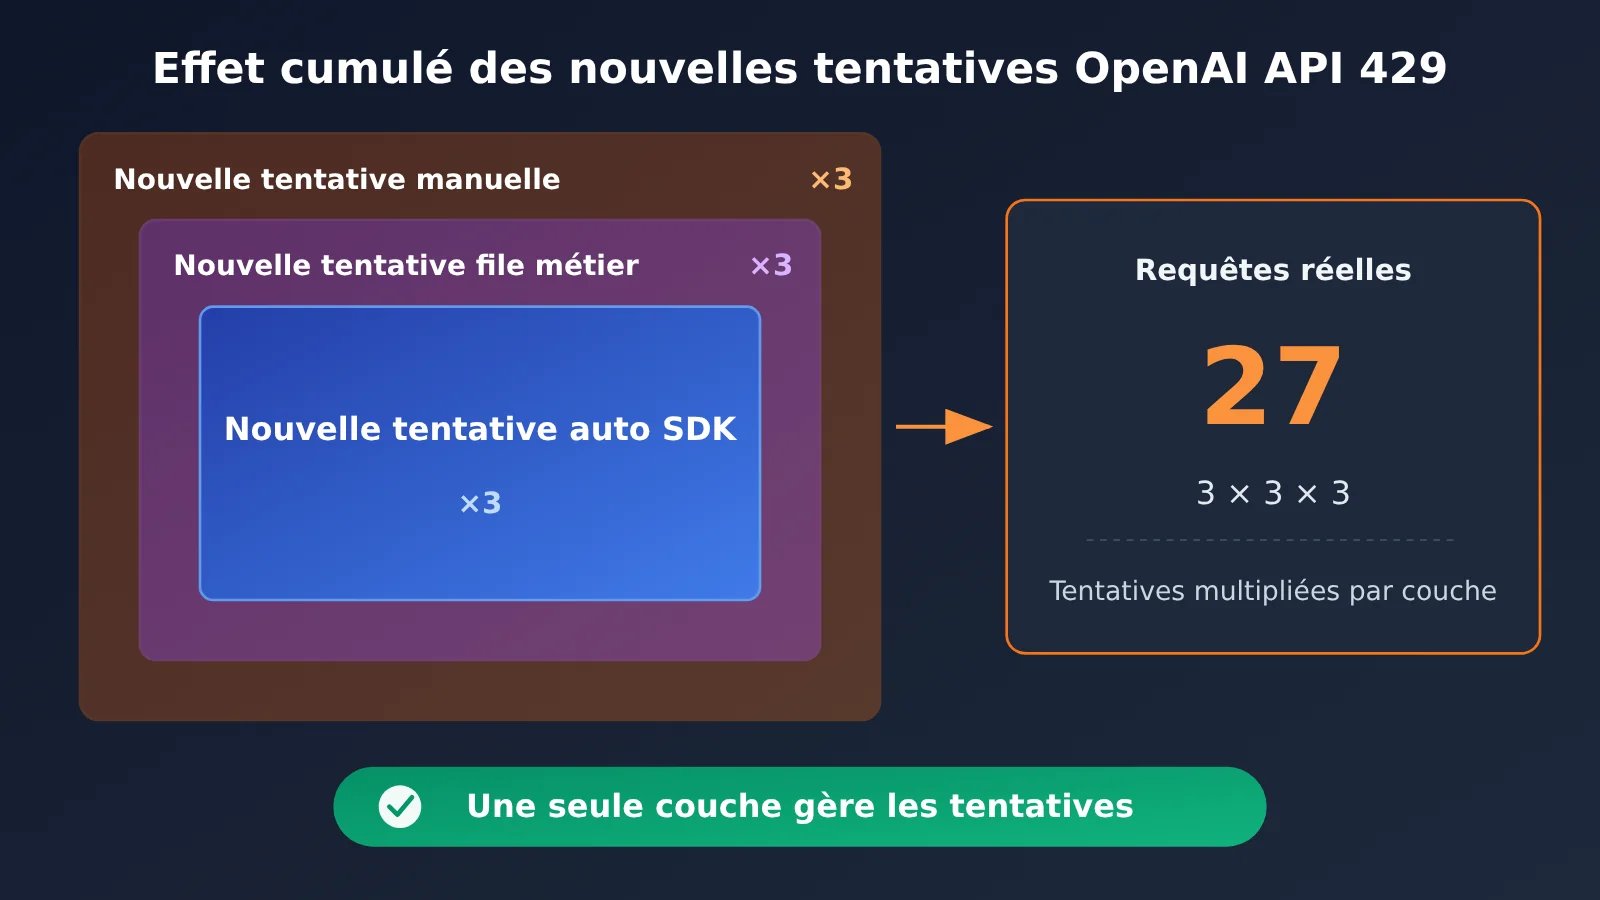
Cela signifie que même si votre code métier ne contient pas une seule ligne de logique de retry, la requête a peut-être déjà été réessayée plusieurs fois. Si votre couche métier ajoute elle-même une couche de retry par-dessus, le nombre réel de requêtes correspond au produit des deux.
Une erreur survenant en cours de requête en streaming ne peut pas toujours être rejouée
La documentation officielle évoque aussi un cas limite facile à négliger : une fois que la sortie en streaming a commencé, les erreurs qui surviennent ensuite ne peuvent pas être systématiquement traitées en rejouant toute la requête. L’utilisateur a peut-être déjà vu une partie du contenu, et le système en aval a peut-être déjà consommé une partie des données. Un rejeu direct entraînerait des doublons, des incohérences, ainsi qu’une consommation supplémentaire de tokens.
Analyse et décisions : comment mettre en œuvre concrètement les 429 de l’API OpenAI dans un projet
Ce qui suit relève d’un jugement d’ingénierie fondé sur les faits ci-dessus, et non des propos officiels d’OpenAI.
Un exemple de backoff pour les erreurs 429 de l’API OpenAI, directement adaptable
L’exemple ci-dessous illustre plusieurs principes : désactiver les tentatives automatiques du SDK et en confier la responsabilité à la couche métier ; lever immédiatement les erreurs de quota ; privilégier l’en-tête Retry-After ; à défaut, utiliser un backoff exponentiel avec gigue complète ; limiter le nombre maximal de tentatives.
import random
import time
from openai import OpenAI, RateLimitError

# Désactiver les tentatives automatiques du SDK pour éviter qu'elles ne se superposent à la logique personnalisée ci-dessous
client = OpenAI(max_retries=0)

# Types de 429 irrécupérables (à vérifier selon les réponses réelles et la documentation officielle)
NON_RETRYABLE_CODES = {"insufficient_quota"}


def parse_retry_after(response):
    """Analyse le nombre de secondes de Retry-After ; renvoie None si invalide. Le format date HTTP peut être ajouté au besoin."""
    if response is None:
        return None
    value = response.headers.get("retry-after")
    try:
        seconds = float(value)
        return seconds if seconds >= 0 else None
    except (TypeError, ValueError):
        return None


def call_with_backoff(messages, model, max_attempts=5, base=1.0, cap=60.0):
    for attempt in range(max_attempts):
        try:
            return client.chat.completions.create(model=model, messages=messages)
        except RateLimitError as e:
            if e.code in NON_RETRYABLE_CODES:
                raise  # Problème de quota/facturation, à confier au processus de gestion du compte
            if attempt == max_attempts - 1:
                raise  # Nombre maximal dépassé, à confier à la file d'attente ou à l'alerte
            wait = parse_retry_after(e.response)
            if wait is None:
                # Gigue complète : valeur aléatoire dans [0, plafond exponentiel]
                wait = random.uniform(0, min(cap, base * 2 ** attempt))
            time.sleep(wait)
Dans cet exemple, max_attempts, base et cap ne sont que des points de départ, pas des valeurs recommandées. Les niveaux de limite varient d’un compte à l’autre, tout comme la forme des tâches ; il n’existe pas de nombre de requêtes simultanées ni de nombre de tentatives unique qui convienne à tous les comptes. Ajustez ces valeurs en fonction de vos propres données de surveillance.
Ajuster selon le type de goulot d’étranglement : les solutions diffèrent entre un goulot de requêtes et un goulot de tokens
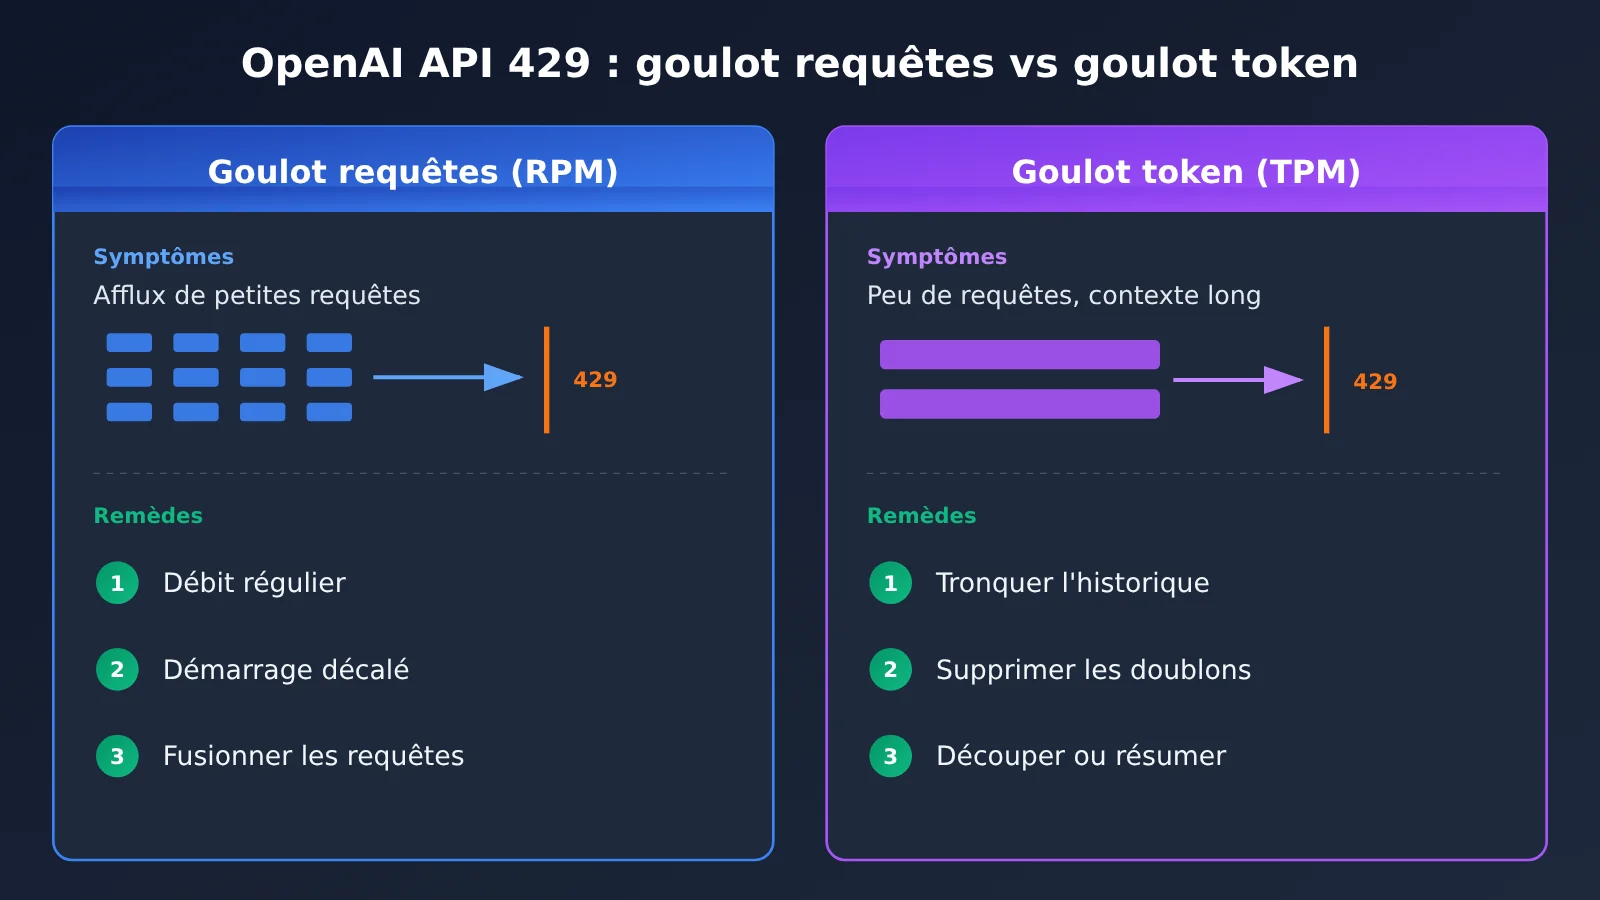
Le backoff ne résout qu’une chose : « combien de temps attendre cette fois-ci ». Il ne dit rien sur « pourquoi on franchit toujours la limite ». Pour réduire les 429, il faut d’abord identifier quelle limite on dépasse.
Goulot d’étranglement côté requêtes : l’essentiel est d’espacer le rythme de soumission. À l’entrée de la file, on fait sortir les tâches à vitesse constante, par exemple avec un token bucket ou un envoi à intervalle fixe, pour éviter qu’une masse de tâches ne déferle dans la même seconde. Au lancement d’un traitement par lots, décalez aussi les démarrages : ne déclenchez pas tout à l’heure pile.
Goulot d’étranglement côté tokens : l’essentiel est de réduire le volume d’une requête individuelle. Les gaspillages classiques : renvoyer intégralement un long prompt système et l’historique à chaque tour de conversation ; renvoyer plusieurs fois le même gros document dans plusieurs requêtes ; fourrer tout le matériel dans le modèle alors qu’on n’a besoin que d’un extrait. Commencez par découper, résumer ou faire de la recherche, puis soumettez : c’est souvent bien plus efficace que d’augmenter le nombre de tentatives.
Les statuts de file d’attente doivent distinguer « en attente de nouvelle tentative » et « compte bloqué »
Beaucoup de systèmes ne connaissent que deux statuts : « en file d’attente » et « échec ». Face à un 429, cela provoque deux erreurs de jugement : une limitation de débit temporaire est prise pour un échec et la tâche est abandonnée, tandis qu’un problème de quota est pris pour une simple mise en attente et l’on patiente indéfiniment.
Une approche plus judicieuse consiste à scinder les deux types de 429 en deux statuts distincts, avec un affichage différent pour chacun :
| Statut de file | Condition de déclenchement | Informations à afficher | Traitement ultérieur |
|---|---|---|---|
| En attente de nouvelle tentative | Limitation de débit temporaire | Heure estimée de la prochaine tentative, nombre de tentatives déjà effectuées | Nouvelle tentative automatique à l’heure prévue, passage en échec une fois la limite atteinte |
| Compte bloqué | Quota, facturation, limites d’utilisation de l’organisation | Raison du blocage (par exemple quota insuffisant) | Suspendre les tâches suivantes du même compte, notifier le responsable |
| Échec | Dépassement de la limite de tentatives ou autre erreur non récupérable | Type d’erreur et message d’origine | Intervention manuelle ou dégradation du service |
« Compte bloqué » a en outre un effet en cascade. Les autres tâches du même compte rencontreront très probablement le même 429 ; mieux vaut alors tout suspendre d’un coup plutôt que de laisser chaque tâche aller se cogner une par une.
Diagnostiquer l’empilement des tentatives : SDK, file d’attente, bouton manuel
Si vous constatez que les erreurs 429 augmentent à chaque nouvelle tentative, la première chose à vérifier est si plusieurs couches de tentatives s’activent en même temps. Le scénario typique : le SDK réessaie automatiquement plusieurs fois, la file d’attente métier redépose la tâche après échec plusieurs fois, et l’utilisateur côté front, voyant l’erreur, clique manuellement sur « Réessayer ». En multipliant ces trois couches, une requête initiale peut se transformer en une dizaine de requêtes réelles, généralement concentrées dans la même fenêtre de limitation de débit — ce qui ne fait qu’aggraver la limitation.
Pour diagnostiquer, je vous conseille de vérifier couche par couche :
- Couche SDK : vérifiez la valeur réelle de
max_retries, ne vous fiez pas à la valeur par défaut dont vous vous souvenez. - Couche file d’attente : vérifiez si la tâche est automatiquement redéposée après échec, et si le redépot applique un backoff.
- Couche interaction : vérifiez si le bouton « Réessayer » est désactivé pendant l’attente, et s’il affiche l’heure de la prochaine tentative.
- Couche logs : attribuez un ID unique à chaque tâche originale et comptez combien de requêtes elle a réellement émises.
Le principe est simple : une seule couche doit être responsable des tentatives sur un même chemin, les autres se contentant de transmettre l’état.
Concevoir une stratégie de récupération distincte pour les 429 de l’API OpenAI en mode streaming
Une requête en streaming qui rencontre un 429 au moment d’établir la connexion, avant d’avoir produit quoi que ce soit, peut être traitée comme une requête classique. En revanche, dès que la sortie a commencé, c’est au métier de décider s’il faut rejouer la requête. Par exemple : prévenir explicitement l’utilisateur que la génération a été interrompue et le laisser relancer ; ou bien jeter la portion déjà produite et la remplacer intégralement. Ne rejouez pas silencieusement en arrière-plan, sous peine de voir apparaître deux blocs de contenu dupliqués à l’écran.
Lors de la migration vers d’autres plateformes, ne recopiez pas la sémantique 429 d’OpenAI
La classification des erreurs décrite dans cet article, les valeurs de error.code, le comportement du Retry-After et les en-têtes de réponse relèvent tous de la sémantique de l’API officielle d’OpenAI. Si vous appelez le modèle via une passerelle tierce, un service proxy ou une plateforme d’agrégation (par exemple APIYI), il faut vous référer à la documentation propre à cette plateforme pour les codes d’erreur, les dimensions de limitation de débit et les recommandations de réessai de l’autre partie : à vérifier séparément, sans recopier directement le comportement d’OpenAI. L’approche la plus sûre consiste à mettre en place une normalisation des erreurs au niveau de la couche d’intégration : mapper les 429 de différentes sources vers les trois états mentionnés dans cet article — « attendre et réessayer / compte bloqué / échec » — puis les confier au module de réessai unifié.
Des changements à surveiller de près
La documentation sur les codes d’erreur et celle sur les limites de débit d’OpenAI sont maintenues en continu. Les niveaux de limite, les dimensions de mesure et les champs d’en-tête de réponse sont tous susceptibles d’être ajustés. Il est recommandé de conserver dans le code les journaux des erreurs originales et de vérifier régulièrement la logique de décision par rapport à la documentation officielle. Par ailleurs, n’inscrivez pas « tous les 429 peuvent être résolus en attendant » dans une configuration par défaut. Une fois cette hypothèse appliquée lorsque le quota est épuisé, le coût se traduit par une file de tâches qui tourne à vide toute une nuit.
Un 429 signifie essentiellement que le serveur dit « ralentissez », et parfois aussi « cette voie est temporairement impraticable ». Distinguer de quel cas il s’agit, puis décider s’il faut attendre, modifier ou arrêter, importe plus que n’importe quel algorithme de réessai sophistiqué. Comme le dit le Lunyu · Zilu (Entretiens de Confucius) :
« Ne cherche pas la rapidité, ne vise pas les petits profits. Qui cherche la rapidité n’atteint pas son but ; qui vise les petits profits ne réalise pas de grandes choses. »