Résumé : Pour choisir un modèle de développement de jeu, il faut regarder le taux de réussite sur une même tâche, le temps d’exécution, le coût API et le coût de correction manuelle ; les grilles tarifaires et les benchmarks de code génériques ne sont que des indicateurs secondaires.
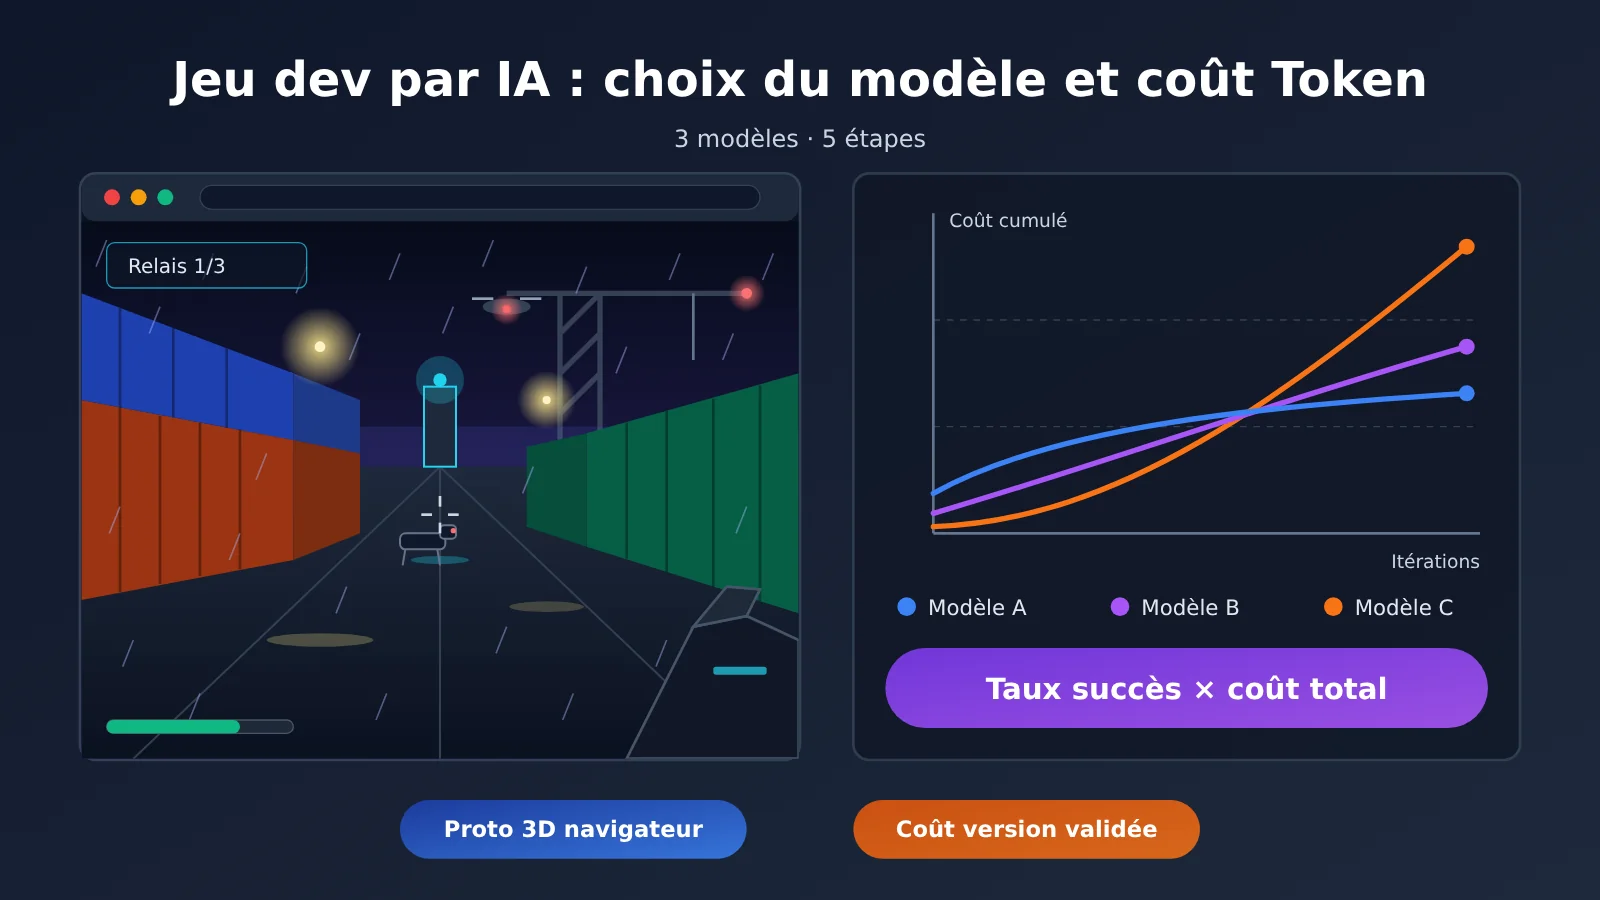
L’essentiel d’abord : quand on laisse une IA développer un jeu de façon autonome, ce qu’il faut comparer au final, c’est le coût de bout en bout pour livrer une version exploitable, pas le prix affiché par million de tokens. Dans le cas Saltline, Claude Fable 5.2 a produit, en environ 8 heures, avec environ 445 millions de tokens d’entrée et environ 2,7 millions de tokens de sortie, un prototype de jeu de tir 3D jouable dans un navigateur. L’estimation du développeur, d’après les tarifs API, tourne autour de 550 dollars, et une grande partie des entrées est passée par le cache. Au 16 novembre 2026, les prix unitaires API standard des trois modèles varient jusqu’à environ 5 fois, mais si le modèle au prix unitaire plus bas demande davantage de tours, le coût total peut être plus élevé. La méthode fiable pour choisir consiste donc à confier la même tâche de jeu aux modèles candidats, à lancer plusieurs exécutions, à relever le taux de réussite, les tokens, la durée et l’effort de correction manuelle, puis à calculer « le coût par version validée ».
Aperçu du contenu : la section 1 utilise Saltline pour décomposer la structure de la facture de tokens d’une expérience de développement de jeu par IA. La section 2 compare les tarifs officiels des trois modèles et explique l’impact du cache sur le coût total. La section 3 présente ce que SWE-bench Verified, Aider Polyglot et l’évaluation historique du NIST peuvent chacun nous apprendre. La section 4 propose un protocole d’évaluation dédié au développement de jeu, reproductible, ainsi que le code. La section 5 traduit les résultats en stratégie de sélection de modèle.
À savoir : Terminologie pour le choix des modèles de développement de jeux IA
| Terme | Explication |
|---|---|
| Token d’entrée | Mesure du contenu soumis au modèle pour traitement, y compris les invites, les fichiers de code et les résultats renvoyés par les outils |
| Token de sortie | Mesure du contenu généré par le modèle, par exemple le code, les textes explicatifs et les paramètres d’appel d’outils |
| Lecture du cache | Réutilisation d’un contexte déjà mis en cache, facturée bien moins cher qu’une entrée normale |
| Écriture du cache | Coût du stockage initial du contexte dans le cache, généralement un peu plus élevé qu’une entrée normale |
| SWE-bench Verified | Benchmark comprenant 500 tâches d’ingénierie logicielle issues de vrais projets open source, vérifiées manuellement |
| Aider Polyglot | Évaluation de modification de code couvrant 6 langages de programmation et 225 exercices |
| Harness | Cadre d’exécution qui organise la boucle entre modèle, outils et tâches, par exemple l’échafaudage d’un Agent |
| Taux de réussite des tâches | Proportion de tâches accomplies selon des critères d’acceptation définis à l’avance |
| Coût de bout en bout | Somme des coûts d’invocation du modèle, d’exécution des outils et de main-d’œuvre pour accomplir l’ensemble d’une tâche |
| Correction manuelle | Modifications manuelles apportées pour que le résultat généré atteigne les critères d’acceptation |
| Génération procédurale | Générer géométrie, textures et sons à l’aide de code et de fonctions mathématiques, plutôt qu’en important des fichiers d’assets |
| Shader | Programme exécuté sur le GPU pour calculer les couleurs, l’éclairage, les matériaux et autres effets visuels |
1 Exemple concret de coût pour un jeu indépendant développé par IA : combien de tokens Saltline a-t-il consommés
1.1 Quel est le gabarit de Saltline
Le 9 novembre 2026, l’ingénieur d’Anthropic Felix Rieseberg a rendu publique une expérience de programmation menée avec Claude Fable 5.2. Il n’a donné au modèle qu’une seule invite, en lui demandant de créer un jeu de tir à la première personne à petite échelle, avec un rendu visuel aussi proche que possible d’un jeu AAA, et sans fournir le moindre retour humain tout au long du processus. Résultat : Saltline, un jeu de tir 3D qui tourne directement dans le navigateur. La scène est un port à conteneurs par une nuit de pluie ; le joueur doit désactiver trois stations relais de signal puis évacuer, face à des drones de patrouille aériens et des chiens mécaniques au sol.
En termes de gabarit, Saltline est un prototype jouable en solo, sur un seul niveau. Le « 3A » est ici un objectif d’expérience et une analogie visuelle, employée pour décrire le style graphique : son volume reste très éloigné des produits 3A commerciaux. La « JiMao · grande production 3A chinoise » qui circule en Chine est la version chinoise, ou une version remballée, de Saltline ; ce nom vient du processus de diffusion et ne reflète pas l’attribution du développement.
1.2 Temps, tokens et coûts selon le développeur
Les données ci-dessous proviennent toutes des publications du développeur lui-même sur X. Il s’agit d’estimations auto-déclarées, non auditées par un tiers :
- Temps de développement : environ 8 heures
- Tokens d’entrée : environ 445 millions, avec un recours massif au cache
- Tokens de sortie : environ 2,7 millions
- Coût estimé d’après les tarifs de l’API : environ 550 dollars
- Méthode de développement : une seule invite, sans itération ni retour humain
Cette somme correspond à un coût de génération unique. Une fois les fichiers du jeu générés, ils s’exécutent localement dans le navigateur du joueur : celui-ci ne sollicite pas l’API Claude pendant qu’il joue. Les 550 dollars ne peuvent donc pas être répartis en un « coût IA par joueur ».
1.3 Décomposer la facture avec les tarifs officiels
D’après les tarifs standard officiels de Claude Fable 5.2 (sortie à 40 $ / million de tokens), les 2,7 millions de tokens de sortie représentent environ 108 dollars. Le solde d’environ 440 dollars correspond au côté entrée : écritures dans le cache, lectures du cache et entrées ordinaires. Le développeur n’a pas publié la quantité de chacun des trois, il est donc impossible de ventiler davantage.
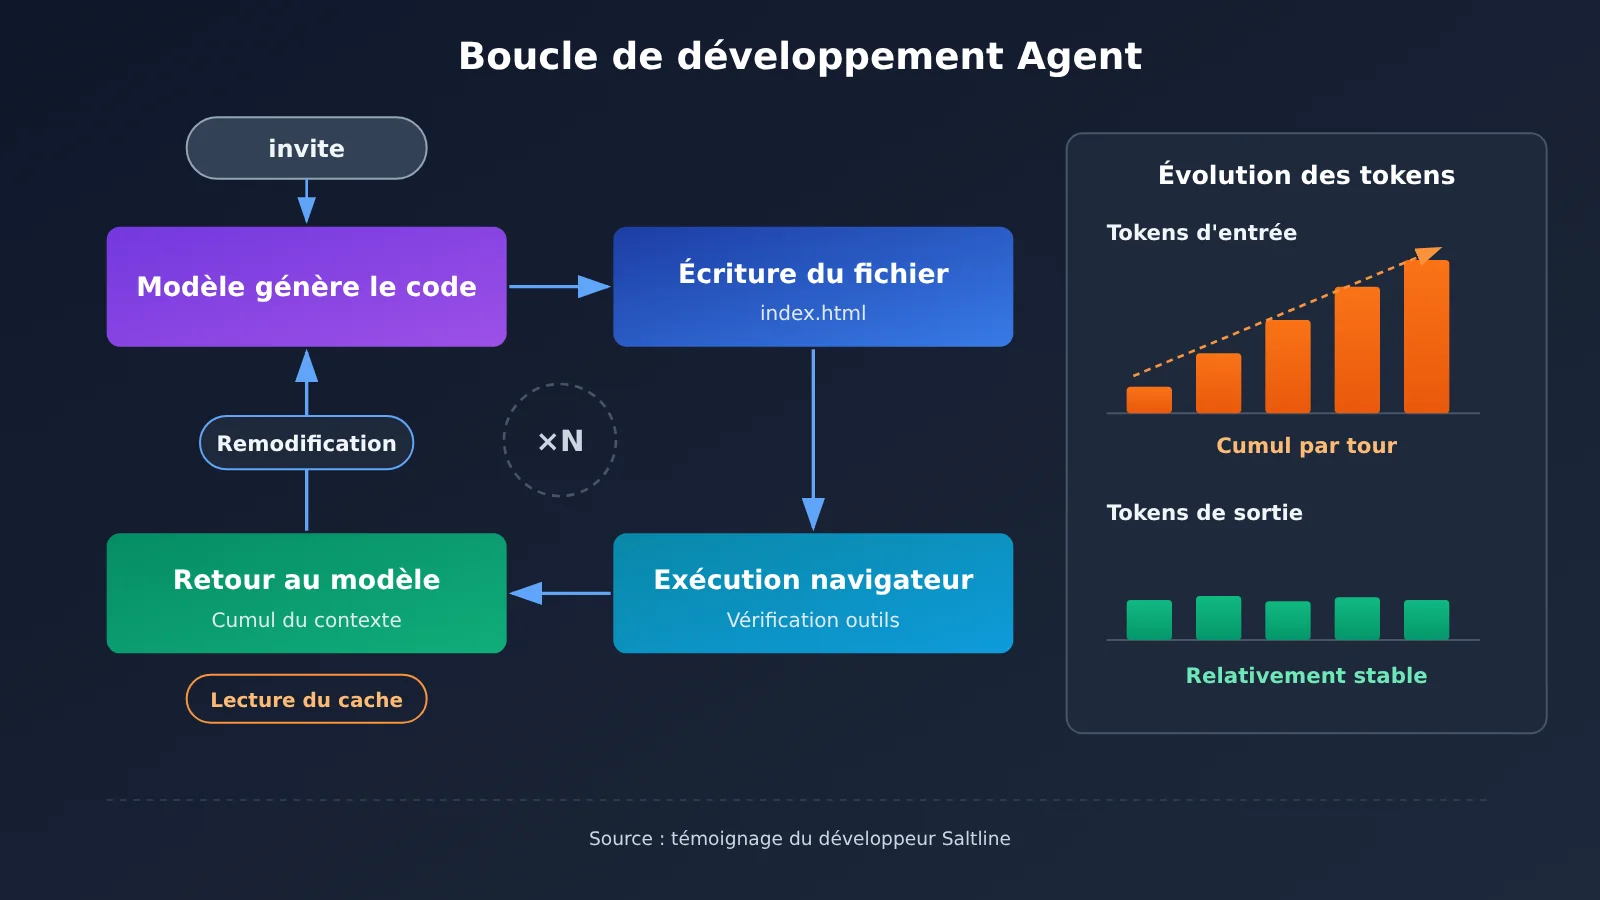
Il suffit de comparer deux valeurs limites pour comprendre le rôle du cache : si les 445 millions de tokens d’entrée étaient facturés intégralement au prix d’entrée ordinaire de 8 $, cela représenterait environ 3 560 dollars ; s’ils l’étaient tous au prix de lecture du cache de 0,20 $, environ 89 dollars. L’estimation réelle se situe entre les deux, et nettement plus près de la borne basse. Autrement dit, dans les tâches de développement d’agents de longue durée, le taux de réussite du cache côté entrée détermine l’ordre de grandeur de la facture, tandis que le prix unitaire de sortie joue un rôle relativement secondaire.
1.4 Pourquoi un fichier de 1,43 MB peut consommer 445 millions de tokens
La version HTML autonome de Saltline pèse environ 1,43 MB (1 425 707 octets). Le développeur explique que les modèles et les textures du jeu sont du code : la géométrie est construite par programme, le rendu des surfaces est calculé par les shaders, et le son est lui aussi généré par programme. Il n’y a aucun asset image ou modèle 3D séparé.
Le résultat est minuscule, mais le processus est très long. Pendant 8 heures, l’agent relit inlassablement des fichiers de code qui ne cessent de grossir, exécute des outils, examine les résultats puis modifie à nouveau — et à chaque tour, il renvoie un gros volume de contexte au modèle. Au final, la consommation de tokens vient principalement de cette boucle, et non de la longueur du fichier final. C’est aussi pour cela qu’il faut mesurer le « coût du processus » lorsqu’on évalue un modèle destiné au développement de jeux.
2 Comparaison des prix des modèles pour le développement de jeux : les différences de facturation des tokens entre trois API
2.1 Les prix standard officiels des trois modèles
Les prix du tableau ci-dessous proviennent des pages officielles de chaque fournisseur ; ils sont à jour au 16 novembre 2026, exprimés en dollars par million de tokens, sur l’offre tarifaire standard de l’API, hors remises d’autres canaux et hors surcharges régionales.
| Modèle | Entrée standard | Sortie | Lecture du cache | Remarques |
|---|---|---|---|---|
| Claude Fable 5.2 | $8 | $40 | $0.20 | Écriture du cache 5 minutes $10, écriture du cache 1 heure $16 ; fenêtre de contexte 1M, sortie maximale 128K |
| GPT-6 Astra | $10 | $50 | $1 | Offre de traitement standard ; les autres niveaux de vitesse, le traitement par lots et les options régionales peuvent avoir des prix différents |
| Gemini 4 Argon | $2 | $10 | $0.10 | Ce prix s’applique jusqu’au 30 novembre 2026 ; à partir du 1er décembre, l’ajustement prévu est de $4 en entrée et $20 en sortie |
Claude Fable 5.2 propose en plus un Fast Mode, à $16 en entrée et $80 en sortie, dont la documentation officielle annonce une vitesse de sortie jusqu’à 2,5 fois plus élevée. Pour les tâches longues qui doivent être bouclées dans un temps imparti, le niveau de vitesse change à la fois la durée et le coût : il faut donc le consigner comme une configuration à part entière lors de l’évaluation.
💡 Conseil de comparaison : les interfaces et les champs de facturation des trois modèles diffèrent, et il faut les intégrer séparément quand on monte son propre environnement d’évaluation. APIYI apiyi.com propose une interface unifiée compatible OpenAI : une seule clé API suffit pour appeler Claude, GPT, Gemini et d’autres modèles, ce qui facilite le changement de modèle dans un même script d’évaluation. Les modèles réellement disponibles et les prix appliqués sont ceux de la liste de la plateforme.
2.2 Les écarts de prix affichés à volume de tokens égal
Pour se faire une idée concrète de l’écart de prix unitaire, on peut appliquer le volume de sortie de Saltline (2,7 millions de tokens) aux tarifs des trois modèles : environ 108 dollars pour Claude Fable 5.2, 135 dollars pour GPT-6 Astra et 27 dollars pour Gemini 4 Argon. Si les 445 millions de tokens d’entrée correspondaient tous à des lectures de cache, on obtiendrait respectivement environ 89, 445 et 45 dollars.
Ces chiffres ne décrivent que la structure de facturation : ils supposent que les trois modèles consomment exactement le même nombre de tokens, une hypothèse qui ne tient presque jamais dans la pratique. Le nombre de tours nécessaires pour venir à bout d’une même tâche, le contexte lu à chaque tour et la longueur du code généré varient d’un modèle à l’autre, et une nouvelle exécution après un échec peut multiplier les coûts.
2.3 Le prix du cache mérite plus d’attention que celui de l’entrée
Dans le développement de type agent, la majeure partie de l’entrée est constituée de contexte répété. Le prix de lecture du cache de GPT-6 Astra représente 1/10 du prix d’entrée standard, contre 1/40 pour Claude Fable 5.2 et 1/20 pour Gemini 4 Argon. Plus ce rapport entre lecture du cache et entrée standard est faible, plus le coût d’entrée des tâches longues peut être réduit.
Le cache a aussi un coût d’écriture et une durée de validité. Chez Claude, l’écriture du cache 5 minutes et celle du cache 1 heure n’ont pas le même prix ; si l’intervalle entre deux appels de l’agent dépasse la validité du cache, il faut réécrire. Pour estimer le coût d’une tâche longue, il faut intégrer dans le calcul le nombre d’écritures de cache, le taux de réussite du cache et la durée de validité.
3 Ce que les benchmarks de programmation peuvent révéler : une référence pour les capacités des modèles de développement de jeux
3.1 SWE-bench Verified : des tâches d’ingénierie logicielle sur de vrais dépôts
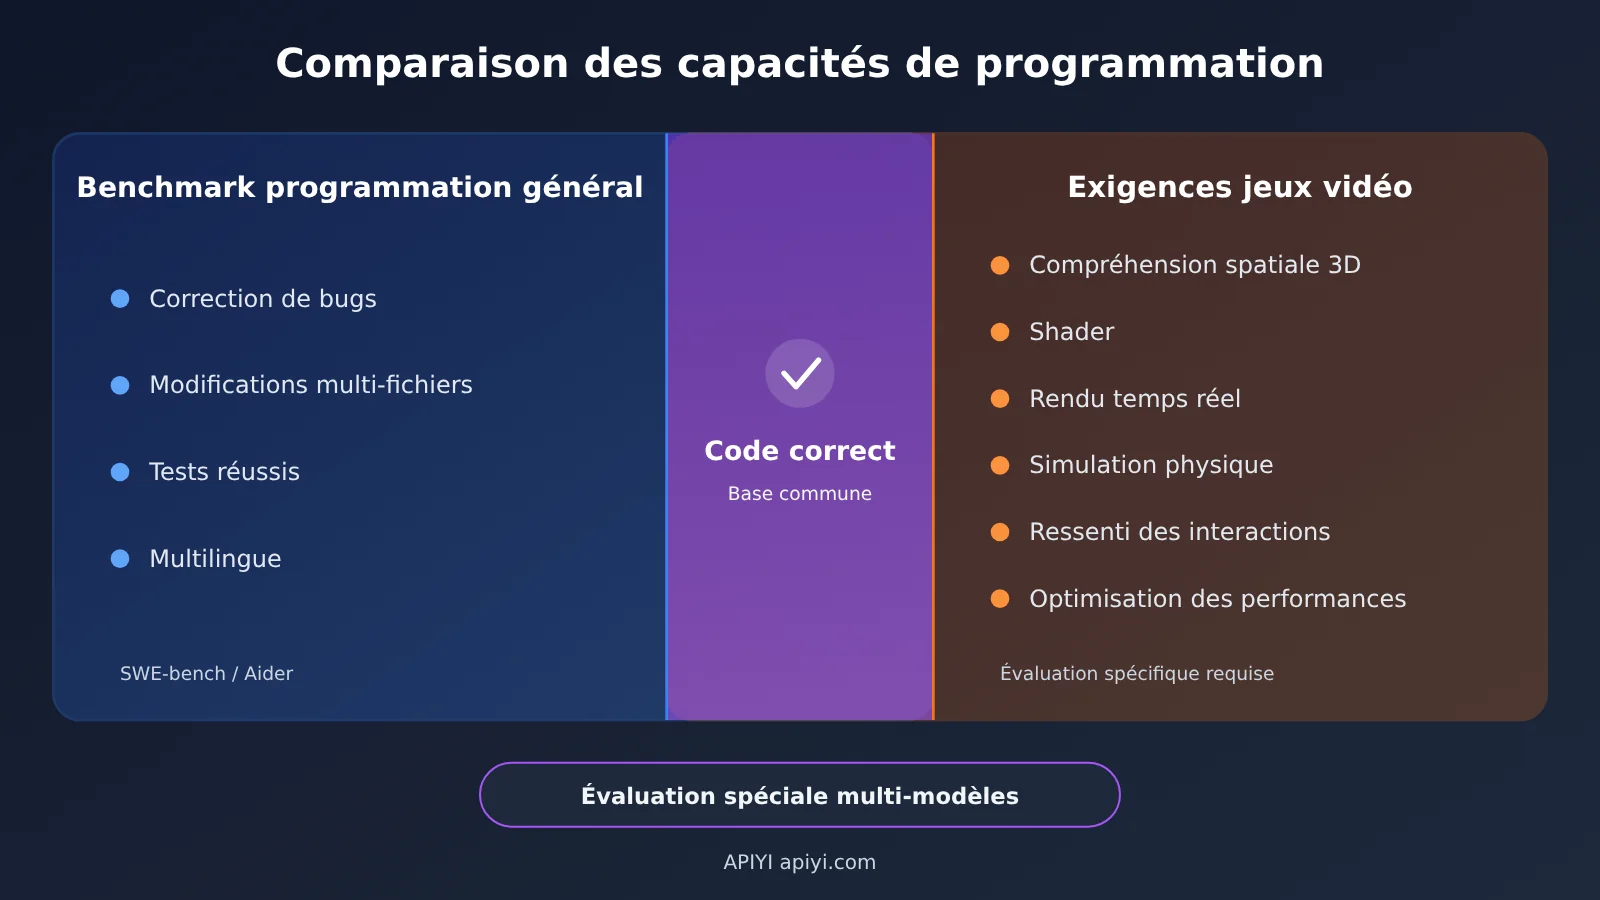
SWE-bench Verified rassemble 500 problèmes sélectionnés et vérifiés manuellement, issus de véritables projets open source. Le modèle doit comprendre le contexte du dépôt et mener à bien des tâches comme corriger des bugs, modifier du code existant, résoudre des tests qui échouent ou encore effectuer des modifications sur plusieurs fichiers — des tâches bien plus proches de l’ingénierie réelle qu’une simple complétion de code.
Lorsque vous utilisez ce benchmark, gardez à l’esprit l’influence du harness. La documentation officielle l’indique clairement : le classement complet mélange différents systèmes d’agents, si bien que pour comparer les modèles entre eux, il faut s’appuyer sur une configuration mini-SWE-agent uniforme. La configuration de l’agent, les outils, l’invite et la version modifient tous le score, et les résultats obtenus avec des configurations différentes doivent être examinés séparément.
3.2 Aider Polyglot : suivre à la fois le taux de réussite et le coût
Aider Polyglot s’appuie sur 225 exercices de programmation couvrant C++, Go, Java, JavaScript, Python et Rust, et utilise des cas de test pour déterminer si le modèle a correctement modifié le code. Ses résultats publics ne se limitent pas au taux de réussite : ils enregistrent aussi la consommation de tokens, le coût d’exécution, les sorties erronées, les erreurs de format et le temps d’exécution de chaque tâche.
Pour le choix d’un modèle, cette façon de consigner « taux de réussite + coût » est très précieuse, et elle rejoint la logique du cadre d’évaluation présenté plus loin dans cet article. Les énoncés eux-mêmes sont des exercices indépendants, et leur échelle comme leur forme présentent un écart notable avec un projet de jeu 3D complet.
3.3 Évaluations historiques du NIST : attention à la version du modèle et à la date
Dans le rapport d’évaluation de modèles publié en 2025 par le CAISI, rattaché au NIST (Institut national des normes et de la technologie des États-Unis), un ensemble de modèles a été testé sur SWE-bench Verified. Les données ci-dessous correspondent à des modèles historiques et à des configurations expérimentales issues de ce rapport ; elles ne représentent pas le classement des derniers modèles en novembre 2026.
| Modèle (version testée dans le rapport 2025) | Score SWE-bench Verified |
|---|---|
| Anthropic Opus 4 | 66.7% |
| GPT-5 | 63.0% |
| DeepSeek V3.1 | 54.8% |
| DeepSeek R1-0528 | 44.6% |
| gpt-oss | 42.6% |
| DeepSeek R1 | 25.4% |
Le rapport fournit également l’erreur type, ce qui montre que les scores d’un même benchmark comportent en eux-mêmes des fluctuations statistiques. Un écart de quelques points de pourcentage peut, dans la marge d’erreur, ne correspondre à aucune différence réelle. Les modèles comparés dans cet article — Claude Fable 5.2, GPT-6 Astra et Gemini 4 Argon — n’apparaissent pas dans ce rapport. Pour choisir, il faut donc chercher les évaluations les plus récentes portant sur les versions actuelles et précisant la configuration, ou réaliser ses propres tests.
3.4 Écart entre les capacités de programmation générale et celles de développement de jeux
Le développement de jeux comprend de nombreuses tâches que les benchmarks d’ingénierie logicielle générale ne couvrent pas suffisamment : compréhension spatiale 3D, écriture de shaders, rendu temps réel, systèmes d’animation, simulation physique, ressenti des interactions et optimisation des performances d’exécution. Des projets comme Saltline exigent en outre des modèles qu’ils génèrent des assets visuels à partir de code, ce qui dépend de la maîtrise de l’infographie et des effets visuels.
Un modèle peut très bien savoir corriger des bugs dans un dépôt Python, tout en étant moyen sur une scène WebGL complexe. SWE-bench et Aider sont utiles pour éliminer les candidats dont les compétences en code sont manifestement insuffisantes ; le classement final doit être décidé par une évaluation spécialisée en développement de jeux.
4 Comment comparer les modèles de développement de jeux par IA : un plan d’évaluation dédié pour une même tâche
4.1 Concevoir une tâche de jeu 3D dans le navigateur unifiée
En s’inspirant de la forme de Saltline, on peut définir la tâche ainsi : générer à partir d’une seule invite un prototype de jeu 3D exécutable dans le navigateur. Tous les modèles candidats reçoivent exactement les mêmes exigences :
- Générer un projet complet, directement exécutable en l’ouvrant dans le navigateur
- Inclure un personnage jouable et un environnement 3D
- Inclure des collisions ou une physique de base
- Inclure un objectif de tâche clair et des conditions de victoire/défaite
- Interdire toute modification manuelle du code central pendant l’évaluation
La difficulté de la tâche doit rester proche de vos besoins réels. Une équipe qui développe des petits jeux casual surestimera le niveau de modèle nécessaire en testant avec un prototype FPS ; une équipe qui développe des projets 3D complexes le sous-estimera en testant avec une tâche 2D simple.
4.2 Dix indicateurs d’évaluation
| Dimension | Contenu de l’évaluation | Comment le consigner |
|---|---|---|
| Complétude fonctionnelle | Les fonctions essentielles du jeu sont-elles implémentées ? | Cocher chaque point d’une liste de fonctionnalités |
| Qualité visuelle | Décor, matériaux, éclairage, animation | Notation à l’aveugle par plusieurs évaluateurs |
| Capacité à s’exécuter | L’application démarre-t-elle correctement ? | Oui / Non |
| Intégrité des interactions | Les entrées et les retours fonctionnent-ils correctement ? | Tester chaque point d’une liste d’actions |
| Stabilité | Y a-t-il des plantages évidents ? | Noter le nombre de plantages sur une durée de jeu fixe |
| Performances | FPS, temps de démarrage, mémoire | Mesures sur un appareil fixe |
| Qualité du code | Lisibilité, modularité, gestion des erreurs | Notation après revue de code |
| Coût en tokens | Entrées, sorties, cache | Cumul à partir du champ API usage |
| Durée totale | Du début à la version exécutable | Chronométrer |
| Corrections manuelles | Interventions humaines nécessaires pour atteindre les critères | Consigner le temps de travail humain |
Parmi ces dimensions, la « capacité à s’exécuter », la « complétude fonctionnelle » et l’« intégrité des interactions » doivent servir de conditions d’acceptation strictes pour déterminer si une exécution est réussie ; la qualité visuelle, les performances et la qualité du code servent à classer les résultats réussis.
4.3 Contrôler l’environnement de test
La comparabilité des résultats d’évaluation dépend du contrôle des variables. Les conditions à uniformiser sont notamment : le même navigateur, le même appareil, la même invite, le même déroulé de test, le même budget de temps, et le fait d’autoriser ou non l’accès au réseau. Si l’on permet au modèle d’appeler lui-même des outils, de rechercher des informations ou de créer des fichiers, les droits d’accès aux outils doivent aussi être identiques pour tous les modèles.
Le harness doit également être figé. Un même modèle, passé dans un autre framework d’agent, peut voir son taux de réussite et sa consommation de tokens varier fortement. Il faut donc préciser dans le rapport d’évaluation le framework utilisé, sa version et ses paramètres — par exemple la température, la longueur maximale de sortie et le niveau de vitesse.
4.4 Exécuter chaque modèle plusieurs fois au minimum
La génération d’un grand modèle de langage est aléatoire : une réussite peut tenir à la chance, un échec peut être accidentel. Chaque modèle devrait donc être exécuté plusieurs fois dans les mêmes conditions (par exemple 5 à 10 fois), en statistiquant le taux de réussite ainsi que les tokens moyens, la durée et le score de qualité des échantillons réussis. Saltline est elle-même une expérience unique : elle prouve que la chose est faisable, mais ne permet pas de donner le taux de réussite de ce modèle sur des tâches similaires.
Le script ci-dessous appelle le modèle via une interface compatible OpenAI et calcule le coût d’un appel à partir du champ usage, selon les tarifs de la section 2 :
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # APIYI interface unifiée, il suffit de changer model pour changer de modèle
)

# Unité : dollars / million de tokens, tarif officiel standard au 2026-11-16
PRICES = {
    "claude-fable-5.2": {"input": 8,  "output": 40, "cache_read": 0.20},
    "gpt-6-astra":      {"input": 10, "output": 50, "cache_read": 1},
    "gemini-4-argon":   {"input": 2,  "output": 10, "cache_read": 0.10},
}

def call_and_price(model: str, messages: list) -> tuple[str, float]:
    resp = client.chat.completions.create(model=model, messages=messages)
    u = resp.usage
    cached = getattr(getattr(u, "prompt_tokens_details", None), "cached_tokens", 0) or 0
    p = PRICES[model]
    cost = ((u.prompt_tokens - cached) * p["input"]
            + cached * p["cache_read"]
            + u.completion_tokens * p["output"]) / 1_000_000
    return resp.choices[0].message.content, cost
Utilisez les noms de modèles réellement proposés par la plateforme d’appel. Les frais d’écriture de cache et les suppléments liés au niveau de vitesse doivent être ajoutés au calcul selon les règles propres à chaque fournisseur.
Voir le script d’évaluation multi-tours et de récapitulatif des coûts
import time
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Appeler plusieurs modèles candidats via APIYI
)

PRICES = {
    "claude-fable-5.2": {"input": 8,  "output": 40, "cache_read": 0.20},
    "gpt-6-astra":      {"input": 10, "output": 50, "cache_read": 1},
    "gemini-4-argon":   {"input": 2,  "output": 10, "cache_read": 0.10},
}

TASK_PROMPT = "生成一个可在浏览器运行的单文件 3D 游戏原型……(所有模型使用同一提示词)"

def price(model, usage):
    cached = getattr(getattr(usage, "prompt_tokens_details", None), "cached_tokens", 0) or 0
    p = PRICES[model]
    return ((usage.prompt_tokens - cached) * p["input"]
            + cached * p["cache_read"]
            + usage.completion_tokens * p["output"]) / 1_000_000

def run_once(model, max_rounds=30):
    """Boucle d'agent simplifiée : générer → vérifier → renvoyer le résultat → corriger"""
    messages = [{"role": "user", "content": TASK_PROMPT}]
    total_cost, start = 0.0, time.time()
    for _ in range(max_rounds):
        resp = client.chat.completions.create(model=model, messages=messages)
        total_cost += price(model, resp.usage)
        code = resp.choices[0].message.content
        report = check_game(code)  # À implémenter soi-même : écrire le fichier, lancer un navigateur headless, exécuter la liste de contrôle des fonctionnalités
        if report["passed"]:
            return True, total_cost, time.time() - start
        messages += [{"role": "assistant", "content": code},
                     {"role": "user", "content": f"检查结果:{report['log']},请修复"}]
    return False, total_cost, time.time() - start

def evaluate(model, trials=5, human_fix_cost=0.0):
    results = [run_once(model) for _ in range(trials)]
    successes = sum(r[0] for r in results)
    api_cost = sum(r[1] for r in results)
    rate = successes / trials
    per_success = (api_cost + human_fix_cost) / successes if successes else float("inf")
    print(f"{model}: 成功率 {rate:.0%},API 总费用 ${api_cost:.2f},"
          f"每个合格版本成本 ${per_success:.2f}")

for m in PRICES:
    evaluate(m)
🚀 Démarrage rapide : pour mettre en place ce type d’évaluation, je vous conseille de commencer par faire tourner le script sur une tâche simple, puis de passer à la tâche complète de jeu. APIYI apiyi.com offre aux nouveaux utilisateurs un quota de test gratuit, que vous pouvez utiliser pour valider la logique du harness et des statistiques de facturation avant d’engager le budget de l’évaluation finale.
5 Comment choisir un modèle pour le développement de jeux par IA : maîtriser le coût en tokens des tâches complexes
5.1 Le taux de réussite détermine le coût total
Le coût complet d’un développement se compose de trois parties :
Coût total de la tâche = coût d’invocation du modèle + coût d’exécution des outils + coût de correction manuelle
En intégrant le taux de réussite, l’indicateur de comparaison le plus utile devient le « coût par version validée » : la dépense totale de toutes les tentatives divisée par le nombre de réussites. Imaginons que le modèle A coûte 100 dollars par tentative avec un taux de réussite de 80 %, soit environ 125 dollars par version validée ; le modèle B coûte 30 dollars par tentative avec un taux de réussite de 20 %, soit environ 150 dollars par version validée, sans compter le temps passé à diagnostiquer les versions ratées. Dans cet exemple, le modèle au prix unitaire le plus bas revient donc plus cher.
La correction manuelle représente souvent le poste le plus lourd. Un ingénieur qui passe plusieurs heures à réparer un résultat généré peut coûter plus cher que l’ensemble des frais d’API de la session. Lors de l’évaluation, il faut donc consigner honnêtement la durée d’intervention humaine et la convertir dans le coût total en fonction du tarif horaire réel de l’équipe.
5.2 Trois stratégies de sélection de modèle
| Stratégie | Cas d’usage | Avantages | Coûts à surveiller |
|---|---|---|---|
| Modèle haute capacité | Architecture complexe, développement à long contexte, collaboration multi-modules, localisation de bugs complexes | Taux de réussite élevé, moins de réexécutions et de corrections manuelles | Prix unitaire élevé, il faut s’appuyer sur le cache pour maîtriser le coût des entrées |
| Modèle à bas coût | Fonctionnalités simples, explication de code, modifications répétitives, assistance aux tests | Prix unitaire faible, adapté aux appels à haute fréquence | Les tâches complexes peuvent échouer sur plusieurs tours, ce qui fait grimper le coût total |
| Collaboration multi-modèles | Un modèle se charge de l’architecture, un autre de l’implémentation, un modèle indépendant fait la revue de code | On associe capacité et prix selon chaque étape | Les passations entre modèles retransmettent le contexte, ce qui augmente les Token et les coûts de coordination |
L’économie d’une collaboration multi-modèles dépend du coût des passations. À chaque passation, il faut renvoyer le contexte du projet à un autre modèle, et le cache ne se partage pas entre des modèles différents. Le schéma collaboratif n’est rentable que lorsque le modèle à bas coût prend en charge suffisamment d’étapes et que les passations sont suffisamment rares — là encore, il faut le vérifier par des tests concrets.
💰 Conseil coûts : la collaboration multi-modèles implique d’appeler plusieurs fournisseurs de modèles au sein d’un même projet. En passant par APIYI apiyi.com avec la même Key et le même code d’intégration, vous réduisez la gestion de plusieurs comptes et l’adaptation des interfaces, ce qui facilite la répartition de l’architecture, de l’implémentation et de la revue entre différents modèles tout en centralisant le suivi des dépenses.
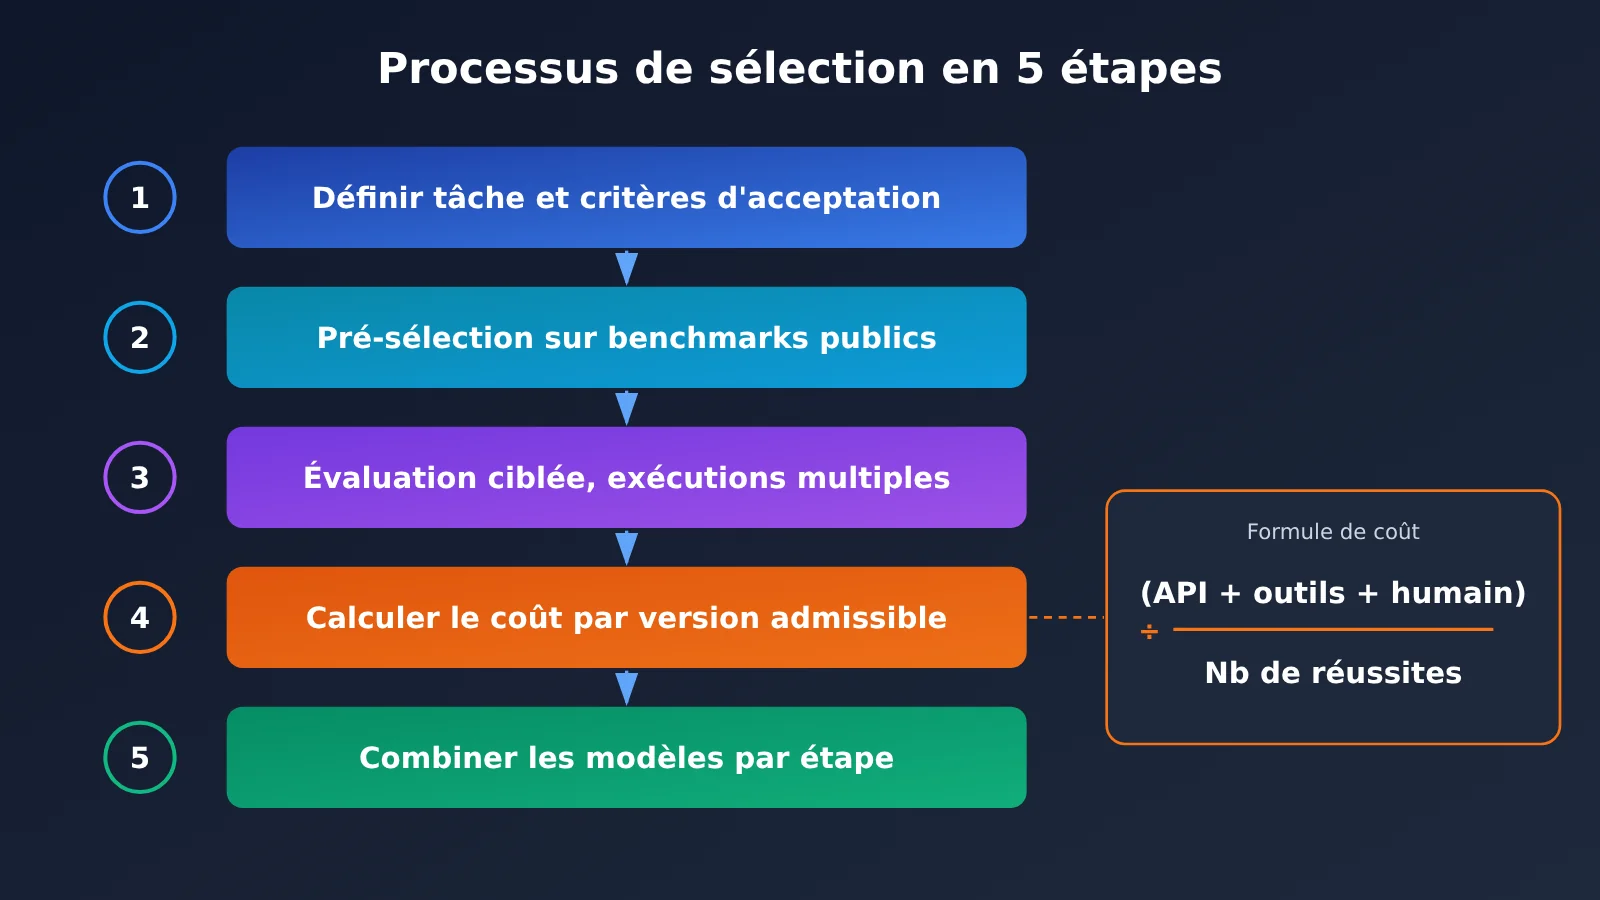
5.3 Un processus de sélection en cinq étapes, directement applicable
- Définir la tâche et les critères d’acceptation : rédigez noir sur blanc la liste des fonctionnalités, les plateformes cibles et le seuil de performance à ne pas franchir ; c’est sur cette base que vous jugerez du succès.
- Pré-filtrer avec des benchmarks publics : appuyez-vous sur les scores SWE-bench Verified et Aider Polyglot de la version actuelle, avec une configuration clairement documentée, pour écarter les modèles dont les capacités en code sont visiblement insuffisantes.
- Lancer une évaluation ciblée : dans un environnement unifié, faites tourner la même tâche de jeu 5 à 10 fois pour chaque modèle candidat, en relevant les dix indicateurs de la section 4.2.
- Calculer le coût de chaque version qualifiée : frais d’API + frais d’outils + frais de correction manuelle, le tout divisé par le nombre de réussites.
- Combiner les modèles selon les étapes : confiez les étapes complexes aux modèles au taux de réussite élevé, et les étapes répétitives aux modèles bon marché ; ensuite, mesurez si cette combinaison fait réellement des économies.
Les prix bougent : Gemini 4 Argon, par exemple, a déjà annoncé un ajustement tarifaire applicable au 1er décembre. Conservez les données brutes de tokens dans vos résultats d’évaluation ; en cas de changement de prix, il suffit de réinjecter le prix unitaire pour actualiser les conclusions.
6 FAQ : questions fréquentes sur le choix d’un modèle d’IA pour le développement de jeux
Q1 : Les 550 dollars de Saltline correspondent-ils à une facture réelle ?
Non, il ne s’agit pas d’une facture auditée. Les 550 dollars sont une estimation réalisée par le développeur Felix Rieseberg à partir des tarifs de l’API ; les données qui l’accompagnent (environ 8 heures, environ 445 millions de tokens d’entrée et environ 2,7 millions de tokens de sortie) proviennent également de ses propres déclarations. Une grande partie des entrées a bénéficié du cache, et la proportion exacte d’écriture et de lecture du cache n’a pas été communiquée.
Q2 : Le modèle au prix unitaire le plus bas est-il vraiment le plus économique ?
Tout dépend du taux de réussite. Le prix unitaire ne détermine que le coût par token ; le nombre de tokens nécessaires pour accomplir une tâche, le nombre de relances et le temps de correction manuelle dépendent tous des capacités du modèle. La comparaison n’a de sens qu’en calculant « coût total ÷ nombre de réussites ».
Q3 : Le modèle classé premier sur SWE-bench est-il le plus adapté au développement de jeux ?
SWE-bench Verified mesure l’ingénierie logicielle sur de vrais dépôts open source, mais sa couverture des shaders, de la compréhension de l’espace 3D, du rendu temps réel et du ressenti des interactions reste limitée. Il convient pour un premier filtrage ; pour le développement de jeux, un classement final nécessite des évaluations dédiées.
Q4 : Les scores du rapport NIST peuvent-ils représenter les modèles actuels ?
Non. Le rapport NIST CAISI a été publié en 2025 et portait sur des modèles historiques comme GPT-5, Opus 4, DeepSeek V3.1, ainsi que sur des configurations expérimentales spécifiques. Pour les nouveaux modèles de novembre 2026, il faut rechercher des évaluations spécifiques à leur version.
Q5 : Comment mettre en place rapidement une évaluation comparative de plusieurs modèles ?
Passer par une plateforme d’agrégation proposant une interface compatible OpenAI est la solution la plus simple. Après vous être inscrit sur APIYI (apiyi.com) pour obtenir une clé API, il suffit de définir le `base_url` du script de cet article sur `https://api.apiyi.com/v1` et de modifier le paramètre `model` pour tester plusieurs modèles avec le même script. Les nouveaux utilisateurs peuvent d’abord valider le script avec le quota gratuit.
Q6 : Quelle est la méthode la plus précise pour comptabiliser le coût en tokens lors d’une évaluation ?
Fiez-vous au champ `usage` de la réponse de l’API : additionnez à chaque appel les tokens d’entrée standard, les lectures de cache et les tokens de sortie, puis calculez selon les tarifs officiels du jour de l’appel et les paliers de facturation. Les frais supplémentaires (écriture de cache, paliers de vitesse, etc.) doivent être ajoutés séparément selon les règles de chaque fournisseur. Lors d’un appel via APIYI (apiyi.com), vous pouvez aussi recouper vos calculs avec l’historique de consommation dans le back-office de la plateforme.
Q7 : Un prototype de jeu généré par IA peut-il être mis en ligne directement ?
Des prototypes comme Saltline prouvent qu’un modèle peut produire une version jouable sans retour humain, mais une mise en ligne commerciale implique la compatibilité multi-navigateurs, l’adaptation mobile, l’optimisation des performances et la maintenance sur le long terme. Les jeux de navigateur dépendent du matériel local et du navigateur ; la page de Saltline signale d’ailleurs des problèmes comme une initialisation lente ou la nécessité de passer en qualité basse en cas de saccades. Les coûts de test et d’optimisation avant la mise en ligne doivent être intégrés au coût de développement complet.
7 Points clés : choisir un modèle d’IA pour le développement de jeux
- L’indicateur central : comparez le coût de bout en bout par version validée, pas le prix au million de tokens.
- La facture Saltline : environ 550 $ selon l’estimation du développeur lui-même, dont près de 108 $ côté sortie, le reste côté entrée.
- Le cache change l’ordre de grandeur : sur les tâches longues, l’entrée pèse l’essentiel ; c’est le prix de lecture du cache et le taux de hit qui comptent le plus.
- Les prix ont une date de péremption : ceux de cet article valent au 2026-11-16, et Gemini 4 Argon doit voir son tarif changer à partir du 1er décembre.
- Les benchmarks servent de premier filtre : SWE-bench et Aider mesurent la programmation en général ; les capacités en jeu vidéo méritent une évaluation dédiée.
- Plusieurs exécutions : lancez chaque modèle 5 à 10 fois dans les mêmes conditions et concluez sur le taux de réussite, pas sur un résultat isolé.
- Pour se lancer : passez d’un modèle à l’autre via l’interface unifiée d’APIYI apiyi.com, pratique pour comparer les coûts avec un seul et même script.
8 En résumé : la méthode pour choisir un modèle capable de développer un jeu en autonomie
Pour qu’une IA développe seule un jeu de A à Z, trois idées résument l’essentiel du choix de modèle :
- Compter tous les coûts : le coût total d’une tâche inclut l’invocation du modèle, l’exécution des outils et les corrections humaines ; les frais d’API n’en sont qu’un poste parmi d’autres.
- Tester réellement les capacités : les benchmarks publics servent au premier tri, mais le classement final pour le développement de jeux vient d’évaluations spécialisées, répétées dans des conditions identiques.
- Combiner selon les étapes : un modèle à fort taux de réussite pour les étapes complexes, un modèle bon marché pour les tâches répétitives — et là aussi, la combinaison doit être validée par des tests.
Saltline donne un ordre de grandeur à garder en tête : une seule invite, environ 8 heures de travail et une facture estimée à près de 550 $ pour produire un prototype 3D jouable dans le navigateur. Combien coûtera votre projet ? Tout dépend de la complexité de la tâche et du taux de réussite des modèles retenus. La voie la plus fiable reste de lancer votre propre évaluation avec le cadre décrit dans cet article.
Le plus simple est de monter rapidement un environnement de comparaison multi-modèles via APIYI apiyi.com : la plateforme fournit une interface compatible OpenAI ainsi qu’un crédit offert aux nouveaux utilisateurs, de quoi mesurer prix et taux de réussite dans un même jeu de scripts.
Références
- Page de démo autonome de Saltline : explications sur l’essai du jeu et la FAQ
- Lien :
saltline.games -
Description : contient des informations sur l’expérience de jeu, notamment l’initialisation, le changement de qualité graphique et les commandes
-
Miroir du code et README de Saltline : attribution des données côté développeur
- Lien :
github.com/realcodebear/saltline-fable-5.2 -
Description : documente la date de génération, les tokens et la source de l’estimation des coûts
-
Dépôt de la version chinoise de Jimao : archive de la version chinoise de Saltline
- Lien :
github.com/Megasu/jimao-3a-game -
Description : fournit des données comme la taille du fichier index.html
-
Spécifications et tarifs du modèle Claude Fable 5.2 : documentation officielle d’Anthropic
- Lien :
platform.claude.com/docs/en/models/fable-5-2/overview -
Description : prix des entrées, des sorties, du cache et du Fast Mode
-
Documentation du modèle GPT-6 Astra : tarifs officiels d’OpenAI
- Lien :
developers.openai.com/api/docs/models/gpt-6-astra -
Description : les prix du niveau de traitement standard font référence ici
-
SWE-bench Verified : page officielle du benchmark en ingénierie logicielle
- Lien :
swebench.com/verified.html -
Description : 500 tâches vérifiées manuellement et configuration unifiée de mini-SWE-agent
-
Aider Leaderboards : résultats de l’évaluation Aider Polyglot
- Lien :
aider.chat/docs/leaderboards -
Description : consigne en même temps le taux de réussite, la consommation de tokens et le coût d’exécution
-
Rapport d’évaluation NIST CAISI (2025) : évaluation indépendante de modèles historiques
- Lien :
nist.gov/system/files/documents/2025/09/30/CAISI_Evaluation_of_DeepSeek_AI_Models.pdf - Description : contient les résultats historiques sur SWE-bench Verified ainsi que l’erreur standard
Auteur : équipe technique APIYI
Échanges techniques : n’hésitez pas à nous contacter depuis la page d’accueil du site APIYI apiyi.com ; pour davantage de ressources d’intégration, rendez-vous sur le centre de documentation docs.apiyi.com