Note de l’auteur : décryptage de la facture en tokens des tâches longues d’un Agent : pourquoi les tokens d’entrée en représentent la plus grande part et comment structurer le contexte pour mieux réutiliser le cache de préfixe.
Beaucoup d’équipes découvrent le problème en consultant leur facture mensuelle après avoir intégré des Agents à plusieurs étapes dans leur produit : l’utilisateur n’a formulé qu’une seule demande, mais la consommation de tokens est des dizaines de fois supérieure à celle d’une conversation ordinaire. Le premier réflexe consiste souvent à se dire que « le modèle est trop bavard » et à limiter la longueur des réponses. En réalité, l’essentiel des coûts vient des entrées, et surtout de l’historique du contexte, transmis à nouveau à chaque tour.
Ce n’est pas une simple supposition. De récents retours d’expérience publiés donnent des chiffres précis : dans des environnements de production en Chine, une requête utilisateur déclenche en moyenne environ 7,2 invocations du modèle ; dans une chaîne de 50 étapes, les tokens d’entrée représentent environ 99,4 % du total, contre 0,6 % pour les tokens de sortie. Les équipes chargées des moteurs d’inférence décrivent elles aussi les charges de travail des Agents de façon similaire : des préfixes longs, des sorties courtes et des cycles à plusieurs tours.
À retenir : cet article vous aidera à comprendre la structure de la facture en tokens des tâches longues d’un Agent, pourquoi le cache de préfixe réduit les coûts et comment organiser le contexte côté application grâce à 5 méthodes concrètes.
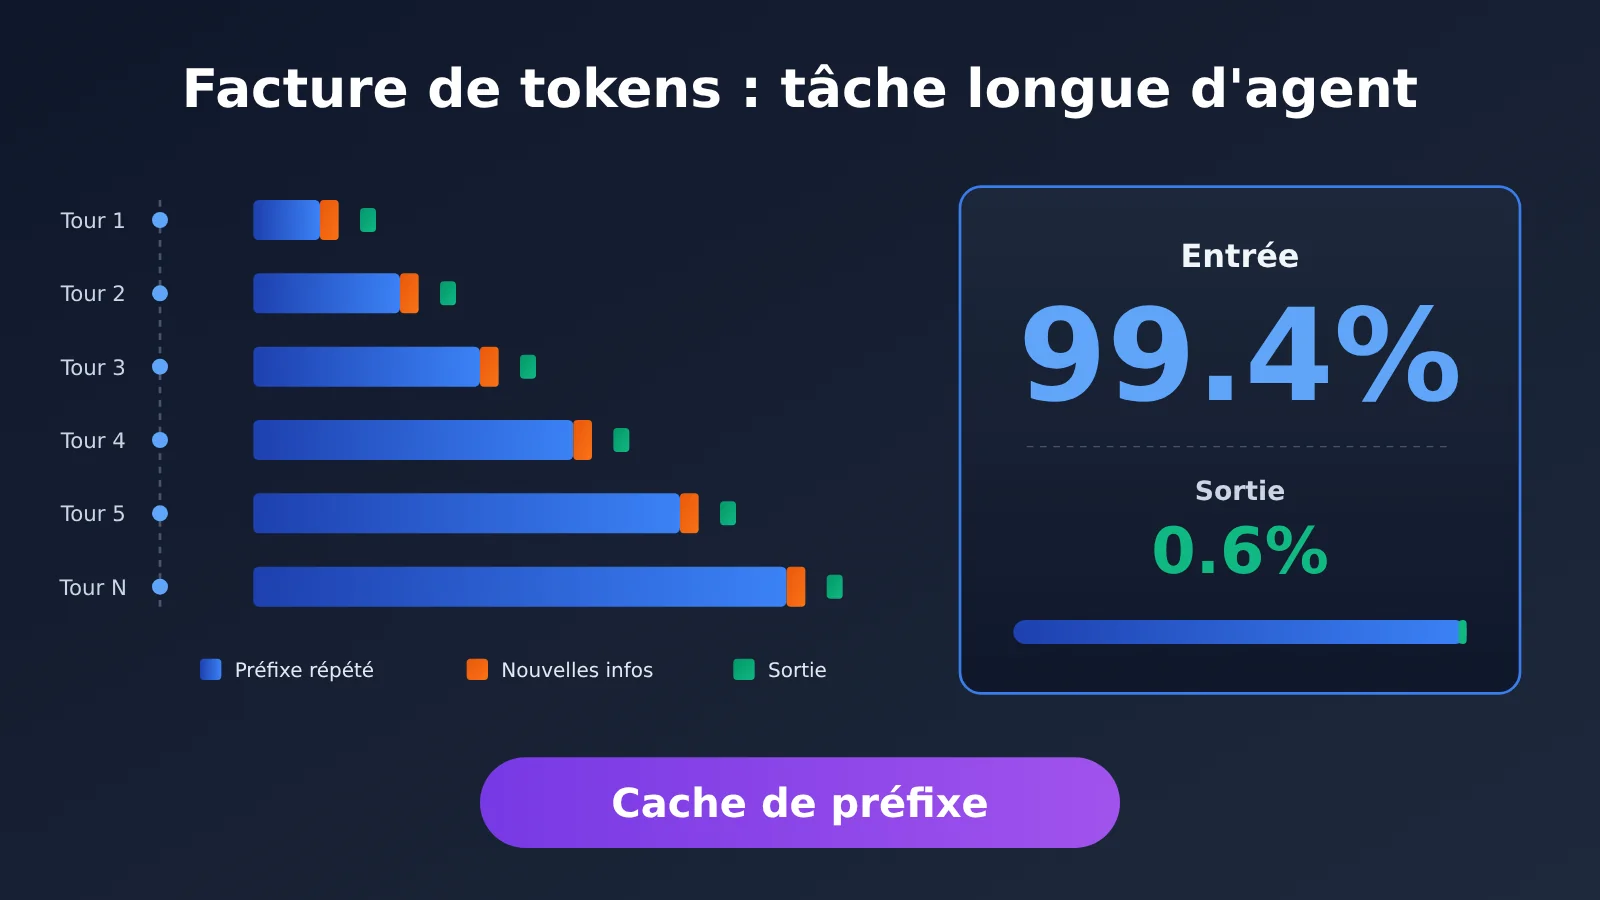
Les points clés de la facture en tokens des tâches longues d’un agent
Voici un résumé des conclusions de l’article. Nous détaillerons ensuite chaque point.
| Point clé | Explication | Ce que cela change pour vous |
|---|---|---|
| Le nombre d’appels se multiplie | Une requête utilisateur entraîne en moyenne environ 7,2 invocations du modèle. Les tâches complexes de plus de 50 étapes ne sont pas rares. | Estimez les coûts par « tâche », pas par « requête ». |
| Les entrées représentent l’essentiel | Dans une chaîne de 50 appels, les entrées représentent environ 99,4 % des tokens, contre 0,6 % pour les sorties. | Pour réduire les coûts, concentrez-vous d’abord sur les entrées : limiter les sorties a un effet plus modeste. |
| Le contexte répété est la cause principale | L’historique est renvoyé à chaque étape et le même contenu est facturé à plusieurs reprises. | Identifiez la véritable source des coûts. |
| Le cache de préfixe permet la réutilisation | Lorsqu’un préfixe identique est trouvé dans le cache, son calcul de prefill n’a pas besoin d’être répété. | Un contexte à la structure stable coûte moins cher. |
| La structure détermine le taux de réussite du cache | Gardez les invites et la structure des outils stables, placez les informations variables à la fin et compressez l’historique au bon moment. | Réduisez les coûts sans changer de modèle. |
Comprendre le coût en tokens des tâches longues d’un agent
La principale différence entre un agent et une conversation classique, c’est la « boucle ». Pour créer une présentation PowerPoint, par exemple, le système doit lire les documents, planifier le contenu, générer les diapositives une par une, utiliser des outils pour les produire et vérifier le résultat. Pour l’utilisateur, c’est une seule tâche. Pour le système, cela représente plusieurs étapes de raisonnement et plusieurs appels d’outils. À chaque étape, il peut aussi devoir relire le contexte et revenir en arrière si le résultat n’est pas satisfaisant.
À chaque appel, le modèle reçoit « l’invite système + les définitions des outils + l’ensemble de l’historique jusqu’ici + les nouvelles informations de l’étape ». L’historique s’allonge, alors que chaque étape n’ajoute que peu de contenu. Après plusieurs dizaines d’étapes, le même préfixe a donc été facturé autant de fois. C’est ainsi que les entrées finissent par représenter 99,4 % des tokens.
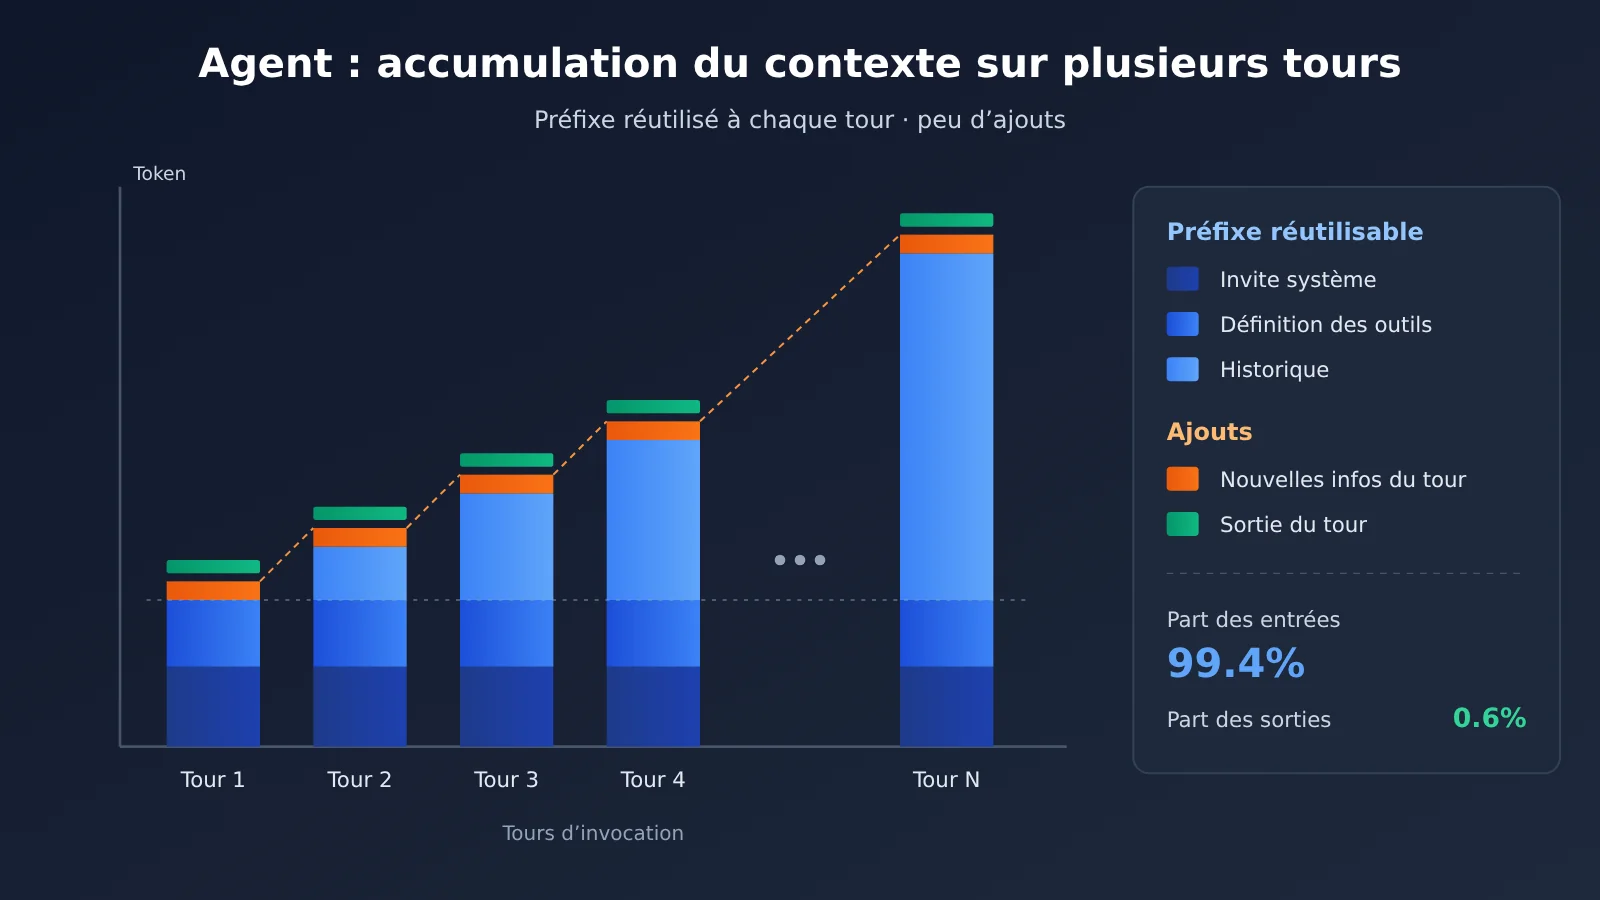
Pourquoi les tâches longues des agents consomment bien plus de tokens en entrée qu’en sortie
Du côté du moteur d’inférence, la structure devient plus claire. TokenSpeed prend l’exemple d’un agent de développement : le modèle réfléchit, appelle des outils, récupère les résultats, puis reprend son raisonnement. Le processus se compose ainsi de plusieurs cycles de requêtes courtes. La première requête peut déjà contenir un préfixe de contexte de plusieurs dizaines de milliers de tokens, tandis que chaque cycle suivant ne produit souvent que quelques centaines de tokens.
Le tableau ci-dessous compare les charges de travail d’un chat classique et d’un agent, pour vous aider à situer votre application.
| Dimension | Charge de travail d’un chat classique | Tâche longue d’un agent |
|---|---|---|
| Forme des requêtes | Une question, une réponse complète | Plusieurs cycles de requêtes courtes, entrecoupés d’appels d’outils |
| Longueur du préfixe | Généralement courte | Peut atteindre plusieurs dizaines de milliers de tokens dès le départ et augmente à chaque cycle |
| Sortie par cycle | Relativement longue | Souvent limitée à quelques centaines de tokens |
| Réutilisation du contexte | Libéré après une seule utilisation | Le même préfixe est transmis à plusieurs reprises pendant la tâche |
| Principal facteur de coût | L’entrée et la sortie ont toutes deux un poids important | L’entrée, surtout les préfixes répétés, représente l’essentiel du coût |
Comment fonctionne le cache de préfixe dans les tâches longues des agents
Le moteur d’inférence traite une requête en deux étapes : pendant le prefill, il calcule l’ensemble de l’entrée et génère le cache KV ; pendant le decode, il génère ensuite les tokens de sortie un par un. Avec un agent, un préfixe de plusieurs dizaines de milliers de tokens doit passer par le prefill à chaque cycle : c’est là que se concentre le coût de calcul. Si ce préfixe a déjà été calculé et que le résultat se trouve encore dans le cache, il peut être réutilisé directement, ce qui évite cette étape de prefill.
Les équipes chargées des moteurs d’inférence considèrent le taux de réutilisation du cache KV comme un facteur clé du coût d’inférence. Selon la présentation, le taux de réutilisation du cache de DeepSeek dépasserait 99 %, alors que la plupart des systèmes du secteur se situent actuellement entre 70 % et 80 %. Pour les charges de travail des agents, le taux de correspondance des préfixes pendant le prefill dépasse généralement 90 % : en cas de correspondance, seuls quelques centaines de tokens supplémentaires doivent être calculés.
Un autre détail passe facilement inaperçu : le cache de préfixe est comparé segment par segment, en partant du début. À ses débuts, TokenSpeed s’est inspiré de SGLang et utilisait un Radix Tree pour gérer ce cache. Chaque nœud de l’arbre correspondait à une séquence de tokens, et la requête était comparée à partir de la racine. Même si TokenSpeed est ensuite passé à une architecture Flat KV, la réutilisation se fait toujours par blocs logiques de taille fixe, soit 128 tokens. Pour les développeurs d’applications, la conséquence est simple : si un seul token diffère au début, le contenu qui suit ne peut plus être réutilisé.
Comment organiser le contexte pour améliorer le taux de réussite du cache de préfixe lors des tâches longues d’un agent
Une fois le fonctionnement du cache compris, la stratégie est claire : garder le début de chaque requête aussi long et stable que possible. L’équipe WorkBuddy fixe les invites et la structure des outils, place les informations variables à la fin du contexte, puis compresse l’historique lorsque celui-ci devient trop long. Voici 5 pratiques concrètes pour appliquer cette méthode.
| Pratique | Action concrète | Contre-exemple courant |
|---|---|---|
| 1. Stabiliser l’invite système | Garder l’invite système identique mot pour mot et regrouper les changements de version | Insérer l’heure actuelle, le nom d’utilisateur ou des exemples aléatoires au début |
| 2. Stabiliser la structure des outils | Garder le même ordre dans la liste des outils et les mêmes descriptions de paramètres | Ajouter ou retirer des outils à chaque tour selon les besoins, ou modifier l’ordre de sérialisation |
| 3. Placer les informations variables à la fin | Ajouter les horodatages, les observations du tour en cours et les états dynamiques à la fin | Placer la « progression actuelle » au début de l’invite système |
| 4. Ajouter à l’historique sans le modifier | Garder l’historique déjà envoyé tel quel et ajouter les nouveaux contenus à la suite | Reformater ou réorganiser les messages précédents à chaque tour |
| 5. Compresser l’historique par étapes | Lorsque le contexte devient trop long, le compresser une fois à un point de contrôle, puis continuer à ajouter les nouveaux contenus | Régénérer le résumé à chaque tour, ce qui modifie constamment le préfixe |
Tâches longues avec un agent : stabiliser les invites et la structure des outils
Les points 1 et 2 sont les plus faciles à négliger. De nombreux frameworks ajoutent la date du jour à l’invite système ou sélectionnent les outils dynamiquement à chaque étape. Dans les deux cas, le début de la requête change à chaque tour et le cache de préfixe ne peut plus être utilisé dès le premier token. Une approche plus fiable consiste à ne placer que les règles et le rôle dans l’invite système, puis à ajouter la date et les autres informations variables à la fin, dans un message ordinaire. De même, listez tous les outils dès le départ et précisez dans l’invite ceux qui peuvent être utilisés à chaque étape, plutôt que de modifier la liste elle-même.
Faites aussi attention à la sérialisation. Si l’ordre des champs JSON d’une même définition d’outil varie d’un processus à l’autre, les préfixes seront différents au niveau des octets. Il est donc conseillé de trier les définitions d’outils de manière stable avant l’envoi et de consigner le hash du préfixe dans les journaux. Cela facilite le diagnostic lorsqu’un préfixe apparemment inchangé ne bénéficie pas du cache.
Tâches longues avec un agent : arbitrer entre compression de l’historique et réutilisation du cache
Le point 5 implique un compromis. Compresser l’historique réduit la longueur de l’entrée, mais modifie le préfixe et empêche nécessairement l’utilisation du cache à ce tour. Compresser à chaque tour revient donc à renoncer à sa réutilisation. Il est plus judicieux de définir un seuil : par exemple, compresser lorsque le contexte atteint une certaine longueur ou à la fin d’une sous-tâche. La version compressée devient alors un nouveau préfixe stable, auquel on continue d’ajouter des éléments sans réécrire l’existant.
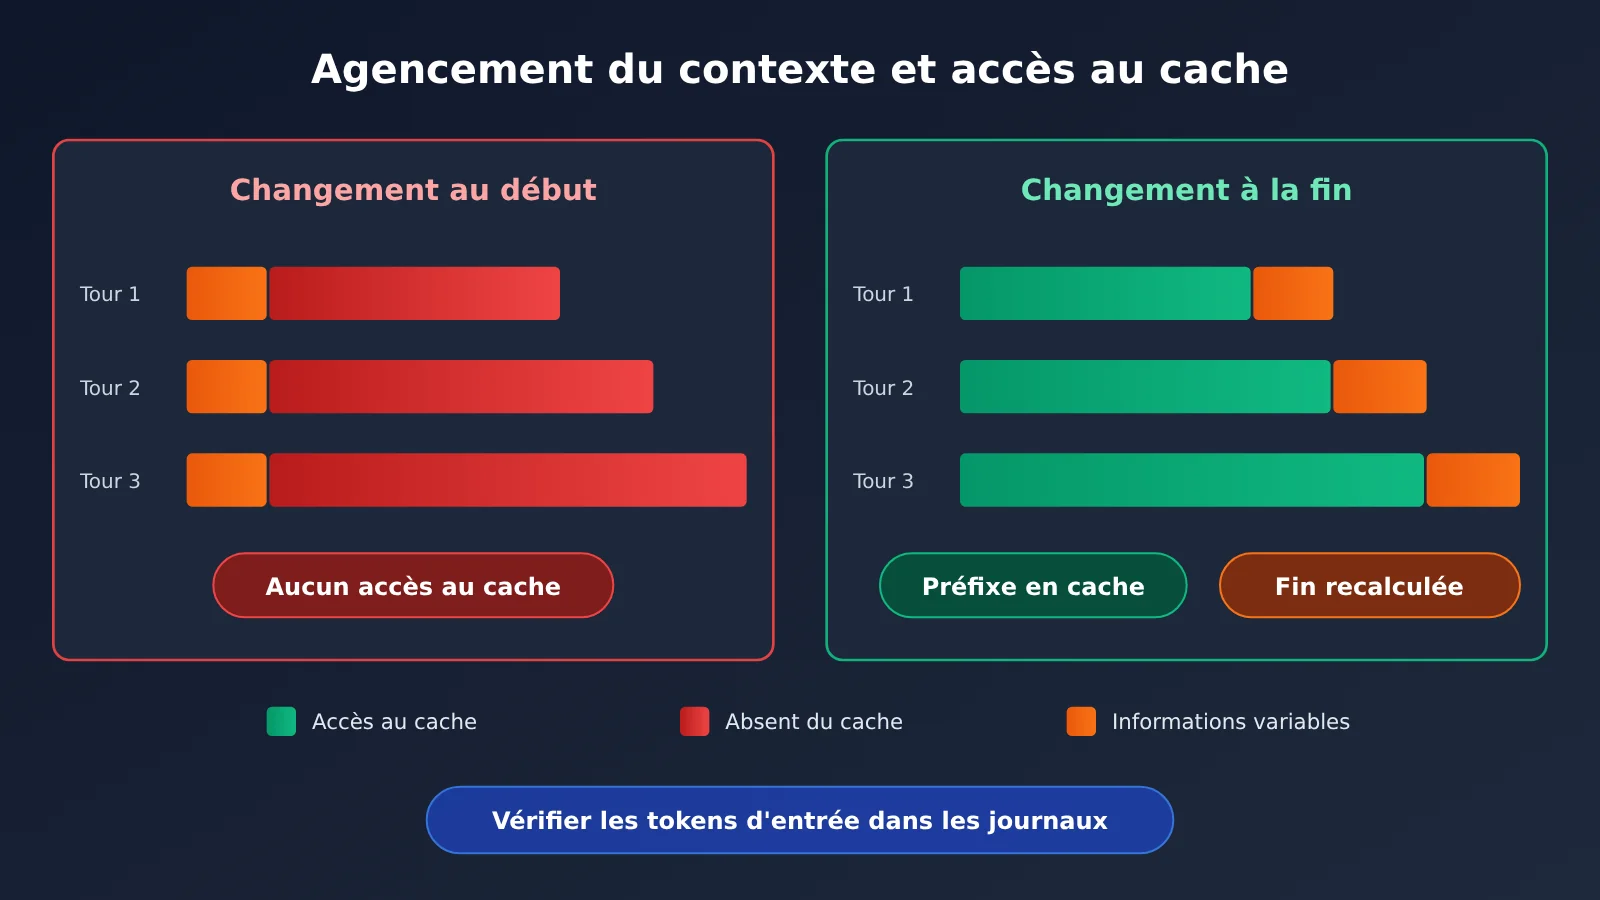
Sur un seul tour, les deux dispositions ci-dessus semblent presque identiques. Mais sur une tâche longue de plusieurs dizaines de tours, la différence de facturation devient notable. Pour savoir à quel cas correspond votre application, le plus simple est d’examiner l’évolution des tokens d’entrée à chaque tour dans les journaux d’appel. APIYI apiyi.com propose une facturation unifiée, des statistiques d’utilisation et des journaux d’appel. Les données de plusieurs modèles peuvent ainsi être comparées au même endroit, ce qui facilite ce type d’analyse de la structure des coûts.
Guide pratique pour optimiser la facture en tokens des tâches longues d’un agent
Cette section ne contient pas de code : elle propose une série d’étapes concrètes à suivre dans l’ordre.
Étape 1 : répartir la facture en tokens par tâche
- Générez un ID pour chaque tâche utilisateur et consignez-le dans les journaux à chaque invocation du modèle liée à cette tâche.
- Relevez le nombre de tokens d’entrée et de sortie dans les informations
usagede chaque réponse. Certains fournisseurs indiquent aussi séparément le nombre de tokens servis depuis le cache ; consultez leur documentation officielle pour connaître les noms exacts des champs. - Regroupez trois indicateurs par tâche : le nombre d’appels, le ratio entre tokens d’entrée et de sortie, et la proportion de tokens servis depuis le cache.
Si vous utilisez des modèles de plusieurs fournisseurs, leurs journaux ne suivent souvent pas les mêmes conventions. En passant par l’interface unifiée d’APIYI, vous pouvez consulter les détails d’utilisation et l’historique des appels de chaque modèle dans une même console. En les associant aux ID de tâche que vous avez enregistrés, vous obtenez une vue complète du coût de chaque tâche et des étapes où il a été engagé.
Étape 2 : repérer où le préfixe change
- Prenez deux requêtes consécutives d’une même tâche et comparez, section par section, l’invite système, les définitions des outils et l’historique des messages pour vérifier qu’ils sont identiques caractère par caractère.
- Repérez en particulier où apparaissent les champs dynamiques, comme les horodatages, les nombres aléatoires ou l’état utilisateur.
- Vérifiez que l’ordre de sérialisation des définitions d’outils et des messages reste stable d’une requête à l’autre.
Étape 3 : appliquer les 5 pratiques et refaire les tests
- Déplacez le contenu dynamique à la fin et figez l’invite système ainsi que la liste des outils.
- Définissez un seuil de compression de l’historique et effectuez la compression à des points de contrôle plutôt qu’à chaque tour.
- Exécutez les versions avant et après modification sur le même ensemble de tâches de test, puis comparez les tokens d’entrée par tâche et la proportion de tokens servis depuis le cache.
🚀 Conseil pour démarrer : comparez impérativement les versions avant et après modification avec les mêmes tâches et le même modèle, faute de quoi les résultats ne seront pas exploitables. Grâce à l’interface unifiée d’APIYI, vous pouvez retester avec un autre modèle sans adapter chaque interface séparément. Les statistiques d’utilisation sont également centralisées, ce qui facilite l’analyse distincte de deux variables : l’optimisation de la structure et les différences entre modèles.
Les limites des estimations de coût
WorkBuddy a publié une estimation fondée sur la taille de ses tâches et le tarif catalogue de l’offre phare de TokenHub : avec un taux de cache de 90 %, le coût estimé par tâche pourrait passer d’environ 21,06 yuans à 3,36 yuans. Ces chiffres correspondent toutefois à une longueur de contexte et à des conditions tarifaires précises. Comme toutes les conditions n’ont pas été rendues publiques, il est impossible de reproduire le calcul ; vous ne pouvez pas non plus les appliquer directement à votre application.
| Facteur | Pourquoi il change le résultat | Ce qu’il faut vérifier |
|---|---|---|
| Longueur du contexte | Plus le préfixe est long, plus sa réutilisation depuis le cache permet d’économiser | La longueur moyenne du préfixe de vos tâches |
| Facturation du cache | La réduction appliquée aux tokens servis depuis le cache varie selon le fournisseur | Les tarifs du cache dans la documentation officielle du modèle cible |
| Conditions d’activation du cache | Les règles de longueur minimale, de durée de validité, etc. varient | Les règles d’activation et d’expiration dans la documentation officielle |
| Intervalle entre les appels | Si l’intervalle entre deux tours est trop long, le cache peut avoir expiré | Si le temps d’exécution des outils est compatible avec la durée de validité du cache |
| Nombre d’étapes | Plus une tâche comporte d’étapes, plus les préfixes répétés s’accumulent | La répartition du nombre d’étapes dans les tâches réelles |
Réduire le coût en tokens des tâches longues d’un agent : les pratiques complémentaires
En plus de la structure du contexte, ce même partage présente deux stratégies côté application, à utiliser avec la mise en cache des préfixes.
- Choisir le modèle selon l’étape : selon l’équipe WorkBuddy, environ 80 % des étapes simples peuvent être confiées à un modèle léger, ce qui réduit le coût par tâche d’environ 57 %. La compilation d’informations ou la conversion de formats ne nécessitent pas forcément un modèle haut de gamme.
- Traiter les erreurs selon leur cause : en cas d’expiration du délai, de refus de requête ou de panne du fournisseur, limitez les tentatives, ajustez le contexte ou changez de modèle selon la cause. Des tentatives sans limite peuvent entraîner la facturation répétée d’un même long préfixe.
Attention : changer de modèle implique aussi de changer de cache. La réutilisation du préfixe doit alors repartir de zéro. Lors de la conception du routage, mieux vaut donc garder autant que possible les étapes successives d’une même sous-tâche sur le même modèle et réserver les changements de modèle aux transitions entre sous-tâches.
Questions fréquentes (FAQ)
Q1 : Qu’est-ce que le cache de préfixe dans les tâches longues d’un Agent ?
Le cache de préfixe permet au service d’inférence de conserver un préfixe d’entrée déjà calculé (KV Cache). Lorsque les requêtes suivantes commencent de la même façon, il le réutilise directement, ce qui évite de recalculer cette partie lors du prefill. Comme un Agent transporte une grande partie du même historique à chaque tour, il se prête particulièrement bien à cette réutilisation.
Q2 : Quelle est la différence entre le cache de préfixe et la compression de l’historique ?
Le cache de préfixe ne réduit pas le contenu en entrée : il rend simplement le calcul des parties répétées moins coûteux. La compression de l’historique raccourcit directement l’entrée, mais modifie le préfixe et invalide donc le cache pour le tour en cours. Les deux approches sont complémentaires : ajoutez les nouveaux éléments à la suite pour favoriser les accès au cache, puis compressez l’historique à un point de contrôle.
Q3 : La proportion de 99,4 % de tokens en entrée s’applique-t-elle à tous les Agents ?
Pas nécessairement. Ce chiffre provient du partage d’une chaîne de 50 appels. Pour les tâches qui comportent moins d’étapes ou produisent des sorties plus longues à chaque tour, la proportion d’entrée sera plus faible. Mais tant que la structure repose sur « un long préfixe, une sortie courte et plusieurs tours », l’entrée représente généralement la majeure partie des tokens. Le mieux est de le mesurer avec vos propres journaux.
Q4 : Dans quels cas vaut-il le plus la peine d’optimiser le cache de préfixe pour un Agent ?
– **Agent de programmation** : le contexte du dépôt est long et les cycles de lecture de fichiers, de modification du code et d’exécution des tests sont fréquents
– **Génération de documents ou de PPT** : les documents sources sont lus, puis le contenu est généré page par page, avec un préfixe très répétitif
– **Agent d’analyse de données** : la structure des tables et les descriptions des indicateurs restent fixes ; seuls les résultats des requêtes s’ajoutent à chaque tour
Q5 : Comment comprendre rapidement la répartition des tokens d’entrée et de sortie de mon application ?
Le plus simple consiste à regrouper les données d’utilisation de chaque tour par ID de tâche. Si votre application utilise plusieurs modèles, vous pouvez les invoquer de façon unifiée via APIYI apiyi.com. La plateforme fournit des statistiques d’utilisation et des journaux d’appels, ce qui facilite l’analyse des entrées et des sorties par modèle et par période. Pour connaître la prise en charge du cache d’invites et la facturation propres à chaque modèle, consultez la documentation de la plateforme.
Q6 : Quelles sont les limites connues du cache de préfixe ?
– Les conditions d’activation varient selon le fournisseur, notamment la longueur minimale et la durée de validité : consultez chaque documentation officielle
– Si l’exécution d’un outil prend trop de temps, le cache peut expirer avant le tour suivant
– Changer de modèle ou modifier l’invite système invalide l’ensemble du cache
– La réduction appliquée aux parties trouvées dans le cache varie selon le modèle ; les économies doivent être vérifiées par des mesures
Facture de tokens des tâches longues d’un agent : l’essentiel à retenir
- Calculez le coût par tâche : une requête représente environ 7,2 appels, et une tâche longue peut dépasser 50 étapes.
- L’entrée pèse le plus lourd : sur une chaîne de 50 étapes, elle représente environ 99,4 % du volume ; réduire la sortie a donc un effet limité.
- Le cache compare les préfixes depuis le début : si un seul token diffère au début, le contenu qui suit ne peut pas être réutilisé.
- La structure compte plus que le modèle : gardez les invites et la structure des outils fixes, et placez les informations variables à la fin.
- Cadencez la compression : compressez une fois à un point de contrôle, plutôt que de réécrire le préfixe à chaque tour.
- N’extrapolez pas les estimations : les coûts publiés dépendent de longueurs et de tarifs précis ; refaites les mesures pour votre cas.
- Observez avant d’optimiser : utilisez les statistiques d’utilisation et les journaux d’appels d’APIYI pour analyser la structure de votre facture.
En résumé
Les principaux enseignements sur la facture de tokens des tâches longues d’un agent :
- Structure de la facture : le coût provient surtout de l’historique du contexte, transmis à nouveau à chaque tour. Les tokens d’entrée représentent la grande majorité du total.
- Principe de réduction des coûts : le cache de préfixe évite de recalculer le prefill pour les préfixes répétés. Son taux de réussite dépend de la structure du contexte.
- Mise en pratique : gardez les invites et les outils fixes, placez les informations variables à la fin, ajoutez les nouveaux éléments à l’historique sans le réécrire et compressez-le par étapes. Choisissez aussi le modèle en fonction de chaque étape.
Commencez par consacrer une semaine à analyser les journaux par tâche, afin de vérifier la part des entrées et le taux de réussite du cache dans votre cas. Appliquez ensuite les cinq pratiques présentées dans cet article, une par une. Si vous utilisez plusieurs modèles, APIYI sur apiyi.com permet d’y accéder depuis un point unique et de consulter les données d’utilisation et les journaux d’appels au même endroit. Vous pourrez ainsi évaluer l’effet réel de chaque optimisation à partir des mêmes données.
📚 Références
- Construire un moteur d’inférence LLM de nouvelle génération pour le raisonnement agentique : synthèse de la présentation de TokenSpeed à AICon 2026 Shenzhen
- Lien :
infoq.cn/article/YwAayF1ylWb7oN4P0lyC -
Description : caractéristiques des charges de travail des agents (« préfixes longs, réponses courtes »), taux de réutilisation du cache KV et conception du cache de préfixes
-
De l’invocation du modèle à la livraison des tâches : comment le MaaS entre en production avec les agents : synthèse de la session MaaS de Tencent Cloud
- Lien :
infoq.cn/article/zZutPTX8bsr6NWQYNC3A - Description : données partagées par WorkBuddy sur le nombre d’invocations, la part des données d’entrée, le cache de préfixes et le routage des modèles
Auteur : équipe technique APIYI
Échanges techniques : pour toute question sur l’invocation de plusieurs modèles et l’analyse de leur utilisation, contactez-nous sur APIYI apiyi.com. Pour en savoir plus, consultez notre documentation sur docs.apiyi.com