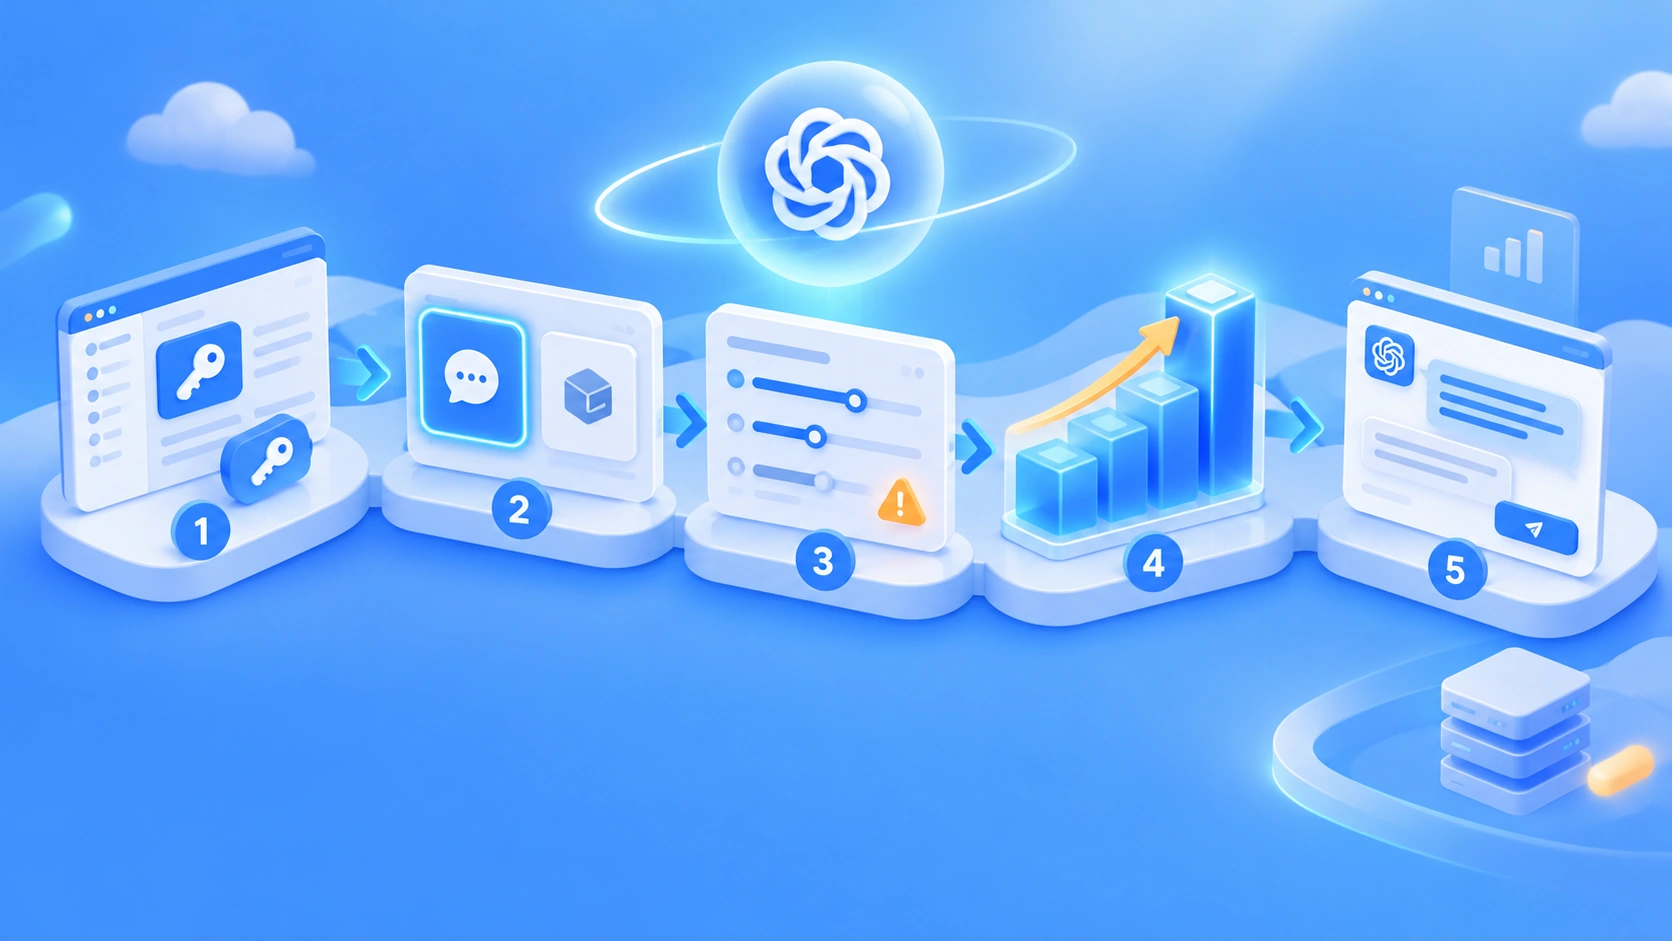
Nota del autor: Sigue el flujo de trabajo en la consola para completar en 5 pasos la integración de la API de GPT-6.1 Terra. Explica cómo elegir el endpoint, qué parámetros pueden dar problemas y cómo funciona la tarifa escalonada de 272K.
En resumen: para integrar GPT-6.1 Terra, la única decisión clave es elegir entre Responses y Chat Completions. Si necesitas llamar a herramientas, debes usar Responses. Si no, puedes reutilizar casi todo tu código actual: basta con cambiar el nombre del modelo.
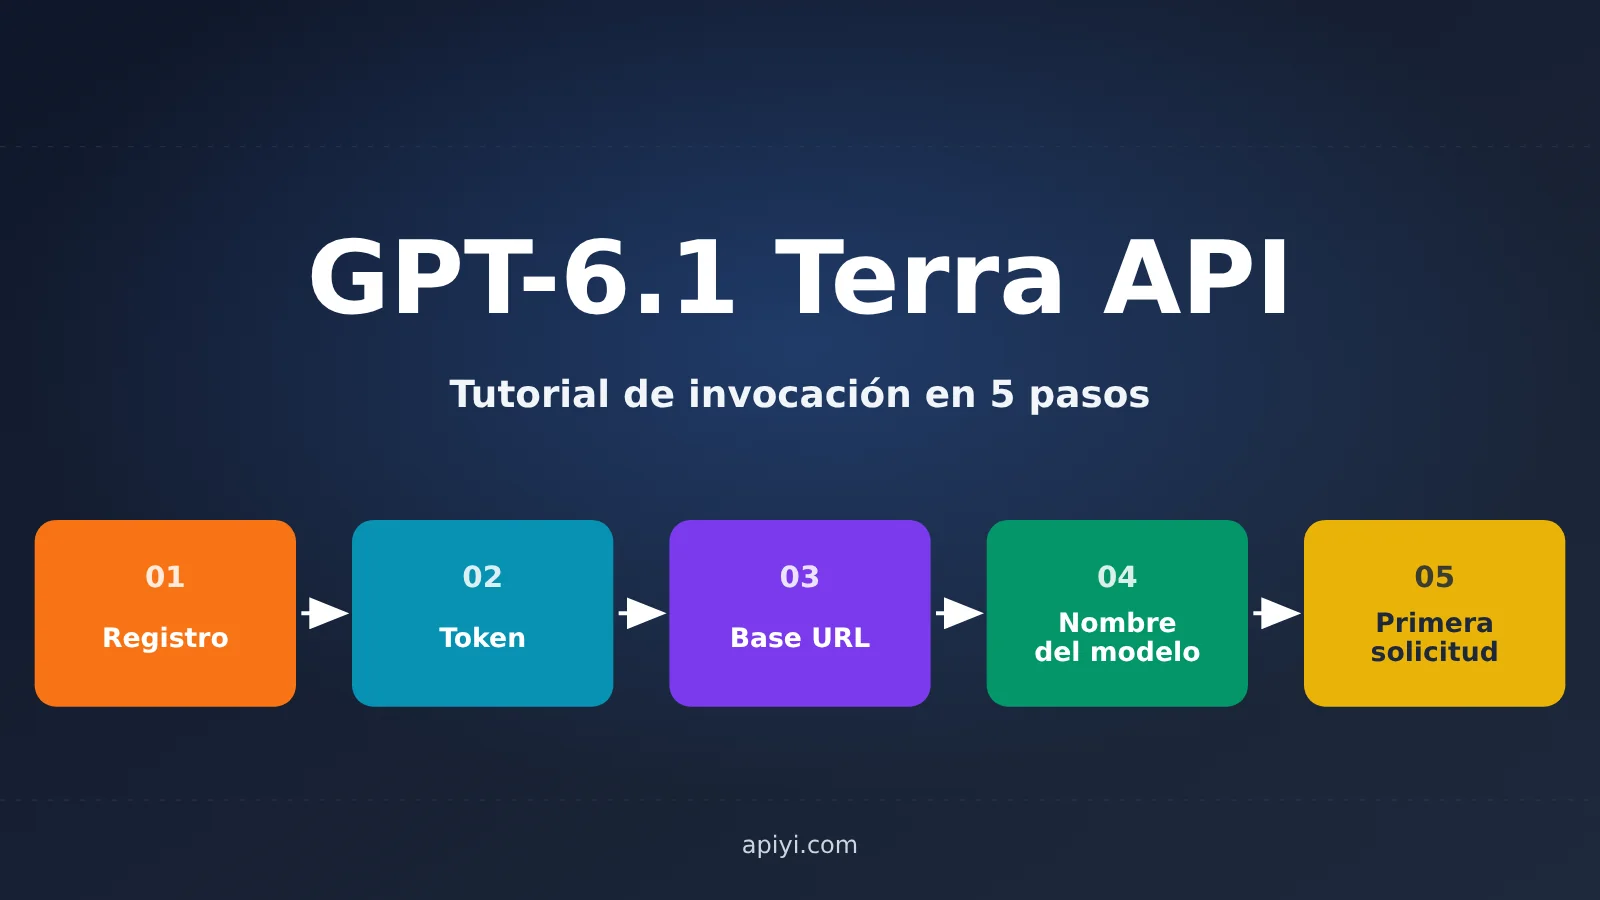
GPT-6.1 Terra se publicó el 2026-10-26 con el ID de modelo gpt-6.1-terra. La documentación oficial ya especifica los endpoints, los parámetros y las reglas de precios, así que esta información se puede verificar. El artículo sigue el orden de los pasos en la consola: registrarse → crear un token → encontrar la Base URL → introducir el nombre del modelo → enviar la primera solicitud. Cada paso incluye un criterio de verificación; la línea de comandos y el código se presentan como alternativas opcionales.
Qué conseguirás: al terminar, habrás verificado desde la consola todo el flujo de integración de la API de GPT-6.1 Terra y sabrás cómo evitar los errores 400 más habituales.
📌 Estado actual de la plataforma: al 2026-10-27,
gpt-6.1-terratodavía no aparece en la lista de modelos en tiempo real de APIYI apiyi.com. Lo añadiremos lo antes posible. Ya están disponibles otros modelos de la misma generación:gpt-6-astra,gpt-6-sol,gpt-6.1-solygpt-6-luna. Puedes usargpt-6.1-solpara verificar el flujo de integración. Consulta la lista de modelos de la plataforma para confirmar los modelos y sus precios.
Puntos clave de la API GPT-6.1 Terra
| Punto clave | Descripción | Qué significa para ti |
|---|---|---|
| ID del modelo | gpt-6.1-terra, publicado el 2026-10-26 |
Usa este valor en el campo model de la solicitud |
| Endpoints disponibles | Responses, Chat Completions y Batch | No admite endpoints como Realtime, Assistants ni Embeddings |
| Llamadas a herramientas | Solo Responses las admite | Si incluyes tools en una solicitud a Chat, fallará directamente |
| Contexto | 1.050.000 tokens en total, 922.000 de entrada por solicitud y 128.000 de salida | Es adecuado para documentos extensos, pero ten en cuenta el tramo de precios de 272K |
| Modalidades | Entrada de texto e imágenes; salida de texto | Para enviar imágenes, usa input_image en Responses |
| Fecha de corte del conocimiento | 2026-06-01 | Para obtener información más reciente, usa la herramienta web_search |
Límites de las capacidades de GPT-6.1 Terra
GPT-6.1 Terra admite streaming, salidas estructuradas, llamadas a funciones, file_search, entrada de imágenes, búsqueda web y caché de indicaciones. No admite ajuste fino ni salidas predictivas. Si tu proyecto anterior depende de modelos ajustados o de salidas predictivas, no podrás migrarlo directamente.
El endpoint Responses permite conectar muchas herramientas, entre ellas web_search, file_search, image_generation, code_interpreter, hosted_shell, apply_patch, skills, computer_use, mcp y tool_search. Esta es la razón fundamental para elegir Responses cuando necesites herramientas: en este modelo, Chat Completions solo sirve para conversaciones de texto.
Cómo llamar a la API de GPT-6.1 Terra: flujo de consola en 5 pasos
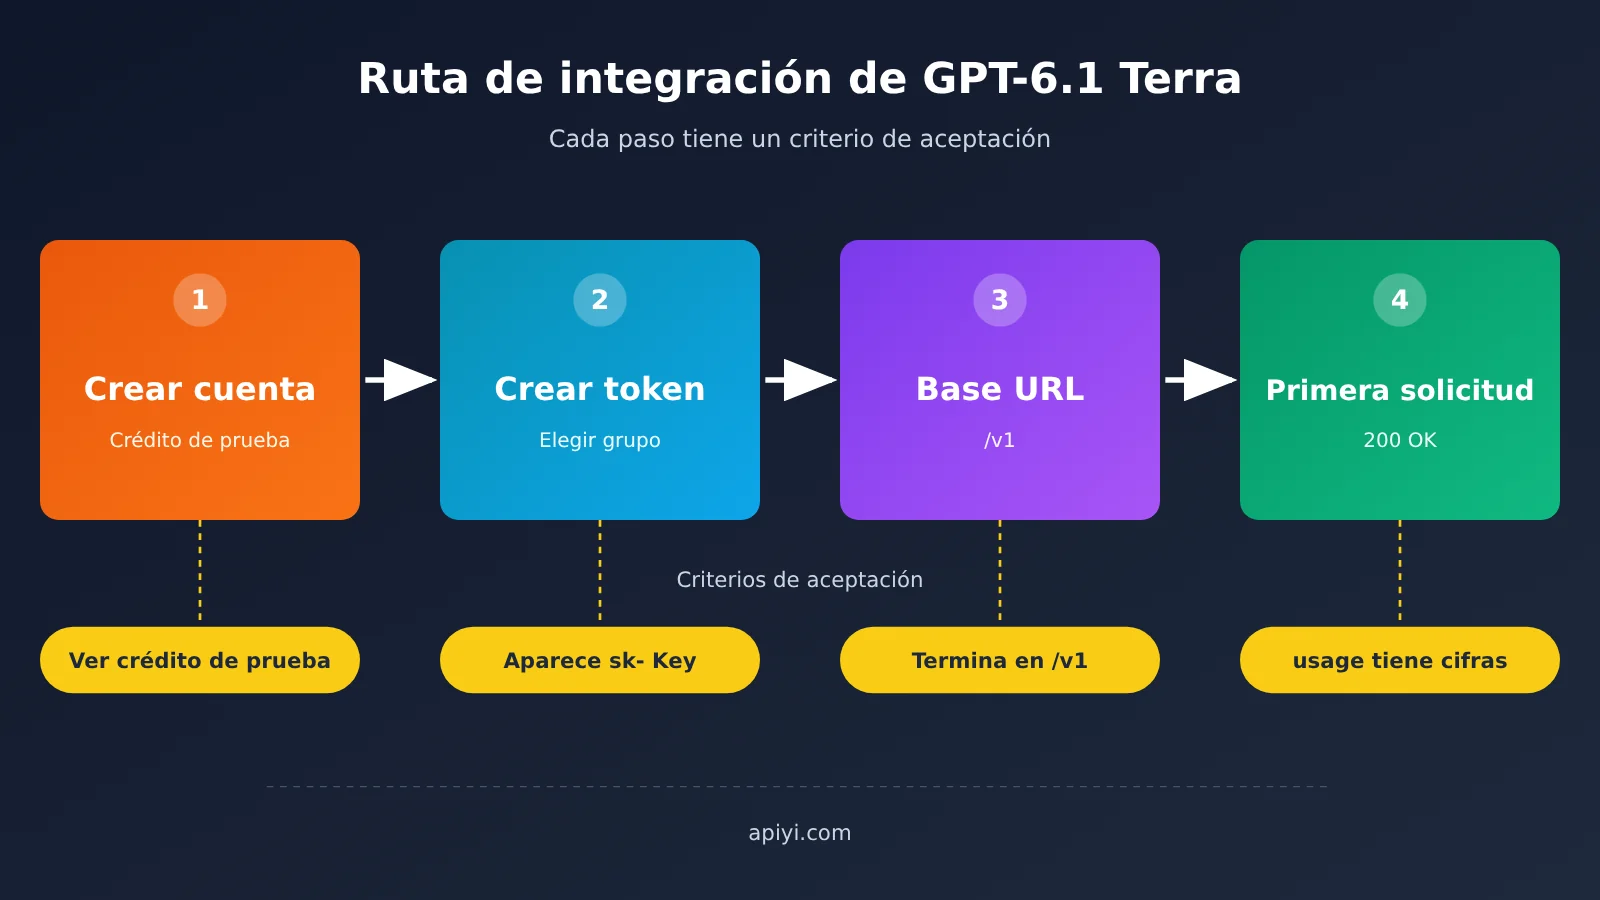
Paso 1: Crear una cuenta
- Abre APIYI en apiyi.com y regístrate con tus propios datos siguiendo las instrucciones de la página. La plataforma exige que cada persona se registre por sí misma.
- Las cuentas nuevas incluyen 0,05 dólares de crédito de prueba, así que puedes completar una invocación sencilla sin recargar saldo.
- Criterio de aceptación: después de iniciar sesión, ve a la consola y comprueba que el crédito de prueba aparece en la página de la cartera o del saldo.
- Si te quedas atascado: si no ves el crédito, confirma primero que has completado el registro. No recargues saldo todavía.
Si prefieres usar el canal oficial, crea una clave en la página API Keys de la plataforma de OpenAI. Para ello, la cuenta debe estar en una región admitida y tener saldo en el nivel Build; es decir, al menos 5 dólares.
Paso 2: Crea un token y elige el grupo adecuado
- Ve a la página de tokens de la consola,
api.apiyi.com/token, y haz clic en «Crear token». - En «Seleccionar grupo», elige uno. El grupo determina los modelos disponibles, el multiplicador de facturación y las rutas al proveedor.
defaultysviptienen el mismo precio que el servicio oficial;CodexReverseutiliza recursos de ingeniería inversa. - Criterio de verificación: después de guardar, debe aparecer en la lista de tokens una clave que empiece por
sk-. - Si te atascas, revisa: el «grupo» del usuario no es lo mismo que el grupo del token. El que realmente se aplica es el que seleccionas para el token.
Paso 3: Encuentra la Base URL
La Base URL depende del SDK; es muy fácil equivocarse al introducirla:
- SDK de OpenAI:
https://api.apiyi.com/v1, debe incluir/v1 - SDK de Anthropic: usa el dominio raíz, sin
/v1 - SDK de Google GenAI: usa el dominio raíz y configura
api_versioncomov1beta
Criterio de verificación: para la serie GPT-6.1, usa el SDK de OpenAI o un cliente compatible con OpenAI, y asegúrate de que la dirección termine en /v1. Si te atascas, revisa: si recibes un error 404, casi seguro que falta /v1 o lo has añadido dos veces.
Paso 4: Introduce el nombre del modelo
En el campo del modelo del cliente o de la herramienta de depuración, introduce el ID del modelo. Te recomendamos empezar con un modelo ligero como gpt-5.4-mini para comprobar que todo funciona y, después, cambiar a gpt-6.1-sol. Cuando gpt-6.1-terra esté disponible en la plataforma, solo tendrás que cambiar un campo. La plataforma no admite formatos de enrutamiento gratuito como auto o auto:free; no intentes usarlos.
Criterio de aceptación: el nombre del modelo coincide exactamente con el que aparece en la lista de modelos de la plataforma. Si te atascas: si aparece un error que indica que el modelo no existe, comprueba primero la ortografía en la lista de modelos y luego verifica que el grupo del token incluya ese modelo.
Paso 5: Haz la primera solicitud
Aquí tienes un ejemplo mínimo viable, con varias opciones de escritura y un total de 5 líneas:
- Configura la variable de entorno:
export OPENAI_API_KEY=sk-tu_token - Crea el cliente:
client = OpenAI(base_url="https://api.apiyi.com/v1"). La clave se leerá automáticamente de la variable de entorno. - Opción con Responses:
r = client.responses.create(model="gpt-6.1-sol", input="Preséntate en una frase", reasoning={"effort": "low"}, max_output_tokens=800) - Opción con Chat:
c = client.chat.completions.create(model="gpt-6.1-sol", messages=[{"role": "developer", "content": "Responde de forma concisa"}, {"role": "user", "content": "Hola"}], max_completion_tokens=800) - Imprime los datos para verificarlos:
print(c.model, c.usage.prompt_tokens)
Criterio de aceptación: la solicitud devuelve HTTP 200 y usage.prompt_tokens contiene un valor numérico (en Responses, comprueba usage.input_tokens). Al cambiar a gpt-6.1-terra, el campo model de la respuesta debe mostrar el nombre de ese modelo.
🚀 Inicio rápido: te recomendamos probar primero
gpt-6.1-solen APIYI, apiyi.com, con el crédito de prueba y confirmar que la clave, el grupo y la URL base funcionan correctamente. Cuando Terra esté disponible, bastará con cambiar el nombre del modelo. Consulta la lista de modelos de la plataforma para conocer los modelos y precios.
| Paso | Acción en la consola | Criterio de aceptación | Qué comprobar primero si te atascas |
|---|---|---|---|
| 1 Registro | Regístrate con tus datos y luego inicia sesión | Puedes ver un crédito de prueba de 0,05 USD | Que el proceso de registro se haya completado |
| 2 Token | Crea un token y selecciona un grupo | En la lista aparece una clave que empieza por sk- |
Que no estés confundiendo el grupo del token con el grupo del usuario |
| 3 URL base | En el SDK de OpenAI, introduce la dirección /v1 |
La dirección termina en /v1 |
Si recibes un error 404, comprueba /v1 |
| 4 Nombre del modelo | Introduce un modelo como gpt-6.1-sol |
Coincide exactamente con la lista de modelos | La ortografía y los modelos incluidos en el grupo |
| 5 Solicitud | Realiza la primera invocación | Devuelve 200 y usage contiene un valor numérico |
El código de estado, el cuerpo de la respuesta y x-request-id |
También puedes usar directamente la integración más sencilla de Magpie. Permite introducir la clave y la URL base en una interfaz gráfica y conecta automáticamente agentes de programación como Claude Code, Codex, Pi y Hermes a la misma puerta de enlace, sin tener que modificar los archivos de configuración uno por uno.
Selección del endpoint de la API GPT-6.1 Terra: Responses frente a Chat Completions
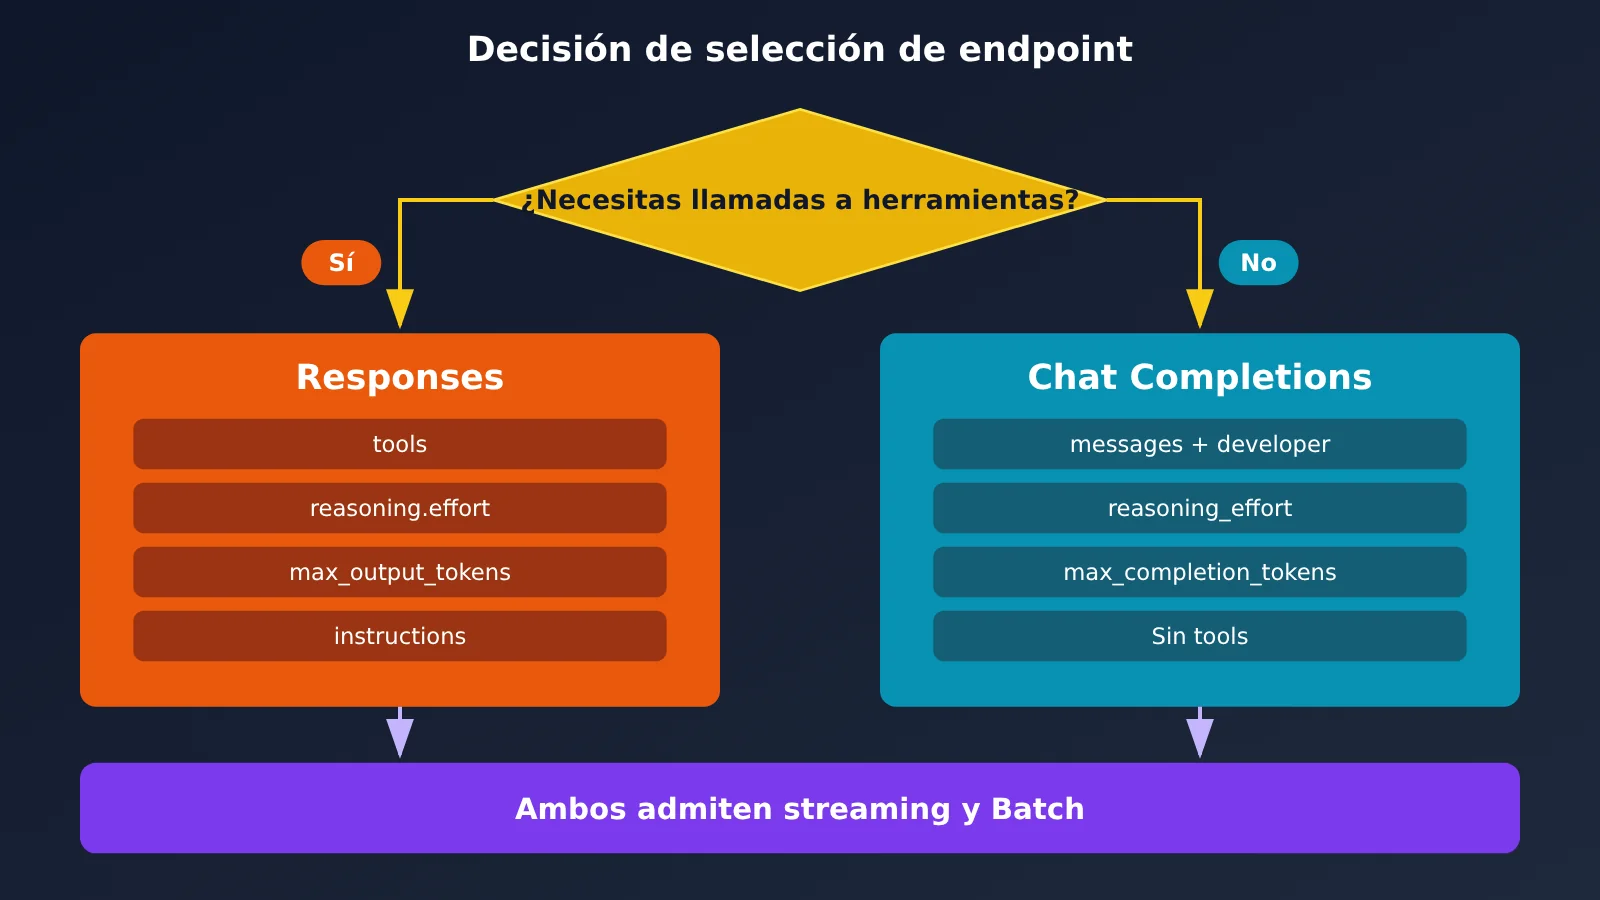
| Aspecto | Responses (v1/responses) | Chat Completions (v1/chat/completions) |
|---|---|---|
| Llamada a herramientas | Sí, permite conectar 10 categorías de herramientas integradas | No; las solicitudes con tools fallan |
| Instrucciones del sistema | instructions |
El rol developer en messages es más fiable que system |
| Nivel de razonamiento | reasoning: {effort: ...} |
reasoning_effort |
| Límite de salida | max_output_tokens |
max_completion_tokens |
| Formato de entrada | Cadena de texto o matriz de mensajes; las imágenes usan input_image | Matriz messages |
| Reproducción de varios turnos | include: ["reasoning.encrypted_content"] y se incluye sin cambios la salida del turno anterior |
El historial de mensajes se concatena manualmente |
| Uso de tokens en streaming | Se devuelve de forma predeterminada | Hay que añadir stream_options: {include_usage: true} |
Análisis comparativo de Chat Completions: Chat destaca por su compatibilidad con el código existente: en la mayoría de los proyectos basta con cambiar el nombre del modelo para que funcione. Sin embargo, en Terra no permite llamar a herramientas y algunos grupos descartan los mensajes system. Responses, en cambio, admite de forma nativa las herramientas y la reproducción cifrada del razonamiento, por lo que es más adecuado para crear agentes y flujos de razonamiento de varios turnos.
El nivel de razonamiento tiene seis opciones: none, low, medium (predeterminado), high, xhigh y max; no existe minimal. Los tokens de razonamiento cuentan tanto para el costo como para el límite de salida. Por eso, conviene dejar margen en max_output_tokens; de lo contrario, la salida podría truncarse antes de que termine el razonamiento.
Tres trampas con los parámetros de la API de GPT-6.1 Terra
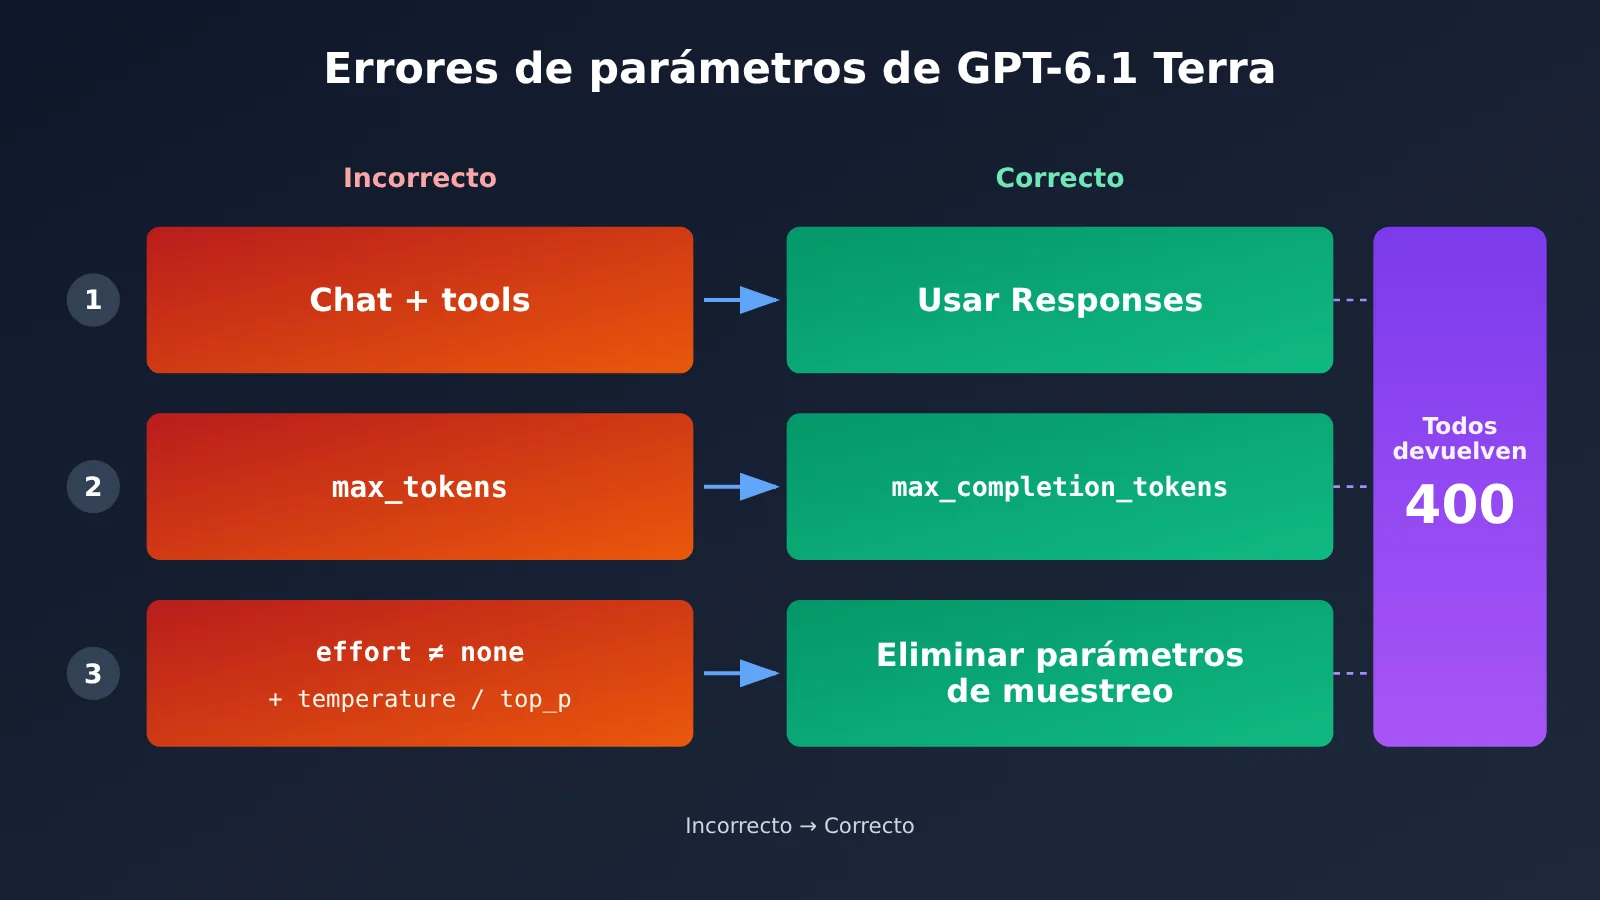
| Trampa | Forma incorrecta | Forma correcta | Consecuencia |
|---|---|---|---|
| Chat con tools | Pasar tools en chat.completions | Usar el endpoint Responses | La solicitud falla |
| Uso de un parámetro antiguo | Pasar max_tokens en el endpoint Chat |
Cambiarlo por max_completion_tokens |
400 |
| Conflicto entre parámetros de muestreo | Pasar temperature o top_p cuando effort no es none | Eliminar temperature, top_p y top_logprobs. En el endpoint Chat, también hay que eliminar logprobs | 400 |
Además de estas tres trampas, la documentación oficial señala varios casos más que pueden provocar un error 400: pasar minimal en effort, asignar un valor no válido a prompt_cache_options.ttl o superar los 922.000 tokens de entrada. Los enlaces de las imágenes deben permitir que el servidor las descargue. Los sitios con medidas anti-scraping pueden provocar fallos; en esos casos, es más fiable usar una URL de datos en base64.
Al investigar un error, conviene tener presente algo importante: el texto original del error aparece una sola vez, en el cuerpo de la respuesta. Los registros del backend sirven como libro contable de facturación; las llamadas fallidas no se facturan. Por eso, guarda el código de estado HTTP, el cuerpo completo de la respuesta original y el x-request-id de los encabezados. No llames primero a raise_for_status() para después leer el cuerpo: podrías perder el mensaje de error.
Precios de la API GPT-6.1 Terra y tramo de 272K
Estos son los precios oficiales, en dólares por millón de tokens. Ten en cuenta que el tramo se aplica a la solicitud completa: si la entrada supera los 272K, todos los conceptos facturables de esa solicitud se cobran según el segundo tramo.
| Concepto facturable | Entrada ≤ 272K | Entrada > 272K |
|---|---|---|
| Entrada | 1 | 2 |
| Salida (incluidos los tokens de razonamiento) | 5 | 7.5 |
| Lectura de caché | 0.05 | 0.1 |
| Escritura en caché (30 minutos) | 1.25 | 2.5 |
| Escritura en caché (12 horas) | 2.50 | 5 |
Para estimar los costos, hay que tener en cuenta los cuatro conceptos: entrada, salida, lectura de caché y escritura en caché. Además, la escritura en caché tiene dos duraciones: 30 minutos y 12 horas. Si solo consideras el precio de entrada y salida, subestimarás el costo de las solicitudes con contexto largo y caché. Los modelos de la misma generación disponibles en la plataforma tienen exactamente los mismos precios que los oficiales para los cuatro conceptos y también aplican el tramo a la solicitud completa.
Los límites de tasa oficiales del plan Standard son: Build, 5.000 RPM / 1 millón de TPM; Launch, 10.000 RPM / 4 millones de TPM; Grow, 15.000 RPM / 40 millones de TPM.
💰 Consejo para reducir costos: en tareas con documentos largos, intenta mantener cada entrada por debajo de 272K y combinarla con el almacenamiento en caché de indicaciones para reducir notablemente el precio por unidad. Al elegir los grupos
defaultosvipen APIYI apiyi.com, puedes disfrutar de precios iguales a los oficiales. Consulta la lista de modelos de la plataforma para ver los modelos y precios concretos.
Aviso de seguridad de la API de GPT-6.1 Terra
Guarda la clave en una variable de entorno o en un servicio de gestión de secretos; no la incluyas directamente en el código fuente ni la subas a un repositorio de Git. Te recomendamos excluir los archivos .env en .gitignore. Si la clave queda expuesta, elimínala de inmediato desde la página de tokens y genera una nueva. Asegúrate también de seleccionar el grupo correcto para el token: si eliges uno incorrecto, puede que el modelo no esté disponible o que se te cobre con una tarifa distinta de la esperada. Lo mejor es usar tokens diferentes para cada proyecto, así podrás controlar los límites y desactivarlos por separado.
Preguntas frecuentes
Q1: ¿Qué es GPT-6.1 Terra?
Es un modelo que OpenAI lanzó el 26 de octubre de 2026, con el ID `gpt-6.1-terra`. Tiene una ventana de contexto de 1.050.000 tokens, acepta texto e imágenes como entrada y genera texto. Se puede invocar mediante los tres endpoints Responses, Chat Completions y Batch.
Q2: ¿Cuál es la diferencia entre Responses y Chat Completions para GPT-6.1 Terra?
Si necesitas invocar herramientas (por ejemplo, `function calling` o `web_search`), elige Responses. Para conversaciones sencillas también puedes usar Chat, pero tendrás que cambiar a `max_completion_tokens` y no podrás incluir `tools`.
Q3: ¿Ya se puede invocar gpt-6.1-terra en APIYI?
A fecha de 27 de octubre de 2026, todavía no está disponible. Publicaremos el modelo lo antes posible. Mientras tanto, puedes probar la integración con `gpt-6.1-sol`, de la misma generación, en APIYI apiyi.com. Consulta la lista de modelos de la plataforma para conocer los modelos y precios disponibles.
Q4: ¿Por qué recibo un error 400 al enviar temperature?
Si el nivel de razonamiento no es `none`, no puedes enviar `temperature`, `top_p` ni `top_logprobs`. Elimina esos parámetros o configura `effort` como `none`.
Q5: ¿Puedo hacer pruebas sin recargar saldo?
Sí. Las cuentas nuevas registradas en APIYI apiyi.com reciben 0,05 dólares de saldo de prueba, suficiente para realizar una invocación sencilla. Te recomendamos verificar primero la integración con `gpt-5.4-mini` y luego cambiar al modelo que necesitas.
Q6: ¿Qué limitaciones conocidas tiene GPT-6.1 Terra?
No admite fine-tuning ni predicted outputs. Tampoco admite los endpoints Realtime, Assistants, Embeddings, Images ni Audio, entre otros. Si la entrada supera los 272K tokens, se cobra el lote completo según la segunda tarifa. Si supera los 922.000 tokens, se devuelve directamente un error 400.
GPT-6.1 Terra API: puntos clave
- La única decisión importante: si necesitas herramientas, usa Responses; si no, basta con cambiar el nombre del modelo en Chat.
- Tres errores habituales con los parámetros: no incluyas
toolsen Chat, usamax_completion_tokensy no envíes parámetros de muestreo cuandoeffortno seanone. - Cinco pasos en la consola: regístrate, crea un token y elige un grupo, añade
/v1a la Base URL, introduce el nombre del modelo y envía una solicitud. - Señales de que todo funciona: la clave empieza por
sk-, la solicitud devuelve un código 200,usagecontiene valores numéricos y el campomodeldevuelve el nombre del modelo. - Cuatro elementos de la tarifa: entrada, salida, lectura de caché y escritura en caché. Si se superan los 272K, todo el pedido pasa al segundo nivel de precios.
- Cómo empezar: primero prueba todo el flujo con
gpt-6.1-solen APIYI. Cuando Terra esté disponible, solo tendrás que cambiar el nombre del modelo.
Resumen
La integración de GPT-6.1 Terra API se resume en tres puntos:
- Empieza por el endpoint: decide primero si usarás Responses o Chat. De ello dependen los parámetros que debes enviar y si podrás invocar herramientas.
- Valida paso a paso: el token, la Base URL, el nombre del modelo y la primera solicitud tienen señales claras para comprobar que todo funciona.
- Ten claros los costos: el nivel de precios de 272K se calcula sobre el pedido completo, y debes incluir en el presupuesto los cuatro conceptos relacionados con la caché.
Te recomendamos probar primero el flujo completo con gpt-6.1-sol en APIYI, en apiyi.com. Al 27 de octubre de 2026, la plataforma todavía no ofrece gpt-6.1-terra. Lo incorporaremos lo antes posible; consulta la lista de modelos de la plataforma para conocer los modelos disponibles y sus precios.
📚 Referencias
- Página del modelo de OpenAI – GPT-6.1 Terra: especificaciones del modelo y compatibilidad con los endpoints
- Enlace:
platform.openai.com/docs/models/gpt-6.1-terra -
Descripción: información oficial sobre el contexto, las modalidades y las herramientas disponibles
-
Guía de modelos más recientes de OpenAI: migración de parámetros y restricciones
- Enlace:
platform.openai.com/docs/guides/latest-model -
Descripción: reglas para parámetros como reasoning.effort y max_completion_tokens
-
Página de precios de OpenAI: tarifas por niveles y precios de la caché
- Enlace:
platform.openai.com/docs/pricing - Descripción: dos niveles de precios para 272K y tarifas según la duración de escritura en caché
Autor: Equipo técnico de APIYI
Consultas técnicas: Puedes contactarnos desde la página de inicio del sitio web de APIYI. Encontrarás más información sobre la integración en el centro de documentación docs.apiyi.com.