作者注:以控制台操作为主线,5 步完成 GPT-6.1 Terra API 接入,讲清端点选择、参数坑和 272K 阶梯计价。
先说结论:接入 GPT-6.1 Terra 只有一个关键选择,就是用 Responses 还是 Chat Completions。 需要工具调用就必须用 Responses;不需要工具的话,现有代码基本照抄,改一下模型名就能跑。
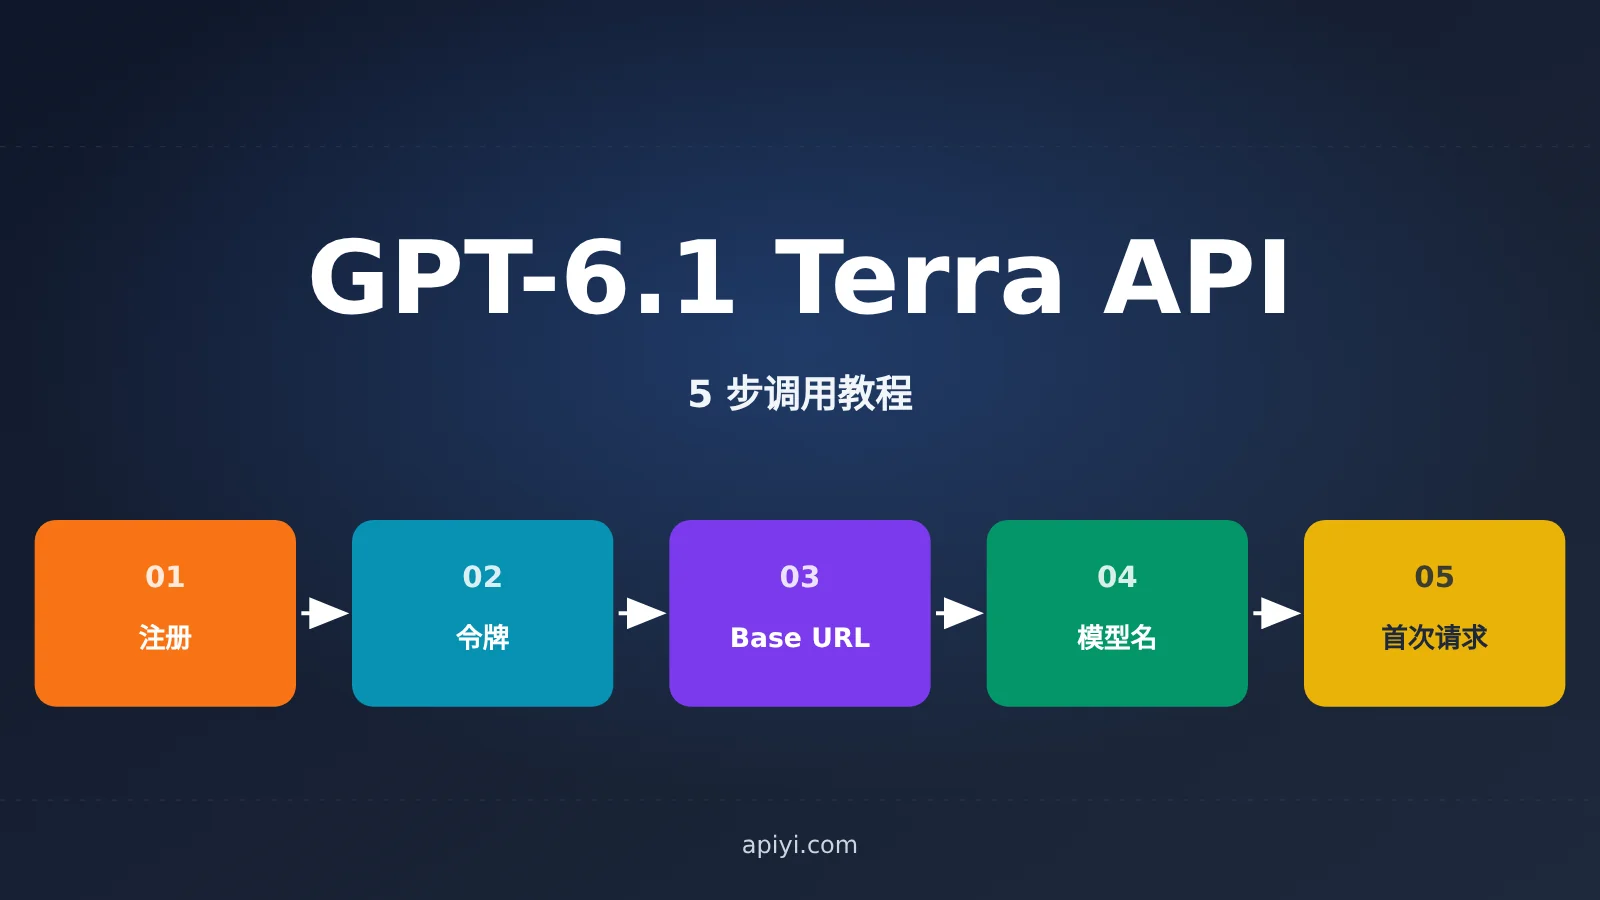
GPT-6.1 Terra 于 2026-10-26 发布,模型 ID 是 gpt-6.1-terra,官方文档已经写明端点、参数和计价规则,这些信息有据可查。本文按控制台页面的操作顺序展开:注册 → 建令牌 → 找 Base URL → 填模型名 → 跑第一次请求。每一步都附有验收标准,命令行和代码只作为可选写法。
核心价值:读完本文,你能在控制台里完成 GPT-6.1 Terra API 的接入链路验证,并避开最常见的 400 报错。
📌 平台现状说明:截至 2026-10-27,API易 apiyi.com 的实时型号列表中还没有
gpt-6.1-terra,我们会尽快推出此模型。同代的gpt-6-astra、gpt-6-sol、gpt-6.1-sol、gpt-6-luna已经上架,可以先用gpt-6.1-sol验证接入链路。型号与价格以平台型号列表为准。
GPT-6.1 Terra API 核心要点
| 要点 | 说明 | 对你的意义 |
|---|---|---|
| 模型 ID | gpt-6.1-terra,2026-10-26 发布 |
请求里的 model 字段照此填写 |
| 可用端点 | Responses、Chat Completions、Batch | Realtime、Assistants、Embeddings 等端点都不支持 |
| 工具调用 | 只有 Responses 支持 | Chat 端带上 tools 会直接失败 |
| 上下文 | 总 1,050,000,单次输入 922,000,输出 128,000 | 适合长文档,但要注意 272K 计价阶梯 |
| 模态 | 输入为文本和图片,输出为文本 | 图片走 Responses 的 input_image |
| 知识截止 | 2026-06-01 | 更新的信息需要配合 web_search 工具获取 |
GPT-6.1 Terra 能力边界详解
GPT-6.1 Terra 支持 streaming、structured outputs、function calling、file_search、image input、web search 和 prompt caching,不支持 fine-tuning 和 predicted outputs。如果你的旧项目依赖微调模型或预测输出,就不能直接迁移过来。
Responses 端点可以挂载的工具很多,包括 web_search、file_search、image_generation、code_interpreter、hosted_shell、apply_patch、skills、computer_use、mcp 和 tool_search。这也是”要工具就选 Responses”的根本原因:Chat Completions 在这个模型上只负责纯对话。
如何调用 GPT-6.1 Terra API:5 步控制台流程
第 1 步:注册账号
- 打开 API易 apiyi.com,按页面提示用本人信息注册账号,平台要求本人注册。
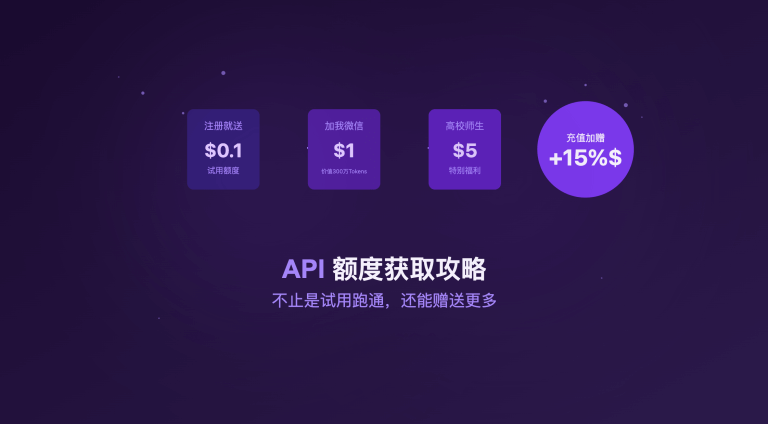
- 新账号自带 0.05 美元试用额度,不充值也能跑通一次轻量调用。
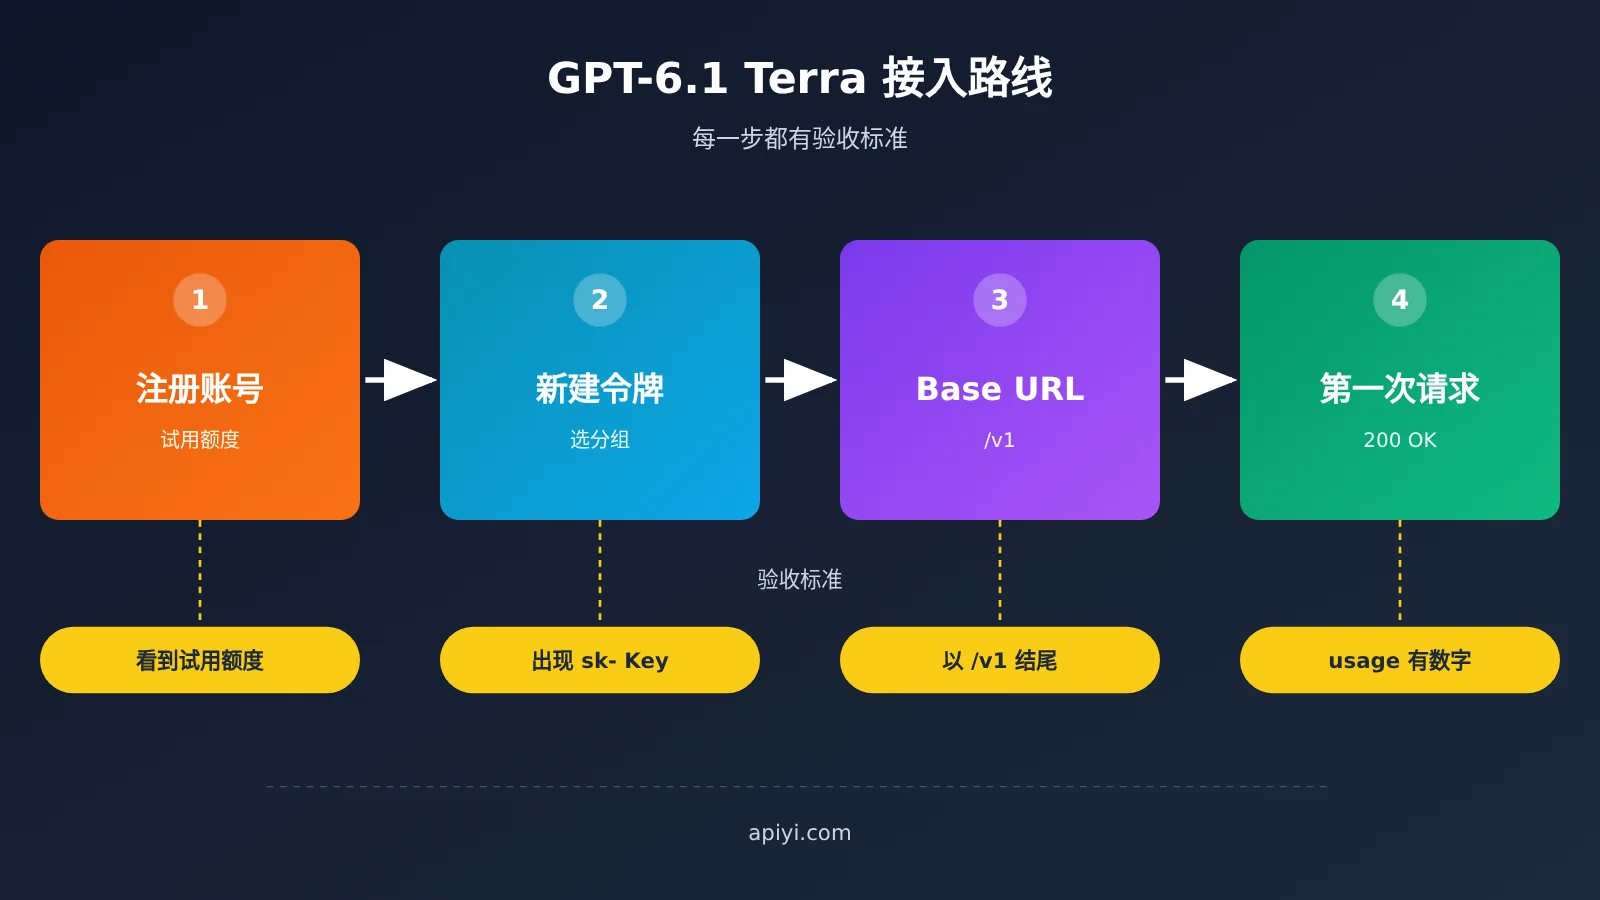
- 验收标准:登录后进入控制台,钱包或余额页能看到试用额度。
- 卡住时看:如果看不到额度,先确认是否完成了注册流程,不要急着充值。
如果走官方渠道,需要在 OpenAI 平台的 API Keys 页面创建 Key。前提是账号位于支持地区,并且已经充值到 Build 层,也就是至少 5 美元。
第 2 步:新建令牌并选对分组
- 进入控制台的令牌页面
api.apiyi.com/token,点击新建令牌。 - 在「选择分组」里挑一个分组。分组决定了可用模型、计费倍率和上游线路。
default和svip与官方同价,CodexReverse走逆向资源。 - 验收标准:保存后,令牌列表里出现一条以
sk-开头的 Key。 - 卡住时看:用户层的「分组」不等于令牌分组,真正生效的是令牌上选的那一个。
第 3 步:找到 Base URL
Base URL 要按 SDK 区分,这是最容易填错的地方:
- OpenAI SDK:
https://api.apiyi.com/v1,要带/v1 - Anthropic SDK:用根域名,不带
/v1 - Google GenAI SDK:用根域名,同时把
api_version设为v1beta
验收标准:GPT-6.1 系列使用 OpenAI SDK 或 OpenAI 兼容客户端,填好的地址以 /v1 结尾。卡住时看:如果报 404,十有八九是 /v1 漏写或重复写了。
第 4 步:填写模型名
在客户端或调试工具的模型字段里填写模型 ID。建议先用 gpt-5.4-mini 这类轻量模型跑通链路,再换成 gpt-6.1-sol。等 gpt-6.1-terra 在平台上架后,只需要改一个字段。平台没有 auto、auto:free 这类免费路由写法,不要尝试。
验收标准:模型名与平台型号列表里的写法逐字一致。卡住时看:报模型不存在时,先去型号列表核对拼写,再检查令牌分组是否覆盖了这个模型。
第 5 步:跑通第一次请求
下面是最小可用示例,可选写法,共 5 行:
- 设置环境变量:
export OPENAI_API_KEY=sk-你的令牌 - 创建客户端:
client = OpenAI(base_url="https://api.apiyi.com/v1"),Key 会自动从环境变量读取 - Responses 写法:
r = client.responses.create(model="gpt-6.1-sol", input="用一句话介绍你自己", reasoning={"effort": "low"}, max_output_tokens=800) - Chat 写法:
c = client.chat.completions.create(model="gpt-6.1-sol", messages=[{"role": "developer", "content": "简洁回答"}, {"role": "user", "content": "你好"}], max_completion_tokens=800) - 打印核对:
print(c.model, c.usage.prompt_tokens)
验收标准:请求返回 HTTP 200,usage.prompt_tokens 有数字(Responses 端看 usage.input_tokens)。换成 gpt-6.1-terra 后,响应里的 model 字段能回显这个模型名。
🚀 快速开始:建议先在 API易 apiyi.com 用试用额度跑通
gpt-6.1-sol,确认 Key、分组和 Base URL 都没问题。Terra 上架后改一下模型名即可切换,型号与价格以平台型号列表为准。
| 步骤 | 控制台操作 | 验收标准 | 卡住时先查 |
|---|---|---|---|
| 1 注册 | 本人注册并登录 | 能看到 0.05 美元试用额度 | 注册流程是否完成 |
| 2 令牌 | 新建令牌并选择分组 | 列表出现 sk- 开头的 Key |
令牌分组与用户分组是否混淆 |
| 3 Base URL | OpenAI SDK 填 /v1 地址 |
地址以 /v1 结尾 |
404 时检查 /v1 |
| 4 模型名 | 填写 gpt-6.1-sol 等型号 |
与型号列表逐字一致 | 拼写和分组覆盖范围 |
| 5 请求 | 发出第一次调用 | 返回 200,usage 有数字 | 状态码、响应体、x-request-id |
当然,你也可以直接用 Magpie 更方便的接入。它把 Key 和 Base URL 填在图形界面里,自动帮你把 Claude Code、Codex、Pi、Hermes 这类编程 Agent 接上同一个网关,不用逐个改配置文件。
GPT-6.1 Terra API 端点选择:Responses 对比 Chat Completions
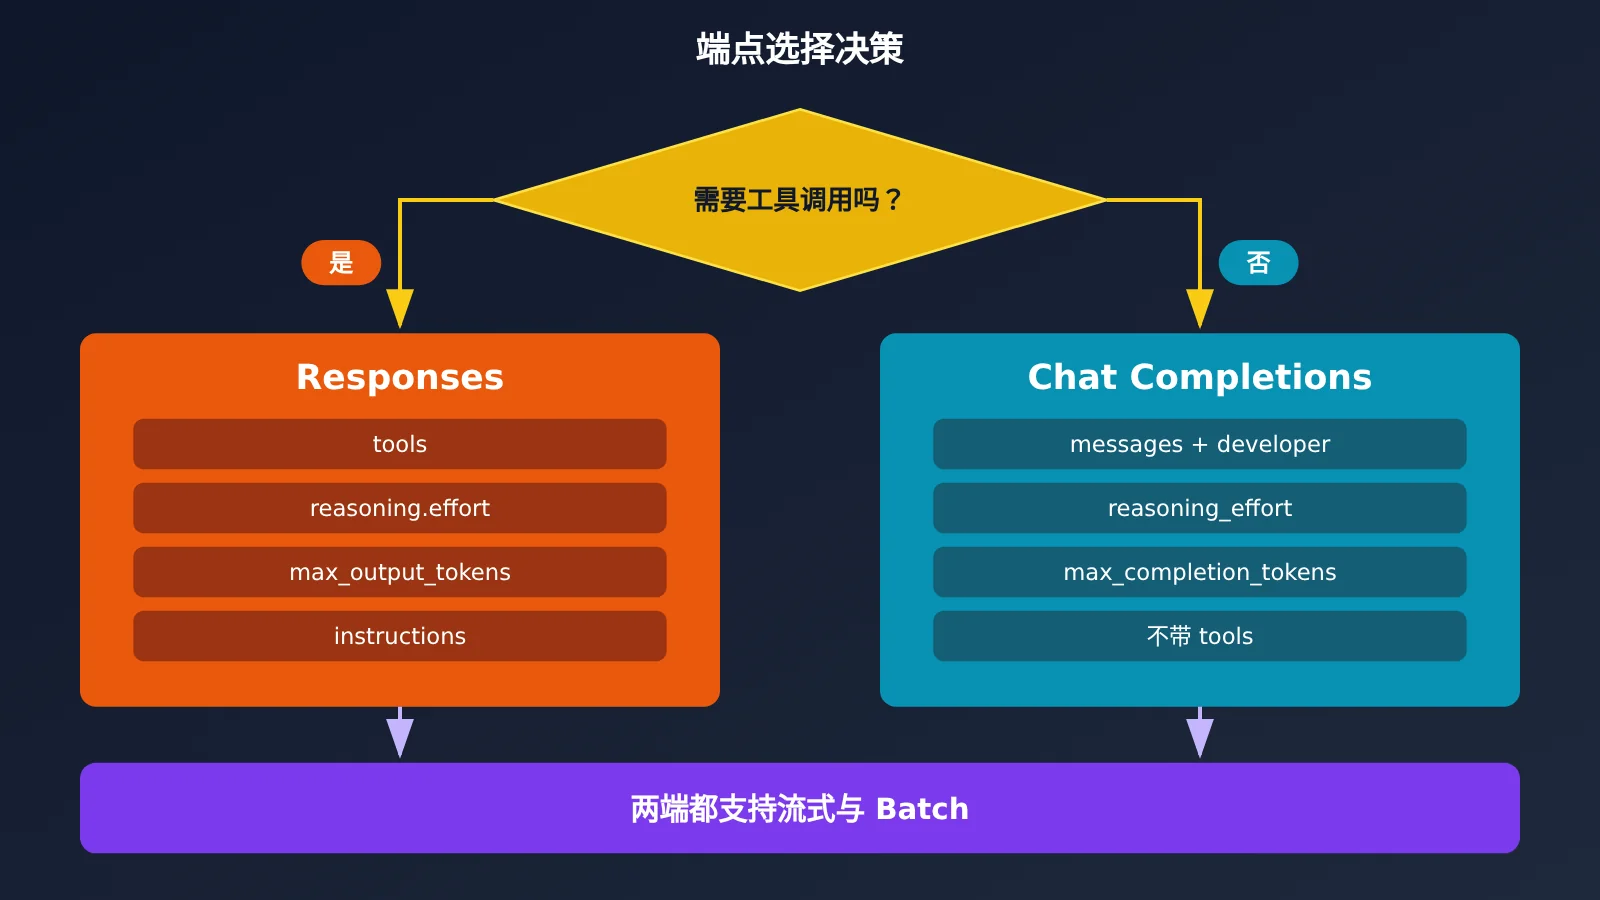
| 对比项 | Responses(v1/responses) | Chat Completions(v1/chat/completions) |
|---|---|---|
| 工具调用 | 支持,可挂载 10 类内置工具 | 不支持,带 tools 会失败 |
| 系统指令 | instructions |
messages 中的 developer 角色,比 system 更稳 |
| 推理力度 | reasoning: {effort: ...} |
reasoning_effort |
| 输出上限 | max_output_tokens |
max_completion_tokens |
| 输入格式 | 字符串或消息数组,图片用 input_image | messages 数组 |
| 多轮回放 | include: ["reasoning.encrypted_content"],并把上轮 output 原样带回 |
自行拼接历史消息 |
| 流式 usage | 默认返回 | 需加 stream_options: {include_usage: true} |
Chat Completions 对标分析:Chat 端在兼容老代码方面优势明显,大多数项目只改模型名就能运行。但它在 Terra 上不能调用工具,部分分组还会丢弃 system 消息。相比之下,Responses 原生支持工具和加密推理回放,更适合构建 Agent 和多轮推理场景。
推理力度共有 none、low、medium(默认)、high、xhigh、max 六档,没有 minimal。推理 token 会计入输出计费和输出上限,所以 max_output_tokens 要预留余量,否则可能推理还没结束输出就被截断了。
GPT-6.1 Terra API 三个参数坑
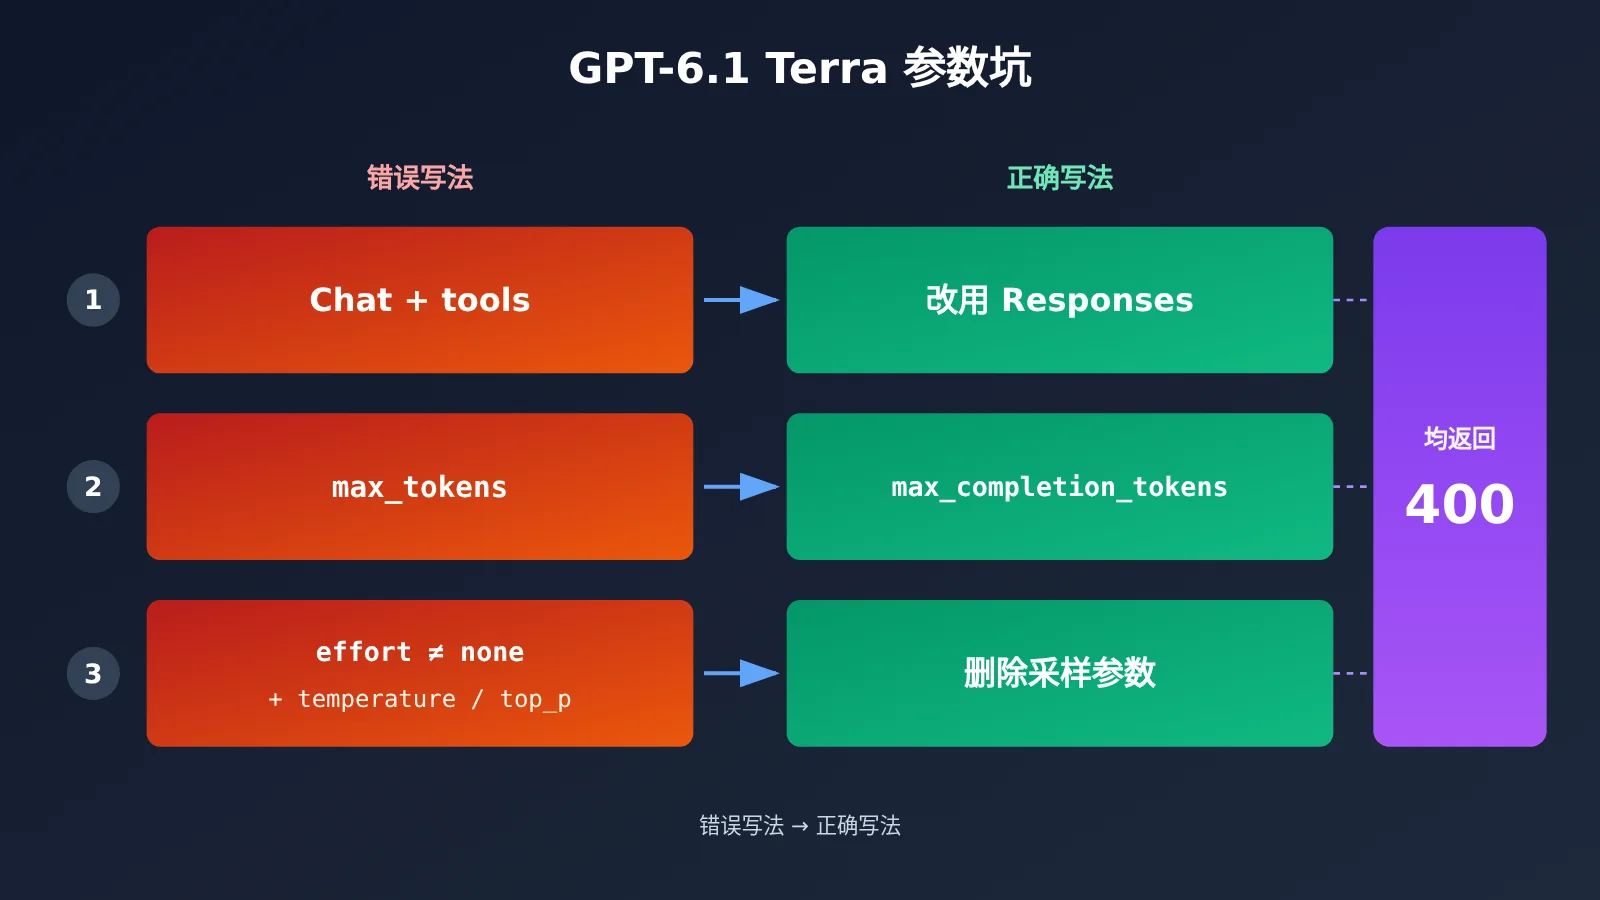
| 坑 | 错误写法 | 正确写法 | 后果 |
|---|---|---|---|
| Chat 带 tools | 在 chat.completions 里传 tools | 改用 Responses 端点 | 请求失败 |
| 用了旧参数 | Chat 端传 max_tokens |
改为 max_completion_tokens |
400 |
| 采样参数冲突 | effort 不是 none 时传 temperature 或 top_p | 删除 temperature、top_p、top_logprobs,Chat 端还要删 logprobs | 400 |
除了这三个坑,官方还列出了几个会触发 400 的情况:effort 传了 minimal、prompt_cache_options.ttl 传了非法值、输入超过 922,000 tokens。图片输入的链接必须能被服务端下载,带反爬的站点会导致失败,这时改用 base64 data URL 更稳。
排查报错时有一个关键习惯:错误原文只在响应体里出现一次,后台日志是计费账本,失败的调用不会入账。所以要保留 HTTP 状态码、原始响应体全文和响应头里的 x-request-id。不要先调用 raise_for_status() 再去读 body,那样错误信息就丢了。
GPT-6.1 Terra API 价格与 272K 阶梯
以下为官方定价,单位是美元每百万 tokens。注意阶梯是按整条请求划分的:只要输入超过 272K,这一整单的所有计费项都按第二档计算。
| 计费项 | 输入 ≤ 272K | 输入 > 272K |
|---|---|---|
| 输入 | 1 | 2 |
| 输出(含推理 token) | 5 | 7.5 |
| 缓存读取 | 0.05 | 0.1 |
| 缓存写入(30 分钟) | 1.25 | 2.5 |
| 缓存写入(12 小时) | 2.50 | 5 |
估算成本时要把四项都算进去:输入、输出、缓存读取、缓存写入。缓存写入还要区分 30 分钟和 12 小时两种时长。只看输入和输出单价,会低估长上下文加缓存场景的费用。平台上已上架的同代模型,四项计费都与官网逐项一致,并且同样按两档整单计费。
官方 Standard 档的限流如下:Build 为 5,000 RPM / 100 万 TPM,Launch 为 1 万 RPM / 400 万 TPM,Grow 为 1.5 万 RPM / 4000 万 TPM。
💰 成本建议:长文档任务尽量把单次输入控制在 272K 以内,再配合 prompt caching,能明显降低单价。通过 API易 apiyi.com 选择
default或svip分组可以享受与官方同价的计费,具体型号与价格以平台型号列表为准。
GPT-6.1 Terra API 安全提醒
Key 要放在环境变量或密钥管理服务里,不要硬编码到源码中,更不要提交到 git 仓库。建议在 .gitignore 里排除 .env 文件。一旦 Key 泄露,立即到令牌页删除并重建。另外,令牌要选对分组:分组错了,轻则报模型不可用,重则按意料之外的倍率计费。不同项目最好使用不同的令牌,便于分别控制额度和停用。
常见问题 FAQ
Q1:什么是 GPT-6.1 Terra?
它是 OpenAI 在 2026-10-26 发布的模型,ID 为 `gpt-6.1-terra`。上下文长度为 1,050,000,输入支持文本和图片,输出为文本,可以通过 Responses、Chat Completions 和 Batch 三个端点调用。
Q2:GPT-6.1 Terra 的 Responses 和 Chat Completions 怎么选?
需要工具调用(如 function calling、web_search)就选 Responses;纯对话场景用 Chat 也可以,但要改用 max_completion_tokens,并且不能带 tools。
Q3:API易现在能调用 gpt-6.1-terra 吗?
截至 2026-10-27 还没有上架,我们会尽快推出此模型。可以先在 API易 apiyi.com 用同代的 `gpt-6.1-sol` 验证接入链路,型号与价格以平台型号列表为准。
Q4:为什么传了 temperature 会报 400?
推理力度不是 none 时,temperature、top_p、top_logprobs 都不能传。要么删掉这些参数,要么把 effort 设为 none。
Q5:没充值能测试吗?
可以。在 API易 apiyi.com 注册的新账号自带 0.05 美元试用额度,足够跑通一次轻量调用。建议先用 `gpt-5.4-mini` 验证链路,再切换到目标模型。
Q6:GPT-6.1 Terra 有哪些已知限制?
不支持 fine-tuning 和 predicted outputs,也不支持 Realtime、Assistants、Embeddings、Images、Audio 等端点。输入超过 272K 会整单按第二档计费,超过 922,000 tokens 会直接报 400。
GPT-6.1 Terra API 核心要点 Key Takeaways
- 唯一关键选择:要工具就用 Responses,否则 Chat 改个模型名即可
- 三个参数坑:Chat 不带 tools、用 max_completion_tokens、effort 非 none 时不传采样参数
- 控制台 5 步:注册、建令牌选分组、Base URL 带 /v1、填模型名、跑请求
- 验收信号:Key 以 sk- 开头,请求返回 200 且 usage 有数字,model 字段回显
- 计价四要素:输入、输出、缓存读取、缓存写入,超过 272K 整单进入第二档
- 上手方式:先在 API易 用 gpt-6.1-sol 跑通链路,Terra 上架后只改模型名
总结
GPT-6.1 Terra API 接入的要点可以归纳为三条:
- 端点先行:先决定用 Responses 还是 Chat,这决定了参数写法和能否调用工具。
- 逐步验收:令牌、Base URL、模型名、第一次请求,每一步都有明确的检查信号。
- 成本心里有数:272K 阶梯按整单计算,缓存四项费用都要纳入预算。
推荐先在 API易 apiyi.com 用 gpt-6.1-sol 跑通完整链路。截至 2026-10-27 平台尚未上架 gpt-6.1-terra,我们会尽快推出此模型,型号与价格以平台型号列表为准。
📚 参考资料
- OpenAI 模型页 – GPT-6.1 Terra:模型规格与端点支持
- 链接:
platform.openai.com/docs/models/gpt-6.1-terra -
说明:上下文、模态、可用工具的官方口径
-
OpenAI 最新模型指南:参数迁移与限制
- 链接:
platform.openai.com/docs/guides/latest-model -
说明:reasoning.effort、max_completion_tokens 等参数规则
-
OpenAI 定价页:阶梯计价与缓存价格
- 链接:
platform.openai.com/docs/pricing - 说明:272K 两档与缓存写入时长定价
作者:APIYI 技术团队
技术交流:欢迎在 API易 网站首页联系我们,更多接入说明可查阅 docs.apiyi.com 文档中心