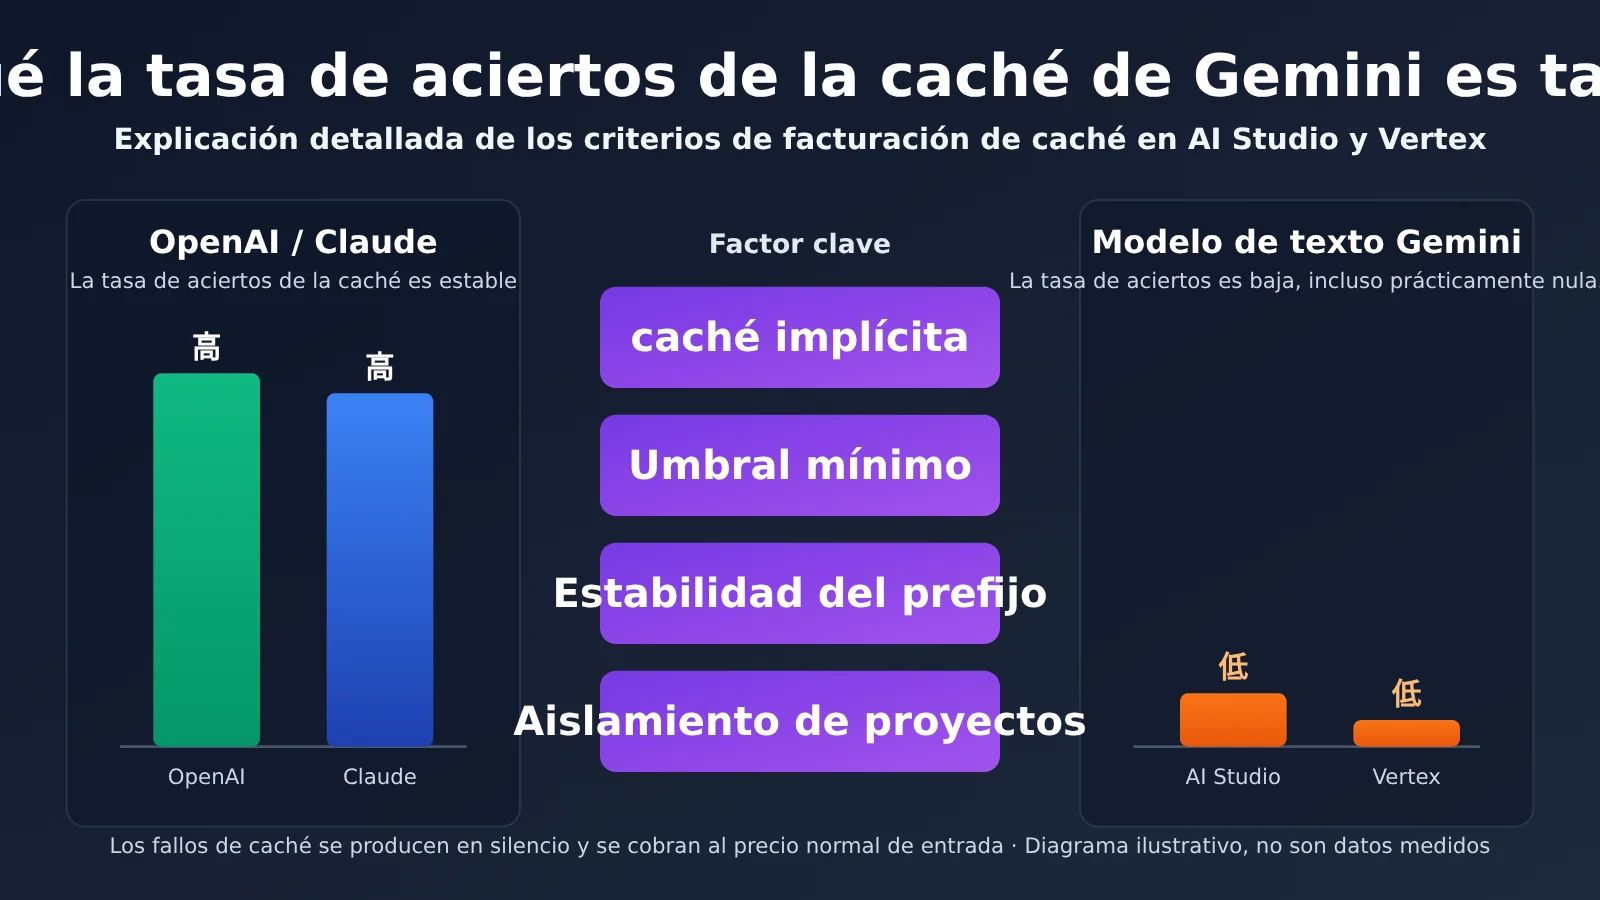
En el uso real de APIYI, la escritura y las lecturas de caché de las series OpenAI y Claude funcionan con normalidad, y la tasa de aciertos también es alta. Los modelos de texto de Gemini son distintos: su tasa de aciertos es muy baja, e incluso puede ser prácticamente nula. Es un hecho que se puede comprobar en las facturas y los detalles de uso, y también uno de los aspectos que más desconcierta a los desarrolladores al cuadrar cuentas.
Este artículo se basa en la documentación oficial de Google disponible hasta el 20 de octubre de 2026. En él desglosamos 5 tipos de motivos por los que la tasa de aciertos de la caché de Gemini es baja y explicamos cómo se definen los cargos por caché en AI Studio (Gemini Developer API) y Vertex AI.
Este no es un análisis para «echarle la culpa a otro». Google no indica en su documentación oficial que «usar un servicio proxy reduzca la tasa de aciertos de la caché de Gemini», y tampoco podemos afirmar que una causa concreta sea necesariamente la responsable sin tener registros de las solicitudes enviadas al proveedor. Lo que hacemos en este artículo es explicar primero las reglas oficiales, enumerar después las condiciones que pueden hacer que no se cumplan y, por último, ofrecer un método de diagnóstico y conciliación que puedes ejecutar por tu cuenta.
Qué te llevas: al terminar, entenderás cuándo se producen aciertos de caché en Gemini y cuándo no, tendrás claro el principio de facturación de que «la entrada total incluye la parte en caché» y podrás comprobar la factura de forma independiente con los campos de respuesta oficiales.
Aspectos clave de la tasa de aciertos de la caché de Gemini
Empecemos por la conclusión. Para entender la caché de Gemini, primero hay que distinguir entre dos mecanismos: la «caché implícita» y la «caché explícita». La forma de activarlos y su facturación son completamente distintas.
| Tipo | Cómo se usa | Cómo se obtiene el descuento por caché | ¿Tiene costo de almacenamiento? |
|---|---|---|---|
| Caché implícita (Implicit caching) | Se activa automáticamente en los modelos compatibles; no hace falta crear un objeto de caché | Cuando una solicitud obtiene un acierto, la parte almacenada en caché se cobra a precio de caché; no se garantiza que haya acierto en todas las solicitudes | No |
| Caché explícita (Explicit caching) | Se crea un objeto de caché de forma manual y se hace referencia a él en las solicitudes posteriores | Las entradas en caché que se referencian y siguen vigentes tienen precio de caché | Sí |
La documentación oficial incluye una frase clave sobre la caché implícita de Developer API: no garantiza un ahorro. La caché explícita es más predecible, pero requiere trabajo de desarrollo adicional: crear objetos de caché, gestionar su vigencia y hacer referencia a ellos en las solicitudes posteriores.
Por qué Gemini se comporta de forma distinta a OpenAI y Claude
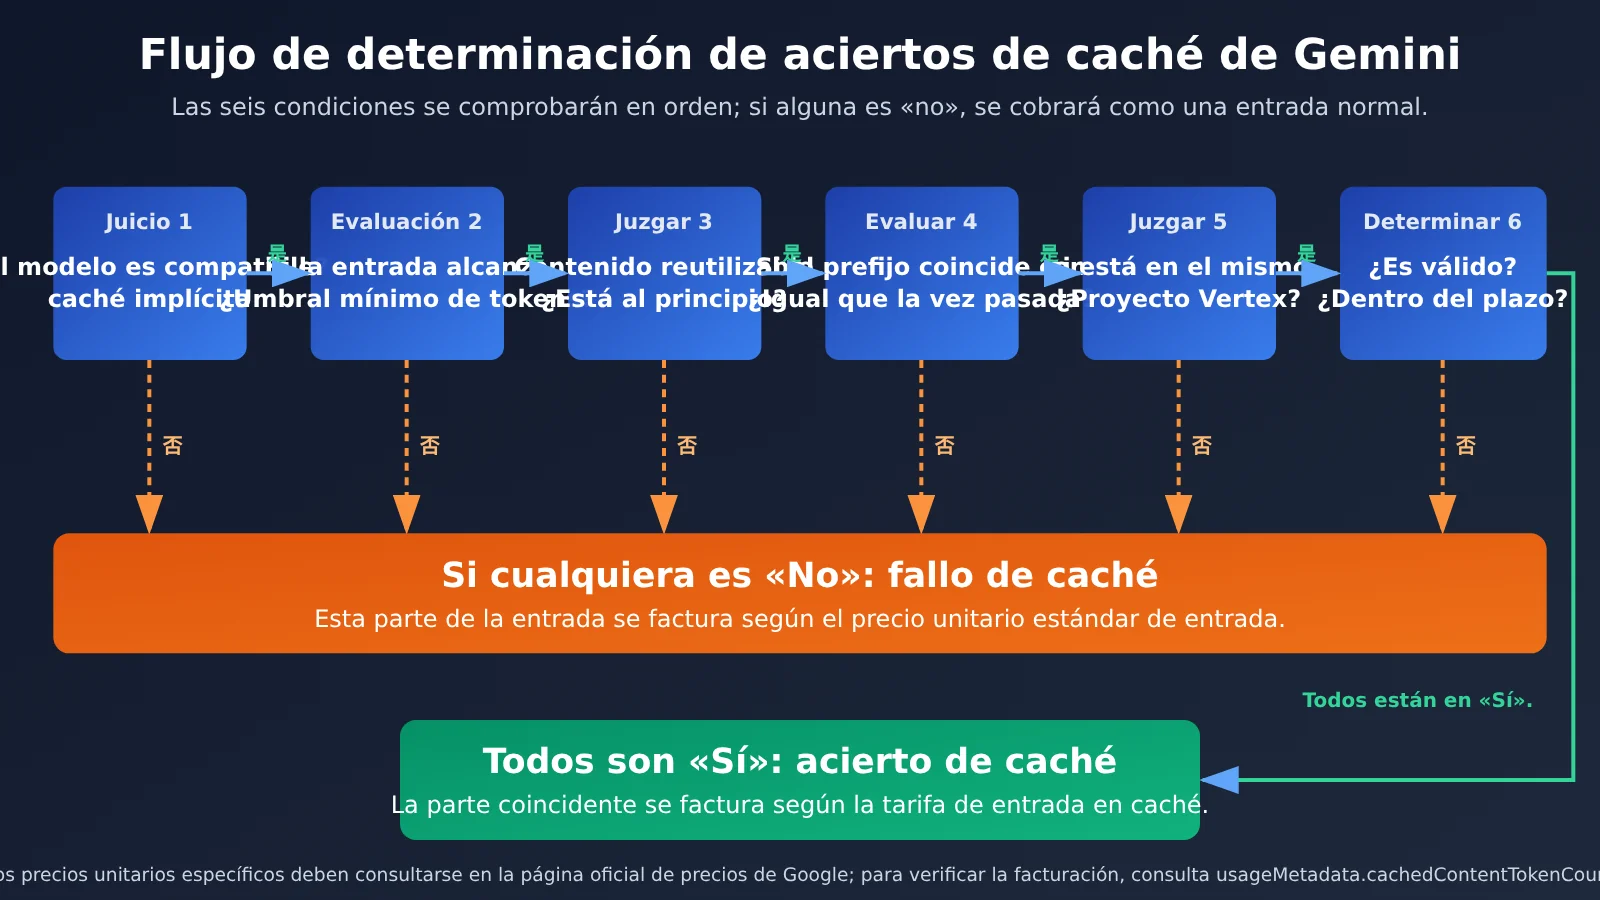
Desde el punto de vista del usuario, las series OpenAI y Claude en APIYI se comportan así: «si envío el mismo prefijo largo, puedo ver de forma estable escrituras y aciertos de caché». En Gemini, en cambio, tienen que cumplirse varias condiciones a la vez: que el modelo admita la caché implícita, que la solicitud alcance el umbral mínimo de tokens de ese modelo, que el contenido reutilizable esté al principio de la indicación, que las solicitudes similares se envíen en un intervalo breve y que, en Vertex, además pertenezcan al mismo proyecto de Google Cloud.
Si no se cumple cualquiera de estas condiciones, la solicitud se cobra al precio normal de entrada. No se produce ningún error ni aparece ningún aviso. Por eso muchas veces no se detecta una «tasa de aciertos baja»: los fallos de caché ocurren de forma silenciosa.
Primero, una aclaración: ¿a qué nos referimos con AI Studio?
En este artículo, «canal de AI Studio» se refiere a Gemini Developer API, es decir, la ruta de llamadas que utiliza una clave API generada en AI Studio, en contraste con Vertex AI, que funciona en Google Cloud. Los dos comparten el enfoque general de la caché, pero difieren en los valores del umbral mínimo, el ámbito de aislamiento y las reglas de los cargos de almacenamiento. Más adelante veremos cada aspecto por separado.
5 causas de una baja tasa de aciertos de caché en Gemini
El análisis se divide en dos partes: las dos primeras causas corresponden a reglas que la documentación oficial especifica claramente; las tres últimas son explicaciones condicionales sobre situaciones en las que esas reglas se incumplen al usar un servicio proxy o en la práctica de ingeniería. No podemos determinar cuál es la causa concreta solo porque se use un servicio proxy: para identificarla hacen falta los registros del proyecto y de las solicitudes de la capa superior.
Causa 1: La solicitud no alcanza el umbral mínimo de tokens para la caché
La caché implícita tiene un umbral mínimo de tokens: las solicitudes con entradas demasiado cortas no se almacenan en caché. Además, el umbral no es exactamente el mismo en ambas plataformas. Estos son algunos de los valores que aparecen en la documentación actual:
| Modelo | Umbral de caché implícita de Developer API | Umbral de caché implícita de Vertex |
|---|---|---|
| Gemini 3.8 Flash | 4,096 | 6,144 |
| Gemini 3.1 Pro Preview | 4,096 | 6,144 |
| Gemini 2.5 Pro (generación anterior, como referencia) | 2,048 | 2,048 |
Hay dos aspectos que pueden llevar a confusión. Primero, los modelos de nueva generación, como Gemini 3.8 Flash, tienen un umbral más alto que la serie 2.5. Si se hacen cálculos tomando como referencia los 2,048 tokens de una versión anterior, se puede llegar a una conclusión equivocada. Segundo, el umbral de un mismo modelo puede ser más alto en Vertex: una solicitud de 5,000 tokens cumple el requisito en Developer API, pero no en Vertex.
Las solicitudes habituales de conversación suelen tener solo unos cientos o entre mil y dos mil tokens, por lo que no alcanzan el umbral de forma natural. Esta es una de las razones más directas por las que Gemini tiene una tasa de aciertos muy baja en escenarios de chat. Conviene aclarar que alcanzar el umbral es una condición necesaria, pero no garantiza un acierto.
Causa 2: El contenido reutilizable no está al principio de la indicación
Google recomienda lo mismo para ambas plataformas: colocar al principio de la indicación el contenido extenso que se reutiliza y enviar, en un intervalo de tiempo relativamente corto, solicitudes con prefijos similares. La caché depende de un prefijo común, no de que «la solicitud incluya el mismo documento».
Dicho de otro modo, incluir el mismo documento en dos solicitudes no garantiza que se produzca un acierto. También importa dónde aparece en cada solicitud y si el contenido que lo precede se mantiene estable. Una estructura como esta puede romper fácilmente el prefijo:
# 反例:变化内容放在最前面
[当前时间:2026-10-20 10:31:07]
[请求 ID:a8f3...]
{system 指令}
{长文档}
{用户问题}
Si cambia un solo carácter al principio, el documento extenso que viene después ya no puede formar un prefijo común con el de la solicitud anterior. Esta conclusión se infiere de las recomendaciones oficiales, pero es una situación muy habitual en ingeniería.
Causa 3: La capa de proxy modifica el prefijo (condicional)
Si la capa de proxy inserta al principio de la indicación una hora variable, un identificador o campos de seguimiento, o si reorganiza, comprime o trunca el contexto de varias rondas, modificará el prefijo común y reducirá las posibilidades de acierto. Se trata de un análisis condicional: no se puede afirmar directamente que un servicio concreto tenga estos comportamientos.
Al investigar el problema, hay que distinguir dos niveles: si el prefijo de la solicitud que envías al proxy es estable y si también lo es el prefijo de la solicitud que el proxy envía a Google. Puedes controlar el primero; para verificar el segundo, hacen falta los registros de solicitudes de la capa superior.
Causa 4: Las solicitudes se distribuyen entre distintos proyectos de Vertex (condicional)
Vertex especifica claramente que la caché está aislada por proyecto de Google Cloud y no se comparte entre proyectos. Si varias solicitudes de una misma sesión se distribuyen entre distintos proyectos de Vertex, la caché creada en el proyecto A no estará disponible para el proyecto B.
Hay que tener cuidado con esta conclusión: que «cambiar la clave» provoque la pérdida de la caché depende de si también cambia el proyecto. No se puede afirmar que cada cambio de clave implique perder la caché; primero hay que confirmar la relación entre las claves y los proyectos.
Causa 5: Solo se reenvían solicitudes de generación y no se usa la caché explícita
Si el flujo de llamadas solo reenvía solicitudes generateContent, sin crear un objeto de caché ni hacer referencia a él en las solicitudes posteriores, toda la cadena depende de la caché implícita. La caché implícita no ofrece garantías de que se produzca un acierto, así que no permite obtener el beneficio estable de la caché explícita: «crear una vez y reutilizar repetidamente».
La siguiente tabla relaciona estos escenarios de proxy con las reglas oficiales:
| Comportamiento observado | Posible efecto | Regla oficial correspondiente |
|---|---|---|
| Las solicitudes de una misma sesión se distribuyen entre distintos proyectos de Vertex | No se puede reutilizar una caché existente de otro proyecto | La caché está aislada por proyecto |
| Se insertan horas o identificadores variables al principio, o se reorganiza el contexto | Se rompe el prefijo común y disminuyen las posibilidades de acierto | Colocar el contenido extenso al principio y mantener prefijos similares |
| La solicitud es corta y contiene poco contenido fijo reutilizable | No alcanza el umbral de caché | Umbral mínimo de tokens |
| Solo se reenvían solicitudes de generación, sin crear ni referenciar un objeto de caché explícita | Solo se depende de la caché implícita, sin garantías de acierto | La caché explícita requiere crear y referenciar un objeto |
🎯 Recomendación técnica: Para investigar problemas con la caché de Gemini, prueba primero a enviar varias solicitudes seguidas con el mismo prefijo extenso y fijo a través de APIYI apiyi.com y compara los campos de tokens de caché de las respuestas. Usa solicitudes controladas para descartar primero problemas relacionados con el prefijo y el umbral; después, comprueba si el problema está en la cadena de llamadas.
Sin los registros del proyecto y de las solicitudes de la capa superior, no se puede determinar la causa solo porque se use un servicio proxy. Tampoco hay fundamento oficial para afirmar que la tasa de aciertos de Vertex sea siempre superior a la de Developer API.
Cómo se determina la facturación de la caché en AI Studio y Vertex
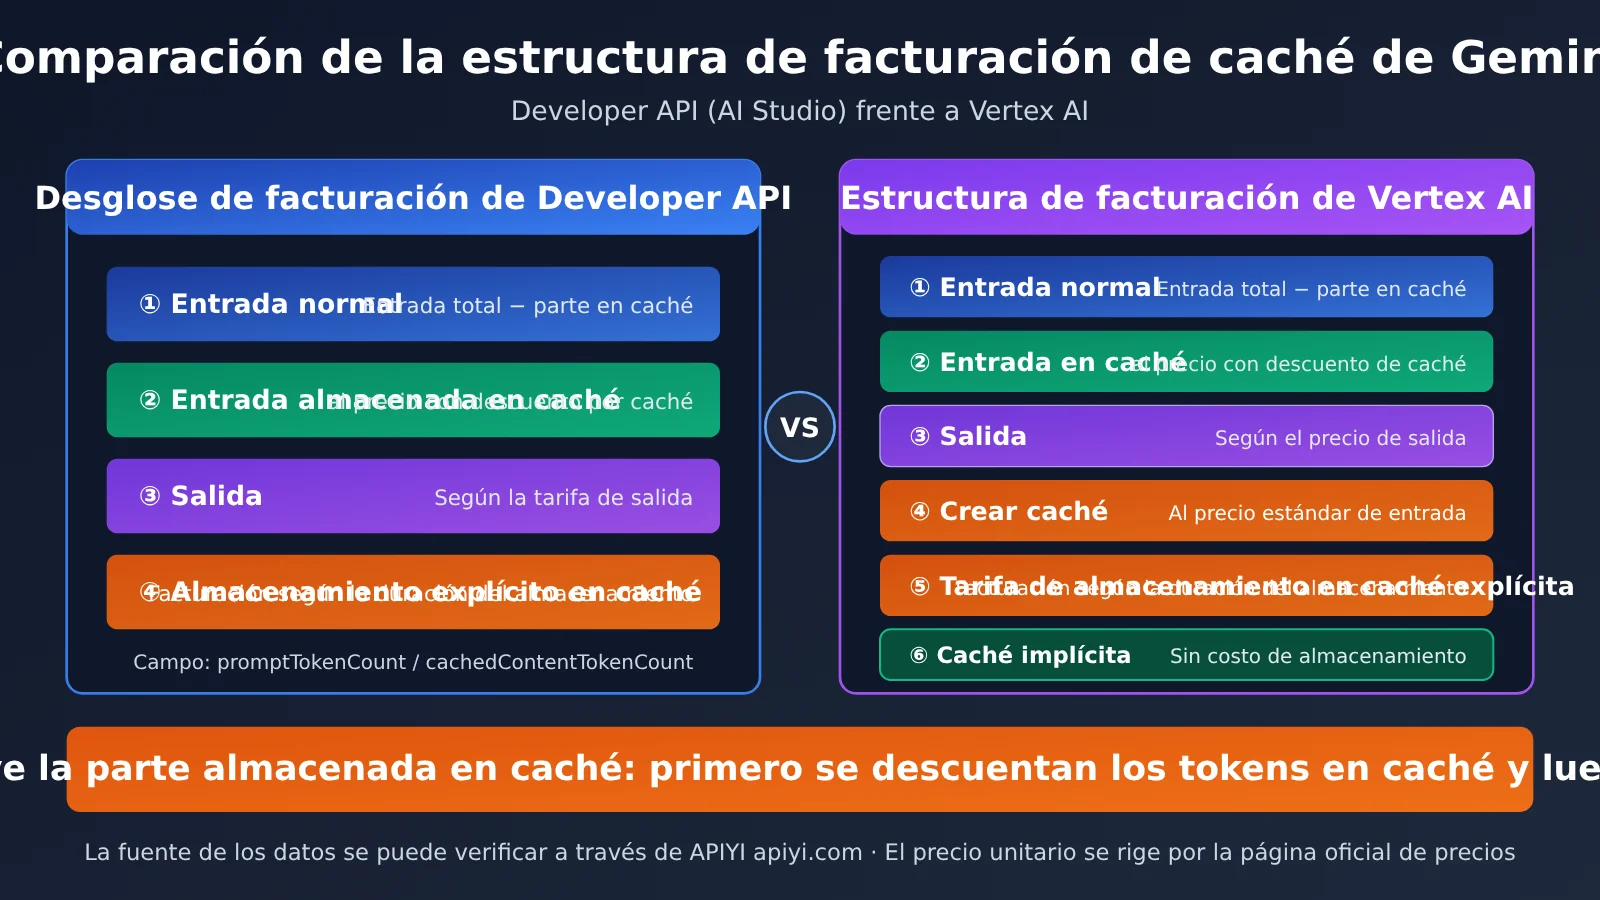
Muchas personas interpretan que una «coincidencia de caché» significa que la solicitud es gratis o que se aplica un descuento uniforme a toda la solicitud. No es así. En ambos servicios hay que distinguir cuatro conceptos: entrada normal, entrada en caché, salida y almacenamiento de caché explícita.
Comparación de las reglas de facturación
| Concepto | Developer API (AI Studio) | Vertex AI |
|---|---|---|
| Entrada normal (parte sin coincidencia) | Se cobra al precio habitual de entrada | Se cobra al precio habitual de entrada |
| Entrada en caché (parte coincidente) | Se cobra al precio de entrada en caché, que aparece por separado en la página de precios | Se cobra al precio de entrada en caché, que aparece por separado en la página de precios |
| Salida | Se cobra por separado | Se cobra por separado |
| Entrada usada para crear la caché | Se incluye en el cargo por uso de tokens en caché | Se cobra al precio estándar de entrada |
| Almacenamiento de caché implícita | No tiene costo | No tiene costo |
| Almacenamiento de caché explícita | Se cobra según el tiempo de almacenamiento | Tiene un costo de almacenamiento |
La documentación de Developer API indica que la facturación depende del uso de tokens en caché, el tiempo de almacenamiento, la entrada que no está en caché y la salida. Vertex especifica además dos puntos: la entrada usada para crear la caché se cobra al precio estándar de entrada; la caché implícita no tiene costo de almacenamiento, mientras que la explícita sí. Consulta las páginas de precios oficiales de cada servicio para conocer los precios vigentes, ya que varían según el modelo y la versión.
Fórmula para calcular el costo de entrada
En una solicitud normal de generación de texto, puedes entender el costo de entrada con esta fórmula:
输入费用 =
(总输入 tokens − 缓存命中 tokens)× 普通输入单价
+ 缓存命中 tokens × 缓存输入单价
La salida se calcula por separado. Si se usa una caché explícita, también se añade el costo de almacenamiento. Por ejemplo, supongamos que una solicitud tiene 10.000 tokens de entrada, de los cuales 8.000 coinciden con la caché. Entonces, 2.000 tokens se cobran al precio normal y 8.000 al precio de entrada en caché.
Un detalle que suele llevar a errores: la entrada total ya incluye la parte en caché
Para revisar los cargos, consulta la respuesta original de Google, no solo el «porcentaje de coincidencias de caché» que muestra el panel del servicio proxy. En usageMetadata, dentro de la respuesta de generateContent, hay dos campos clave:
| Campo | Significado | Qué tener en cuenta al revisar los cargos |
|---|---|---|
usageMetadata.promptTokenCount |
Total de tokens de entrada | Incluye la parte en caché |
usageMetadata.cachedContentTokenCount |
Tokens correspondientes a la parte en caché | Cantidad de tokens que coincidieron con la caché |
Por tanto, no calcules primero todo promptTokenCount al precio normal y luego añadas otro cargo por la entrada en caché: estarías contando dos veces esos tokens. Lo correcto es restar del total la parte en caché para obtener los tokens que se cobran al precio normal. Si usas la nueva Interactions API, el campo oficial para consultar las estadísticas de caché es usage.total_cached_tokens.
Dos aspectos que conviene separar
También hay que distinguir entre cuántos tokens de caché coinciden realmente en Google y cómo el servicio proxy aplica ese ahorro a tu factura. El primer dato se puede comprobar con los campos oficiales; el segundo depende de las reglas de facturación del propio servicio proxy, y la documentación oficial de Google no puede confirmarlo. Por eso, al revisar los cargos, conviene comprobar tanto los campos de caché que devuelve el servicio como el criterio de facturación que aparece en el desglose.
💡 Recomendación: al revisar los cargos, consulta primero los campos de tokens en caché de cada solicitud y luego el resumen de la factura. Si necesitas comparar OpenAI, Claude y Gemini con el mismo criterio, puedes usar APIYI apiyi.com para enviar la misma indicación a cada servicio y cambiar de modelo rápidamente.
Diferencias en la facturación de la caché entre Gemini, Claude y OpenAI
Los tres servicios gestionan la caché de forma distinta, así que también cambia el criterio para revisar los cargos. La tabla compara cómo se activa y cómo se factura. Los descuentos y los periodos de validez varían según la versión del modelo, así que los datos de la tabla son aproximados y corresponden al momento de redacción; consulta las páginas de precios oficiales para conocer los valores exactos:
| Aspecto | Gemini | Claude | OpenAI |
|---|---|---|---|
| Cómo se activa | Dos mecanismos: caché implícita automática y objetos de caché explícita | Explícita: se marca un punto de caché en la solicitud con cache_control |
Automática, sin modificar el código |
| Costo de escritura en caché | No hay costo para la caché implícita; la creación de caché explícita se cobra según la entrada y, además, tiene un costo de almacenamiento | Sí. El precio de escritura es superior al de la entrada normal y varía según el periodo de validez de 5 minutos o 1 hora | No hay un costo de escritura independiente |
| Precio de lectura de caché (coincidencia) | Inferior al de la entrada normal; el descuento depende del modelo | Aproximadamente una décima parte del precio de la entrada normal | Inferior al de la entrada normal; el descuento depende del modelo |
| Costo de almacenamiento | Solo para la caché explícita; se cobra según el tiempo de almacenamiento | No hay un cargo aparte; el periodo de validez se elige al escribir en la caché | No hay |
| Umbral mínimo | Varía según el modelo y el canal; en Vertex puede ser superior al de Developer API | Varía según el modelo; suele ser de 1.024 tokens o más | Normalmente, desde 1.024 tokens |
| Garantía de coincidencia | La caché implícita no ofrece garantías; la explícita es más predecible | Una vez marcado el punto, suele haber coincidencias estables durante el periodo de validez | Coincidencia automática de prefijos, sin garantía |
| Campos de uso | cachedContentTokenCount (incluido en promptTokenCount) |
cache_creation_input_tokens, cache_read_input_tokens; se muestran por separado de los tokens de entrada normales |
prompt_tokens_details.cached_tokens (incluido en prompt_tokens) |
Hay tres aspectos de la tabla que suelen generar confusión:
- Costo de escritura: Claude cobra más por escribir en la caché y menos por leerla. Por eso, «escribir mucho y leer poco» puede salir más caro que no usar caché. OpenAI no cobra por la escritura, así que no tener coincidencias no genera un costo adicional. La caché implícita de Gemini tampoco tiene costo de escritura; solo la caché explícita genera costos de creación y almacenamiento.
- Quién decide si se usa la caché: con Claude, quien envía la solicitud marca explícitamente el punto de caché, así que el comportamiento es más predecible. En la caché implícita de OpenAI y Gemini, la plataforma decide automáticamente; los desarrolladores solo pueden aumentar las probabilidades manteniendo estable el prefijo. Esta es una de las razones por las que algunas personas perciben que las coincidencias son más estables en Claude y OpenAI que en Gemini: en Gemini también influyen el umbral mínimo, el prefijo y el aislamiento entre canales.
- Criterio para calcular la entrada total: en Gemini y OpenAI, la entrada total ya incluye la parte en caché, así que hay que restarla antes de aplicar los precios. En Claude,
input_tokensno incluye las lecturas ni las escrituras de caché, por lo que hay que calcular cada uno de los tres conceptos por separado y sumarlos. Si aplicas la fórmula de un servicio a otro, el cálculo será incorrecto. Para revisar cargos de distintos modelos con APIYI apiyi.com, comprueba primero qué incluye cada campo devuelto.
Primeros pasos con la tasa de aciertos de caché de Gemini: realiza una prueba
Después de la teoría, lo más fiable es comprobarlo por tu cuenta. La idea es crear un prefijo fijo que supere el umbral mínimo, colocar la pregunta variable al final, enviar varias solicitudes seguidas y observar cómo cambian los campos de tokens en caché.
Ejemplo mínimo
El siguiente código usa el formato compatible con OpenAI e imprime la información de uso devuelta. Los nombres de los campos dependen de la respuesta real y pueden variar según la forma de integración:
import time
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # 使用 APIYI 统一接口
)

# 固定的长前缀:务必超过目标模型的最低缓存门槛
LONG_PREFIX = "这里放一段稳定不变的长文档或系统指令……" * 800

for i in range(3):
    resp = client.chat.completions.create(
        model="gemini-3.8-flash",
        messages=[
            {"role": "system", "content": LONG_PREFIX},
            {"role": "user", "content": f"请用一句话总结,第 {i} 次提问"},
        ],
    )
    print(i, resp.usage)
    time.sleep(2)
Ver el código completo de prueba y verificación
import time
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # 使用 APIYI 统一接口
)

LONG_PREFIX = "这里放一段稳定不变的长文档或系统指令……" * 800


def extract_cached_tokens(usage) -> int:
    """尝试从 usage 中读取缓存 token 数,字段名以实际返回为准"""
    details = getattr(usage, "prompt_tokens_details", None)
    if details is not None:
        cached = getattr(details, "cached_tokens", None)
        if cached is not None:
            return cached
    return 0


def estimate_input_cost(total_in: int, cached: int,
                        normal_price: float, cached_price: float) -> float:
    """
    按官方口径估算输入费用:
    总输入已包含缓存部分,所以普通部分 = 总输入 - 缓存部分
    单价请填入官方定价页当前数值(每百万 token)
    """
    normal_part = total_in - cached
    return (normal_part * normal_price + cached * cached_price) / 1_000_000


def run_test(model: str, rounds: int = 3):
    results = []
    for i in range(rounds):
        resp = client.chat.completions.create(
            model=model,
            messages=[
                {"role": "system", "content": LONG_PREFIX},
                {"role": "user", "content": f"请用一句话总结,第 {i} 次提问"},
            ],
        )
        usage = resp.usage
        cached = extract_cached_tokens(usage)
        results.append((i, usage.prompt_tokens, cached))
        print(f"第 {i} 次:总输入={usage.prompt_tokens},缓存命中={cached}")
        time.sleep(2)
    return results


if __name__ == "__main__":
    for m in ["gemini-3.8-flash"]:
        print("模型:", m)
        run_test(m)
🚀 Para empezar rápidamente: recomendamos usar APIYI, en apiyi.com, para preparar esta prueba comparativa. Solo tienes que cambiar el parámetro
modeldel mismo script para probar sucesivamente Gemini, OpenAI y Claude, y comparar de forma directa el comportamiento de caché de cada modelo.
Variables que debes controlar durante la prueba
Al ejecutar la prueba, revisa esta lista punto por punto para no confundir un problema propio con uno de la cadena de integración:
| Elemento | Qué hacer | Objetivo |
|---|---|---|
| Longitud del prefijo | Comprueba que supere el umbral mínimo actual del modelo | Descartar problemas con el umbral |
| Estabilidad del prefijo | No incluyas marcas de tiempo ni ID de solicitud al principio | Evitar alterar el prefijo |
| Ubicación del contenido variable | Coloca la pregunta del usuario al final | Mantener el prefijo común lo más largo posible |
| Intervalo entre solicitudes | Envíalas seguidas y en un intervalo breve | Seguir las recomendaciones oficiales |
| Grupo de control | Prueba la misma indicación con OpenAI o Claude | Determinar si la diferencia se debe al mecanismo del modelo o a la cadena de integración |
Cómo interpretar los resultados
Si el prefijo es lo bastante largo, mantiene una estructura estable y las solicitudes se envían con poco intervalo, pero Gemini sigue teniendo muy pocos aciertos de caché mientras que la misma indicación sí obtiene aciertos normales en OpenAI o Claude, la diferencia se debe al mecanismo de caché de Gemini y a las condiciones de la cadena ascendente, no a la forma de escribir la indicación. En ese caso, puedes considerar la caché explícita: fija el contenido extenso que quieras reutilizar, crea un objeto de caché y haz referencia a él en las solicitudes.
Si tu caso de uso consiste principalmente en conversaciones cortas, en vez de intentar aumentar la tasa de aciertos, conviene asumir que la caché de Gemini ofrece pocos beneficios en ese escenario y centrar la optimización de costos en elegir el modelo y controlar la longitud de las respuestas.
Preguntas frecuentes
Q1: ¿Por qué la tasa de aciertos de caché de Gemini es mucho menor que la de OpenAI y Claude?
La caché implícita de Gemini requiere que se cumplan varias condiciones: que el modelo sea compatible, que se alcance el umbral mínimo de tokens, que el prefijo sea estable y que las solicitudes se realicen con poca diferencia de tiempo. En Vertex también se aplica el aislamiento por proyecto, y la documentación oficial deja claro que los aciertos no están garantizados. Si falla cualquiera de estas condiciones, se cobra silenciosamente como entrada normal. Para identificar la causa en una cadena concreta, hay que revisar los registros de las solicitudes ascendentes.
Q2: ¿Google ha dicho oficialmente que usar un servicio intermediario reduce la tasa de aciertos de caché?
No. La documentación oficial solo especifica las condiciones de las que depende la caché: un prefijo reutilizable, un umbral mínimo de tokens y el ámbito de aplicación. Si la cadena de integración altera alguna de estas condiciones, la tasa de aciertos puede bajar. Para comparar el comportamiento de caché de distintos modelos, puedes usar APIYI, en apiyi.com, y hacer una prueba controlada con la misma indicación.
Q3: ¿La parte que acierta en la caché es gratis?
No. La parte que acierta se cobra con la tarifa de entrada en caché, que es menor que la de la entrada normal, pero no es gratuita. Las páginas de precios de ambos servicios muestran por separado los precios de entrada normal y de entrada en caché. La caché explícita también tiene un costo de almacenamiento.
Q4: ¿Debo sumar por separado la parte en caché a los tokens de entrada de la factura?
No. `promptTokenCount` representa la entrada total e incluye la parte en caché. Resta `cachedContentTokenCount` de la entrada total para obtener la parte que se cobra al precio normal; después, calcula por separado el costo de la parte en caché.
Q5: ¿Los umbrales de caché son iguales en AI Studio y Vertex?
No del todo. Según la documentación actual, Gemini 3.1 Pro Preview y Gemini 3.8 Flash tienen un umbral de 4.096 en Developer API y de 6.144 en Vertex. Para la generación anterior, Gemini 2.5 Pro tiene un umbral de 2.048 en ambos. Los umbrales pueden cambiar con las versiones de los modelos, así que conviene consultar los valores actuales de la documentación oficial.
Q6: Si cambio la clave API, ¿pierdo la caché?
Depende de si cambias de proyecto. En Vertex, la caché está aislada por proyecto de Google Cloud y no se comparte entre proyectos, así que cambiar a una clave de otro proyecto implica perder el acceso a esa caché. No se puede asumir directamente que se pierda al usar distintas claves del mismo proyecto.
Q7: ¿Me conviene usar caché implícita o explícita?
Si necesitas reutilizar repetidamente grandes bloques de contenido fijo, como documentos extensos o instrucciones de sistema largas, la caché explícita ofrece más previsibilidad, pero implica costos de desarrollo y almacenamiento. Si solo reutilizas contenido de vez en cuando, la caché implícita no tiene costo adicional, aunque sus beneficios son imprevisibles. Puedes hacer primero una comparación a pequeña escala con APIYI, en apiyi.com, y decidir después si vale la pena desarrollar la caché explícita.
Q8: ¿Puedo usar directamente la tasa de aciertos que muestra el panel del servicio intermediario para verificar la factura?
No es recomendable. Toma como referencia los campos de caché de la respuesta original oficial. Además, los aciertos reales en el servicio ascendente de Google y la forma en que el servicio intermediario los incluye en tu factura son cuestiones distintas; para esto último, debes revisar las reglas de facturación del propio intermediario.
Puntos clave sobre la tasa de aciertos de la caché
- El comportamiento observado es real: la caché de OpenAI y Claude funciona de forma estable, mientras que la tasa de aciertos de Gemini es baja e incluso puede acercarse a cero. Conviene analizarlo por separado.
- La documentación oficial no garantiza los aciertos: la caché implícita de Gemini no garantiza un ahorro en costos. Para usar la caché explícita, hay que crear un objeto de caché y hacer referencia a él.
- El umbral depende del modelo: los modelos más recientes tienen umbrales más altos. Además, los valores pueden variar entre Vertex y Developer API.
- Los aciertos dependen del prefijo: coloca el contenido largo al principio y no insertes allí datos variables, como la hora o un ID, porque romperían el prefijo común.
- Vertex separa la caché por proyecto: la caché no se comparte entre proyectos. Si las solicitudes se distribuyen entre varios proyectos, se pierde la caché.
- La entrada total incluye los tokens en caché:
promptTokenCountya incluye la parte almacenada en caché. Para conciliar los costos, réstala primero y luego aplica los precios correspondientes a cada parte. - Concilia los datos usando los campos de la respuesta: toma como referencia los campos de caché de la respuesta oficial y compara distintos modelos con la misma indicación a través de APIYI, apiyi.com.
Resumen
La baja tasa de aciertos de la caché de Gemini se debe a la combinación de varios factores: la caché implícita no garantiza aciertos, el umbral mínimo de tokens aumenta según el modelo, el prefijo debe mantenerse estable, la caché de Vertex está aislada por proyecto y la caché explícita requiere creación manual. Si se modifican algunos de estos elementos en la cadena de solicitudes, la tasa de aciertos puede bajar. Para determinar la causa concreta, hay que revisar los proyectos de origen y los registros de solicitudes.
En cuanto a la facturación, recuerda tres puntos: los aciertos de caché no son gratuitos; la entrada total incluye la parte almacenada en caché, así que no debes cobrarla dos veces; y la caché explícita tiene un costo adicional de almacenamiento, mientras que la implícita no. Para conciliar los costos, toma como referencia los campos de la respuesta oficial y verifica por separado los criterios de facturación del servicio proxy.
Como siguiente paso, te recomendamos usar el script de prueba de este artículo para comparar Gemini con OpenAI y Claude mediante un prefijo largo fijo. Después, decide si te conviene incorporar la caché explícita. Puedes validar el resultado rápidamente a través de APIYI, apiyi.com: varios modelos utilizan la misma interfaz, lo que facilita comparar costos.
Referencias
- Documentación de caché de Gemini API: información oficial sobre la caché implícita y explícita
- Enlace:
ai.google.dev/gemini-api/docs/caching -
Descripción: incluye el umbral mínimo de tokens y los factores que influyen en la facturación
-
Página de precios de Gemini API: precios de las entradas normales y en caché, las salidas y el almacenamiento
- Enlace:
ai.google.dev/gemini-api/docs/pricing -
Descripción: sirve para consultar los precios unitarios actuales
-
Descripción general de la caché de contexto en Vertex AI: aislamiento entre proyectos y reglas de facturación de la caché
- Enlace:
docs.cloud.google.com/vertex-ai/generative-ai/docs/context-cache/context-cache-overview -
Descripción: explica por qué la caché de Vertex no se comparte entre proyectos
-
Referencia de Gemini API
generateContent: campousageMetadatade la respuesta - Enlace:
ai.google.dev/api/generate-content - Descripción: incluye el campo de tokens en caché que se utiliza para revisar la facturación
Autor: equipo de APIYI
Intercambio técnico: puedes compartir en los comentarios tus experiencias al diagnosticar problemas con la caché de Gemini. Encontrarás más recursos en el centro de documentación de APIYI: docs.apiyi.com.