Al cambiar de gemini-3.1-pro-preview a Gemini 4 Argon, muchos desarrolladores han observado un problema: con la misma indicación, a veces las respuestas de Argon parecen «menos profundas». Es muy probable que la causa sea el valor predeterminado de la intensidad de razonamiento de Gemini 4 Argon. Según la documentación oficial de Google, el valor predeterminado de thinking_level en Gemini 4 Argon es medium, no high. En cambio, gemini-3.1-pro-preview usa high, el nivel más alto, de forma predeterminada. Si nunca has configurado explícitamente la intensidad de razonamiento en tu código o cliente, al migrar la profundidad de razonamiento del modelo puede bajar un nivel sin que te des cuenta.
El problema se complica porque clientes de chat habituales, como Cherry Studio, suelen tardar en incorporar los parámetros de razonamiento de los modelos nuevos. Puede que la opción para elegir la intensidad ni siquiera aparezca en el cuadro de entrada. En este artículo explicamos los niveles de intensidad de razonamiento de Gemini 4 Argon, sus valores predeterminados y cómo afectan al costo. Después, mostramos tres formas de configurarlos: mediante la API nativa, una interfaz compatible con OpenAI y los parámetros personalizados de Cherry Studio.
Qué te llevas de este artículo: al terminar, podrás configurar la intensidad de razonamiento de Gemini 4 Argon al nivel que quieras, independientemente de cómo lo invoques, y evitar problemas de migración como el truncamiento por max_tokens y los errores 400 por parámetros no admitidos.
Puntos clave sobre la intensidad de razonamiento de Gemini 4 Argon
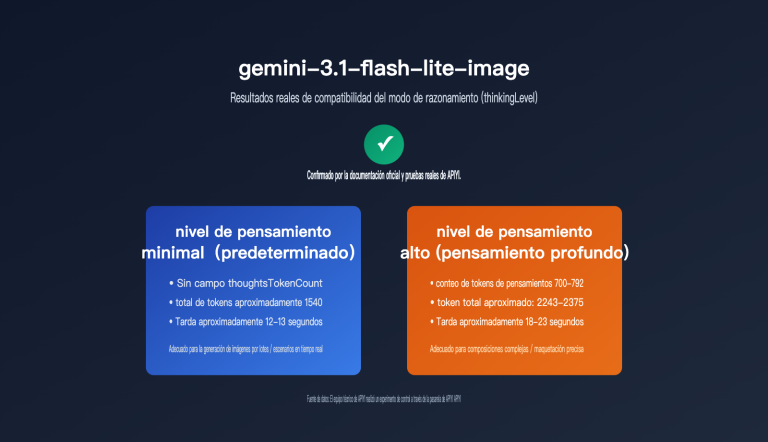
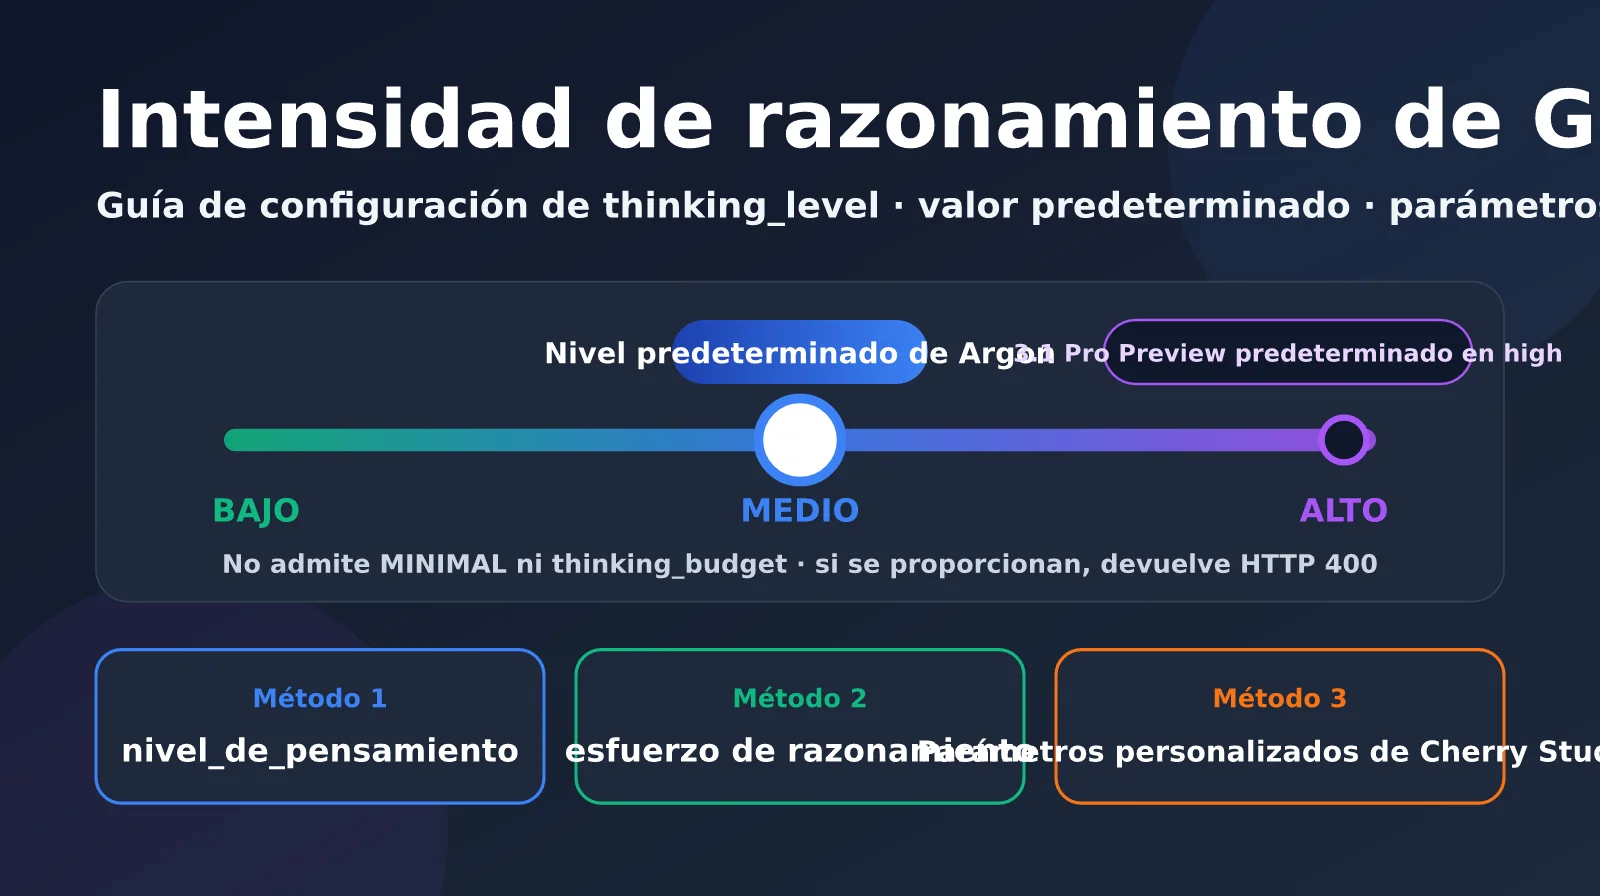
Gemini 4 Argon controla la intensidad de razonamiento mediante el parámetro thinking_level, que admite tres niveles: low, medium y high. A diferencia de los modelos anteriores, ya no permite configurar thinking_budget por número de tokens ni admite el nivel minimal. Si se especifica cualquiera de estos dos, la solicitud devuelve directamente un error HTTP 400. En la siguiente tabla resumimos la descripción oficial de los tres niveles, según la guía para desarrolladores de Google Cloud.
| Nivel de razonamiento | ¿Es el predeterminado? | Casos de uso recomendados oficialmente | Características |
|---|---|---|---|
| LOW | No | Clasificación, resúmenes y extracción de metadatos | Menor latencia y casi ningún token de razonamiento |
| MEDIUM | ✅ Predeterminado en gemini-4-argon | Programación habitual, invocación de herramientas, preguntas y respuestas sobre documentos, comprensión de video | Equilibrio entre velocidad, costo y precisión |
| HIGH | ✅ Predeterminado en la versión cyber-permissive | Ingeniería de software con varios archivos, demostraciones formales, diseño de arquitectura y búsqueda de vulnerabilidades | Razonamiento más profundo, con un aumento notable de la latencia hasta el primer token y del costo |
| MINIMAL | No compatible | — | Devuelve un error HTTP 400 |
| thinking_budget | No compatible | — | En los modelos anteriores se asignaba silenciosamente a otro valor; Argon devuelve directamente un error 400 |
Ten en cuenta que la versión gemini-4-argon-cyber-permissive, dirigida a defensores de redes del programa Fairwind, usa HIGH de forma predeterminada. La versión estándar, gemini-4-argon, usa MEDIUM. Además, en las tablas de evaluación de Google, todos los resultados de Argon se obtuvieron con el nivel de razonamiento más alto. Si lo usas con el valor predeterminado medium, el rendimiento real podría no alcanzar el nivel que sugieren las cifras oficiales.
Valores predeterminados de intensidad de razonamiento de Gemini 4 Argon y comparación con modelos anteriores
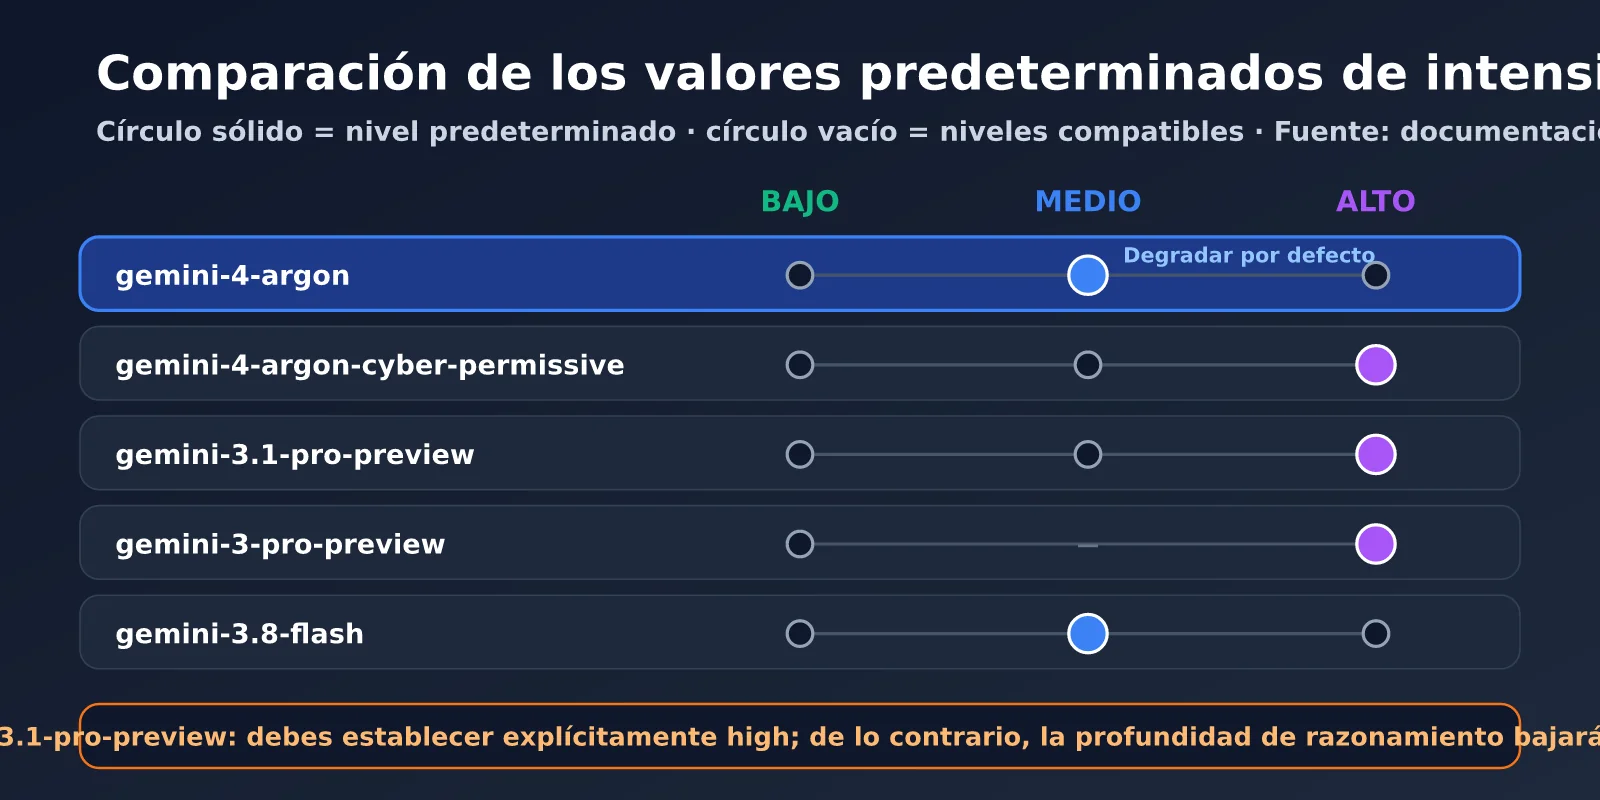
Si comparamos los valores predeterminados de razonamiento de Gemini 4 Argon con los de otros modelos recientes de Gemini, queda más claro dónde está el riesgo al migrar. Los siguientes datos proceden de la documentación oficial de Google sobre el modo thinking de Gemini API.
| Modelo | Nivel de razonamiento predeterminado | Niveles disponibles |
|---|---|---|
| gemini-4-argon | medium | low, medium, high |
| gemini-4-argon-cyber-permissive | high | low, medium, high |
| gemini-3.1-pro-preview | high | low, medium, high |
| gemini-3-pro-preview | high | low, high |
| gemini-3.8-flash | medium | low, medium, high |
| gemini-3-flash-preview | high | minimal, low, medium, high |
Como se ve, Google está reduciendo de high a medium el nivel de razonamiento predeterminado de sus nuevos modelos. Es el caso tanto de Gemini 3.8 Flash como de Gemini 4 Argon. Así se reducen la latencia y el costo predeterminados, pero quienes están acostumbrados a que 3.1 Pro «razone al máximo» de forma predeterminada deben tenerlo en cuenta: al migrar a Argon, hay que configurar high explícitamente para conservar la profundidad de razonamiento anterior.
🎯 Consejo para la migración: al pasar de gemini-3.1-pro-preview a Gemini 4 Argon, configura explícitamente el nivel de razonamiento en el código y compara la calidad de las respuestas de ambos modelos. Con la interfaz unificada de la plataforma APIYI apiyi.com, puedes invocar los dos modelos de Gemini para hacer pruebas A/B; solo tienes que cambiar el parámetro
model.
Cómo se relaciona la intensidad de razonamiento de Gemini 4 Argon con la facturación
La intensidad de razonamiento no solo afecta a la calidad de las respuestas, sino que también determina directamente el costo. Los tokens de razonamiento de Argon se cobran al precio de los tokens de salida: durante el periodo de lanzamiento, cuestan 10 USD por millón de tokens; el precio oficial será de 20 USD. Además, de forma predeterminada, el proceso de razonamiento no se muestra por completo al usuario. En otras palabras, cuanto más alto sea el nivel, más pagarás por ese razonamiento «invisible».
Con una estimación aproximada basada en el precio de lanzamiento, si una solicitud en nivel high genera 1.500 tokens de razonamiento, solo esa parte añade unos 0,015 USD. Con 10.000 solicitudes al día, el costo adicional rondaría los 4.500 USD al mes. Esta es también una razón práctica por la que Google ha bajado a medium el nivel predeterminado de Argon: la mayoría de las solicitudes habituales no necesitan el razonamiento más profundo, y con high de forma predeterminada muchos usuarios pagarían por un razonamiento que no necesitan. Por eso, lo más sensato es elegir el nivel según el tipo de tarea, en lugar de fijar high para todo.
3 formas de configurar la intensidad de razonamiento de Gemini 4 Argon
Según cómo realices la llamada, hay tres formas de configurar la intensidad de razonamiento de Gemini 4 Argon: thinking_level en el SDK nativo de Google, reasoning_effort en la interfaz compatible con OpenAI y el envío de parámetros nativos de Google mediante extra_body. No se pueden usar las tres al mismo tiempo; si lo haces, se producirá un error.
| Método | Ubicación del parámetro | Valores disponibles | Casos de uso |
|---|---|---|---|
| thinking_level nativo | thinking_config.thinking_level |
LOW / MEDIUM / HIGH | Google GenAI SDK, Vertex AI |
| reasoning_effort compatible con OpenAI | Campo de nivel superior del cuerpo de la solicitud: reasoning_effort |
minimal / low / medium / high | OpenAI SDK y distintos clientes compatibles |
Envío mediante extra_body |
extra_body.google.thinking_config |
low / medium / high | Cuando necesitas activar también opciones nativas, como los resúmenes del razonamiento |
En la interfaz compatible con OpenAI, reasoning_effort se convierte en thinking_level para Argon. Según la tabla de equivalencias oficial de Google, tanto minimal como low se convierten en low; medium se convierte en medium y high, en high. Sin embargo, Argon no reconoce niveles superiores como xhigh o max, que sí usan OpenAI y Anthropic. Si los envías, recibirás directamente un error 400.
Método 1: configurar thinking_level con el SDK nativo
Con Google GenAI SDK, basta con especificar directamente el nivel en ThinkingConfig. Los endpoints de Vertex AI admiten tres regiones: global, us y eu.
from google import genai
from google.genai import types

client = genai.Client(enterprise=True, project="YOUR_PROJECT", location="global")

resp = client.models.generate_content(
    model="gemini-4-argon",
    contents="为多生产者单消费者场景设计一个无锁环形缓冲区",
    config=types.GenerateContentConfig(
        thinking_config=types.ThinkingConfig(thinking_level="HIGH"),
        max_output_tokens=32768,
    ),
)
print(resp.text)
Método 2: configurar reasoning_effort en la interfaz compatible con OpenAI
Si tu proyecto está basado en OpenAI SDK, llamar a Argon mediante una interfaz compatible es la opción que requiere menos cambios: solo tienes que añadir el parámetro reasoning_effort.
from openai import OpenAI

client = OpenAI(api_key="YOUR_API_KEY", base_url="https://api.apiyi.com/v1")

resp = client.chat.completions.create(
    model="gemini-4-argon",
    reasoning_effort="high",      # 映射为 thinking_level=high
    max_tokens=32000,             # 必须为思考 token 预留空间
    messages=[{"role": "user", "content": "审查这段并发代码的竞态条件"}],
)
print(resp.choices[0].message.content)
print(resp.usage)
Ver el código completo: envío mediante extra_body y prueba comparativa de los tres niveles
import time
from openai import OpenAI

client = OpenAI(api_key="YOUR_API_KEY", base_url="https://api.apiyi.com/v1")
PROMPT = "一个 Kubernetes Pod 一直处于 CrashLoopBackOff,请给出系统的排查步骤和命令"


def call_with_effort(level: str):
    """方式二:OpenAI 兼容的 reasoning_effort"""
    start = time.time()
    resp = client.chat.completions.create(
        model="gemini-4-argon",
        reasoning_effort=level,
        max_tokens=32000,
        messages=[{"role": "user", "content": PROMPT}],
    )
    return resp, time.time() - start


def call_with_extra_body(level: str):
    """方式三:extra_body 透传 Google 原生 thinking_config
    注意:不能与 reasoning_effort 同时使用"""
    return client.chat.completions.create(
        model="gemini-4-argon",
        max_tokens=32000,
        messages=[{"role": "user", "content": PROMPT}],
        extra_body={
            "google": {
                "thinking_config": {
                    "thinking_level": level,
                    "include_thoughts": True,
                }
            }
        },
    )


if __name__ == "__main__":
    for level in ("low", "medium", "high"):
        resp, cost_time = call_with_effort(level)
        u = resp.usage
        print(f"[{level:6}] 耗时 {cost_time:5.1f}s | 输出 {u.completion_tokens} token")
💡 Consejo para las llamadas: la interfaz compatible con OpenAI es la forma más sencilla de integrar Gemini 4 Argon; apenas tendrás que modificar el código que ya usa OpenAI SDK. Te recomendamos obtener créditos de prueba en APIYI apiyi.com y usar el script comparativo anterior para probar cómo afectan los tres niveles a tus tareas habituales.
Configurar la intensidad de razonamiento de Gemini 4 Argon en Cherry Studio
En la esquina inferior derecha del cuadro de entrada de Cherry Studio hay un menú desplegable para elegir la intensidad de razonamiento, pero esta opción solo aparece en los modelos de razonamiento que el cliente reconoce. Según los issues de la comunidad, Cherry Studio determina si un modelo admite esta opción a partir de su catálogo integrado, generado durante la compilación a partir de models.dev y OpenRouter. No consulta en tiempo real las capacidades que devuelve la interfaz. Por eso, en modelos recién publicados como Gemini 4 Argon, es posible que el menú no aparezca hasta que se actualice el catálogo del cliente, o que la opción esté disponible pero no surta efecto.
En estos casos, lo más fiable es usar la función de parámetros personalizados de Cherry Studio. Según la documentación oficial, los parámetros personalizados se añaden directamente al cuerpo de la solicitud y tienen prioridad sobre los parámetros integrados.
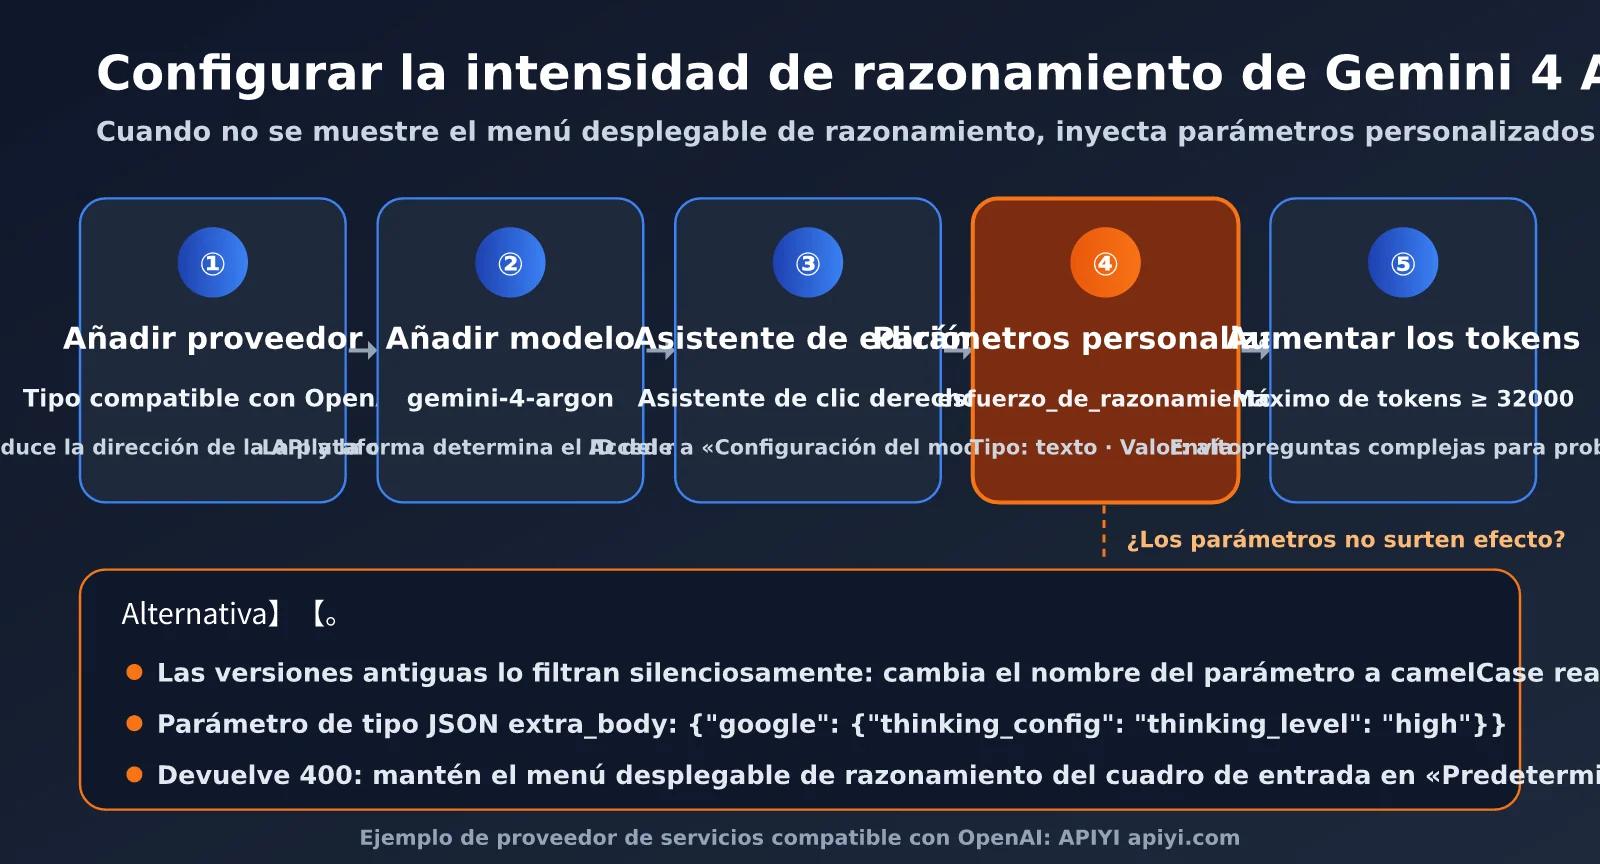
Pasos para configurar parámetros personalizados en Cherry Studio
A continuación se describen los pasos para configurar un proveedor compatible con OpenAI:
- Añadir un proveedor: en los ajustes, añade un proveedor compatible con OpenAI e introduce la dirección de la API y la clave; por ejemplo,
https://api.apiyi.comde APIYI. - Añadir un modelo: añade el ID de modelo
gemini-4-argonal proveedor. - Abrir los ajustes del asistente: en la lista de asistentes, haz clic derecho en el asistente que quieras configurar, selecciona «Editar asistente» y ve a la pestaña «Ajustes del modelo».
- Añadir un parámetro personalizado: escribe
reasoning_effortcomo nombre del parámetro, selecciona «Texto» como tipo e introducehigh(olowomedium) como valor. - Aumentar el límite de salida: activa y aumenta «Número máximo de tokens». Se recomienda usar al menos 32000 para dejar espacio al proceso de razonamiento.
- Enviar una prueba: prueba con una pregunta que requiera varios pasos de razonamiento y compara el tiempo de respuesta y el contenido del razonamiento antes y después de configurar el parámetro.
Si la intensidad de razonamiento sigue sin surtir efecto después de seguir los pasos anteriores, comprueba estas situaciones habituales:
| Problema | Posible causa | Solución |
|---|---|---|
No hay cambios después de configurar reasoning_effort |
Las versiones antiguas filtraban silenciosamente este parámetro en el modo compatible con OpenAI | Actualiza a la última versión o prueba con el nombre de parámetro reasoningEffort |
| No aparece el menú desplegable de intensidad de razonamiento en el cuadro de entrada | El catálogo de modelos integrado aún no incluye Argon | Usa parámetros personalizados; si tienes experiencia, también puedes añadir la información sobre las capacidades de razonamiento en la configuración del modelo |
| La solicitud devuelve un error 400 | El cliente envía niveles como max o xhigh, que Argon no admite |
Deja el menú desplegable en «Predeterminado» y especifica low, medium o high únicamente mediante parámetros personalizados |
| La configuración integrada sobrescribe el parámetro | La opción de razonamiento del cuadro de entrada entra en conflicto con el parámetro personalizado | Deja el cuadro de entrada en «Predeterminado» para evitar configurarlo en ambos sitios |
| Necesitas enviar parámetros nativos | Quieres activar también los resúmenes del razonamiento | Añade un parámetro de tipo JSON llamado extra_body con el valor {"google": {"thinking_config": {"thinking_level": "high"}}} |
El problema por el que reasoning_effort se filtraba silenciosamente se corrigió en Cherry Studio mediante una PR en marzo de 2026. Las nuevas versiones lo convierten automáticamente en reasoningEffort, que es el nombre que se usa internamente. Si tienes una versión anterior, puedes escribir directamente el nombre en formato camelCase, reasoningEffort, para evitar el filtro.
La idea es la misma con otros clientes de chat habituales: busca una opción llamada «Parámetros personalizados», «Cuerpo adicional de la solicitud» o «Parámetros avanzados» y añade reasoning_effort como campo de nivel superior del cuerpo de la solicitud. Si el cliente solo admite parámetros en formato JSON, usa extra_body para enviar el thinking_config nativo. Cuando termines, compara el tiempo de respuesta y el consumo de tokens con la misma pregunta compleja para confirmar que el parámetro se aplica correctamente.
🚀 Recomendación para clientes: para integrar Gemini 4 Argon en Cherry Studio, recomendamos elegir un proveedor compatible con OpenAI, ya que el envío de parámetros es más fiable. APIYI apiyi.com ofrece una interfaz unificada compatible con OpenAI: basta con configurarla una vez en Cherry Studio para usar modelos de Gemini, Claude, GPT y otras familias.
Pruebas del nivel de razonamiento de Gemini 4 Argon y guía para evitar errores
El nivel de razonamiento afecta directamente a la latencia, el costo y la calidad de las respuestas. El blog técnico independiente ComputingForGeeks realizó una serie de pruebas comparativas con Argon en tareas de operaciones y obtuvo resultados muy útiles.
| Métrica | Predeterminado (medium) | high | Diferencia |
|---|---|---|---|
| Promedio de tokens de salida | 463 | 1,836 | Aproximadamente 4 veces más |
| Latencia promedio | 5.5 segundos | 15.3 segundos | Aproximadamente 2.8 veces más |
| Primer token visible | Aproximadamente 4.3 segundos | 12–13 segundos | Primero genera unos 1,400 tokens de razonamiento |
| Costo de 9 invocaciones (precio promocional) | $0.045 | $0.169 | Aproximadamente 3.8 veces más |
| low / medium frente a la configuración predeterminada | Prácticamente iguales | — | En tareas cortas, ninguno generó tokens de razonamiento |
Estos datos muestran dos cosas. Primero, en tareas sencillas y breves, low, medium y la configuración predeterminada prácticamente no se diferencian: ninguno genera tokens de razonamiento. Solo el nivel high activa un razonamiento realmente profundo. Segundo, el costo de high es evidente: casi cuadruplica el costo y añade unos 8 segundos de latencia antes del primer token. Hay que tener en cuenta que la prueba solo incluyó indicaciones cortas; con tareas largas y complejas, el nivel medium también podría generar un proceso de razonamiento.
4 errores frecuentes al configurar el nivel de razonamiento de Gemini 4 Argon
Según la guía de migración de Google y las pruebas de la comunidad, estos son algunos de los errores más comunes al configurar el nivel de razonamiento de Gemini 4 Argon:
- Un valor demasiado bajo de max_tokens puede producir una respuesta vacía:
max_output_tokensincluye tanto los tokens de razonamiento como los del texto de respuesta. En una prueba, al usar el nivel high con un máximo de 1024 tokens, Argon dedicó los 1021 tokens disponibles al razonamiento y terminó devolviendo una cadena vacía, conMAX_TOKENScomo motivo de finalización. Si usas high, reserva al menos 16K–32K tokens. - Mantener thinking_budget provoca un error:
gemini-3.1-pro-previewconvierte silenciosamentethinking_budgeten un nivel de razonamiento, pero Argon devuelve directamente un error 400. No olvides eliminar este parámetro al migrar. - Se ignoran los parámetros de muestreo, como temperature: la documentación de Google indica que el backend de Argon ignora los valores personalizados de temperature. Además,
frequency_penalty,presence_penaltyycandidate_countdevuelven un error 400. Se recomienda controlar la profundidad del razonamiento con el nivel correspondiente y el formato de salida conresponse_schema. - Reducir max_tokens para ahorrar costos puede ser contraproducente: Google recomienda bajar el nivel de razonamiento para reducir el costo y la latencia, en lugar de reducir max_tokens, ya que esto puede truncar la respuesta.
📊 Recomendación para elegir un nivel: para consultas cotidianas y programación sencilla, basta con el nivel predeterminado medium. Cambia a high para tareas como diseñar arquitecturas complejas, refactorizar varios archivos o demostrar teoremas. Puedes comparar el consumo de tokens de cada nivel en los registros de invocaciones de APIYI apiyi.com para encontrar el mejor equilibrio entre calidad y costo.
Preguntas frecuentes
P1: ¿El nivel de razonamiento predeterminado de Gemini 4 Argon es high?
No. La versión estándar `gemini-4-argon` usa medium de forma predeterminada. La única excepción es `gemini-4-argon-cyber-permissive`, dirigido a equipos de defensa de redes, cuyo nivel predeterminado es high. Esto es distinto de `gemini-3.1-pro-preview`, que viene configurado con el nivel más alto, high. Si necesitas la máxima capacidad de razonamiento, debes configurar explícitamente `thinking_level=»high»` o `reasoning_effort=»high»`.
P2: ¿Se puede desactivar el razonamiento de Gemini 4 Argon o establecerlo en minimal?
No. Argon solo admite los niveles low, medium y high. Configurar minimal o `thinking_budget` devuelve un error HTTP 400. Si pasas `reasoning_effort=»minimal»` a través de una interfaz compatible con OpenAI, se convierte en low. Si necesitas una latencia muy baja, puedes considerar modelos que admitan el nivel minimal, como la serie Gemini 3.x Flash.
P3: ¿Qué hago si no aparece la opción de nivel de razonamiento en Cherry Studio?
Esto se debe a que el catálogo de modelos integrado de Cherry Studio todavía no incluye Argon. Puedes añadir el parámetro personalizado `reasoning_effort` en «Editar asistente → Configuración del modelo», con tipo de texto y valor `high`. Los parámetros personalizados tienen prioridad sobre los integrados. Se recomienda usar proveedores de servicios compatibles con OpenAI, como APIYI apiyi.com, que suelen transmitir los parámetros de forma más estable.
P4: ¿Cómo puedo confirmar que el nivel de razonamiento se está aplicando?
La forma más directa es consultar la cantidad de tokens de salida en `usage` y el tiempo de respuesta: con el nivel high, tanto los tokens de salida como la latencia hasta el primer token serán claramente superiores a los de la configuración predeterminada. En Cherry Studio también puedes comprobar si aparece contenido de razonamiento. Se recomienda probar la misma pregunta compleja con el nivel predeterminado y con high, y comparar los resultados.
Resumen
La conclusión clave sobre la intensidad de razonamiento de Gemini 4 Argon es esta: el valor predeterminado es medium, no high. Esto es distinto de gemini-3.1-pro-preview, cuyo valor predeterminado es el nivel más alto. Si migras sin configurar este parámetro explícitamente, la profundidad de razonamiento del modelo bajará un nivel sin que te des cuenta. Argon solo admite tres niveles: low, medium y high. Tanto thinking_budget como minimal provocarán un error 400. Además, al usar el nivel high, debes reservar suficientes max_tokens para los tokens de razonamiento.
En cuanto a la forma de invocarlo, el SDK nativo utiliza thinking_level, mientras que la interfaz compatible con OpenAI utiliza reasoning_effort. En clientes como Cherry Studio, que todavía no admiten las opciones de razonamiento de Argon, puedes añadirlas mediante parámetros personalizados. Para las tareas habituales, recomendamos mantener el valor predeterminado medium y cambiar a high cuando una tarea compleja lo requiera; decide qué nivel usar basándote en pruebas reales.
Recomendamos conectarse a Gemini 4 Argon de forma unificada y compatible con OpenAI a través de APIYI apiyi.com. Así puedes cambiar fácilmente la intensidad de razonamiento con un único parámetro, reasoning_effort, tanto en el código como en clientes como Cherry Studio.
Referencias:
- Documentación de Google Gemini API sobre pensamiento: ai.google.dev/gemini-api/docs/thinking
- Documentación de Google Gemini API sobre compatibilidad con OpenAI: ai.google.dev/gemini-api/docs/openai
- Guía para desarrolladores de Google Cloud sobre Gemini 4 Argon: docs.cloud.google.com/gemini-enterprise-agent-platform/models/guides/gemini-4-argon
- Documentación de configuración del asistente de Cherry Studio: docs.cherryai.com.cn
- Incidencias #11987 y #19761 de Cherry Studio en GitHub: github.com/CherryHQ/cherry-studio
Autor: Equipo de APIYI | Compartimos de forma continua prácticas para integrar Modelos de Lenguaje Grande y ajustar sus parámetros. Visita APIYI apiyi.com para ver más tutoriales sobre la integración de modelos de IA.