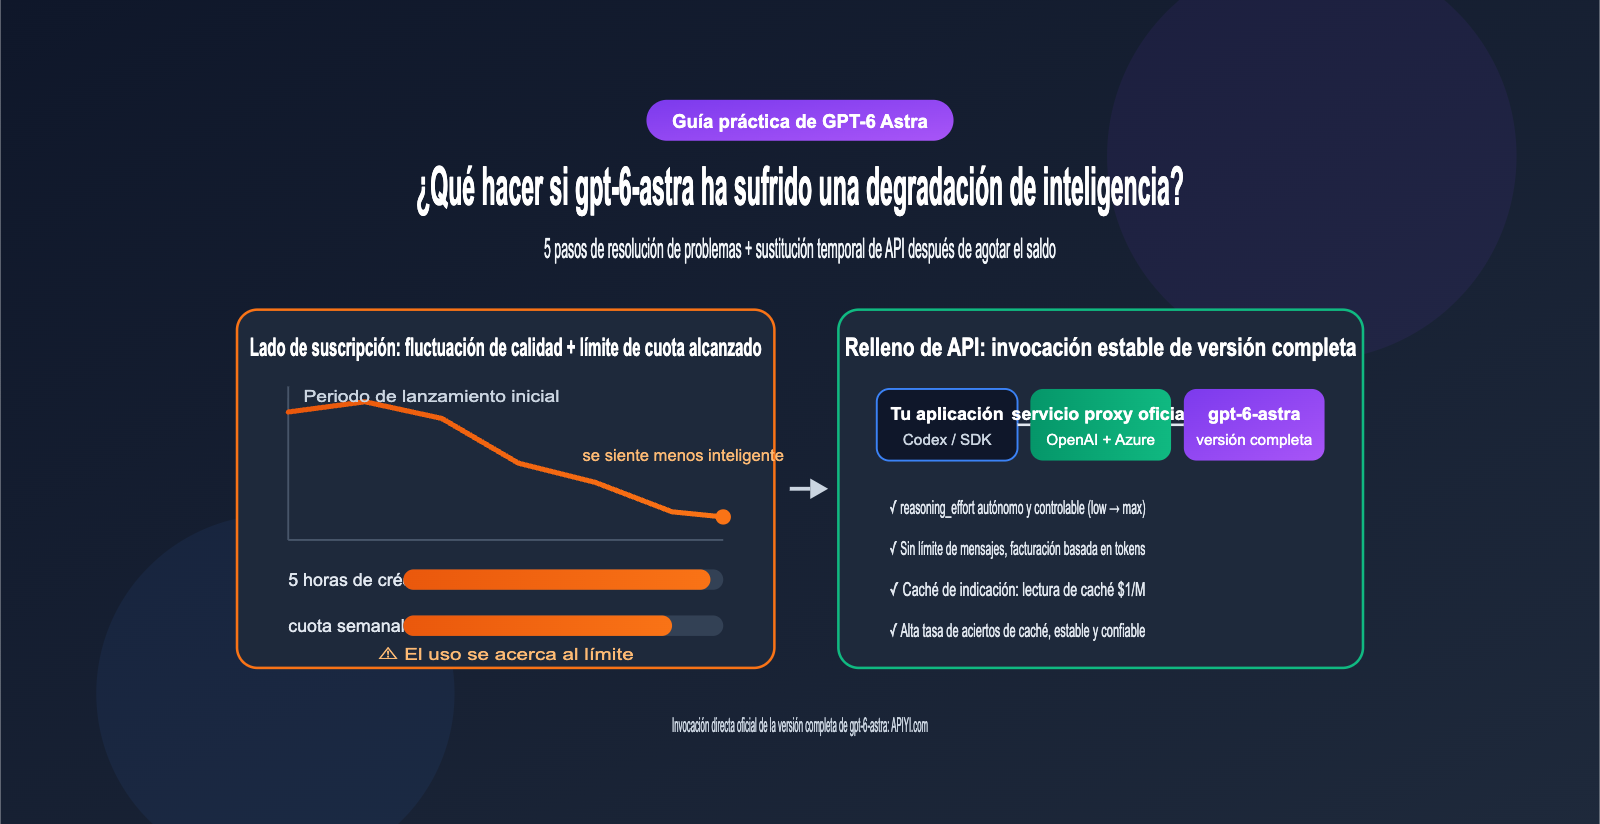
El gpt-6-astra se lanzó el 3 de septiembre de 2026 y estuvo disponible para todos al día siguiente. Sin embargo, apenas una semana después, las redes sociales se llenaron de quejas sobre una supuesta "degradación de inteligencia" (conocida como lobotomía o nerfing): los mismos indicadores producían resultados de menor calidad que en los primeros días, y el nivel de razonamiento "Extra high" ahora es más rápido pero entrega respuestas más superficiales. Al mismo tiempo, los límites de uso de Astra en ChatGPT y Codex se han vuelto mucho más estrictos en comparación con la generación anterior, el GPT-5.6 Sol, dejando a muchos desarrolladores bloqueados a mitad de camino. En este artículo, te presento un método de 5 pasos para determinar si el gpt-6-astra realmente ha perdido capacidad, junto con una solución de respaldo mediante el servicio proxy de API oficial para que tu flujo de trabajo no se detenga.
Valor principal: Al terminar de leer, sabrás distinguir entre una "degradación real" y un "sesgo de percepción", conocerás los límites reales de tu suscripción y aprenderás a utilizar estrategias de caché y niveles de razonamiento controlados para invocar la versión completa del gpt-6-astra a un costo razonable.
Puntos clave sobre la controversia de la degradación del gpt-6-astra
Antes de empezar a investigar, pongamos sobre la mesa los hechos conocidos. Según medios internacionales como Decrypt, las quejas se concentraron una semana después del lanzamiento de Astra. Algunos desarrolladores (incluido el equipo de opencode) volvieron al GPT-5.6 Sol debido a que los costos se duplicaron y la calidad no cumplió con las expectativas. Sin embargo, hasta el momento de escribir este artículo, OpenAI no ha publicado una declaración oficial sobre Astra, y muchos usuarios experimentados sostienen que el modelo no ha cambiado, sino que, tras la "luna de miel", la gente ha empezado a notar más sus errores.
| Punto | Hecho conocido | Qué significa para ti |
|---|---|---|
| Fecha de lanzamiento | 03-09-2026 para usuarios aprobados, 04-09 disponible para todos | El modelo sigue en fase inicial, las políticas del servidor pueden cambiar con frecuencia |
| Quejas de degradación | Usuarios reportan peor salida con la misma indicación y menor tiempo en niveles de razonamiento altos | Es necesario verificar de forma reproducible, no solo basarse en sensaciones |
| Respuesta oficial | No hay declaración oficial sobre Astra | No se puede confirmar si se ha ajustado la intensidad de razonamiento predeterminada |
| Precedentes | En julio de 2026, Sol también enfrentó dudas similares; OpenAI negó una reducción deliberada, pero admitió experimentar con ajustes de "intensidad de razonamiento" | El presupuesto de razonamiento en ChatGPT no está bajo tu control total |
| Restricción de límites | Plus en Work/Codex tiene aprox. 5-45 mensajes/5 horas, la mitad que en la época de Sol | Los usuarios intensivos alcanzan el límite fácilmente en horas pico |
¿Por qué el gpt-6-astra "se siente más tonto"?
La posibilidad de que los pesos del modelo hayan sido reemplazados en secreto es bastante baja; la causa más común suele estar en el "presupuesto de razonamiento". El gpt-6-astra en la API admite cinco niveles de intensidad de razonamiento: low, medium, high, xhigh y max. Cuanto más alto es el nivel, más pasos de pensamiento realiza el modelo antes de responder, lo que aumenta tanto la calidad como el tiempo de respuesta. En productos de suscripción como ChatGPT y Codex, el presupuesto de razonamiento es gestionado de forma centralizada por la plataforma. Si la plataforma reduce el presupuesto real para manejar la presión de cómputo, lo que el usuario percibe es un resultado "más rápido pero más superficial", lo cual coincide plenamente con las quejas.
Por otro lado, desarrolladores como Theo señalan que la varianza en la salida de Astra es bastante alta: para una misma tarea, puede dar un resultado brillante o cometer un error básico. Al principio, es fácil recordar los casos brillantes, pero con el uso prolongado, los fallos se vuelven más evidentes. Esta brecha psicológica también se interpreta como una "degradación". Por lo tanto, la clave de la investigación es separar tres variables: "gestión de la plataforma", "varianza del modelo" y "uso personal".
Método de 5 pasos para solucionar problemas de "degradación" en gpt-6-astra
Este flujo de trabajo es ideal para cuando sospechas que gpt-6-astra ha sufrido una degradación en su rendimiento. Sigue estos pasos en orden para descartar causas específicas y evitar cambiar de modelo a ciegas.
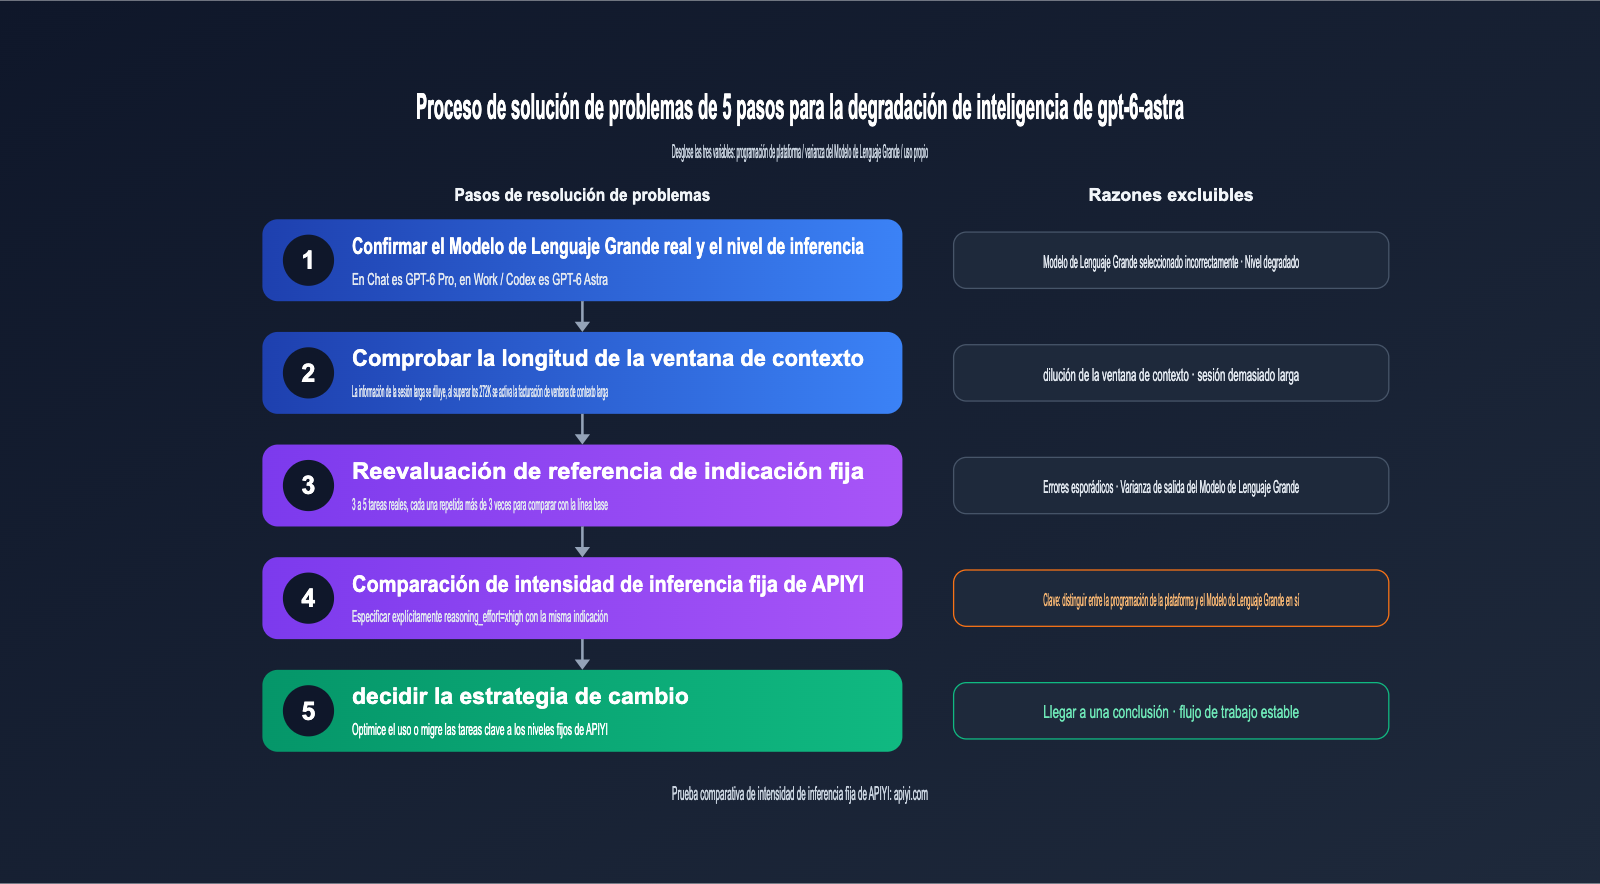
- Confirma el modelo y el nivel de intensidad: En ChatGPT, Astra aparece como GPT-6 Pro en el chat, mientras que en Work y Codex es GPT-6 Astra; ambos tienen sistemas de cuotas distintos. Primero, verifica qué modelo estás ejecutando realmente y qué nivel de intensidad de razonamiento has seleccionado. Comprueba si la interfaz ya te ha avisado de una degradación por falta de cuota.
- Revisa si la ventana de contexto es demasiado larga: La ventana de contexto de Astra es de 1,050,000 tokens, pero la dilución de la información inicial en sesiones largas es un problema común en todos los Modelos de Lenguaje Grande. Si una sesión de Codex lleva horas activa, inicia una nueva y simplifica el material de fondo antes de probar.
- Realiza pruebas de referencia con una indicación fija: Elige de 3 a 5 tareas reales que conozcas bien, guarda la salida inicial como línea base y repite la misma indicación al menos 3 veces para ver si el rendimiento empeora de forma constante o si son errores aleatorios. Una comparación única carece de valor estadístico.
- Usa la API con intensidad de razonamiento fija como control: Especifica explícitamente
reasoning_efforta través de la API y compara la salida con la de ChatGPT usando la misma indicación. Si el resultadoxhighde la API es notablemente superior al de la suscripción, es muy probable que el problema esté en el presupuesto de inferencia de la plataforma y no en el modelo en sí. - Decide tu estrategia según los resultados: Si es un problema de uso, optimiza tus indicaciones y la gestión de la sesión; si es un problema de programación o cuotas de la plataforma, traslada las tareas críticas a una invocación de API controlada.
| Fenómeno | Causa más probable | Método de verificación | Acción recomendada |
|---|---|---|---|
| Respuesta rápida pero razonamiento superficial | Presupuesto de inferencia reducido | Comparar con xhigh en API |
Mover tareas críticas a la API con nivel fijo |
| Errores frecuentes en sesiones largas | Dilución de contexto o superación del rango de 272K | Probar en una sesión nueva | Dividir tareas y simplificar contexto |
| Resultados inconsistentes en la misma tarea | Alta varianza en la salida del modelo | Ejecutar la misma indicación 3-5 veces | Añadir pasos de validación o muestreo múltiple |
| Aviso repentino de uso insuficiente | Límite de 5 horas o cuota semanal alcanzado | Revisar panel de uso | Esperar al reinicio o usar la API como respaldo |
| Calidad de código notablemente inferior | Cambio de nivel o deriva de la indicación | Comparar con la línea base inicial | Fijar la indicación del sistema y el nivel |
🎯 Consejo de diagnóstico: El paso 4 es fundamental para distinguir entre un "problema de plataforma" y un "problema de modelo". Recomendamos utilizar APIYI (apiyi.com) para ejecutar la misma indicación con los niveles
highyxhighpor separado. Esta plataforma ofrece gpt-6-astra mediante un proxy directo y oficial, manteniendo los parámetros de llamada idénticos a la interfaz nativa de OpenAI, lo que hace que los resultados de comparación sean mucho más fiables.
¿Qué hacer cuando se agota el límite de gpt-6-astra?
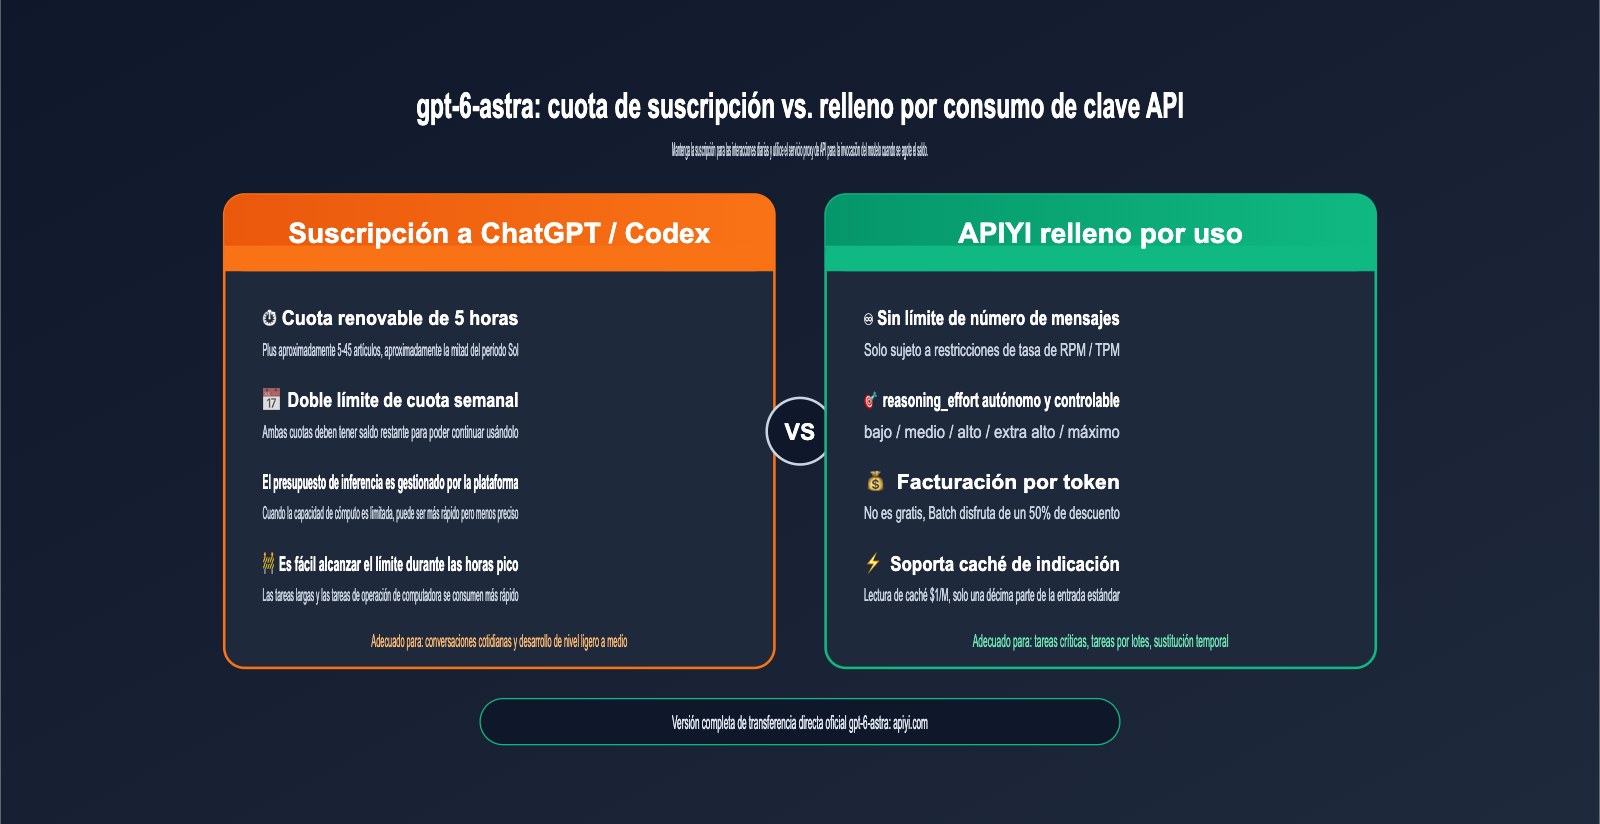
Incluso si el modelo no ha sufrido una degradación de rendimiento, quedarse sin cuota es suficiente para interrumpir el ritmo de trabajo. Según información recopilada de medios y comunidades internacionales, Astra utiliza una doble restricción en ChatGPT Work y Codex: un "límite móvil de 5 horas + límite semanal". Para seguir usándolo, ambos deben tener saldo disponible. Además, se ha reportado que, tras el reinicio de cuotas del 5 de septiembre, los límites para algunos usuarios intensivos se han vuelto aún más estrictos. La siguiente tabla muestra estimaciones de la comunidad; los datos oficiales siempre deben consultarse en el panel de uso de OpenAI.
| Plan de suscripción | Cuota estimada de Astra en Work/Codex | GPT-6 Pro en Chat | Perfil de usuario |
|---|---|---|---|
| Plus | Aprox. 5-45 mensajes / 5 horas | No disponible | Uso ligero, tareas complejas ocasionales |
| Pro $100 | Aprox. 25-225 mensajes / 5 horas | Aprox. 50 mensajes / semana | Desarrollo diario principal |
| Pro $200 | Aprox. 100-900 mensajes / 5 horas | Aprox. 200 mensajes / semana | Uso intensivo todo el día |
| API (pago por uso) | Sin límite de mensajes, sujeto a RPM/TPM | No aplica | Tareas por lotes, críticas o respaldo |
La gran diferencia en los rangos se debe a que el consumo de cuota por mensaje depende de la complejidad de la tarea, el nivel de razonamiento y la longitud del contexto. No es lo mismo una tarea de automatización de 40 minutos que una pregunta sencilla. Para la mayoría de los desarrolladores, subir al plan de $200 solo por picos de demanda ocasionales no resulta rentable; una estrategia más económica es mantener la suscripción actual y utilizar la API para cubrir los momentos de alta demanda.
Tres ventajas de usar la API de gpt-6-astra como respaldo
Usar la API como respaldo temporal no solo te da "más cuota", sino que te devuelve el control. Primero, tú especificas explícitamente la intensidad de razonamiento, evitando ajustes silenciosos de la plataforma, lo que contrarresta la incertidumbre de la "degradación de inteligencia". Segundo, la API se factura por token, por lo que no pagas cuando no la usas, ideal para necesidades intermitentes. Tercero, la API admite optimizaciones de costos como Batch y caché de indicaciones.
Al elegir un proveedor, asegúrate de que sea una conexión directa oficial. Algunos canales de terceros usan interfaces inversas o redirigen las peticiones a otros modelos, lo que empeora el problema. El servicio gpt-6-astra de APIYI (apiyi.com) ofrece la versión completa, con conexión directa oficial a OpenAI y Azure, manteniendo los parámetros de interfaz idénticos a los originales, siendo un complemento estable ideal.
Inicio rápido con la API de gpt-6-astra
gpt-6-astra admite los endpoints Chat Completions, Responses y Batch, aceptando texto e imágenes como entrada. El siguiente ejemplo minimalista utiliza el SDK oficial de OpenAI; solo necesitas reemplazar base_url y la clave API para ejecutarlo.
Ejemplo de invocación minimalista de gpt-6-astra
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_APIYI_KEY",
    base_url="https://api.apiyi.com/v1"
)

response = client.chat.completions.create(
    model="gpt-6-astra",
    reasoning_effort="xhigh",  # low / medium / high / xhigh / max
    messages=[
        {"role": "system", "content": "Eres un ingeniero backend senior, responde siempre con código ejecutable."},
        {"role": "user", "content": "Implementa un caché LRU con tiempo de expiración en Python"}
    ]
)
print(response.choices[0].message.content)
print(response.usage)  # Presta atención a prompt_tokens_details.cached_tokens
Ver código completo: encapsulado con claves de caché, reintentos y estadísticas de uso
import time
from openai import OpenAI, APIError, RateLimitError

client = OpenAI(
    api_key="YOUR_APIYI_KEY",
    base_url="https://api.apiyi.com/v1"
)

# La indicación del sistema larga y fija al principio facilita el uso de la caché de indicaciones
SYSTEM_PROMPT = open("system_prompt.md", encoding="utf-8").read()


def ask_astra(user_input: str,
              effort: str = "high",
              cache_key: str = "project-alpha-v1",
              max_retries: int = 3) -> str:
    """Invoca gpt-6-astra, fija la intensidad de razonamiento y reutiliza la clave de caché"""
    for attempt in range(max_retries):
        try:
            resp = client.chat.completions.create(
                model="gpt-6-astra",
                reasoning_effort=effort,
                prompt_cache_key=cache_key,
                messages=[
                    {"role": "system", "content": SYSTEM_PROMPT},
                    {"role": "user", "content": user_input},
                ],
            )
            usage = resp.usage
            cached = 0
            if usage.prompt_tokens_details:
                cached = usage.prompt_tokens_details.cached_tokens or 0
            hit_rate = cached / usage.prompt_tokens if usage.prompt_tokens else 0
            print(f"Entrada {usage.prompt_tokens} | Caché {cached} "
                  f"| Tasa de acierto {hit_rate:.1%} | Salida {usage.completion_tokens}")
            return resp.choices[0].message.content
        except RateLimitError:
            wait = 2 ** attempt
            print(f"Límite alcanzado, reintentando en {wait} segundos")
            time.sleep(wait)
        except APIError as e:
            print(f"Error de interfaz: {e}")
            time.sleep(1)
    raise RuntimeError("Falló tras varios reintentos")


if __name__ == "__main__":
    tasks = [
        "Revisa el uso de índices en este SQL: SELECT ...",
        "Diseña un esquema de reintento idempotente para el servicio de pedidos",
    ]
    for t in tasks:
        print(ask_astra(t, effort="xhigh")[:200])
💡 Consejo: Para la primera llamada, usa el nivel
mediumpara verificar la conexión y luego ajusta según la dificultad de la tarea. Puedes obtener cuota de prueba registrándote en APIYI (apiyi.com) antes de migrar tus tareas formales.
Cambiar a la API de gpt-6-astra en Codex
Si usas principalmente Astra en Codex CLI, no necesitas interrumpir tu trabajo al agotar la cuota. Puedes configurar un proveedor de modelo personalizado en ~/.codex/config.toml y usar tu clave API:
model = "gpt-6-astra"
model_provider = "apiyi"
model_reasoning_effort = "high"

[model_providers.apiyi]
name = "APIYI"
base_url = "https://api.apiyi.com/v1"
env_key = "APIYI_API_KEY"
wire_api = "responses"
Tras configurar, ejecuta export APIYI_API_KEY=tu_clave y reinicia Codex. Cuando se restablezca tu cuota de suscripción, simplemente comenta la línea model_provider para volver al modo original.
¿Cómo elegir la intensidad de razonamiento de gpt-6-astra?
La intensidad de razonamiento determina la calidad, el tiempo de respuesta y el costo. Se recomienda elegir según el tipo de tarea.
| Intensidad | Escenario típico | Calidad | Tiempo y costo |
|---|---|---|---|
| low | Conversión de formatos, preguntas simples | Básica | Mínimo |
| medium | Autocompletado de código, redacción | Equilibrada | Bajo |
| high | Refactorización compleja, diseño de arquitectura | Estable y fiable | Medio |
| xhigh | Depuración de errores, agentes de cadena larga | Experiencia premium | Alto |
| max | Pruebas matemáticas, auditoría de seguridad | Máxima capacidad | Muy alto, requiere control |
🎯 Recomendación: Si sospechas que el modelo ha sido "degradado" en la suscripción, fija tus tareas críticas en el nivel
xhighmediante la API. Al usar APIYI (apiyi.com), la calidad depende totalmente de los parámetros de tu solicitud, manteniendo los resultados bajo tu control.
Control de costes y optimización de la tasa de aciertos de caché en gpt-6-astra
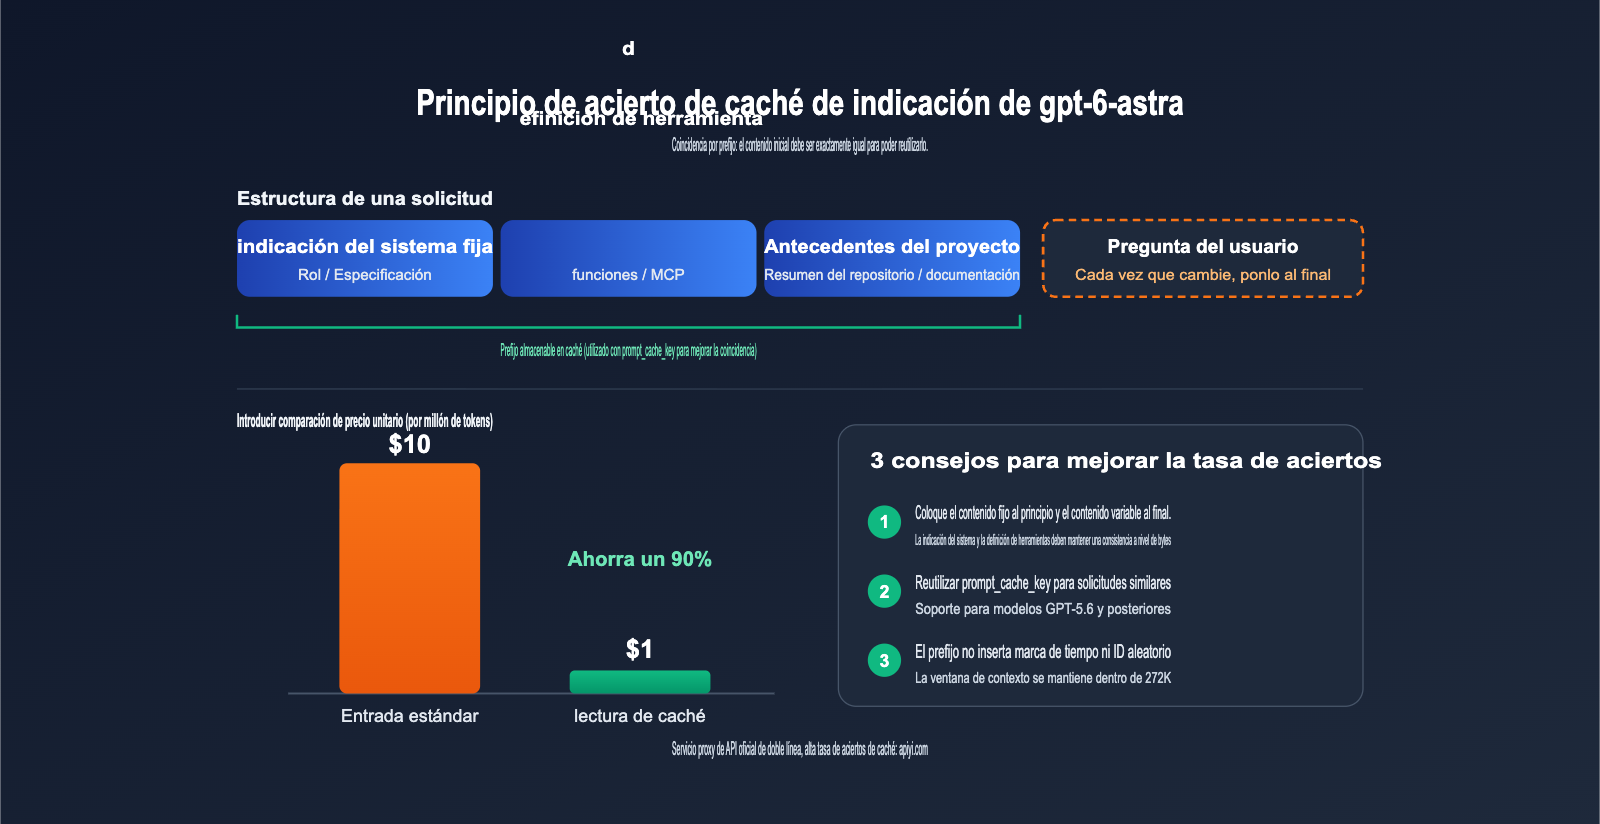
El precio oficial de gpt-6-astra es de $10 por entrada y $50 por salida (por cada millón de tokens), lo cual es varias veces superior al precio de lanzamiento de GPT-5.6 Sol. Por lo tanto, el control de costes debe ser una prioridad al utilizar esta API como complemento. La buena noticia es que el precio de entrada en caché de Astra es de solo $1, lo que equivale a un 10% del precio de entrada estándar; una alta tasa de aciertos en la caché marcará una diferencia directa en tu factura.
| Ítem de facturación | Precio oficial (por millón de tokens) | Descripción |
|---|---|---|
| Entrada estándar | $10 | Aplicable cuando la entrada no supera los 272K tokens |
| Lectura de caché | $1 | Parte que acierta en la caché de la indicación, ahorra un 90% |
| Escritura de caché | $12.5 | Prefijo recién escrito en caché, ligeramente superior a la entrada estándar |
| Salida estándar | $50 | Incluye tokens de inferencia |
| Contexto largo | 2x entrada y caché, 1.5x salida | Se activa cuando la entrada supera los 272K tokens |
| Batch / Flex | 50% del precio estándar | Ideal para tareas que no requieren respuesta en tiempo real |
4 consejos para mejorar la tasa de aciertos de caché en gpt-6-astra
La caché de la indicación se basa en la coincidencia de "prefijos"; siempre que el contenido al inicio de la solicitud sea idéntico, se pueden reutilizar los resultados de cálculo previos. Basándonos en este mecanismo, puedes optimizar lo siguiente:
- Coloca el contenido fijo al principio: Mantén el contenido invariable (indicaciones del sistema, definiciones de herramientas, especificaciones del proyecto) al comienzo del mensaje, y deja las partes variables (preguntas del usuario, marcas de tiempo) para el final.
- Usa
prompt_cache_key: Los modelos GPT-5.6 y posteriores admiten este parámetro. Usar la misma clave de caché para solicitudes que comparten un prefijo largo puede aumentar significativamente la probabilidad de coincidencia. - Evita insertar valores dinámicos en el prefijo: Incluir la hora actual o IDs aleatorios en la indicación del sistema hará que el prefijo sea diferente en cada solicitud, invalidando la caché.
- Mantén el contexto dentro de los 272K: Superar este umbral activará la facturación de contexto largo y duplicará el precio de lectura de caché. Para documentos largos, se recomienda realizar una búsqueda antes de enviarlos al modelo.
La tasa de aciertos de caché también depende de la estabilidad de la infraestructura subyacente. Si las solicitudes fluctúan frecuentemente entre diferentes backends, es difícil mantener la caché. APIYI (apiyi.com) utiliza rutas directas oficiales de OpenAI y Azure, y ha optimizado el enrutamiento para que sea compatible con la caché de gpt-6-astra. En escenarios con prefijos fijos, puedes obtener una alta tasa de aciertos; puedes verificar los resultados directamente a través del campo cached_tokens en la respuesta.
Preguntas frecuentes sobre la degradación y el uso de gpt-6-astra como complemento
Q1: ¿Realmente OpenAI ha degradado gpt-6-astra?
Actualmente no hay pruebas oficiales de que se hayan reemplazado los pesos del modelo, y OpenAI no ha emitido ninguna declaración formal. Una explicación más probable es un cambio en la programación del presupuesto de inferencia en el lado de la suscripción, sumado a la varianza de salida propia del modelo. Sugerimos utilizar el método de verificación de 5 pasos de este artículo y realizar una comparación con un nivel fijo de API antes de sacar conclusiones.
Q2: ¿Es el gpt-6-astra llamado vía API el mismo modelo que el de ChatGPT?
Es el mismo modelo. La diferencia es que la API te permite especificar explícitamente la intensidad de la inferencia, mientras que el presupuesto de inferencia de los productos de suscripción es gestionado por la plataforma. APIYI (apiyi.com) ofrece la versión completa de gpt-6-astra con enrutamiento directo oficial, donde la intensidad de la inferencia se ejecuta exactamente según los parámetros que envíes.
Q3: ¿Se pueden usar la cuota de suscripción y la API al mismo tiempo?
Sí, son independientes. Una práctica recomendada es seguir usando la cuota de suscripción para las interacciones diarias y cambiar a la API cuando la cuota se agote o cuando necesites realizar procesamiento por lotes. En Codex, puedes cambiar rápidamente mediante archivos de configuración.
Q4: ¿Es muy caro usar la API como complemento?
Depende del uso. Controlar el nivel de inferencia, mejorar la tasa de aciertos de caché y poner las tareas que no son en tiempo real en modo Batch puede reducir los costes a más de la mitad. Se recomienda calcular el coste por tarea con un pequeño volumen de trabajo real en APIYI (apiyi.com) antes de decidir la escala de uso.
Q5: ¿Cómo combinar gpt-6-astra y GPT-5.6 Sol?
Sol tiene un precio mucho más bajo, ideal para tareas de codificación rutinarias y procesamiento por lotes; Astra destaca en tareas de operación de PC, razonamiento complejo y agentes de cadena larga. Puedes usar Sol como modelo predeterminado y escalar a Astra solo para problemas difíciles; así mantendrás la calidad mientras controlas los costes.
Resumen: Convierte la incertidumbre de gpt-6-astra en una variable controlable
gpt-6-astra es actualmente el Modelo de Lenguaje Grande insignia más potente de OpenAI, pero la controversia sobre la "reducción de inteligencia" y el endurecimiento de los límites de uso tras su lanzamiento inicial revelaron una característica esencial de los productos de suscripción: tanto el presupuesto de inferencia como los límites de uso son decididos por la plataforma, dejando al usuario en una posición pasiva. Ante esta situación, en lugar de especular constantemente sobre si el modelo se ha vuelto menos capaz, es mejor establecer tu propia línea base de calidad mediante indicaciones fijas y niveles de inferencia predefinidos.
En la práctica, puedes seguir tres pasos: primero, utiliza el método de resolución de problemas de 5 pasos para distinguir entre la programación de la plataforma, la varianza del modelo y tu propio uso; luego, cuando se agoten tus cuotas, utiliza la API como respaldo, fijando las tareas críticas en los niveles high o xhigh; finalmente, reduce los costos mediante prefijos fijos, prompt_cache_key y procesamiento por lotes (Batch). De esta manera, sin importar cómo ajuste la plataforma su suscripción, tu flujo de trabajo principal se mantendrá estable.
Si necesitas un canal de respaldo estable, te recomendamos utilizar la versión completa de gpt-6-astra a través de APIYI (apiyi.com). Esta plataforma ofrece un servicio proxy de API directo y oficial tanto de OpenAI como de Azure, siendo totalmente compatible con la interfaz oficial y ofreciendo una alta tasa de aciertos en caché, lo que la convierte en un complemento fiable más allá de las suscripciones de ChatGPT y Codex.
Referencias:
- Documentación del modelo OpenAI (gpt-6-astra): developers.openai.com/api/docs/models/gpt-6-astra
- Centro de ayuda de OpenAI sobre el uso de Astra: help.openai.com
- Informe de Decrypt sobre la controversia de la reducción de inteligencia de Astra: decrypt.co
- Documentación de caché de indicaciones de Microsoft Foundry: learn.microsoft.com
- Documentación del modelo APIYI: docs.apiyi.com
Sobre el autor: Equipo técnico de APIYI, especializado en la integración de API de Modelos de Lenguaje Grande y prácticas de ingeniería. Te invitamos a intercambiar experiencias sobre la optimización de la invocación y el control de costos de gpt-6-astra a través de APIYI (apiyi.com).