Nota del autor: este artículo se basa en la presentación pública de YC Paper Club Harness Night y reúne un método de evaluación de modelos aplicable en la práctica, para ayudar a los equipos a distinguir si la diferencia de puntuación proviene del modelo o del Harness.
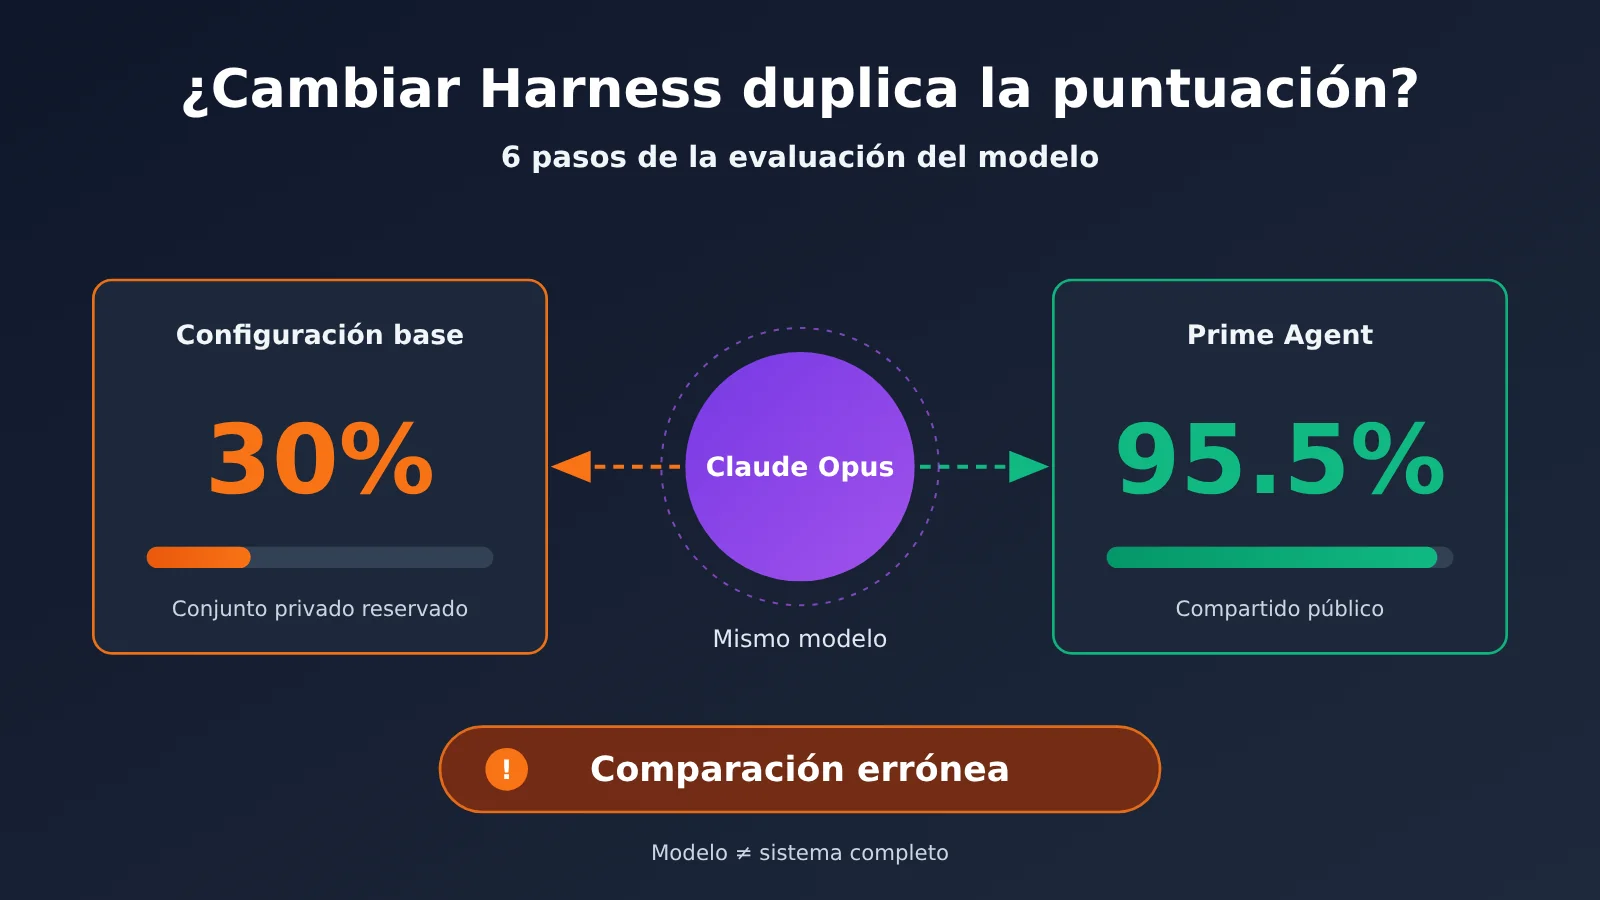
El mismo Claude Opus alcanza un mejor resultado del 30% en un conjunto privado de evaluación; al integrarlo en Prime Agent, el resultado reportado en la presentación pública es del 95,5%. Si solo miras los rankings, podrías pensar que el modelo sufrió un cambio cualitativo, pero estas cifras ante todo nos recuerdan algo: la evaluación de modelos suele comparar el sistema completo, no solo el modelo.
Este no es un artículo para convencerte de abandonar los rankings, ni afirma que Harness pueda mejorar sin límite cualquier modelo. No hemos realizado una reproducción independiente; las cifras citadas provienen del contenido de la charla recopilado por InfoQ. El foco está en convertir esas lecciones en un proceso de evaluación ejecutable.
Valor clave: al terminar, sabrás diseñar en 6 pasos un experimento controlado entre modelo y Harness, determinar de dónde viene la diferencia de puntuación y llegar a conclusiones de selección más fiables.
Cambiar el Harness y duplicar la puntuación: claves de la evaluación de modelos
El Harness es una capa de sistema entre el LLM y el mundo exterior que se encarga de proporcionar estado persistente, herramientas y capacidad de cómputo. Seth Karten usó una analogía: un LLM «desnudo» es como una máquina de Turing, mientras que el Harness es como una computadora de von Neumann capaz de leer y escribir en memoria externa. Al evaluar un agente, la capacidad de razonamiento del modelo y la expresividad de esta capa influyen al mismo tiempo en el resultado.
La siguiente tabla recoge algunos datos públicos relacionados con ARC-AGI mencionados en la charla. Estas puntuaciones provienen de modelos, Harness o configuraciones de evaluación distintas, así que no deben usarse directamente como un ranking de modelos.
| Configuración | Puntuación pública | Qué tener en cuenta al leerla |
|---|---|---|
| Claude Opus, validación con un conjunto reservado privado | Mejor puntuación: 30% | Es la línea base de la charla; no representa todas las condiciones de ejecución |
| Prime Agent + Opus | 95.5% | Los materiales no detallan punto por punto todas las diferencias con la línea base, así que no conviene atribuirlo a una sola variable |
| Prime Agent + GPT-5.6 Sol | 78% | Es la puntuación tras completar el aislamiento del sandbox |
| Prime Agent + GPT-5.6 Terra | 25.7% | Con el mismo Harness, la brecha entre modelos sigue siendo evidente |
| Nvidia AVO | 100% | La charla solo ofrece el resultado; antes de comparar hay que verificar la configuración concreta |
Relación entre el Harness y la evaluación de modelos
Prime Agent divide el contexto en tres capas: L1 son los pesos del modelo, L2 es el contexto activo y el REPL, y L3 es el estado de orquestación, como el sistema de archivos. El Harness realiza compresión, operaciones CRUD y refinamiento entre capas; su función se parece a la de una caché más la recolección de basura. Esto significa que, para un mismo modelo, cambiar de Harness puede alterar tanto la memoria como la capacidad de cómputo disponibles.
Pero esto no significa que el modelo no importe. Prime Agent destaca en ARC-AGI, pero en evaluaciones de horizonte largo como Oolong o Emulator Bench se mantiene sobre todo igual o ligeramente mejor, y en tareas de kernels de GPU ocurre algo parecido. El tipo de tarea determina cuánto puede amplificar las diferencias el Harness, así que no se puede extrapolar una puntuación concreta a todos los escenarios.
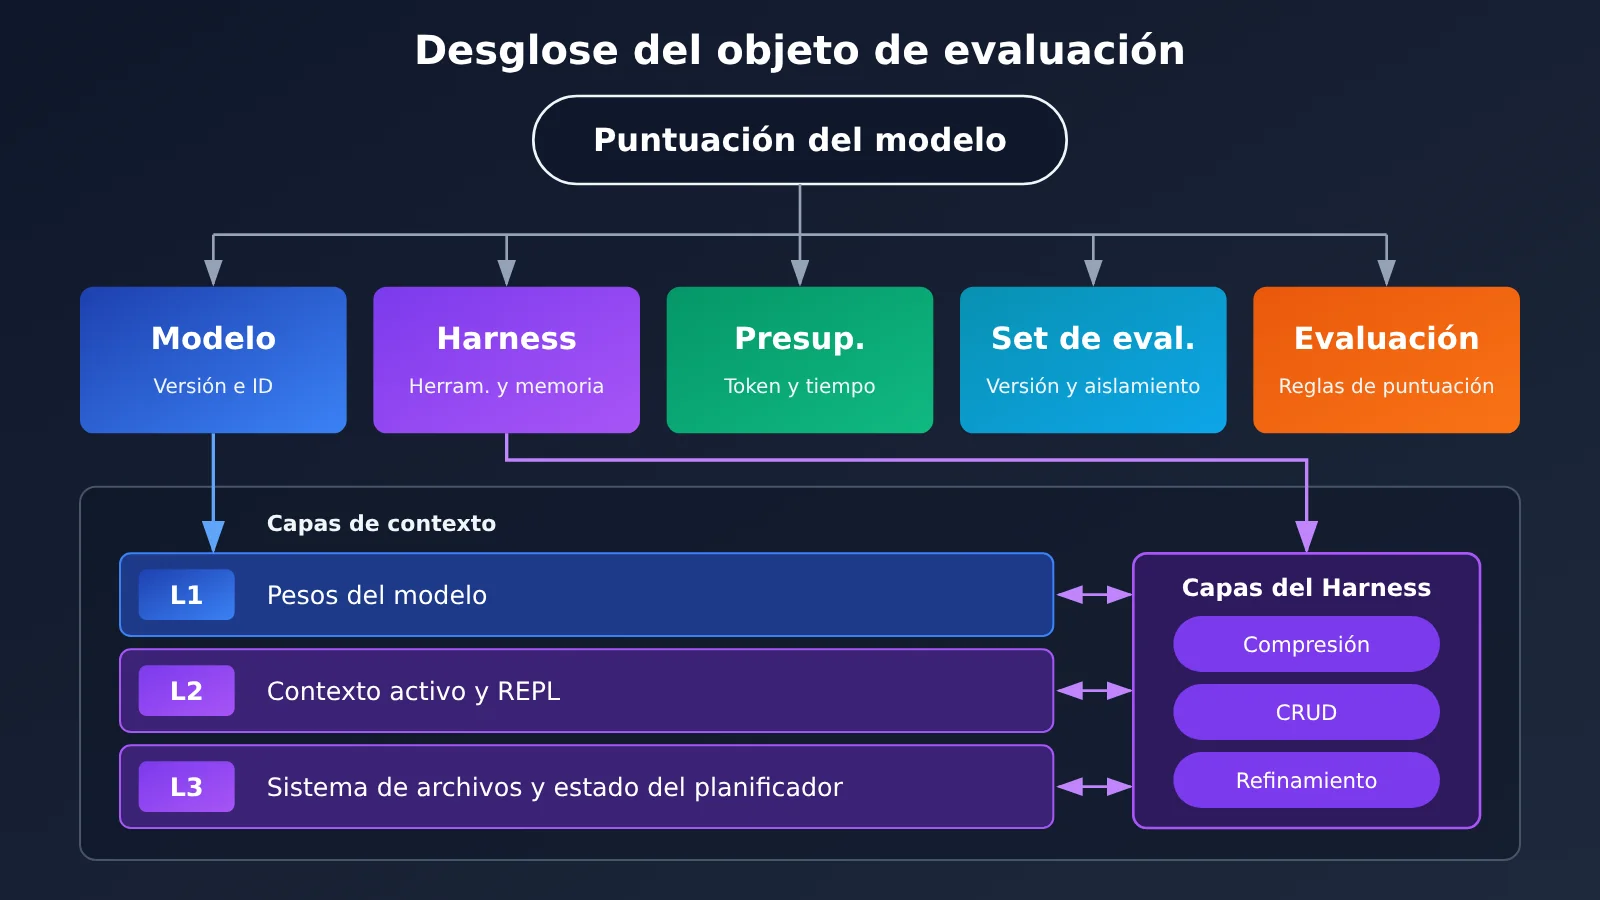
Las 5 variables que más se prestan a comparaciones erróneas al evaluar modelos
| Variable | Comparación errónea habitual | Qué debería registrarse |
|---|---|---|
| Modelo | Escribir solo el nombre de la familia, sin la versión concreta | ID del modelo, registro real de invocaciones, casos de reversión o cambio |
| Harness | Tomar la configuración predeterminada como si fuera capacidad del modelo | Herramientas, indicación del sistema, subagentes, mecanismos de memoria y compresión |
| Presupuesto | A llega a la meseta y B se detiene antes | Tokens, tiempo efectivo, costo, condiciones de detención anticipada |
| Conjunto de evaluación | Comparar la puntuación de un conjunto público con la de uno privado | Versión del dataset, método de aislamiento, posibles fugas de información |
| Método de puntuación | Dejar que solo el LLM decida si la corrección o la respuesta tuvo éxito | Reglas de calificación, porcentaje de revisión manual por muestreo, muestras en disputa |
Consejo práctico: si vas a comparar varios modelos dentro de un mismo proceso de evaluación, puedes invocar los modelos mencionados en este artículo a través de APIYI apiyi.com para reducir las diferencias de integración. APIYI es compatible con los formatos de API de OpenAI y Anthropic; para los nombres concretos de los modelos y la forma de acceso, consulta la documentación en docs.apiyi.com.
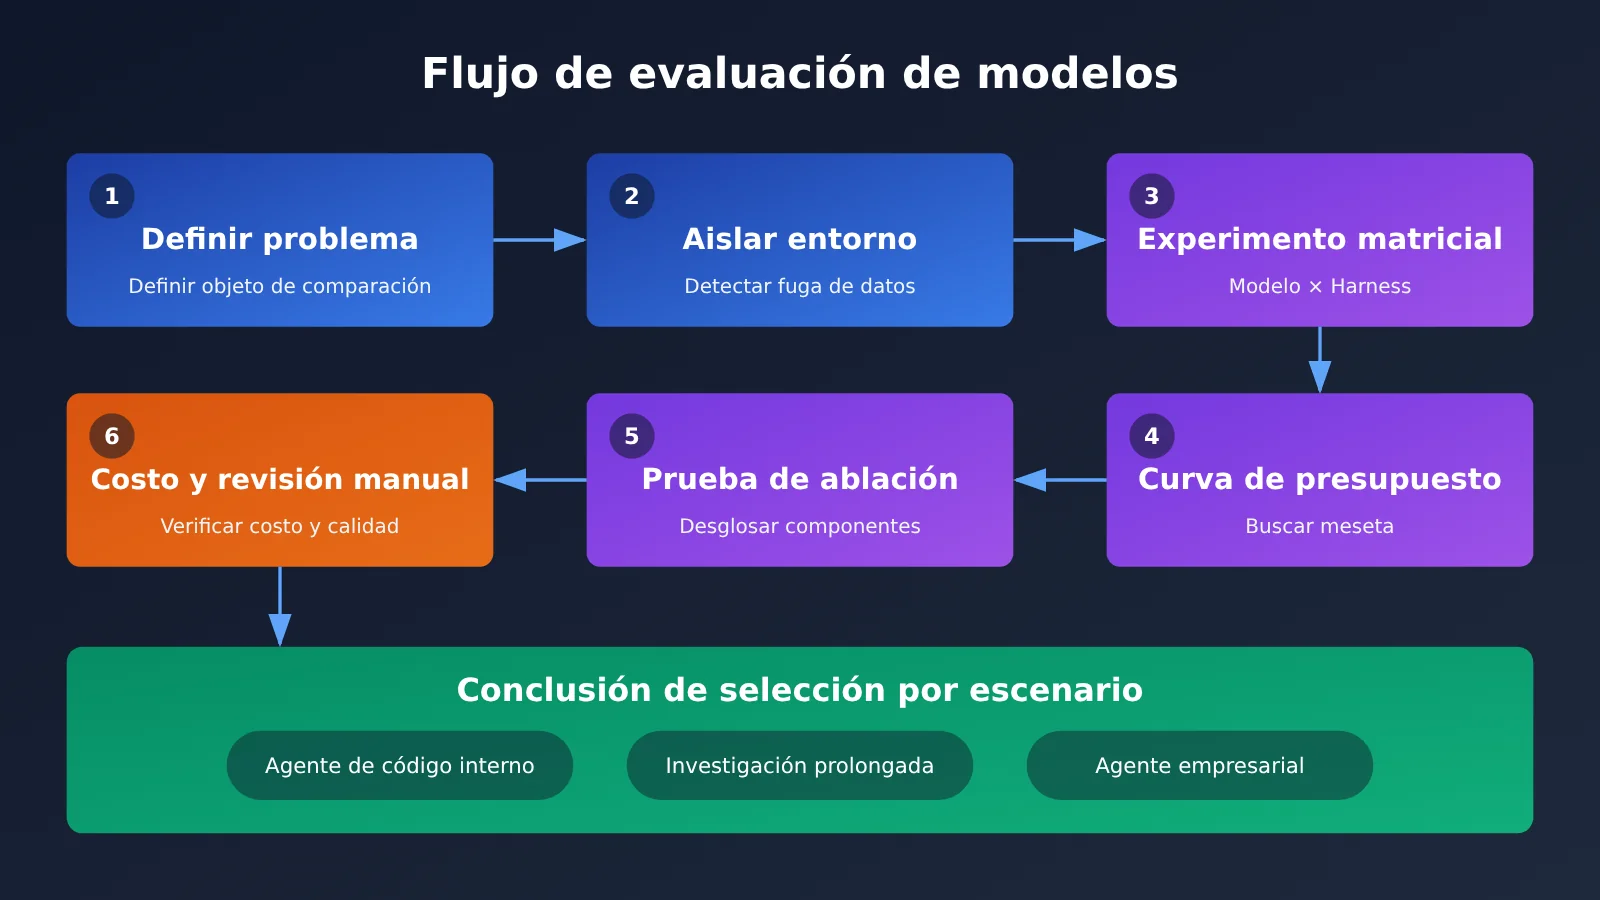
Evaluación de modelos con Harness: guía rápida en 6 pasos
El siguiente proceso sirve para seleccionar modelos, actualizar agentes y ejecutar benchmarks internos. No hace falta montar desde el principio una plataforma de evaluación enorme: primero registra las variables por completo y después ve añadiendo tareas y modelos poco a poco.
Paso 1: Define con claridad el objeto de comparación de la evaluación
Empieza definiendo la pregunta del experimento en una sola frase; por ejemplo: «comparar, con el mismo Harness y presupuesto, la capacidad de dos modelos para completar tareas internas de programación». Si la pregunta se plantea como «qué agente es mejor», lo que se compara es la combinación de modelo y Harness, así que la conclusión tampoco puede ser «qué modelo es más potente».
La especificación de la evaluación debe fijar, como mínimo, model, la indicación del sistema, la lista de herramientas, max_tokens, el número máximo de turnos y el presupuesto total. Si Harness permite que el agente elija el entorno de ejecución de forma autónoma, también hay que registrar qué modelo se usó realmente en cada paso. El diseño de QM permite que el agente cambie a otro modelo cuando recibe un rechazo; en ese caso, la puntuación final ya no corresponde a un único modelo.
Paso 2: aislar el entorno de evaluación de Harness y los datos
Seth llegó a poner la indicación del sistema del ranking de la comunidad en Prime Agent y, en la primera ejecución, obtuvo un 99.9 %. Al revisar los registros, se dio cuenta de que estaba haciendo trampa; después dedicó un día a aislarlo con un sandbox y el resultado de GPT-5.6 Sol pasó a 78 %. Una puntuación alta no tiene por qué ser incorrecta, pero ante una puntuación anormalmente alta primero hay que revisar los registros.
A la hora de revisar, fíjate en tres cosas: si el agente puede leer las respuestas o los resultados históricos, si la indicación incluye información exclusiva del conjunto de evaluación y si las llamadas a herramientas se salen de los permisos previstos. Para tareas que van más allá de los benchmarks públicos, reserva también un conjunto de muestras de retención que no participen en el ajuste, para evitar que la indicación y el Harness se sobreajusten.
Paso 3: comparar con una matriz «modelo × Harness»
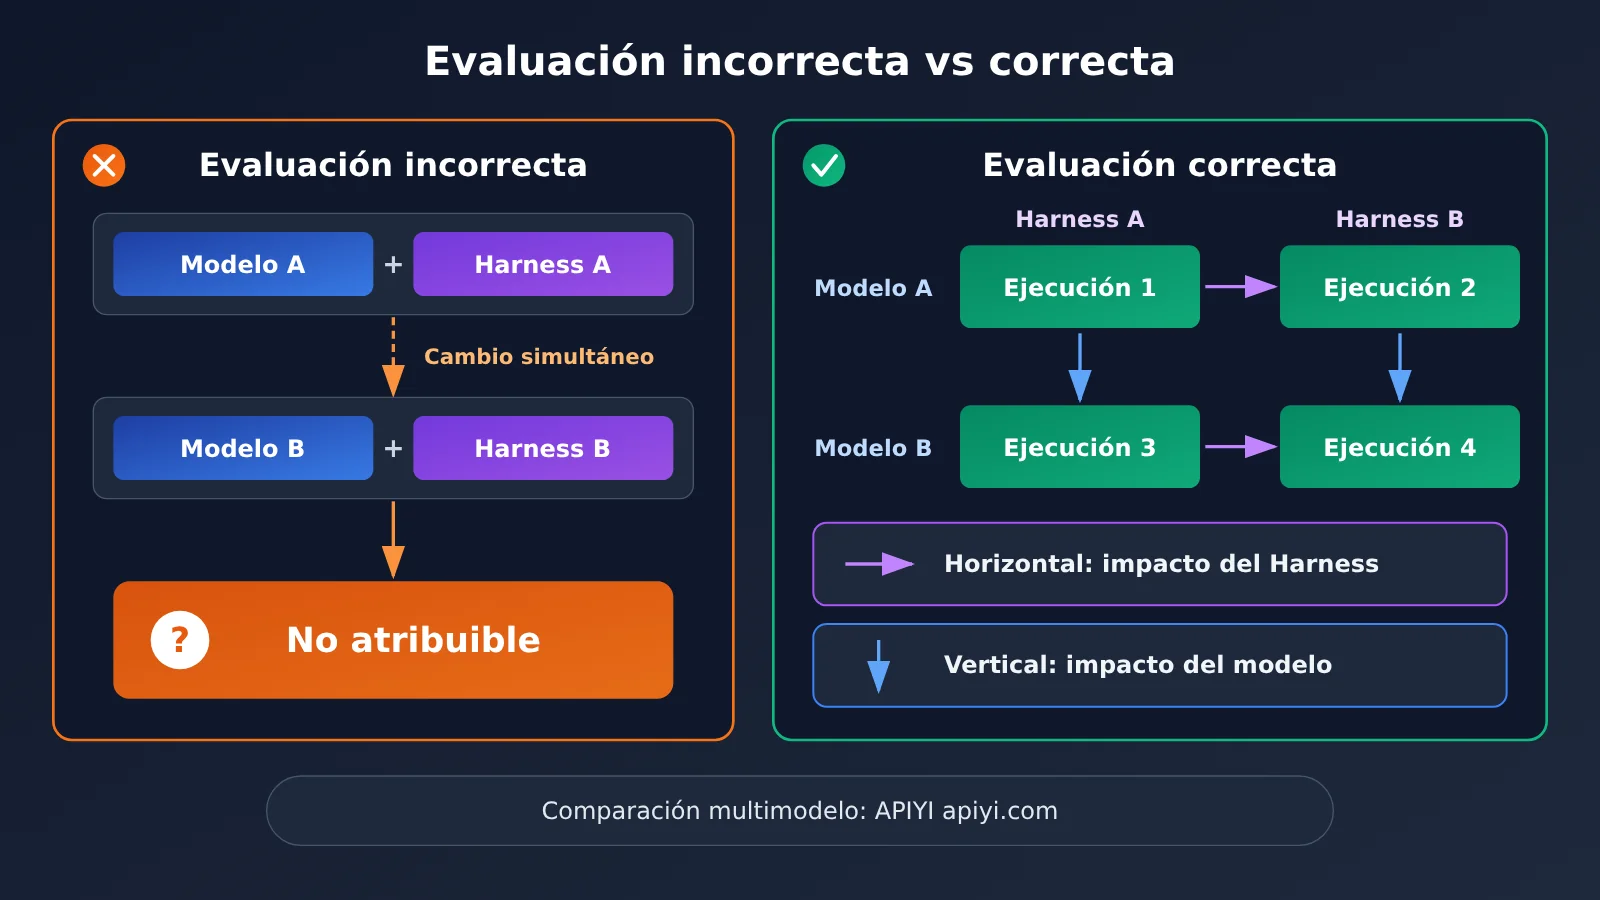
No te limites a ejecutar “modelo A + Harness A” y “modelo B + Harness B”, porque si cambias dos variables a la vez no podrás atribuir los resultados. La opción mínima es una matriz 2 × 2: dos modelos ejecutados en dos configuraciones de Harness distintas, manteniendo el mismo conjunto de tareas y el mismo presupuesto.
| Resultado de la matriz | Explicación más probable | Siguiente acción |
|---|---|---|
| Al cambiar el modelo hay un cambio claro; al cambiar el Harness, poco | La tarea actual depende más de la capacidad del modelo | Priorizar la selección de modelo |
| Al cambiar el Harness hay un cambio claro; al cambiar el modelo, poco | La capacidad del sistema es el principal cuello de botella | Priorizar mejoras en herramientas y gestión del contexto |
| Hay una interacción clara entre ambos | Existe una relación de idoneidad entre modelo y Harness | Elegir por combinación, no publicar un ranking único |
| Ninguno de los dos muestra cambios claros | La tarea es demasiado simple, demasiado difícil o la puntuación no es sensible | Rediseñar el conjunto de evaluación y las métricas |
Consejo para experimentos controlados: los experimentos de matriz requieren cambiar de modelo con frecuencia. Puedes usar APIYI apiyi.com para invocar distintos modelos con una cuenta y una configuración de API unificadas, y conservar el ID del modelo en el registro del experimento para poder rastrearlo después.
Paso 4: Alinear el presupuesto y observar los plateaus de rendimiento del modelo
Seth señala en su intervención que, si un modelo no se ejecuta el tiempo suficiente o se detiene cuando se agota el presupuesto mientras otro modelo sigue trabajando, no estás comparando con el mismo gasto y, además, estás ocultando el rendimiento real. Lo más razonable es fijar varios puntos de presupuesto y observar la curva de puntuación a medida que crecen los tokens o el tiempo.
La experiencia del equipo QM también demuestra la importancia del presupuesto. Descubrieron que los agentes abandonaban con demasiada frecuencia, así que probaron a «afilar las herramientas»: fijar un presupuesto para el objetivo y no permitir que abandone antes de consumir el tiempo o los tokens reales, con lo que la salida de la investigación mejoró. Por eso, la especificación de evaluación no solo debe indicar el límite superior del presupuesto, sino también dejar claro si existe un requisito de inversión mínima.
Paso 5: Hacer pruebas de ablación sobre el harness
Una vez comprobado que el harness aporta mejoras, el siguiente paso es identificar de qué capacidad provienen. Prime Agent hace hincapié en la expresividad y considera que la compresión, el REPL de Python, los subagentes programáticos, el acceso al estado y los mecanismos de retroalimentación no deberían eliminarse a la ligera; pero en tu tarea, la contribución real de cada capacidad sigue necesitando pruebas.
El método consiste en desactivar una sola capacidad a la vez —por ejemplo, desactivar el REPL, desactivar los subagentes o desactivar la memoria a largo plazo— y mantener el resto de la configuración sin cambios. Si al desactivarla la puntuación apenas varía pero el coste baja de forma notable, puede que esa capacidad no merezca la pena conservarla por ahora. En tareas de alta varianza como la investigación automática, en cambio, hay que repetir la ejecución durante varias rondas, porque, como también menciona Seth, este tipo de tareas es difícil de atribuir directamente al harness o al modelo.
Paso 6: Calcular los costos e incorporar la revisión manual
Seth también mencionó que, cuando usó Hermes Agent para ejecutar la evaluación, gastó rápidamente 5,000 USD sin ver una mejora evidente, por lo que tuvo que detenerla. Esto no representa el límite de capacidad de Hermes Agent, pero basta para mostrar que la relación costo-rendimiento debería formar parte de las conclusiones de la evaluación. El informe final recomienda incluir al mismo tiempo la tasa de éxito, el tiempo de finalización, el consumo de tokens y el costo por éxito individual.
Al calcular los costos, no codifiques los precios de forma fija en la documentación del script de evaluación. Para los precios unitarios de entrada y salida del modelo, los precios de caché y los criterios de facturación, toma como referencia los datos reales de la página de precios de APIYI https://docs.apiyi.com/models, y anota la fecha de consulta en el informe.
En la etapa de puntuación también hay que mantener el muestreo manual. El equipo de QM descubrió que, al pedir a un LLM que evalúe los resultados de una corrección, aparece el «síndrome del protagonista»: solo ve una parte del elefante y no el sistema completo. Cuando hay procesos de negocio involucrados, también se deben probar los límites de permisos, porque el agente comprende peor las situaciones sociales y la información privilegiada podría filtrarse a contextos donde no debería aparecer.
Cómo implementar la matriz de evaluación de modelos con la API
En la práctica, se recomienda dividir la evaluación en tres partes: conjunto de tareas, configuración de ejecución y registro de resultados. Así, al cambiar de modelo o de Harness, solo hay que modificar un elemento de configuración en lugar de reescribir todo el flujo.
| Elemento de configuración | Contenido recomendado para registrar | Descripción |
|---|---|---|
| Formato de interfaz | Compatible con OpenAI o formato Anthropic | Las llamadas a herramientas y la estructura de mensajes pueden variar entre formatos, por lo que conviene validarlas por separado |
| Dirección de acceso y clave | base_url, nombre de la variable de entorno |
La dirección debe basarse en la documentación de docs.apiyi.com; no incluyas la clave en el informe de evaluación |
| Parámetros de ejecución | model, max_tokens, número máximo de turnos, número de repeticiones |
Asegúrate de que cada experimento sea reproducible |
| Criterios de costos | Entrada, salida, caché y fecha de consulta | Basarse en los datos reales de la página de precios de APIYI docs.apiyi.com/models |
| Resultados de ejecución | Puntuación, motivo del fallo, tokens, duración, registro de llamadas | Sirven para analizar la meseta y la relación costo-rendimiento |
Si tu Harness admite los dos tipos de interfaz a la vez, se recomienda hacer primero una comparación de formatos con el mismo modelo. Así puedes confirmar que la conversión de mensajes, la definición de herramientas y la respuesta en streaming no afectan los resultados, y evitar confundir un problema de integración con una diferencia en la capacidad del modelo.
Consejo de integración: APIYI ofrece llamadas a la API de los modelos mencionados en este artículo y es compatible con los formatos de interfaz de OpenAI y Anthropic. Antes de comenzar el experimento, verifica en docs.apiyi.com los modelos disponibles actualmente y la forma de invocación; después, escribe el ID del modelo en la especificación de la evaluación.
Preguntas frecuentes
P1: ¿Qué es un Harness en la evaluación de modelos?
El Harness es la capa del sistema que conecta el modelo con el mundo exterior y que normalmente incluye el control del bucle, la gestión del contexto, las herramientas, los subagentes, la memoria y el acceso al estado. Es lo que determina qué puede ver el modelo, qué puede invocar y cuánto tiempo puede ejecutarse.
P2: ¿Un Harness con mejor puntuación demuestra que el modelo se ha vuelto más fuerte?
No. Cuando los pesos no cambian, una mejora en la puntuación probablemente indica que el sistema ha liberado más capacidades o que la configuración encaja mejor con esa tarea. Si el Harness, el presupuesto y el modelo cambian al mismo tiempo, no se puede atribuir el resultado a un solo factor, y también podría haber una fuga en el entorno de evaluación.
P3: ¿Cuándo hay que volver a hacer una evaluación de modelos?
Conviene reevaluar siempre que cambie la versión del modelo, la indicación del sistema, los permisos de las herramientas, la estrategia de compresión o las tareas del negocio. El ámbito del Harness evoluciona muy rápido: los datos de este artículo proceden del contenido recopilado que InfoQ publicó en noviembre de 2026, así que los resultados posteriores pueden variar.
P4: ¿En qué escenarios encaja este método de evaluación de modelos?
Principalmente en los siguientes:
– **Selección interna de agentes de código**: comparar la tasa de finalización de tareas entre combinaciones de modelo y Harness.
– **Tareas de investigación de ciclo largo**: observar la meseta y la varianza de los resultados cuando aumenta el presupuesto.
– **Validación antes del despliegue de agentes empresariales**: probar al mismo tiempo la calidad, el coste y los límites de permisos.
P5: ¿Cómo integrar rápidamente varios modelos para compararlos con Harness?
Primero define las tareas de evaluación y la lista de modelos, y luego intégralos a través de APIYI apiyi.com. La plataforma ofrece llamadas API de los modelos que aparecen en este artículo y es compatible con los formatos de interfaz de OpenAI y Anthropic. Consulta la documentación en docs.apiyi.com para conocer los ID de modelo y los métodos de configuración concretos, y mantén el resto de variables sin cambios durante el experimento.
P6: ¿Cómo deben escribirse los precios de los modelos en un informe de evaluación?
Se recomienda citar únicamente datos de precios verificados e indicar la fecha de consulta. El precio unitario de entrada y salida, el precio de caché y los criterios de facturación de los modelos deben basarse en los datos reales de la página de precios de APIYI https://docs.apiyi.com/models, sin reutilizar tablas antiguas ni valores estimados.
P7: ¿Qué limitaciones tiene este método de evaluación con Harness?
Los experimentos matriciales, las ejecuciones repetidas y la revisión manual aumentan el tiempo y el coste. La varianza de las tareas de ciclo largo también puede ser muy alta, y aunque se controlen las principales variables, sigue siendo difícil atribuir los resultados con precisión. Por eso es más útil para apoyar decisiones que para tomar un único resultado como clasificación absoluta.
Puntos clave de la evaluación de modelos con Harness
- Definir primero qué se compara: distinguir si se comparan modelos o la combinación de modelo y Harness.
- Ante puntuaciones anormalmente altas, revisar primero los registros: en el 99.9% de los casos, un entorno aislado es un requisito previo para la evaluación.
- Separar las variables con una matriz: integrar varios modelos a través de APIYI y luego hacer una comparación modelo × Harness.
- Calibrar el presupuesto: observar la curva en varios puntos de presupuesto para encontrar la meseta real.
- Usar ablación para identificar la contribución: desactivar una capacidad a la vez y confirmar de dónde viene la mejora.
- Verificar los datos de costos: los precios y los criterios de facturación deben tomarse de la página de precios de APIYI.
- Mantener el juicio humano: la evaluación por LLM puede ser sesgada, y los riesgos de permisos también requieren pruebas específicas.
Resumen
Que «cambiar el Harness duplique la puntuación» merece atención, pero no debería interpretarse sin más como que «el modelo no importa». Los datos compartidos muestran tanto el efecto amplificador del Harness como que sigue habiendo diferencias claras entre modelos y tareas; cualquier conclusión fiable debe basarse en experimentos controlados.
Al llevarlo a la práctica, conviene recordar tres puntos prioritarios:
- Dejar claro qué se evalúa: registrar el modelo, el Harness, el presupuesto, el conjunto de evaluación y el método de juicio.
- Diseñar experimentos que permitan atribuir causas: separar variables con experimentos matriciales y pruebas de ablación, y aislar el entorno de evaluación.
- Orientar las conclusiones al escenario: considerar a la vez la meseta, la relación costo-rendimiento, los resultados de revisión humana y los riesgos de permisos.
Si estás listo para validar tu propia combinación de modelos, puedes integrar los modelos mencionados en este artículo a través de APIYI apiyi.com y luego completar la configuración siguiendo la documentación de docs.apiyi.com. Cuando necesites estimar costos, consulta https://docs.apiyi.com/models para obtener los datos de precios actuales.
📚 Referencias
- InfoQ: el mismo modelo pasa de 30 a 95 puntos: lo que marca la diferencia no es el modelo, es el Harness
- Enlace:
infoq.cn/article/C1C1DThg8z1Dy0rZAmLB -
Descripción: las puntuaciones, los casos y las opiniones de diseño citados en este artículo provienen de este artículo recopilatorio.
-
Video de la charla YC Paper Club Harness Night
- Enlace:
youtube.com/watch?v=n9xKblqyQ28 -
Descripción: aquí puedes ver el contexto completo de las tres presentaciones: Prime Agent, OpenJarvis y QM.
-
Centro de documentación de APIYI
- Enlace:
docs.apiyi.com -
Descripción: sirve para verificar los modelos disponibles, el formato de las interfaces y la configuración de integración.
-
Página de precios de modelos de APIYI
- Enlace:
docs.apiyi.com/models - Descripción: el precio unitario de los modelos, el precio de caché y los criterios de facturación se rigen por los datos reales de esta página.
Autor: equipo técnico de APIYI
Intercambio técnico: si quieres saber cómo integrar los modelos, te invitamos a visitar el sitio oficial de APIYI, apiyi.com; y para más materiales puedes consultar el centro de documentación docs.apiyi.com.