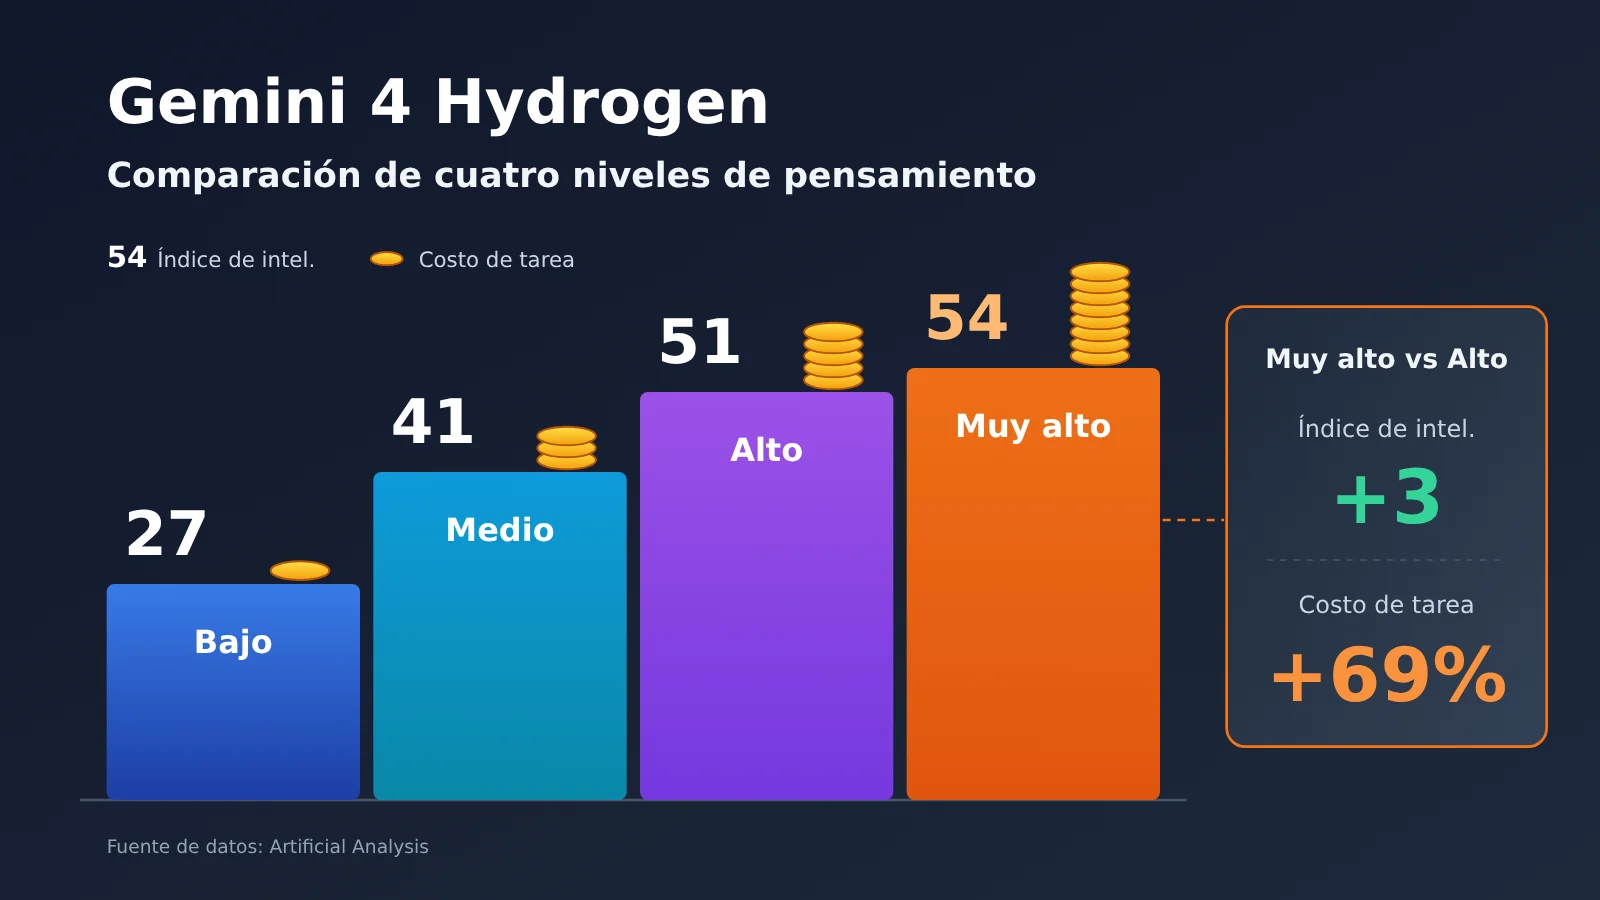
Resumen en una frase: La evaluación de cuatro niveles de Artificial Analysis muestra que, al pasar Gemini 4 Hydrogen de High a XHigh, el índice de inteligencia solo sube 3 puntos, mientras que el costo de las tareas de evaluación aumenta cerca del 69%; por eso conviene configurar el nivel de pensamiento según la dificultad de la tarea.
Google lanzó oficialmente Gemini 4 Hydrogen el 12 de noviembre de 2026 y ofrece cuatro niveles de pensamiento: Low, Medium, High y XHigh. Los cuatro niveles usan el mismo ID de modelo y la misma tarifa por token, pero en las evaluaciones de terceros las puntuaciones, los costos y los tiempos de espera varían mucho.
Esta no es una recomendación de «cuanto más alto el nivel, mejor». En este artículo uso los datos de evaluación estandarizados de Artificial Analysis para calcular el rendimiento marginal de cada nivel y dar recomendaciones claras según el tipo de tarea.
Valor clave: al terminar este artículo, podrás decidir qué nivel usar en tu negocio y cómo controlar el costo de pensamiento con el parámetro thinking_level.
Términos que conviene conocer antes de comparar los cuatro niveles de pensamiento de Gemini 4 Hydrogen
- thinking_level: parámetro del nivel de pensamiento que controla la profundidad de razonamiento del modelo. Hydrogen admite cuatro valores: Low, Medium, High y XHigh.
- Tokens de pensamiento: tokens que el modelo usa para razonar antes de dar la respuesta final. Según la página oficial de precios de Google, esta parte se factura como salida.
- Token: unidad de medida con la que el modelo procesa texto, imágenes y demás información; la API factura por millón de tokens.
- Harness: marco de pruebas que organiza la entrada del modelo, ejecuta llamadas a herramientas y puntúa las tareas. Las puntuaciones obtenidas con distintos Harness no se pueden comparar directamente.
- API: interfaz que permite a los programas llamar al servicio. Los ejemplos de código de este artículo usan el formato compatible con OpenAI.
Un mismo Gemini 4 Hydrogen, ¿por qué los cuatro niveles rinden tan distinto?
Gemini 4 Hydrogen es un modelo de alta eficiencia lanzado por Google DeepMind, pensado sobre todo para programación diaria y ejecución de tareas de AI Agent; el ID del modelo en la API es gemini-4-hydrogen. Los cuatro niveles de pensamiento no son cuatro modelos, sino cuatro profundidades de razonamiento de un mismo modelo. La documentación de Google Cloud indica tareas recomendadas para cada nivel:
| Nivel de pensamiento | Uso recomendado por Google | Profundidad de razonamiento | ¿Predeterminado? |
|---|---|---|---|
| Low | Tareas simples como clasificación | Superficial | No |
| Medium | Programación habitual | Media | No (nivel predeterminado de 3.8 Flash) |
| High | Agentes de varios pasos | Profunda | ✅ Predeterminado de Hydrogen |
| XHigh | Razonamiento complejo y profundo | La más profunda | No |
Los cuatro niveles de pensamiento de Hydrogen tienen el mismo precio unitario, ¿por qué cambia la factura?
A 13 de noviembre de 2026, el precio oficial de Google para llamadas Standard es de $1.50 por millón de tokens de entrada y $7.50 por millón de tokens de salida, sin diferencias entre los cuatro niveles. La diferencia viene del consumo de tokens: cuanto más alto es el nivel, más tokens de pensamiento genera el modelo antes de responder, y esos tokens se cobran a precio de salida.
Así que «el mismo precio unitario» no significa «el mismo coste por tarea». Una misma pregunta en XHigh puede generar varias veces más contenido de pensamiento que en High, y la factura subirá con ello. Al estimar costes no basta con fijarse en la longitud de la respuesta final: también hay que incluir la parte invisible del pensamiento.
Datos de pruebas de los cuatro niveles de Gemini 4 Hydrogen: comparación de puntuación, costo y velocidad
Los siguientes datos provienen de la organización independiente Artificial Analysis, y la evaluación se completó el mismo día del lanzamiento. El índice de inteligencia, el costo por tarea de evaluación y el tiempo promedio provienen de su Intelligence Index v5.0.1; la latencia del primer token de respuesta y el total de tokens de salida provienen de una instantánea de página del 13 de noviembre de 2026. Todos los siguientes son resultados de evaluaciones estandarizadas de terceros, no son pruebas reales de este sitio.
| Nivel de pensamiento | Índice de inteligencia | Costo promedio por tarea | Tiempo promedio por tarea | Latencia del primer token de respuesta | Tokens de salida de la evaluación completa |
|---|---|---|---|---|---|
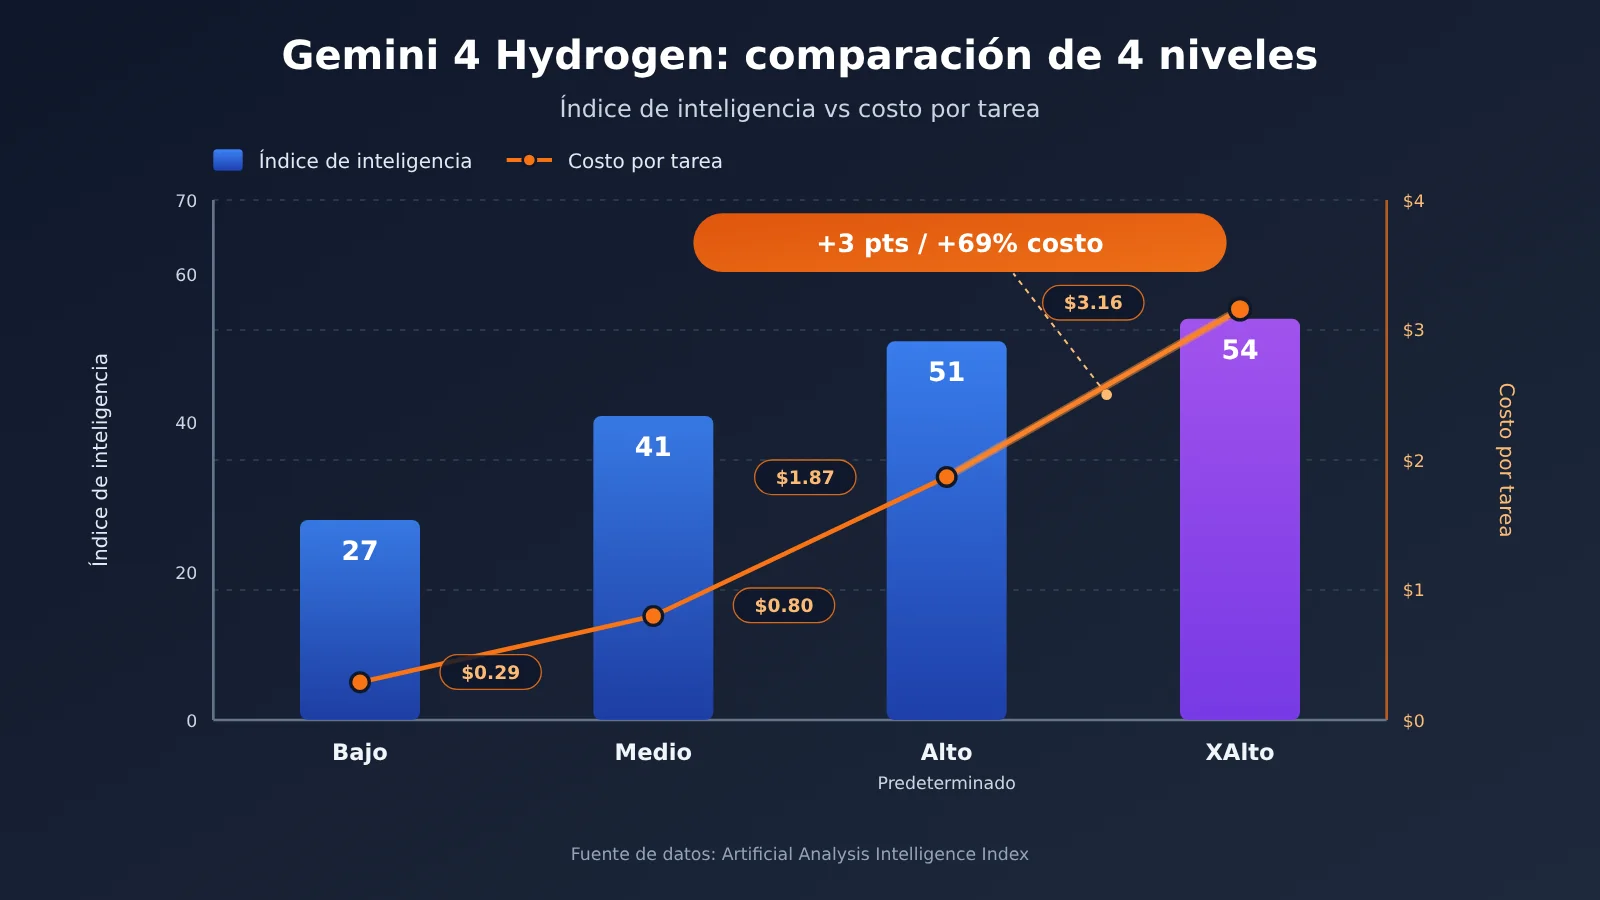
| Low | 27 | $0.29 | 1,3 minutos | aprox. 5,7 segundos | 20,3 millones |
| Medium | 41 | $0.80 | 3,7 minutos | aprox. 11,8 segundos | 54,4 millones |
| High (predeterminado) | 51 | $1.87 | 8,3 minutos | aprox. 18,9 segundos | 110 millones |
| XHigh | 54 | $3.16 | 13,5 minutos | aprox. 37,8 segundos | 304 millones |
No mezcles los tres indicadores de tiempo
Esta tabla contiene tres tipos de indicadores, con significados diferentes:
- Índice de inteligencia: puntuación de capacidad que sintetiza múltiples benchmarks, solo indica el nivel relativo dentro de este conjunto de evaluaciones.
- Tiempo promedio por tarea: indicador ponderado calculado a partir del número de tokens de salida de la tarea y la velocidad de salida de extremo a extremo, representa la carga de trabajo estandarizada de evaluación. Cuando un usuario hace una pregunta simple, no necesariamente tiene que esperar 8,3 minutos.
- Latencia del primer token de respuesta: tiempo de espera desde que se envía la solicitud hasta que se ve el primer token de respuesta, incluye la fase de pensamiento del modelo de razonamiento, es el indicador que los usuarios perciben más en escenarios de conversación.
Como se puede ver en la tabla, la diferencia de puntuación entre Medium y High (10 puntos) es mucho mayor que entre High y XHigh. Con el mismo nombre de modelo, la diferencia de capacidad real entre diferentes niveles puede superar los 20 puntos. Al comparar Hydrogen con otros modelos, primero hay que confirmar qué nivel está usando la otra parte.
Gemini 4 Hydrogen XHigh cuesta 69% más que High: ¿qué se compra realmente?
Al comparar los datos de los cuatro niveles por pares, se pueden ver el beneficio y el costo de cada salto de nivel. Los porcentajes incrementales de la siguiente tabla fueron calculados por la redacción a partir de los datos publicados por Artificial Analysis.
| Ruta de mejora | Cambio en el índice de inteligencia | Cambio en el costo por tarea | Cambio en el tiempo promedio | Costo adicional por cada punto extra |
|---|---|---|---|---|
| Low → Medium | +14 puntos | +176% | +185% | Aprox. $0.036 |
| Medium → High | +10 puntos | +134% | +124% | Aprox. $0.107 |
| High → XHigh | +3 puntos | +69% | +63% | Aprox. $0.43 |
Retornos decrecientes: el costo marginal de los cuatro niveles de pensamiento de Hydrogen
Al pasar de High a XHigh, el índice de inteligencia aumenta de 51 a 54, una mejora de aproximadamente 5.9%; el costo por tarea sube de $1.87 a $3.16, el tiempo aumenta de 8.3 minutos a 13.5 minutos y la latencia de la primera respuesta se duplica de unos 18.9 segundos a unos 37.8 segundos. Si lo calculamos por “cada punto adicional”, el costo marginal de XHigh es aproximadamente 12 veces el de Low → Medium.
La razón principal es el uso de tokens. La salida de toda la suite de evaluación de High es de unos 110 millones de tokens, y la de XHigh es de unos 304 millones, aproximadamente 2.76 veces más. Sin embargo, la factura no aumentó 2.76 veces, porque el costo total también incluye los tokens de entrada, los aciertos de caché y la forma en que se ponderan las tareas de evaluación; no se puede estimar el costo directamente multiplicando los tokens de salida.
Un promedio bajo no significa que la ganancia en tareas complejas también sea baja
El índice de inteligencia es el resultado promedio de varias tareas; una diferencia de 3 puntos puede deberse a dos escenarios: en la mayoría de las tareas ambos niveles rinden igual, y en unas pocas tareas de alta dificultad XHigh es claramente mejor. Para tareas como razonamiento científico, demostraciones matemáticas o refactorizaciones grandes que abarcan varios archivos, donde “un solo paso en falso echa todo a perder”, el pensamiento adicional de XHigh puede determinar si la tarea se completa con éxito.
Por eso, una forma más precisa de decirlo es: XHigh tiene una relación costo-beneficio muy baja para tareas normales, pero puede ser necesario para unas pocas tareas de alta dificultad. Para decidir si vale la pena pagar 69% más, debes verificarlo con tus propias muestras de tareas; no basta con mirar el puntaje promedio.
🎯 Consejo técnico: conviene seleccionar primero entre 20 y 50 muestras de tareas reales, ejecutarlas una vez con High y otra con XHigh, y comparar la tasa de éxito y el costo por tarea. A través de APIYI apiyi.com, puedes cambiar los parámetros con la misma clave API y completar la prueba A/B, sin necesidad de modificar la estructura del código de negocio.
¿Para qué tareas sirve cada uno de los cuatro niveles de pensamiento de Gemini 4 Hydrogen?
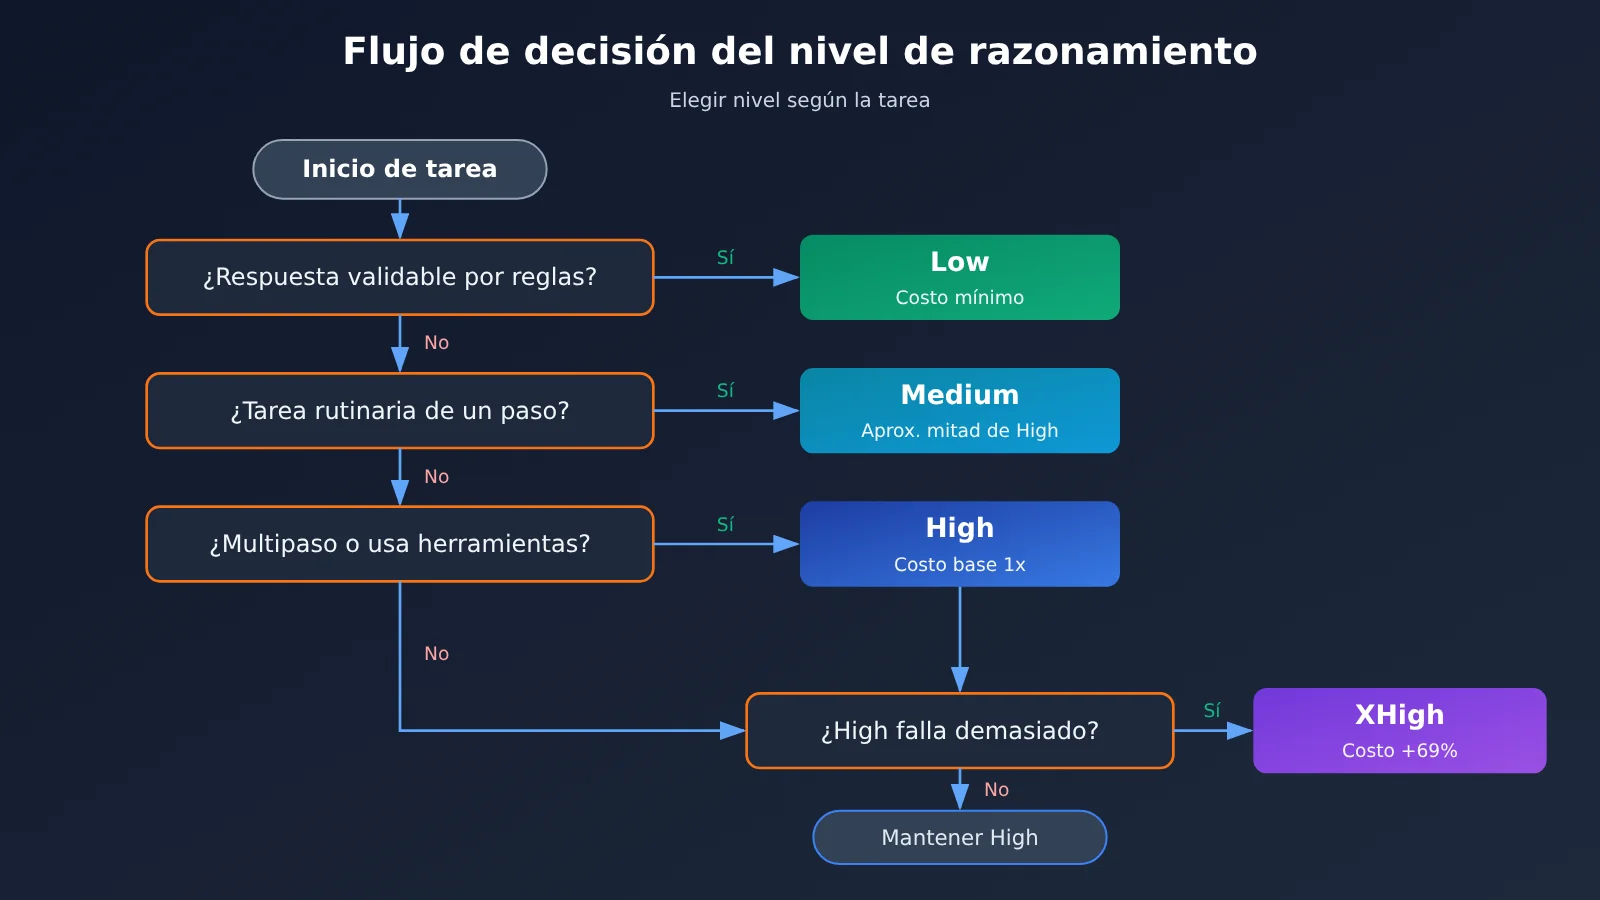
Combinando las recomendaciones oficiales de Google con los datos de coste anteriores, podemos dar las siguientes sugerencias según la dificultad de la tarea:
| Tipo de tarea | Nivel recomendado | Ejemplo típico | Motivo de la elección |
|---|---|---|---|
| Clasificación, extracción, formateo | Low | Clasificación de tickets, extracción de campos, formateo de JSON, preguntas y respuestas simples | Coste más bajo, latencia del primer token de unos 5.7 segundos, adecuado para alta concurrencia |
| Código y procesamiento de contenido habitual | Medium | Escritura de funciones en un solo archivo, reescritura de textos, resúmenes de documentos, automatización de negocio general | 14 puntos más que Low, y el coste sigue siendo menos de la mitad de High |
| Agentes de varios pasos y llamada de herramientas | High | Corrección de bugs entre archivos, llamadas continuas a herramientas, análisis integral tras la recuperación | Nivel predeterminado oficial, equilibrio entre capacidad y coste |
| Razonamiento de alta complejidad | XHigh | Razonamiento científico, demostraciones matemáticas, refactorización de grandes proyectos de software | Úsalo solo cuando la tasa de éxito de High claramente no baste |
Cuándo usar los niveles bajos de Hydrogen
Low y Medium encajan en escenarios donde el objetivo de la tarea está claro y la respuesta es fácil de verificar. Por ejemplo, extraer importes y fechas de un contrato, o repartir el feedback de los usuarios en diez categorías: en tareas así, pensar más difícilmente mejora la precisión, solo aumenta la latencia y el coste. En escenarios sensibles a la latencia del primer token, como el chat en tiempo real o el autocompletado de búsqueda, los ~5.7 segundos de Low son claramente mejores que los ~37.8 segundos de XHigh.
Cuándo usar los niveles altos de Hydrogen
High es el nivel predeterminado que fija Google y encaja con la mayoría de los flujos de trabajo de agentes. Solo cuando aparece el caso de «High falla repetidamente y el coste de reintentar ya supera el coste de subir de nivel» conviene pasar a XHigh. Conviene tener en cuenta que la ficha oficial del modelo de Google también señala que los niveles de pensamiento altos pueden aumentar de forma notable el tiempo y el coste, y que de vez en cuando aparecen latencias o tiempos de espera agotados; en tareas de cadena larga hay que configurar bien las estrategias de timeout y reintento.
Cómo los desarrolladores pueden controlar el coste de razonamiento de Gemini 4 Hydrogen
El parámetro thinking_level y su valor predeterminado
Hydrogen utiliza el parámetro thinking_level para elegir el nivel de razonamiento. Si no se especifica, el valor predeterminado es High. Al migrar desde Gemini 3.8 Flash hay varios puntos que conviene tener en cuenta:
- En 3.8 Flash, el valor predeterminado es Medium. Después de la migración, si no se pasa el parámetro, cambiará automáticamente a High y la factura podría aumentar.
thinking_budgetyMINIMALya no son compatibles; si se usan, devolverán HTTP 400.- Los valores personalizados de temperature, top_p y top_k se ignoran.
- Las llamadas a herramientas en varios turnos requieren guardar y reenviar correctamente las firmas de pensamiento (thought signatures).
Ejemplo mínimo: invocar Hydrogen por nivel
A continuación usamos el formato compatible con OpenAI y pasamos el nivel de pensamiento mediante extra_body. Es posible que cada plataforma use campos distintos para transmitir este parámetro; consulta la documentación de la plataforma para conocer el nombre exacto del campo.
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Interfaz unificada de APIYI
)

resp = client.chat.completions.create(
    model="gemini-4-hydrogen",
    messages=[{"role": "user", "content": "把这条反馈分类:退款太慢"}],
    extra_body={"thinking_level": "low"}  # Para clasificación simple usa Low
)
print(resp.choices[0].message.content)
Ver el código completo: clasificar según la dificultad de la tarea y escalar de nivel automáticamente
import openai
from typing import Optional

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

# Mapeo de tipos de tarea a nivel predeterminado
LEVEL_MAP = {
    "classify": "low",
    "extract": "low",
    "content": "medium",
    "code": "medium",
    "agent": "high",
    "reasoning": "xhigh",
}
ESCALATE = {"low": "medium", "medium": "high", "high": "xhigh"}


def call_hydrogen(prompt: str, level: str) -> tuple[str, dict]:
    resp = client.chat.completions.create(
        model="gemini-4-hydrogen",
        messages=[{"role": "user", "content": prompt}],
        extra_body={"thinking_level": level},
    )
    usage = resp.usage.model_dump() if resp.usage else {}
    return resp.choices[0].message.content, usage


def run_task(prompt: str, task_type: str, validator=None,
             max_level: Optional[str] = "high") -> str:
    """Empieza con el nivel bajo; si la validación falla, sube de nivel progresivamente. max_level limita el nivel máximo"""
    level = LEVEL_MAP.get(task_type, "medium")
    while True:
        answer, usage = call_hydrogen(prompt, level)
        print(f"[{level}] usage={usage}")  # Registra los tokens, para calcular el coste de las tareas exitosas
        if validator is None or validator(answer):
            return answer
        if level == max_level or level not in ESCALATE:
            return answer
        level = ESCALATE[level]


result = run_task(
    prompt="提取订单号,只返回数字:订单 A-20261113-889 已发货",
    task_type="extract",
    validator=lambda s: s.strip().replace("-", "").isalnum(),
)
print(result)
🚀 Inicio rápido: APIYI apiyi.com ofrece una interfaz compatible con OpenAI. Con una sola clave API puedes invocar modelos populares como Gemini, Claude y OpenAI. Los usuarios nuevos disponen de crédito gratuito de prueba, ideal para probar primero la estrategia de niveles anterior y luego pasarla a producción.
Estrategia por niveles: empezar bajo y subir solo si falla
La práctica recomendada es «nivel bajo por defecto, subir según necesidad»: para tareas simples, usar siempre Low o Medium; para tareas complejas, arrancar en High y subir a XHigh únicamente cuando falle la validación; además, definir un techo máximo por tipo de tarea para evitar que los costos se disparen sin querer. Esto va en la misma línea que la idea de Google en Antigravity Orchestrator de repartir el trabajo entre distintos modelos, solo que aquí lo que ajustamos es la profundidad de razonamiento de un mismo modelo.
Medir la optimización de niveles de Hydrogen con cuatro indicadores
| Indicador | Cómo se calcula | Por qué nos importa |
|---|---|---|
| Precisión / tasa de éxito | Tareas que pasan la validación ÷ total de tareas | La calidad no puede caer de forma notable al bajar de nivel |
| Tiempo de extremo a extremo | Tiempo total desde la solicitud hasta obtener un resultado utilizable, incluyendo reintentos | La latencia del primer token es solo una parte |
| Consumo de tokens | Tokens de entrada + salida (incluido el razonamiento) | Los tokens de razonamiento se facturan como salida |
| Costo por tarea exitosa | Gasto total ÷ tareas exitosas | Con niveles bajos y fallos frecuentes que obligan a reintentar, puede salir más caro que un nivel alto |
El «costo por tarea exitosa» es el que mejor refleja el gasto real. Si con Medium un 30% de las tareas necesita volver a ejecutarse, mientras que con High se resuelven al primer intento, entonces el costo por tarea exitosa de High puede acabar siendo más bajo.
Preguntas frecuentes (FAQ)
P1: ¿Los cuatro niveles de pensamiento de Gemini 4 Hydrogen son cuatro modelos distintos?
No. Los cuatro niveles son distintas profundidades de razonamiento del mismo modelo `gemini-4-hydrogen`, se cambian con el parámetro thinking_level, el precio por Token es el mismo y la diferencia está en la cantidad de Tokens de pensamiento que se generan.
P2: XHigh solo saca 3 puntos más que High, ¿entonces no vale la pena usarlo en absoluto?
No se puede ver así. Esos 3 puntos son la diferencia promedio en varias tareas; en razonamiento científico, demostraciones matemáticas y tareas de ingeniería grandes, XHigh puede ser lo que determina si la tarea se completa o no. Para tareas normales, XHigh tiene una relación costo-beneficio baja; para unas pocas tareas muy difíciles, puede ser necesario.
P3: High tarda 8.3 minutos de media, ¿eso significa que hay que esperar todo ese tiempo cada vez que preguntamos?
No. Los 8.3 minutos son el tiempo ponderado de las tareas estandarizadas de evaluación de Artificial Analysis. Para una conversación normal conviene fijarse más bien en la latencia del primer Token de respuesta: unos 18.9 segundos con High y unos 5.7 segundos con Low. La duración real depende además de la longitud de la tarea.
P4: ¿Qué pasa si no se pasa thinking_level?
Se usa High por defecto. En proyectos migrados desde Gemini 3.8 Flash (Medium por defecto), si se reutiliza el código antiguo sin pasar el parámetro, el nivel de pensamiento se eleva automáticamente y el costo puede subir también; conviene establecer el nivel de forma explícita.
P5: ¿Cómo comparar rápidamente el efecto de distintos niveles en mi propio negocio?
Se recomienda preparar un lote de muestras de tareas reales, ejecutarlas con distintos niveles y calcular la tasa de éxito y el consumo de Tokens:
1. Regístrate en APIYI apiyi.com y obtén la clave API y la cuota de prueba gratuita
2. Usa el código de este artículo y modifica el valor de `thinking_level`
3. Elige el nivel más adecuado según el «costo por tarea exitosa»
P6: ¿Qué problemas conocidos tienen los niveles altos de pensamiento de Hydrogen?
La ficha del modelo de Google menciona que los niveles altos de pensamiento pueden aumentar de forma notable el tiempo y el costo, y que en ocasiones aparecen retrasos o tiempos de espera agotados. Además, en Hacker News algunos usuarios han reportado casos de sobre-ejecución en ciertas tareas de Agent. Se recomienda definir tiempos de espera, un nivel máximo y condiciones de parada para las tareas largas.
P7: Al estimar costos por Token, ¿cuál es el error más común?
Estimar solo según el número de palabras de la respuesta final. Los Tokens de pensamiento se cobran al precio de salida, y en la batería completa de evaluaciones los Tokens de salida de XHigh son aproximadamente 2.76 veces los de High. Consultar el desglose de uso real en la consola de APIYI apiyi.com es más fiable que estimar a mano.
Puntos clave del pensamiento en cuatro niveles de Gemini 4 Hydrogen
- Mismo modelo, diferentes niveles: los cuatro niveles tienen el mismo precio unitario; el coste real de la tarea depende del uso de tokens de pensamiento.
- Rendimientos decrecientes evidentes: de High a XHigh suma 3 puntos, pero el coste de la tarea de evaluación aumenta aproximadamente un 69%.
- Latencia duplicada: la latencia de la primera respuesta en XHigh es de aproximadamente 37,8 segundos, el doble que en High.
- Por defecto es High: al migrar desde 3.8 Flash, es necesario establecer explícitamente el nivel.
- Selecciona el nivel según la dificultad: para clasificación usa Low, para tareas normales Medium, para agentes High, y solo para problemas difíciles XHigh.
- Fíjate en el coste por tarea exitosa: incluye también los reintentos para comparar el gasto real de los diferentes niveles.
- Valida con muestras: puedes comparar el efecto de los cuatro niveles con una sola clave a través de APIYI (apiyi.com).
Resumen
Conclusiones clave de la comparación de los cuatro niveles de pensamiento de Gemini 4 Hydrogen:
- Gran diferencia de capacidad: de 27 puntos en Low a 54 puntos en XHigh; bajo el mismo nombre de modelo, la capacidad se duplica.
- Coste marginal creciente: el coste adicional por cada punto extra pasa de aproximadamente $0,036 en Low → Medium a aproximadamente $0,43 en High → XHigh.
- XHigh debe usarse según sea necesario: la diferencia en la puntuación media es pequeña, pero para algunas tareas de alta dificultad aún puede ser crucial.
La recomendación para el día a día del negocio es: establecer explícitamente thinking_level, usar niveles bajos para tareas simples, aumentar el nivel para pasos complejos, y utilizar el coste por tarea exitosa como métrica final.
Se recomienda validar rápidamente el rendimiento de cada nivel con muestras de tareas reales a través de APIYI (apiyi.com); la plataforma ofrece una interfaz compatible con OpenAI y crédito de prueba gratuito.
📚 Referencias
- Artificial Analysis – Página de evaluación de las cuatro configuraciones de Gemini 4 Hydrogen: índice de inteligencia, coste por tarea, duración y datos de latencia
- Enlace:
artificialanalysis.ai/models/gemini-4-hydrogen-low - Enlace:
artificialanalysis.ai/models/gemini-4-hydrogen-medium - Enlace:
artificialanalysis.ai/models/gemini-4-hydrogen-high - Enlace:
artificialanalysis.ai/models/gemini-4-hydrogen -
Descripción: fuente de todos los datos comparativos de las cuatro configuraciones que aparecen en este artículo; la latencia es una métrica dinámica
-
Blog oficial de Google – Introducing Gemini 4 Hydrogen: anuncio de lanzamiento
- Enlace:
blog.google/innovation-and-ai/models-and-research/gemini-models/introducing-gemini-4-hydrogen/ -
Descripción: posicionamiento del modelo, alcance de capacidades y casos de partners
-
Guía para desarrolladores de Google Cloud – Gemini 4 Hydrogen:
thinking_levely consideraciones de migración - Enlace:
docs.cloud.google.com/gemini-enterprise-agent-platform/models/guides/gemini-4-hydrogen -
Descripción: usos recomendados de las cuatro configuraciones, configuración predeterminada y parámetros incompatibles
-
Página de precios de Google AI Studio: precios oficiales de la API de Hydrogen
- Enlace:
aistudio.google.com/docs/pricing -
Descripción: precios de los modos Standard, Batch, Flex y Priority, y reglas de facturación de los tokens de pensamiento
-
Ficha del modelo de Google DeepMind: limitaciones y evaluaciones de seguridad
- Enlace:
deepmind.google/models/model-cards/gemini-4-hydrogen/ - Descripción: riesgos de duración con niveles de pensamiento altos, rechazos, alucinaciones y otros problemas conocidos
Autor: equipo técnico de APIYI
Intercambio técnico: puedes contactarnos desde la página de inicio del sitio oficial de APIYI para conseguir más material sobre la integración de los modelos de la serie Gemini