Nota del autor: que un modelo «parezca menos capaz» no significa necesariamente que haya sido sustituido. A partir de la reciente investigación de Anthropic sobre pruebas de inferencia con FlashProve, este artículo organiza los factores que afectan a los resultados de las llamadas a la API en una secuencia de diagnóstico, desde el lado del cliente hasta el servidor.
«La misma pregunta se resuelve en la web oficial, pero al usar la API se queda atascada»; «este mes el modelo parece claramente menos capaz». Casi todos los desarrolladores que integran un Modelo de Lenguaje Grande mediante una API se han encontrado con quejas parecidas. La primera reacción de muchos es preguntarse: ¿habrán cambiado el modelo por detrás?
Anthropic publicó recientemente FlashProve, un prototipo de investigación de código abierto que intenta usar pruebas criptográficas para verificar si «esta respuesta procede realmente de un conjunto concreto de pesos». Esto abre, por primera vez, una vía de verificación matemática para comprobar si se ha sustituido un modelo.
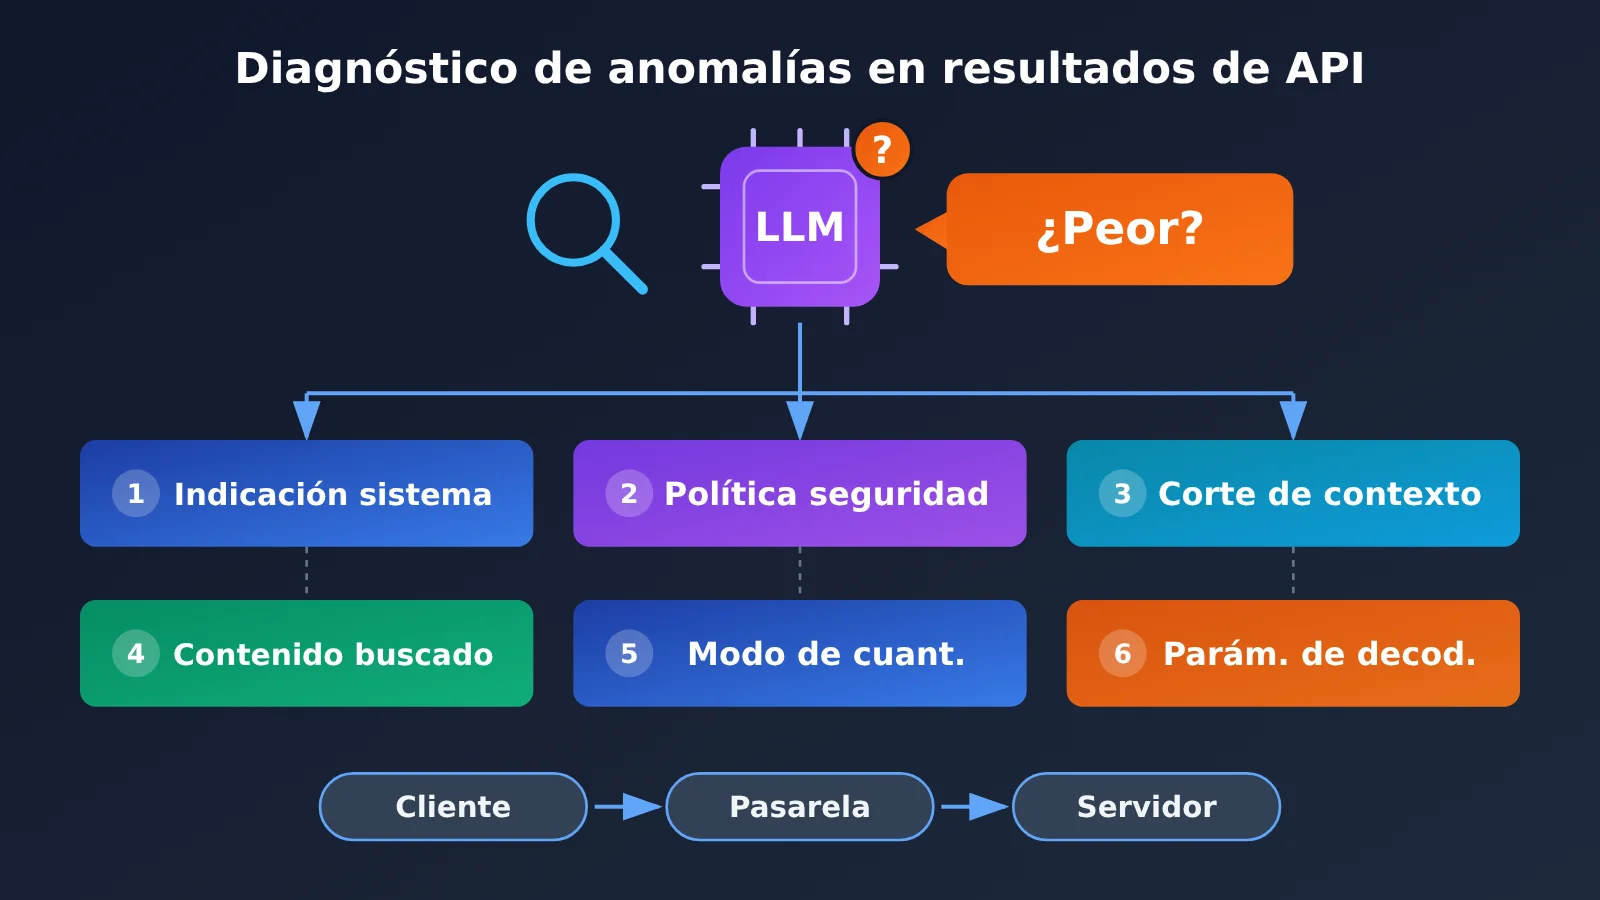
Pero eso no resuelve por completo el problema de la aparente pérdida de capacidad. La investigación señala que, incluso cuando se ha confirmado la identidad de los pesos, las indicaciones de sistema, las políticas de seguridad, el truncamiento del contexto, el contenido recuperado, el método de cuantización y los parámetros de decodificación siguen afectando al resultado final. La experiencia del equipo de Kimi también muestra que una parte considerable de las anomalías en las evaluaciones se debe al uso incorrecto de los parámetros de decodificación.
Qué te llevarás: al terminar este artículo, tendrás una lista para diagnosticar por qué un modelo parece menos capaz. Sabrás qué puedes comprobar por tu cuenta, qué requiere la colaboración del proveedor y por qué «hacer unas cuantas preguntas para identificar el modelo» no es un método fiable.
El modelo parece menos capaz: claves para investigarlo
Primero, pongamos en contexto el debate. Surgió a raíz de una investigación de Anthropic sobre la «inferencia verificable» y llevó a la comunidad a plantearse una pregunta: ¿quién tiene la culpa cuando un modelo parece haber perdido capacidad?
| Aspecto | Detalle |
|---|---|
| Responsable | Equipo de investigación de Anthropic, que también publicó el código, el informe técnico y las pruebas formales en Lean |
| Propuesta | FlashProve: genera pruebas criptográficas de la inferencia del modelo mediante pruebas de conocimiento cero concisas zkSNARK |
| Qué resuelve | Permite verificar si una salida procede de unos pesos determinados, sin divulgarlos ni obligar al usuario a volver a ejecutar el modelo |
| Qué no resuelve | Los cambios en la capa del producto, como las indicaciones de sistema, las políticas de seguridad, el contexto o los parámetros de decodificación |
| Qué implica para desarrolladores | Si el rendimiento del modelo resulta anómalo, hay que investigar cada capa, no centrarse solo en si «lo han sustituido» |
Cómo demuestra FlashProve que el modelo es quien dice ser
FlashProve funciona en dos pasos. Primero, el proveedor genera un «compromiso» para los pesos del modelo: una especie de huella criptográfica que los identifica de forma única sin revelarlos. Después, genera una prueba para una entrada y una salida determinadas. Con el compromiso, la indicación, la respuesta y el archivo de prueba, el usuario puede verificar en su propia computadora si la salida se calculó realmente con los pesos comprometidos.
El diseño de conocimiento cero garantiza que el verificador no obtenga los pesos ni los valores intermedios del cálculo, y que tampoco pueda ver qué expertos se invocaron en cada capa de un modelo MoE. Es mucho más fiable que «pedirle al modelo que se identifique»: el nombre que aparece en la respuesta ya no sirve como prueba de identidad; lo que se comprueba es la relación computacional entre la salida y los pesos.
Anthropic realizó un experimento con Llama 4 Maverick y sus pesos públicos de 4 bits. Es un modelo de mezcla de expertos con unos 400.000 millones de parámetros, de los que activa unos 17.000 millones por token. Estos son los datos principales publicados:
| Métrica | Datos del experimento | Aclaración |
|---|---|---|
| Rendimiento de generación de pruebas | Unos 110 tokens/segundo con una sola H100 | Es la velocidad de generación de pruebas, no la de respuesta del chat |
| Tamaño del archivo de prueba | Unos 19 MB por solicitud de 1.024 tokens | Debe transmitirse junto con la respuesta |
| Tiempo de verificación | Unos 17 segundos en una CPU de 24 hilos | No requiere GPU; puede hacerse en una computadora portátil |
| Generación del compromiso de los pesos | Unos 39 minutos | Solo hay que generarlo una vez |
| Costo adicional | El tiempo de GPU es entre 70 y 95 veces mayor que en una inferencia normal con vLLM | Todavía queda camino para su adopción a gran escala |
Por qué el modelo puede parecer menos capaz aunque se hayan confirmado los pesos
FlashProve tiene un requisito clave: el usuario debe conocer de antemano el compromiso del «modelo auténtico». Si el proveedor solo puede demostrar que la respuesta procede de un modelo que él mismo eligió, pero el usuario no puede confirmar que sea el que contrató, la prueba sigue sin resolver el problema de identidad. Lo ideal sería que el fabricante del modelo o una entidad de confianza publicara el compromiso, para que el usuario verificara siempre esa misma huella.
Más importante aún: que los pesos no hayan cambiado no significa que el servicio siga siendo el mismo. Una prueba vinculada a los pesos no permite saber automáticamente si se ajustó la indicación de sistema, si se truncó el contexto o si los parámetros de decodificación siguen siendo los mismos. Por eso persisten las quejas de que un modelo parece menos capaz: a menudo son el resultado de varios cambios acumulados.
6 causas comunes de que un modelo parezca menos inteligente
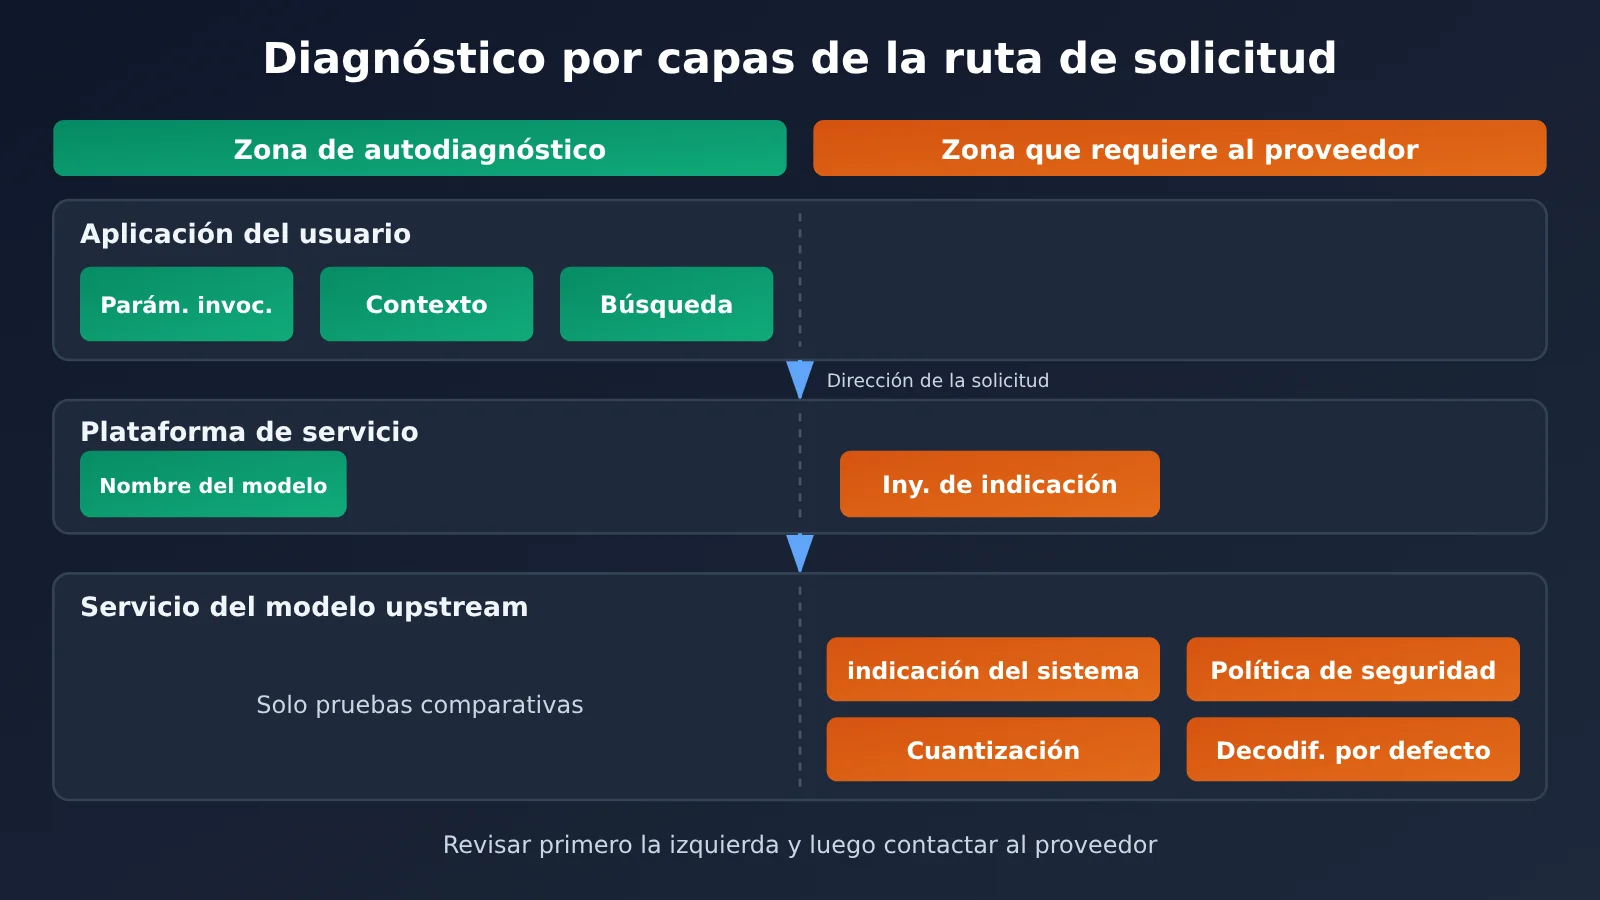
Si analizamos uno por uno los factores de la investigación de referencia y los agrupamos según dónde podría estar el problema, veremos que una buena parte depende de quien hace la invocación.
| Factor | Manifestaciones típicas | Dónde puede ocurrir | ¿Puede revisarlo el usuario? |
|---|---|---|---|
| Parámetros de decodificación | Salidas dispersas o repetitivas, puntuaciones bajas en modo de razonamiento | Principalmente en la aplicación cliente, aunque el servidor también puede establecer valores predeterminados | Sí, revisando los parámetros de la solicitud |
| Truncamiento del contexto | «Olvida» lo anterior, da respuestas incompletas o ignora instrucciones | Tanto en la aplicación cliente como en el servidor | En parte, revisando el uso de tokens |
| Indicación del sistema | Cambios de estilo, más rechazos o formato incorrecto | Incorporada por la aplicación cliente o el servidor | Puede revisar la suya, pero no la del servidor |
| Política de seguridad | Ciertos tipos de preguntas se rechazan de repente o reciben respuestas más conservadoras | Principalmente en el servidor | Es difícil; hace falta una explicación del proveedor |
| Contenido recuperado | Variaciones en la calidad de las respuestas en escenarios RAG | En la cadena de recuperación de la aplicación cliente | Sí, revisando el contenido recuperado |
| Método de cuantización | Ligera pérdida general de capacidad y más errores en razonamientos largos | En el despliegue del servidor | No, hace falta la colaboración del proveedor |
Uso incorrecto de los parámetros de decodificación: una causa fácil de pasar por alto
Al presentar Kimi Vendor Verifier, el equipo de Kimi compartió un hallazgo muy representativo: desde el lanzamiento de K2 Thinking, habían recibido numerosos comentarios de la comunidad sobre puntuaciones anómalas. Tras investigarlos, confirmaron que una parte considerable se debía al uso incorrecto de los parámetros de decodificación. El equipo estableció restricciones para esos parámetros en el modo Thinking y comprobó que el contenido del razonamiento se devolviera correctamente.
La conclusión para cualquier desarrollador es clara: si parámetros como temperature, top_p, max_tokens o el interruptor del modo de razonamiento no coinciden con las recomendaciones oficiales, el rendimiento del modelo puede alejarse bastante de lo esperado. Esto es especialmente importante en los modelos de razonamiento: cada proveedor tiene sus propios requisitos sobre los parámetros de muestreo, el presupuesto de razonamiento y la forma de devolver el contenido del razonamiento en conversaciones de varios turnos. Consulta los valores concretos en la documentación oficial de cada modelo, en vez de reutilizar la configuración habitual de un modelo de conversación.
Contexto incompleto: cuando parece que el modelo «pierde la memoria»
Otro problema frecuente está en el contexto. Si en una conversación de varios turnos solo se envía el mensaje más reciente, el modelo no puede «recordar» lo anterior. En un flujo de trabajo, si el historial supera la ventana de contexto del modelo, las primeras instrucciones del sistema suelen ser lo que se trunca. Como resultado, el modelo deja de repente de respetar el formato de salida. Además, un valor de max_tokens demasiado bajo puede truncar la respuesta a mitad de camino, dando la impresión de que «se detuvo a mitad de la respuesta».
Todos estos problemas pueden dar la sensación de que el modelo se ha vuelto menos inteligente, pero la mayoría de las veces se pueden identificar al momento revisando el cuerpo de la solicitud y el motivo de finalización en la respuesta.
Cómo investigar si un modelo parece haberse vuelto menos inteligente: 3 pasos
Como las causas pueden estar en distintos puntos de la cadena de invocación, conviene empezar por lo más fácil y económico de comprobar. Sigue este orden:
- Revisa primero tu integración: comprueba el nombre de
model, los parámetros de decodificación,max_tokens, la indicación del sistema, la lista completa de mensajes y el contenido recuperado por RAG. - Haz una prueba comparativa: mantén fijos los parámetros y las indicaciones, y compara el comportamiento con el de los canales oficiales o con lo descrito en la documentación oficial. Ejecuta la prueba varias veces para observar la distribución de los resultados, en lugar de basarte en uno solo.
- Evalúa por último el servicio: si la configuración de tu integración es correcta y la diferencia se reproduce de forma consistente, contacta con el proveedor y comparte los registros de las solicitudes y los resultados de las pruebas.
Ejemplo mínimo: una invocación reproducible con parámetros fijos
El primer paso más práctico es declarar todos los parámetros de forma explícita, sin depender de valores predeterminados, e imprimir el motivo de finalización y el uso de tokens:
import openai

client = openai.OpenAI(api_key="YOUR_API_KEY", base_url="https://api.apiyi.com/v1")

resp = client.chat.completions.create(
    model="gpt-4o-mini",  # Sustituye por el nombre del modelo que quieres revisar
    messages=[{"role": "user", "content": "用三句话解释什么是零知识证明"}],
    temperature=0, max_tokens=800,
)
print(resp.choices[0].finish_reason, resp.usage)
print(resp.choices[0].message.content)
Si finish_reason es length, la respuesta se truncó por max_tokens. En ese caso, la respuesta incompleta no indica que el modelo sea menos capaz, sino que hay un problema de configuración. El número de tokens de entrada en usage también ayuda a comprobar si se envió todo el contexto.
Ver el script completo de pruebas comparativas
import json
import openai
from collections import Counter

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Para cambiar de modelo, solo modifica el parámetro model
)

# Declara todos los parámetros explícitamente para no depender de valores predeterminados
PARAMS = {
    "temperature": 0.2,   # Para modelos de razonamiento, usa el valor recomendado en la documentación oficial
    "top_p": 1.0,
    "max_tokens": 2000,
}

TEST_CASES = [
    {"id": "math", "prompt": "一个数加上它的一半等于 45,这个数是多少?只给出数字。", "expect": "30"},
    {"id": "format", "prompt": "用 JSON 输出三种水果名称,键名为 fruits。", "expect": "fruits"},
]

def run_case(model: str, case: dict, rounds: int = 5) -> dict:
    """Ejecuta un mismo caso varias veces y calcula la tasa de aciertos, los truncamientos y el uso de tokens"""
    hits, finish = 0, Counter()
    prompt_tokens = []
    for _ in range(rounds):
        resp = client.chat.completions.create(
            model=model,
            messages=[
                {"role": "system", "content": "你是严谨的助手,按要求作答。"},
                {"role": "user", "content": case["prompt"]},
            ],
            **PARAMS,
        )
        content = resp.choices[0].message.content or ""
        finish[resp.choices[0].finish_reason] += 1
        prompt_tokens.append(resp.usage.prompt_tokens)
        if case["expect"] in content:
            hits += 1
    return {
        "case": case["id"],
        "hit_rate": hits / rounds,
        "finish_reasons": dict(finish),
        "prompt_tokens": sorted(set(prompt_tokens)),
    }

if __name__ == "__main__":
    model = "gpt-4o-mini"  # Sustituye por el modelo que quieres revisar
    report = [run_case(model, c) for c in TEST_CASES]
    print(json.dumps({"model": model, "params": PARAMS, "report": report},
                     ensure_ascii=False, indent=2))
La clave de este script no está en las preguntas de prueba, sino en tres aspectos: fijar todos los parámetros e incluirlos en el informe, ejecutar cada caso varias veces para observar la tasa de aciertos y registrar finish_reason y prompt_tokens para descartar problemas de truncamiento y contexto. Solo después de descartar estas tres posibilidades vale la pena preguntarse si hubo cambios en el servidor.
🚀 Consejo para el diagnóstico: APIYI apiyi.com utiliza una interfaz compatible con OpenAI. Para cambiar de modelo, solo hay que modificar el parámetro model, lo que facilita comparar varios modelos con el mismo script de pruebas. La plataforma ofrece registros de llamadas y estadísticas de uso para revisar el consumo de las solicitudes y los tokens, y así ayudar a comprobar si se envió todo el contexto. Para saber qué campos muestran los registros, consulta la consola de la plataforma.
Qué puedes revisar tú y cuándo necesitas al proveedor
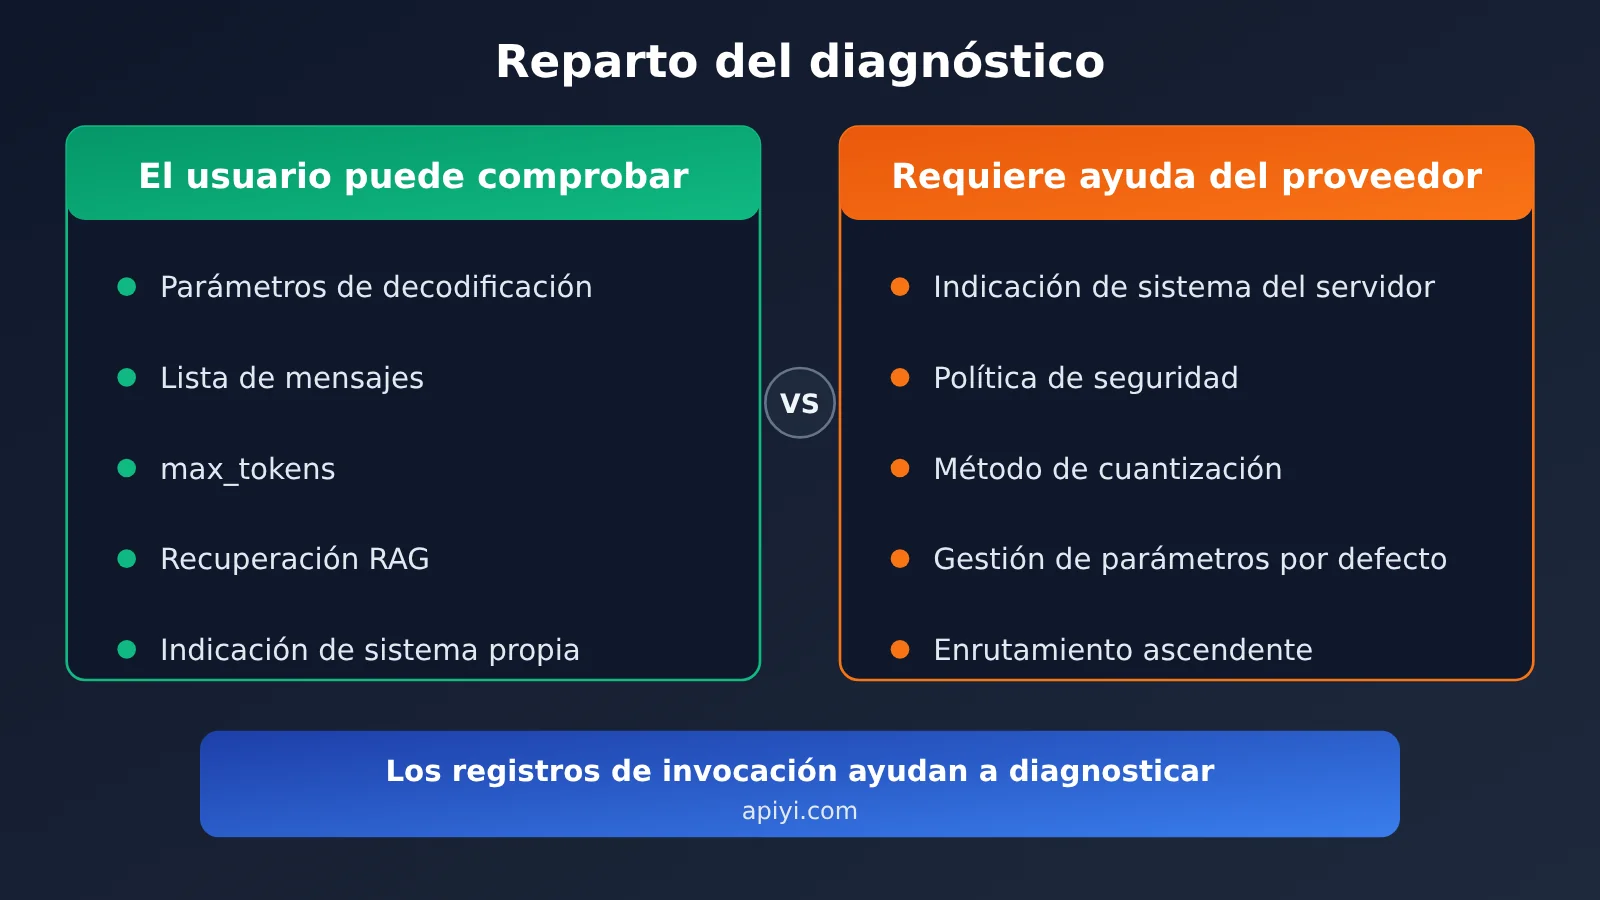
| Aspecto | Cómo comprobarlo | Información que debe proporcionar el proveedor |
|---|---|---|
| Parámetros de decodificación | Muestra el cuerpo completo de la solicitud y compáralo con la documentación oficial | Si la plataforma modifica los parámetros o añade valores predeterminados |
| Integridad del contexto | Revisa la lista de mensajes y prompt_tokens | Si hay truncamientos o límites de ventana en el servidor |
| Modo de razonamiento | Comprueba el ajuste de razonamiento y cómo se devuelve su contenido | Si el proveedor upstream admite los parámetros correspondientes |
| Cuantización y despliegue | No se puede comprobar por cuenta propia | Precisión del despliegue e información sobre el canal upstream |
| Políticas de seguridad | Compara cómo responde a la misma solicitud a través del canal oficial | Si se han añadido reglas de revisión adicionales |
Cuando contactes con el proveedor, lleva una solicitud de ejemplo con parámetros fijos, los resultados estadísticos de varias ejecuciones y datos comparativos. Así será mucho más fácil avanzar. Si solo dices «el modelo se ha vuelto menos capaz», le resultará difícil identificar el problema.
Por qué hacer unas pocas preguntas no basta para determinar si un modelo se ha vuelto menos capaz
En la comunidad se ha popularizado un método: preguntarle al modelo algo que solo conocería una versión nueva y, si no sabe responder, concluir que «lo han cambiado». El problema es que una sola respuesta incluye un componente aleatorio. Un error puntual, parámetros diferentes, falta de contexto o diferencias en el enrutamiento interno del proveedor pueden llevar a la misma conclusión: «Este no es el modelo que quería».
El proyecto de investigación Model Equality Testing de la Universidad de Stanford ofrece una perspectiva más rigurosa. Los investigadores probaron 31 endpoints de API comerciales correspondientes a cuatro modelos Llama de 2024 y encontraron que la distribución de las respuestas de 11 de ellos presentaba diferencias estadísticas respecto a la distribución de referencia obtenida con los pesos publicados por Meta. La clave está en que el método compara «distribuciones» de respuestas, no si una o dos preguntas se contestan correctamente.
Para los desarrolladores, lo útil es adoptar ese enfoque estadístico: observar las diferencias persistentes con parámetros fijos, varios casos de prueba y múltiples ejecuciones. Por eso, el script comparativo anterior utiliza la «tasa de aciertos» en lugar de un «resultado individual».
Análisis del impacto de la pérdida de capacidad de los modelos
Impacto para los desarrolladores
- Revisar antes de sacar conclusiones: cuando los resultados sean anómalos, primero revisa el cuerpo de la solicitud. El uso incorrecto de parámetros y la falta de contexto son los problemas más fáciles de comprobar y de los más frecuentes.
- Definir los parámetros explícitamente: en producción, no dependas de valores predeterminados. Configura los modelos de razonamiento según la documentación oficial e incluye los parámetros en el control de versiones.
- Crear un conjunto de pruebas de regresión: mantén una serie de casos fijos y ejecútalos periódicamente. Así, si el modelo pierde capacidad, tendrás datos y no solo impresiones.
- Conservar los registros de invocación: los parámetros de la solicitud, el uso de tokens y el motivo de finalización son pruebas clave al comunicarte con el proveedor.
Impacto en la industria
- De las impresiones a las pruebas: FlashProve muestra cómo se puede verificar la identidad de los pesos. En el futuro, los proveedores de modelos, las entidades de evaluación y los reguladores podrían usarlo para confirmar qué modelo se está utilizando realmente.
- La exigencia de transparencia se ampliará: además de los pesos, la consistencia de las indicaciones del sistema, las estrategias de decodificación y las configuraciones de despliegue será uno de los próximos focos de debate.
- Su adopción generalizada llevará tiempo: el costo de generar una prueba es varias decenas de veces mayor que el de una inferencia normal. También hace falta admitir contextos más largos y contar con un mecanismo confiable de publicación de compromisos, por lo que es difícil que cubra las invocaciones cotidianas a corto plazo.
Preguntas frecuentes
P1: Si el modelo parece menos capaz, ¿qué debería revisar primero?
Primero revisa tu solicitud: si el nombre de model es correcto, si los parámetros de decodificación, como temperature, siguen las recomendaciones oficiales, si max_tokens es demasiado bajo y si se incluye el historial completo de mensajes en las conversaciones de varios turnos. La experiencia del equipo de Kimi indica que una parte considerable de los resultados anómalos en las pruebas se debe al uso incorrecto de los parámetros de decodificación, por lo que esta comprobación suele dar resultados rápidos.
P2: ¿Puede FlashProve resolver por completo la controversia sobre la pérdida de capacidad de los modelos?
No. Puede verificar si la salida procede de unos pesos determinados, pero para ello debe existir un compromiso confiable del modelo con el que contrastarla. Una prueba de pesos no cubre automáticamente factores como la indicación del sistema, las políticas de seguridad, el truncamiento del contexto, el método de cuantización o los parámetros de decodificación.
P3: ¿Cómo se realiza una prueba comparativa confiable?
Mantén fijos todos los parámetros y las indicaciones, prepara varios casos con respuestas claras y ejecuta cada uno varias veces para calcular la tasa de aciertos. Registra también finish_reason y el consumo de tokens. Con APIYI apiyi.com puedes comparar varios modelos usando el mismo código compatible con OpenAI. Los usuarios nuevos disponen de saldo gratuito de prueba para este tipo de verificaciones.
P4: ¿Por qué un modelo de razonamiento puede rendir peor en la API que en la versión web?
Entre las causas habituales están que el modo de razonamiento no esté activado o que su presupuesto sea diferente, que los parámetros de muestreo no coincidan con las recomendaciones oficiales, que el contenido de razonamiento no se devuelva correctamente en las conversaciones de varios turnos o que las indicaciones del sistema y las herramientas incluidas en la versión web no estén disponibles en la API. Conviene revisar cada punto en la documentación oficial de la API del modelo.
P5: Si todo está correcto tras la revisión, ¿cómo debería comunicarme con el proveedor?
Prepara ejemplos de solicitudes con parámetros fijos, estadísticas de varias ejecuciones, datos comparativos de los canales oficiales y las franjas horarias en las que aparecieron las anomalías. En la consola de APIYI apiyi.com puedes consultar los registros de invocación y las estadísticas de uso. Incluir los registros correspondientes puede reducir considerablemente el tiempo necesario para identificar el problema.
Puntos clave para investigar si un modelo se ha vuelto menos capaz
- Que un modelo parezca menos capaz no significa que lo hayan sustituido: la indicación del sistema, el contexto y los parámetros de decodificación también pueden cambiar los resultados.
- El uso incorrecto de parámetros es común: el equipo de Kimi confirmó que una parte considerable de los resultados anómalos en las pruebas se debía al uso incorrecto de parámetros de decodificación.
- Conviene investigar por etapas: primero revisa la configuración del cliente, después realiza pruebas comparativas y, por último, evalúa si hay un problema en el servidor.
- Una sola pregunta no basta para sacar conclusiones: compara la distribución de las respuestas en varias ejecuciones, en lugar de fijarte en una o dos.
- La verificación de pesos tiene límites: FlashProve solo comprueba la identidad de los pesos; no detecta cambios de configuración en la capa del producto.
- Unifica las herramientas de prueba: puedes usar la interfaz compatible y los registros de APIYI apiyi.com para comparar modelos.
Resumen
Hasta ahora, los debates sobre si un modelo se había vuelto menos capaz se apoyaban sobre todo en capturas de pantalla e impresiones. FlashProve de Anthropic ofrece una forma verificable de comprobar si se ha sustituido el modelo, pero también nos recuerda que, además de los pesos, hay toda una capa de configuración que afecta a los resultados.
- Primero, revisa tu configuración: los parámetros de decodificación,
max_tokens, la lista de mensajes y el contenido recuperado mediante RAG son el punto de partida más económico. - Después, compara: utiliza parámetros fijos, varios casos de prueba y múltiples ejecuciones para contrastar los resultados con el rendimiento oficial. Sustituye las impresiones por datos.
- Por último, contacta con el proveedor: una vez descartados los errores del cliente, comparte los registros de las solicitudes y los resultados estadísticos para ayudar a localizar posibles problemas del servidor.
Te recomendamos incorporar el script comparativo de este artículo a tus pruebas de regresión habituales. Con APIYI apiyi.com puedes usar el mismo código para verificar rápidamente el rendimiento de varios modelos; la plataforma ofrece una cuota gratuita de prueba y una interfaz unificada compatible con OpenAI.
📚 Referencias
- 36氪 / APPSO – Análisis de la investigación de Anthropic sobre inferencia verificable: principios de FlashProve, datos experimentales y análisis de las causas de la degradación del rendimiento
- Enlace:
36kr.com/p/4056019887510401 -
Descripción: Fuente principal de los datos de este artículo. Incluye información sobre Kimi Vendor Verifier y Model Equality Testing.
-
Anthropic Research – Provable Inference: página oficial de investigación de FlashProve
- Enlace:
anthropic.com/research/provable-inference - Descripción: Incluye el informe técnico, el código abierto y las pruebas formales.
Autor: Equipo técnico de APIYI
Consultas técnicas: Si tienes problemas al investigar resultados anómalos en las invocaciones, contáctanos desde la página de inicio de APIYI en apiyi.com. Para más información sobre la integración, visita el centro de documentación en docs.apiyi.com.