Nota del autor: al comparar el costo de los modelos, fijarse solo en el precio por millón de tokens puede llevarte a elegir mal. Este artículo presenta un método de cálculo basado en «precio unitario × consumo real de tokens» y los pasos para hacer una prueba con una muestra pequeña de tus propias tareas.
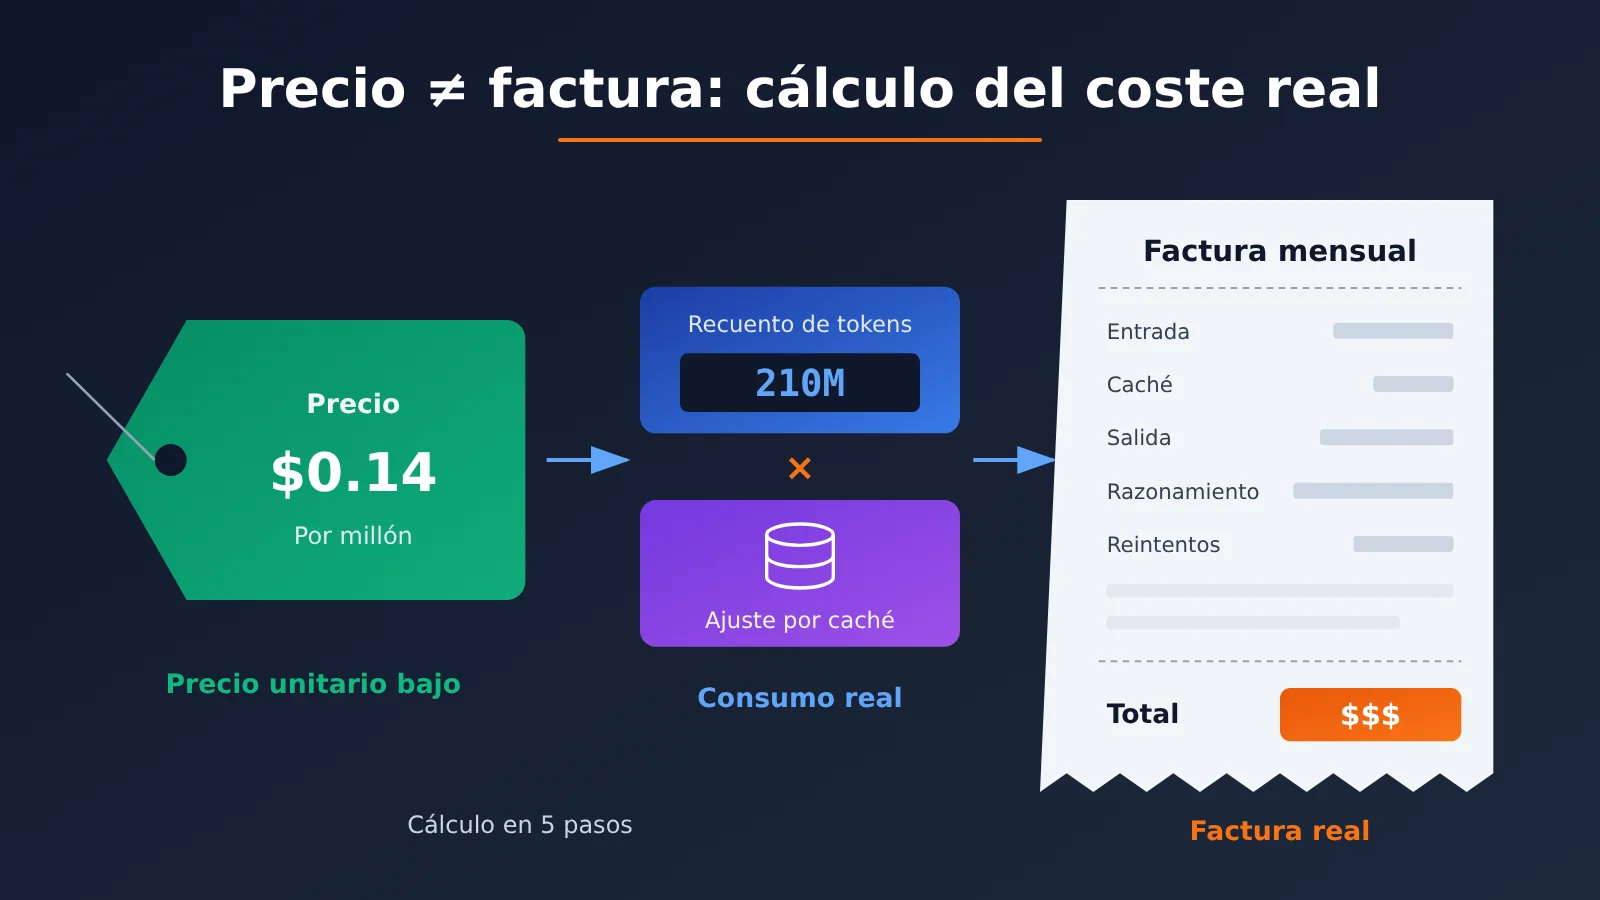
Muchos equipos empiezan por consultar la página de precios al elegir un modelo. Ven que el modelo A cuesta apenas unos céntimos por millón de tokens, mientras que el modelo B cuesta varios dólares, y concluyen que A es más económico. Pero, al final del mes, la factura no siempre coincide con lo esperado: a veces, el modelo «barato» termina costando más. En este artículo explicamos el método para calcular el costo real: «precio unitario × consumo real de tokens + ajuste por caché», para que puedas hacer bien las cuentas antes de elegir un modelo.
Este no es otro resumen de tablas de precios. Las tablas quedan desactualizadas; el método de cálculo sigue siendo útil. Tomaremos casos de cálculos publicados, extraeremos un marco general y lo aplicaremos a tus propias tareas.
Qué te llevarás: al terminar, podrás explicar por qué «un precio más bajo no significa una factura más baja» y medir el costo por tarea de cada modelo candidato con entre 20 y 50 solicitudes reales.
Claves del costo real de un modelo
| Punto clave | Explicación | Impacto en la elección |
|---|---|---|
| El precio unitario es solo uno de los factores | Factura = suma de los tokens de cada tipo × su precio correspondiente | Comparar solo el precio unitario equivale a mirar solo la mitad de la fórmula |
| Diferencias en la tokenización | Un mismo texto se divide en cantidades distintas de tokens según el modelo | El costo de entrada debe calcularse con el recuento real de cada modelo |
| Tokens de razonamiento | El proceso de razonamiento de estos modelos suele facturarse como salida, aunque el usuario no lo vea | Una respuesta visible muy corta puede generar una factura elevada |
| Aciertos de caché | Cuando un prefijo repetido se encuentra en caché, se factura a una tarifa más baja | La diferencia es considerable con indicaciones largas de sistema y conversaciones de varios turnos |
| Tasa de éxito y reintentos | Las respuestas incorrectas o con un formato no válido obligan a repetir la tarea | Costo efectivo = costo por intento ÷ tasa de éxito |
Por qué el precio por millón de tokens no basta para calcular el costo real
El precio por millón de tokens indica «cuánto cuesta cada token», pero la factura refleja «cuánto cuesta completar una tarea». Entre ambos hay una variable clave: cuántos tokens hacen falta para terminarla. Las diferencias entre modelos en este aspecto suelen ser incluso mayores que las diferencias de precio unitario.
Un cálculo publicado el 1 de agosto de 2026 en un blog independiente muestra un caso típico: DeepSeek V4 Flash y Gemini 3.6 Flash obtuvieron la misma puntuación en Artificial Analysis, 50 puntos. El precio anunciado del primero era de $0.14/M y el del segundo, de $1.50/M: una diferencia de aproximadamente 10 veces. Pero en la misma evaluación, el primero consumió unos 210 millones de tokens y el segundo, unos 59 millones, más de tres veces menos. El mayor consumo compensó buena parte de la ventaja en precio unitario, por lo que la diferencia real quedó muy lejos de ser de 10 veces.
Otro factor son las diferencias de tokenización. En un artículo del 12 de agosto de 2026 de la misma fuente, se pidió a 9 modelos que contaran los tokens de un documento idéntico. Los resultados variaron entre 614 y 957 tokens, una diferencia de aproximadamente el 56% entre el mínimo y el máximo. Es decir, aunque dos modelos tengan exactamente el mismo precio de entrada, el costo de procesar una misma indicación puede variar en más de un 50%.
💡 Sobre los datos: estas cifras proceden de cálculos puntuales publicados en un blog independiente. Las tareas de evaluación, las versiones de los modelos y los precios cambian con el tiempo, así que solo sirven para ilustrar el fenómeno; no conviene usarlas directamente para preparar tu presupuesto. Para tus propias tareas, tendrás que hacer las pruebas de nuevo.
Composición de la factura del modelo: qué tipos de tokens determinan el costo real
Para calcular bien los costos, primero hay que saber qué conceptos aparecen en la factura. La mayoría de los proveedores facturan las categorías de la siguiente tabla, aunque los nombres y la facturación por separado dependen de la documentación oficial de cada uno.
| Concepto facturado | Significado | Forma habitual de cobro | Detalles fáciles de pasar por alto |
|---|---|---|---|
| Entrada sin acierto de caché | Indicaciones enviadas en la solicitud actual que no se encontraron en la caché | Precio unitario de entrada | Depende del tokenizador: un mismo texto puede tener costos distintos |
| Entrada con acierto de caché | Parte del prefijo idéntica a la de solicitudes anteriores | Precio de lectura de caché, normalmente mucho menor que el de entrada | El prefijo debe coincidir exactamente para aprovechar la caché |
| Escritura en caché | Algunos proveedores cobran por separado la primera escritura en caché | Puede ser más cara que la entrada normal | Si la tasa de aciertos es baja, puede resultar más costosa |
| Salida visible | Respuesta que ve finalmente el usuario | Precio unitario de salida | Suele ser varias veces superior al de entrada |
| Tokens de razonamiento | Proceso de razonamiento interno del modelo | Por lo general, se cobran al precio unitario de salida | No aparecen en la respuesta, pero se incluyen en la factura |
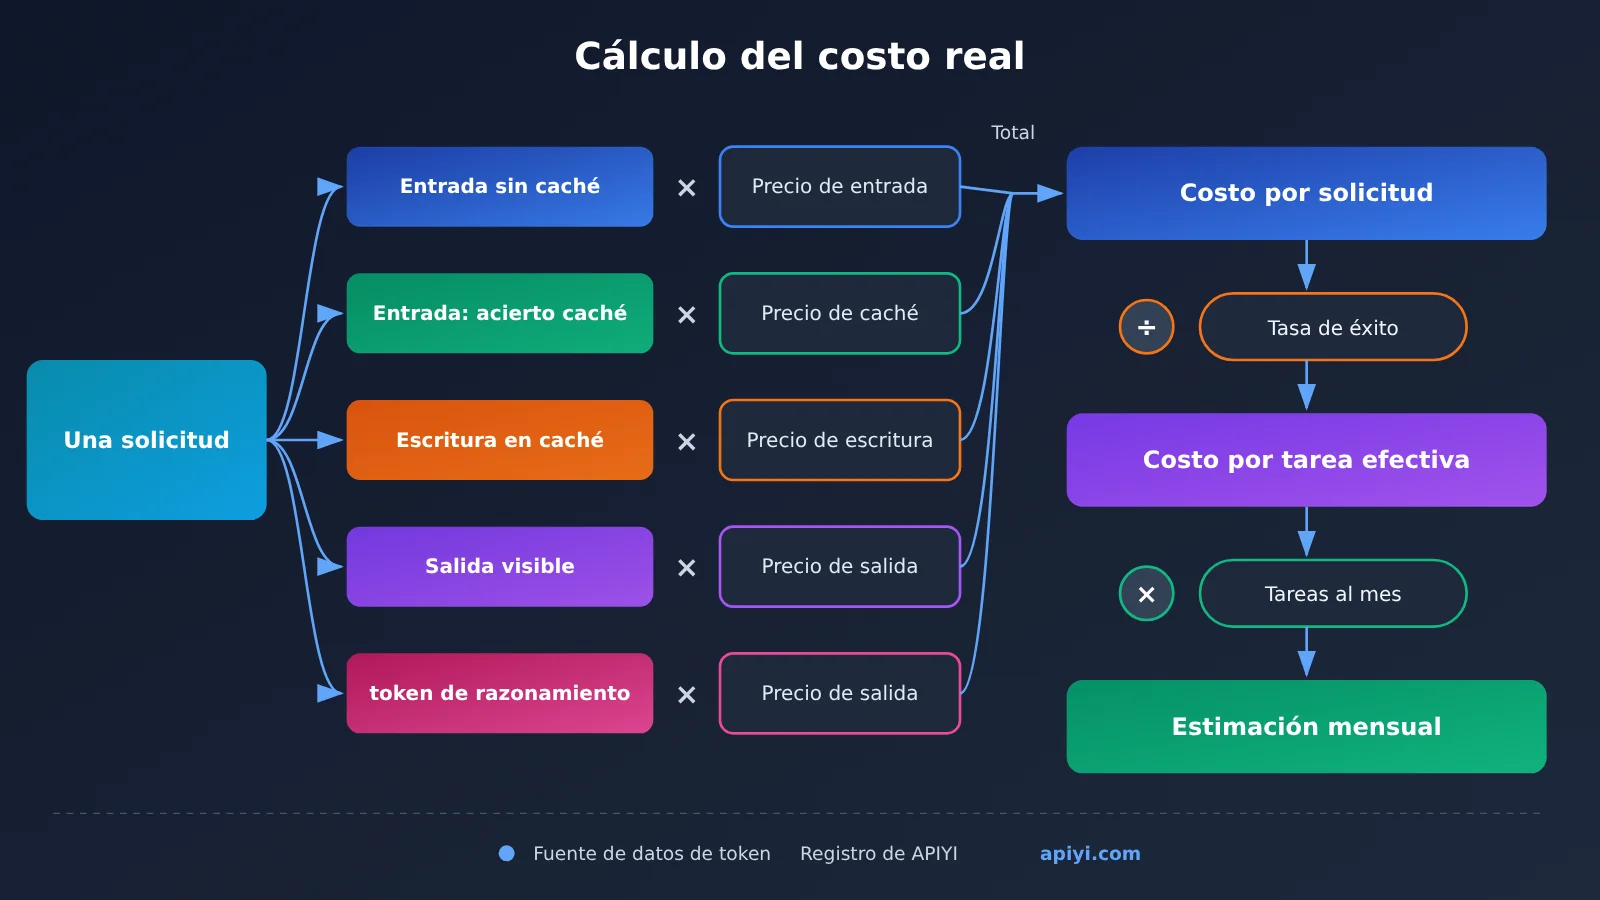
Al reunir estos conceptos en unas fórmulas, obtenemos el marco de cálculo central de este artículo:
- Costo por solicitud = tokens de entrada sin acierto de caché × precio unitario de entrada + tokens con acierto de caché × precio unitario de caché + tokens escritos en caché × precio unitario de escritura + (salida visible + tokens de razonamiento) × precio unitario de salida
- Costo efectivo por tarea = costo por solicitud × número promedio de invocaciones ÷ tasa de éxito de las tareas
- Estimación mensual = costo efectivo por tarea × número de tareas mensuales
El impacto de la caché suele subestimarse. Un artículo de la misma fuente, publicado el 6 de agosto de 2026, señala que el precio de DeepSeek V4 Flash con acierto de caché es unas 50 veces menor que sin acierto, y que los precios de caché entre distintos proveedores de alojamiento pueden variar hasta 28 veces. Esto significa que la factura de un mismo modelo puede ser completamente distinta según el canal utilizado. Por eso, es imprescindible comprobar los precios de caché del canal que uses.
El efecto multiplicador de los tokens de razonamiento en el costo real
Los modelos de razonamiento son uno de los casos más comunes de «precio bajo, factura alta». El usuario hace una sola pregunta y el modelo responde con 200 caracteres, pero antes puede haber procesado miles de tokens internamente. Estos suelen facturarse al precio de salida, que ya es varias veces superior al de entrada.
Las estimaciones públicas de terceros también muestran este efecto. Un artículo del 4 de agosto de 2026 afirma que Qwen 3.8 Max obtuvo 3 puntos más que DeepSeek V4 Flash en Artificial Analysis, pero que, en las 3 tareas que puso a prueba, costó unas 345 veces más y fue unas 6 veces más lento. Otro artículo de la misma serie, con el mismo método de evaluación, ofrece estos resultados: Kimi K3 obtuvo 57 puntos por $2,437; DeepSeek V4 Flash, 50 puntos por $72; y Qwen 3.7 Max, 46 puntos por $1,604. Es posible obtener una puntuación más baja y gastar más, y la razón suele estar en la cantidad de tokens consumidos.
También puede haber diferencias entre versiones de un mismo proveedor. Un artículo señala que Claude Opus 4.5 a 4.8 y Opus 5 tienen el mismo precio, $5/$25, pero que las pruebas muestran una diferencia de aproximadamente 1.30 veces en el consumo de tokens. Aunque el precio no cambie, la factura puede variar un 30 %, algo que es fácil pasar por alto al actualizar la versión del modelo.
Cómo estimar el costo real a partir del consumo de tokens: 5 pasos para empezar
Este proceso permite hacer una estimación con una muestra pequeña sin necesidad de escribir scripts complejos. La regla principal es sencilla: para una misma tarea y una misma entrada, contabiliza por separado los tokens de entrada, salida, caché y razonamiento.
Paso 1: Prepara una muestra representativa de tareas
Selecciona entre 20 y 50 solicitudes del entorno de producción o de necesidades reales. Incluye los tipos de tareas principales, como preguntas y respuestas breves, documentos largos y conversaciones de varios turnos. Conserva en las muestras las indicaciones completas del sistema y el contexto, ya que las coincidencias de caché se producen principalmente en esos prefijos repetidos. No hagas la prueba solo con un «hola»: así no podrás medir las diferencias de tokenización ni el efecto de la caché.
Paso 2: Mantén fijas las variables e invoca cada modelo candidato
Usa la misma indicación de sistema, la misma entrada del usuario y los mismos valores de max_tokens y temperatura para cada modelo candidato. Si un modelo de razonamiento admite un parámetro de intensidad de razonamiento, registra el nivel utilizado: la cantidad de tokens de razonamiento puede variar mucho según el nivel.
En este paso, usar un punto de acceso común ahorra bastante trabajo. Con una plataforma de agregación como APIYI apiyi.com, puedes cambiar entre modelos de distintos proveedores con la misma clave API y el mismo método de invocación compatible con OpenAI. Basta con cambiar el nombre del modelo para ejecutar toda la comparación, sin tener que abrir una cuenta, añadir fondos y adaptar el SDK para cada proveedor.
Paso 3: Registra cada tipo de token por separado
Después de cada invocación, consulta el número de tokens en el campo usage de la respuesta. En el formato compatible con OpenAI, los campos más habituales son:
usage.prompt_tokens: número total de tokens de entradausage.prompt_tokens_details.cached_tokens: parte de los tokens de entrada recuperada de la cachéusage.completion_tokens: número total de tokens de salidausage.completion_tokens_details.reasoning_tokens: parte de los tokens de salida usada para razonamiento
Los nombres de los campos varían según el proveedor. Por ejemplo, el formato de Anthropic usa cache_read_input_tokens y cache_creation_input_tokens para distinguir entre la lectura y la escritura en caché. Consulta la documentación de cada proveedor para conocer los detalles.
Si prefieres no analizar las respuestas por tu cuenta, también puedes consultar los registros de la plataforma. APIYI ofrece registros y estadísticas de uso para cada invocación, lo que facilita comparar el consumo de un mismo lote de muestras entre distintos modelos. Ten en cuenta que debes comprobar en la consola y en la documentación de facturación de la plataforma si los tokens de caché y de razonamiento aparecen por separado y si los aciertos de caché se facturan por separado. Confírmalo antes de hacer los cálculos.
🚀 Inicio rápido: prueba primero una comparación a pequeña escala con 20 muestras en APIYI apiyi.com. Así podrás comprobar el orden de magnitud del consumo de tokens de cada modelo antes de decidir si amplías la muestra. La ventaja de usar un saldo común es que los gastos de las pruebas con varios modelos quedan concentrados en una sola cuenta, lo que también facilita revisar los cargos al terminar.
Paso 4: Resume los resultados en la plantilla de cálculo
Completa la siguiente plantilla con los resultados registrados, una fila por modelo. En el apartado de precios, indica siempre la fecha de consulta y la fuente.
| Campo | Instrucciones | Fuente de datos |
|---|---|---|
| Modelo y versión | Indica el número de versión o el sufijo de fecha exacto | Parámetros de invocación |
| Precios y fecha de consulta | Una columna para entrada, salida, lectura de caché y escritura de caché | Página oficial de precios o página de precios de la plataforma utilizada |
| Promedio de tokens de entrada sin acierto de caché | Media de la muestra | usage de la respuesta o registros de la plataforma |
| Promedio de tokens con acierto de caché | Media de la muestra; calcula también la tasa de aciertos | usage de la respuesta o registros de la plataforma (por ejemplo, estadísticas de uso de APIYI) |
| Promedio de tokens de salida visible | Total de salida menos la parte de razonamiento | usage de la respuesta |
| Promedio de tokens de razonamiento | Regístralos por separado para los modelos de razonamiento | usage de la respuesta |
| Tasa de éxito de las tareas | Porcentaje aprobado mediante evaluación manual o reglas | Registros de evaluación |
| Costo efectivo por tarea | Calcúlalo con la fórmula anterior | Cálculo resumido |
Paso 5: Toma la decisión según el costo efectivo por tarea
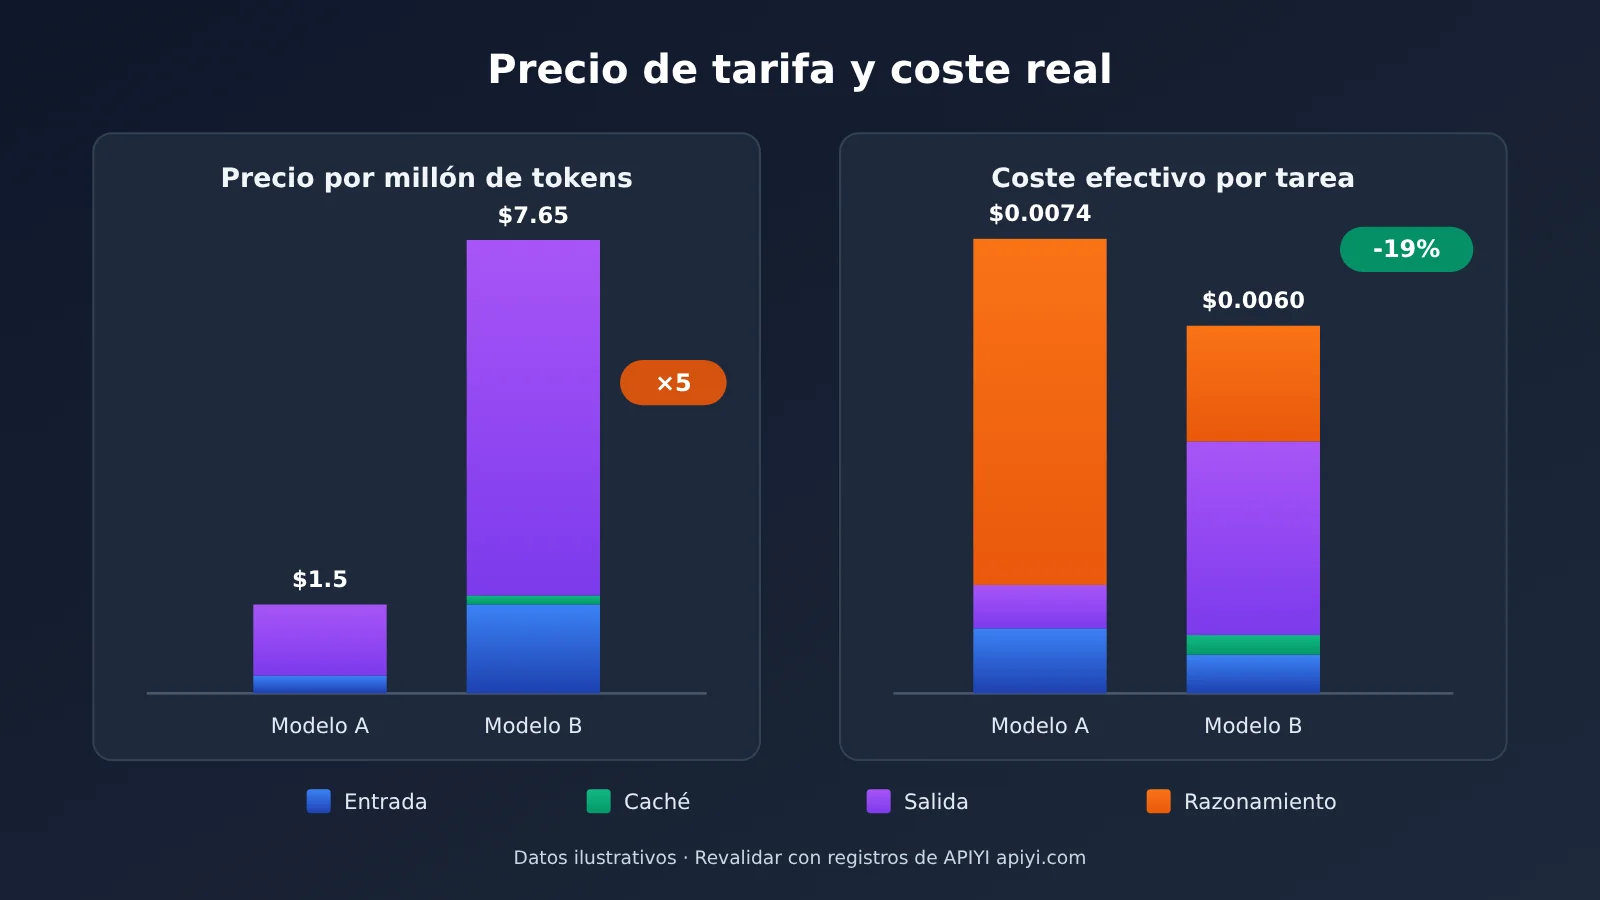
Al final, lo que debes comparar no es el precio unitario, sino el «costo efectivo por tarea». A continuación, usamos precios ilustrativos para mostrar el cálculo. Las cifras son ficticias y no representan el precio real de ningún modelo.
Supongamos que el modelo A tiene un precio de $0.3/M para la entrada y $1.2/M para la salida; el modelo B cuesta $1.5/M para la entrada, $6/M para la salida y $0.15/M para la lectura de caché. Su precio unitario es 5 veces el de A.
| Concepto | Modelo A (precio bajo) | Modelo B (precio alto) |
|---|---|---|
| Tokens de entrada sin acierto de caché | 3,000 | 400 |
| Tokens con acierto de caché | 0 | 2,000 |
| Tokens de salida visible + razonamiento | 500 + 4,000 | 500 + 300 |
| Costo de entrada | $0.0009 | $0.0006 + $0.0003 |
| Costo de salida | $0.0054 | $0.0048 |
| Costo por solicitud | $0.0063 | $0.0057 |
| Tasa de éxito de las tareas | 85% | 95% |
| Costo efectivo por tarea | aprox. $0.0074 | aprox. $0.0060 |
En este escenario ilustrativo, la tokenización del modelo B es más compacta, por lo que necesita 600 tokens menos de entrada; la mayor parte de su extensa indicación de sistema se recupera de la caché; y su proceso de razonamiento también es mucho más corto. Al final, aunque el precio de B es 5 veces mayor, su costo efectivo es alrededor de un 19% menor que el de A. En la práctica, el resultado podría ser el contrario; por eso es fundamental repetir la prueba con tus propias tareas.
Aspectos que debes revisar al calcular el costo real
El método de cálculo no es complicado, pero hay algunos detalles que pueden distorsionar los resultados. Conviene revisarlos uno por uno antes de empezar:
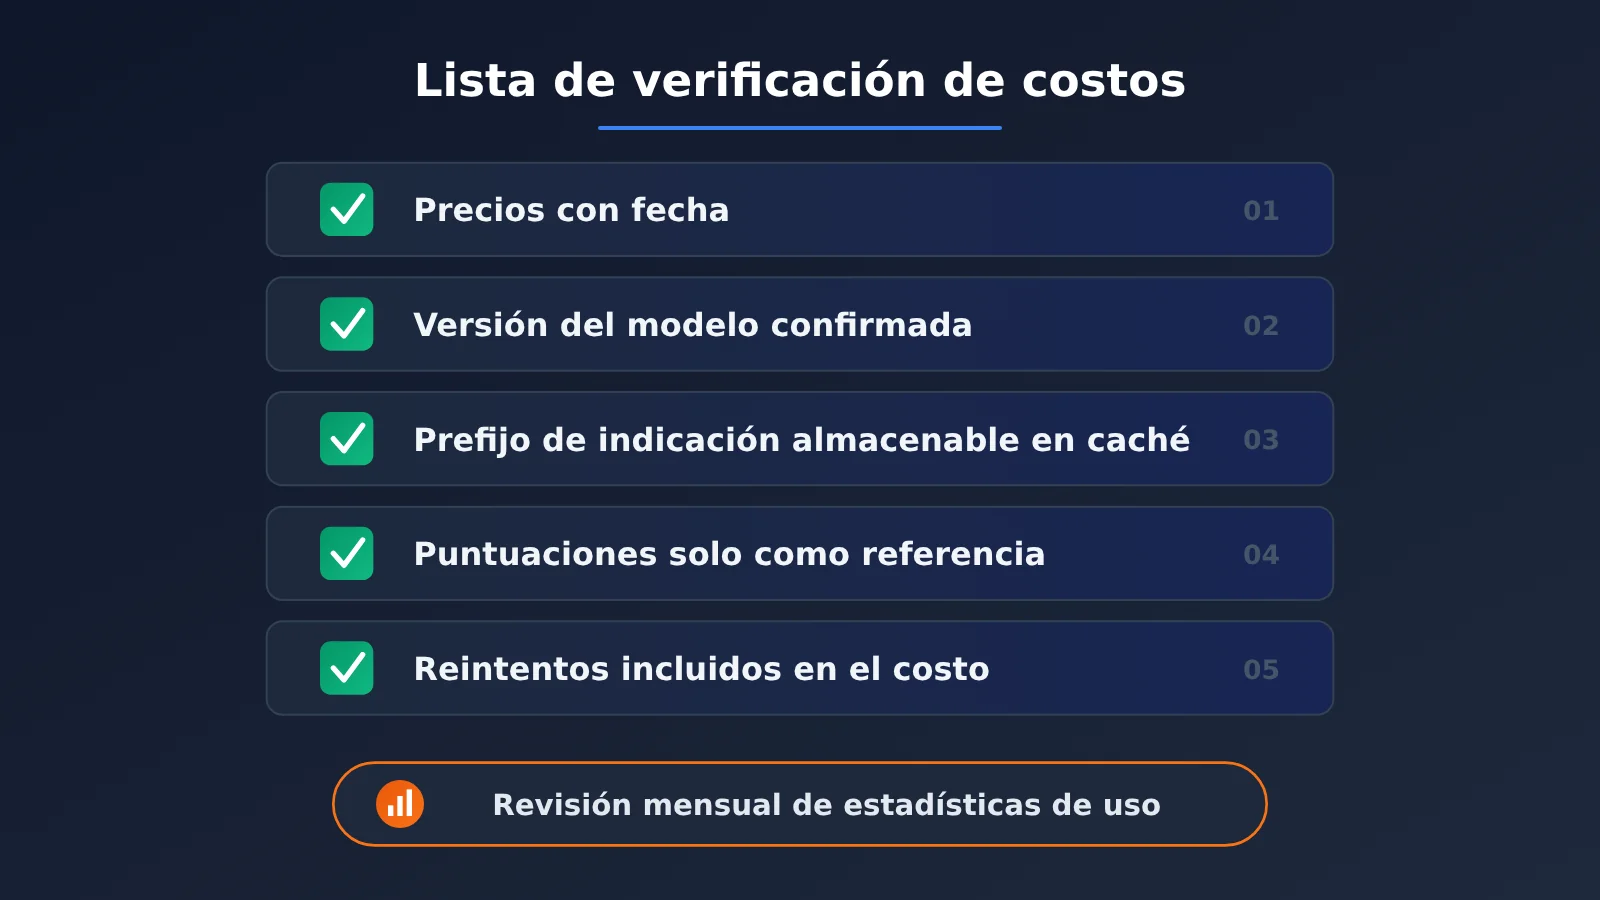
- Indica siempre la fecha de los precios: los precios de los modelos cambian con frecuencia. Por ejemplo, una de las fuentes menciona que DeepSeek V4 Pro 0813 aplica tarifas diferenciadas para horas pico y horas valle desde el 16 de agosto de 2026. El precio de un mismo modelo puede variar según el horario y el canal.
- Comprueba a qué versión apunta el alias del modelo: un artículo señala que un nombre de modelo aparentemente «muy usado» en realidad invoca una versión antigua. Durante las pruebas, registra el identificador del modelo devuelto en la respuesta para evitar probar la versión A y poner en producción la versión B.
- El acierto de caché depende de que el prefijo sea idéntico: si colocas contenido dinámico, como marcas de tiempo o ID de usuario, al principio de la indicación, el prefijo cambiará en cada llamada y será casi imposible aprovechar la caché. Usa la misma estructura de indicaciones que en producción.
- Usa los resultados de benchmarks solo como referencia: las puntuaciones globales de plataformas como Artificial Analysis y los costos calculados por tarea reflejan la distribución de tareas de la entidad evaluadora, que no necesariamente coincide con tu caso de uso.
- Incluye los reintentos: las repeticiones causadas por límites de frecuencia 429, errores de formato o respuestas que no cumplen los requisitos también generan costos. Calcula la tasa de éxito a partir de los resultados de evaluación reales.
💰 Consejo para optimizar costos: una vez terminadas las pruebas, puedes usar el «costo por tarea válida» como indicador principal para elegir un modelo y tratar las puntuaciones de benchmarks y la latencia como condiciones que debe cumplir. En APIYI apiyi.com, cambiar de modelo solo requiere modificar su nombre. Así puedes ajustar rápidamente la configuración en producción si cambian las conclusiones de tus pruebas y seguir vigilando el consumo real mediante los registros de llamadas.
Preguntas frecuentes FAQ
Q1: ¿Qué es el «costo real» de un modelo?
El costo real es lo que pagas por completar una tarea concreta, no el precio anunciado por millón de tokens. Se calcula multiplicando la cantidad real de cada tipo de token (entrada sin acierto de caché, acierto de caché, escritura en caché, salida visible y razonamiento) por su precio correspondiente. Después se tienen en cuenta la tasa de éxito y los reintentos para obtener el costo efectivo por tarea.
Q2: ¿Por qué un mismo documento tiene diferentes cantidades de tokens según el modelo?
Porque cada modelo usa un tokenizador distinto, que divide el chino, el código y los signos de puntuación con una granularidad diferente. En una medición pública, un mismo documento se contabilizó entre 614 y 957 tokens en 9 modelos. Por eso, el costo de entrada debe calcularse con la cantidad de tokens que informa cada modelo, sin aplicar el conteo de uno a los demás.
Q3: ¿Es necesario incluir los tokens de razonamiento en el costo?
Sí. La mayoría de los proveedores los incluyen en la salida y los cobran al precio de salida. No aparecen en el texto de la respuesta, pero pueden representar la mayor parte de los tokens de salida. Al evaluar modelos de razonamiento, conviene registrar `reasoning_tokens` por separado y comparar con el mismo nivel de intensidad de razonamiento.
Q4: ¿Cuánto se puede ahorrar con los aciertos de caché?
Depende de los precios de caché del proveedor y de tu tasa de aciertos. En las fuentes de referencia se menciona que el precio de DeepSeek V4 Flash con acierto de caché es aproximadamente 1/50 del precio sin acierto, aunque los precios de caché entre distintos proveedores de alojamiento pueden variar hasta 28 veces. Los mayores ahorros se obtienen en casos como indicaciones de sistema largas, prefijos fijos de bases de conocimiento y conversaciones de varias rondas. Consulta los precios del canal que utilices para conocer las cifras concretas.
Q5: ¿Cómo calcular rápidamente los costos de varios modelos con una muestra pequeña?
Te recomendamos usar una plataforma que ofrezca acceso unificado a varios modelos:
1. Regístrate en APIYI apiyi.com y obtén una clave API
2. Prepara entre 20 y 50 muestras de tareas reales y mantén fijas las indicaciones y los parámetros
3. Cambia el nombre del modelo en cada invocación y reúne los totales de cada tipo de token a partir de los registros de invocación y las estadísticas de uso
4. Calcula el costo efectivo por tarea con la plantilla de este artículo
Así puedes completar toda la comparación con una sola cuenta y un mismo método de invocación, reduciendo el costo de abrir cuentas y conciliar facturas con varios proveedores.
Q6: ¿Se puede usar directamente el «costo por tarea» publicado en un blog de terceros?
No es recomendable usarlo directamente para elaborar un presupuesto. Estos datos sirven para detectar combinaciones de modelos en las que «puede haber diferencias en el consumo de tokens» y reducir la lista de candidatos. Pero las tareas de evaluación, las versiones de los modelos, los precios y las condiciones de caché serán distintos de los de tu negocio, así que debes verificar las cifras finales con tus propias muestras.
Q7: ¿Qué limitaciones tiene este método de cálculo?
Una muestra pequeña solo refleja los tipos de tareas que incluye. Si cambia la distribución de tareas de tu negocio, tendrás que repetir la evaluación. Además, los registros de algunas plataformas no distinguen necesariamente entre tokens de caché y de razonamiento; en ese caso, tendrás que recopilarlos del campo `usage` de la respuesta del modelo. Los precios y las versiones de los modelos también cambian, así que conviene repetir la evaluación después de cada ajuste de precios o actualización.
Puntos clave para calcular el costo real de un modelo
- El precio unitario es solo la mitad de la fórmula: la factura depende del precio unitario multiplicado por el consumo real de tokens.
- Las diferencias de tokenización importan: un mismo documento puede generar más de un 50 % de diferencia en el número de tokens entre modelos.
- Los tokens de razonamiento aumentan el costo de salida: el proceso de razonamiento que no se ve también se factura como salida.
- El precio de la caché varía según el proveedor: la tasa de aciertos y el precio unitario de la caché determinan conjuntamente el costo de las indicaciones largas.
- Decide según el costo efectivo por tarea: incluye la tasa de éxito y los reintentos.
- Repite las pruebas desde una interfaz unificada: con la interfaz y los registros de invocación de APIYI, es más sencillo probar la misma muestra en varios modelos.
Resumen
Para estimar el costo real de un modelo a partir del consumo de tokens y la caché, hay tres pasos clave:
- Desglosa la factura: cuenta por separado los tokens de entrada sin acierto de caché, lectura de caché, escritura en caché, salida visible y razonamiento. Multiplica cada categoría por su precio unitario.
- Repite las pruebas con tus propias tareas: las pruebas y los precios de terceros son solo una referencia. Los datos fiables son los que obtienes al probar la misma tarea con la misma entrada.
- Compara el costo efectivo por tarea: incluye la tasa de éxito y los reintentos, y usa el volumen mensual de tareas para elaborar el presupuesto.
Los precios cambian y siguen apareciendo modelos nuevos, pero este método de cálculo se puede reutilizar a largo plazo. Antes de elegir un modelo, conviene comparar 20 muestras reales y decidir después cuál poner en producción. Si necesitas cambiar rápidamente entre modelos de distintos proveedores para hacer pruebas, puedes acceder a todos desde APIYI, en apiyi.com, y consultar el consumo real de cada modelo directamente en los registros de invocación.
📚 Referencias
- Ofox.ai Blog, página 23: incluye resúmenes de artículos sobre el consumo de tokens de DeepSeek V4 Flash frente a Gemini 3.6 Flash, las diferencias de precio de la caché y estimaciones de costos de la serie Qwen.
- Enlace:
ofox.ai/blog/page/23/ -
Nota: los artículos se publicaron en agosto de 2026. Los datos proceden de mediciones individuales realizadas por terceros y solo sirven como referencia.
-
Ofox.ai Blog, página 22: incluye comparativas del recuento de tokens de un mismo documento en 9 modelos, diferencias de consumo entre versiones de Claude y precios de DeepSeek V4 Pro según la franja horaria.
- Enlace:
ofox.ai/blog/page/22/ -
Nota: útil para conocer casos concretos de diferencias entre tokenizadores y versiones.
-
Ofox.ai Blog, página 25: incluye una comparativa del costo por tarea de Kimi K3, GLM-5.2 y Opus 4.8.
- Enlace:
ofox.ai/blog/page/25/ - Nota: los precios y los resultados de las pruebas pueden cambiar. Consulta las páginas oficiales de precios de cada proveedor antes de usarlos.
Autor: Equipo técnico de APIYI
Contacto técnico: Puedes contactarnos desde la página principal de APIYI, apiyi.com. Encontrarás más recursos de integración en el centro de documentación docs.apiyi.com.