Nota del autor: cómo desglosar y cotejar los cargos de una API de Modelos de Lenguaje Grande, detectar cambios bruscos y afrontar variaciones de precio.
A finales de mes abres la factura y descubres que el costo de un modelo ha subido bastante respecto al mes anterior, aunque el número de invocaciones casi no ha cambiado. Es una situación habitual para los equipos que ya usan API de Modelos de Lenguaje Grande en producción. En este artículo veremos un método basado en desglosar los cargos y cotejarlos con los registros de invocación, para que puedas entender y comprobar tu factura.
Esto no es un resumen de precios. Las tarifas de los proveedores cambian con frecuencia, así que no incluiremos precios unitarios concretos. Nos centraremos en los criterios de facturación y en cómo verificarlos a largo plazo.
Una señal de lo que ocurre en el sector: en noviembre de 2026, una empresa de infraestructura de IA buscaba personal para operar su plataforma de Modelos de Lenguaje Grande. Entre las responsabilidades del puesto figuraba explícitamente la «verificación de costos y facturación»: comprobar los criterios de cobro de tokens de entrada, salida, caché y razonamiento, así como de imágenes, audio y video, y detectar a tiempo facturas anómalas, cambios de precio y discrepancias en los cargos. Si los proveedores de plataformas necesitan personal dedicado a esta tarea, es porque los propios criterios de facturación son complejos. Como cliente de la API, también te conviene tener tu propia rutina de conciliación.
La idea principal: al terminar de leer, sabrás de dónde procede cada tipo de cargo de una API de Modelos de Lenguaje Grande, cómo cotejar el uso con los registros de invocación y cómo identificar rápidamente por qué cambia de forma brusca el costo de una misma solicitud.
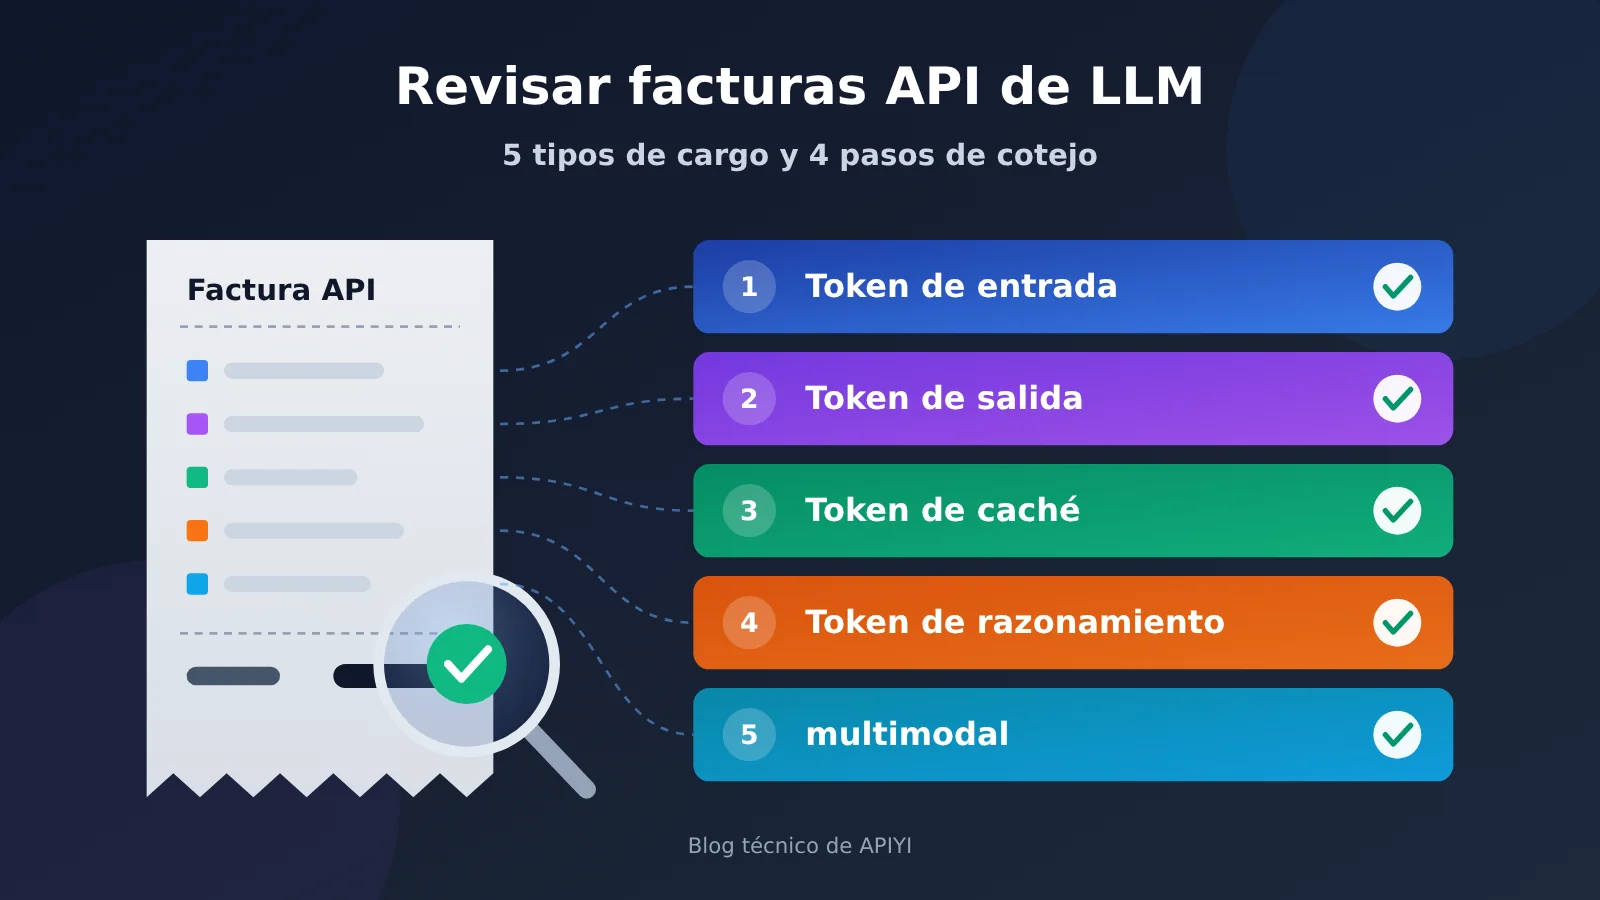
Claves de la factura de API de Modelos de Lenguaje Grande: 5 conceptos de cobro
El costo de una invocación del modelo no suele ser tan simple como «número de llamadas × precio unitario». Cada concepto tiene su propio precio y origen. Si los analizas en conjunto, es fácil interpretar mal la estructura de costos.
| Concepto de cobro | De dónde procede | Características habituales del precio | Qué revisar al conciliar la factura |
|---|---|---|---|
| Tokens de entrada | Indicaciones del sistema, historial de conversación, definiciones de herramientas, documentos recuperados, entrada del usuario | Se cobran por token y suelen ser más baratos que los de salida | Si el contexto está creciendo sin que te des cuenta |
| Tokens de salida | Respuesta visible generada por el modelo | Se cobran por token y su precio unitario suele ser mayor que el de entrada | Longitud de las respuestas y configuración de max_tokens |
| Tokens de caché | Prefijos de entrada encontrados en la caché | La parte recuperada suele tener descuento; algunos proveedores cobran aparte la escritura | Si está bajando la tasa de aciertos |
| Tokens de razonamiento | Proceso de razonamiento interno de los modelos de razonamiento | Suelen cobrarse como salida, aunque no necesariamente aparecen en la respuesta | Si está aumentando la longitud del razonamiento |
| Cobro multimodal | Entrada o generación de imágenes, audio y video | Por imagen, por segundo, por resolución o mediante conversión a tokens | Si han cambiado los parámetros de calidad o formato |
Por qué la factura de la API puede no cuadrar
La primera razón son los tokens invisibles. Puede que en tu código solo hayas escrito una pregunta del usuario, pero la solicitud enviada también puede incluir miles de tokens de indicaciones del sistema, varias rondas de conversación y esquemas de herramientas. Los modelos de razonamiento también generan numerosos tokens de razonamiento que el usuario no ve. Todo esto aparece en la factura, aunque no se muestre en la interfaz.
La segunda razón es que los criterios de cobro no son uniformes. Para una misma entrada de imagen, algunos proveedores cobran por imagen y otros la convierten en tokens según la resolución. Con la caché pasa algo parecido: algunos proveedores la gestionan automáticamente, otros requieren que se declare de forma explícita; algunos solo descuentan las lecturas y otros también cobran un extra por las escrituras. Antes de comparar modelos o proveedores, hay que unificar los criterios.
La tercera razón es que las variables pueden cambiar con el tiempo. Un alias de modelo puede pasar a apuntar a una versión nueva, un pequeño cambio en el prefijo de la indicación puede invalidar toda la caché y un modelo de razonamiento puede dedicar más tiempo a pensar ante una pregunta más difícil. Aunque el precio unitario no cambie, la factura sí puede hacerlo.
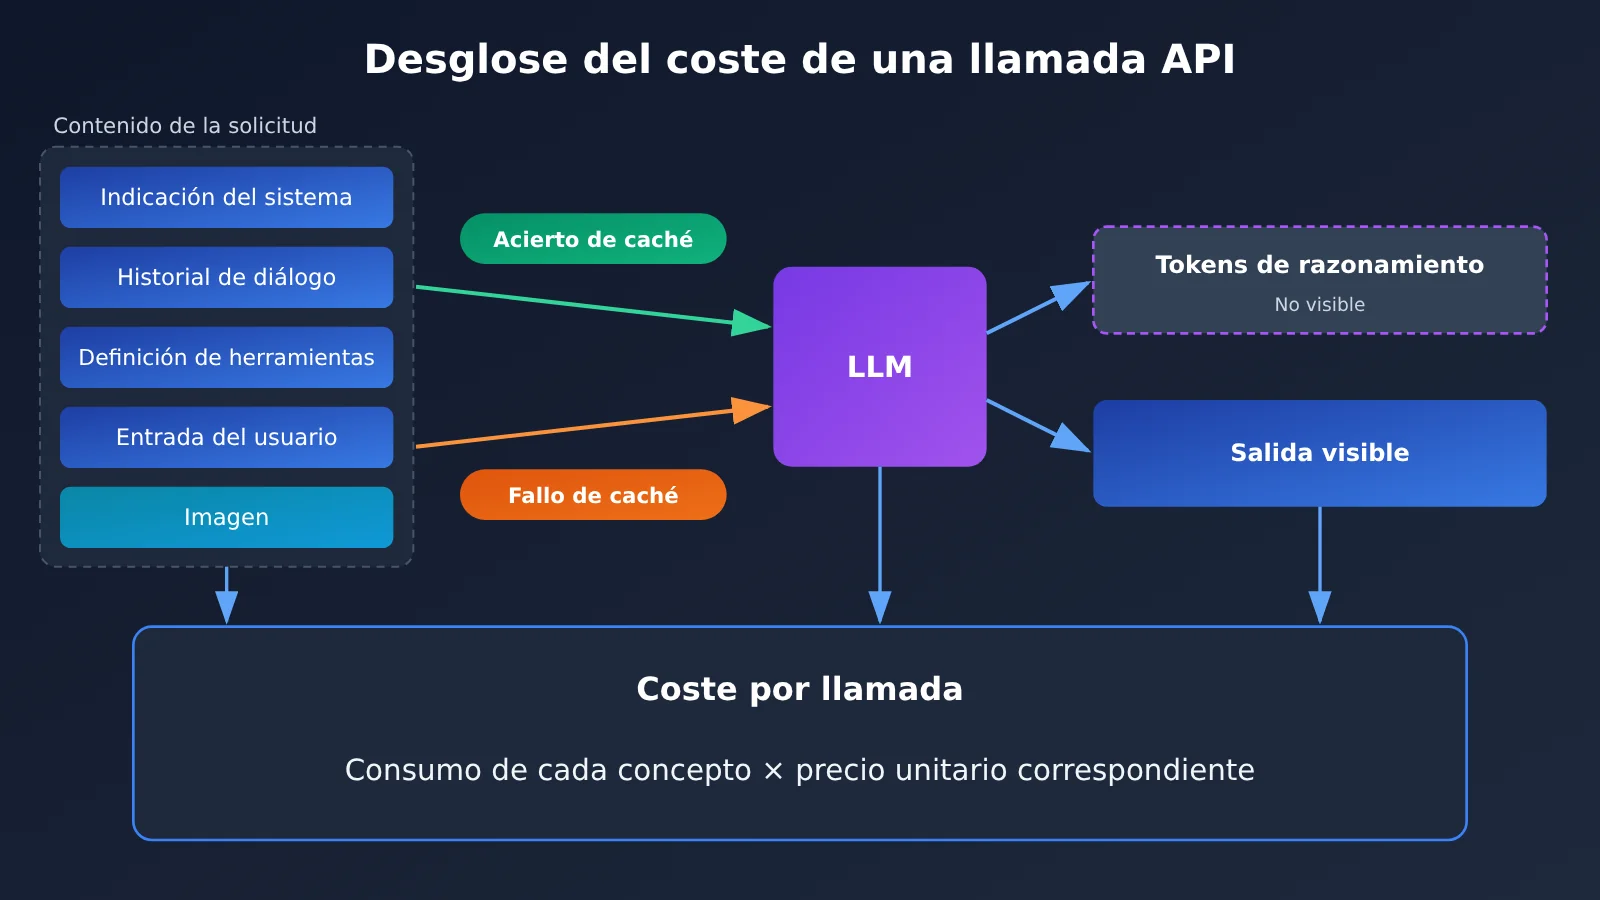
Desglose de los cargos en la factura de una API de Modelos de Lenguaje Grande
Tokens de entrada: el costo que más se suele subestimar
Los tokens de entrada incluyen todo lo que el modelo «lee» en una solicitud, no solo el mensaje del usuario. En una conversación de varias rondas, el historial anterior se vuelve a enviar en cada ronda. Cuanto más larga sea la conversación, mayor será el costo de entrada por ronda; el costo total crece aproximadamente con el cuadrado del número de rondas.
Las aplicaciones RAG también consumen muchos tokens de entrada. Tanto el número de fragmentos de documentos recuperados como la longitud de cada uno determinan directamente el costo. En los escenarios de Function Calling, el JSON Schema que define las herramientas cuenta como entrada en cada solicitud: cuantas más herramientas haya, mayor será el costo fijo.
Ten en cuenta que cada modelo usa su propio tokenizador. Un mismo texto en chino puede producir cantidades de tokens muy distintas según el modelo, así que no conviene usar el recuento de uno para estimar el costo de otro.
Tokens de salida: precio más alto y control directo mediante parámetros
Los tokens de salida corresponden a la respuesta generada por el modelo. La mayoría de los proveedores cobran un precio considerablemente mayor por los tokens de salida que por los de entrada, así que pedirle al modelo que vaya al grano suele ahorrar más que reducir la entrada.
max_tokens establece un límite para el costo de salida, pero no garantiza que se alcance. Si la respuesta se trunca, la parte ya generada se sigue cobrando. Si una respuesta en streaming se interrumpe, el tratamiento de los tokens generados también puede variar entre plataformas; conviene consultar la documentación oficial.
Tokens de caché: solo ahorran cuando hay coincidencia
La caché de indicaciones funciona así: cuando varias solicitudes comparten el mismo prefijo —por ejemplo, la misma indicación de sistema o el mismo documento largo—, el proveedor puede reutilizar la parte ya procesada y aplicar un descuento a esa entrada.
Hay varias reglas habituales de la caché que conviene comprobar:
- Activación automática: algunos proveedores la activan por defecto; otros requieren marcar explícitamente en la solicitud dónde se usa la caché.
- Requisitos de coincidencia del prefijo: normalmente debe coincidir palabra por palabra desde el principio; cualquier cambio en el prefijo invalida todo lo que sigue.
- Longitud mínima y vigencia: es posible que los prefijos demasiado cortos no se almacenen en caché y, cuando esta caduca, hay que volver a escribirlos.
- Costo de escritura: algunos proveedores cobran la primera escritura en caché a un precio superior al de la entrada normal; solo las lecturas posteriores son más baratas.
Al conciliar los cargos, conviene contabilizar por separado los «tokens de lectura de caché» y los «tokens de entrada normal». De lo contrario, una caída en la tasa de aciertos podría confundirse con un aumento en el volumen de invocaciones.
Tokens de razonamiento: no se ven, pero se pagan
Los modelos de razonamiento realizan un proceso interno antes de dar una respuesta, y esos tokens suelen cobrarse al precio de salida. En muchos casos, el razonamiento no se devuelve completo: solo puedes ver la cantidad de tokens en los campos de uso.
La cantidad de tokens de razonamiento varía según la dificultad del problema y el parámetro de intensidad de razonamiento. En una misma interfaz, si las preguntas de los usuarios se vuelven más complejas, la factura puede subir. Si tu aplicación solo necesita hacer clasificaciones sencillas o convertir formatos, usar un modelo de razonamiento suele significar pagar por un razonamiento innecesario.
Facturación multimodal: confirma primero «por qué se cobra»
La facturación multimodal es la que presenta mayores diferencias, por lo que conviene consultar la página oficial de precios de cada modelo. La siguiente tabla muestra las formas de cobro más comunes; las reglas concretas dependen de lo que publique cada proveedor.
| Tipo | Forma de cobro habitual | Parámetros clave que afectan al costo | Recomendación para la revisión |
|---|---|---|---|
| Entrada de imágenes (comprensión) | Conversión a tokens según la resolución o cobro por imagen | Dimensiones de la imagen, parámetro de nivel de detalle | Registra la resolución real antes y después de la carga |
| Generación de imágenes | Cobro por imagen o por tokens de salida | Tamaño, nivel de calidad, cantidad de imágenes generadas | Registra los parámetros de cada solicitud |
| Entrada/salida de audio | Cobro por duración o conversión a tokens de audio | Duración del audio, método de procesamiento de muestras | Registra la duración real del audio |
| Síntesis de voz | Cobro por número de caracteres o por tokens | Longitud del texto, categoría de voz | Registra la longitud del texto sintetizado |
| Generación/comprensión de video | Cobro por segundo, por fotograma o por nivel de resolución | Duración, resolución, tasa de fotogramas | Registra la combinación de duración y resolución |
| Embeddings | Cobro por tokens de entrada | Longitud del texto, tamaño del lote | Lleva un registro separado del precio habitual de entrada |
🎯 Consejo técnico: En escenarios multimodales, conviene usar un único punto de entrada para gestionar de forma centralizada las distintas formas de facturación. La descripción oficial de APIYI apiyi.com indica que los modelos de la plataforma usan un saldo común y que esta ofrece estadísticas de uso y registros de invocación. Puedes revisar primero qué campos aparecen en los registros de la consola y después decidir qué parámetros debes añadir a tu tabla de conciliación.
Guía rápida para conciliar facturas de API de Modelos de Lenguaje Grande en 4 pasos
La idea central es sencilla: multiplica el uso que has registrado por los precios que guardaste para calcular el costo esperado y compáralo con la factura de la plataforma. Si la diferencia supera el margen de tolerancia, revisa cada partida.
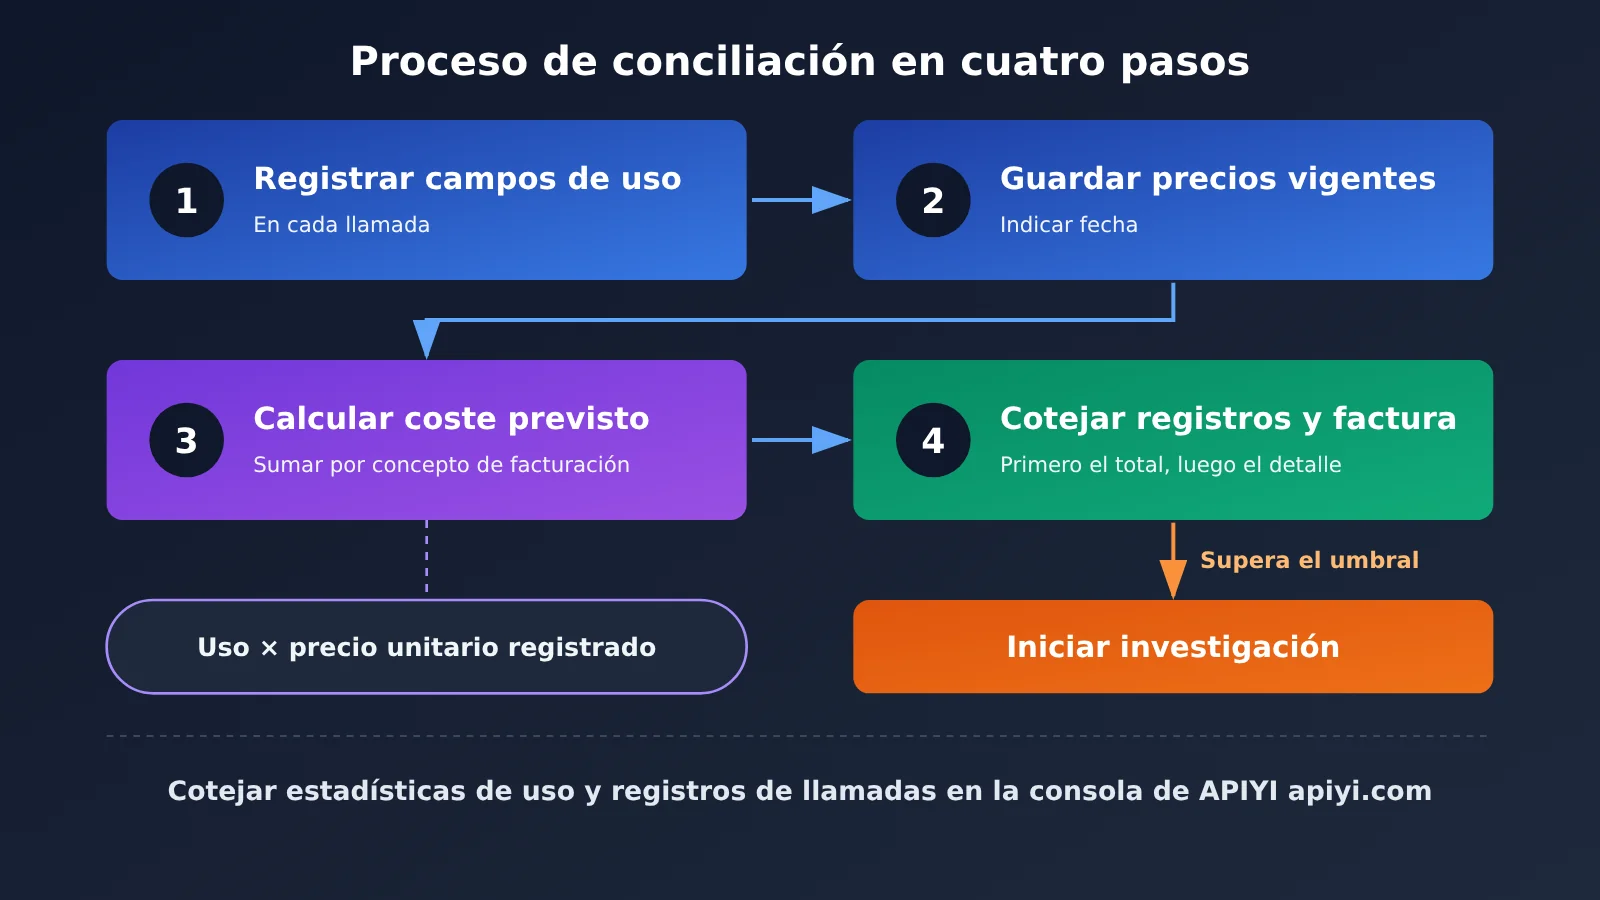
Paso 1: Registra los campos de uso después de cada invocación
Las interfaces compatibles con el formato de OpenAI suelen devolver un objeto usage en la respuesta. Estos son los campos más habituales y su significado. La respuesta puede variar según el modelo y la plataforma, así que conviene hacer una solicitud de prueba antes de integrar la API.
| Campo (nombres habituales en el formato compatible con OpenAI) | Significado | Concepto de facturación |
|---|---|---|
prompt_tokens |
Número total de tokens de entrada de la solicitud | Entrada (incluye la parte en caché) |
prompt_tokens_details.cached_tokens |
Parte de la entrada encontrada en caché | Lectura de caché |
completion_tokens |
Número total de tokens de salida | Salida (puede incluir razonamiento) |
completion_tokens_details.reasoning_tokens |
Parte de la salida correspondiente al razonamiento | Razonamiento |
model |
Nombre del modelo que generó la respuesta | Identificación de cambios de versión |
Se recomienda guardar en la base de datos, como mínimo, la siguiente información de cada invocación:
- Hora de la solicitud, ID de la solicitud e identificador del caso de uso;
- Nombre del modelo especificado en la solicitud y
modeldevuelto en la respuesta; - Todos los campos de uso de la tabla anterior; registra los campos ausentes como vacíos, no como 0;
- Parámetros de las solicitudes multimodales, como tamaño de imagen, duración del audio y cantidad de elementos generados;
- Si se usó streaming, si hubo reintentos y si la respuesta se truncó (
finish_reason).
Ten en cuenta que prompt_tokens y completion_tokens suelen ser totales; la caché y el razonamiento son partes de esos totales. Al calcular el costo, primero resta esas partes del total y después multiplica cada una por su precio correspondiente. De lo contrario, podrías contabilizar cargos dos veces o no aplicar algún descuento.
Paso 2: Mantén un registro de precios con fechas
No fijes los precios unitarios directamente en el código. Es recomendable mantener una tabla en la que cada fila incluya el nombre del modelo, el concepto de facturación, el precio unitario, la moneda, la fecha de entrada en vigor y la fuente (la página oficial de precios o un anuncio de la plataforma).
Cuando cambie un precio, añade una fila en lugar de sobrescribir el valor anterior. Así podrás recalcular la factura de cualquier día con los precios vigentes en ese momento. Si haces invocaciones a través de una plataforma agregadora como APIYI, usa el precio unitario que la plataforma publique en ese momento e indica también la fecha de consulta.
Paso 3: Calcula el costo esperado
El costo esperado de cada invocación se puede desglosar en varias partidas:
- Tokens de entrada no encontrados en la caché × precio unitario de entrada;
- Tokens de lectura de caché × precio unitario de lectura de caché (si también se cobra por escritura en caché, añade esa partida);
- Tokens de salida visibles × precio unitario de salida;
- Tokens de razonamiento × precio unitario correspondiente (en la mayoría de los casos es el mismo que el de salida; consulta la documentación oficial);
- La parte multimodal se calcula por separado, según los criterios de facturación de cada modalidad.
Al agrupar los resultados por día, modelo y caso de uso, tendrás un registro de cuánto esperas gastar.
Paso 4: Compara tus registros con los logs y la facturación de la plataforma
Compara tu registro de gastos con las estadísticas de uso y los logs de llamadas de la plataforma. Empieza por el importe total, sigue con los importes por modelo y, por último, revisa las solicitudes concretas.
Conviene establecer un umbral de tolerancia. Es normal encontrar pequeñas diferencias debido al tipo de cambio, la precisión de la facturación o la zona horaria de las estadísticas. Solo tendrás que investigar las que superen ese umbral.
🚀 Inicio rápido: Si ya invocas modelos en APIYI apiyi.com, puedes exportar los logs de llamadas de un período y compararlos, uno por uno, con los campos
usageque hayas registrado. Comprueba si los campos que ofrece actualmente la plataforma distinguen los tokens de caché y de razonamiento; si no aparecen por separado, usa como detalle los campos de respuesta que hayas guardado localmente.
Señales de anomalías en la facturación de API de Modelos de Lenguaje Grande: cómo investigar cambios bruscos de costos
Un cambio repentino en el costo de un mismo tipo de solicitud es una señal que merece especial atención. La siguiente tabla recoge causas habituales y formas de investigarlas.
| Anomalía | Posible causa | Cómo investigarla |
|---|---|---|
| Sube el costo por llamada, pero el volumen no cambia | El alias del modelo apunta a una nueva versión con un precio unitario o consumo de tokens diferente | Compara los valores anteriores y actuales del campo model en las respuestas |
| Sube el costo de entrada, pero el total de tokens de entrada no cambia | Baja la tasa de aciertos de caché | Revisa la proporción de cached_tokens y comprueba si se modificó el prefijo de la indicación |
| Sube el costo de salida, pero la longitud de la respuesta visible no cambia | Aumentan los tokens de razonamiento | Revisa la tendencia de reasoning_tokens y comprueba los parámetros de intensidad de razonamiento |
| Los tokens de entrada aumentan lentamente de forma continua | No se trunca el historial de conversación, aumentan los fragmentos recuperados o se añaden definiciones de herramientas | Revisa una muestra de los cuerpos completos de las solicitudes |
| Hay más llamadas que operaciones del negocio | El cliente reintenta o reenvía las solicitudes tras un tiempo de espera agotado | Elimina los duplicados por ID de solicitud e ID de operación antes de contabilizarlas |
| El costo de imágenes o videos se dispara | Se aumentó la resolución, el nivel de calidad o la cantidad generada | Compara los parámetros de especificación de las solicitudes |
| El precio unitario de la factura no coincide con la instantánea de precios | El proveedor oficial o la plataforma cambió sus precios | Consulta la página de precios y los anuncios, y actualiza la instantánea de precios |
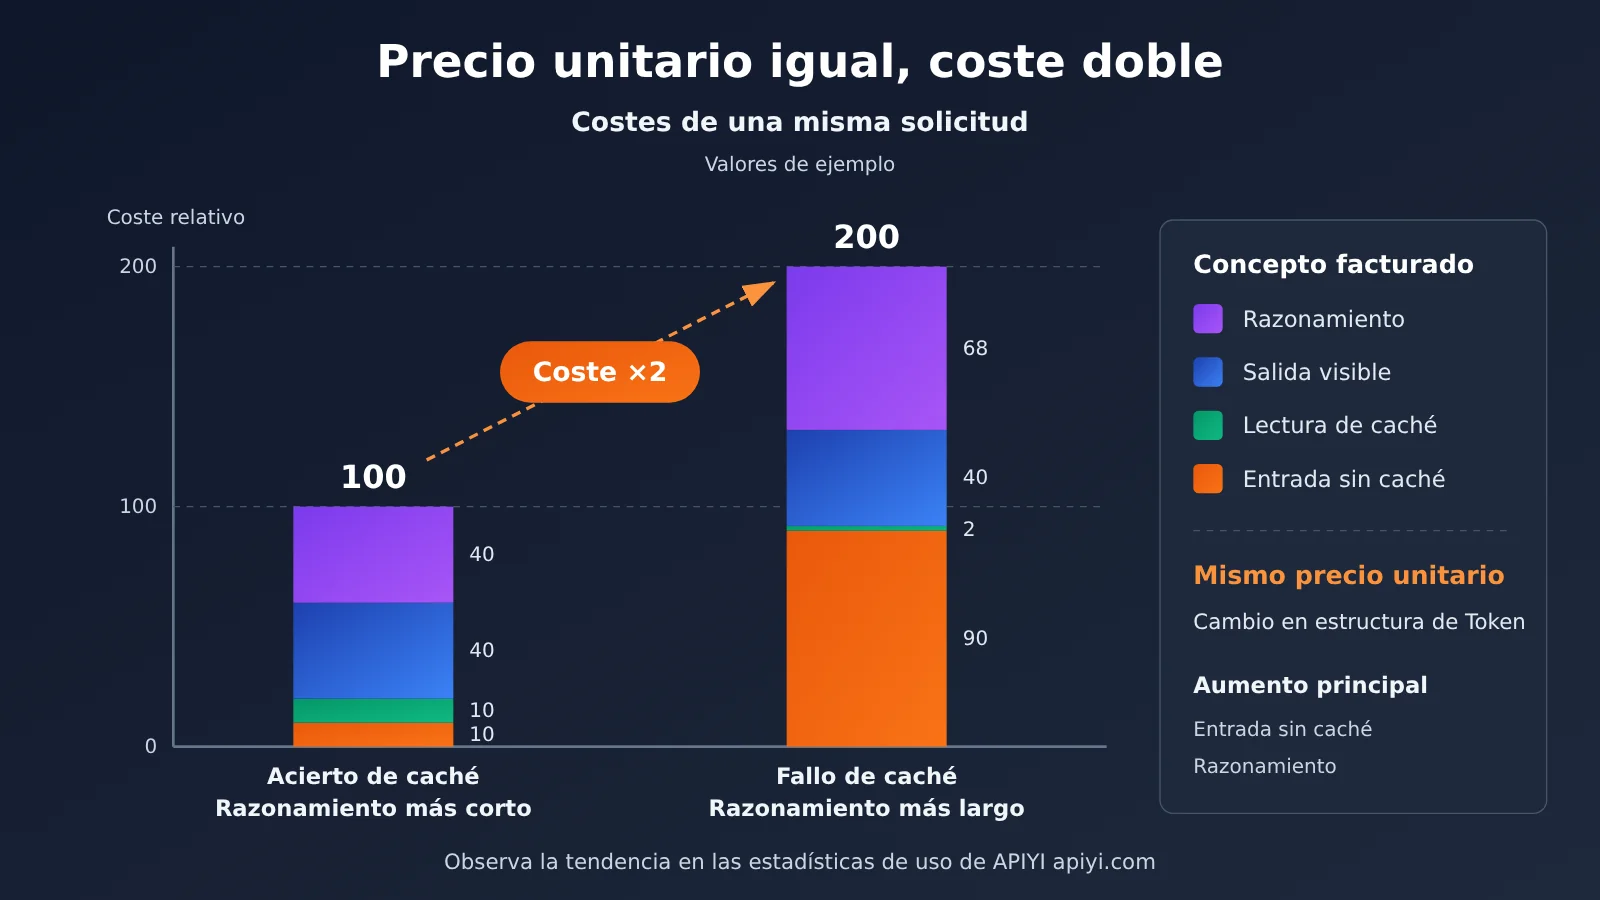
Fallo de caché: el aumento de costos más difícil de detectar
Un fallo de caché suele deberse a un cambio que «parece inofensivo». Por ejemplo, añadir la fecha actual al principio de la indicación del sistema o insertar el ID de usuario en el prefijo. En ambos casos, el prefijo cambia en cada solicitud, la caché deja de funcionar y el costo de entrada vuelve directamente a la tarifa normal.
La forma correcta de organizarlo es poner el contenido fijo al principio y el contenido variable al final. Después de modificar la plantilla de una indicación, revisa al día siguiente si cambió la tasa de aciertos de caché.
Variaciones en la longitud del razonamiento: la dificultad también afecta a la factura
El costo de los modelos de razonamiento depende de la dificultad de las preguntas. Si un día los usuarios plantean de repente muchas preguntas complejas, los tokens de razonamiento aumentarán de forma notable: es una fluctuación normal. Pero si siguen creciendo sin que cambie el tipo de solicitud, conviene comprobar si se modificó la versión del modelo o los parámetros de razonamiento.
Hábitos para detectar cambios de precio en la factura de API de Modelos de Lenguaje Grande
No puedes controlar los cambios de precio, pero sí la rapidez con la que los detectas. Estos hábitos son fáciles de mantener a largo plazo:
- Cada semana: revisa la tendencia de gastos por modelo y el costo promedio por solicitud; presta atención a los cambios bruscos.
- Cada mes: concilia la factura completa e investiga cada diferencia que supere el umbral establecido.
- Después de modificar una plantilla de indicaciones: observa durante 1-2 días la proporción de solicitudes que usan la caché.
- Antes de cambiar o actualizar un modelo: compara el consumo de tokens y el costo de los modelos anterior y nuevo con un volumen reducido de tráfico.
- Presta atención a los anuncios: suscríbete a las actualizaciones de precios y modelos de los proveedores o plataformas que utilizas. Cuando recibas un aviso, actualiza de inmediato tu registro de precios.
- Fija la versión: en producción, procura usar nombres de modelo con un número de versión específico para evitar sorpresas por actualizaciones automáticas de alias.
💡 Consejo: Si tu servicio utiliza modelos de varios proveedores, conciliar los gastos repartidos entre varias cuentas puede llevar mucho tiempo. Con acceso unificado a través de APIYI apiyi.com, puedes consultar el uso de distintos modelos con un mismo saldo y un mismo registro, lo que facilita comparar el costo por solicitud. Conviene comprobar primero en la consola qué nivel de detalle está disponible.
Preguntas frecuentes (FAQ)
P1: ¿Qué es un token en la factura de una API de Modelos de Lenguaje Grande?
Un token es la unidad básica con la que un modelo procesa texto: puede entenderse como un fragmento resultante de dividir el texto. Un carácter chino puede corresponder a uno o varios tokens, según el tokenizador del modelo. Las facturas suelen cobrar por separado los tokens de entrada, salida, caché y razonamiento, entre otras categorías.
P2: ¿Qué diferencia hay entre los tokens de caché y los tokens de entrada normales?
Ambos son tokens de entrada, pero los tokens de caché corresponden a la parte del prefijo que coincide con contenido ya almacenado en caché y suelen tener descuento. Los tokens de entrada normales se cobran a la tarifa completa. Algunos proveedores también cobran por separado la escritura inicial en caché, por lo que conviene contabilizar las tres categorías por separado al conciliar la factura.
P3: ¿Por qué no se ven los tokens de razonamiento en la respuesta?
Los tokens de razonamiento se generan durante el proceso interno de razonamiento del modelo. Muchos modelos no devuelven ese proceso completo a quien hace la solicitud, sino que solo indican la cantidad en el campo de uso. Suelen cobrarse a la tarifa de salida, por lo que el costo puede ser considerable incluso si la respuesta es breve.
P4: ¿Por qué puede cambiar de repente el costo de una misma solicitud?
Hay tres causas habituales: el alias del modelo apunta a una nueva versión, un cambio en el prefijo de la indicación impide aprovechar la caché o aumenta la longitud del razonamiento. También puede deberse a cargos duplicados por reintentos o a un aumento de los parámetros de especificación multimodal. Revisar uno por uno los puntos de la tabla de señales de anomalía de este artículo te ayudará a encontrar la causa.
P5: ¿Cómo puedo usar los registros de la plataforma para revisar mi factura de la API de un Modelo de Lenguaje Grande?
Primero, registra en tu sistema el campo `usage` y el ID de solicitud de cada respuesta. Después, exporta los registros de invocación de la plataforma y compáralos solicitud por solicitud. Por ejemplo, en APIYI apiyi.com puedes consultar las estadísticas de uso y los registros de invocación desde la consola. Primero confirma qué campos incluyen los registros y luego combínalos con tus datos locales para conciliar la factura.
P6: ¿Cómo se estima el costo de un modelo multimodal?
Primero, consulta la página oficial de precios para confirmar cómo se cobra: por imagen, por segundo o mediante una conversión de la resolución a tokens. Después, registra en los logs de solicitud los parámetros correspondientes, como el tamaño de la imagen, la duración del audio y la resolución y duración del video. Usa esos parámetros y la tarifa aplicable para calcular una estimación.
P7: Si encuentro diferencias al conciliar la factura, ¿qué reviso primero?
Primero, confirma que la referencia de precios esté actualizada para descartar cambios de tarifa. Después, compara el número de invocaciones para descartar reintentos y solicitudes duplicadas. Por último, desglosa las diferencias por modelo y concepto de facturación para identificar si provienen de la entrada, la caché, el razonamiento o la parte multimodal.
P8: ¿Qué limitaciones tiene este método de conciliación?
Depende de los campos de uso que devuelve la respuesta. Si algunos modelos o interfaces no proporcionan el desglose de caché y razonamiento, tendrás que recurrir a la factura de la plataforma. Además, el tipo de cambio, la precisión de la facturación y la zona horaria utilizada para las estadísticas pueden causar pequeñas diferencias. Conviene establecer un umbral razonable en lugar de buscar una coincidencia exacta hasta el último céntimo.
Puntos clave de la facturación de API de Modelos de Lenguaje Grande
- El costo se compone de varios cargos: entrada, salida, caché, razonamiento y modalidades multimodales tienen precios distintos y deben contabilizarse por separado.
- Los tokens de entrada incluyen mucho más que la pregunta del usuario: también cuentan las indicaciones del sistema, el historial, los documentos recuperados y las definiciones de herramientas.
- Los aciertos de caché dependen de que el prefijo coincida: coloca el contenido fijo al principio y las variables al final; después de cambiar una plantilla, revisa la tasa de aciertos.
- Los tokens de razonamiento no se ven, pero se cobran: evita usar modelos de razonamiento para tareas sencillas y observa la evolución de la longitud del razonamiento.
- En multimodal, pregunta primero «¿en qué unidad se cobra?»: puede ser por imagen, por segundo o según la resolución; consulta la página oficial de precios.
- La conciliación tiene cuatro pasos: registra el uso, mantén un historial de precios, calcula el costo esperado y compáralo con los registros y las facturas.
- Un punto de acceso unificado facilita la conciliación: puedes usar el saldo unificado y los registros de invocación de APIYI apiyi.com para revisar de forma centralizada el uso de varios modelos.
Resumen
Para entender y comprobar una factura de API de Modelos de Lenguaje Grande, hay tres claves:
- Desglosa los cargos: divide el costo de cada invocación en entrada, caché, salida, razonamiento y modalidades multimodales, e identifica el origen de cada uno;
- Lleva tus propios registros: guarda en una base de datos los campos de uso y los parámetros de cada invocación, y mantén un historial de precios con fechas;
- Compara periódicamente: revisa las tendencias cada semana y concilia el total cada mes. Si el costo cambia de forma repentina, comprueba la versión del modelo, los aciertos de caché, la longitud del razonamiento, los reintentos y los parámetros.
Los operadores de las plataformas verifican estos criterios de facturación, pero también conviene que, como usuario, desarrolles tus propios hábitos de conciliación. Si tu negocio necesita invocar modelos de varios proveedores, puedes usar APIYI apiyi.com como punto de acceso unificado para consultar el uso y los registros de invocación desde una sola consola y, después, comprobarlos con el método de este artículo.
📚 Referencias
- Oferta de empleo en V2EX: puesto de operaciones de plataforma de Modelos de Lenguaje Grande en una empresa de infraestructura para agentes de IA: entre las responsabilidades figura la «verificación de costos y facturación»
- Enlace:
v2ex.com/t/1254263 -
Descripción: publicada el 2026-11-03, explica que el equipo de la plataforma debe verificar los criterios de facturación de tokens de entrada y salida, tokens de caché, tokens de razonamiento, imágenes, audio y video, además de detectar facturas anómalas, cambios de precios y discrepancias en la facturación
-
Páginas oficiales de precios de los proveedores de modelos: la única fuente autorizada para consultar tarifas específicas y reglas de facturación
- Enlace: consulta la sección de precios o documentación del sitio oficial del proveedor que utilices
- Descripción: los precios cambian con frecuencia; asegúrate de registrar la fecha de consulta al citarlos
Autor: equipo técnico de APIYI
Contacto técnico: si tienes dudas sobre cómo verificar la facturación de las API de Modelos de Lenguaje Grande, contáctanos a través de la página principal de APIYI apiyi.com. Encontrarás más recursos de integración en el centro de documentación docs.apiyi.com