Nota del autor: guía para desarrolladores que necesitan diagnosticar errores de invocación de API de modelos en producción. Con códigos de error, registros y una reproducción mínima con curl, ayuda a identificar si el fallo está en la llamada propia, la plataforma de pasarela o el modelo proveedor, y qué información incluir al reportarlo.
Una alerta de madrugada indica que está aumentando la tasa de errores de la API de un modelo. En estos casos, lo que más tiempo consume no suele ser la reparación, sino saber a quién acudir: ¿se rompió algo en tu código, falló la plataforma de pasarela o está teniendo problemas el servicio del modelo proveedor? En este artículo veremos un método de atribución en tres capas: “llamada propia → plataforma de pasarela → modelo proveedor”, para acotar rápidamente dónde buscar cuando falla una invocación de la API de un modelo.
Esto no es una simple tabla de códigos de error. Este enfoque de tres capas también es habitual entre quienes operan plataformas de agregación de modelos: reproducen el problema a partir de los parámetros de la solicitud, los registros, los códigos de error y la cadena de llamadas, y después determinan si el origen está en la llamada del usuario, las capacidades de la plataforma o el servicio del modelo proveedor. Aquí convertimos ese enfoque en una secuencia de diagnóstico que puedes aplicar directamente. Tanto si te conectas al proveedor como si usas una pasarela de agregación como APIYI, puedes seguir el mismo orden.
Qué aprenderás: una secuencia de diagnóstico de 6 pasos, señales para identificar las categorías de errores más comunes, cómo crear una reproducción mínima con curl y una lista de información que puedes completar directamente al reportar el problema.
Claves para atribuir errores de API del modelo a una de tres capas
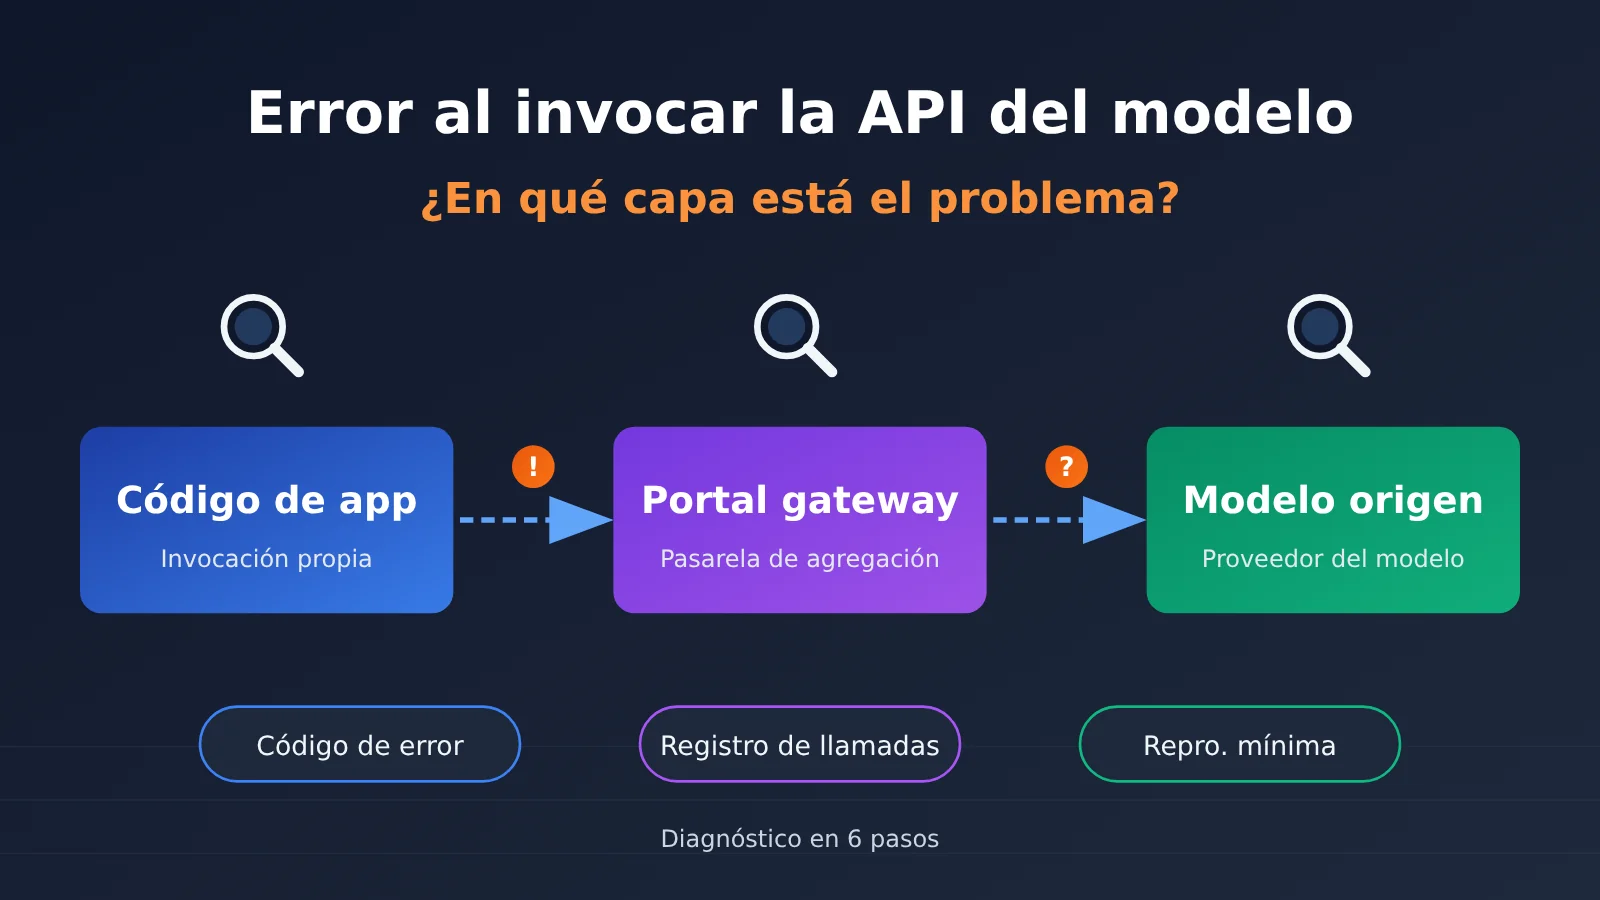
Una llamada a la API de un modelo pasa por al menos tres capas: tu aplicación y su entorno de red, la pasarela o plataforma de agregación intermedia y el servicio del modelo que proporciona la inferencia. Incluso con una conexión directa al proveedor, la capa intermedia existe, aunque sea mínima: incluye el balanceo de carga y la capa de acceso. El objetivo del diagnóstico es identificar con precisión en cuál de ellas está la falla.
| Capa | Problemas típicos | Señales frecuentes | Responsable |
|---|---|---|---|
| Tu propia llamada | Clave incorrecta, parámetros no válidos, límite de contexto superado, tiempo de espera local demasiado corto, problemas de proxy o DNS | El error 4xx se reproduce de forma constante; funciona en otro entorno; solo afecta a ciertas rutas del código | Tú |
| Plataforma de pasarela | Errores de autenticación o facturación, asignación incorrecta de parámetros, problemas de enrutamiento o de respaldo, limitación de solicitudes de la plataforma, conexión interrumpida | La conexión directa funciona, pero falla a través de la pasarela; el formato del error no coincide con el del proveedor; varios modelos presentan problemas a la vez | La plataforma |
| Modelo del proveedor | Sobrecarga del servicio, cambios de versión del modelo, variación de capacidades, limitación de solicitudes del proveedor | Fallan varios canales de acceso a la vez; hay un aviso en la página de estado del proveedor; solo afecta a un modelo | El proveedor del modelo (normalmente a través de la plataforma) |
Por qué conviene identificar primero la capa responsable
Cuando falla una llamada a la API de un modelo, muchos equipos reaccionan aumentando los reintentos o cambiando directamente de modelo. A veces eso resuelve el problema de forma temporal, pero, si no se encuentra la causa, puede volver a aparecer unos días después. También puede ocultar un error de configuración. Identificar primero el origen evita perder tiempo en la dirección equivocada.
Este análisis también ayuda a decidir a quién acudir. Si el problema está en tu propia llamada, puedes resolverlo cambiando el código; si está en la plataforma de pasarela, tendrás que contactar con ella y proporcionar el ID de la solicitud; si está en el modelo del proveedor, por lo general solo queda esperar a que se restablezca el servicio, cambiar de modelo o activar una alternativa de respaldo. Las soluciones son muy distintas y, si identificas mal el origen, la reparación tardará más.
Seis pasos para diagnosticar errores al invocar un modelo mediante API
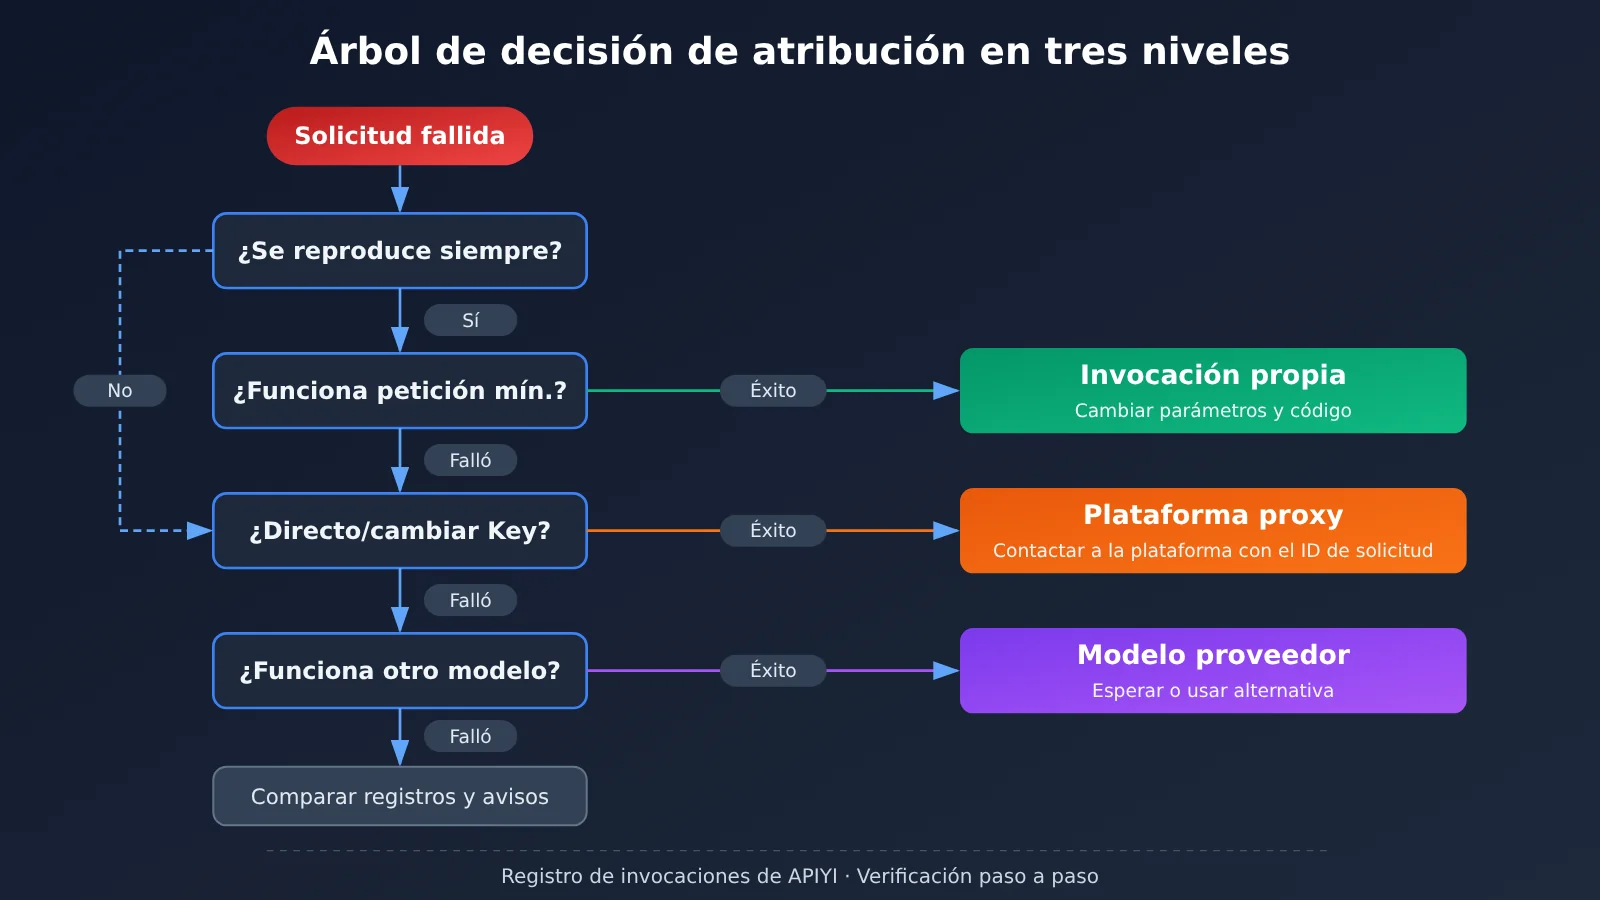
Este orden sigue dos principios: empezar por las comprobaciones más sencillas y aislar el problema antes de profundizar. Cada paso busca descartar una posibilidad, en lugar de sospechar de todos los componentes a la vez.
- Confirma el alcance: comprueba si fallan todas las solicitudes o solo algunas, si afecta a uno o varios modelos y cuándo empezó. Cuanto más amplio sea el impacto, más probable es que el problema esté en la plataforma o en el proveedor. Si solo afecta a una función, lo más probable es que esté en tu código.
- Registra el error original: guarda el código de estado HTTP, el cuerpo de la respuesta sin modificar, el ID de solicitud de las cabeceras (si existe), la hora y el tiempo transcurrido. No te quedes solo con la excepción procesada por el SDK: muchos detalles importantes pueden perderse en ese proceso.
- Reproduce el problema con una solicitud mínima: fuera del código de tu aplicación, envía con curl la solicitud más simple posible, por ejemplo, un texto corto, sin streaming ni llamadas a herramientas. Si funciona, es probable que el problema esté en la combinación de parámetros o en la lógica de tu aplicación.
- Añade los parámetros de forma gradual: parte de la solicitud mínima y añade uno a uno la indicación de sistema, el contexto largo y parámetros como
stream,toolsyresponse_format, hasta encontrar el que provoca el fallo. - Haz pruebas comparativas: prueba otro modelo a través de la misma pasarela o, si tu entorno de red lo permite, conéctate directamente al proveedor. Si funciona al cambiar de modelo, suele apuntar al proveedor; si funciona con la conexión directa, suele apuntar a la pasarela.
- Consulta los registros y avisos: revisa los registros de invocación de la plataforma y la página de estado del proveedor para confirmar si la solicitud llegó a la plataforma, si esta la reenvió y qué respondió el proveedor.
Errores habituales de la API de modelos y señales para identificarlos
Los códigos de error son la pista más directa para diagnosticar un problema, pero no todas las plataformas los asignan de la misma manera. La siguiente tabla se basa en la semántica general de HTTP; consulta la documentación de tu plataforma para conocer el significado concreto de cada código.
| Categoría de error | Manifestación típica | Señales para identificarlo | Origen más probable |
|---|---|---|---|
| Fallo de autenticación | 401 / 403 | Se resuelve al cambiar la clave; la clave tiene espacios de más o se usa en el entorno equivocado | Principalmente la propia llamada; en ocasiones, el estado de la cuenta en la plataforma |
| Error de parámetros | 400 / 422 | Una solicitud mínima funciona, pero falla al volver a añadir un parámetro; el mensaje de error indica el nombre del campo | La propia llamada o un error de mapeo de parámetros de la plataforma |
| El modelo no existe | 404 o aviso de modelo no válido | El nombre del modelo está mal escrito, o el modelo se ha retirado o renombrado | La propia llamada o un cambio en la versión del modelo |
| Límite de solicitudes / cuota | 429 | Se resuelve al reducir la concurrencia; las cabeceras de respuesta incluyen un tiempo de espera para reintentar | Depende del origen del límite: puede estar en la plataforma o en el proveedor del modelo |
| Error del servidor | 500 / 502 / 503 | La misma solicitud funciona de forma intermitente; varios usuarios informan del problema a la vez | La plataforma de la pasarela o el proveedor del modelo |
| Tiempo de espera agotado | 504 o tiempo de espera agotado en el cliente | Es más frecuente en solicitudes con respuestas largas; desaparece al usar streaming | La configuración local del tiempo de espera, la pasarela o una inferencia demasiado lenta del proveedor |
| Interrupción del streaming | La conexión SSE se corta antes de recibir el marcador de finalización | Las solicitudes sin streaming funcionan; solo ocurre con respuestas largas | Un proxy intermedio, la política de mantenimiento de conexiones de la pasarela o el proveedor |
Casos especiales: interrupciones de streaming, cambios de versión y degradación automática
Las interrupciones de streaming son de los problemas más difíciles de diagnosticar. El cliente solo ve que la conexión se ha cerrado y el código de estado HTTP puede seguir siendo 200. Para investigarlas, comprueba primero si tu proxy, balanceador de carga o Nginx tiene configurado un tiempo de espera por inactividad demasiado corto para conexiones de larga duración. Después, usa curl con el parámetro -N para observar directamente la salida SSE en bruto y verificar si se recibió el marcador de fin.
Los cambios de versión no siempre generan errores, pero pueden alterar la salida: por ejemplo, el formato JSON puede dejar de ser estable o pueden faltar parámetros en las llamadas a herramientas. Si el nombre del modelo apunta a un alias que se actualiza continuamente, su comportamiento puede cambiar sin aviso cuando el proveedor actualice el modelo. En producción, conviene fijar nombres de modelo que incluyan una fecha o un número de versión y realizar pruebas de regresión periódicas.
La degradación automática y el enrutamiento dinámico pueden hacer que los resultados del diagnóstico varíen de una vez a otra. Algunas puertas de enlace cambian automáticamente a un canal o modelo de respaldo cuando falla el proveedor. Esto mejora la disponibilidad, pero también puede provocar que «la misma solicitud funcione una vez y falle la siguiente» o que «el estilo de la salida cambie de repente». Al investigarlo, comprueba si el campo model de la respuesta coincide con el de la solicitud. Si los registros de la plataforma indican el canal o modelo que se usó realmente, revísalos también. Que el cliente pueda detectar la degradación depende de cómo la implemente la plataforma; lo mejor es confirmarlo de antemano.
Primeros pasos ante errores al invocar la API de un modelo: reproducción mínima con curl
El objetivo de una reproducción mínima es descartar interferencias del código de la aplicación. curl no depende de ningún SDK y muestra la interacción HTTP en bruto, por lo que resulta ideal como «evidencia». En los ejemplos se usa una interfaz compatible con OpenAI; sustituye la dirección por la base_url que indique la documentación de tu plataforma.
5 trucos de curl para una reproducción mínima
- Ver solo el código de estado y el tiempo transcurrido: usa
-sS -o /dev/null -w "%{http_code} %{time_total}"para comprobar en segundos si la solicitud llegó y cuánto tardó. - Ver la solicitud completa y las cabeceras de respuesta: usa el parámetro
-vpara inspeccionar el handshake TLS, las cabeceras de solicitud y las de respuesta. Muchas plataformas incluyen el ID de solicitud y la información sobre límites de frecuencia en las cabeceras de respuesta. - Distinguir los tiempos de cada etapa de conexión: añade
%{time_namelookup},%{time_connect}y%{time_starttransfer}a-w. Si la resolución DNS o el establecimiento de la conexión son lentos, suele tratarse de un problema de red local; si el tiempo hasta el primer byte es alto, normalmente la lentitud está en la puerta de enlace o en la inferencia del proveedor. - Observar la salida en streaming: añade
-Npara desactivar el búfer y establece"stream": trueen el cuerpo de la solicitud. Así podrás observar los datos SSE línea por línea e identificar dónde se produce la interrupción. - Usar un cuerpo de solicitud mínimo: conserva solo
modely un elemento enmessages, con una frase breve. No incluyas parámetros opcionales comotools,response_formatomax_tokens.
🚀 Consejo para diagnosticar problemas: en plataformas de agregación como APIYI, una misma clave permite invocar modelos de varios proveedores. Al hacer una reproducción mínima, basta con cambiar el campo
modelpara probar otro modelo. Así puedes comparar rápidamente los resultados sin preparar una cuenta y una clave para cada proveedor.
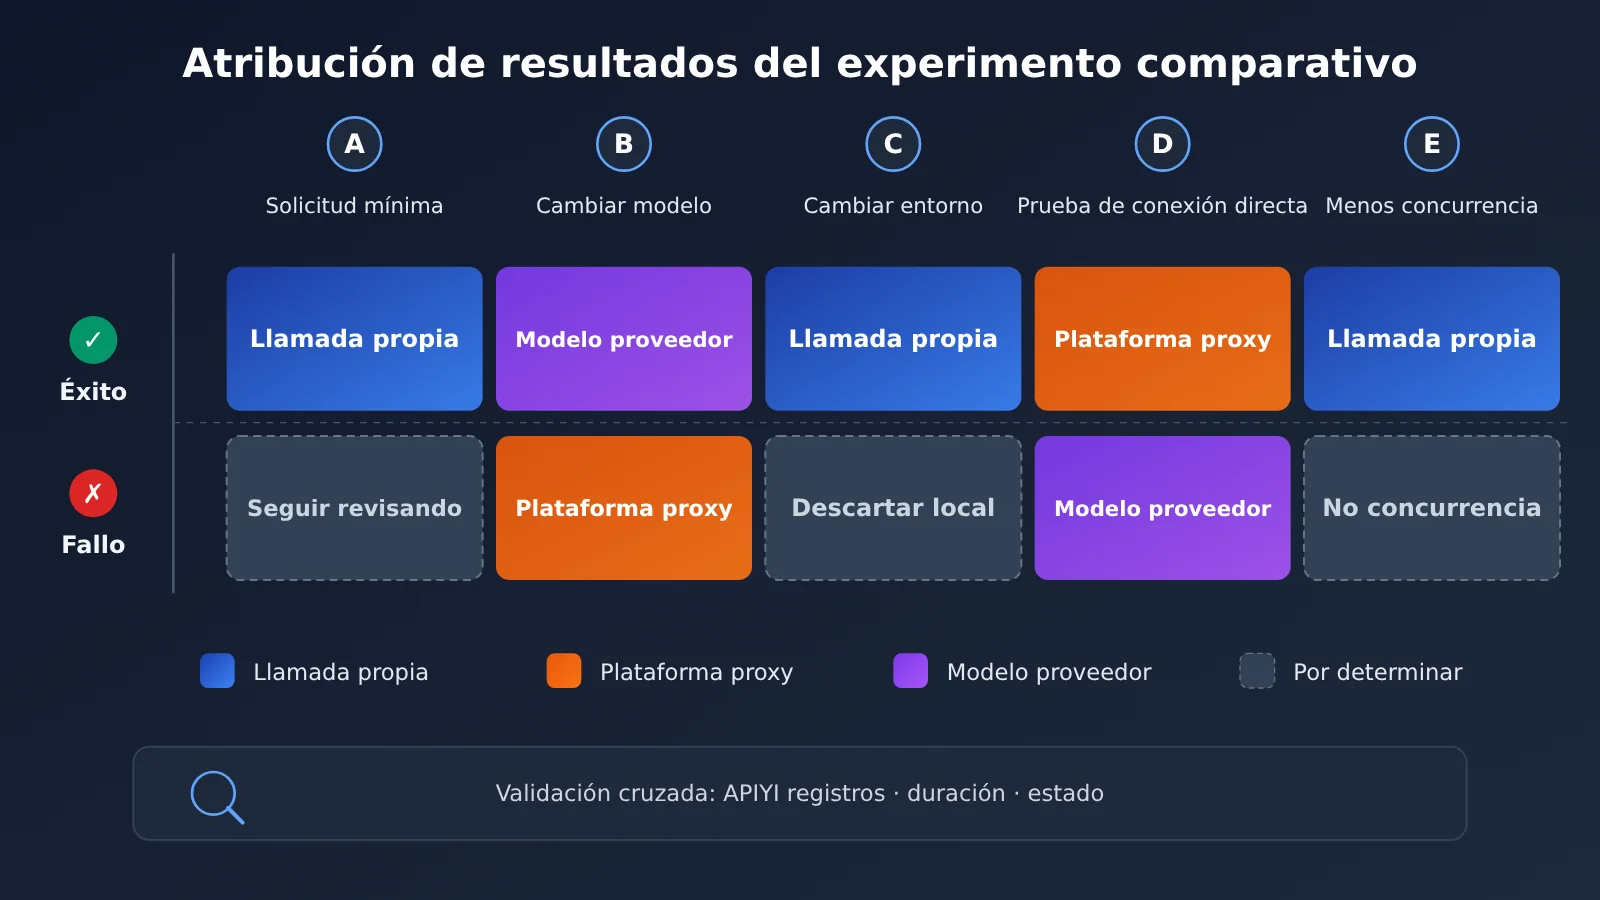
Matriz de pruebas comparativas: identifica la capa donde está el fallo
Al combinar la reproducción mínima con pruebas comparativas, puedes llegar a una conclusión bastante fiable sobre el origen del problema. Se recomienda ejecutar al menos los tres primeros grupos de la tabla.
| Grupo de prueba | Acción | Qué indica si funciona | Qué indica si falla |
|---|---|---|---|
| A: solicitud mínima | Misma clave y mismo modelo, con el cuerpo de solicitud más sencillo posible | El problema está en los parámetros o la lógica del código de la aplicación | Continúa con los grupos B y C |
| B: cambiar de modelo | Misma puerta de enlace y misma clave, con un modelo de otro proveedor | Puede haber un problema en el proveedor del modelo original | Es más probable que el problema esté en la puerta de enlace, la clave o la red local |
| C: cambiar de entorno | Envía la misma solicitud desde otra máquina o red | Hay un problema con la red local, el proxy o el DNS | Descarta los factores de la red local |
| D: comparar con una conexión directa | Si es posible, conéctate directamente a la interfaz oficial del proveedor | Es más probable que el problema esté en la puerta de enlace; puedes reportarlo a la plataforma | El problema está en el propio modelo del proveedor |
| E: reducir la concurrencia | Reduce la concurrencia a 1 y vuelve a intentarlo | Hay un problema de límites de frecuencia o cuota | El problema no está relacionado con la concurrencia |
Usar los registros de llamadas para identificar la causa de los errores de la API del modelo
curl te dice si una llamada falla «ahora»; los registros te muestran qué ocurrió «en ese momento». Los problemas en producción suelen ser difíciles de reproducir de forma consistente, así que los registros pueden ser la única fuente de evidencia. Al investigar, alinea los registros de tu aplicación con los de la plataforma por hora e ID de solicitud, y analízalos en conjunto.
En la aplicación, conviene registrar como mínimo: la hora de la solicitud, el nombre del modelo, un resumen de los parámetros (sin datos sensibles), el código de estado HTTP, la respuesta de error original, el tiempo total, el tiempo hasta el primer byte y el ID de solicitud devuelto por la plataforma. Los registros de la plataforma pueden completar la información que no ves, como si la solicitud llegó a la plataforma, cuántos tokens se facturaron y qué modelo se invocó realmente.
💡 Consejo para usar los registros: si accedes a través de APIYI, puedes consultar los registros de llamadas por intervalo de tiempo en la consola y cotejarlos uno a uno con los registros de tu aplicación. Para saber qué campos incluyen los registros de la plataforma y si transmiten los errores originales del proveedor upstream, consulta la información de la consola y la documentación. Si tienes dudas, preguntar directamente al soporte técnico es más rápido que intentar adivinar.
Información que debes incluir al reportar una incidencia al proveedor
Cuanto más completo sea el reporte, más rápido se podrá resolver el problema. Una descripción como «la API no funciona» casi siempre dará lugar a varias rondas de preguntas. Prepara la información de la siguiente tabla y envíala de una sola vez.
| Información | Ejemplo | Para qué sirve |
|---|---|---|
| Intervalo de tiempo | Preciso al segundo, con la zona horaria | Facilita la búsqueda en los registros de la plataforma |
| ID de solicitud | Identificador único en los encabezados o el cuerpo de la respuesta | Permite localizar directamente una solicitud |
| Nombre del modelo y endpoint | Nombre completo del modelo y ruta de la API | Ayuda a determinar si el problema afecta a un proveedor upstream específico |
| Error original | Código de estado y cuerpo completo de la respuesta | Permite distinguir los errores de la plataforma de los transmitidos por el proveedor upstream |
| Reproducción mínima | Descripción de los parámetros de curl sin datos sensibles | Permite reproducir el problema de forma consistente |
| Alcance del impacto | Porcentaje de fallos y modelos o funciones afectados | Ayuda a evaluar la gravedad del problema |
| Comparaciones realizadas | Resultados de los experimentos de los grupos A a E | Evita repetir las mismas comprobaciones |
Antes de reportar la incidencia, elimina o enmascara la clave API y los datos privados de los usuarios. Conserva solo unos pocos caracteres del principio y del final de la clave para identificarla. Si la plataforma ofrece soporte técnico 24/7, ante una incidencia urgente puedes informar primero del alcance del impacto y añadir los detalles después.
Preguntas frecuentes (FAQ)
Q1: ¿Qué debo hacer primero si falla una invocación del modelo a través de la API?
Primero, registra el error original: el código de estado, el cuerpo completo de la respuesta, el ID de la solicitud y la hora. Después, comprueba a qué afecta. No te apresures a reiniciar el servicio ni a modificar el código: si pierdes la información original, será mucho más difícil encontrar la causa.
Q2: ¿Cómo distingo entre un problema de la pasarela y uno del proveedor del modelo?
Lo más eficaz es hacer una prueba comparativa: cambia de modelo en la misma pasarela. Si todo vuelve a funcionar, es más probable que el problema esté en el proveedor del modelo original. Si puedes conectarte directamente al proveedor y la conexión funciona, es más probable que el problema esté en la pasarela. También puedes revisar el formato de la respuesta de error: los errores del proveedor que se transmiten sin modificar suelen tener una estructura característica.
Q3: Si recibo un error 429 por límite de solicitudes, ¿el problema es mío?
No necesariamente. Un 429 puede deberse a la cuota de tu cuenta, al límite de solicitudes simultáneas por clave de la plataforma o a una sobrecarga general del proveedor. Primero, reduce la concurrencia a 1 y vuelve a intentarlo. Después, revisa los avisos sobre límites en los encabezados de la respuesta y confirma con la plataforma en qué capa se está aplicando el límite.
Q4: ¿Cómo investigo si una misma solicitud a veces funciona y a veces falla?
Primero, revisa si hay algún mecanismo automático de respaldo o enrutamiento dinámico: comprueba que el campo `model` de la respuesta coincida con el canal utilizado según los registros de la plataforma. Después, analiza la distribución de los tiempos de las solicitudes fallidas. Si se concentran alrededor de un mismo valor, es posible que se esté alcanzando el límite de tiempo de espera de alguna capa.
Q5: ¿Cómo puedo comparar modelos sin gastar mucho?
Lo más sencillo es usar una plataforma de agregación con una interfaz unificada para varios modelos. En APIYI, basta con cambiar el campo `model` usando la misma clave para pasar de un proveedor a otro. Así puedes crear una reproducción mínima y comparar modelos en pocos minutos, sin tener que solicitar una cuenta a cada proveedor.
Q6: Si la calidad de las respuestas del modelo cae de repente, ¿se considera un error de invocación?
Este problema no genera un error, pero también hay que investigar su causa. Primero, comprueba si el nombre del modelo apunta a un alias que se actualiza periódicamente. Después, compara casos de prueba fijos con resultados anteriores. Si confirmas que el comportamiento del modelo ha cambiado, informa a la plataforma y comparte ejemplos comparativos.
Q7: Al reportar un problema a través de una pasarela de agregación, ¿debo proporcionar información del proveedor?
No necesitas contactar directamente al proveedor, pero sí debes proporcionar el ID de la solicitud, el nombre del modelo y el mensaje de error original. Con esos datos, la plataforma puede buscar los registros de las solicitudes reenviadas y determinar si el error proviene del proveedor. Por ejemplo, si contactas al soporte técnico de APIYI con el ID de la solicitud y el intervalo de tiempo, puedes reducir considerablemente los intercambios necesarios.
Claves para resolver errores de invocación de la API de modelos
- Identifica primero la capa responsable: determina si el problema está en tu propia llamada, en la plataforma de gateway o en el proveedor del modelo antes de decidir cómo solucionarlo.
- Conserva los datos originales: el código de estado, la respuesta completa y el ID de solicitud son pruebas esenciales para identificar la causa.
- Reproduce el error con el mínimo necesario: usa curl para aislar el código de negocio y vuelve a añadir los parámetros uno por uno hasta encontrar el que provoca el fallo.
- Compara para localizar la capa: prueba con otro modelo, otro entorno y una conexión directa. Estas tres comparaciones suelen bastar para localizar el origen del fallo.
- Cuidado con la conmutación automática: si los resultados varían entre llamadas, comprueba el modelo utilizado y los registros de enrutamiento de la respuesta.
- Coteja los registros de ambos lados: cruza los registros de la aplicación con los registros de llamadas de plataformas como APIYI, usando la hora y el ID de solicitud.
- Reporta el problema de forma estructurada: envía de una vez la hora, el ID de solicitud, el error original y los resultados de las pruebas comparativas.
Resumen
Cuando falla la invocación de la API de un modelo, lo más importante no es encontrar una solución de inmediato, sino determinar primero en qué capa está el problema:
- Tu propia llamada: confírmalo con una reproducción mínima y añadiendo los parámetros paso a paso. Normalmente se resuelve cambiando el código o la configuración.
- La plataforma de gateway: confírmalo comparando con una conexión directa y revisando los registros de la plataforma. Después, contacta con el proveedor y facilita el ID de solicitud.
- El proveedor del modelo: confírmalo probando otro modelo y consultando los avisos del proveedor. Para mitigar el problema, cambia de modelo o aplica una estrategia de respaldo.
Te recomendamos incluir los 6 pasos de diagnóstico de este artículo y la lista para reportar problemas en el manual de guardia de tu equipo. Así, la próxima vez que llegue una alerta, podrán seguir el procedimiento directamente. Si estás creando una solución de acceso a varios modelos, puedes usar APIYI apiyi.com para realizar pruebas comparativas entre modelos con la misma interfaz y combinar los resultados con los registros de llamadas de la plataforma para establecer tu propio proceso de diagnóstico.
📚 Referencias
- Códigos de estado de respuesta HTTP de MDN: explicación del significado general de los códigos de estado HTTP
- Enlace:
developer.mozilla.org/zh-CN/docs/Web/HTTP/Status -
Descripción: ayuda a entender el significado estándar de los errores 4xx y 5xx
-
Manual oficial de curl: descripción completa de los parámetros de curl
- Enlace:
curl.se/docs/manpage.html -
Descripción: incluye las variables de tiempo de
-wy parámetros habituales para la resolución de problemas, como-Ny-v -
Server-Sent Events de MDN: explicación del protocolo de transmisión SSE
- Enlace:
developer.mozilla.org/zh-CN/docs/Web/API/Server-sent_events - Descripción: ayuda a entender el formato de la salida en streaming y cómo se manifiestan las interrupciones
Autor: equipo técnico de APIYI
Contacto técnico: puedes contactarnos desde la página principal de APIYI. Encontrarás más recursos sobre integración y resolución de problemas en el centro de documentación docs.apiyi.com