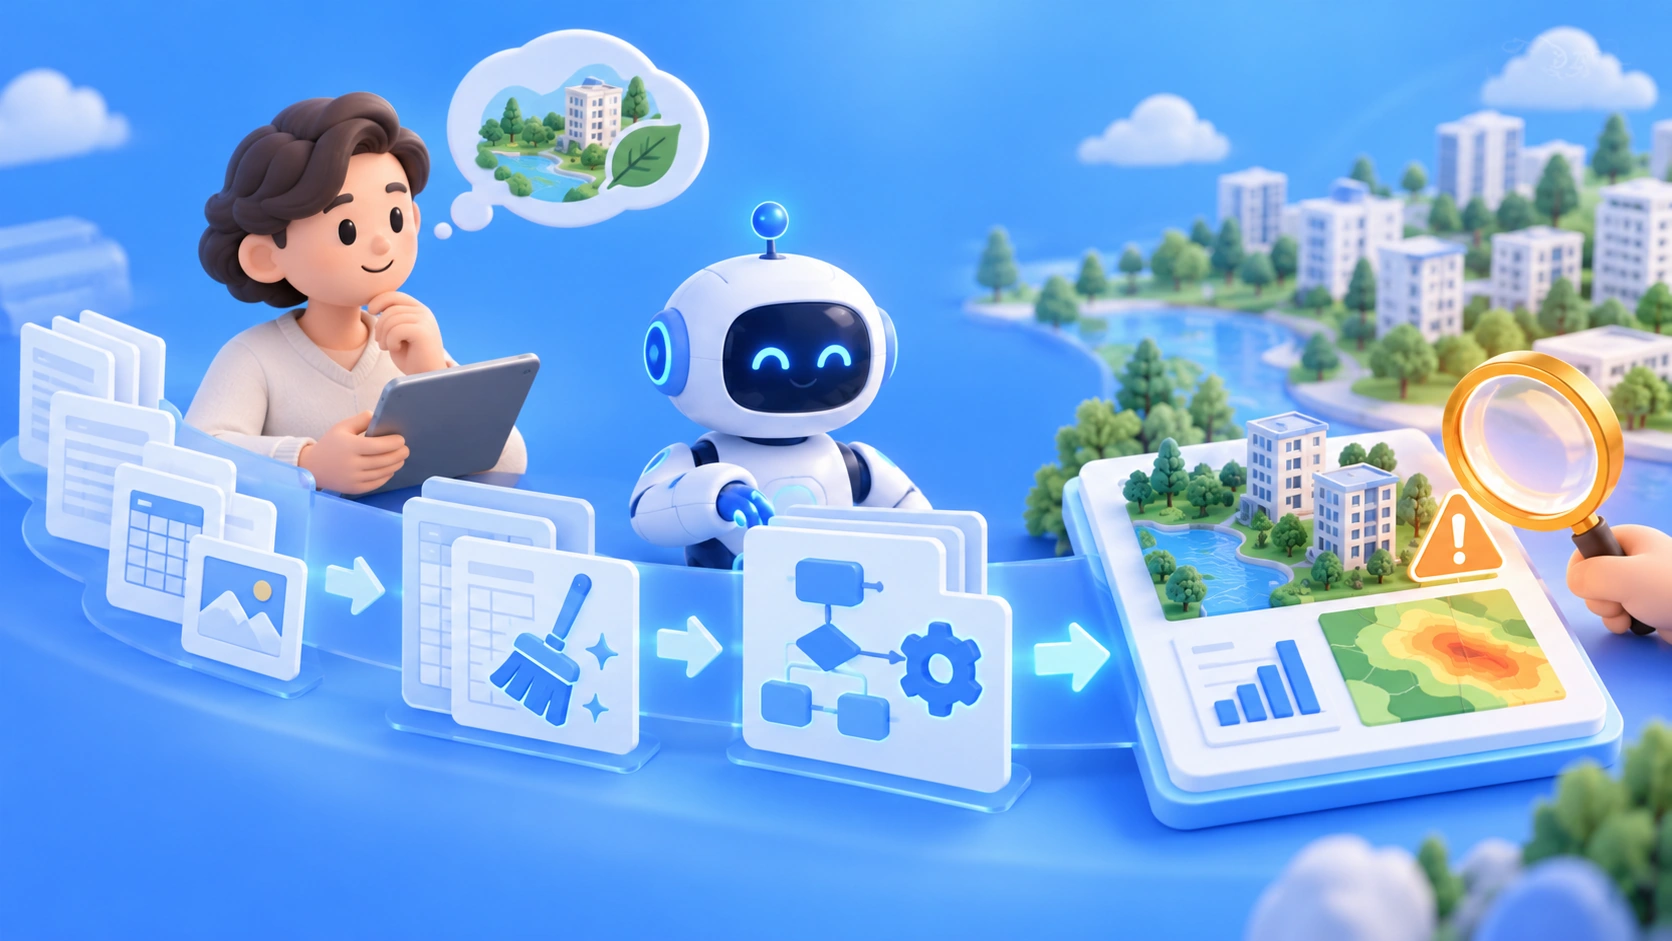
Nota del autor: El proyecto de evaluación de riesgos ambientales de Heimstaden sirve como ejemplo para analizar cómo se reparten el trabajo las personas y Codex cuando alguien sin perfil de desarrollo descubre datos, los limpia y construye flujos de trabajo. También explica por qué la responsabilidad de la metodología y la validación humana deben permanecer en manos de especialistas del dominio.
Muchos analistas de negocio conocen su sector, pero no saben programar. Cuando se enfrentan a un proyecto con datos dispersos en decenas de fuentes públicas y en formatos distintos, antes solo podían esperar al equipo técnico o contratar consultores externos. A partir de un caso real que ya es público, este artículo explica cómo repartir el trabajo entre personas y máquinas cuando alguien sin perfil de desarrollo usa Codex para construir flujos de procesamiento de datos. El foco está en dos límites que no conviene cruzar: quién se responsabiliza de la metodología y quién valida los resultados.
Este no es un artículo promocional sobre cómo «la IA puede hacerlo todo por ti». El caso incluye cifras llamativas, pero también muchos detalles que no se han revelado. Por eso, distinguiremos claramente entre los hechos conocidos y las inferencias.
Valor principal: al terminar de leer, sabrás qué etapas de un proyecto de datos puede asumir un agente de programación y qué responsabilidades debes conservar. También entenderás cómo convertir un análisis puntual en una capacidad que el equipo pueda seguir mejorando.
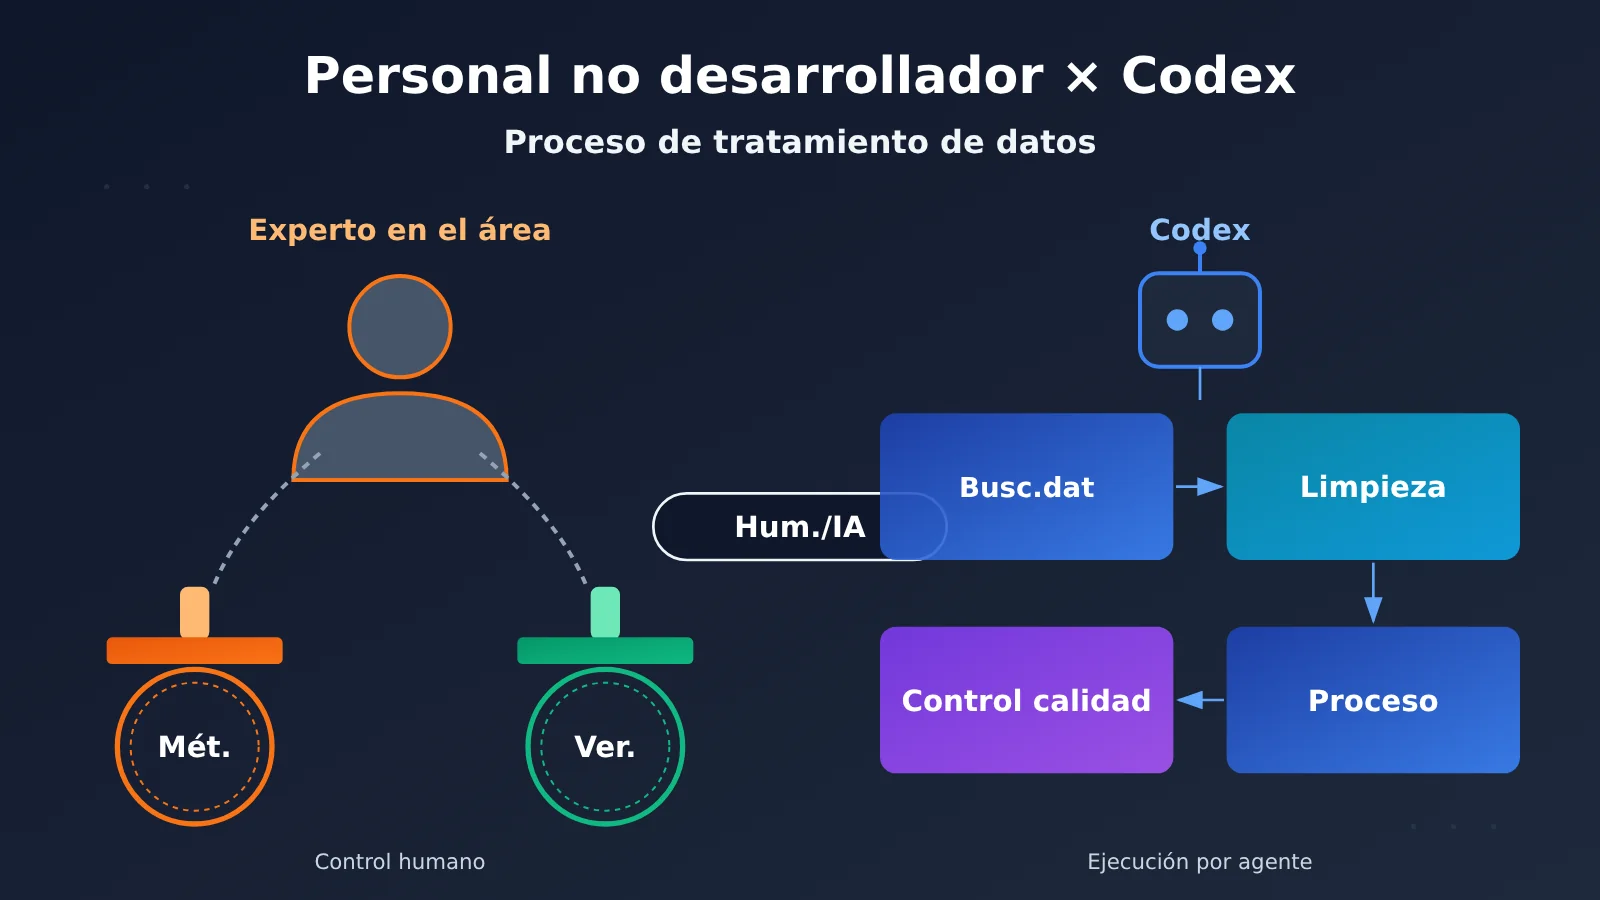
Claves para que personas sin experiencia en desarrollo creen flujos de procesamiento de datos con Codex
El 3 de noviembre de 2026, OpenAI publicó el caso de cliente de Heimstaden, una empresa europea de gestión de propiedades residenciales. Una parte del caso está dedicada a Julia Erlandsen, analista de sostenibilidad ambiental que, sin experiencia en desarrollo de software, utilizó Codex para completar una evaluación de riesgos ambientales de toda la cartera de activos. La siguiente tabla resume los aprendizajes más útiles del caso.
| Clave | Lo que muestra el caso | Valor para el lector |
|---|---|---|
| Naturaleza del problema | La información existe, pero está dispersa en distintas fuentes públicas, formatos y conjuntos de datos | Identificar proyectos con datos dispersos, especialmente adecuados para incorporar agentes |
| Tareas del agente | Descubrimiento, limpieza y estandarización de datos, controles de calidad y desarrollo de flujos de procesamiento repetibles | Saber qué etapas se pueden delegar |
| Control de la especialista | La analista mantiene en todo momento el control de la metodología y la validación | Proteger la credibilidad de las conclusiones |
| Resultado a escala | Evaluación de 20,112 activos y generación de más de 6 millones de filas de datos utilizables | Demostrar que las personas sin experiencia en desarrollo también pueden procesar datos a gran escala |
| Beneficio a largo plazo | El proyecto puntual se convierte en una capacidad repetible, sin necesidad de consultores externos | Mantener el control de la metodología y poder seguir mejorándola |
Cómo repartir el trabajo en un flujo de procesamiento de datos con Codex
La frase más importante del caso es breve: Codex apoyó el descubrimiento, la limpieza, la estandarización y los controles de calidad de los datos, así como el desarrollo de flujos de procesamiento repetibles, mientras Julia mantuvo el control de la metodología y la validación. Esta frase marca una frontera clara. Todo lo relacionado con «cómo limpiar los datos y convertirlos en un flujo que funcione» puede delegarse al agente; lo relacionado con «qué criterios usar para evaluar el riesgo y si los resultados son correctos» debe quedar en manos de una persona.
Esta frontera importa porque la evaluación de riesgos ambientales debe servir, en última instancia, para evaluar riesgos climáticos, cumplir los requisitos de presentación de informes y tomar decisiones de inversión. Si la metodología se basa en los supuestos predeterminados del agente, la analista no podrá explicar a inversores o auditores de dónde salen las conclusiones. Las propias palabras de Julia lo confirman: «Ahora tenemos el control de esta metodología y podemos seguir desarrollándola por nuestra cuenta». Ese control implica comprender y dominar la lógica de la evaluación, no solo tener una tabla de resultados.
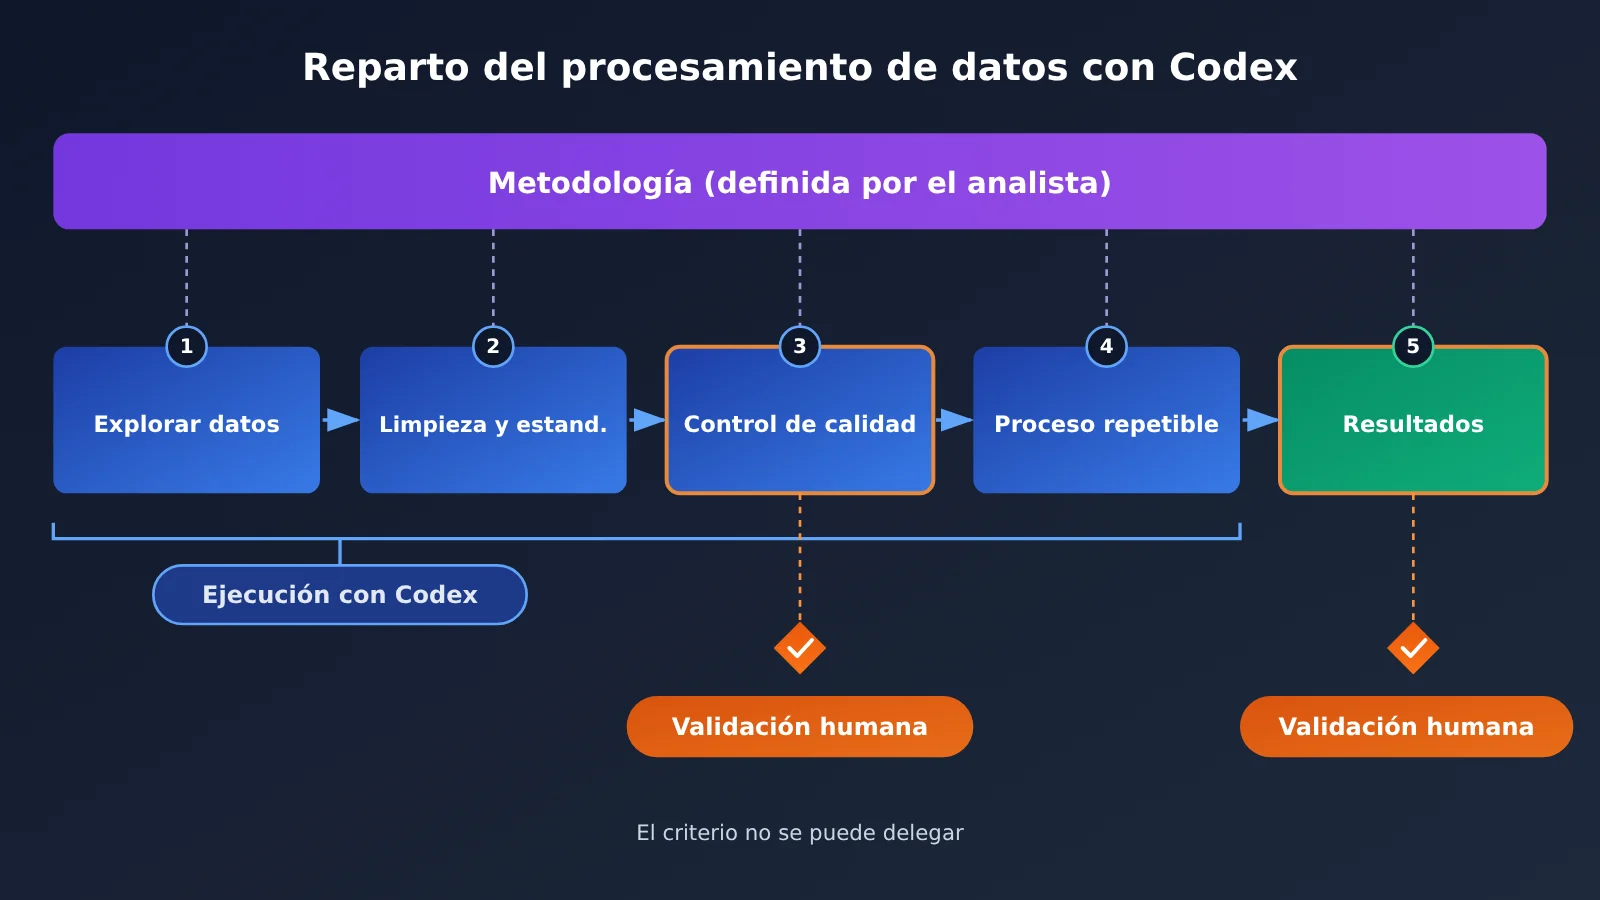
Principios para repartir tareas en un flujo de procesamiento de datos con Codex para personas sin conocimientos de programación
A partir del reparto de responsabilidades del caso, podemos elaborar una tabla más general. La columna «Detalles divulgados en el caso» indica si el texto original los proporciona. Las prácticas sugeridas se basan en nuestra experiencia con proyectos de datos y no representan necesariamente la forma de trabajar de Heimstaden.
| Etapa | Tareas del agente de programación | Responsabilidades del experto en el dominio | Detalles divulgados en el caso |
|---|---|---|---|
| Descubrimiento de datos | Buscar y enumerar posibles fuentes de datos, y explicar el significado de los campos | Determinar si las fuentes son fiables y adecuadas para la evaluación | No se divulgaron las fuentes concretas |
| Limpieza y normalización | Unificar formatos, unidades y codificaciones, y cotejar coordenadas y direcciones | Decidir cómo tratar los valores ausentes y contradictorios | No se divulgaron las reglas |
| Control de calidad | Crear comprobaciones automatizadas y generar una lista de anomalías | Definir qué se considera una anomalía y revisar muestras | No se divulgaron los métodos ni las tasas de error |
| Construcción del flujo | Integrar los pasos en un flujo de procesamiento que pueda ejecutarse de nuevo | Confirmar que la lógica del flujo coincide con la metodología | Solo se indicó que era «repetible» |
| Metodología y conclusiones | Ejecutar los cálculos siguiendo las instrucciones | Establecer el marco de evaluación, las ponderaciones y los umbrales, y asumir la responsabilidad de los resultados | Se especificó que seguían a cargo de los analistas |
De esta tabla se desprenden 5 principios para repartir el trabajo:
- La ejecución se puede delegar; el juicio, no. El agente es bueno convirtiendo una petición vaga como «organiza los datos» en operaciones concretas, pero solo alguien que conoce el sector puede responder si un umbral es razonable.
- Primero documenta la metodología y después entrégasela al agente. El marco de evaluación debe ser un documento que puedas explicar por tu cuenta, no una serie de instrucciones dispersas en una conversación.
- La validación necesita una perspectiva independiente. Si el agente que creó el flujo también revisa su propio trabajo, solo podrá detectar una parte de los problemas. No se deben omitir la revisión manual de muestras ni la comparación con referencias externas.
- El flujo debe poder repetirse. Un resultado manual obtenido una sola vez no permite iterar; un flujo que se puede ejecutar de nuevo sí es un activo.
- La responsabilidad de las conclusiones siempre recae en una persona. La estrategia general de IA de Heimstaden también recalca que los empleados son responsables de revisar y aprobar las decisiones, y que el contenido generado por IA debe pasar por una revisión humana antes de publicarse.
🎯 Consejo técnico: Si algún paso de tu flujo de datos requiere invocar un Modelo de Lenguaje Grande, por ejemplo, para clasificar descripciones de texto no estructurado según su nivel de riesgo, puedes usar APIYI apiyi.com para invocar varios modelos principales mediante una misma interfaz. Comparar las evaluaciones de distintos modelos sobre la misma muestra facilita la detección de sesgos sistemáticos de un modelo y constituye, por sí solo, un método de validación de bajo costo.
Guía rápida de Codex para el procesamiento de datos sin conocimientos de desarrollo
El caso no revela qué modalidad de Codex utilizó Julia ni detalla cómo interactuó con la herramienta o cómo organizó su flujo de trabajo. Por eso, los siguientes pasos no reproducen el caso: toman como referencia su reparto de tareas y ofrecen un punto de partida para analistas sin experiencia en desarrollo. Tal como se solicita, no incluimos código; usamos una lista para explicar qué darle al agente y qué revisar en cada paso.
Primer paso: redacta una metodología en lenguaje natural
Antes de empezar, deja clara la lógica de evaluación en un documento, por ejemplo, llamado methodology.md. Incluye al menos el objetivo de la evaluación, los indicadores necesarios, cómo se calcula cada uno, los umbrales para clasificar los niveles de riesgo y los criterios para tratar los datos faltantes. Este documento deja constancia de que la metodología es tuya y debe servir de referencia cada vez que le pidas al agente que modifique el flujo de trabajo.
Segundo paso: deja que el agente descubra los datos, pero toma tú la decisión
Cuéntale al agente el objetivo de la evaluación y pídele que enumere las posibles fuentes de datos, los campos que contiene cada una, su frecuencia de actualización y sus limitaciones conocidas. Revisa una por una si son fuentes confiables y si su cobertura coincide con la distribución de tus activos. Conviene pedirle al agente que guarde los datos originales descargados en un directorio raw independiente y que nunca los modifique. Todo el procesamiento posterior debe hacerse sobre copias.
Tercer paso: limpieza y estandarización, dejando constancia de cada cambio
Indícale al agente tus reglas de estandarización, como el formato unificado de direcciones, el sistema de coordenadas, las unidades y el formato de fechas. Después, pídele que genere el flujo de procesamiento. La condición clave es que cada transformación genere un registro de cambios: cuántas filas se eliminaron, cuántos registros se combinaron y cuáles no se pudieron hacer coincidir. Así, aunque no entiendas el código, podrás revisar los registros y valorar si el procesamiento fue razonable.
Cuarto paso: hacer la comprobación de calidad en dos niveles
El primer nivel lo realiza el agente: pídele que programe comprobaciones automáticas para detectar valores duplicados, valores faltantes, valores fuera de rango y fallos al hacer coincidir activos, entre otros casos, y que genere una lista de anomalías. El segundo nivel te corresponde a ti: selecciona al azar una parte de los activos de los resultados y revísalos manualmente con el método que conozcas. La proporción de la muestra y los criterios de tolerancia deben quedar definidos de antemano en el documento metodológico y registrarse por separado en una tabla como validation_log.
Quinto paso: convertir el proceso en un flujo reproducible
Cuando hayas confirmado que los resultados son fiables, pide al agente que organice todo el proceso en un flujo que pueda volver a ejecutarse con un solo clic y que redacte una guía de uso. Las instrucciones deben permitir que un colega que tampoco sepa programar pueda seguirlas. Solo entonces el proyecto habrá pasado de ser un «análisis puntual» a una «capacidad reutilizable».
| Etapa | Lo que le das al agente | Resultados que debes revisar | Riesgos habituales |
|---|---|---|---|
| Metodología | Objetivos de la evaluación y conocimientos del sector | El documento metodológico que escribiste | Criterios de los indicadores poco claros que obligan a rehacer el trabajo |
| Identificación de datos | Objetivos y alcance | Lista de fuentes y descripción de sus limitaciones | Incorporar datos de fuentes poco fiables o desactualizados |
| Limpieza y normalización | Reglas de normalización | Registro de cambios de cada paso | Eliminación silenciosa de datos que deja resultados aparentemente limpios |
| Comprobación de calidad | Definición de anomalías y proporción de la muestra | Lista de anomalías y resultados del muestreo manual | Confiar solo en las comprobaciones automáticas y pasar por alto errores sistemáticos |
| Consolidación del flujo | Requisitos de ejecución y actualización | Flujo reproducible y guía de uso | Que solo el agente «recuerde» cómo ejecutar el proceso |
🚀 Inicio rápido: Si en el tercer o cuarto paso necesitas un Modelo de Lenguaje Grande para interpretar campos de texto, por ejemplo, para analizar descripciones de riesgos en informes públicos de distintos países, puedes empezar comparando los resultados de varios modelos con una pequeña muestra en APIYI apiyi.com. Elige el más estable e intégralo después en el proceso formal, para evitar apostar todo el conjunto de datos a un solo modelo desde el principio.
Comparación del flujo de procesamiento de datos con Codex frente a otras opciones
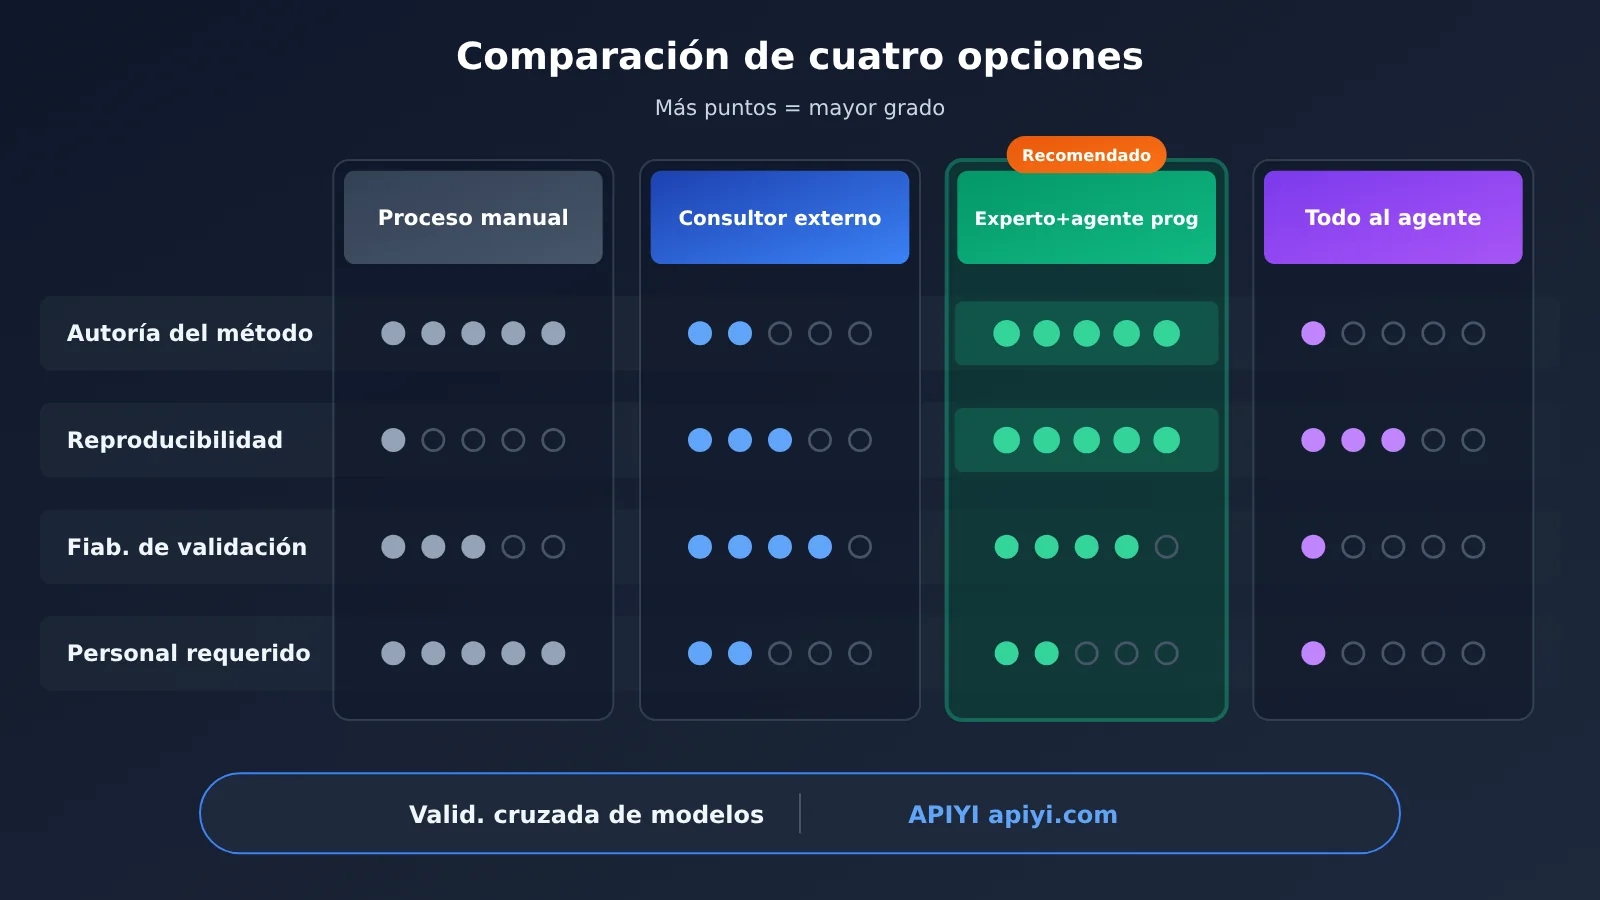
| Opción | Control de la metodología | Repetibilidad | Fiabilidad de la validación | Principal problema |
|---|---|---|---|---|
| Procesamiento totalmente manual | En manos del experto | Baja, suele ser difícil repetir el proceso | Depende de la atención de cada persona | Gran consumo de recursos humanos; en el caso analizado se estimó que harían falta 5 personas durante 1 año |
| Consultores externos | Suele quedar en manos de los consultores | Media, depende de lo que entreguen los consultores | Alta, pero poco transparente | Las iteraciones posteriores exigen volver a contratar el servicio |
| Experto + agente de programación | En manos del experto | Alta, el proceso puede repetirse | Alta, siempre que la validación humana sea adecuada | Exige que el experto sepa estructurar bien su metodología |
| Todo a cargo del agente | Difuso, implícito en los supuestos predeterminados | Media | Baja, es difícil explicar de dónde salen las conclusiones | No se puede responder por las conclusiones ante terceros |
Análisis de la comparación
Frente a los consultores externos: los consultores externos ofrecen ciertas ventajas en experiencia profesional y rapidez de entrega. Sin embargo, la metodología suele quedarse con ellos: para actualizar la evaluación al año siguiente, hay que volver a coordinarse y pagar. En cambio, el modelo de «experto + agente de programación» mantiene la metodología dentro de la organización. Heimstaden también mencionó expresamente que este proyecto evitó la contratación de consultores externos que habría sido necesaria.
Frente a dejarlo todo en manos del agente: pasarle todo el proyecto al agente parece la opción más sencilla y rápida. Pero el agente hará sus propias suposiciones sobre muchos detalles, como la forma de completar valores faltantes o descartar valores atípicos. Esas suposiciones pueden no coincidir con las prácticas habituales del sector. Cuando una evaluación debe respaldar el cumplimiento normativo de informes y las decisiones de inversión, es difícil que conclusiones de este tipo resistan un examen detallado.
Conviene interpretar con cautela las cifras de ahorro de personal. El texto original indica que la «necesidad estimada para completar el trabajo» pasó de 5 personas trabajando durante 1 año a 2 personas durante 2 meses. En un cálculo aproximado, son 60 meses-persona frente a 4. Pero se trata de una estimación de la propia empresa, sin verificación independiente, y tampoco se especifica cómo se repartieron las funciones entre las 2 personas.
💡 Recomendación: si tu equipo ya tiene una metodología y solo le falta capacidad de ejecución técnica, la opción de «experto + agente de programación» es la que más merece la pena probar. En las partes del proceso que requieran invocar modelos, puedes usar la interfaz unificada de APIYI apiyi.com para alternar entre distintos modelos y compararlos. Así tampoco tendrás que reescribir todo el proceso si cambias de modelo más adelante.
Lo que se sabe y lo que no sobre el caso de Codex para el procesamiento de datos
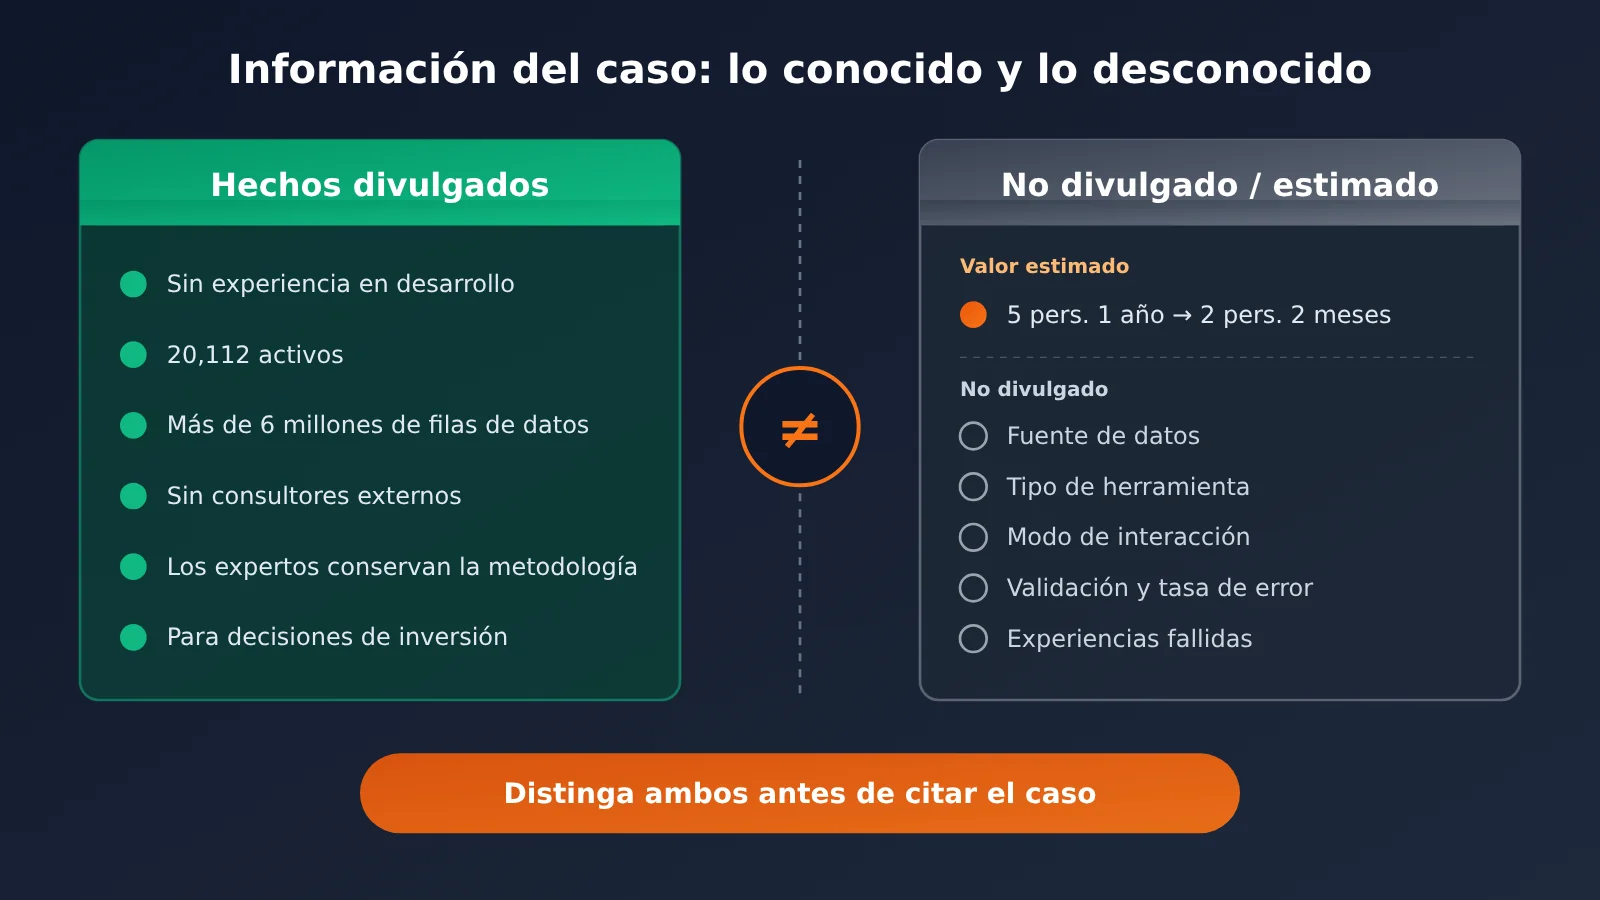
Para no interpretar el caso más allá de lo que cuenta, separamos la información que el artículo original presenta de forma explícita de la que no se ha divulgado.
| Categoría | Contenido |
|---|---|
| Información divulgada | La analista no tenía experiencia en desarrollo de software; Codex ayudó a descubrir datos, limpiarlos y normalizarlos, realizar controles de calidad y desarrollar procesos; la analista siguió a cargo de la metodología y la validación; se evaluaron 20.112 activos y se generaron más de 6 millones de filas de datos; no se necesitaron consultores externos; los resultados se usaron para evaluar riesgos climáticos, elaborar informes y tomar decisiones de inversión |
| Estimación | La empresa estima que el trabajo pasó de requerir 5 personas durante 1 año a 2 personas durante 2 meses |
| Información no divulgada | Las fuentes de datos concretas; cómo se utilizó Codex (aplicación de escritorio, CLI u otra opción); la forma de interacción y el flujo de trabajo; los métodos concretos de validación y las tasas de error; las dificultades y los fallos durante el proceso |
Estas lagunas no restan valor al principio de reparto de responsabilidades, pero sí significan que no puedes dar por hecho que obtendrás las mismas cifras de eficiencia. En un proyecto real, es muy posible que dediques más tiempo a definir la metodología y validar los resultados manualmente que a «pedirle al agente que escriba el proceso». Vale la pena recordar una conclusión de los directivos de Heimstaden: la IA no puede arreglar un mal proceso, pero sí puede potenciar enormemente uno bueno.
Preguntas frecuentes (FAQ)
Q1: ¿Qué significa que una persona sin perfil de desarrollo use Codex para crear flujos de procesamiento de datos?
Significa que una persona experta en su campo, sin conocimientos de programación, describe sus necesidades en lenguaje natural a un agente de programación. El agente se encarga de tareas técnicas como obtener, limpiar y revisar los datos, además de escribir el flujo de trabajo. La persona experta define la metodología y valida los resultados. El proyecto de evaluación de riesgos ambientales de Heimstaden es un caso público de este enfoque.
Q2: ¿En qué se diferencia esto de hacer preguntas sobre datos directamente a ChatGPT?
Las consultas de preguntas y respuestas suelen resolver problemas puntuales, y sus resultados son difíciles de reproducir. El valor de un agente de programación está en crear un flujo de procesamiento que se puede ejecutar de nuevo. Si los datos se actualizan, se puede volver a ejecutar; si cambia la metodología, se puede modificar. A eso se refiere el caso cuando habla de pasar de un proyecto de análisis complejo a una capacidad reproducible.
Q3: ¿Cuándo se publicó este caso?
OpenAI publicó el caso el 3 de noviembre de 2026. Refleja prácticas recientes de uso de agentes de programación en empresas. Las cifras concretas y las herramientas pueden cambiar con el tiempo, pero el principio de «delegar la ejecución al agente y dejar el criterio en manos de expertos» seguirá siendo útil como referencia.
Q4: ¿Qué proyectos de datos se prestan mejor a este reparto de funciones?
– **Integración de datos públicos de múltiples fuentes**: por ejemplo, conjuntos de datos ambientales, climáticos o demográficos dispersos entre distintas instituciones
– **Informes periódicos**: informes de cumplimiento y divulgación que deben elaborarse cada trimestre o cada año
– **Evaluaciones masivas de carteras de activos**: situaciones en las que miles de registros deben puntuarse con criterios uniformes
Q5: Si el flujo necesita invocar un Modelo de Lenguaje Grande, ¿cómo se puede empezar rápidamente?
Puedes registrarte en APIYI apiyi.com y usar una misma interfaz para invocar varios modelos populares. Después, compara sus resultados de clasificación o extracción con una pequeña muestra representativa. Una vez que hayas confirmado que los resultados son estables y siguen criterios coherentes, puedes incorporarlos al flujo de producción. La comparación entre modelos también puede servir de apoyo a la validación humana.
Q6: ¿Hasta qué punto debe llegar la validación humana?
El caso no detalla el método de validación ni la tasa de errores. Una práctica general es definir de antemano la proporción de muestras y los criterios de tolerancia al error, revisar una por una las anomalías señaladas por las comprobaciones automáticas y verificar una muestra aleatoria de los resultados normales. También conviene contrastarlos con referencias externas conocidas. Todos los registros de validación deben conservarse para futuras auditorías.
Q7: ¿Qué limitaciones tiene este modelo?
En primer lugar, las cifras de eficiencia provienen de estimaciones de la empresa y no se han verificado de forma independiente. En segundo lugar, las personas sin perfil de desarrollo aún necesitan saber explicar la metodología con claridad; de lo contrario, el agente solo amplificará la confusión. Por último, el caso no menciona dificultades ni experiencias fallidas. En la práctica, puede haber errores en el flujo que resulten difíciles de entender, por lo que quizá sea necesario pedir ayuda a colegas técnicos para investigarlos.
Q8: ¿Por qué es tan importante dominar la metodología internamente?
Cuando el equipo tiene el control de la metodología, puede modificarla y explicarla directamente la próxima vez que se actualicen los datos, cambien los requisitos regulatorios o los inversionistas pidan explicaciones, sin tener que recurrir de nuevo a consultores. A esa autonomía a largo plazo se refiere Julia cuando dice: «Ahora tenemos esta metodología y podemos seguir desarrollándola por nuestra cuenta».
Puntos clave del flujo de procesamiento de datos con Codex para personas sin perfil de desarrollo
- Reparto de responsabilidades: deja que el agente se encargue del descubrimiento, la limpieza, el control de calidad y los flujos de datos; reserva la metodología y la validación para los expertos.
- La metodología va primero: documenta el marco de evaluación antes de pedirle al agente que lo ejecute.
- Validación independiente: hacen falta las tres capas: comprobaciones automáticas, muestreo manual y comparación con referencias externas.
- La repetibilidad es clave: un flujo que puede volver a ejecutarse es un activo; un resultado puntual no permite iterar.
- Cautela con las cifras: pasar de 5 personas durante 1 año a 2 personas durante 2 meses es una estimación que no conviene extrapolar directamente.
- La comparación entre modelos ayuda a validar: en las etapas que requieran invocar un Modelo de Lenguaje Grande, puedes usar la interfaz unificada de APIYI para hacer comprobaciones cruzadas entre varios modelos.
Resumen
Lo más útil de que personas sin perfil de desarrollo creen flujos de procesamiento de datos con Codex no son las cifras de eficiencia, sino el reparto claro de responsabilidades:
- El agente se encarga de la ejecución: puedes delegarle el descubrimiento de datos, la limpieza y normalización, los controles de calidad y la creación de flujos repetibles.
- Los expertos aportan criterio: definir la metodología y validar los resultados es fundamental para que las conclusiones sean fiables y explicables.
- La capacidad se consolida: mantener el control de la metodología y contar con flujos que puedan volver a ejecutarse convierte un proyecto puntual en una capacidad que la organización puede mejorar de forma continua.
Si tienes un proyecto con datos dispersos y sin acceso inmediato a recursos técnicos, empieza por dedicar tiempo a documentar la metodología y después haz una prueba piloto a pequeña escala. En las etapas que impliquen invocar Modelos de Lenguaje Grande, puedes usar la interfaz unificada de APIYI apiyi.com para comparar el rendimiento de varios modelos y añadir una capa de respaldo a la validación humana.
📚 Referencias
- Caso de cliente de OpenAI – Heimstaden: cómo Heimstaden transforma la gestión de propiedades residenciales con ChatGPT y Codex
- Enlace:
openai.com/index/heimstaden/ - Descripción: única fuente de los datos de este caso, incluida la distribución de responsabilidades y las estimaciones del proyecto de evaluación de riesgos ambientales
Autor: Equipo técnico de APIYI
Contacto técnico: Puedes contactarnos desde la página principal de APIYI. Encontrarás más información sobre la integración de modelos en el centro de documentación docs.apiyi.com