Nota del autor: tras la publicación como código abierto del prototipo de investigación Super-agent de DeepSeek, ¿en qué se diferencia realmente de Claude Code y Codex? En este artículo analizamos seis dimensiones de las tres capas de capacidad —modelo, herramientas de programación y sistema de orquestación— y ofrecemos recomendaciones según la forma de trabajar de cada persona.
El 31 de octubre de 2026, el equipo DeepSeek Harness publicó el artículo técnico «Exploración del diseño de Super-agent: hacia sistemas de agentes más autónomos» y liberó en su GitHub oficial el prototipo asociado dsh-superagent-prototype bajo la licencia MIT. La arquitectura de orquestación de dos capas, con un Router permanente y Workers independientes no tardó en generar debate. Medios como Bloomberg y South China Morning Post la presentaron en el contexto de la competencia con Claude Code y Codex.
Este no es otro artículo que toma partido sobre «quién sustituirá a quién». El propio repositorio se identifica claramente como un prototipo de investigación, y Claude Code y Codex hace tiempo que dejaron de ser herramientas de una sola sesión. Al comparar DeepSeek Super-agent con Claude Code y Codex, la pregunta que realmente vale la pena hacerse es: ¿las diferencias vienen del modelo subyacente o del sistema de orquestación de agentes?
Qué te llevas: al terminar el artículo, podrás distinguir en qué capa se sitúa cada uno, entender qué implica en la práctica el enfoque de diseño de DeepSeek y elegir la combinación de herramientas que mejor se adapte a tu forma de trabajar.
DeepSeek Super-agent: datos clave de un vistazo
Primero, aclaremos los hechos. DeepSeek Super-agent no es un nuevo modelo fundacional, sino una arquitectura de agentes construida en torno a un Modelo de Lenguaje Grande. Lo que se ha publicado hasta ahora es un prototipo de investigación, no un producto comercial terminado.
| Dato | Detalle |
|---|---|
| Fecha de publicación | 31 de octubre de 2026 (el artículo técnico y el repositorio se publicaron el mismo día) |
| Equipo responsable | Equipo de DeepSeek Harness |
| Nombre del proyecto | deepseek-ai/dsh-superagent-prototype, desarrollado principalmente en TypeScript |
| Licencia de código abierto | MIT: se puede descargar y modificar gratuitamente, y usar en proyectos comerciales siempre que se cumplan las obligaciones de la licencia |
| Estado del proyecto | Prototipo de investigación; no se ha anunciado una fecha de lanzamiento comercial ni un precio de suscripción específico |
| Requisitos de ejecución | Un entorno DeepSeek Harness y un proveedor de modelos configurado |
| Alcance actual | Supervisa un solo repositorio de GitHub, puede integrarse con Feishu y lleva el trabajo de una Issue a un PR |
Al 2 de noviembre, la página del proyecto mostraba alrededor de 8900 stars y 898 forks; estas cifras siguen cambiando. Conviene recordar que los stars solo reflejan el interés que genera el proyecto: no indican cuántas instalaciones reales tiene ni su tasa de éxito al programar.
¿Qué problema intenta resolver DeepSeek Super-agent?
El punto de partida del equipo de DeepSeek es interesante: a medida que los modelos mejoran en tareas individuales, el cuello de botella pasa de ser la capacidad del modelo a ser la atención humana. Según la experiencia del equipo, una persona suele poder dar seguimiento eficazmente a unas 3 a 5 sesiones activas de agentes. Entre los motivos están la dispersión del contexto, los cambios frecuentes de ventana, la necesidad de dar instrucciones manuales para el siguiente paso cuando termina una tarea, el bloqueo de sesiones por invocaciones de herramientas y las interrupciones cuando el dispositivo local entra en reposo.
La cifra de 3 a 5 sesiones es una estimación basada en la experiencia del equipo de DeepSeek, no una estadística del sector. Aun así, deja clara la dirección de la investigación de Super-agent: no se trata de hacer que el modelo sea más inteligente, sino de transferir de la persona al sistema la programación de sesiones, el procesamiento de eventos y la gestión del contexto. Para ello, el equipo plantea cuatro características como objetivos de diseño: Continuous (continuidad), Productive (alta productividad), Proactive (proactividad) y Persistent (persistencia). Que sean objetivos no significa que el prototipo ya los haya cumplido todos.
DeepSeek Super-agent frente a Claude Code y Codex: primero, distingamos tres niveles
Antes de debatir «cuál es mejor», hay que reconocer que los tres no pertenecen exactamente a la misma categoría de producto. Claude Code y Codex son productos y ecosistemas de herramientas de agentes orientados a la programación. Super-agent, en cambio, se centra en crear una capa externa que mantenga el agente activo, responda a eventos y coordine varias tareas. El razonamiento y la ejecución de herramientas siguen dependiendo del modelo subyacente y de DeepSeek Harness.
Por eso conviene comparar tres niveles: la capacidad del modelo determina la calidad del razonamiento en cada paso y del código generado; la capacidad de las herramientas de programación determina si puede leer y escribir archivos, ejecutar pruebas y crear PR; y la capacidad del sistema de coordinación determina cómo se reciben, asignan, supervisan y entregan varias tareas. Mezclar los tres niveles puede llevar fácilmente a conclusiones engañosas.
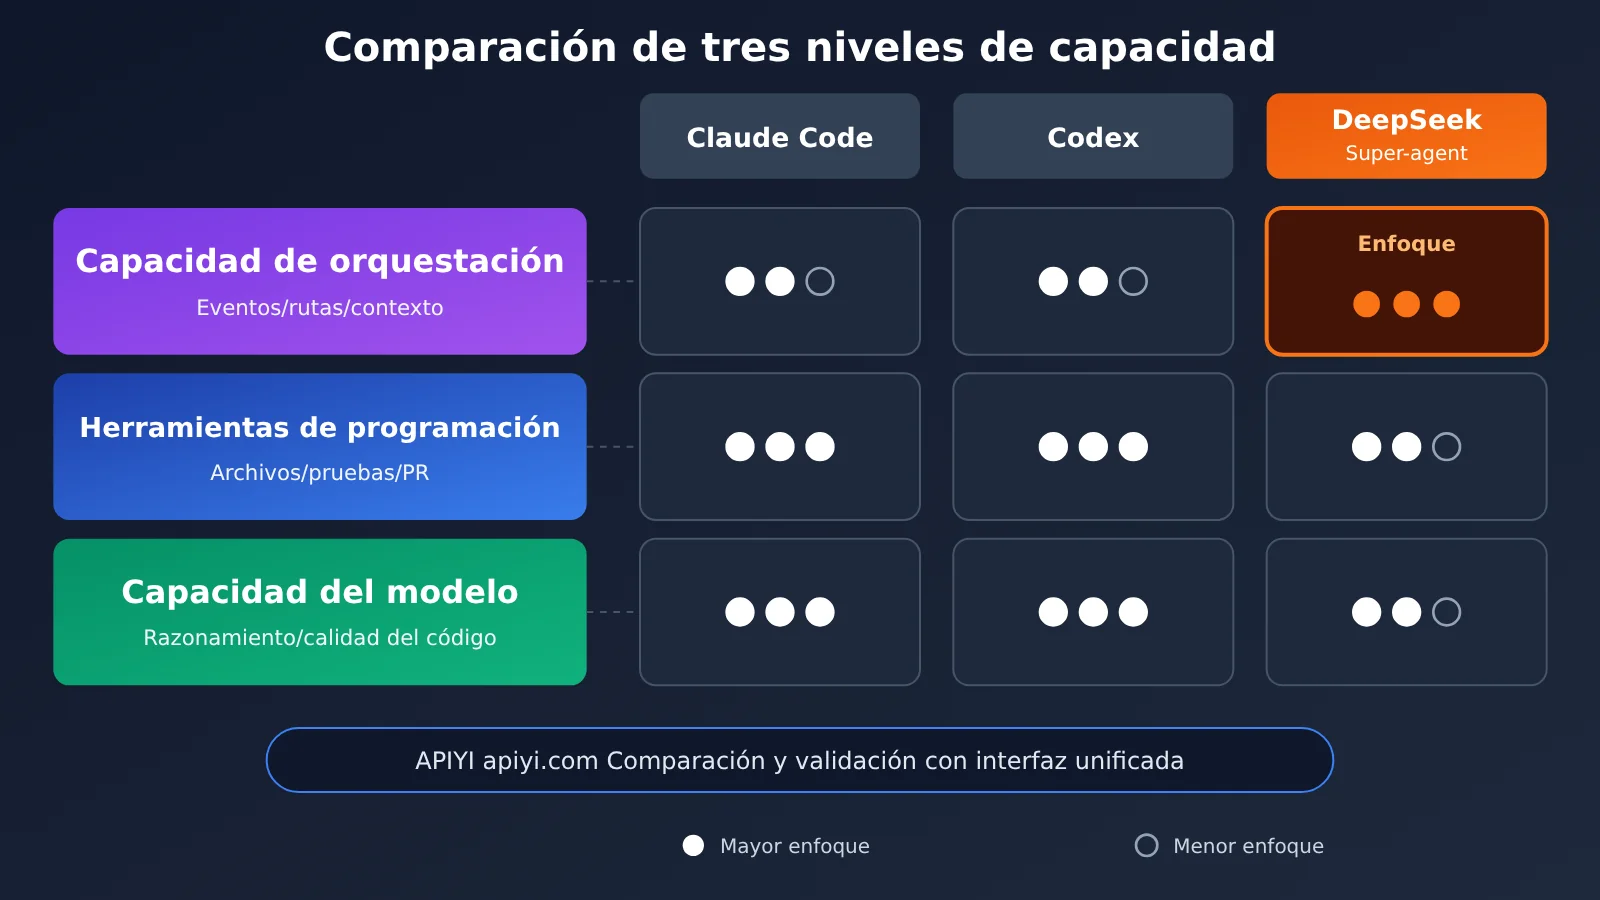
A continuación comparamos los mecanismos de funcionamiento publicados hasta ahora en seis dimensiones. Ten en cuenta que la tabla compara «mecanismos», no es una clasificación de rendimiento bajo las mismas condiciones.
| Dimensión | Prototipo de DeepSeek Super-agent | Ecosistema de Claude Code | Ecosistema de Codex / OpenAI |
|---|---|---|---|
| Programación de una sola tarea | Depende de Harness y del modelo elegido; ejecutada por Worker | Agente de programación consolidado, con CLI, aplicación de escritorio y nube | Agente de programación consolidado, en local y en la nube |
| Colaboración entre agentes | Dos capas: Router + Worker | Subagents, Agent Teams experimental | Sesiones paralelas, Worktrees; Multi-agent es una capacidad de la API |
| Activación por eventos | GitHub y, opcionalmente, Feishu | GitHub Actions, Channels (versión preliminar de investigación) | Automatización de eventos de aplicaciones compatibles y flujos de trabajo de GitHub Actions |
| Ejecución continua en segundo plano | Sesiones de Worker; la ejecución continua entre dispositivos sigue en fase de exploración | Agentes en segundo plano, tareas programadas en la nube | Tareas en la nube y tareas programadas en segundo plano |
| Gestión del contexto | Router permanente mantiene el contexto global; los Worker están aislados | Contexto independiente para cada subagente y lista de tareas compartida por el equipo | Espacios de trabajo aislados para las tareas en la nube; el agente principal recopila los resultados |
| Coste de despliegue | Autodespliegue; requiere Node.js, tmux, una cuenta de GitHub dedicada, entre otros | Producto comercial, fácil de empezar a usar | Producto comercial, fácil de empezar a usar |
Cada fila tiene una implicación distinta. La «programación de una sola tarea» determina tu experiencia diaria al escribir código; la «activación por eventos» y la «ejecución en segundo plano» determinan si el agente puede trabajar sin que estés pendiente; la «gestión del contexto» determina si las tareas interfieren entre sí cuando se acumulan; y el «coste de despliegue» influye directamente en si el equipo está dispuesto a invertir tiempo desde el principio.
Las capacidades multiagente de Claude Code son considerables
Según la documentación oficial de Anthropic, los Subagents de Claude Code cuentan con una ventana de contexto independiente, permiten configurar instrucciones de sistema específicas, limitar las herramientas disponibles y asignar distintos modelos. También pueden realizar investigaciones y algunas tareas de implementación en paralelo, en segundo plano. La función experimental Agent Teams va un paso más allá: un Lead y varios Teammates trabajan como sesiones independientes de Claude Code, comparten una lista de tareas y pueden enviarse mensajes directamente entre sí. Esta función está desactivada por defecto y, según advierte Anthropic, aumenta la carga de coordinación y el consumo de tokens.
En cuanto a eventos y ejecución continua, claude-code-action puede responder a menciones de @claude en comentarios de issues y PR y, con la configuración adecuada, convertir un issue en un PR. Channels, disponible como vista previa de investigación, envía mensajes de chat, webhooks y resultados de CI a una sesión en ejecución mediante MCP, pero exige que la sesión permanezca activa. Además, existen /loop dentro de la sesión, tareas programadas en la aplicación de escritorio y tareas programadas en la nube. Algunas pueden seguir ejecutándose en la nube después de apagar el equipo local. Así que la idea de que «Claude Code solo puede esperar pasivamente a recibir instrucciones» hace tiempo que quedó desfasada.
Capacidades multitarea de Codex: hay que distinguir entre producto y API
Codex puede utilizar Git Worktree para crear varios directorios de trabajo independientes para un mismo proyecto, de modo que distintas sesiones puedan modificar diferentes ramas en paralelo. Codex Cloud analiza código, implementa cambios y ejecuta pruebas en espacios de trabajo aislados; las tareas en la nube pueden continuar incluso después de apagar el equipo local. El ecosistema de ChatGPT y Codex también admite tareas programadas en segundo plano y, para usuarios que cumplen los requisitos, activación mediante eventos de aplicaciones como GitHub y filtrado de la actividad de los PR.
Hay un punto que puede resultar confuso: las capacidades multiagente que ofrecen OpenAI Agents API y Responses API —un agente principal que delega en subagentes con contextos independientes— son capacidades de API y no pueden equipararse directamente con las funciones predeterminadas de todas las interfaces de Codex. Del mismo modo, el ejemplo de OpenAI Cookbook que explica cómo usar GitHub Actions para invocar Codex CLI y generar un PR de corrección tras un fallo de CI es una forma de configurar un flujo de trabajo, no una función integrada que Codex CLI incluya de serie.
La coordinación Router + Worker de DeepSeek Super-agent
El flujo principal del prototipo de DeepSeek se resume en Source → Trigger → Eval → Ticket → Assignment → Executor → Result. Los eventos llegan desde GitHub o Feishu y pasan primero por reglas deterministas que filtran los permisos. Después, el modelo decide si es necesario crear una tarea. Cada tarea aceptada genera un Ticket independiente que se asigna a un Worker con su propio directorio de trabajo. El resultado vuelve por el canal original, por ejemplo, como un PR de GitHub.
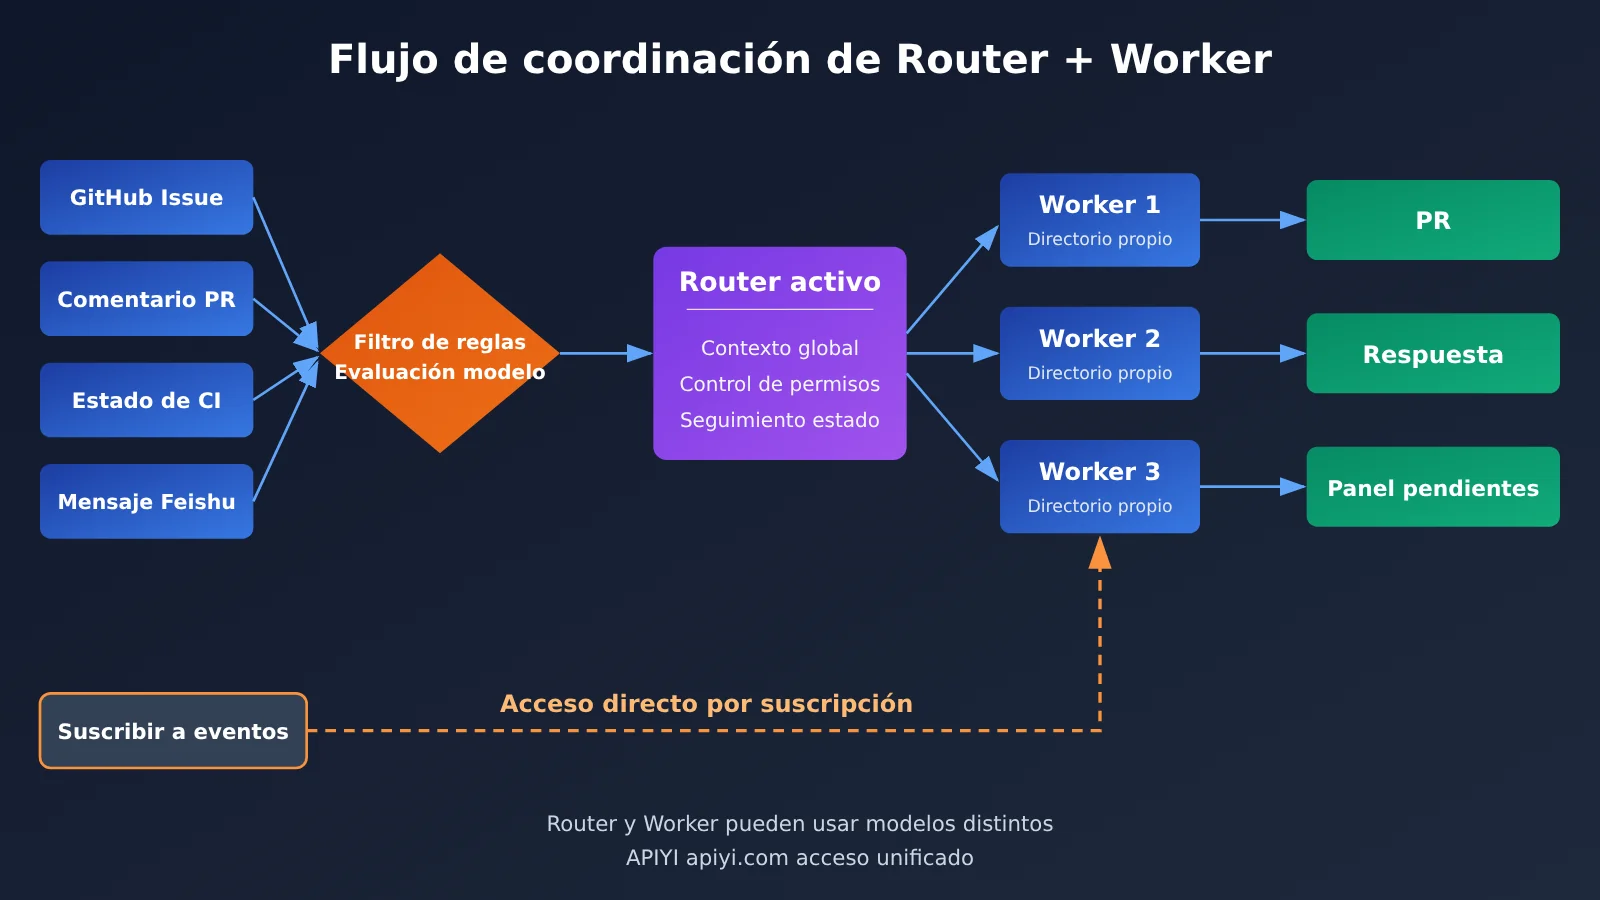
El Router es la sesión principal que permanece activa. Recibe mensajes, mantiene el contexto global, decide si hay que crear tareas, comprueba las autorizaciones y asigna y supervisa las tareas. En principio, no se encarga de tareas complejas de programación. Por eso, según el equipo oficial, en algunos casos puede usar un modelo más ligero para reducir los costes de coordinación. El Worker, por su parte, recibe tareas bien definidas y trabaja en un directorio aislado: escribe código, ejecuta pruebas, atiende comentarios posteriores y entrega el resultado.
La verdadera diferencia: el enfoque de diseño del sistema de orquestación de DeepSeek Super-agent
Si Claude Code y Codex ya cuentan con capacidades de múltiples agentes, ejecución en segundo plano y gestión de eventos, ¿qué diferencia a DeepSeek? La respuesta no está en si tienen o no esas funciones, sino en quién gestiona las tareas y cuál es el alcance de esa gestión.
Un agente principal que delega subtareas, o el Team Lead de un Agent Team, suele participar directamente en la planificación y coordinación de una tarea compleja, así como en la integración de sus resultados. El Router de DeepSeek, en cambio, se centra en la coordinación general entre tareas: un Router permanente gestiona varios trabajos relativamente independientes al mismo tiempo. El usuario interactúa con un único Super-agent lógico, directamente desde canales de trabajo como GitHub o Feishu, sin tener que gestionar cada sesión de Worker por separado.
La propia DeepSeek reconoce que, si se configura el agente principal de un Agent Team para que solo gestione las interacciones generales y la delegación, sin ejecutar tareas personalmente, también se puede crear una arquitectura de dos niveles similar. Por tanto, Router + Worker no es una capacidad exclusiva que otros no puedan implementar. La diferencia real está en hasta qué punto se sistematizan la escucha permanente, el enrutamiento entre tareas y la unificación del contexto de trabajo. Esto se refleja en tres puntos:
- Router permanente: funciona como una sesión principal que permanece activa a largo plazo, no como un coordinador que se inicia temporalmente para cada tarea. Así, el contexto global puede mantenerse entre tareas.
- Entrega directa de eventos suscritos: un Worker suscrito a un hilo puede recibir directamente los eventos posteriores, como nuevos comentarios en la misma PR, lo que reduce las reasignaciones del Router.
- Iniciativa conservadora: las tareas se dividen en Explicit (solicitudes explícitas) e Inferred (candidatas inferidas). Por defecto, las tareas inferidas usan el modo
observe: solo se registran, no se ejecutan. La fusión automática de PR también está desactivada por defecto.
Cómo interpretar los datos oficiales de los experimentos de DeepSeek Super-agent
DeepSeek realizó una serie de experimentos sintéticos de orquestación. Cada ejecución incluía unos 300 mensajes, de los cuales alrededor de 20 eran solicitudes de trabajo; el resto eran conversaciones informales, comentarios posteriores, cancelaciones y mensajes de CI. El trabajo de programación se sustituyó por herramientas simuladas con tiempos de ejecución, y cada configuración se ejecutó 5 veces.
| Configuración | Tiempo de finalización P50 | Tiempo de finalización P95 | Tokens leídos de caché por ejecución |
|---|---|---|---|
| Super-agent | 12.4 minutos | 15.7 minutos | Unos 23.2 millones |
| Super-agent, sin entrega directa de eventos suscritos | 12.6 minutos | 15.5 minutos | Unos 31.8 millones |
| Una sesión + Subagent, indicación neutral | 20.4 minutos | 29.5 minutos | Unos 6.1 millones |
| Una sesión + Subagent, prioridad a la delegación | 13.8 minutos | 29.0 minutos | Unos 10.8 millones |
Hay dos conclusiones especialmente útiles. Primero, frente a la configuración de una sola sesión que prioriza la delegación, la ventaja de Super-agent en P50 es pequeña, pero su P95 es considerablemente menor. Esto indica que el principal beneficio de la arquitectura de dos niveles es evitar que algunas tareas se retrasen demasiado cuando hay muchas en marcha. Segundo, al eliminar la entrega directa de eventos suscritos, el tiempo de finalización apenas cambia, pero las lecturas de caché aumentan de unos 23.2 a 31.8 millones. Por tanto, su función principal es reducir el trabajo repetido del Router, no acelerar la ejecución.
Pero es importante dejar claros los límites: este es un experimento de orquestación, no una prueba de calidad de generación de código. Los grupos de comparación usan una sesión + Subagent con indicaciones específicas; no son pruebas de los productos completos Claude Code o Codex en las mismas condiciones. Por eso, los resultados no demuestran una mejora del 39 % o del 47 % en la eficiencia real de programación, y mucho menos sirven para elaborar una clasificación de velocidad entre los tres. Otra prueba oficial de procesamiento por lotes del Router muestra que, con unos 40 eventos por minuto, el tamaño medio de los lotes aumenta a 2.8 y el tiempo de inferencia prorrateado por decisión baja a 1.6 segundos. Esto también demuestra únicamente su viabilidad bajo la carga de prueba utilizada.
Costos y límites de seguridad de DeepSeek Super-agent
La mayor velocidad tiene un precio: más tokens. En pruebas sintéticas, Super-agent realizó unas 3,8 veces más lecturas de caché que una configuración neutral de sesión única. Pero eso no significa que el costo total se multiplique por 3,8: también depende del precio de los modelos, los aciertos de caché, el volumen de tokens de entrada y salida y los modelos que usen el Router y los Workers. DeepSeek tampoco ha publicado el costo medio por tarea real.
Como referencia, estos son los precios oficiales de la API de DeepSeek al 2 de noviembre de 2026 (USD / 1 millón de tokens). Son tarifas de los modelos, no planes de precios de Super-agent:
| Modelo y franja horaria | Entrada sin acierto de caché | Entrada con acierto de caché | Salida |
|---|---|---|---|
| DeepSeek V4.1 Flash, horas de baja demanda | $0.15 | $0.003 | $0.60 |
| DeepSeek V4.1 Flash, horas pico | $0.30 | $0.006 | $1.20 |
| DeepSeek V4 Pro, horas de baja demanda | $0.66 | $0.022 | $1.98 |
| DeepSeek V4 Pro, horas pico | $1.32 | $0.044 | $3.96 |
Además, Search y Fetch cuestan $0.75 cada uno por cada 1000 solicitudes exitosas. Se cobran desde el 1 de noviembre de 2026 a las 00:00, hora de Pekín, y solo generan cargos cuando se utilizan. Quien despliegue el sistema también debe contar los recursos del servidor, los gastos de funcionamiento continuo y el mantenimiento manual. Claude Code y Codex, por su parte, tienen distintos planes de suscripción, API y ejecución en la nube. Por ahora no existe una medida común de «costo por PR que cumple los requisitos» que permita comparar los tres.
💰 Consejo para gestionar costos: en una arquitectura multiagente, la clave del gasto está en «qué modelo usa cada rol». Si quieres probar una combinación con un modelo ligero para el Router y uno más potente para los Workers, puedes acceder a varios modelos principales a través de APIYI apiyi.com con una sola clave API. El pago por uso facilita observar el gasto en tokens de las distintas combinaciones en una misma factura.
La seguridad tampoco se puede pasar por alto. La documentación oficial de despliegue reconoce que las configuraciones predefinidas del Router y los Workers se ejecutan en modo danger-full-access y, por defecto, con la cuenta de usuario del sistema del operador. Esto les permite leer archivos del directorio personal, ejecutar programas locales y acceder a credenciales locales. DeepSeek recomienda usar un usuario de sistema independiente y una cuenta de bot de GitHub separada. Escuchar comentarios y mensajes externos también introduce riesgos de inyección de indicaciones. Además, la comunidad ha publicado un informe de auditoría de terceros sobre el commit 6337fc8, que señala posibles problemas, entre ellos la validación de la interfaz de administración. Sin embargo, el proceso completo de ataque no se ha reproducido de forma independiente, por lo que debe tratarse como un «riesgo potencial» y no como un incidente ocurrido.
Análisis del impacto de DeepSeek Super-agent
Impacto para los desarrolladores
- Hay que ampliar los criterios de evaluación: al elegir una herramienta, no basta con mirar las puntuaciones del modelo subyacente. También hay que comprobar si la integración de eventos, el aislamiento de tareas, la ejecución en segundo plano y los mecanismos de revisión humana encajan con el flujo de trabajo del equipo.
- El prototipo funciona, pero requiere atención: el usuario de la comunidad xxxxkkkqq logró llevar una incidencia hasta un PR en un repositorio privado, pero también encontró problemas: notificaciones que no llegaban, mensajes que no se recibían pese a que las comprobaciones de despliegue eran correctas y fallos en las aserciones de las pruebas por tener el sistema configurado en chino. Otro usuario detectó en una hora, usando WSL2, dos defectos relacionados con la identificación de procesos de Node.js 24 y la pérdida de comentarios de GitHub.
- Tiene un valor claro como base para desarrollos propios: para los equipos que pueden mantener TypeScript, integraciones con GitHub y API de modelos, ofrece una implementación de referencia completa de Router, eventos, tickets, Worker y reglas de permisos.
Impacto para el sector
- La competencia se amplía: en la programación con IA, la competencia ya no se limita a comparar modelos. El Agent Harness, el diseño de flujos de trabajo y la experiencia del desarrollador están pasando a ser factores igual de importantes.
- El «agente proactivo» avanza hacia la estandarización: DeepSeek vincula el «trabajo proactivo» con políticas de autorización, el modo observe y la validación humana, en respuesta a una preocupación real: si los agentes podrían consumir innecesariamente la atención del equipo.
Teniendo en cuenta estas capacidades, se puede elegir según el modo de trabajo:
| Modo de trabajo | Combinación recomendada | Motivo |
|---|---|---|
| Programación diaria de una sola tarea | Claude Code o Codex | Son productos consolidados, fáciles de empezar a usar y no requieren desplegar un sistema de planificación |
| Varias tareas independientes en paralelo | Claude Code Agent Teams / agentes en segundo plano, Codex Worktrees / tareas en la nube | Ya cuentan con mecanismos maduros de paralelismo y aislamiento |
| Investigación sobre escucha continua de eventos y enrutamiento unificado | Prototipo de DeepSeek Super-agent | Muestra de forma directa el diseño de un Router permanente y la suscripción a eventos |
| Sistema propio de orquestación de agentes | Prototipo de código abierto + API de varios modelos | Permite personalizar la lógica de planificación y el reparto de funciones entre modelos |
| Repositorios de producción sensibles | Por ahora, no se recomienda usar directamente el prototipo de investigación | La ejecución con privilegios elevados y los problemas de seguridad aún necesitan mejoras |
🎯 Recomendación: las combinaciones de herramientas no son excluyentes. Muchos equipos pueden usar Claude Code o Codex para la programación diaria y una capa de planificación propia para gestionar eventos y enrutamiento. Al crear esa capa, puedes obtener primero una cuota gratuita de prueba a través de APIYI apiyi.com y comparar cómo funcionan distintos modelos como Router y Worker.
Cómo reproducir la idea del Router de DeepSeek Super-agent con una API
La mejor forma de entender un sistema de coordinación es crear una versión mínima. El siguiente ejemplo usa una interfaz compatible con OpenAI para que un modelo ligero tome decisiones de enrutamiento. Solo sirve para ilustrar la idea y no representa el código real del prototipo de DeepSeek:
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # APIYI OpenAI 兼容接口
)

event = "PR #42 评论:CI 在 test_auth.py 失败,请帮忙看看"
resp = client.chat.completions.create(
    model="ROUTER_MODEL",  # 替换为控制台中可用的轻量模型名
    messages=[{"role": "user", "content": f"判断该事件是否需要建任务,只回答 YES/NO:{event}"}]
)
print(resp.choices[0].message.content)
Ver el ejemplo completo de código Router + Worker
import openai
from dataclasses import dataclass, field

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # 一个 Key 接入多家模型
)

ROUTER_MODEL = "ROUTER_MODEL"   # 轻量模型:负责路由判断
WORKER_MODEL = "WORKER_MODEL"   # 强模型:负责具体任务
AUTHORIZED_USERS = {"alice", "bob"}  # 确定性规则:授权名单

@dataclass
class Ticket:
    thread_id: str
    task: str
    history: list = field(default_factory=list)

tickets: dict[str, Ticket] = {}

def router_eval(event: dict) -> bool:
    """先规则过滤,再由模型判断是否建任务"""
    if event["user"] not in AUTHORIZED_USERS:
        return False  # 未授权:仅观察,不执行
    resp = client.chat.completions.create(
        model=ROUTER_MODEL,
        messages=[
            {"role": "system", "content": "你是任务路由器,只回答 YES 或 NO。"},
            {"role": "user", "content": f"该消息是否是需要执行的工作请求?\n{event['text']}"}
        ],
        max_tokens=5
    )
    return "YES" in resp.choices[0].message.content.upper()

def worker_run(ticket: Ticket, text: str) -> str:
    """Worker 使用独立上下文处理任务"""
    ticket.history.append({"role": "user", "content": text})
    resp = client.chat.completions.create(
        model=WORKER_MODEL,
        messages=[{"role": "system", "content": "你是代码修复助手,给出修复思路。"}] + ticket.history
    )
    answer = resp.choices[0].message.content
    ticket.history.append({"role": "assistant", "content": answer})
    return answer

def handle(event: dict) -> str:
    tid = event["thread_id"]
    # 订阅直通:已有 Ticket 的后续事件直接交给对应 Worker
    if tid in tickets:
        return worker_run(tickets[tid], event["text"])
    if router_eval(event):
        tickets[tid] = Ticket(thread_id=tid, task=event["text"])
        return worker_run(tickets[tid], event["text"])
    return "已记录,未建任务"

print(handle({"thread_id": "pr-42", "user": "alice", "text": "CI 在 test_auth.py 失败"}))
print(handle({"thread_id": "pr-42", "user": "alice", "text": "补充:只在 Python 3.12 下失败"}))
Este ejemplo muestra tres ideas: las reglas deterministas se aplican antes de la decisión del modelo, el Router y el Worker usan modelos distintos y los eventos posteriores de un mismo hilo entran directamente en el contexto del Worker existente. Un sistema real también necesita aislamiento de directorios de trabajo, entornos aislados para controlar permisos, persistencia de estado y revisión humana; aspectos que todavía se están perfeccionando en el prototipo.
🚀 Primeros pasos: para ejecutar el código anterior, solo tienes que sustituir la clave API y los nombres de los modelos. Puedes consultar la lista de modelos disponibles en la consola de APIYI en apiyi.com. Los nuevos usuarios tienen una cuota gratuita de prueba, ideal para validar la idea de coordinación con poco gasto antes de decidir si invertir en desarrollo adicional.
Preguntas frecuentes FAQ
Q1: ¿DeepSeek Super-agent es un modelo nuevo?
No. Super-agent es una arquitectura de sistema de agentes que funciona por encima del modelo. Lo que se ha publicado como código abierto es un prototipo de investigación basado en DeepSeek Harness. No exige usar un modelo específico de DeepSeek: tanto para el Router como para el Worker se pueden elegir el proveedor y el modelo en la configuración.
Q2: ¿DeepSeek Super-agent reemplazará a Claude Code y Codex?
Por ahora no hay motivos para afirmarlo. Los tres operan en niveles distintos: Claude Code y Codex son productos maduros de agentes de programación, mientras que Super-agent se centra en la coordinación continua desde una capa externa. Hasta el 2 de noviembre, tampoco se habían publicado comparativas de programación a gran escala y en las mismas condiciones. Los experimentos sintéticos oficiales no sirven para comparar el rendimiento de los tres.
Q3: ¿Claude Code y Codex pueden ejecutar tareas en segundo plano y activadas por eventos?
Sí. Claude Code cuenta con GitHub Actions, Channels en vista previa de investigación, agentes en segundo plano y tareas programadas en la nube. El ecosistema de Codex ofrece tareas en la nube, Worktrees, tareas programadas en segundo plano y automatizaciones activadas por eventos en aplicaciones compatibles. La diferencia está en los puntos de acceso, los requisitos y los mecanismos de implementación, no en si disponen o no de estas funciones.
Q4: ¿El prototipo de DeepSeek Super-agent es gratuito?
El código es gratuito y de código abierto bajo la licencia MIT, pero la invocación del modelo sigue cobrándose por token. También hay costos de servidor, mantenimiento y revisión humana. Que sea de código abierto no significa que el costo total de cada tarea sea menor. Si quieres gestionar de forma centralizada los gastos de API de varios modelos, puedes usar APIYI apiyi.com con pago por uso y consultar el consumo en un solo lugar.
Q5: ¿Cómo probar a bajo costo la distribución de tareas entre varios modelos con Router + Worker?
Puedes usar como referencia el código de ejemplo de este artículo, configurar `base_url` como `https://api.apiyi.com/v1` y dejar que un modelo ligero se encargue del enrutamiento y uno más potente de la ejecución. Al registrarte en APIYI apiyi.com, obtienes crédito gratuito para pruebas y puedes usar una sola clave API para alternar entre modelos populares como OpenAI, Claude y Gemini y compararlos.
Q6: ¿Qué limitaciones conocidas tiene el prototipo de DeepSeek Super-agent?
Por ahora solo permite monitorizar un repositorio de github.com y no es compatible con GitHub Enterprise Server. Para desplegarlo se necesitan Node.js 22.19+ o 24+, tmux, GitHub CLI 2.48+ y una cuenta de bot dedicada. El Worker se ejecuta de forma predeterminada con privilegios elevados, lo que implica riesgos de inyección de indicaciones y de exposición de credenciales. La comunidad también ha reportado problemas como la pérdida de notificaciones y la compatibilidad con Node.js 24. No se recomienda usarlo directamente en repositorios de producción sensibles.
DeepSeek Super-agent frente a Claude Code y Codex: puntos clave
- Distintos niveles: Super-agent es un prototipo de sistema de orquestación; Claude Code y Codex son productos de agentes de programación.
- Los sistemas multiagente no son exclusivos: Claude Code y Codex ya ofrecen subagentes, sesiones paralelas y capacidades para tareas en segundo plano y eventos.
- La diferencia está en la sistematización: el Router permanente, el enrutamiento entre tareas, el acceso directo mediante suscripción y el contexto unificado son los puntos clave del diseño.
- Los datos experimentales tienen límites: el experimento sintético solo refleja el rendimiento de la orquestación; no demuestra la calidad del código ni establece una clasificación entre los tres.
- Velocidad a cambio de tokens: las lecturas de caché son aproximadamente 3,8 veces mayores que en una solución de sesión única. El costo debe calcularse según la combinación de modelos.
- La seguridad debe contemplarse desde el inicio: ejecutar el sistema con privilegios elevados y el riesgo de inyección a través de entradas externas exigen cuentas independientes y revisión humana.
- Probarlo es más fiable: con una sola clave de APIYI apiyi.com puedes experimentar con varios modelos en los roles de Router y Worker.
Resumen
Las conclusiones principales de la comparación entre DeepSeek Super-agent, Claude Code y Codex son:
- La primera diferencia es el nivel: las capacidades del modelo, las de la herramienta de programación y las del sistema de orquestación son tres cosas distintas. Compararlas como si fueran lo mismo no tiene sentido.
- El valor de DeepSeek está en el diseño de la orquestación: sistematiza la escucha permanente, el enrutamiento entre tareas y el contexto unificado, y limita la proactividad mediante permisos y el modo observe.
- La diferencia de madurez es real: el prototipo ya cuenta con casos reales que van de Issue a PR, pero aún debe mejorar en instalación, fiabilidad y seguridad. Claude Code y Codex siguen siendo opciones más seguras para programar a diario.
La competencia en programación con IA está pasando de «qué modelo es más potente» a una comparación más amplia que incluye Agent Harness, flujos de trabajo y experiencia de desarrollo. Para la mayoría de los equipos, lo más práctico es usar productos maduros para la programación diaria y, al mismo tiempo, probar a pequeña escala una capa de orquestación propia.
Una opción es usar APIYI apiyi.com para acceder de forma unificada a modelos de distintos proveedores y comprobar rápidamente su rendimiento y costo en los roles de Router y Worker.
📚 Referencias
- Repositorio oficial del prototipo DeepSeek Super-agent: estado del proyecto, código fuente y alcance de uso
- Enlace:
github.com/deepseek-ai/dsh-superagent-prototype -
Descripción: incluye el README, la documentación de despliegue y documentos sobre el mecanismo de autorización y la filosofía de diseño
-
Precios oficiales de DeepSeek API: precios de los modelos y costos de Search/Fetch
- Enlace:
api-docs.deepseek.com/quick_start/pricing -
Descripción: base para calcular los costos de los modelos Router/Worker
-
Documentación de Claude Code Subagents y Agent Teams: capacidades multiagente
- Enlaces:
code.claude.com/docs/en/sub-agents,code.claude.com/docs/en/agent-teams -
Descripción: explica los contextos independientes de los subagentes y los mecanismos de colaboración en equipo
-
Documentación de Claude Code Channels y tareas programadas: envío de eventos y ejecución continua
- Enlaces:
code.claude.com/docs/en/channels,code.claude.com/docs/en/scheduled-tasks -
Descripción: explica las condiciones de uso y las limitaciones de las funciones en vista previa de investigación
-
Documentación de Codex Cloud y Worktrees: tareas en la nube y espacios de trabajo paralelos
- Enlaces:
help.openai.com/en/articles/20001545-using-codex-cloud,learn.chatgpt.com/docs/environments/git-worktrees -
Descripción: fuente oficial para distinguir las funciones del producto Codex
-
Guía multiagente de OpenAI Agents API: orquestación multiagente a nivel de API
- Enlace:
developers.openai.com/api/docs/guides/agents-api/multi-agent -
Descripción: conviene consultarla por separado de las funciones del producto Codex
-
Debate de la comunidad sobre pruebas de DeepSeek Harness: informe de extremo a extremo, desde el issue hasta el PR
- Enlace:
github.com/deepseek-ai/deepseek-harness/discussions/11706 - Descripción: permite conocer el funcionamiento real del prototipo y los problemas frecuentes
Autor: Equipo técnico de APIYI
Contacto técnico: Puedes contactarnos desde la página principal del sitio oficial de APIYI. Para más recursos sobre integración de múltiples modelos y orquestación de agentes, visita el centro de documentación en docs.apiyi.com