Autorenhinweis: Wir vergleichen die von MiniMax veröffentlichten Zahlen Punkt für Punkt mit den unabhängigen Testergebnissen von Vals. So kannst du einschätzen, ob MiniMax M3.1 Flash für dich geeignet ist – und wann du besser nicht wechselst.
Kurz gesagt: MiniMax M3.1 Flash ist günstig und schnell und eignet sich besonders für Büroautomatisierung sowie Agent-Aufgaben in den Bereichen Bildverarbeitung, Finanzen und Steuern. Bei Aufgaben mit langen Prozessketten und großen Code-Refactorings liegt das Modell jedoch deutlich hinter den Spitzenmodellen von Claude zurück. Es eignet sich für die Übernahme vieler klar geregelter Aufgaben, aber nicht als Ersatz für dein Hauptmodell bei den schwierigsten Aufgaben.
Zum Umfang dieses Artikels: Mit „Praxistest“ im Titel ist eine Zusammenfassung öffentlich verfügbarer Tests von Drittanbietern gemeint, vor allem von Vals AI. Wir haben selbst keine Benchmarks durchgeführt, und der Artikel enthält keine eigenen Testergebnisse. Bei allen Zahlen ist die Quelle angegeben. Sie sind in drei Kategorien unterteilt: „offizielle Angaben“ (von MiniMax veröffentlicht), „Tests von Drittanbietern“ (etwa von Vals) und „unbekannt/nicht veröffentlicht“.
Der Mehrwert für dich: Nach der Lektüre weißt du, bei welchen Punkten die offiziellen und die unabhängigen Zahlen voneinander abweichen und wo die Stärken und Schwächen von MiniMax M3.1 Flash liegen. Außerdem erhältst du eine Checkliste für einen 30-minütigen Selbsttest, mit der du entscheiden kannst, ob sich ein Modellwechsel für deine Aufgaben lohnt.
MiniMax M3.1 Flash: Die wichtigsten Funktionen im Überblick
Zunächst ein paar grundlegende Begriffe: Token ist die Einheit, nach der Modelle abgerechnet werden und die ihre Eingabelänge misst. Laut offizieller Umrechnung entsprechen etwa 750 englische Wörter ungefähr 1.000 Tokens. Ein Agent ist eine Art, ein Modell zu nutzen, bei der es selbstständig Tools aufrufen und Aufgaben in mehreren Schritten erledigen kann – zum Beispiel Formulare automatisch ausfüllen, Befehle in der Kommandozeile ausführen oder Informationen recherchieren und anschließend einen Bericht verfassen. Das Kontextfenster bezeichnet die maximale Länge des Inhalts, den ein Modell auf einmal „sehen“ kann.
Alle Angaben in der folgenden Tabelle stammen aus der offiziellen Dokumentation und der Preisseite von MiniMax und sind somit Angaben des Anbieters.
| Punkt | Offizielle Angaben zu MiniMax M3.1 Flash | Erläuterung |
|---|---|---|
| Modellname | MiniMax-M3.1-Flash | Der frühere Name MiniMax-M3.1-Flash-Preview wurde eingestellt. Anfragen mit dem alten Namen werden automatisch an das neue Modell weitergeleitet. |
| Architektur | MoE, insgesamt 428B Parameter, davon etwa 23B aktiviert | Wie bei M3; MiniMax hat noch keinen technischen Bericht zu den Änderungen an Flash veröffentlicht. |
| Kontextfenster | 1.000.000 Tokens | Auf der Vals-Seite ist eine maximale Ausgabe von 524.288 Tokens angegeben. |
| Ein- und Ausgabe | Text-, Bild- und Videoeingabe, Textausgabe | Unterstützt multimodales Verständnis. |
| Denkaufwand (effort) | low / medium / high / xhigh / max | Ohne Angabe ist standardmäßig max eingestellt. |
| Preis (pro Million Tokens) | Eingabe: 0,15 $, Ausgabe: 0,60 $, Cache-Lesezugriffe: 0,015 $ | Kein Aufpreis für lange Kontexte. |
| Open-Source-Gewichte | Laut einem offiziellen X-Beitrag sollen sie am 23. Oktober veröffentlicht werden. | Zum Zeitpunkt der Veröffentlichung (22. Oktober) waren sie noch nicht verfügbar. |
MoE (Mixture of Experts, „Mischung aus Experten“) ist eine Modellarchitektur, bei der das Modell insgesamt sehr viele Parameter hat, aber pro Anfrage nur eine kleine Auswahl seiner „Experten“ für die Berechnung heranzieht. So lässt sich eine große Modellkapazität mit kontrollierbaren Inferenzkosten verbinden. Cache-Lesezugriffe beziehen sich auf wiederholt auftretende Eingabeinhalte – etwa eine feste System-Eingabeaufforderung –, die aus dem Cache abgerufen und deshalb günstiger abgerechnet werden.
Der Denkmechanismus von MiniMax M3.1 Flash: reduzieren, aber nicht abschalten
Das ist eine der häufigsten Stolperfallen beim Umstieg von M3. Die Denkfunktion von M3.1 Flash lässt sich nicht abschalten: Wird in einer Anfrage thinking disabled oder effort none übergeben, gibt die Schnittstelle direkt einen 400-Fehler zurück. Der genaue Fehlertext lautet model "MiniMax-M3.1-Flash" requires adaptive thinking. Wer Zeit und Tokens sparen möchte, kann den effort-Wert nur herabsetzen.
Je höher die effort-Stufe, desto ausführlicher denkt das Modell, desto mehr Ausgabetokens erzeugt es und desto höher ist die Latenz. Die Parameternamen unterscheiden sich je nach Protokoll: Im Anthropic-Protokoll lautet der Parameter output_config.effort, im OpenAI-Protokoll reasoning_effort und im Responses-Protokoll reasoning.effort. Außerdem wird der Denkinhalt jetzt separat zurückgegeben. Im OpenAI-kompatiblen Protokoll steht er im Feld reasoning_content; das Feld content enthält nur die endgültige Antwort. Wenn du den Denkinhalt bisher bei M3 aus den <think>-Tags herausgelöst hast, musst du diesen Teil deines Codes anpassen.
🚀 Empfehlung für den schnellen Einstieg: Zum Zeitpunkt der Veröffentlichung ist MiniMax-M3.1-Flash noch nicht auf der APIYI-Preisseite aufgeführt. Wir werden das Modell so bald wie möglich bereitstellen. Ob du es aufrufen kannst, entnimmst du bitte der APIYI-Preisseite. Wenn du dich zunächst mit dem Schnittstellenformat der MiniMax-Modelle vertraut machen möchtest, kannst du MiniMax M3 direkt über APIYI auf apiyi.com aufrufen. Das Modell unterstützt sowohl das OpenAI- als auch das Anthropic-Schnittstellenformat und ist außerdem in der ClaudeCode-Gruppe verfügbar.
MiniMax M3.1 Flash im Praxistest: offizielle Angaben vs. unabhängige Benchmarks
Benchmarks bewerten Modelle anhand eines festen Aufgabensatzes. Selbst bei identischem Testnamen können die Ergebnisse je nach Testanbieter und Ausführungsumgebung stark voneinander abweichen. Bevor Sie die Zahlen vergleichen, sollten Sie deshalb prüfen, wer den Test durchgeführt hat und unter welchen Bedingungen.
| Test | Ergebnis | Quelle | Testbedingungen / Anmerkungen |
|---|---|---|---|
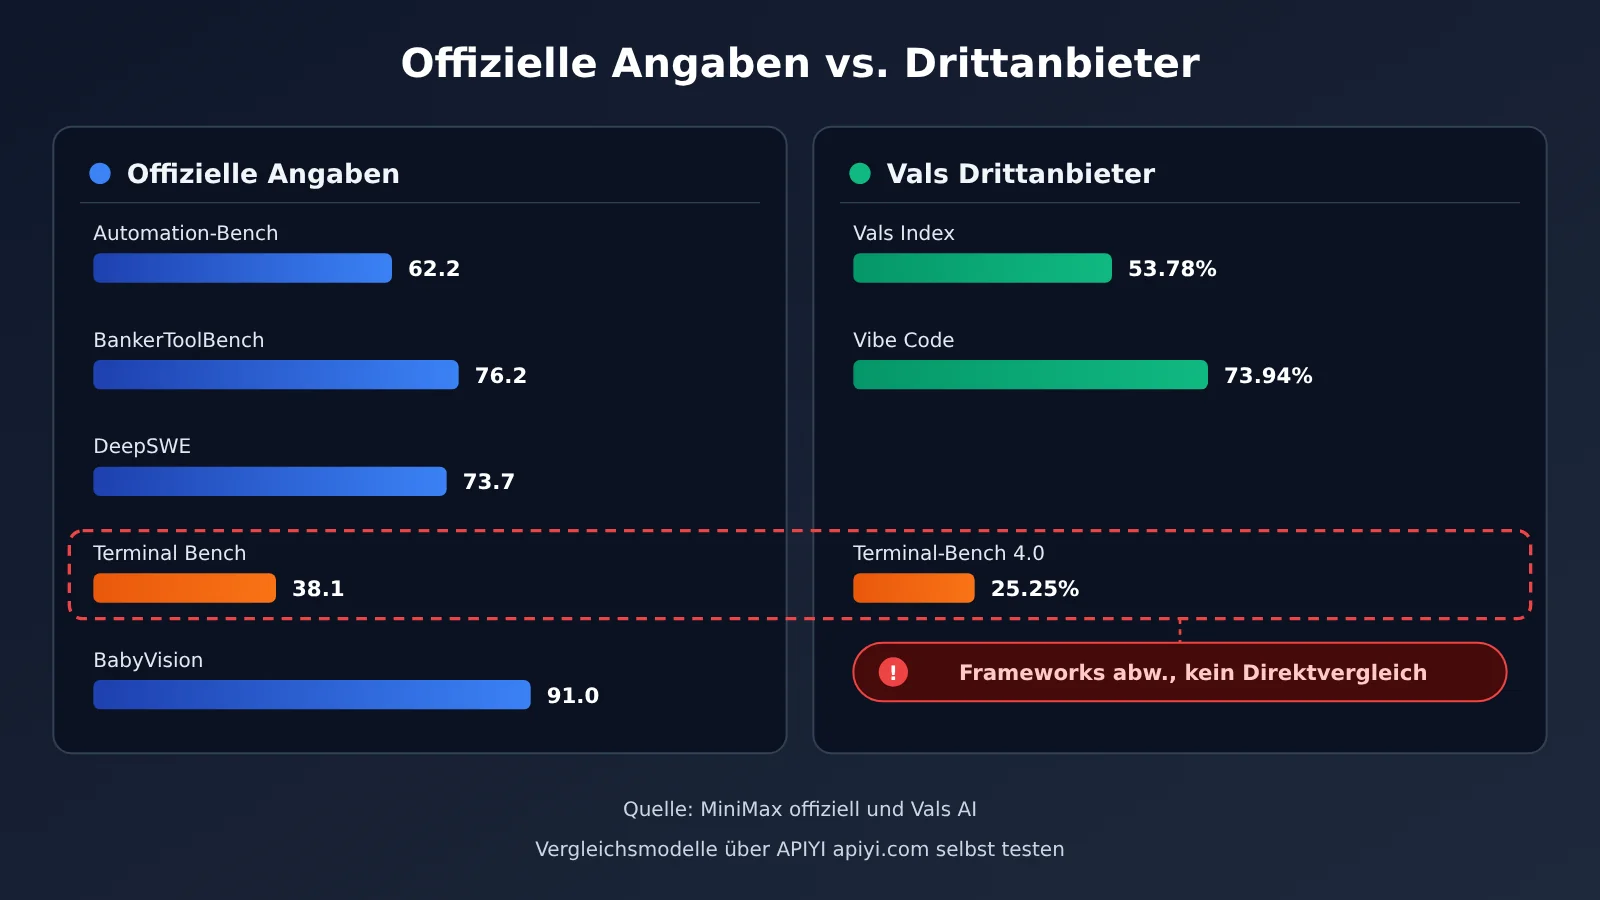
| Automation-Bench v1.0.6 | 62.2 (Opus 5: 50.3) | Offizielle Angaben | Offizielle Tabelle; in der offiziellen Kostengrafik erreicht die max-Stufe 62.8 |
| BankerToolBench | 76.2 (gleichauf mit Opus 5) | Offizielle Angaben | Aufgaben zum Einsatz von Tools im Bankwesen |
| DeepSWE v1.1 | 73.7 % (DeepSeek V4.1 Flash-1017: 77.0) | Offizielle Angaben | In der offiziellen Tabelle liegt ein Vergleichsmodell vorn |
| OSWorld V2 | 61.7 | Offizielle Angaben | Laut Hersteller das führende chinesische Modell |
| Agents‘ Last Exam (ALE) | 29.6 | Offizielle Angaben | Laut Hersteller das führende chinesische Modell |
| CyberGym | 82 % | Offizielle Angaben | Aufgaben aus dem Bereich Sicherheit |
| Terminal Bench 4.0 | 38.1 (Opus 5: 51.8) | Offizielle Angaben | 13.7 Punkte hinter Opus 5 |
| SWE Refactor Bench | 23.0 (Opus 5: 31.0) | Offizielle Angaben | Aufgaben zur Code-Refaktorierung |
| BabyVision (mit Tools) | 91.0 | Offizielle Angaben | Visuelles Verständnis |
| HLE (ohne Tools) | 43.4 | Offizielle Angaben | Anspruchsvolle Fragen aus verschiedenen Bereichen |
| Vals Index | 53.78 %, Platz 15 von 22 Modellen | Unabhängiger Test von Vals | Platz 5 unter 11 Modellen mit offenen Gewichten, knapp hinter Xiaomis MiMo V2.6 Flash (54.83 %) |
| Terminal-Bench 4.0 | 25.25 %, Platz 22 von 51 Modellen | Unabhängiger Test von Vals | Offizielle API, temperature 1, top_p 0.95, effort max, maximale Ausgabe 262k |
| HLAB-Vals-1.1 | 7.50 %, Platz 17 von 23 Modellen | Unabhängiger Test von Vals | Wie oben |
Wichtig: In der offiziellen Tabelle vergleicht Anthropic mit Claude Opus 5, nicht mit Opus 5.5. Claude Opus 5.5 ist derzeit weiterhin Anthropics leistungsstärkstes Flaggschiffmodell; MiniMax hat es in den offiziellen Angaben nicht für einzelne Tests als Vergleich herangezogen. Behauptungen wie „M3.1 Flash holt zu Opus 5.5 auf“ sind daher nicht belegt.
4 Stellen, an denen die Zahlen zu MiniMax M3.1 Flash nicht zusammenpassen
- Terminal Bench: offiziell 38,1 gegenüber 25,25 % bei Vals. Beide Seiten sprechen von Terminal-Bench 4.0, verwenden aber unterschiedliche Test-Frameworks. Ein Test-Framework stellt dem Modell die Ausführungsumgebung und den Scheduler bereit. Es beeinflusst direkt, ob das Modell mehrstufige Befehle erfolgreich ausführen kann. Deshalb lassen sich die beiden Zahlen nicht direkt vergleichen. Man kann also auch nicht behaupten, „die offiziellen Angaben seien um 13 Punkte geschönt“. Zu einem übereinstimmenden Ergebnis kommen beide Seiten dennoch: Lange Aufgaben im Terminal sind eine Schwäche von M3.1 Flash. In der offiziellen Tabelle liegt das Modell hinter Opus 5, und auch in Vals’ Rangliste befindet es sich im Mittelfeld der 51 Modelle.
- Automation-Bench: 62,8 in der Kostengrafik gegenüber 62,2 in der Tabelle. Im selben offiziellen Material tauchen zwei verschiedene Werte auf. Die Abweichung von 0,6 Punkten ändert wenig an der Schlussfolgerung. Sie zeigt aber, dass auch die offiziellen Unterlagen nicht ganz konsistent sind. Beim Zitieren empfiehlt es sich daher, den Tabellenwert zu verwenden und die Quelle anzugeben.
- Kosten: „70 % niedriger“, „ein Drittel“ und „die Hälfte“. Im offiziellen Blog heißt es, die Gesamtkosten für Agent-Aufgaben seien im Vergleich zur Vorgängergeneration um 70 % gesunken. In einem offiziellen X-Beitrag ist dagegen von einem Drittel der Kosten von M3 die Rede. Betrachtet man nur den Tokenpreis, kostet Flash die Hälfte des Standardpreises von M3 (0,15 $ gegenüber 0,30 $). Laut offizieller Aussage beziehen sich die Angaben auf die Kosten pro Aufgabe; wie genau diese berechnet werden, wurde nicht veröffentlicht.
- Geschwindigkeit: über 170, über 200 und etwa 150. Darauf geht der nächste Abschnitt genauer ein.
So lässt sich die Geschwindigkeit von MiniMax M3.1 Flash einschätzen: Alle TPS-Angaben stammen vom Hersteller
TPS (Tokens pro Sekunde) gibt an, wie viele Tokens ein Modell pro Sekunde ausgibt. Je höher der Wert, desto schneller erzeugt es Text. P50 bezeichnet den Median: Sortiert man die Geschwindigkeit aller Anfragen von niedrig nach hoch, liegt der P50 genau in der Mitte. Dieser Wert ist aussagekräftiger als der Durchschnitt, wenn es darum geht, die „typische“ Geschwindigkeit einzuschätzen.
Alle bislang veröffentlichten Geschwindigkeitsangaben stammen von MiniMax selbst. Unabhängige Messungen durch Dritte sind nicht auffindbar:
- Offizieller Blog: Im Alltag sind mehr als 200 TPS möglich, der P50 liegt stabil bei über 170 TPS.
- Offizielle Produktseite: etwa 150 Tokens pro Sekunde.
- Offizieller Blog und X-Beiträge: Die Geschwindigkeit der Online-Inferenz ist etwa dreimal so hoch wie bei M3.
Die Angaben beruhen auf unterschiedlichen Messgrundlagen. Die Formulierung auf der Produktseite ist eher konservativ. Noch wichtiger: Eine hohe TPS-Zahl bedeutet nicht automatisch, dass die Antwort schnell kommt. Bei M3.1 Flash ist der Effort standardmäßig auf „max“ eingestellt. Auch Tokens, die beim Nachdenken ausgegeben werden, zählen mit. Muss das Modell für eine Aufgabe erst „nachdenken“ und dabei mehrere Tausend Tokens erzeugen, kann es trotz 170 TPS eine Weile dauern, bis die endgültige Antwort vorliegt. Für das tatsächliche Geschwindigkeitserlebnis kommt es auf „ausgegebene Tokens insgesamt ÷ TPS + Wartezeit bis zum ersten Token“ an. Deshalb empfiehlt die Checkliste für eigene Tests weiter unten, sowohl die Tokenzahl als auch die benötigte Zeit zu erfassen.
Leistungsgrenzen von MiniMax M3.1 Flash: Stärken und Schwächen
Zunächst ein Blick auf die von Vals dokumentierten Verbesserungen gegenüber der Vorgängerversion M3. Alle folgenden Werte stammen aus Drittanbieter-Benchmarks.
| Vals-Test | M3.1 Flash | M3 | Veränderung |
|---|---|---|---|
| Vibe Code Bench | 73.94 % | 47.57 % | Deutliche Verbesserung |
| Tax Agent Bench | 32.14 % | 20.59 % | Spürbare Verbesserung |
| EMB v1.1 | 67.84 % | 59.75 % | Verbesserung |
| Finance Agent v2.1 | 58.83 % | 54.34 % | Leichte Verbesserung |
| Legal Research Bench | 34.13 % | 29.81 % | Leichte Verbesserung |
| Dimension | Einschätzung | Begründung |
|---|---|---|
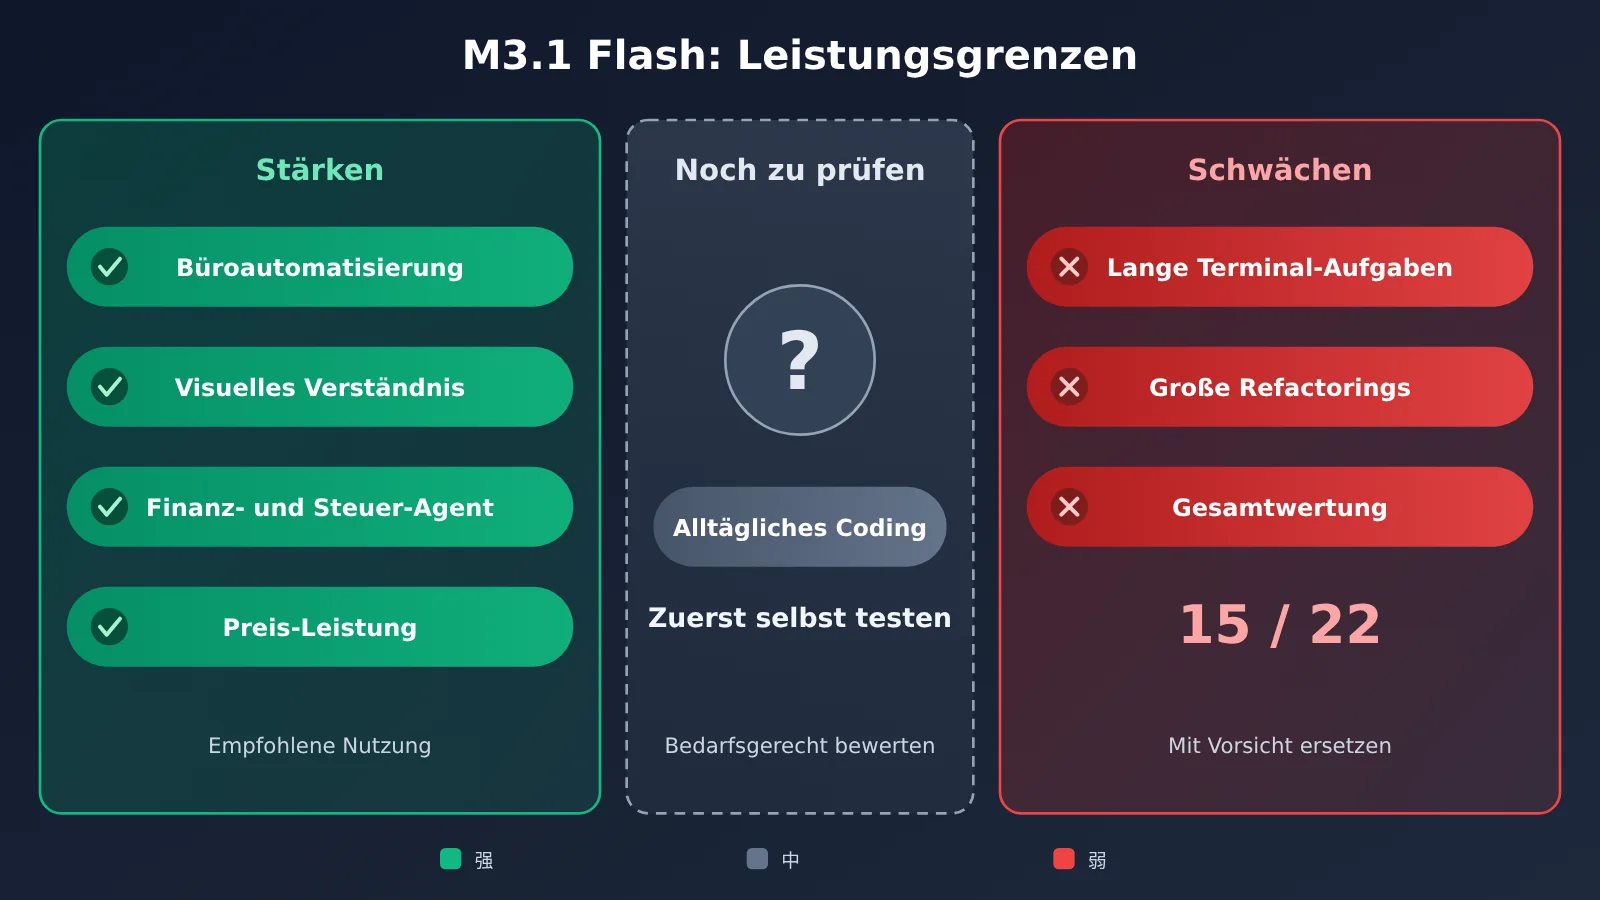
| Agenten für Büroautomatisierung | Stark | Offizieller Wert: Automation-Bench 62.2 (Opus 5: 50.3), OSWorld V2: 61.7 |
| Visuelles Verständnis | Stark | Offizieller Wert: BabyVision (mit Tools) 91.0; unterstützt Bild- und Videoeingaben |
| Agenten für Finanz- und Steueraufgaben | Ziemlich stark | Offizieller Wert: BankerToolBench 76.2; bei den Vals-Steuer- und Finanztests besser als M3 |
| Preis-Leistungs-Verhältnis | Stark | Offizieller Preis: halb so hoch wie der Standardpreis von M3, ohne Aufpreis für lange Kontexte |
| Langwierige Terminalaufgaben | Schwach | Im offiziellen Terminal Bench liegt das Modell 13.7 Punkte hinter Opus 5; im Vals Terminal-Bench 4.0 belegt es Rang 22 von 51 Modellen |
| Umfangreiche Code-Refactorings | Schwach | Offizieller Wert: SWE Refactor Bench 23.0; Opus 5 erreicht 31.0 |
| Gesamtleistung | Mittelfeld | Rang 15 von 22 Modellen im Vals Index |
Stärken auf einen Blick
- Niedriger Preis, einfache Abrechnung: 0,15 $ für Eingaben und 0,60 $ für Ausgaben. Bis zu einem Kontextfenster von 1M gilt ein einheitlicher Preis – ideal für Aufrufe in großem Umfang.
- Stark bei Büro- und visuellen Agenten: Bei Aufgaben wie Tabellen aufbereiten, Webseiten bedienen und Bilder erkennen, kommen offizielle Tests und Drittanbieter-Benchmarks zu ähnlichen Ergebnissen.
- Deutlicher Fortschritt gegenüber M3: Im Vibe Code Bench von Vals stieg der Wert von 47.57 % auf 73.94 %. Damit hat sich das Modell bei der Entwicklung kleiner Alltagsanwendungen deutlich verbessert.
Einschränkungen auf einen Blick
- Bei komplexen Entwicklungsaufgaben noch mit Rückstand: Bei mehrstufigen Aufgaben in der Kommandozeile und umfangreichen Änderungen über mehrere Dateien hinweg liegt das Modell laut den offiziellen Benchmarks hinter Opus 5.
- Der Denkmodus lässt sich nicht deaktivieren: Auch kurze Fragen und Antworten durchlaufen den Denkprozess. Das ist für Anwendungen ungünstig, bei denen eine geringe Verzögerung bis zum ersten Token wichtig ist.
- Mangelnde Transparenz: Die offizielle Kostenberechnung und der technische Bericht wurden noch nicht veröffentlicht. Die Angabe „ein Drittel der Kosten“ lässt sich daher vorerst nicht unabhängig überprüfen.
Wann Sie nicht zu MiniMax M3.1 Flash wechseln sollten
In den folgenden sechs Fällen sollten Sie Ihr Hauptmodell besser noch nicht durch M3.1 Flash ersetzen – oder zumindest erst eigene Tests durchführen:
- Ihre Hauptaufgabe ist ein Agent für lange Terminal-Prozesse: etwa CI-Pipelines automatisch auszuführen, Probleme auf Servern zu untersuchen oder Dutzende Befehle nacheinander auszuführen. Sowohl die offiziellen Daten als auch die von Vals weisen hier auf Schwächen hin. Wenn Claude Opus 5.5 bei Ihnen zuverlässig läuft, dürften die Kosten für Nacharbeit durch einen Modellwechsel die eingesparten Token-Kosten leicht übersteigen.
- Sie führen häufig umfangreiche Refactorings durch: Bei Aufgaben wie dem Ändern von Schnittstellen über mehr als zehn Dateien hinweg oder dem Aufteilen von Modulen liegt M3.1 Flash im offiziellen SWE Refactor Bench mit 23,0 deutlich hinter Opus 5 mit 31,0. Solche Aufgaben sollten Sie weiterhin einem Spitzenmodell überlassen.
- Sie müssen den Denkmodus deaktivieren und eine extrem niedrige Latenz erreichen: Bei Echtzeit-Kundendienst, Intent-Klassifizierung oder Autovervollständigung lässt sich das Denken von M3.1 Flash nicht abschalten. Selbst im Modus „low“ müssen Sie mit einer längeren Wartezeit rechnen als bei einem Modell ohne Denkmodus.
- Ihre bestehende Integration wertet
<think>-Tags aus und eine Anpassung ist kurzfristig nicht geplant: M3.1 Flash gibt Denkinhalte in einem separaten Feld zurück. Wenn Sie einfach nur den Modellnamen ändern, kann Ihre Parsing-Logik die Daten möglicherweise nicht mehr abrufen oder sogar einen Fehler auslösen. - Sie möchten das Modell sofort lokal und privat bereitstellen: Laut offizieller Ankündigung sollen die Gewichte am 23. Oktober veröffentlicht werden. Zum Zeitpunkt der Veröffentlichung dieses Artikels sind sie jedoch noch nicht verfügbar. Auch Angaben zum benötigten VRAM und zu weiteren Anforderungen hat der Anbieter noch nicht veröffentlicht. Eine zuverlässige Hardwareplanung ist daher derzeit nicht möglich.
- Der Preis pro Token ist niedrig, pro Aufgabe aber nicht unbedingt: Im standardmäßig eingestellten Modus „max“ fallen viele Denk-Token an. Wenn Ihre Aufgaben kurze Antworten erfordern und Ihr aktuelles Modell ohnehin günstig ist, sinkt Ihre tatsächliche Rechnung durch den Wechsel möglicherweise nicht. Vergleichen Sie unbedingt die Kosten pro Aufgabe.
30-Minuten-Checkliste für deinen eigenen Test von MiniMax M3.1 Flash
Rankings zeigen nur den Durchschnitt. Entscheidend ist, wie das Modell bei deinen Aufgaben abschneidet. Mit den folgenden Schritten kannst du in 30 Minuten einen Vergleich durchführen. Als Testzugang eignen sich die offizielle MiniMax-API oder der kostenlose, allerdings ratenbegrenzte Endpunkt minimax/minimax-m3.1-flash:free auf OpenRouter.
- Aufgaben auswählen (ca. 5 Minuten): Suche dir drei Arten von Aufgaben aus deiner aktuellen Arbeit aus und wähle für jede Art drei bis fünf Beispiele. Die erste Kategorie umfasst Routineaufgaben mit klaren Regeln, etwa Tabellen aufbereiten oder Zusammenfassungen schreiben. Die zweite sind Aufgaben, die zu deinem Arbeitsalltag gehören. Die dritte umfasst schwierige Aufgaben, bei denen du dir am meisten Sorgen machst, zum Beispiel mehrstufige Terminal-Aufgaben oder Änderungen über mehrere Dateien hinweg.
- Parameter festlegen: Lass M3.1 Flash zunächst mit
mediumlaufen und wiederhole den Test anschließend mit der Standardeinstellungmax. Notiere dir jeweils die Einstellung. Verwende für das Vergleichsmodell dieselben festen Einstellungen und ändere sie nicht während des Tests. - Dieselben Aufgaben vergleichen (ca. 15 Minuten): Verwende für beide Modelle exakt dieselben Eingabeaufforderungen und denselben Kontext und teste alle Aufgaben nacheinander.
- Daten erfassen: Notiere für jede Aufgabe die Eingabe-Token, Ausgabe-Token (einschließlich des Denkprozesses), die Gesamtdauer, ob sie beim ersten Versuch erfolgreich war und wie viel du manuell nachbearbeiten musst.
- Kosten pro Aufgabe berechnen (ca. 10 Minuten): Berechne die tatsächlichen Kosten für jede Aufgabe anhand der offiziellen Formel: „Nutzung ÷ 1.000.000 × Einzelpreis“. Addiere dabei die Kosten für Eingabe, Ausgabe und Cache-Lesezugriffe.
- Fazit nach Kategorie ziehen: Wenn die Qualität für eine Aufgabenart akzeptabel ist und die Kosten pro Aufgabe niedriger sind, kannst du nur diese Aufgabenart umstellen. Wenn MiniMax bei den schwierigen Aufgaben der dritten Kategorie deutlich schlechter abschneidet, solltest du dafür weiterhin dein bisheriges Modell verwenden.
💡 Tipp zur Vergleichsgruppe: Über APIYI unter apiyi.com kannst du mit demselben API-Schlüssel
claude-opus-5-5oder MiniMax-M3 aufrufen. So musst du für einen einmaligen Vergleichstest nicht extra Konten bei mehreren Plattformen anlegen.
MiniMax-Modelle und Claude Opus 5.5 auf APIYI kombinieren
Die Positionierung von M3.1 Flash macht das Modell eher zum „Arbeitstier“ für die Massenverarbeitung im Team als zum einzigen Modell. In der Praxis ist es sinnvoll, die Aufgaben nach ihrem Schwierigkeitsgrad aufzuteilen: Günstige Aufgaben mit hohem Volumen übernimmt die MiniMax-Reihe, anspruchsvolle Planung und Refactorings Claude Opus 5.5.
| Modell | Einordnung | Geeignete Aufgaben | Verfügbare Plattformen |
|---|---|---|---|
| MiniMax-M3.1-Flash | Günstiges, schnelles Agent-Modell | Büroautomatisierung, visuelle Aufgaben, umfangreiche Finanz- und Steueraufgaben | Offizielle MiniMax-API / M Plan; ob das Modell über APIYI verfügbar ist, entnehmen Sie bitte der Preisseite |
| MiniMax-M3 | Vorgängergeneration und bisheriges Hauptmodell | Alltägliche Aufgaben auf Chinesisch, Massenverarbeitung | APIYI apiyi.com (OpenAI- und Anthropic-Format) |
| claude-opus-5-5 | Aktuell leistungsstärkstes Flaggschiffmodell von Anthropic | Komplexe Planung, umfangreiche Refactorings, Agent-Aufgaben mit langen Ablaufketten | APIYI apiyi.com |
| claude-opus-5 | Flaggschiffmodell der Vorgängergeneration | Vergleichsmodell in den offiziellen Benchmark-Tabellen | APIYI apiyi.com |
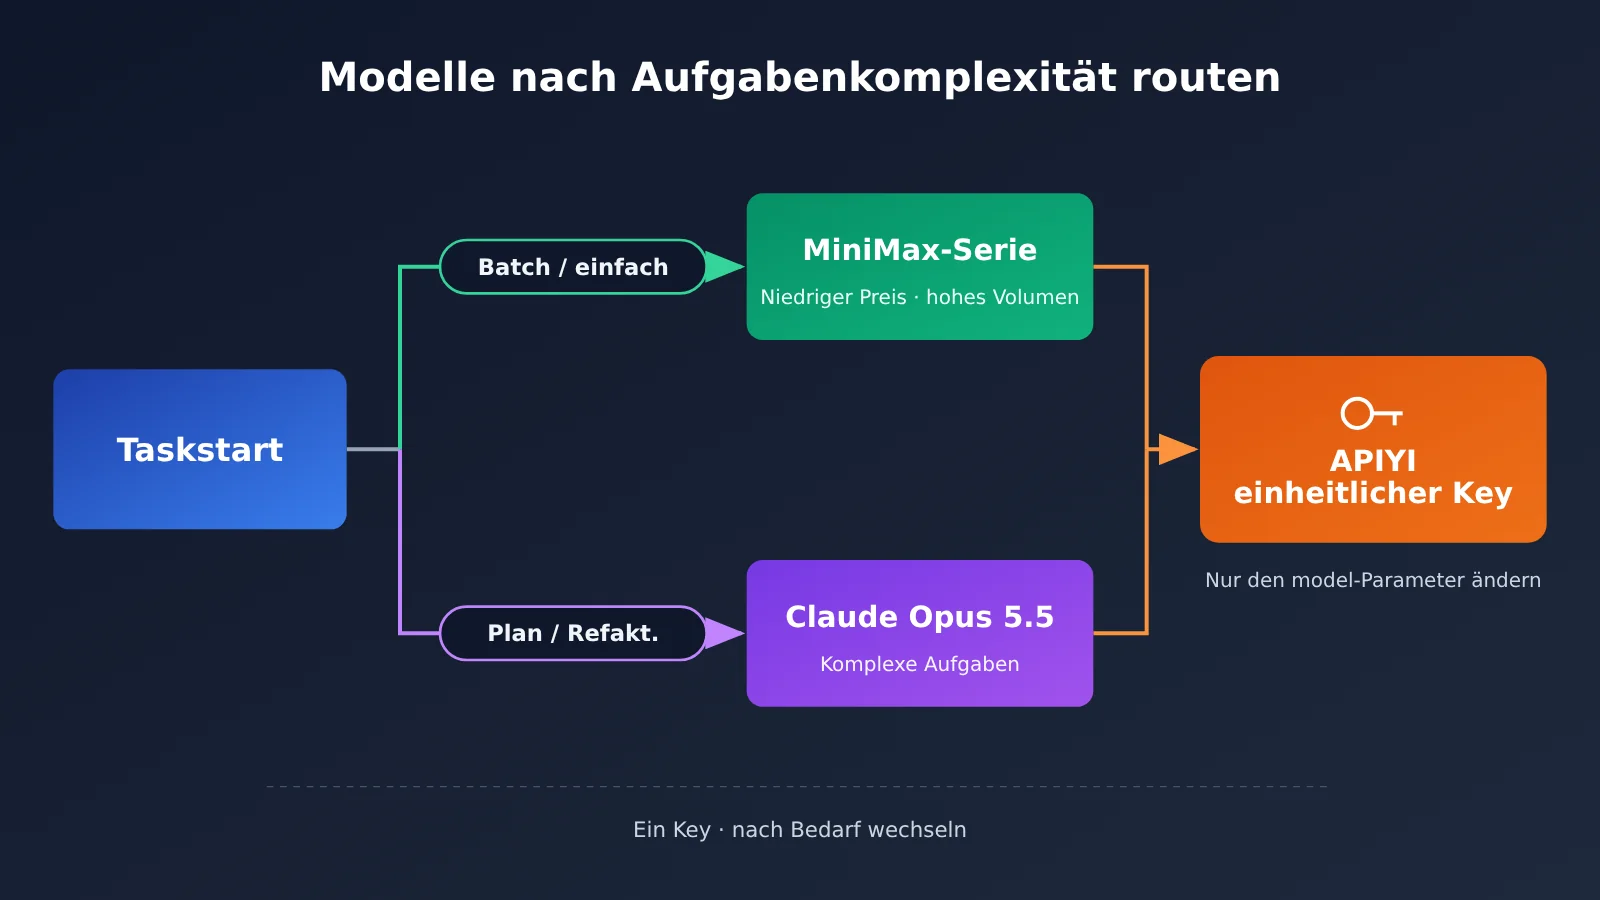
Über APIYI können Sie mit einem einzigen Schlüssel Claude, GPT, Gemini und weitere internationale Modelle sowie in China entwickelte Modelle wie DeepSeek und MiniMax aufrufen. Um das Modell zu wechseln, müssen Sie lediglich den Parameter model ändern:
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_APIYI_KEY",
    base_url="https://api.apiyi.com/v1"  # APIYI-Schnittstelle
)

def ask(model, prompt):
    resp = client.chat.completions.create(
        model=model,
        messages=[{"role": "user", "content": prompt}],
    )
    return resp.choices[0].message.content

# Günstige Aufgaben mit hohem Volumen übernimmt die MiniMax-Reihe
print(ask("MiniMax-M3", "把这段会议纪要整理成 5 条待办"))

# Anspruchsvolle Planung und Refactorings übernimmt Claude Opus 5.5
print(ask("claude-opus-5-5", "为这个单体服务设计分阶段拆分方案"))
Laut der veröffentlichten Preisliste von APIYI kostet claude-opus-5-5 4 $ für Eingaben und 20 $ für Ausgaben pro einer Million Tokens. Für claude-opus-5 liegen die Preise bei 5 $ beziehungsweise 25 $. Sollte MiniMax-M3.1-Flash später auf der Preisseite von APIYI aufgeführt werden, verwenden Sie einfach den dort angegebenen Modellnamen und Preis.
Häufige Fragen (FAQ)
F1: Was sind die Stärken von MiniMax M3.1 Flash?
Laut den Angaben des Herstellers und den Ergebnissen von Vals liegen die Stärken bei der Automatisierung von Büroaufgaben mit Agenten, dem visuellen Verständnis, dem Aufruf von Tools für Finanz- und Steueraufgaben sowie dem niedrigen Preis. In der Gesamtwertung von Vals belegt das Modell unter 22 Modellen Platz 15 und liegt damit im Mittelfeld. Es ist kein Allround-Modell.
F2: Welches Modell ist besser – MiniMax M3.1 Flash oder Claude Opus 5.5?
Der Hersteller hat keinen direkten Vergleich mit Opus 5.5 veröffentlicht. In der offiziellen Tabelle wird Opus 5 als Vergleichsmodell herangezogen. Selbst im Vergleich mit Opus 5 liegt M3.1 Flash bei Terminal Bench und SWE Refactor Bench zurück. Opus 5.5 ist weiterhin das stärkste Flaggschiffmodell von Anthropic.
F3: Welches Ergebnis stimmt: 38,1 bei Terminal Bench laut Hersteller oder 25,25 % bei Vals?
Beide Ergebnisse sind korrekt, beruhen aber auf unterschiedlichen Testverfahren und lassen sich nicht direkt miteinander vergleichen. Beide zeigen dasselbe: Längere, mehrstufige Terminal-Aufgaben sind eine Schwäche von M3.1 Flash.
F4: Kann ich M3.1 Flash derzeit über APIYI aufrufen?
Stand 22.10.2026 ist MiniMax-M3.1-Flash noch nicht auf der Preisseite von APIYI aufgeführt. Ob das Modell aufgerufen werden kann, entnehmen Sie bitte der Preisseite von APIYI. Derzeit können Sie MiniMax-M3, claude-opus-5-5 und weitere Modelle direkt über APIYI unter apiyi.com aufrufen.
F5: Welche Stufe sollte ich für „effort“ einstellen?
Wenn Sie keinen Wert angeben, wird standardmäßig „max“ verwendet. Damit erzielen Sie die bestmöglichen Ergebnisse, allerdings dauert die Verarbeitung am längsten und es werden die meisten Ausgabetoken erzeugt. Für einfache Aufgaben in größeren Mengen empfiehlt es sich, zunächst „low“ oder „medium“ auszuprobieren und die Stufe bei unzureichender Qualität zu erhöhen. Der Denkprozess selbst lässt sich nicht deaktivieren.
F6: Kann ich den API-Schlüssel eines M-Plan-Abos direkt als API-Schlüssel verwenden?
Nein, die Schlüssel sind nicht austauschbar. Laut der offiziellen FAQ sind der nutzungsbasierte API-Schlüssel und der Abo-Schlüssel für M Plan zwei unterschiedliche Schlüssel, die an verschiedenen Stellen im Backend abgerufen werden müssen. Die monatlichen Gebühren der einzelnen M-Plan-Stufen finden Sie auf der offiziellen Website.
F7: Wie kann ich die Ergebnisse selbst kostengünstig überprüfen?
Führen Sie zunächst einige Aufgaben mit einem kostenlosen, ratenbegrenzten Endpunkt auf OpenRouter aus. Als Vergleich können Sie Flaggschiffmodelle über APIYI unter apiyi.com mit demselben API-Schlüssel aufrufen. Halten Sie anschließend die Token-Nutzung und die Laufzeit anhand der 30-Minuten-Checkliste in diesem Artikel fest.
MiniMax M3.1 Flash: Die wichtigsten Erkenntnisse
- Keine eigenen Tests: Alle Zahlen stammen entweder aus Angaben von MiniMax oder aus unabhängigen Tests von Vals.
- Im Mittelfeld angesiedelt: Im Vals Index erreicht das Modell 53,78 % und belegt Platz 15 von 22 Modellen.
- Klare Stärken: Büroautomatisierung, visuelles Verständnis, Agenten für Finanz- und Steueraufgaben sowie ein niedriger Preis.
- Klare Schwächen: Aufgaben mit langen Terminal-Prozessketten und umfangreiche Refactorings. Auch in der offiziellen Tabelle liegt das Modell hinter Opus 5.
- Zahlen sind nicht immer vergleichbar: Die beiden Terminal-Bench-Werte lassen sich nicht direkt miteinander vergleichen. Kosten und Geschwindigkeit beruhen auf den Angaben des Herstellers.
- Den Denkmodus kann man nicht ausschalten: Das „effort“-Niveau lässt sich nur senken. Wer von M3 umsteigt, muss außerdem die Auswertungslogik für das Tag
<think>anpassen. - Die Kombination ist oft günstiger: Auf APIYI lassen sich MiniMax-Modelle und Opus 5.5 mit einem einzigen API-Schlüssel nutzen und je nach Schwierigkeitsgrad der Aufgabe einsetzen.
Fazit
Die wichtigsten Erkenntnisse zu MiniMax M3.1 Flash:
- Einsatzbereiche: Das Modell eignet sich für Büroautomatisierung, visuelle Aufgaben und Agenten für Finanz- und Steueraufgaben. Weniger geeignet ist es für Aufgaben mit langen Terminal-Prozessketten und umfangreiche Refactorings.
- Zahlen richtig einordnen: Die offiziellen Angaben und die Ergebnisse unabhängiger Tests beruhen auf unterschiedlichen Testverfahren. Selbst in den offiziellen Materialien gibt es kleinere Abweichungen, etwa zwischen 62,8 und 62,2. Geben Sie bei Zitaten daher immer die Quelle an.
- Umstieg oder nicht?: Für umfangreiche Aufgaben mit klaren Regeln lohnt sich ein Test. Bei besonders anspruchsvollen Aufgaben sollten Sie vorerst beim bisherigen Modell bleiben. Ein eigener Test von 30 Minuten kann Klarheit schaffen.
Testen Sie das Modell zunächst mit Ihren eigenen Aufgaben und stellen Sie die Nutzung dann schrittweise nach Aufgabenkategorie um, statt alles auf einmal zu ersetzen. MiniMax-M3 und claude-opus-5-5 lassen sich als Vergleichsmodelle über APIYI apiyi.com zentral aufrufen. So können Sie die Vergleichstests mit demselben API-Schlüssel durchführen.
📚 Quellen
- Offizieller Veröffentlichungsblog von MiniMax: Offizielle Benchmark-Ergebnisse, Geschwindigkeit und Preise von M3.1 Flash
- Link:
minimax.io/blog/minimax-m31f -
Hinweis: Hauptquelle für die vom Hersteller veröffentlichten Daten
-
Offizielle MiniMax-Dokumentation: Modellaufruf:
effort-Parameter, Denkmechanismus und API-Endpunkt - Link:
platform.minimax.io/docs/guides/text-generation -
Hinweis: Pflichtlektüre für Migration und Integration
-
Offizielle MiniMax-Preisseite: Abrechnungsregeln für M3.1 Flash und M3
- Link:
platform.minimax.io/docs/guides/pricing -
Hinweis: Zur Berechnung der Kosten pro Aufgabe
-
Vals-AI-Modellseite: Unabhängige Testergebnisse zu M3.1 Flash
- Link:
vals.ai/models/minimax_MiniMax-M3.1-flash -
Hinweis: Enthält Ranglisten und Testbedingungen
-
Bericht von MarkTechPost: Aufbereitung der offiziellen Vergleichstabellen
- Link:
marktechpost.com/2026/10/19/minimax-m3-1-flash-release - Hinweis: Enthält Vergleichsdaten zu Opus 5 und Unterschiede bei den Kostendiagrammen
Autor: Technisches Team von APIYI
Technischer Austausch: Kontaktieren Sie uns gerne über die Startseite von APIYI unter apiyi.com. Weitere Informationen zur Anbindung finden Sie im Dokumentationszentrum unter docs.apiyi.com.