Note de l’auteur : nous comparons point par point les chiffres publiés officiellement par MiniMax et les évaluations indépendantes de Vals pour vous aider à déterminer si MiniMax M3.1 Flash vous convient — et dans quels cas il vaut mieux ne pas changer de modèle.
En bref : MiniMax M3.1 Flash est économique et rapide. Il excelle dans l’automatisation bureautique, la vision et les tâches d’agent liées à la finance et à la fiscalité. En revanche, il est nettement moins performant que les modèles phares de Claude pour les tâches complexes menées en plusieurs étapes dans un terminal et les refactorisations de grandes bases de code. Il peut prendre en charge des tâches répétitives aux règles bien définies, mais ne convient pas pour remplacer le modèle principal auquel vous confiez vos tâches les plus difficiles.
Précision sur le périmètre de l’article : les « tests » mentionnés dans le titre désignent une synthèse d’évaluations publiques réalisées par des tiers, principalement par Vals AI. Nous n’avons effectué aucun test nous-mêmes et ne présentons aucune donnée issue de nos propres essais. La source de chaque chiffre est indiquée : « données communiquées par MiniMax », « évaluation tierce » (Vals, entre autres) ou « inconnue/non publiée ».
L’essentiel : vous découvrirez où les chiffres officiels et ceux des évaluations tierces divergent, quels sont les points forts et les limites de MiniMax M3.1 Flash, ainsi qu’une liste de tests à réaliser en 30 minutes pour décider si vos tâches justifient un changement de modèle.
Aperçu des fonctionnalités clés de MiniMax M3.1 Flash
Commençons par quelques notions de base. Un token est une unité utilisée pour mesurer la facturation et la longueur des calculs du modèle. D’après la conversion officielle, environ 750 mots en anglais correspondent à 1 000 tokens. Un agent désigne une façon d’utiliser un modèle capable d’appeler des outils de façon autonome et d’accomplir une tâche en plusieurs étapes, par exemple remplir automatiquement un formulaire, exécuter des commandes dans un terminal ou faire des recherches avant de rédiger un rapport. La fenêtre de contexte correspond à la quantité maximale de contenu que le modèle peut « voir » en une seule fois.
Les informations du tableau ci-dessous proviennent toutes de la documentation et de la page des tarifs officielles de MiniMax : elles correspondent donc à ce que l’entreprise déclare officiellement.
| Élément | Informations officielles sur MiniMax M3.1 Flash | Remarques |
|---|---|---|
| Nom du modèle | MiniMax-M3.1-Flash | L’ancien nom MiniMax-M3.1-Flash-Preview a été retiré. Les requêtes envoyées avec cet ancien nom sont automatiquement redirigées vers le nouveau modèle. |
| Architecture | MoE, 428 B de paramètres au total, environ 23 B activés | Identique à M3 ; MiniMax n’a pas encore publié de rapport technique précisant les changements apportés à Flash. |
| Fenêtre de contexte | 1 000 000 tokens | La page Vals indique une sortie maximale de 524 288 tokens. |
| Entrée / sortie | Entrées texte, image et vidéo ; sortie texte | Prise en charge de la compréhension multimodale. |
| Niveau de réflexion (effort) | low / medium / high / xhigh / max | Par défaut, max si aucun paramètre n’est transmis. |
| Prix (par million de tokens) | Entrée : 0,15 $ ; sortie : 0,60 $ ; lecture du cache : 0,015 $ | Aucun supplément pour les contextes longs. |
| Poids ouverts | Une publication officielle sur X annonce leur mise à disposition le 23 octobre. | Ils n’étaient pas encore disponibles à la date de publication (22 octobre). |
MoE (mélange d’experts) désigne une architecture de modèle dans laquelle le nombre total de paramètres est élevé, mais où seule une petite partie des « experts » est sollicitée à chaque calcul. Cela permet de conserver une grande capacité tout en maîtrisant le coût de l’inférence. La lecture du cache désigne la facturation à tarif réduit des contenus d’entrée répétés, comme une invite système fixe, lorsqu’ils sont reconnus dans le cache.
Le mécanisme de réflexion de MiniMax M3.1 Flash : on peut le réduire, mais pas le désactiver
C’est le piège le plus fréquent lors d’une migration depuis M3. La fonction de réflexion de M3.1 Flash ne peut pas être désactivée : si la requête transmet thinking disabled ou effort none, l’interface renvoie directement une erreur 400, dont le message exact est model "MiniMax-M3.1-Flash" requires adaptive thinking. Pour réduire le temps de réponse et le nombre de tokens, la seule option consiste à diminuer le niveau d’effort.
Plus le niveau d’effort est élevé, plus le modèle réfléchit, plus il génère de tokens en sortie et plus la latence augmente. Le nom du paramètre varie selon le protocole : output_config.effort pour le protocole Anthropic, reasoning_effort pour le protocole OpenAI et reasoning.effort pour le protocole Responses. Par ailleurs, le contenu de réflexion est désormais renvoyé séparément. Avec le protocole compatible OpenAI, il se trouve dans le champ reasoning_content, tandis que content contient uniquement la réponse finale. Si votre code extrayait auparavant le contenu de réflexion des balises <think> de M3, vous devrez le modifier.
🚀 Pour démarrer rapidement : à la date de publication, MiniMax-M3.1-Flash n’est pas encore disponible sur la page des tarifs d’APIYI. Nous l’ajouterons dès que possible. Consultez la page des tarifs d’APIYI pour vérifier sa disponibilité. En attendant, vous pouvez vous familiariser avec le format d’interface de la gamme MiniMax en appelant MiniMax-M3 directement sur APIYI, à l’adresse apiyi.com. Le service prend en charge les formats d’interface OpenAI et Anthropic, et le modèle est disponible dans le groupe ClaudeCode.
Données réelles sur MiniMax M3.1 Flash : chiffres officiels et évaluations indépendantes
Un benchmark consiste à évaluer un modèle à partir d’un ensemble fixe de questions. Pour un même test, les résultats peuvent varier considérablement selon l’organisme qui le réalise et l’environnement d’exécution. Avant de regarder les chiffres, il faut donc vérifier qui a effectué le test et dans quelles conditions.
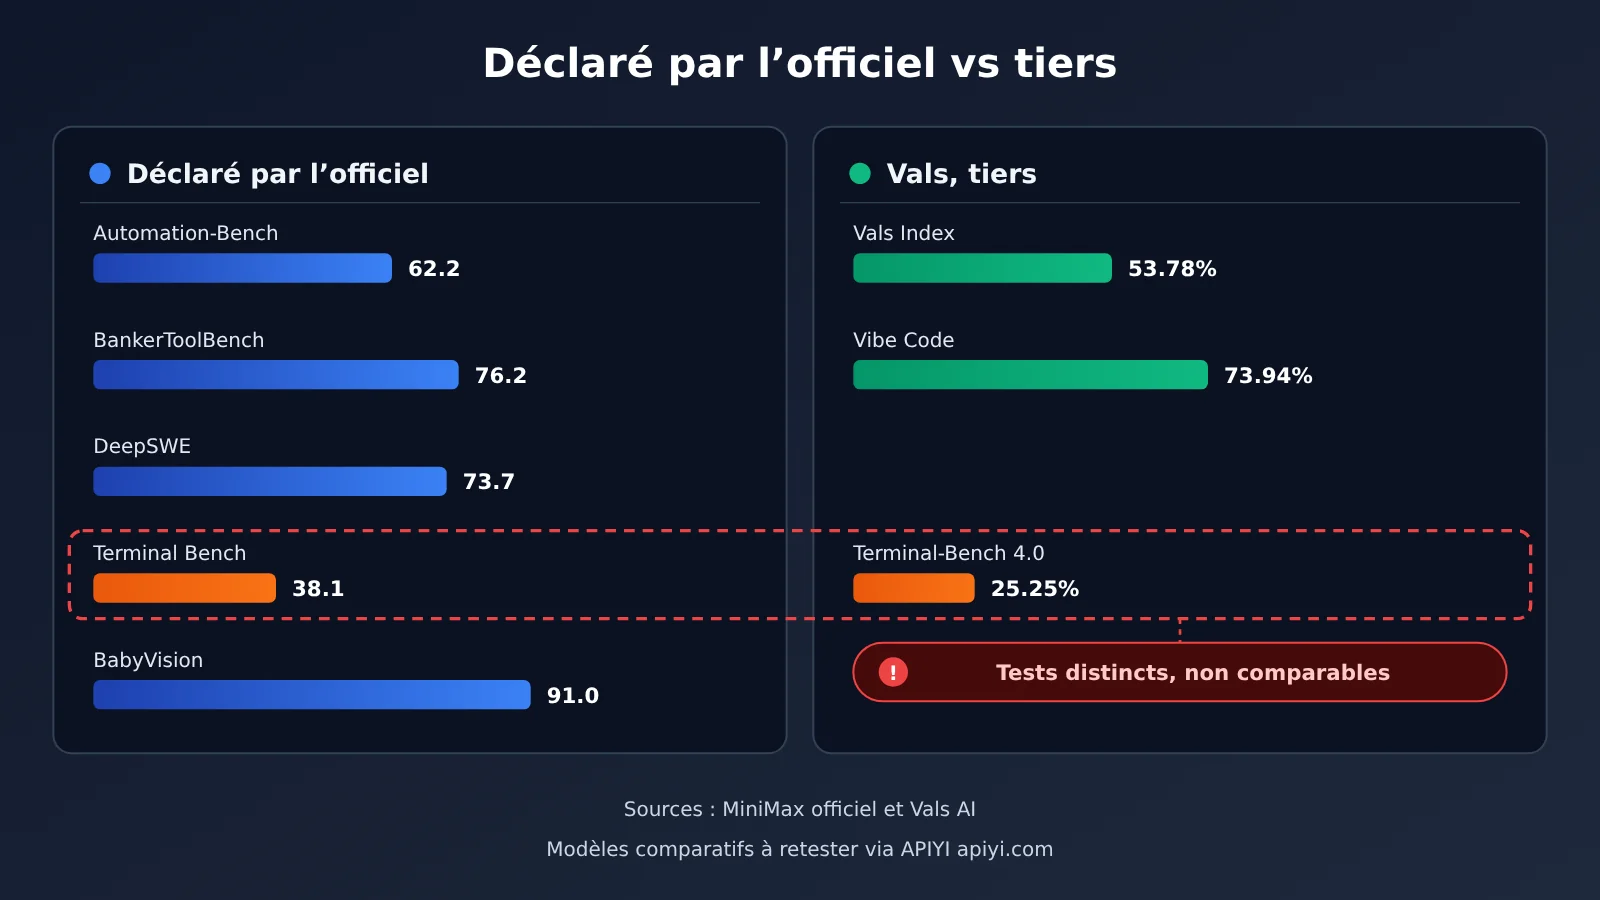
| Test | Score | Source | Conditions de test / remarques |
|---|---|---|---|
| Automation-Bench v1.0.6 | 62.2 (Opus 5 : 50.3) | Chiffres officiels | Tableau officiel ; le graphique officiel des coûts indique 62.8 pour la version max |
| BankerToolBench | 76.2 (à égalité avec Opus 5) | Chiffres officiels | Tâches d’appel d’outils dans le secteur bancaire |
| DeepSWE v1.1 | 73.7 % (DeepSeek V4.1 Flash-1017 : 77.0) | Chiffres officiels | Dans le tableau officiel, un modèle concurrent obtient un meilleur résultat |
| OSWorld V2 | 61.7 | Chiffres officiels | MiniMax le présente comme le meilleur modèle chinois |
| Agents’ Last Exam (ALE) | 29.6 | Chiffres officiels | MiniMax le présente comme le meilleur modèle chinois |
| CyberGym | 82 % | Chiffres officiels | Tâches liées à la sécurité |
| Terminal Bench 4.0 | 38.1 (Opus 5 : 51.8) | Chiffres officiels | 13.7 points de moins qu’Opus 5 |
| SWE Refactor Bench | 23.0 (Opus 5 : 31.0) | Chiffres officiels | Tâches de refactorisation de code |
| BabyVision (avec outils) | 91.0 | Chiffres officiels | Compréhension visuelle |
| HLE (sans outils) | 43.4 | Chiffres officiels | Questions-réponses générales de grande difficulté |
| Vals Index | 53.78 %, 15e sur 22 modèles | Évaluation indépendante de Vals | 5e parmi 11 modèles à poids ouverts, légèrement derrière le Xiaomi MiMo V2.6 Flash (54.83 %) |
| Terminal-Bench 4.0 | 25.25 %, 22e sur 51 modèles | Évaluation indépendante de Vals | API officielle, temperature 1, top_p 0.95, effort max, sortie maximale de 262k |
| HLAB-Vals-1.1 | 7.50 %, 17e sur 23 modèles | Évaluation indépendante de Vals | Mêmes conditions |
À noter : dans son tableau, MiniMax compare son modèle à Claude Opus 5, et non à Opus 5.5. Claude Opus 5.5 reste le modèle phare le plus puissant d’Anthropic, mais l’entreprise ne l’a pas comparé point par point à M3.1 Flash. L’affirmation selon laquelle « M3.1 Flash rattrape Opus 5.5 » n’est donc pas étayée.
4 écarts entre les chiffres de MiniMax M3.1 Flash
-
Terminal Bench : 38,1 % selon les chiffres officiels contre 25,25 % chez Vals. Les deux évaluations portent le nom de Terminal-Bench 4.0, mais elles utilisent des bancs de test différents. Un banc de test, c’est l’environnement d’exécution et le programme d’orchestration mis en place pour le modèle. Il peut directement influencer sa capacité à mener à bien des commandes en plusieurs étapes. Ces deux chiffres ne sont donc pas directement comparables, et on ne peut pas en conclure que « les chiffres officiels sont gonflés de 13 points ». Les deux évaluations aboutissent toutefois à la même conclusion : les longues tâches exécutées dans un terminal sont un point faible de M3.1 Flash. Dans le tableau officiel, le modèle est derrière Opus 5 ; dans le classement de Vals, il se situe dans la deuxième moitié des 51 modèles évalués.
-
Automation-Bench : 62,8 sur le graphique des coûts contre 62,2 dans le tableau. Le même document officiel contient deux chiffres différents, avec un écart de 0,6 point, qui ne change pas grand-chose à la conclusion. Cela montre toutefois que les documents officiels eux-mêmes présentent des incohérences. Si vous citez ces chiffres, mieux vaut vous appuyer sur le tableau et indiquer la source.
-
Coût : « 70 % de moins », « un tiers » et « moitié moins ». Le billet officiel indique que le coût global des tâches de type agent est inférieur de 70 % à celui de la génération précédente. Dans un post officiel sur X, le coût annoncé est d’un tiers de celui de M3. Si l’on se base uniquement sur le prix par token, Flash coûte moitié moins cher que M3 au tarif standard (0,15 $ contre 0,30 $). Selon les explications officielles, les chiffres portent sur le coût par tâche, mais la méthode de calcul n’a pas été rendue publique.
-
Vitesse : plus de 170, plus de 200 et environ 150. La section suivante explique ce point en détail.
Comment évaluer la vitesse de MiniMax M3.1 Flash : les chiffres de TPS sont officiels
Le TPS (tokens per second, ou tokens par seconde) indique combien de tokens le modèle génère chaque seconde. Plus le chiffre est élevé, plus le texte s’affiche rapidement. Le P50 est la médiane : si l’on classe toutes les vitesses des requêtes de la plus faible à la plus élevée, le P50 est la valeur du milieu. Il est souvent plus représentatif d’une situation « habituelle » que la moyenne.
Pour l’instant, les données de vitesse publiées viennent toutes de MiniMax. Nous n’avons trouvé aucune mesure indépendante réalisée par un tiers :
- Blog officiel : la génération courante peut atteindre plus de 200 TPS, avec un P50 stable au-dessus de 170 TPS ;
- Page produit officielle : environ 150 tokens par seconde ;
- Blog officiel et publications sur X : la vitesse d’inférence en ligne est environ trois fois supérieure à celle de M3.
Ces chiffres ne reposent pas sur les mêmes critères ; la page produit présente une estimation plus prudente. Mais surtout, un TPS élevé ne signifie pas forcément une réponse rapide. Par défaut, le paramètre effort de M3.1 Flash est réglé sur max, et les tokens de raisonnement comptent aussi dans la sortie. Si une tâche nécessite d’abord de « réfléchir » à plusieurs milliers de tokens, même à 170 tokens par seconde, il faudra attendre un certain temps avant d’obtenir la réponse finale. En pratique, la vitesse ressentie dépend du « nombre total de tokens générés ÷ TPS + temps d’attente avant le premier token ». C’est pourquoi la liste d’auto-évaluation ci-dessous demande de noter à la fois le nombre de tokens et le temps écoulé.
Limites de MiniMax M3.1 Flash : ses points forts et ses points faibles
Commençons par les progrès relevés par Vals par rapport à la génération précédente, M3. Tous les résultats du tableau ci-dessous proviennent de « tests tiers ».
| Test Vals | M3.1 Flash | M3 | Évolution |
|---|---|---|---|
| Vibe Code Bench | 73.94% | 47.57% | Forte hausse |
| Tax Agent Bench | 32.14% | 20.59% | Hausse marquée |
| EMB v1.1 | 67.84% | 59.75% | En hausse |
| Finance Agent v2.1 | 58.83% | 54.34% | Légère hausse |
| Legal Research Bench | 34.13% | 29.81% | Légère hausse |
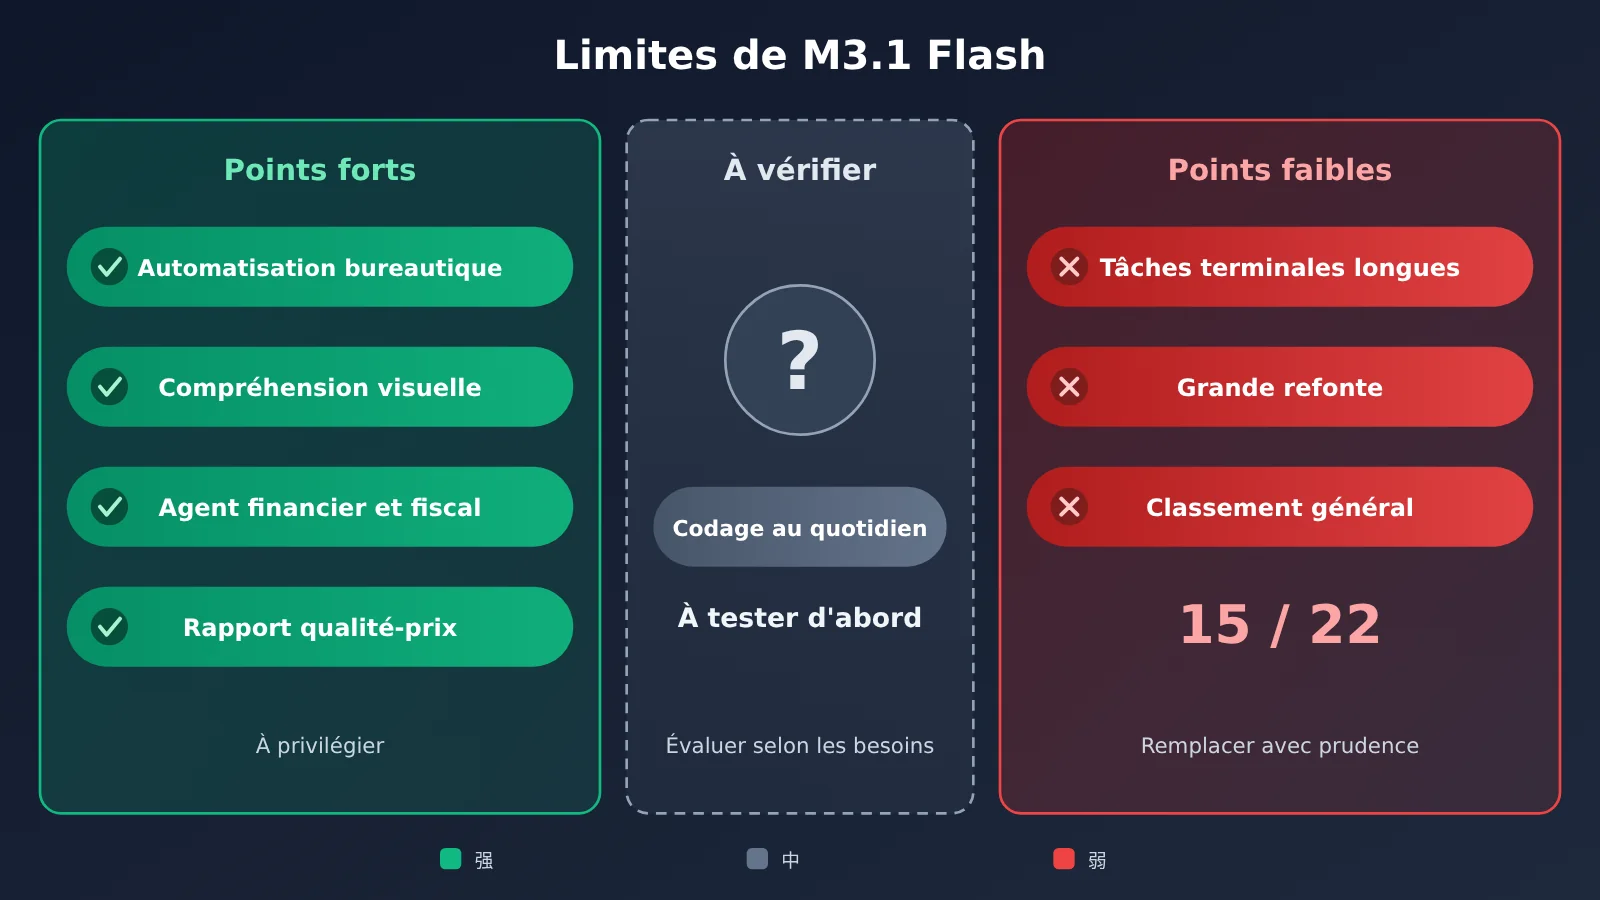
| Dimension | Évaluation | Justification |
|---|---|---|
| Automatisation des tâches bureautiques par des agents | Forte | Score officiel de 62.2 à Automation-Bench (contre 50.3 pour Opus 5) ; 61.7 à OSWorld V2 |
| Compréhension visuelle | Forte | Score officiel de 91.0 à BabyVision avec outils ; prise en charge des images et des vidéos en entrée |
| Agents financiers et fiscaux | Plutôt forte | Score officiel de 76.2 à BankerToolBench ; les résultats de Vals en fiscalité et en finance sont en hausse par rapport à M3 |
| Rapport qualité-prix | Fort | Tarif officiel deux fois inférieur à celui de M3, sans supplément pour les longues fenêtres de contexte |
| Tâches terminal en plusieurs étapes | Faible | Le score officiel à Terminal Bench est inférieur de 13.7 points à celui d’Opus 5 ; le modèle se classe 22e sur 51 à Terminal-Bench 4.0 de Vals |
| Refactorisation de grands projets | Faible | Score officiel de 23.0 à SWE Refactor Bench, contre 31.0 pour Opus 5 |
| Niveau général | Moyen | 15e sur 22 modèles dans le classement Vals Index |
En résumé : les points forts
- Tarif bas et facturation simple : 0,15 $ en entrée et 0,60 $ en sortie. Le tarif est fixe jusqu’à une fenêtre de contexte de 1 M de jetons, ce qui convient aux appels en grand volume.
- Bonnes performances des agents pour les tâches bureautiques et visuelles : les résultats des tests officiels et tiers vont dans le même sens pour des tâches comme la mise en forme de tableaux, les manipulations de pages Web ou la reconnaissance d’images.
- Des progrès nets par rapport à M3 : le score de Vibe Code Bench de Vals passe de 47.57% à 73.94%. Le modèle a franchi un cap pour créer de petites applications au quotidien.
En résumé : les limites
- Des lacunes persistent sur les tâches d’ingénierie complexes : les résultats officiels montrent que le modèle reste derrière Opus 5 pour les tâches en plusieurs étapes dans le terminal et les modifications importantes dans plusieurs fichiers.
- La réflexion ne peut pas être désactivée : même les questions courtes passent par un processus de réflexion, ce qui pénalise les usages sensibles à la latence avant le premier jeton.
- Une transparence insuffisante : ni la méthode de calcul des coûts ni le rapport technique officiel n’ont été publiés. L’affirmation d’un « coût réduit d’un tiers » ne peut donc pas encore être vérifiée de manière indépendante.
Quand ne pas passer à MiniMax M3.1 Flash
Dans les six cas suivants, mieux vaut éviter de remplacer votre modèle principal par M3.1 Flash, ou au moins le tester avant de prendre une décision :
- Votre tâche principale est un agent terminal avec une longue chaîne d’actions : par exemple, lancer automatiquement une CI, diagnostiquer un problème sur un serveur ou exécuter des dizaines de commandes à la suite. Les données officielles et celles de Vals signalent toutes deux des limites sur ce type de tâche. Si Claude Opus 5.5 fonctionne déjà très bien pour vous, le coût des reprises après le changement risque de dépasser les économies réalisées sur les tokens.
- Vous effectuez souvent de grandes refactorisations : pour des tâches comme modifier des interfaces dans une dizaine de fichiers ou scinder des modules, le score de M3.1 Flash au benchmark officiel SWE Refactor Bench (23,0) est loin derrière celui d’Opus 5 (31,0). Mieux vaut continuer à confier ces tâches à un modèle phare.
- Vous devez désactiver la réflexion et obtenir une latence très faible : pour des cas d’usage comme le service client en temps réel, la classification d’intentions ou la saisie prédictive, la réflexion de M3.1 Flash ne peut pas être désactivée. Même avec le niveau low, il faut prévoir un temps d’attente supplémentaire par rapport à un modèle qui ne réfléchit pas.
- Votre intégration actuelle analyse les balises
<think>et vous ne prévoyez pas de la modifier prochainement : M3.1 Flash renvoie désormais le contenu de réflexion dans un champ distinct. Si vous changez simplement le nom du modèle, votre logique d’analyse risque de ne pas récupérer les données, voire de provoquer une erreur. - Vous devez déployer le modèle en local et en environnement privé dès maintenant : le fournisseur a annoncé la publication des poids pour le 23 octobre, mais ils ne sont toujours pas disponibles à la date de publication de cet article. Les informations nécessaires au déploiement, comme la mémoire vidéo requise, n’ont pas non plus été communiquées. Il est donc impossible de planifier le matériel de manière fiable pour l’instant.
- Un coût inférieur par token ne signifie pas forcément un coût inférieur par tâche : le niveau max utilisé par défaut génère beaucoup de tokens de réflexion. Si vos réponses sont courtes et que votre modèle actuel est déjà bon marché, votre facture réelle ne baissera pas nécessairement après le changement. Comparez impérativement le « coût par tâche ».
MiniMax M3.1 Flash : checklist pour le tester en 30 minutes
Un classement donne une indication sur les performances moyennes, mais c’est votre travail qui constitue le test ultime. Suivez les étapes ci-dessous pour comparer les modèles en 30 minutes. Vous pouvez utiliser l’API officielle de MiniMax ou le point de terminaison gratuit, soumis à des limites de débit, sur OpenRouter : minimax/minimax-m3.1-flash:free.
- Choisissez les tâches (environ 5 minutes) : sélectionnez 3 catégories de tâches réelles que vous avez effectuées récemment, avec 3 à 5 exemples par catégorie. La première regroupe les tâches répétitives aux règles claires, comme la mise en forme de tableaux ou la rédaction de résumés. La deuxième correspond à vos tâches quotidiennes principales. La troisième rassemble les tâches difficiles qui vous inquiètent le plus, comme des opérations en plusieurs étapes dans un terminal ou des modifications réparties sur plusieurs fichiers.
- Fixez les paramètres : faites d’abord un test avec M3.1 Flash en mode medium, puis un autre avec le mode max par défaut, et notez le mode utilisé. Conservez exactement les mêmes paramètres pour le modèle auquel vous le comparez ; ne les changez pas en cours de test.
- Comparez les mêmes tâches (environ 15 minutes) : utilisez exactement les mêmes invites et le même contexte pour les deux modèles, puis exécutez chaque tâche.
- Notez les résultats : pour chaque tâche, relevez le nombre de tokens en entrée et en sortie (y compris la partie consacrée au raisonnement), le temps total, la réussite dès le premier essai et la quantité de modifications manuelles nécessaires.
- Calculez le coût par tâche (environ 10 minutes) : appliquez la formule officielle « volume utilisé ÷ 1 000 000 × tarif unitaire », puis additionnez les coûts d’entrée, de sortie et de lecture du cache pour obtenir le coût réel de chaque tâche.
- Tirez une conclusion pour chaque catégorie : si la qualité est acceptable et le coût par tâche inférieur dans une catégorie, ne migrez que cette catégorie. Si le modèle échoue clairement sur les tâches difficiles de la troisième catégorie, continuez à les confier à votre modèle habituel.
💡 Suggestion pour le modèle de comparaison : vous pouvez utiliser APIYI, sur apiyi.com, pour appeler claude-opus-5-5 ou MiniMax-M3 avec la même clé API. Vous n’aurez ainsi pas besoin de créer plusieurs comptes sur différentes plateformes pour effectuer un seul test comparatif.
Combiner les modèles MiniMax et Claude Opus 5.5 sur APIYI
M3.1 Flash est conçu pour prendre en charge les tâches répétitives en équipe, plutôt que pour être votre unique modèle. Une approche efficace consiste à répartir les tâches selon leur difficulté : confier les tâches peu coûteuses et volumineuses à la série MiniMax, et réserver la planification complexe et les refactorisations à Claude Opus 5.5.
| Modèle | Positionnement | Tâches adaptées | Plateformes disponibles |
|---|---|---|---|
| MiniMax-M3.1-Flash | Modèle d’agent rapide et peu coûteux | Automatisation bureautique, vision, traitement en masse de tâches financières et fiscales | API officielle MiniMax / M Plan ; disponibilité sur APIYI à vérifier sur la page des tarifs |
| MiniMax-M3 | Modèle phare de la génération précédente | Tâches courantes en chinois, traitement en masse | APIYI apiyi.com (formats OpenAI et Anthropic) |
| claude-opus-5-5 | Modèle phare le plus puissant d’Anthropic à ce jour | Planification complexe, refactorisations de grande ampleur, agents avec de longues chaînes d’actions | APIYI apiyi.com |
| claude-opus-5 | Modèle phare de la génération précédente | Modèle de référence dans les tableaux de performances officiels | APIYI apiyi.com |
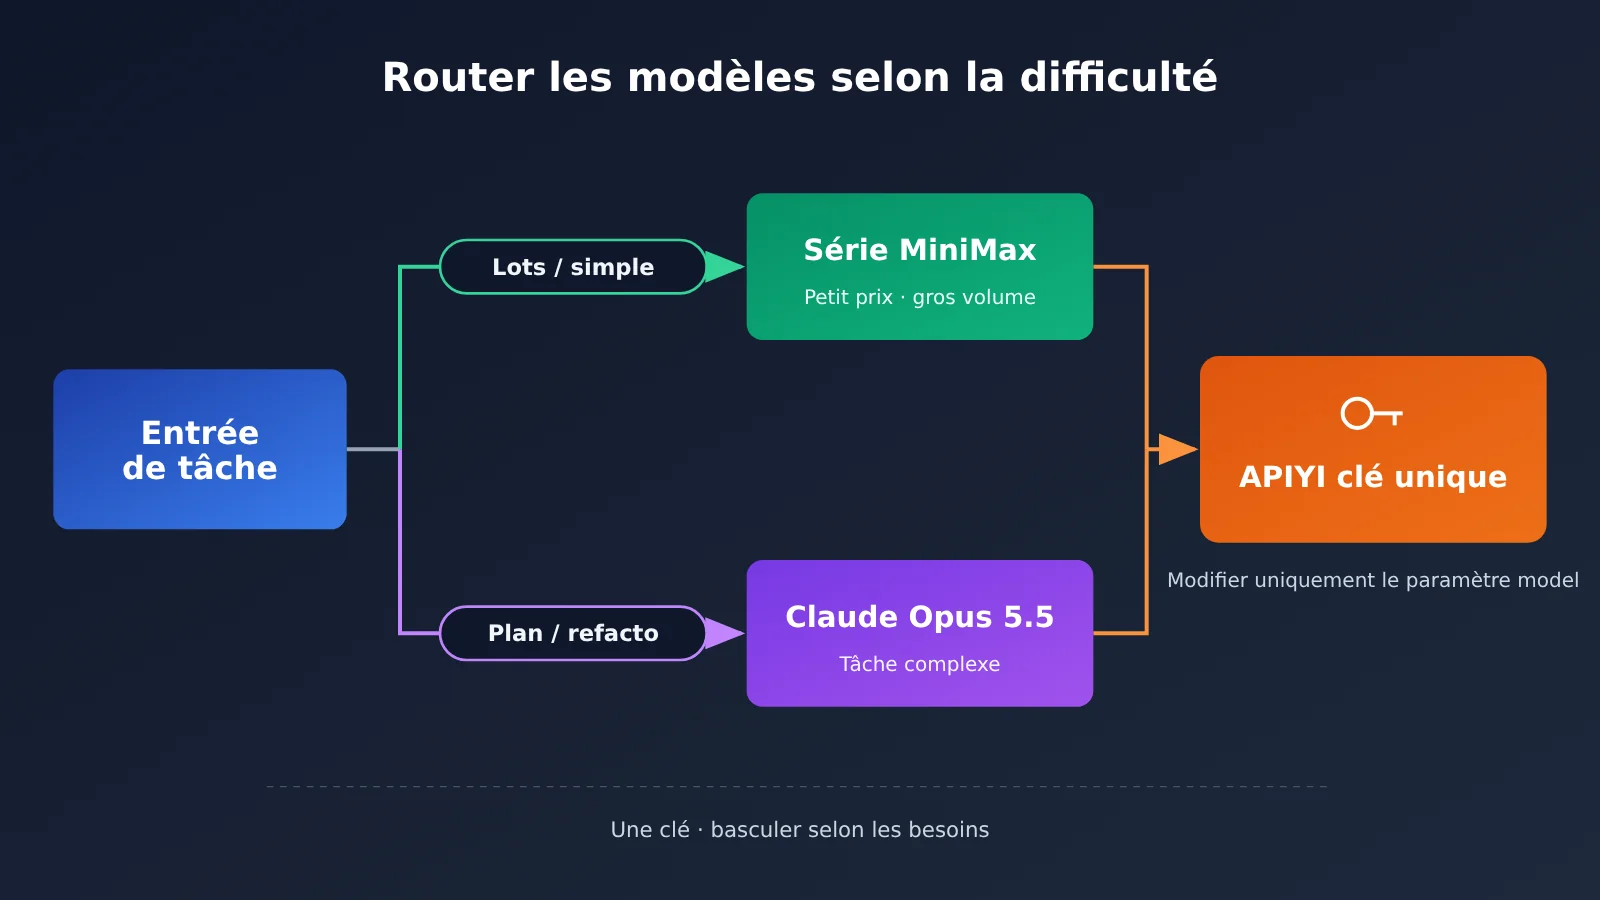
Sur APIYI, une seule clé permet d’appeler des modèles internationaux comme Claude, GPT et Gemini, ainsi que des modèles chinois comme DeepSeek et MiniMax. Pour changer de modèle, il suffit de modifier le paramètre model :
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_APIYI_KEY",
    base_url="https://api.apiyi.com/v1"  # Interface unifiée d’APIYI
)

def ask(model, prompt):
    resp = client.chat.completions.create(
        model=model,
        messages=[{"role": "user", "content": prompt}],
    )
    return resp.choices[0].message.content

# Confier les tâches peu coûteuses et volumineuses à la série MiniMax
print(ask("MiniMax-M3", "把这段会议纪要整理成 5 条待办"))

# Réserver la planification complexe et les refactorisations à Claude Opus 5.5
print(ask("claude-opus-5-5", "为这个单体服务设计分阶段拆分方案"))
Côté tarifs, selon les prix officiels publiés par APIYI, claude-opus-5-5 coûte 4 $ en entrée et 20 $ en sortie par million de jetons, contre 5 $ / 25 $ pour claude-opus-5. Si MiniMax-M3.1-Flash apparaît ensuite sur la page des tarifs d’APIYI, fiez-vous au nom du modèle et au prix indiqués sur cette page.
Questions fréquentes (FAQ)
Q1 : Qu’est-ce qui fait la force de MiniMax M3.1 Flash ?
D’après les résultats publiés par le fabricant et ceux de Vals, ses points forts sont l’automatisation des tâches bureautiques par des agents, la compréhension visuelle, l’utilisation d’outils dans les domaines de la finance et de la fiscalité, ainsi que son prix bas. Au classement général, il arrive 15ᵉ sur les 22 modèles évalués par Vals : il se situe donc dans la moyenne et n’est pas polyvalent dans tous les domaines.
Q2 : Lequel est le plus performant, MiniMax M3.1 Flash ou Claude Opus 5.5 ?
Le fabricant n’a pas comparé M3.1 Flash à Opus 5.5 dans chaque catégorie : le modèle de référence de son tableau est Opus 5. Même face à Opus 5, M3.1 Flash obtient de moins bons résultats sur Terminal Bench et SWE Refactor Bench. Opus 5.5 reste le modèle phare le plus performant d’Anthropic.
Q3 : Quel résultat est correct pour Terminal Bench : les 38,1 % annoncés par le fabricant ou les 25,25 % de Vals ?
Les deux résultats sont valides, mais ils proviennent de cadres d’évaluation différents et ne peuvent pas être comparés directement. Ils aboutissent toutefois à la même conclusion : les tâches qui nécessitent de nombreuses étapes dans un terminal sont le point faible de M3.1 Flash.
Q4 : Peut-on déjà utiliser M3.1 Flash via APIYI ?
Au 22 octobre 2026, MiniMax-M3.1-Flash ne figure pas encore sur la page des tarifs d’APIYI. Consultez cette page pour savoir s’il est disponible. Pour le moment, vous pouvez appeler directement des modèles comme MiniMax-M3 et claude-opus-5-5 via APIYI, sur apiyi.com.
Q5 : Quel niveau d’effort choisir ?
Si vous ne précisez pas de valeur, le niveau par défaut est `max` : les résultats sont optimaux, mais le traitement est plus lent et génère davantage de tokens. Pour les tâches simples à traiter en lot, commencez par `low` ou `medium`, puis augmentez le niveau si la qualité ne suffit pas. Il est impossible de désactiver le raisonnement.
Q6 : Peut-on utiliser directement comme clé API la clé d’un abonnement M Plan ?
Non, ces clés ne sont pas interchangeables. La FAQ officielle précise que les clés API facturées à l’usage et les clés d’abonnement M Plan sont différentes et qu’elles s’obtiennent à des endroits distincts de l’espace d’administration. Pour connaître le prix mensuel de chaque formule M Plan, consultez le site officiel.
Q7 : Comment vérifier soi-même les performances à moindre coût ?
Vous pouvez commencer par tester quelques tâches avec un point de terminaison gratuit à débit limité sur OpenRouter. Pour comparer avec des modèles phares, vous pouvez utiliser le même clé via APIYI, sur apiyi.com, puis noter la consommation de tokens et le temps de traitement à l’aide de la liste de vérification de 30 minutes de cet article.
MiniMax M3.1 Flash : points clés
- Aucun test réalisé par l’auteur : tous les chiffres proviennent des données publiées par MiniMax ou d’évaluations tierces de Vals ;
- Un positionnement intermédiaire : le modèle obtient 53,78 % à l’index Vals et se classe 15e sur 22 modèles ;
- Des points forts bien identifiés : automatisation bureautique, compréhension visuelle, agents spécialisés en finance et fiscalité, et faible coût unitaire ;
- Des limites tout aussi claires : il est moins performant sur les tâches terminales à plusieurs étapes et les refactorisations de grande ampleur ; le tableau officiel le place aussi derrière Opus 5 ;
- Des chiffres à interpréter selon leur méthode de calcul : les deux scores de Terminal Bench ne sont pas directement comparables, et les coûts comme les vitesses sont calculés selon la méthode de MiniMax ;
- Le mode de réflexion ne peut pas être désactivé : on peut seulement réduire le niveau d’effort. Pour migrer depuis M3, il faut adapter la logique d’analyse des balises
<think>; - Mieux vaut combiner les modèles : APIYI permet d’utiliser une seule clé API pour associer les modèles de la série MiniMax à Opus 5.5 et répartir les tâches selon leur difficulté.
Conclusion
Les points essentiels à retenir sur MiniMax M3.1 Flash :
- Son champ de compétences : il est adapté à l’automatisation bureautique, à la vision et aux tâches d’agent en finance et fiscalité. Il est moins à l’aise avec les tâches terminales à plusieurs étapes et les refactorisations de grande ampleur ;
- La méthode de calcul des chiffres : les résultats officiels et ceux des évaluations tierces reposent sur des cadres de test différents. Les documents officiels présentent eux-mêmes de légers écarts, par exemple entre 62,8 et 62,2. Précisez la source lorsque vous citez ces chiffres ;
- Faut-il changer de modèle ? Pour les tâches en lot, avec des règles bien définies, cela vaut la peine de faire un essai. Pour les tâches les plus complexes, mieux vaut ne pas changer tout de suite : un test de 30 minutes sur vos propres cas vous donnera une réponse.
Commencez par comparer les modèles sur des tâches réelles, puis migrez progressivement selon le type de tâche, plutôt que de tout remplacer d’un coup. Vous pouvez appeler le modèle de référence, MiniMax-M3 et claude-opus-5-5 via APIYI apiyi.com, avec une seule clé API pour effectuer vos tests comparatifs.
📚 Références
- Article officiel de MiniMax : scores aux tests de référence, vitesse et tarifs de M3.1 Flash
- Lien :
minimax.io/blog/minimax-m31f -
Remarque : principale source des données publiées par MiniMax
-
Documentation officielle de MiniMax : invocation du modèle : paramètre
effort, mécanisme de réflexion et URL de l’interface - Lien :
platform.minimax.io/docs/guides/text-generation -
Remarque : à lire avant toute migration ou intégration
-
Page officielle des tarifs de MiniMax : règles de facturation de M3.1 Flash et de M3
- Lien :
platform.minimax.io/docs/guides/pricing -
Remarque : utile pour calculer le coût de chaque tâche
-
Page du modèle sur Vals AI : résultats d’évaluations indépendantes de M3.1 Flash
- Lien :
vals.ai/models/minimax_MiniMax-M3.1-flash -
Remarque : comprend le classement et les conditions de test
-
Article de MarkTechPost : compilation du tableau comparatif officiel
- Lien :
marktechpost.com/2026/10/19/minimax-m3-1-flash-release - Remarque : comprend les données de comparaison avec Opus 5 et les différences entre les graphiques de coûts
Auteur : Équipe technique d’APIYI
Échanges techniques : contactez-nous depuis la page d’accueil du site APIYI, apiyi.com. Retrouvez d’autres ressources d’intégration dans le centre de documentation docs.apiyi.com.