Nota do autor: comparamos item por item os números divulgados oficialmente pela MiniMax e as avaliações independentes da Vals para ajudar você a decidir se o MiniMax M3.1 Flash é adequado para o seu caso e quando não vale a pena trocar.
Conclusão em uma frase: O MiniMax M3.1 Flash é barato e rápido, e se destaca em automação de escritório, visão computacional e tarefas de agentes relacionadas a finanças e impostos; mas fica claramente atrás dos modelos de ponta da Claude em tarefas longas executadas no terminal e em grandes refatorações de código. É indicado para assumir tarefas em lote, com regras bem definidas, mas não para substituir o modelo principal nas tarefas mais difíceis.
Antes de tudo, o escopo deste artigo: o termo “avaliação prática” no título se refere a um compilado de avaliações públicas de terceiros, principalmente da Vals AI. Não fizemos nossos próprios testes, e o artigo não inclui dados de avaliações internas. Todas as métricas terão a fonte identificada e serão divididas em três categorias: “declarado oficialmente” (divulgado pela própria MiniMax), “avaliação de terceiros” (Vals e outras fontes) e “desconhecido/não divulgado”.
O que você vai encontrar: ao terminar de ler, você saberá em quais pontos os números oficiais e os de terceiros divergem, quais são os pontos fortes e as limitações do MiniMax M3.1 Flash e também terá uma lista de verificação de 30 minutos para decidir se vale a pena mudar o modelo usado nas suas tarefas.
Visão geral dos principais recursos do MiniMax M3.1 Flash
Antes, vamos esclarecer alguns conceitos básicos. Token é a unidade usada para calcular o custo e o comprimento do processamento do modelo. Segundo a conversão oficial, cerca de 750 palavras em inglês equivalem a 1.000 tokens. Agente é uma forma de usar o modelo em que ele consegue chamar ferramentas por conta própria e concluir tarefas em várias etapas, como preencher formulários automaticamente, executar comandos no terminal ou pesquisar informações e depois escrever um relatório. A janela de contexto é a quantidade máxima de conteúdo que o modelo consegue “ver” de uma só vez.
Todas as informações da tabela abaixo vêm da documentação oficial e da página de preços da MiniMax — ou seja, são declarações oficiais da empresa.
| Item | Informações oficiais do MiniMax M3.1 Flash | Observações |
|---|---|---|
| Nome do modelo | MiniMax-M3.1-Flash | O nome antigo, MiniMax-M3.1-Flash-Preview, foi descontinuado. As solicitações enviadas com o nome antigo são direcionadas automaticamente para o novo modelo |
| Arquitetura | MoE, com 428B de parâmetros no total e cerca de 23B ativos | Igual à do M3. A MiniMax ainda não publicou um relatório técnico explicando as mudanças do Flash |
| Janela de contexto | 1.000.000 de tokens | A página Vals informa que o limite máximo de saída é de 524.288 tokens |
| Entrada / saída | Entrada de texto, imagens e vídeos; saída de texto | Suporta compreensão multimodal |
| Nível de raciocínio (effort) | low / medium / high / xhigh / max | Se o parâmetro não for informado, o padrão é max |
| Preço (por milhão de tokens) | Entrada: US$ 0,15; saída: US$ 0,60; leitura do cache: US$ 0,015 | Não há cobrança adicional para contextos longos |
| Pesos de código aberto | Uma publicação oficial no X diz que serão disponibilizados em 23 de outubro | Até a publicação deste artigo (22 de outubro), ainda não tinham sido lançados |
MoE (mistura de especialistas) é uma arquitetura de modelo em que há muitos parâmetros no total, mas apenas uma pequena parte dos “especialistas” é acionada em cada processamento. Assim, o modelo consegue manter uma grande capacidade sem elevar tanto o custo de inferência. Leitura do cache é a cobrança reduzida aplicada quando conteúdos de entrada repetidos — como um comando de sistema fixo — são encontrados no cache.
Como funciona o raciocínio do MiniMax M3.1 Flash: dá para reduzir, mas não desativar
Essa é a armadilha mais comum na migração do M3. O recurso de raciocínio do M3.1 Flash não pode ser desativado: se a solicitação incluir thinking disabled ou effort none, a API retornará um erro 400. A mensagem exata é model "MiniMax-M3.1-Flash" requires adaptive thinking. Para reduzir o tempo e o consumo de tokens, a única opção é diminuir o nível de effort.
Quanto mais alto o nível de effort, mais o modelo raciocina, mais tokens gera e maior é a latência. O nome do parâmetro muda conforme o protocolo: no protocolo Anthropic, é output_config.effort; no protocolo OpenAI, é reasoning_effort; e no protocolo Responses, é reasoning.effort. Além disso, o conteúdo do raciocínio agora é retornado separadamente. No protocolo compatível com OpenAI, ele fica no campo reasoning_content, enquanto content contém apenas a resposta final. Se antes você extraía o conteúdo de raciocínio das tags <think> do M3, será preciso adaptar esse código.
🚀 Sugestão para começar rapidamente: até a publicação deste artigo, o MiniMax-M3.1-Flash ainda não está disponível na página de preços da APIYI. Vamos disponibilizar o modelo em breve. Consulte a página de preços da APIYI para saber se ele já pode ser usado. Se quiser se familiarizar com o formato das APIs da série MiniMax, você pode chamar o MiniMax-M3 diretamente em apiyi.com, da APIYI. Ele é compatível com os formatos de API OpenAI e Anthropic e também está disponível no grupo ClaudeCode.
Dados de testes do MiniMax M3.1 Flash: números divulgados pela empresa vs. avaliações independentes
Benchmark é uma forma de avaliar um modelo usando um conjunto fixo de questões. Mesmo com o mesmo nome de teste, as pontuações podem variar bastante conforme a instituição e o ambiente de execução. Por isso, antes de olhar os números, vale conferir quem fez a avaliação e em quais condições.
| Teste | Pontuação | Fonte | Condições do teste / observações |
|---|---|---|---|
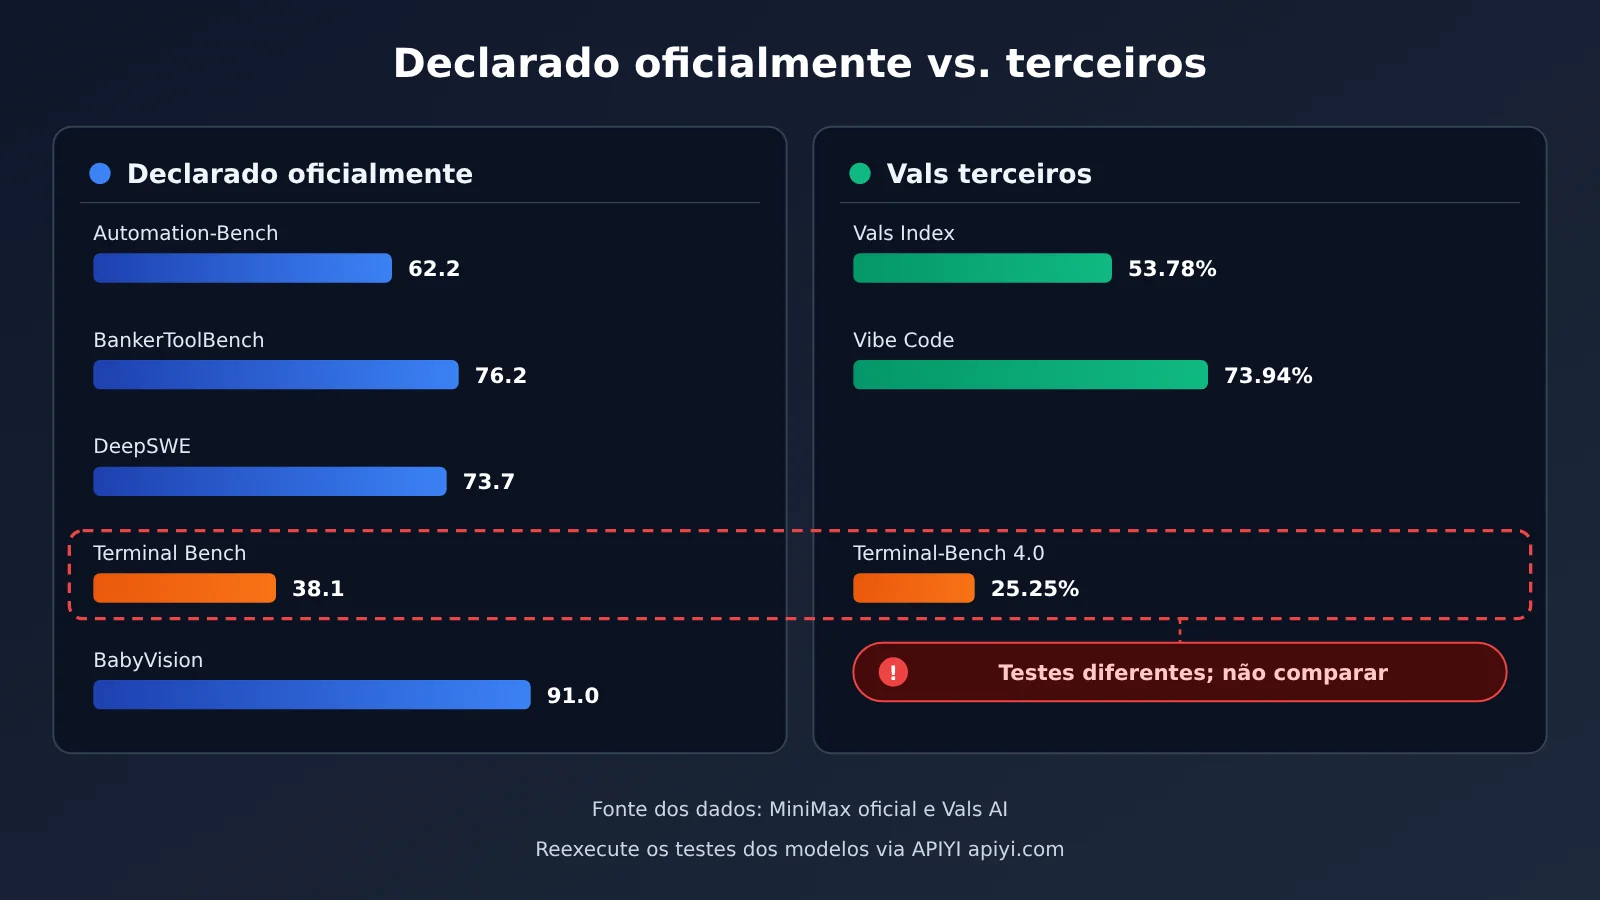
| Automation-Bench v1.0.6 | 62.2 (Opus 5: 50.3) | Divulgado pela empresa | Tabela oficial; no gráfico oficial de custos, a pontuação mostrada para a versão max é 62.8 |
| BankerToolBench | 76.2 (empatado com Opus 5) | Divulgado pela empresa | Tarefas de uso de ferramentas no setor bancário |
| DeepSWE v1.1 | 73.7% (DeepSeek V4.1 Flash-1017: 77.0) | Divulgado pela empresa | Outro modelo teve pontuação mais alta na tabela oficial |
| OSWorld V2 | 61.7 | Divulgado pela empresa | A empresa afirma que é o melhor modelo chinês |
| Agents’ Last Exam (ALE) | 29.6 | Divulgado pela empresa | A empresa afirma que é o melhor modelo chinês |
| CyberGym | 82% | Divulgado pela empresa | Tarefas de segurança |
| Terminal Bench 4.0 | 38.1 (Opus 5: 51.8) | Divulgado pela empresa | 13.7 pontos abaixo do Opus 5 |
| SWE Refactor Bench | 23.0 (Opus 5: 31.0) | Divulgado pela empresa | Tarefas de refatoração de código |
| BabyVision (com ferramentas) | 91.0 | Divulgado pela empresa | Compreensão visual |
| HLE (sem ferramentas) | 43.4 | Divulgado pela empresa | Perguntas e respostas abrangentes de alta dificuldade |
| Vals Index | 53.78%, 15º entre 22 modelos | Avaliação independente da Vals | 5º entre 11 modelos com pesos abertos, ligeiramente abaixo do Xiaomi MiMo V2.6 Flash (54.83%) |
| Terminal-Bench 4.0 | 25.25%, 22º entre 51 modelos | Avaliação independente da Vals | API oficial, temperature 1, top_p 0.95, effort max, saída máxima de 262k |
| HLAB-Vals-1.1 | 7.50%, 17º entre 23 modelos | Avaliação independente da Vals | Mesmas condições acima |
Vale destacar: na tabela oficial, o modelo da Anthropic usado para comparação é o Claude Opus 5, não o Opus 5.5. O Claude Opus 5.5 continua sendo o modelo flagship mais poderoso da Anthropic, e a empresa não o comparou com o M3.1 Flash em cada teste. Portanto, afirmações como «o M3.1 Flash alcançou o Opus 5.5» não têm fundamento.
4 pontos em que os números do MiniMax M3.1 Flash não batem
- Terminal Bench: 38,1 na avaliação oficial contra 25,25% na Vals. As duas avaliações usam o nome Terminal-Bench 4.0, mas os frameworks de teste são diferentes. O framework de teste é o ambiente de execução e o programa de orquestração preparados para o modelo; ele influencia diretamente a capacidade do modelo de concluir comandos com várias etapas. Por isso, não dá para comparar os dois números diretamente nem afirmar que “a avaliação oficial inflou o resultado em 13 pontos”. A conclusão comum às duas avaliações é que tarefas longas de terminal são um ponto fraco do M3.1 Flash. Na própria tabela oficial, ele fica atrás do Opus 5; no ranking da Vals, também aparece na faixa intermediária inferior entre 51 modelos.
- Automation-Bench: 62,8 no gráfico de custos contra 62,2 na tabela. O mesmo material oficial apresenta dois números, com uma diferença de 0,6 ponto, que pouco afeta a conclusão. Ainda assim, isso mostra que o próprio material oficial tem divergências. Ao citar os dados, é recomendável usar o número da tabela e indicar a fonte.
- Custo: “70% menor”, “1/3” e “metade”. O blog oficial diz que o custo combinado de tarefas do tipo Agent é 70% menor que o da geração anterior; uma publicação oficial no X diz que é 1/3 do custo do M3. Considerando apenas o preço por token, o Flash custa metade do preço padrão do M3 (US$ 0,15 contra US$ 0,30). Segundo a comunicação oficial, os outros números consideram o custo por tarefa, mas o método de cálculo não foi divulgado.
- Velocidade: mais de 170, mais de 200 e cerca de 150. A próxima seção explica isso em detalhes.
Como avaliar a velocidade do MiniMax M3.1 Flash: todos os números de TPS são oficiais
TPS (tokens por segundo) indica quantos tokens o modelo gera por segundo. Quanto maior o valor, mais rápido o texto é produzido. P50 é a mediana: ordenando a velocidade de todas as solicitações da menor para a maior, o valor que fica bem no meio é o P50. Ele costuma representar melhor o «desempenho típico» do que a média.
Até agora, os dados de velocidade disponíveis publicamente vêm todos da própria MiniMax. Não encontramos medições independentes de terceiros:
- Blog oficial: a geração em uso cotidiano pode chegar a mais de 200 TPS, com P50 estável acima de 170 TPS;
- Página oficial do produto: cerca de 150 tokens por segundo;
- Blog oficial e publicação no X: velocidade de inferência online aproximadamente 3 vezes maior que a do M3.
Esses números usam critérios diferentes; o valor informado na página do produto é mais conservador. O ponto mais importante é que TPS alto não significa necessariamente respostas rápidas. O effort padrão do M3.1 Flash é max, e os tokens usados para pensar também entram na contagem da saída. Se uma tarefa exigir primeiro «pensar» em alguns milhares de tokens, mesmo a 170 tokens por segundo, pode demorar bastante até a resposta final. Na prática, a velocidade depende de «total de tokens gerados ÷ TPS + tempo até o primeiro token». Por isso, a lista de verificação para os testes abaixo pede que você registre tanto a quantidade de tokens quanto o tempo gasto.
Limites de capacidade do MiniMax M3.1 Flash: pontos fortes e fracos
Vamos começar pelos avanços em relação à geração anterior, o M3, registrados pela Vals. Todos os resultados da tabela abaixo são de avaliações de terceiros.
| Teste da Vals | M3.1 Flash | M3 | Variação |
|---|---|---|---|
| Vibe Code Bench | 73,94% | 47,57% | Grande avanço |
| Tax Agent Bench | 32,14% | 20,59% | Avanço significativo |
| EMB v1.1 | 67,84% | 59,75% | Avanço |
| Finance Agent v2.1 | 58,83% | 54,34% | Pequeno avanço |
| Legal Research Bench | 34,13% | 29,81% | Pequeno avanço |
| Dimensão | Avaliação | Base |
|---|---|---|
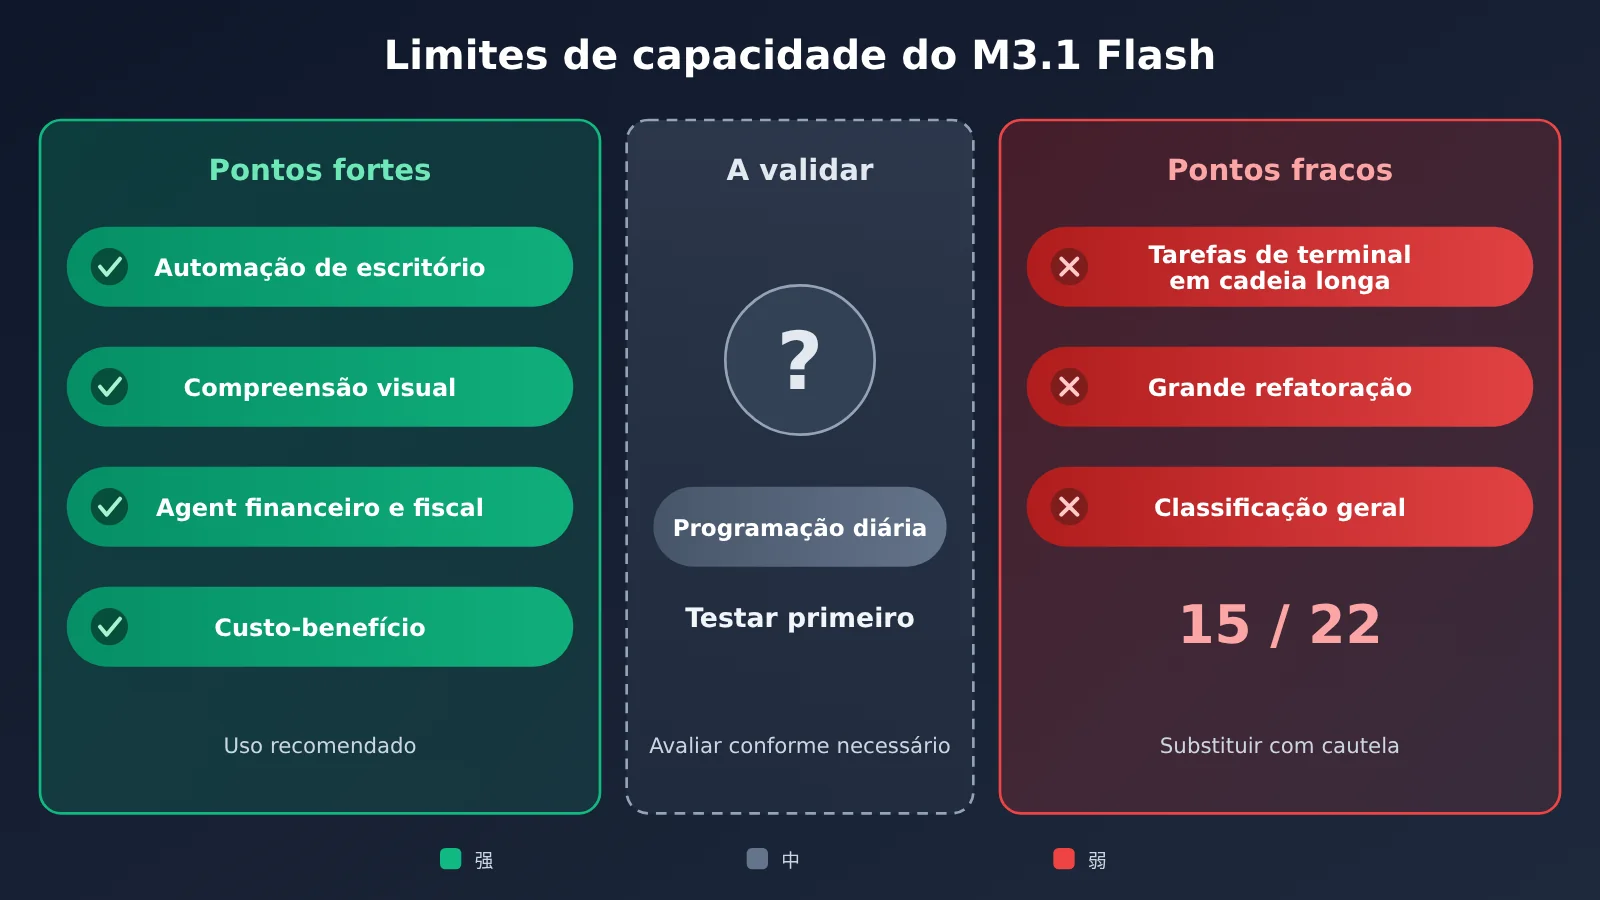
| Automação de escritório com Agent | Forte | Automation-Bench oficial: 62,2 (Opus 5: 50,3); OSWorld V2: 61,7 |
| Compreensão visual | Forte | BabyVision oficial (com ferramentas): 91,0; aceita imagens e vídeos como entrada |
| Agents de finanças e impostos | Relativamente forte | BankerToolBench oficial: 76,2; nos testes de impostos e finanças da Vals, supera o M3 |
| Custo-benefício | Forte | O preço oficial é metade do preço padrão do M3, sem cobrança adicional por contexto longo |
| Tarefas de terminal com fluxos longos | Fraco | No Terminal Bench oficial, fica 13,7 pontos atrás do Opus 5; no Terminal-Bench 4.0 da Vals, ocupa a 22ª posição entre 51 modelos |
| Grandes refatorações de código | Fraco | SWE Refactor Bench oficial: 23,0; Opus 5: 31,0 |
| Nível geral | Intermediário | 15º entre 22 modelos no Vals Index |
Resumo dos pontos fortes
- Preço baixo e cobrança simples: US$ 0,15 para entrada e US$ 0,60 para saída. O preço é o mesmo para contextos de até 1 milhão de tokens, o que favorece chamadas em grande escala;
- Bom desempenho em automação de escritório e Agents visuais: os resultados oficiais e de terceiros apontam na mesma direção em tarefas como organizar planilhas, navegar em páginas da web e reconhecer imagens;
- Avanço significativo em relação ao M3: no Vibe Code Bench da Vals, o resultado passou de 47,57% para 73,94%, elevando o nível do modelo em tarefas cotidianas de criação de pequenos aplicativos.
Resumo das limitações
- Ainda fica atrás em tarefas de engenharia complexas: em tarefas com várias etapas no terminal e grandes mudanças em vários arquivos, os próprios dados oficiais mostram que o modelo fica atrás do Opus 5;
- Não dá para desativar o modo de raciocínio: até perguntas curtas passam pelo processo de raciocínio, o que não é ideal em situações sensíveis à latência até o primeiro token;
- Transparência limitada: o método de cálculo de custos e o relatório técnico oficiais ainda não foram publicados. Por isso, a afirmação de que o custo é “1/3” ainda não pode ser verificada de forma independente.
Quando não vale a pena trocar pelo MiniMax M3.1 Flash
Nos 6 casos abaixo, é melhor não trocar seu modelo principal pelo M3.1 Flash — ou, pelo menos, fazer alguns testes antes de decidir:
- Sua principal tarefa é usar agentes de terminal em fluxos longos: por exemplo, executar CI automaticamente, investigar problemas em servidores ou rodar dezenas de comandos de uma vez. Os dados oficiais e os da Vals apontam esse tipo de tarefa como um ponto fraco. Se o Claude Opus 5.5 já funciona bem para você, o custo do retrabalho causado pela troca pode superar a economia com tokens.
- Você costuma fazer grandes refatorações: tarefas como alterar interfaces em mais de dez arquivos ou dividir módulos. No SWE Refactor Bench oficial, o resultado do modelo foi 23,0, contra 31,0 do Opus 5 — uma diferença considerável. Para esse tipo de tarefa, vale continuar usando um modelo de ponta.
- Você precisa desativar o raciocínio para obter latência muito baixa: em cenários como atendimento ao cliente em tempo real, classificação de intenção e preenchimento automático, não é possível desativar o raciocínio do M3.1 Flash. Mesmo no nível low, há um tempo de espera a mais em comparação com modelos que não usam raciocínio.
- Sua integração atual depende da análise das tags
<think>e não há previsão de reformulação no curto prazo: no M3.1 Flash, o conteúdo de raciocínio é retornado em um campo separado. Se você apenas trocar o nome do modelo, sua lógica de análise pode não conseguir obter os dados — ou até gerar um erro. - Você precisa implantar o modelo localmente e em ambiente privado agora: segundo o anúncio oficial, os pesos seriam disponibilizados em 23 de outubro, mas ainda não tinham sido publicados até a data deste artigo. A equipe também não divulgou informações como os requisitos de memória de vídeo necessários para a implantação. Por enquanto, não dá para planejar o hardware com segurança.
- O custo por token parece baixo, mas o custo por tarefa pode não ser: no nível max, o modelo pode gerar muitos tokens de raciocínio. Se suas tarefas têm respostas curtas e o modelo que você usa hoje já é barato, a troca pode não reduzir a conta na prática. Compare sempre o custo por tarefa.
Checklist de 30 minutos para testar o MiniMax M3.1 Flash
Os rankings mostram apenas o desempenho médio. O padrão final é o que funciona para as suas tarefas. Siga os passos abaixo para fazer uma comparação em 30 minutos. Você pode usar a API oficial da MiniMax ou o endpoint gratuito com limite de requisições do OpenRouter: minimax/minimax-m3.1-flash:free.
- Escolha as tarefas (cerca de 5 minutos): selecione 3 tipos de tarefas reais do seu trabalho recente, com 3 a 5 exemplos de cada tipo. O primeiro tipo deve incluir tarefas em lote com regras claras, como organizar planilhas e escrever resumos. O segundo deve ser composto pelas tarefas que você mais faz no dia a dia. O terceiro deve incluir as tarefas difíceis que mais preocupam você, como operações no terminal com várias etapas ou alterações em vários arquivos.
- Mantenha os parâmetros fixos: primeiro, teste o M3.1 Flash no nível medium e, depois, no nível max, que é o padrão. Anote o nível usado em cada teste. Mantenha as mesmas configurações no modelo de comparação que você usa atualmente. Não faça ajustes durante o teste.
- Compare as mesmas tarefas (cerca de 15 minutos): use exatamente o mesmo comando e contexto nos dois modelos e execute todas as tarefas, uma por uma.
- Registre os dados: para cada tarefa, anote os tokens de entrada, os tokens de saída (incluindo a parte de raciocínio), o tempo total, se o resultado foi correto na primeira tentativa e quanto conteúdo você precisou corrigir manualmente.
- Calcule o custo por tarefa (cerca de 10 minutos): use a fórmula oficial — “uso ÷ 1.000.000 × preço unitário” — e some os custos de entrada, saída e leitura do cache para descobrir quanto cada tarefa custou de fato.
- Tire conclusões por categoria: se a qualidade de uma categoria for aceitável e o custo por tarefa for menor, migre apenas essa categoria. Se o modelo falhar claramente nas tarefas difíceis do terceiro tipo, continue usando o modelo original para elas.
💡 Sugestão para o grupo de comparação: você pode usar a APIYI (apiyi.com) para chamar
claude-opus-5-5ouMiniMax-M3com a mesma chave API. Assim, não precisa criar contas em várias plataformas só para fazer um teste comparativo.
Como combinar as séries MiniMax e Claude Opus 5.5 na APIYI
O posicionamento do M3.1 Flash faz dele uma opção mais adequada para atuar como o “operário de processamento em lote” da equipe do que como o único modelo. Uma abordagem prática é distribuir as tarefas conforme o nível de dificuldade: deixar os trabalhos baratos e volumosos com a série MiniMax e delegar o planejamento complexo e a refatoração ao Claude Opus 5.5.
| Modelo | Perfil | Tarefas indicadas | Plataformas disponíveis |
|---|---|---|---|
| MiniMax-M3.1-Flash | Modelo de agente rápido e de baixo custo | Automação de escritório, visão computacional, tarefas financeiras e fiscais em lote | API oficial da MiniMax / M Plan; a disponibilidade na APIYI deve ser confirmada na página de preços |
| MiniMax-M3 | Modelo principal da geração anterior | Tarefas cotidianas em chinês, processamento em lote | APIYI apiyi.com (formatos compatíveis com OpenAI e Anthropic) |
| claude-opus-5-5 | Modelo flagship mais avançado da Anthropic | Planejamento complexo, grandes refatorações, agentes com fluxos longos | APIYI apiyi.com |
| claude-opus-5 | Modelo flagship da geração anterior | Referência para comparação nas tabelas oficiais de benchmarks | APIYI apiyi.com |
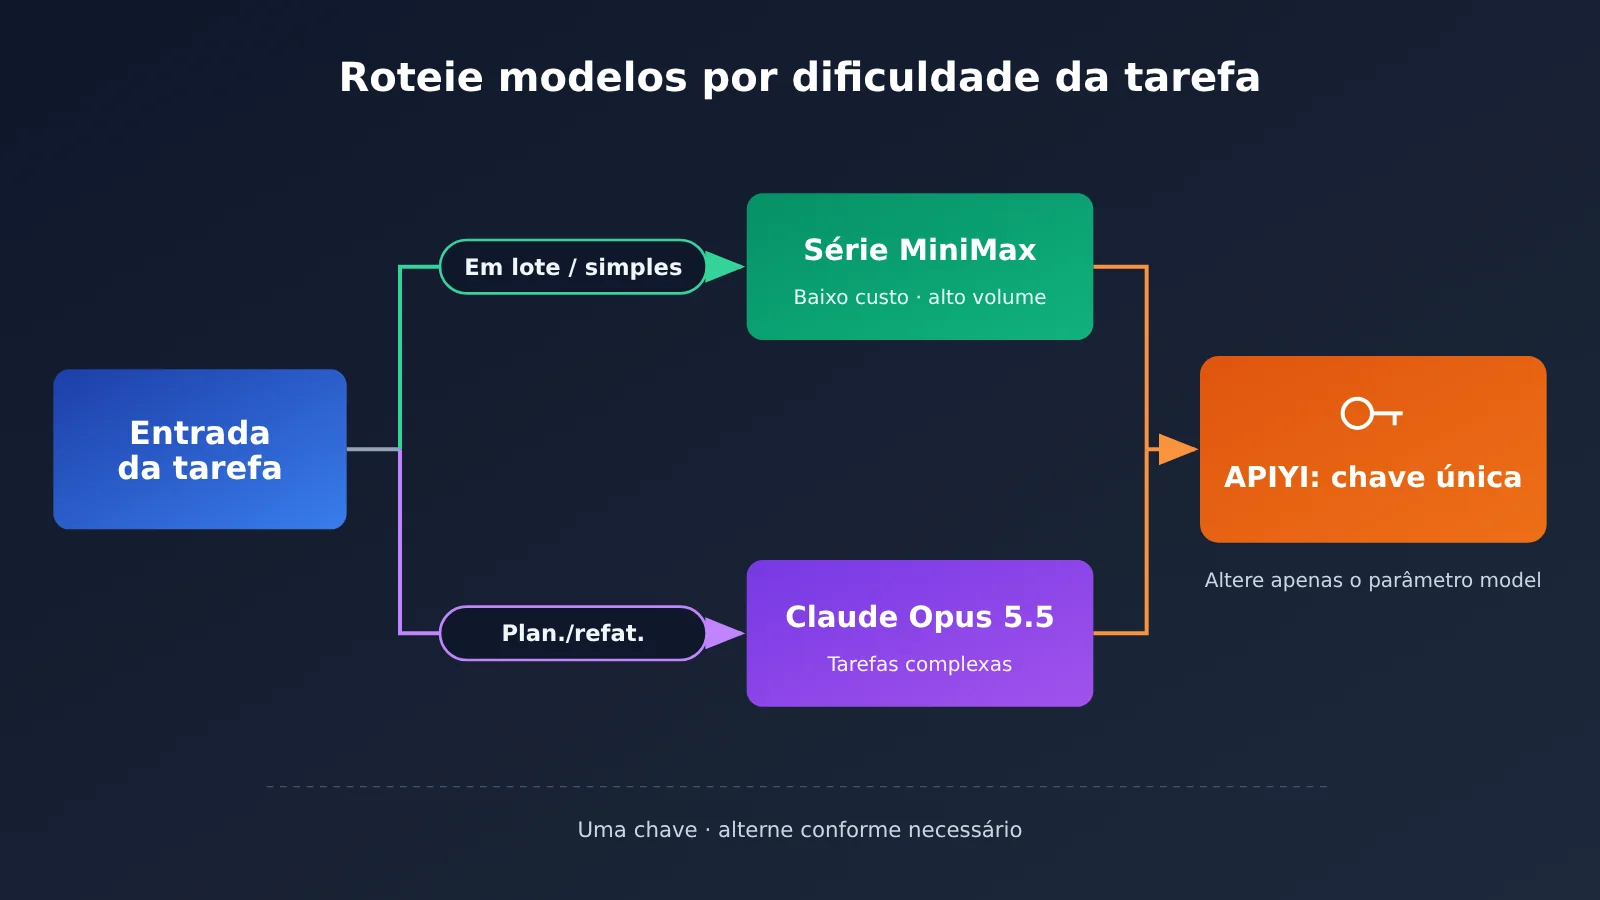
Na APIYI, uma única chave permite chamar modelos internacionais como Claude, GPT e Gemini, além de modelos chineses como DeepSeek e MiniMax. Para trocar de modelo, basta alterar o parâmetro model:
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_APIYI_KEY",
    base_url="https://api.apiyi.com/v1"  # APIYI 统一接口
)

def ask(model, prompt):
    resp = client.chat.completions.create(
        model=model,
        messages=[{"role": "user", "content": prompt}],
    )
    return resp.choices[0].message.content

# 便宜、量大的活交给 MiniMax 系列
print(ask("MiniMax-M3", "把这段会议纪要整理成 5 条待办"))

# 难的规划和重构交给 Claude Opus 5.5
print(ask("claude-opus-5-5", "为这个单体服务设计分阶段拆分方案"))
Em relação aos preços, de acordo com os valores oficiais publicados pela APIYI, o claude-opus-5-5 custa US$ 4 por milhão de tokens de entrada e US$ 20 por milhão de tokens de saída. O claude-opus-5 custa US$ 5 e US$ 25, respectivamente. Se o MiniMax-M3.1-Flash aparecer na página de preços da APIYI, basta usar o nome do modelo e o preço informados nessa página.
Perguntas frequentes
P1: Em que o MiniMax M3.1 Flash se destaca?
Segundo os dados divulgados pela própria empresa e os resultados da Vals, seus pontos fortes são a automação de tarefas de escritório com agentes, a compreensão visual, o uso de ferramentas em áreas como finanças e impostos e o preço baixo. No ranking geral da Vals, ficou em 15º lugar entre 22 modelos, um resultado intermediário. Não é um modelo que se destaca em tudo.
P2: Qual é melhor: ele ou o Claude Opus 5.5?
A empresa não fez uma comparação item a item com o Opus 5.5. Na tabela oficial, o modelo usado como referência é o Opus 5. Mesmo em comparação com o Opus 5, o M3.1 Flash fica atrás no Terminal Bench e no SWE Refactor Bench. O Opus 5.5 continua sendo o modelo flagship mais poderoso da Anthropic.
P3: Qual resultado do Terminal Bench está correto: os 38,1% oficiais ou os 25,25% da Vals?
Os dois resultados são reais, mas foram obtidos com estruturas de avaliação diferentes e não podem ser comparados diretamente. A conclusão em comum é que tarefas de terminal com cadeias longas são um ponto fraco do M3.1 Flash.
P4: Já é possível usar o M3.1 Flash pela APIYI?
Em 22/10/2026, o MiniMax-M3.1-Flash ainda não aparecia na página de preços da APIYI. Consulte essa página para confirmar se o modelo está disponível. No momento, você pode usar diretamente pela APIYI, em apiyi.com, modelos como o MiniMax-M3 e o claude-opus-5-5.
P5: Em qual nível devo configurar o parâmetro effort?
Se você não informar um valor, o padrão é `max`. Esse nível oferece o resultado mais completo, mas é o mais lento e também gera mais tokens de saída. Para tarefas simples em lote, vale começar com `low` ou `medium` e aumentar o nível se a qualidade não for suficiente. Não é possível desativar o raciocínio.
P6: Posso usar diretamente como chave API a chave da assinatura M Plan?
Não. Segundo o FAQ oficial, a chave API com cobrança por uso e a chave de assinatura do M Plan são diferentes e devem ser obtidas em áreas distintas do painel. Consulte o site oficial para ver o preço mensal de cada plano do M Plan.
P7: Como posso testar o desempenho por conta própria e gastando pouco?
Você pode começar executando algumas tarefas nos endpoints gratuitos com limite de uso do OpenRouter. Para comparar com modelos flagship, use o mesmo chave API pela APIYI, em apiyi.com, e registre o consumo de tokens e o tempo de execução seguindo a lista de verificação de 30 minutos deste artigo.
Principais pontos sobre o MiniMax M3.1 Flash
- Este artigo não inclui testes próprios: todos os números vêm de dados divulgados pela MiniMax ou de avaliações de terceiros feitas pela Vals;
- Desempenho intermediário no geral: o Vals Index é de 53,78%, com o modelo na 15ª posição entre 22;
- Pontos fortes bem definidos: automação de escritório, compreensão visual, agentes de IA para finanças e impostos, além do baixo custo por unidade;
- Pontos fracos bem definidos: tarefas de terminal com cadeias longas e grandes refatorações; até na tabela oficial, o modelo fica atrás do Opus 5;
- Os números dependem dos critérios usados: as duas pontuações do Terminal Bench não podem ser comparadas diretamente, e os dados de custo e velocidade seguem os critérios divulgados pela própria MiniMax;
- Não dá para desligar o raciocínio: só é possível reduzir o nível de esforço. Para migrar do M3, é preciso ajustar a lógica de análise das tags
<think>; - Combinar modelos pode sair mais em conta: use uma única chave API na APIYI para combinar os modelos da linha MiniMax com o Opus 5.5 e distribuir as tarefas conforme a dificuldade.
Resumo
Os principais pontos sobre o MiniMax M3.1 Flash:
- Limites de capacidade: o modelo se destaca em automação de escritório, compreensão visual e tarefas de agentes de IA para finanças e impostos, mas não é tão adequado a tarefas de terminal com cadeias longas nem a grandes refatorações;
- Critérios por trás dos números: os dados oficiais e os de terceiros usam estruturas de avaliação diferentes. Até nos materiais oficiais há pequenas divergências, como 62,8 e 62,2. Ao citar esses números, informe a fonte;
- Vale a pena trocar?: vale testar o modelo em tarefas em lote com regras claras. Para as tarefas mais difíceis, é melhor não trocar ainda — faça um teste de 30 minutos para decidir.
A recomendação é começar comparando os modelos com tarefas reais e, depois, migrar aos poucos, por categoria. Evite substituir tudo de uma vez. Você pode chamar o modelo de referência e os modelos MiniMax-M3 e claude-opus-5-5 que já usa por meio da APIYI, em apiyi.com, e fazer testes comparativos com a mesma chave API.
📚 Referências
- Blog oficial de lançamento da MiniMax: resultados de benchmark, velocidade e preços oficiais do M3.1 Flash
- Link:
minimax.io/blog/minimax-m31f -
Observação: principal fonte dos dados divulgados pela própria empresa
-
Documentação oficial da MiniMax: invocação do modelo: parâmetro
effort, mecanismo de raciocínio e endereço da API - Link:
platform.minimax.io/docs/guides/text-generation -
Observação: leitura essencial para migração e integração
-
Página oficial de preços da MiniMax: regras de cobrança do M3.1 Flash e do M3
- Link:
platform.minimax.io/docs/guides/pricing -
Observação: usada para calcular o custo por tarefa
-
Página do modelo no Vals AI: resultados de avaliações de terceiros do M3.1 Flash
- Link:
vals.ai/models/minimax_MiniMax-M3.1-flash -
Observação: inclui classificações e condições dos testes
-
Reportagem do MarkTechPost: compilação da tabela comparativa oficial
- Link:
marktechpost.com/2026/10/19/minimax-m3-1-flash-release - Observação: inclui dados de comparação com o Opus 5 e diferenças nos gráficos de custos
Autor: equipe técnica da APIYI
Contato técnico: entre em contato conosco pela página inicial do site APIYI, em apiyi.com. Mais materiais de integração estão disponíveis na central de documentação, em docs.apiyi.com.