Nota del autor: Hemos comparado punto por punto las cifras publicadas por MiniMax con las evaluaciones de terceros de Vals para ayudarte a decidir si MiniMax M3.1 Flash es adecuado para ti y cuándo no deberías cambiar de modelo.
Conclusión en una frase: MiniMax M3.1 Flash es barato y rápido, y destaca en automatización de oficina, tareas visuales y tareas de agentes relacionadas con finanzas e impuestos; sin embargo, queda claramente por detrás de los modelos insignia de Claude en tareas complejas con terminal y refactorizaciones de código a gran escala. Es adecuado para hacerse cargo de tareas repetitivas y con reglas claras, pero no para sustituir al modelo principal en las tareas más difíciles.
Antes de empezar, aclaremos el alcance de este artículo: «pruebas reales» en el título se refiere a un resumen de evaluaciones públicas de terceros, principalmente de Vals AI. No hemos realizado nuestras propias pruebas de rendimiento y el artículo no incluye datos de pruebas propias. Todas las cifras indican su fuente y se clasifican en tres categorías: «declaradas por el fabricante» (publicadas por MiniMax), «evaluaciones de terceros» (Vals y otros) y «desconocidas/no publicadas».
Valor principal: Al terminar de leer, sabrás en qué puntos no coinciden las cifras oficiales y las de terceros, cuáles son las fortalezas y limitaciones de MiniMax M3.1 Flash y, además, tendrás una lista de comprobación para hacer tus propias pruebas en 30 minutos y decidir si conviene cambiar de modelo para tus tareas.
Repaso de las funciones principales de MiniMax M3.1 Flash
Antes, repasemos algunos conceptos básicos. Token es la unidad que se utiliza para calcular el costo y la longitud del contenido procesado por el modelo. Según la conversión oficial, unos 750 términos en inglés equivalen aproximadamente a 1000 tokens. Agent se refiere a un uso del modelo en el que puede llamar a herramientas por su cuenta y completar tareas en varios pasos, como rellenar formularios automáticamente, ejecutar comandos en la línea de comandos o consultar información y luego redactar un informe. La ventana de contexto es la cantidad máxima de contenido que el modelo puede «ver» en una sola interacción.
La información de la tabla siguiente procede íntegramente de la documentación oficial y la página de precios de MiniMax: son datos «declarados por la propia empresa».
| Elemento | Información oficial sobre MiniMax M3.1 Flash | Descripción |
|---|---|---|
| Nombre del modelo | MiniMax-M3.1-Flash | El nombre anterior, MiniMax-M3.1-Flash-Preview, ya está retirado. Las solicitudes que usen ese nombre se redirigen automáticamente al nuevo modelo. |
| Arquitectura | MoE, 428B de parámetros totales y unos 23B activos | La misma que M3. MiniMax todavía no ha publicado un informe técnico que explique los cambios de Flash. |
| Ventana de contexto | 1,000,000 tokens | La página de Vals indica que la salida máxima es de 524,288 tokens. |
| Entrada / salida | Entrada de texto, imágenes y video; salida de texto | Admite comprensión multimodal. |
| Nivel de razonamiento (effort) | low / medium / high / xhigh / max | Si no se especifica ningún parámetro, el valor predeterminado es max. |
| Precio (por millón de tokens) | Entrada: $0.15; salida: $0.60; lectura de caché: $0.015 | No hay recargo por contexto largo. |
| Pesos de código abierto | Una publicación oficial en X afirma que se publicarán el 23 de octubre | A la fecha de publicación (22 de octubre), todavía no se habían publicado. |
MoE (mezcla de expertos) es una arquitectura de modelo en la que hay muchos parámetros en total, pero en cada operación solo participa una pequeña parte de los «expertos». Así se puede mantener una gran capacidad y, al mismo tiempo, controlar el costo de inferencia. La lectura de caché se refiere al contenido de entrada que se repite —por ejemplo, una indicación del sistema fija— y que, al encontrarse en la caché, se factura a un precio más bajo.
El mecanismo de razonamiento de MiniMax M3.1 Flash: se puede reducir, pero no desactivar
Este es uno de los errores más comunes al migrar desde M3. La función de razonamiento de M3.1 Flash no se puede desactivar: si se envía thinking disabled o effort none en la solicitud, la interfaz devuelve directamente un error 400. El mensaje de error original es model "MiniMax-M3.1-Flash" requires adaptive thinking. Para ahorrar tiempo y tokens, la única opción es reducir el valor de effort.
Cuanto más alto sea el nivel de effort, más razonará el modelo, más tokens generará y mayor será la latencia. El nombre del parámetro cambia según el protocolo: en el protocolo de Anthropic es output_config.effort; en el de OpenAI, reasoning_effort; y en el de Responses, reasoning.effort. Además, el contenido del razonamiento ahora se devuelve por separado. Con el protocolo compatible con OpenAI, aparece en el campo reasoning_content, mientras que content contiene solo la respuesta final. Si antes extraías el razonamiento de las etiquetas <think> de M3, tendrás que modificar esa parte del código.
🚀 Recomendación para empezar rápidamente: a la fecha de publicación, MiniMax-M3.1-Flash todavía no aparece en la página de precios de APIYI; lo incorporaremos lo antes posible. Consulta la página de precios de APIYI para confirmar si ya está disponible. Si quieres familiarizarte primero con el formato de las interfaces de la serie MiniMax, puedes llamar directamente a MiniMax-M3 en APIYI apiyi.com. Admite los formatos de interfaz de OpenAI y Anthropic, y está disponible en el grupo ClaudeCode.
Datos reales de MiniMax M3.1 Flash: cifras oficiales frente a evaluaciones de terceros
Un benchmark consiste en puntuar un modelo con un conjunto fijo de preguntas. Aunque el nombre de la prueba sea el mismo, los resultados pueden variar mucho según quién la realice y el entorno de ejecución. Por eso, antes de fijarse en las cifras, conviene comprobar quién hizo la prueba y en qué condiciones.
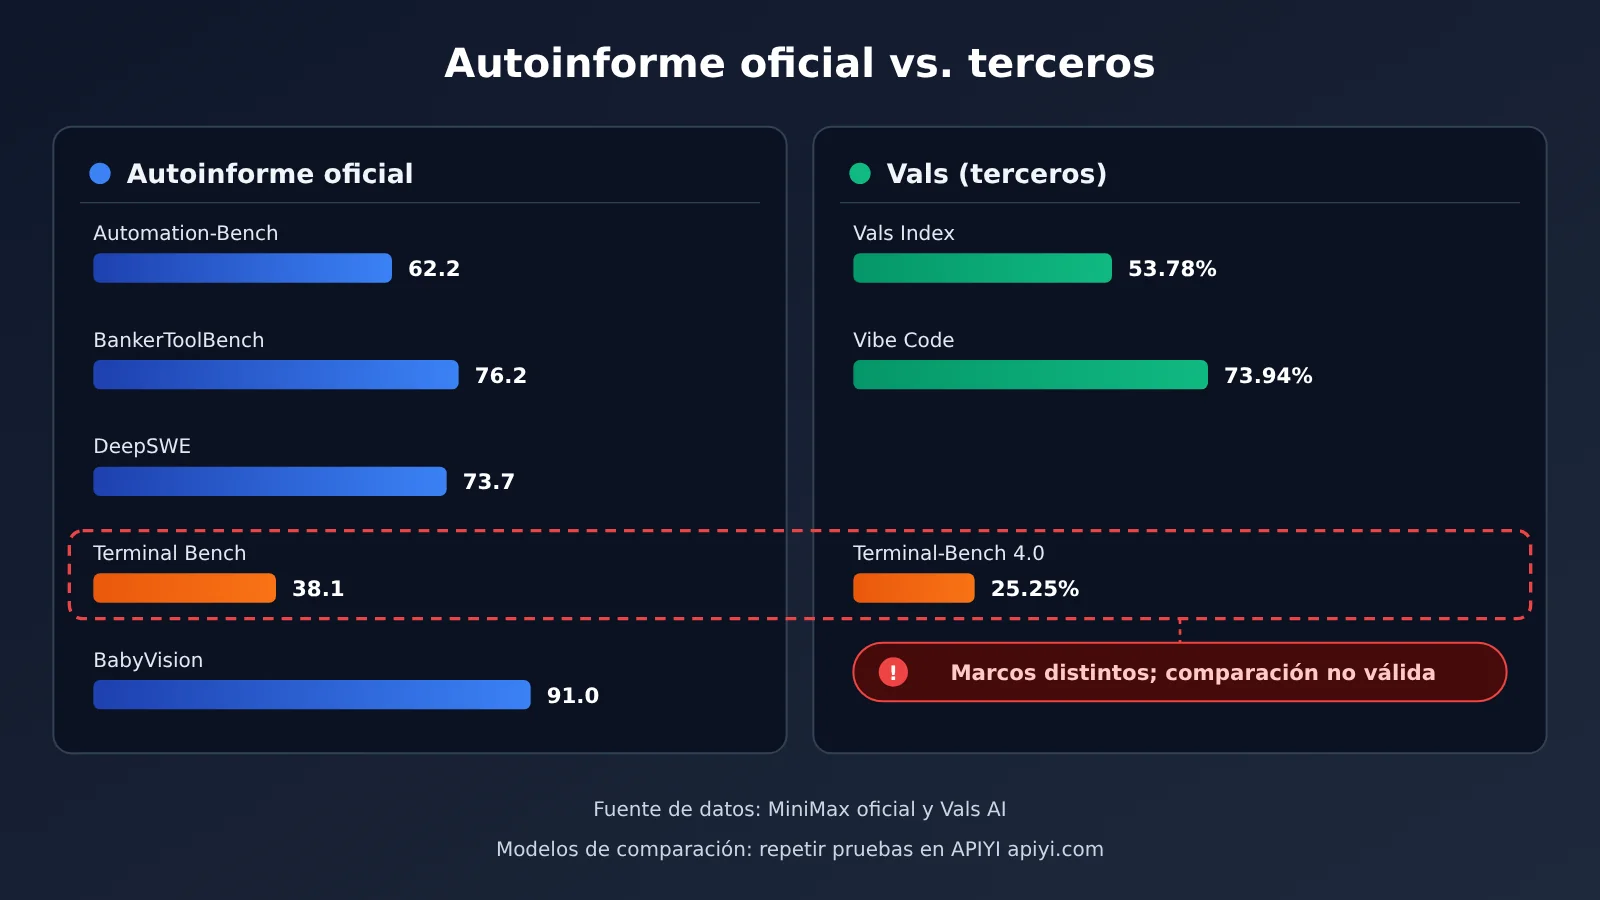
| Prueba | Puntuación | Fuente | Condiciones de prueba / notas |
|---|---|---|---|
| Automation-Bench v1.0.6 | 62.2 (Opus 5 obtuvo 50.3) | Cifras oficiales | Tabla oficial; en el gráfico oficial de costos, la versión max aparece con 62.8 |
| BankerToolBench | 76.2 (a la par de Opus 5) | Cifras oficiales | Tareas de uso de herramientas en el sector bancario |
| DeepSWE v1.1 | 73.7% (DeepSeek V4.1 Flash-1017 obtuvo 77.0) | Cifras oficiales | En la tabla oficial, un modelo de la competencia obtuvo una puntuación superior |
| OSWorld V2 | 61.7 | Cifras oficiales | MiniMax lo presenta como el modelo chino líder |
| Agents’ Last Exam (ALE) | 29.6 | Cifras oficiales | MiniMax lo presenta como el modelo chino líder |
| CyberGym | 82% | Cifras oficiales | Tareas de seguridad |
| Terminal Bench 4.0 | 38.1 (Opus 5 obtuvo 51.8) | Cifras oficiales | 13.7 puntos por debajo de Opus 5 |
| SWE Refactor Bench | 23.0 (Opus 5 obtuvo 31.0) | Cifras oficiales | Tareas de refactorización de código |
| BabyVision (con herramientas) | 91.0 | Cifras oficiales | Comprensión visual |
| HLE (sin herramientas) | 43.4 | Cifras oficiales | Preguntas integrales de alta dificultad |
| Vals Index | 53.78%, puesto 15 de 22 modelos | Tercero independiente: Vals | Entre los modelos con pesos abiertos, puesto 5 de 11; ligeramente por debajo de Xiaomi MiMo V2.6 Flash (54.83%) |
| Terminal-Bench 4.0 | 25.25%, puesto 22 de 51 modelos | Tercero independiente: Vals | API oficial, temperature 1, top_p 0.95, effort max, salida máxima de 262k |
| HLAB-Vals-1.1 | 7.50%, puesto 17 de 23 modelos | Tercero independiente: Vals | Mismas condiciones |
Hay que aclarar un punto importante: en la tabla oficial, el modelo de referencia de Anthropic es Claude Opus 5, no Opus 5.5. Claude Opus 5.5 sigue siendo el modelo insignia más potente de Anthropic, pero la compañía no lo ha comparado prueba por prueba. Por tanto, afirmaciones como «M3.1 Flash alcanza a Opus 5.5» no tienen fundamento.
4 discrepancias en las cifras de MiniMax M3.1 Flash
-
Terminal Bench: 38,1 en la prueba oficial frente a 25,25 % en Vals. Ambas pruebas se llaman Terminal-Bench 4.0, pero usan marcos de evaluación distintos. El marco de evaluación es el entorno de ejecución y el programa de orquestación que se preparan para el modelo; ambos pueden influir directamente en su capacidad para completar correctamente tareas de varios pasos. Por eso, no se pueden comparar las dos cifras directamente ni afirmar que «la cifra oficial está inflada en 13 puntos». La conclusión común es que las tareas largas de terminal son un punto débil de M3.1 Flash. En la tabla oficial, queda por detrás de Opus 5, y en la clasificación de Vals se sitúa en la mitad inferior de 51 modelos.
-
Automation-Bench: 62,8 en el gráfico de costos frente a 62,2 en la tabla. En el mismo material oficial aparecen dos cifras distintas, con una diferencia de 0,6 puntos que apenas afecta a la conclusión. Aun así, esto demuestra que el propio material oficial contiene discrepancias. Al citarlo, conviene usar la cifra de la tabla e indicar la fuente.
-
Costos: «un 70 % menos», «un tercio» y «la mitad». En su blog oficial, la empresa afirma que el costo total de las tareas de agentes es un 70 % menor que el de la generación anterior. En una publicación oficial en X, dice que es un tercio del costo de M3. Si solo se compara el precio por token, Flash cuesta la mitad que M3 al precio estándar (0,15 $ frente a 0,30 $). La empresa calcula sus cifras por tarea, pero no ha hecho público el método concreto.
-
Velocidad: más de 170, más de 200 y alrededor de 150. Lo explicamos en detalle en la siguiente sección.
Cómo interpretar la velocidad de MiniMax M3.1 Flash: todos los TPS son cifras oficiales
TPS (tokens por segundo) indica cuántos tokens genera el modelo cada segundo. Cuanto mayor sea el valor, más rápido produce texto. P50 es la mediana: si ordenamos de menor a mayor la velocidad de todas las solicitudes, el valor que queda justo en el centro es el P50. Es más representativo de lo que suele ocurrir que el promedio.
Por ahora, todos los datos de velocidad publicados proceden de MiniMax. No hemos encontrado mediciones independientes de terceros:
- Blog oficial: en el uso diario puede alcanzar más de 200 TPS, con un P50 estable por encima de 170 TPS;
- Página oficial del producto: alrededor de 150 tokens por segundo;
- Blog oficial y publicaciones en X: su velocidad de inferencia en línea es aproximadamente 3 veces la de M3.
Estas cifras se basan en criterios distintos; la de la página del producto es más conservadora. Y hay un punto aún más importante: un TPS alto no significa que la respuesta llegue rápido. El valor predeterminado de effort en M3.1 Flash es max, y los tokens de razonamiento también cuentan como parte de la salida. Si una tarea requiere «pensar» primero varios miles de tokens, incluso a 170 tokens por segundo puede llevar bastante tiempo obtener la respuesta final. La velocidad que se percibe en la práctica depende de «tokens de salida totales ÷ TPS + tiempo de espera hasta el primer token». Por eso, en la lista de comprobación para las pruebas propias que aparece más adelante, se pide registrar tanto el número de tokens como el tiempo transcurrido.
Límites de capacidad de MiniMax M3.1 Flash: puntos fuertes y débiles
Veamos primero las mejoras registradas por Vals con respecto a la generación anterior, M3. Todas las pruebas de la tabla son «evaluaciones de terceros».
| Prueba de Vals | M3.1 Flash | M3 | Cambio |
|---|---|---|---|
| Vibe Code Bench | 73.94% | 47.57% | Gran mejora |
| Tax Agent Bench | 32.14% | 20.59% | Mejora notable |
| EMB v1.1 | 67.84% | 59.75% | Mejora |
| Finance Agent v2.1 | 58.83% | 54.34% | Ligera mejora |
| Legal Research Bench | 34.13% | 29.81% | Ligera mejora |
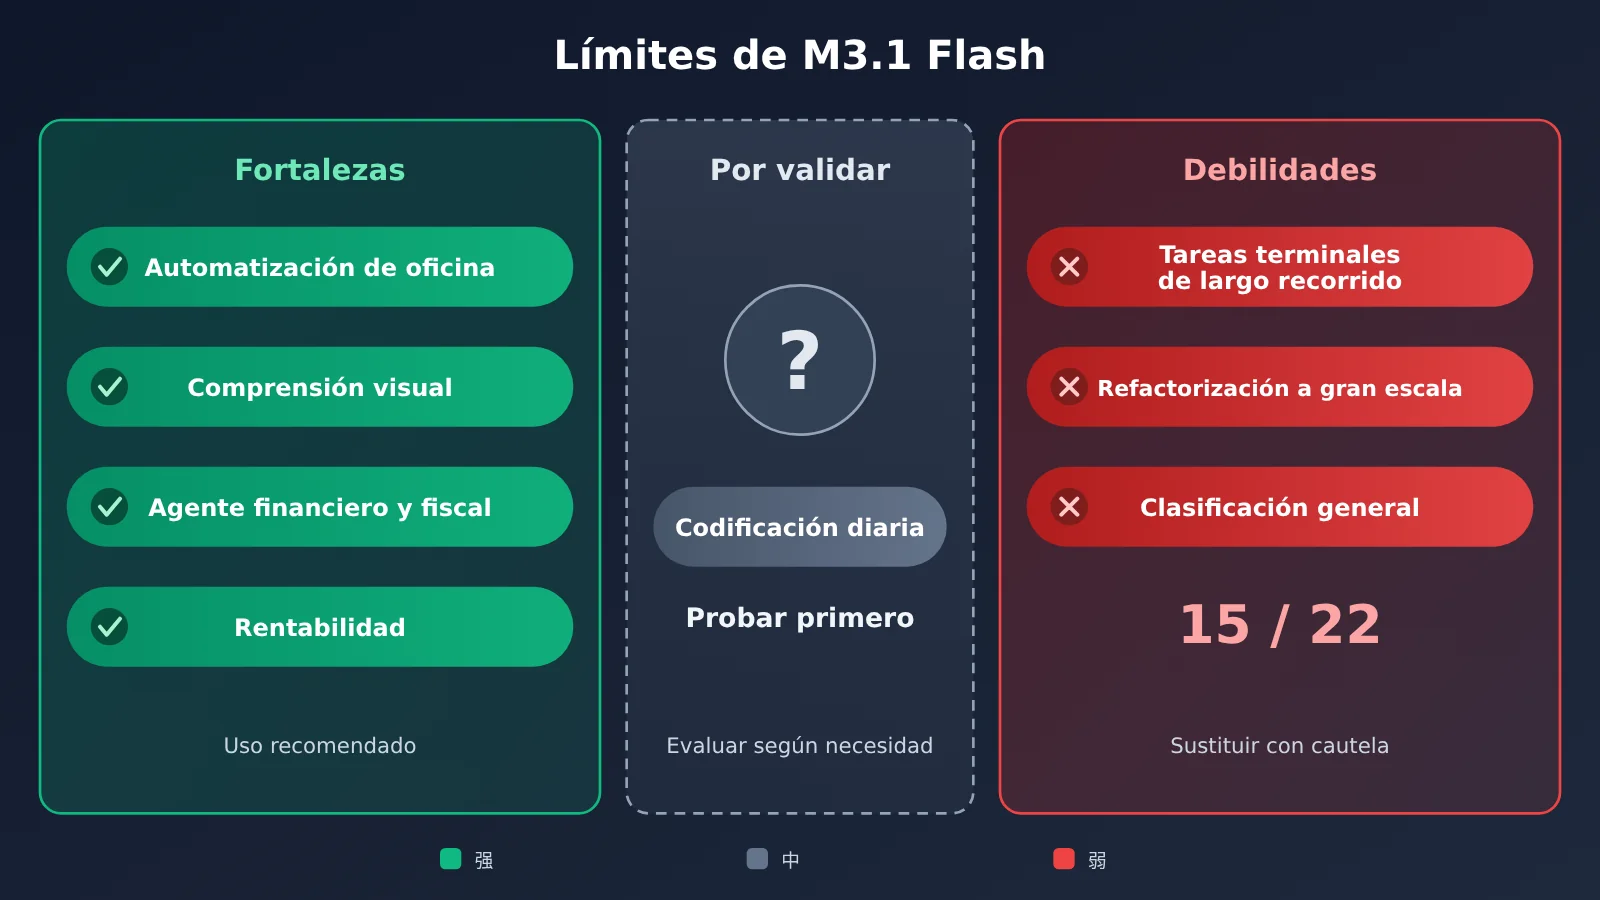
| Dimensión | Evaluación | Fundamento |
|---|---|---|
| Automatización de oficina con agentes | Fuerte | Automation-Bench oficial: 62.2 (Opus 5 obtiene 50.3); OSWorld V2: 61.7 |
| Comprensión visual | Fuerte | BabyVision oficial (con herramientas): 91.0; admite imágenes y vídeos como entrada |
| Agentes de finanzas y fiscalidad | Bastante fuerte | BankerToolBench oficial: 76.2; en las pruebas fiscales y financieras de Vals, mejora con respecto a M3 |
| Relación calidad-precio | Fuerte | El precio oficial es la mitad de la tarifa estándar de M3 y no hay recargo por contextos largos |
| Tareas terminales de larga duración | Débil | En Terminal Bench oficial queda 13.7 puntos por detrás de Opus 5; en Terminal-Bench 4.0 de Vals ocupa el puesto 22 entre 51 modelos |
| Grandes refactorizaciones de código | Débil | SWE Refactor Bench oficial: 23.0; Opus 5 obtiene 31.0 |
| Nivel general | Intermedio | Puesto 15 entre 22 modelos en el índice de Vals |
Resumen de ventajas
- Precio bajo y facturación sencilla: $0.15 por entrada y $0.60 por salida. La tarifa es fija para contextos de hasta 1M, por lo que resulta adecuado para un gran volumen de invocaciones;
- Buen rendimiento en agentes de oficina y tareas visuales: las conclusiones de las pruebas oficiales y de terceros coinciden en tareas como organizar tablas, navegar por páginas web y reconocer elementos en imágenes;
- Mejora notable con respecto a M3: en Vibe Code Bench, pasa del 47.57% al 73.94%, lo que supone un salto en su capacidad para crear aplicaciones pequeñas de uso cotidiano.
Resumen de limitaciones
- Aún le falta para las tareas de ingeniería complejas: en operaciones de línea de comandos con varios pasos y cambios extensos en varios archivos, las tablas oficiales muestran que queda por detrás de Opus 5;
- No se puede desactivar el razonamiento: incluso las preguntas y respuestas breves pasan por el proceso de razonamiento, por lo que no es ideal en escenarios sensibles a la latencia hasta el primer token;
- Transparencia limitada: el método oficial de cálculo de costos y el informe técnico aún no se han publicado, así que por ahora no se puede verificar de forma independiente la afirmación de que cuesta «un tercio».
Cuándo no conviene cambiar a MiniMax M3.1 Flash
En estas 6 situaciones, es mejor no sustituir todavía tu modelo principal por M3.1 Flash, o al menos probarlo antes de decidir:
- Tu tarea principal es ejecutar agentes de terminal con cadenas de pasos largas: por ejemplo, ejecutar CI automáticamente, diagnosticar problemas en servidores o ejecutar decenas de comandos de una sola vez. Tanto los datos oficiales como los de Vals señalan esta área como un punto débil. Si Claude Opus 5.5 funciona de forma fiable para ti, el costo de las correcciones que implique el cambio podría superar el ahorro en tokens.
- Haces refactorizaciones grandes con frecuencia: tareas como cambiar interfaces en más de diez archivos o dividir módulos. En la prueba oficial SWE Refactor Bench, M3.1 Flash obtuvo 23,0 puntos frente a los 31,0 de Opus 5: una diferencia considerable. Es mejor seguir delegando este tipo de tareas al modelo insignia.
- Necesitas desactivar el razonamiento y buscas una latencia muy baja: en casos como atención al cliente en tiempo real, clasificación de intenciones y autocompletado, no se puede desactivar el razonamiento de M3.1 Flash. Incluso en el nivel low, hay que esperar más que con un modelo sin razonamiento.
- Tu integración actual depende de analizar las etiquetas
<think>y no tienes previsto modificarla pronto: M3.1 Flash devuelve el contenido del razonamiento en un campo independiente. Si cambias directamente el nombre del modelo, es posible que tu lógica de análisis no obtenga los datos o incluso genere un error. - Necesitas implementar el modelo localmente y de forma privada ahora mismo: según el anuncio oficial, los pesos se publicarían el 23 de octubre, pero a la fecha de publicación de este artículo aún no se habían publicado. Tampoco se han dado a conocer datos oficiales sobre la memoria de video necesaria, por lo que todavía no es posible planificar el hardware de forma fiable.
- Puede ser barato por token, pero no necesariamente por tarea: el nivel max predeterminado puede generar muchos tokens de razonamiento. Si tus tareas requieren respuestas breves y el modelo que ya usas es barato, cambiarte no necesariamente reducirá la factura. Compara siempre el costo por tarea.
Lista de comprobación para probar MiniMax M3.1 Flash en 30 minutos
Las clasificaciones solo reflejan el rendimiento promedio; el criterio definitivo son tus propias tareas. Puedes seguir estos pasos para hacer una comparación en 30 minutos. Para probarlo, puedes usar la API oficial de MiniMax o el endpoint gratuito con límite de velocidad de OpenRouter: minimax/minimax-m3.1-flash:free.
- Elige las tareas (unos 5 minutos): selecciona 3 tipos de tareas reales de tu trabajo reciente, con entre 3 y 5 ejemplos de cada tipo. El primer tipo debe incluir tareas repetitivas y con reglas claras, como organizar tablas o redactar resúmenes. El segundo, tus tareas habituales más importantes. El tercero, las tareas difíciles que más te preocupan, como operaciones de terminal con varios pasos o modificaciones en varios archivos.
- Fija los parámetros: ejecuta M3.1 Flash primero con el nivel
mediumy luego con el nivel predeterminadomax. Anota qué nivel usaste. Configura el modelo con el que lo vas a comparar con los mismos parámetros y no los cambies a mitad de la prueba. - Compara las mismas tareas (unos 15 minutos): usa exactamente las mismas indicaciones y el mismo contexto con ambos modelos, y ejecuta todas las tareas una por una.
- Registra los datos: para cada tarea, anota los tokens de entrada, los tokens de salida (incluidos los del razonamiento), el tiempo total, si se completó correctamente al primer intento y cuánto contenido tuviste que corregir manualmente.
- Calcula el costo por tarea (unos 10 minutos): aplica la fórmula oficial «uso ÷ 1.000.000 × precio unitario». Suma los costos de entrada, salida y lectura de caché para calcular cuánto costó realmente cada tarea.
- Saca conclusiones por categoría: si la calidad de una categoría es aceptable y el costo por tarea es menor, cambia solo esa categoría. Si el modelo falla claramente en las tareas difíciles de la tercera categoría, sigue asignándolas al modelo que ya usabas.
💡 Sugerencia para el grupo de comparación: puedes usar APIYI apiyi.com para llamar a
claude-opus-5-5o a MiniMax-M3 con la misma clave API. Así no tendrás que registrarte en varias plataformas solo para hacer una prueba comparativa.
Combinar MiniMax y Claude Opus 5.5 en APIYI
La función de M3.1 Flash hace que encaje mejor como «especialista en procesamiento por lotes» dentro de un equipo que como modelo único. Una estrategia práctica consiste en repartir el trabajo según su dificultad: las tareas económicas y de gran volumen se asignan a la serie MiniMax, y la planificación y refactorización complejas, a Claude Opus 5.5.
| Modelo | Función | Tareas adecuadas | Plataformas disponibles |
|---|---|---|---|
| MiniMax-M3.1-Flash | Modelo de agente económico y rápido | Automatización de tareas de oficina, visión artificial y tareas financieras y fiscales por lotes | API oficial de MiniMax / M Plan; consulta la página de precios para saber si está disponible en APIYI |
| MiniMax-M3 | Modelo principal de la generación anterior | Tareas cotidianas en chino y procesamiento por lotes | APIYI, apiyi.com (formatos compatibles con OpenAI y Anthropic) |
| claude-opus-5-5 | El modelo insignia más potente de Anthropic | Planificación compleja, grandes refactorizaciones y agentes con flujos de varios pasos | APIYI, apiyi.com |
| claude-opus-5 | Modelo insignia de la generación anterior | Referencia de comparación en las tablas oficiales de puntuaciones | APIYI, apiyi.com |
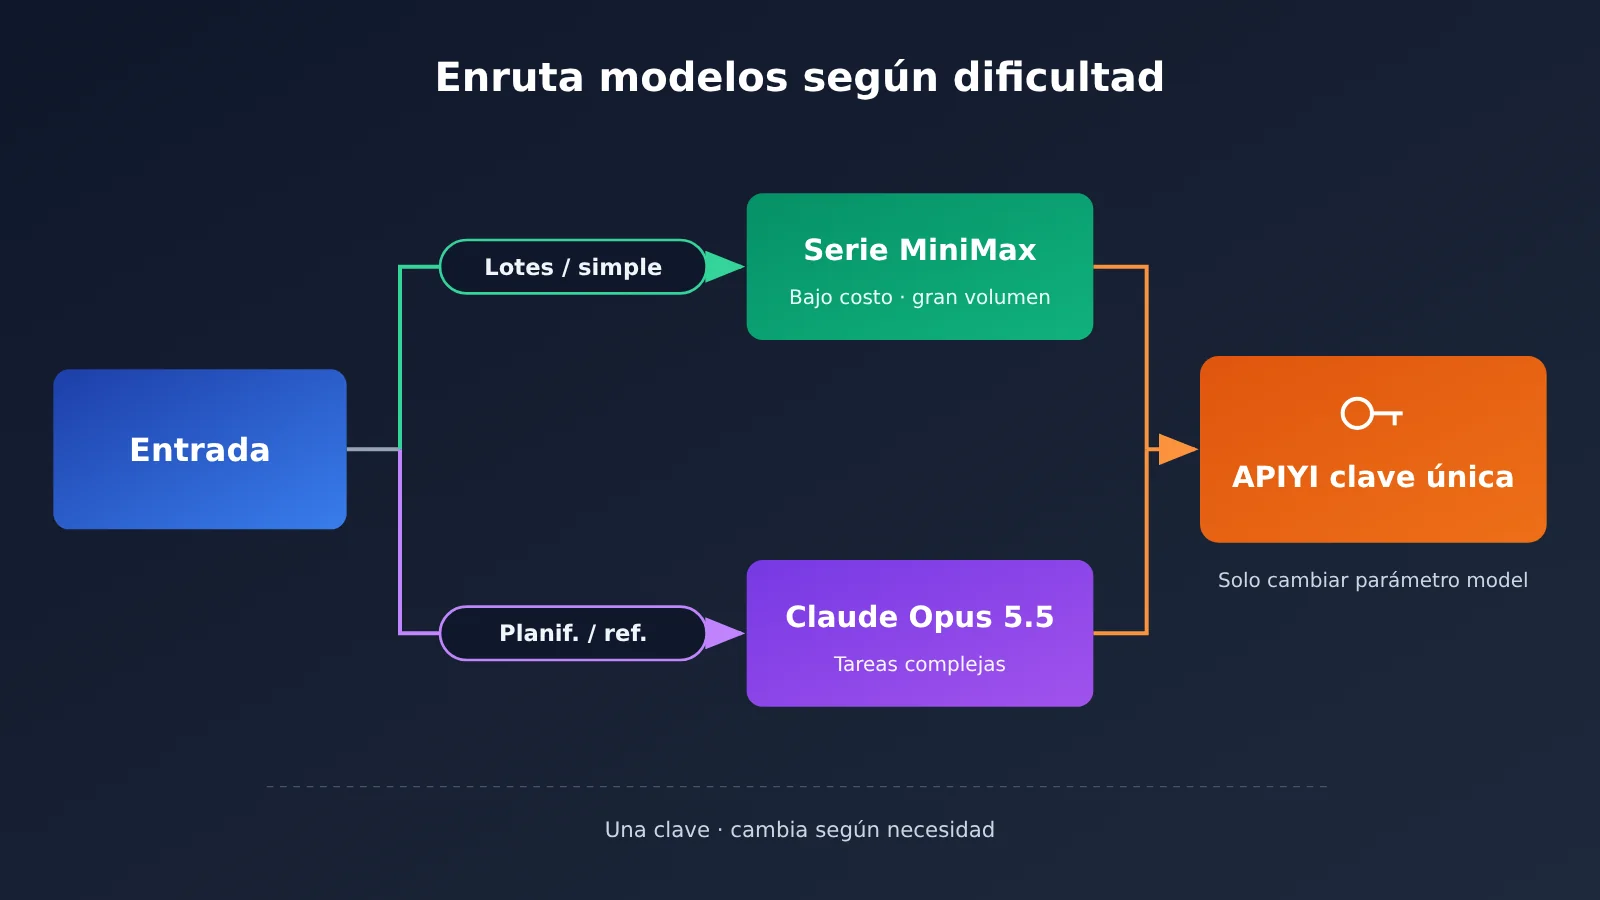
En APIYI, una sola clave permite invocar modelos internacionales como Claude, GPT y Gemini, así como modelos nacionales como DeepSeek y MiniMax. Para cambiar de modelo, solo hay que modificar el parámetro model:
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_APIYI_KEY",
    base_url="https://api.apiyi.com/v1"  # APIYI 统一接口
)

def ask(model, prompt):
    resp = client.chat.completions.create(
        model=model,
        messages=[{"role": "user", "content": prompt}],
    )
    return resp.choices[0].message.content

# 便宜、量大的活交给 MiniMax 系列
print(ask("MiniMax-M3", "把这段会议纪要整理成 5 条待办"))

# 难的规划和重构交给 Claude Opus 5.5
print(ask("claude-opus-5-5", "为这个单体服务设计分阶段拆分方案"))
En cuanto a los precios, según las tarifas oficiales publicadas por APIYI, claude-opus-5-5 cuesta $4 por millón de tokens de entrada y $20 por millón de tokens de salida; claude-opus-5 cuesta $5 y $25, respectivamente. Si más adelante aparece MiniMax-M3.1-Flash en la página de precios de APIYI, basta con usar el nombre del modelo y el precio que allí se indiquen.
Preguntas frecuentes
Q1: ¿Qué hace destacar a MiniMax M3.1 Flash?
Según los datos publicados por la propia empresa y los resultados de Vals, destaca en la automatización de tareas de oficina con agentes, la comprensión visual, el uso de herramientas para tareas financieras y fiscales, y su bajo precio. En la clasificación general de los 22 modelos de Vals ocupa el puesto 15, así que se sitúa en un nivel intermedio y no es un modelo todoterreno.
Q2: ¿Cuál es mejor, MiniMax M3.1 Flash o Claude Opus 5.5?
La empresa no ha publicado una comparación punto por punto con Opus 5.5; en su tabla oficial, el modelo de referencia es Opus 5. Incluso frente a Opus 5, M3.1 Flash queda por detrás en Terminal Bench y SWE Refactor Bench. Opus 5.5 sigue siendo el modelo insignia más potente de Anthropic.
Q3: ¿Cuál de los resultados es correcto: el 38,1 de Terminal Bench publicado oficialmente o el 25,25 % de Vals?
Ambos resultados son válidos, pero proceden de marcos de evaluación distintos, así que no se pueden comparar directamente restando uno del otro. La conclusión común es que las tareas de terminal con cadenas de pasos largas son un punto débil de M3.1 Flash.
Q4: ¿Ya se puede usar M3.1 Flash a través de APIYI?
A fecha de 2026-10-22, MiniMax-M3.1-Flash todavía no aparece en la página de precios de APIYI. Para saber si está disponible, consulta esa página. Por ahora, puedes usar directamente MiniMax-M3, claude-opus-5-5 y otros modelos a través de APIYI en apiyi.com.
Q5: ¿Qué nivel de effort debería elegir?
Si no especificas ningún valor, el nivel predeterminado es max: ofrece el máximo rendimiento, pero también es el más lento y genera más tokens de salida. Para tareas sencillas en lote, conviene empezar con low o medium y subir el nivel si la calidad no es suficiente. No es posible desactivar el razonamiento.
Q6: ¿Se puede usar directamente como clave API la clave de una suscripción M Plan?
No, son claves distintas y no se pueden intercambiar. Las preguntas frecuentes oficiales indican que la clave API de pago por uso y la clave de suscripción de M Plan se obtienen en secciones distintas del panel. Consulta el sitio oficial para conocer el precio mensual de cada plan M Plan.
Q7: ¿Cómo puedo comprobar el rendimiento por mi cuenta y a bajo costo?
Puedes empezar ejecutando algunas tareas con el punto de acceso gratuito de OpenRouter, que tiene límites de velocidad. Para comparar con modelos insignia, puedes usar una misma clave para invocarlos a través de APIYI en apiyi.com. Después, registra el consumo de tokens y el tiempo empleado con la lista de comprobación de 30 minutos de este artículo.
Puntos clave de MiniMax M3.1 Flash
- No hemos hecho pruebas propias: todas las cifras proceden de datos publicados por MiniMax o de la evaluación de terceros de Vals;
- Rendimiento general intermedio: obtuvo un 53,78 % en Vals Index y ocupa el puesto 15 de 22 modelos;
- Puntos fuertes claros: automatización de oficina, comprensión visual, agentes de finanzas e impuestos, y un precio bajo;
- Puntos débiles claros: tareas complejas de terminal con muchos pasos y refactorizaciones grandes; también queda por detrás de Opus 5 en la tabla oficial;
- Las cifras dependen del criterio usado: las dos puntuaciones de Terminal Bench no son directamente comparables. Tanto el coste como la velocidad corresponden a datos oficiales;
- No se puede desactivar el razonamiento: solo se puede reducir el nivel de esfuerzo. Para migrar desde M3, hay que adaptar la lógica que interpreta las etiquetas
<think>; - Sale más rentable combinar modelos: con una sola clave en APIYI, puedes combinar la serie MiniMax con Opus 5.5 y asignar cada tarea según su dificultad.
Resumen
Puntos clave de MiniMax M3.1 Flash:
- Límites de sus capacidades: destaca en automatización de oficina, tareas visuales y tareas de agentes de finanzas e impuestos; no tanto en tareas complejas de terminal con muchos pasos ni en refactorizaciones grandes;
- Criterios detrás de las cifras: las cifras oficiales y las de terceros se obtienen con marcos de prueba distintos. Incluso los materiales oficiales presentan pequeñas diferencias, como 62,8 y 62,2. Al citar las cifras, indica siempre la fuente;
- ¿Conviene cambiar?: vale la pena probarlo en tareas por lotes y con reglas claras. Para las tareas más difíciles, es mejor mantener el modelo actual. Una prueba propia de 30 minutos puede ayudarte a decidir.
Te recomendamos comparar primero los modelos con tus tareas reales y luego migrar gradualmente, según el tipo de tarea, en lugar de sustituirlo todo de una vez. Puedes usar APIYI apiyi.com para invocar desde un mismo lugar los modelos de comparación y los que ya usas, MiniMax-M3 y claude-opus-5-5, y hacer las pruebas con una sola clave.
📚 Referencias
- Blog oficial de MiniMax: resultados oficiales de M3.1 Flash en pruebas de rendimiento, velocidad y precio
- Enlace:
minimax.io/blog/minimax-m31f -
Nota: principal fuente de los datos publicados por la propia empresa
-
Documentación oficial de MiniMax: invocación del modelo: parámetro
effort, mecanismo de razonamiento y dirección de la API - Enlace:
platform.minimax.io/docs/guides/text-generation -
Nota: documentación imprescindible para migrar e integrar el modelo
-
Página oficial de precios de MiniMax: tarifas de M3.1 Flash y M3
- Enlace:
platform.minimax.io/docs/guides/pricing -
Nota: útil para calcular el costo de cada tarea
-
Página del modelo en Vals AI: resultados de evaluaciones de terceros sobre M3.1 Flash
- Enlace:
vals.ai/models/minimax_MiniMax-M3.1-flash -
Nota: incluye clasificaciones y condiciones de las pruebas
-
Artículo de MarkTechPost: recopilación de las tablas comparativas oficiales
- Enlace:
marktechpost.com/2026/10/19/minimax-m3-1-flash-release - Nota: incluye datos comparativos con Opus 5 y diferencias en los gráficos de costos
Autor: equipo técnico de APIYI
Consultas técnicas: puedes ponerte en contacto con nosotros desde la página de inicio de APIYI, apiyi.com. También puedes consultar más información de integración en el centro de documentación docs.apiyi.com.