Anmerkung des Autors: Von Abnahmekriterien und Datenisolierung bis zur unabhängigen Prüfung – mit fünf Schritten eine externe Validierung für komplexe KI-Aufgaben entwerfen und scheinbare Erledigung durch Selbstbewertung des Modells vermeiden.
Die Antwort „Aufgabe erledigt, Ergebnisse korrekt“ klingt überzeugend – bis sich der Vorgang nicht reproduzieren lässt. Genau das ist für viele KI-Nutzende bei komplexen Aufgaben ein wiederkehrendes Problem. Dieser Artikel stellt ein eigenständig ausführbares Verfahren zur Gestaltung externer Validierung vor, mit dem Sie „das Modell sagt, es sei erledigt“ in „die Belege zeigen, dass es erledigt ist“ verwandeln.
Claude-Entwickler Felix Rieseberg empfiehlt in seinem im Oktober 2026 veröffentlichten Praxisleitfaden ausdrücklich: Lassen Sie das Modell nicht sich selbst bewerten, und setzen Sie konsequent auf externe Validierung. Die ideale Form sei ein Werkzeug, das das Modell selbst ausführen kann und das sofort Rückmeldung liefert. InfoQ veröffentlichte am 4. November 2026 eine chinesische Übersetzung dieses Artikels.
Dies ist kein Ratgeber, der Ihnen sagt, Sie sollten „einfach noch einmal genauer prüfen“. Der Originalartikel gibt die Richtung vor; auf dieser Grundlage arbeitet dieser Beitrag umsetzbare Designschritte heraus – von der Auswahl geeigneter Validierungsmethoden über häufige Fehlermuster bis hin zur Prüfung durch mehrere Modelle.
Der zentrale Nutzen: Nach der Lektüre können Sie für Ihre eigenen komplexen KI-Aufgaben einen Validierungsvertrag formulieren. So iteriert das Modell anhand entscheidbarer Rückmeldungen, statt in einer Selbstbewertung zu enden.
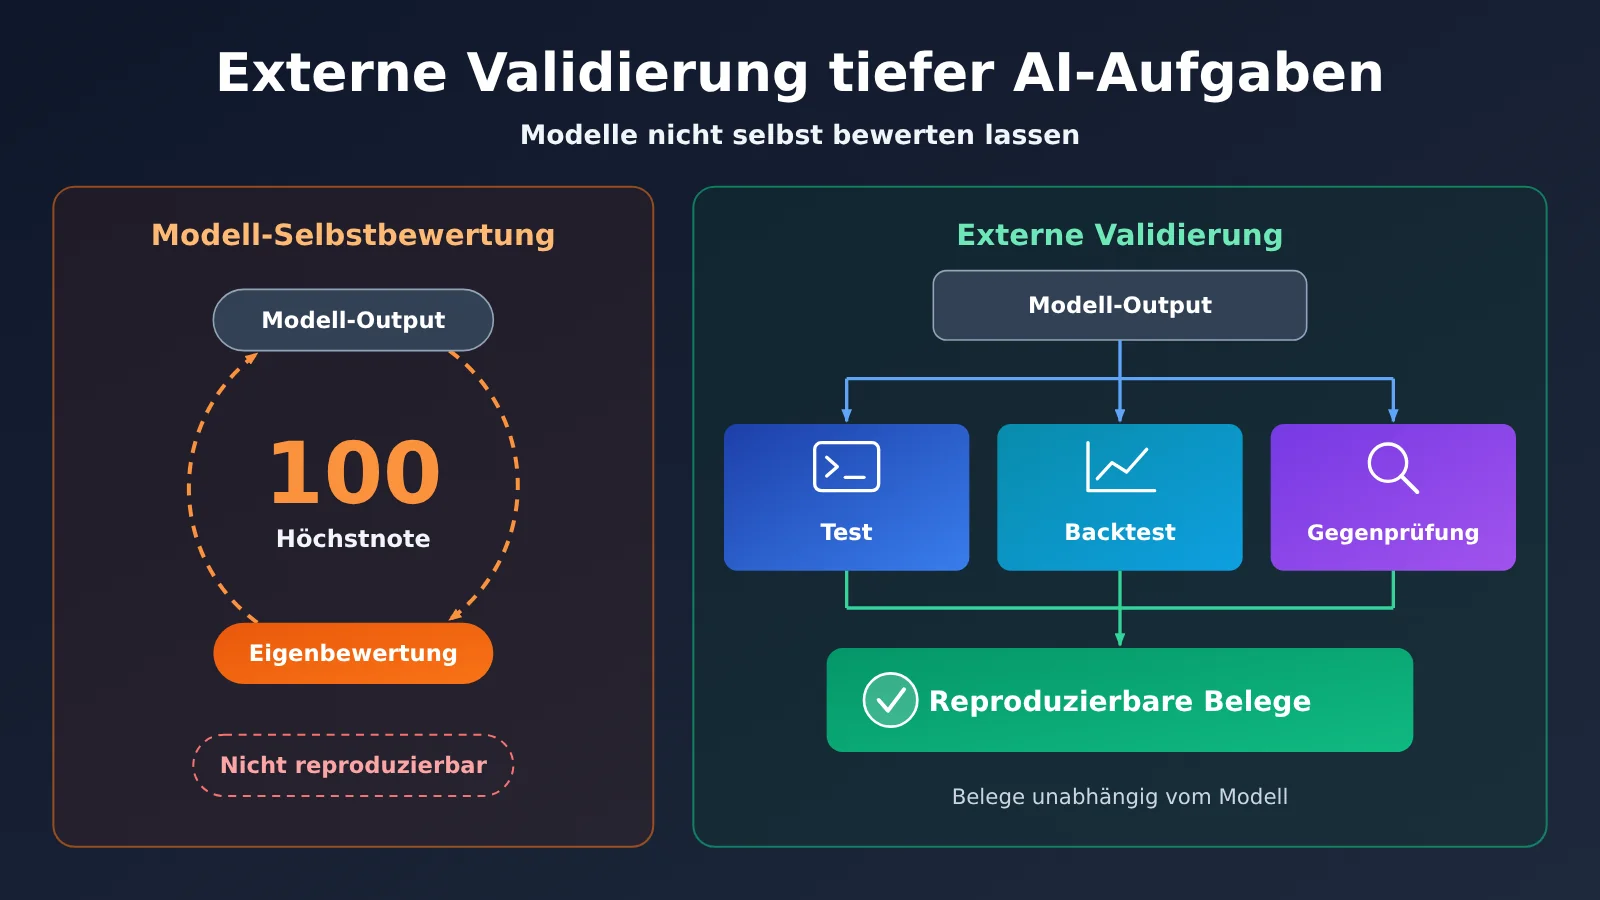
Kernpunkte der externen Validierung bei tiefgehenden KI-Aufgaben
Entscheidend bei der externen Validierung ist nicht ein zusätzlicher Prüfschritt, sondern dass die Beurteilungsgrundlage unabhängig von der Argumentation des Modells selbst ist.
| Punkt | Erläuterung | Nutzen |
|---|---|---|
| Erst die Kriterien | Vor dem Start schriftlich festhalten, wann etwas als bestanden gilt – und das möglichst prüfbar formulieren | Verhindert, dass das Modell das Ziel im Nachhinein neu auslegt |
| Datentrennung | Schlussfolgerungen mit Daten oder Szenarien prüfen, die das Modell noch nicht gesehen hat | Trennt echte Erkenntnisse von nachträglicher Anpassung |
| Werkzeuge zuerst | Bevorzugt Validatoren einsetzen, die laufen und sofort Rückmeldung geben | Das Modell kann selbstständig iterieren, weniger manuelle Aufsicht nötig |
| Belege sichern | Laufergebnisse, Logs und Schritte zur Reproduktion aufbewahren | Andere können Schlussfolgerungen prüfen, statt ihnen nur zu glauben |
| Unabhängige Gegenprüfung | Ergebnisse mit anderen Methoden und aus einer anderen Perspektive herausfordern | Deckt Probleme auf, die ein einzelner Validator übersieht |
Warum tiefgehende KI-Aufgaben externe Validierung brauchen
Wenn Rieseberg von „Tiefe“ spricht, meint er: die Werkzeuge, Techniken und das Wissen von Spitzenexperten des jeweiligen Fachgebiets nutzen und bis in die zugrunde liegenden Daten vordringen, statt an der Oberfläche der Aufgabe zu bleiben. Je tiefer die Aufgabe geht, desto schwerer fällt es, das Ergebnis intuitiv zu beurteilen. Eine fachlich sauber formulierte Abwanderungsanalyse kann überzeugend klingen – das belegt aber nicht, dass die darin enthaltenen Kausalaussagen stimmen.
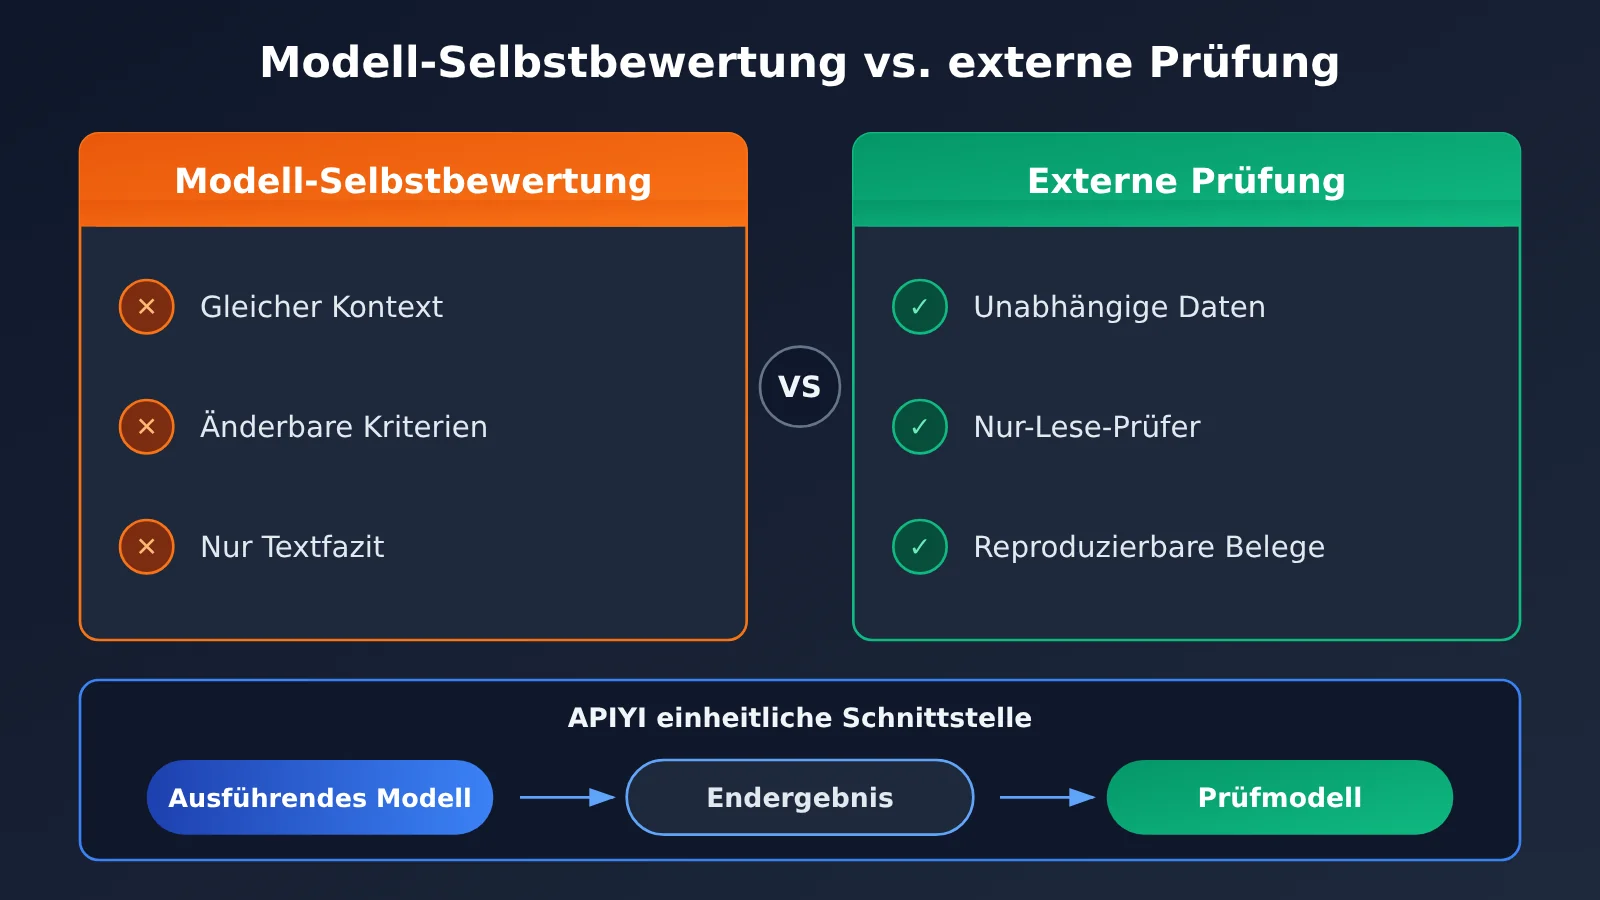
Er nennt außerdem ein häufiges Phänomen: Bittet man das Modell, sich wie ein Experte zu verhalten, wechselt es oft nur das Vokabular, nicht aber die Arbeitsweise. Selbsteinschätzung erkennt solche Probleme kaum, weil Bewertende und Erstellende dieselben Annahmen teilen. Ist die Argumentation von Anfang an schief, verläuft auch die Bewertung durch das Modell oft entlang derselben Schieflage.
Waghalsige Ziele machen die Validierung noch wichtiger. Der Originaltext empfiehlt, scheinbar unvernünftige Ziele zu setzen – etwa die Ladezeit einer Website von 10 Sekunden auf 200 Millisekunden zu drücken – und das Modell weiter probieren zu lassen. Solche Ziele funktionieren, weil 200 Millisekunden messbar sind. Ist ein Ziel aggressiv, aber nicht überprüfbar, bekommt man am Ende wahrscheinlich nur einen selbstbewussteren Bericht.
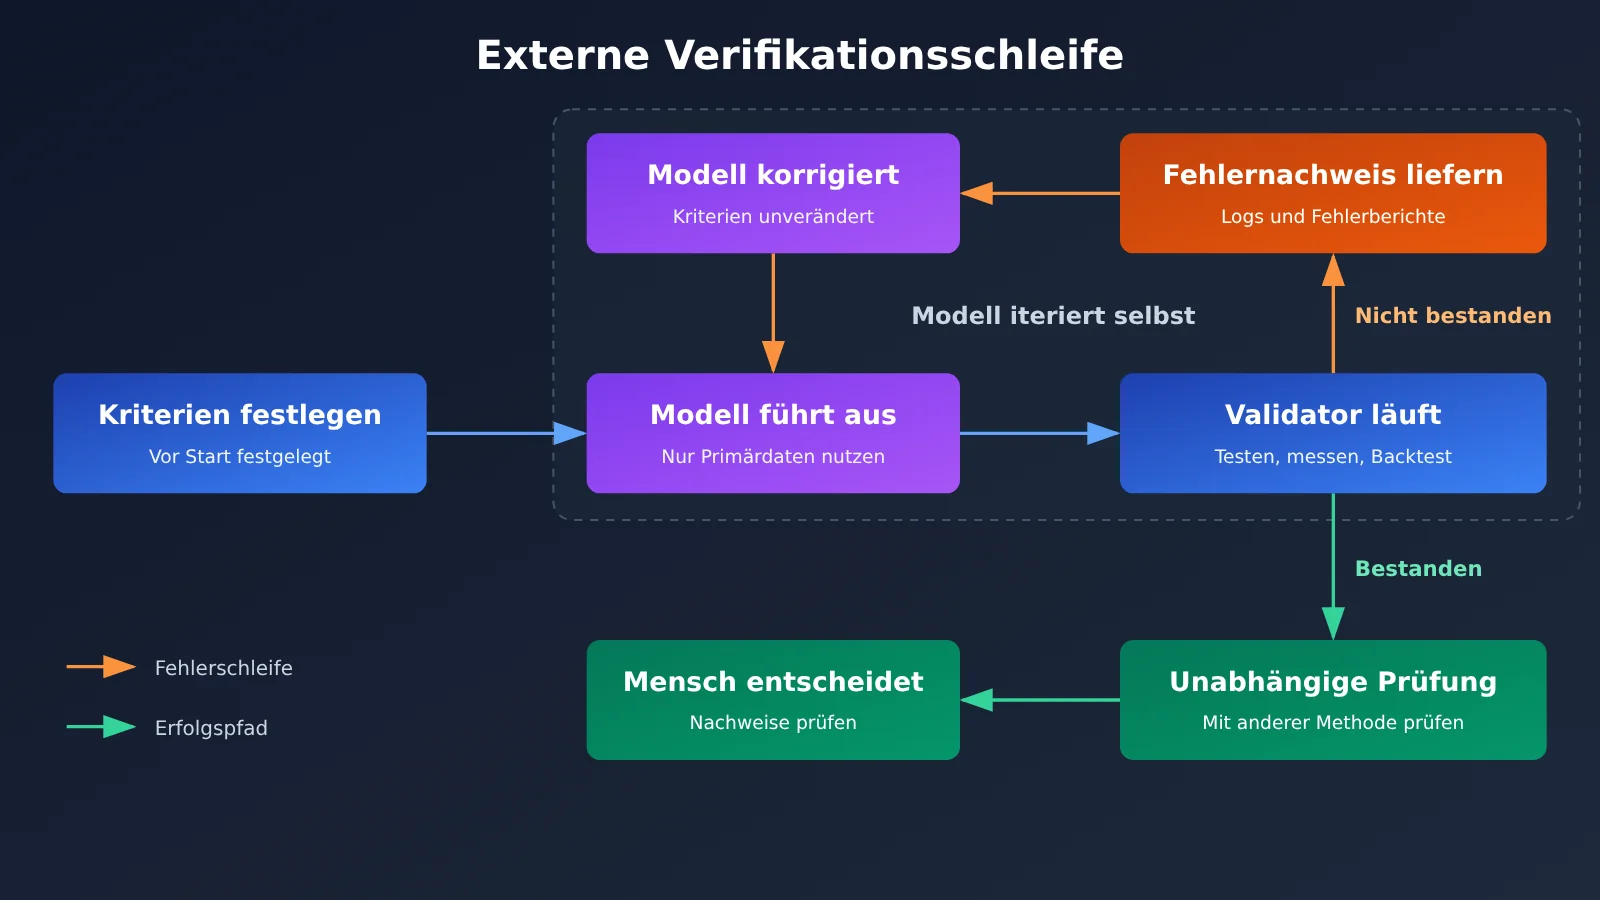
Externe Validierung für tiefe KI-Aufgaben: Die 5-Schritte-Methode für den schnellen Einstieg
Die folgende Methode hängt von keinem bestimmten Modell und keinem Framework ab – du kannst sie zunächst an einer Aufgabe ausprobieren, die gerade bei dir läuft. Falls sich nicht alles sofort umsetzen lässt, empfiehlt es sich, mit den ersten drei Schritten zu beginnen.
Schritt 1: Das Aufgabenziel in ein externes Validierungskriterium umformulieren
„Analysiert umfassend“ oder „Code von hoher Qualität“ lässt sich nicht direkt beurteilen. Solche Formulierungen müssen in Bedingungen umgeschrieben werden, die entweder bestehen oder durchfallen. Statt „den Absturz beheben“ heißt es zum Beispiel „die ursprünglichen Reproduktionsschritte laufen ohne Absturz durch und alle zugehörigen Tests sind grün“. Die Kriterien müssen feststehen, bevor das Modell mit der Arbeit beginnt – sonst könnte es die Definition von Erfolg erst im Nachhinein anpassen.
Du kannst zuerst den folgenden Validierungsvertrag ausarbeiten und ihn dann dem Modell zur Ausführung übergeben:
| Feld | Was klar beschrieben sein muss | Beispiel |
|---|---|---|
| Endziel | Das tatsächlich gewünschte fachliche oder technische Ergebnis | Die Anwendung bleibt stabil, gleichartige Abstürze treten nicht mehr auf |
| Originalmaterial | Die Primärdaten, die das Modell direkt verwenden soll | Absturzberichte, Zuordnung von Versionen zu Git-Commits |
| Validierer | Welches Tool oder welche Daten über das Ergebnis entscheiden | Reproduktionsskript, automatisierte Tests, zurückgehaltene Daten |
| Erfolgsbedingung | Eindeutige Schwellenwerte oder Entscheidungsregeln | Auf allen drei Zielsystemen lässt sich der Absturz nicht mehr reproduzieren |
| Verbote | Was das Modell nicht verändern darf | Tests nicht löschen, zurückgehaltene Daten nicht verändern |
| Nachweise zur Abgabe | Die mitzuliefernden Laufzeitergebnisse | Befehle, Logs, Fehleraufzeichnungen und Endergebnis |
| Abbruchbedingung | Wann abgebrochen wird oder an einen Menschen übergeben wird | Nach Erreichen der Iterationsgrenze die Blockierungsursache melden |
Schritt 2: Schlussfolgerungen von Validierungsdaten trennen
Wenn das Modell mit denselben Daten eine Hypothese aufstellt und sie auch belegt, ist das keine externe Validierung. Das im Original verwendete Beispiel zur Kundenabwanderung zeigt ein gutes Vorgehen: Man lässt das Modell in den Logs nach dem frühesten Churn-Signal suchen und belegt anschließend mit Daten, die es noch nicht gesehen hat, dass dieses Signal tatsächlich Vorhersagekraft besitzt. In der Praxis kann man die Daten zeitlich aufteilen: frühe Daten für die Exploration, spätere Daten für die Prüfung.
Holdout-Daten sollten am besten von einem unabhängigen Skript oder einer unabhängigen Person verwahrt werden. Das Modell erhält dann nur die Ausführungsergebnisse und kann nicht direkt auf die Details zugreifen. Passt man den Ansatz wiederholt anhand der Ergebnisse an, werden die Holdout-Daten nach und nach „gelernt“. Deshalb sollte man für wichtige Schlussfolgerungen zusätzlich einen Datensatz zurückhalten, der erst bei der finalen Abnahme zum Einsatz kommt.
Schritt 3: Bevorzugen Sie externe Validierungswerkzeuge, die das Modell selbst ausführen kann
Je näher ein Validator am realen Ergebnis liegt und je schneller das Feedback ausfällt, desto besser kann das Modell eigenständig iterieren. Die folgende Tabelle fasst einige externe Validierungsmethoden nach häufigen Aufgaben zusammen. Bei der Auswahl muss man nicht nach der einen „stärksten Lösung“ streben; vielmehr sollte man sie je nach Risiko kombinieren.
| Validierungsmethode | Was sie belegen kann | Feedback-Geschwindigkeit | Hauptgrenzen |
|---|---|---|---|
| Automatisierte Tests und Reproduktionsskripte | Dass ein bestimmtes Verhalten den Erwartungen entspricht | Schnell | Deckt nur bereits beschriebene Szenarien ab |
| Performance-Messwerkzeuge | Ob Kennzahlen Schwellenwerte erreichen | Schnell | Umgebungsunterschiede können Ergebnisse beeinflussen |
| Backtesting mit Holdout-Daten | Ob eine Schlussfolgerung Vorhersagekraft besitzt | Mittel | Historische Muster setzen sich nicht unbedingt fort |
| Red-Team-Prüfung der Methode | Ob Annahmen und Beweiskette schwach sind | Mittel | Die Qualität der Beurteilung hängt von der Prüfmethode ab |
| Schattenbetrieb | Ob ein Ansatz im realen Prozess wirksam ist | Langsam | Lange Zyklen, hohe organisatorische Kosten |
| Stichprobenprüfung durch Fachexperten | Ob Ergebnisse fachlichem Urteil entsprechen | Langsam | Schwer flächendeckend abzudecken |
Schritt 4: Externe Validierung in den Arbeitszyklus des Modells integrieren
Validierungswerkzeuge entfalten nur dann eine kontinuierliche Iterationswirkung, wenn sie in die Arbeitsumgebung des Modells integriert sind. Der Fall zur Behebung eines Absturzes im Original ist sehr anschaulich: Der Autor ermöglicht Claude zunächst, bequem auf Absturzberichte zuzugreifen, zu wissen, welcher Git-Commit zu welcher Version gehört, und Windows-, macOS- und Linux-Rechner zu nutzen. Unter diesen Voraussetzungen kann das Modell Probleme eigenständig reproduzieren und Korrekturen validieren.
Das zeigt auch: Externe Validierung erfordert oft Anpassungen am Arbeitsablauf und nicht nur an der Eingabeaufforderung. Sie müssen die notwendigen Daten und Werkzeuge bereitstellen, etwa Datenquellen über MCP-Konnektoren anbinden, und gleichzeitig die Berechtigungen auf den Aufgabenbereich beschränken. Das Design des Arbeitszyklus sollte mindestens drei Elemente enthalten:
- Fehlerfeedback: konkrete Fehlerprotokolle und fehlgeschlagene Prüfpunkte zurückgeben, nicht nur das Wort „fehlgeschlagen“.
- Iterationslimit: Wiederholungsversuche und Gesamtbudget begrenzen, damit das Modell nicht in eine unproduktive Schleife gerät.
- Geschützte Objekte: Tests, Validierungsskripte und Holdout-Daten schreibgeschützt machen, damit das Modell nicht durch Ändern der Kriterien „besteht“.
Schritt 5: Externe Validierung durch unabhängige Überprüfung und Parallelbetrieb abschließen
Dass ein einzelner Validator besteht, bedeutet nicht, dass die Schlussfolgerung belastbar ist. Im Original wird vorgeschlagen, ein gezielt auf Fehlersuche ausgelegtes „Red Team“ einzubeziehen, etwa Leerverkäufer und forensische Buchprüfer; der Schwerpunkt liegt aber nicht darauf, ihren Ton zu imitieren, sondern ihre tatsächlichen Forschungsmethoden zu nutzen. Zum Beispiel können Sie das Modell bitten, die ursprüngliche Quelle jeder wichtigen Zahl nachzuvollziehen oder aktiv nach Daten zu suchen, die die Schlussfolgerung widerlegen könnten.
Bei prozessbezogenen Änderungen können Sie außerdem einen Parallelbetrieb einsetzen. Das Original empfiehlt, zunächst mit historischen Daten zu belegen, dass der neue Retrospektivmechanismus Probleme früher hätte erkennen können, und ihn dann ein Quartal lang parallel zum bestehenden Prozess laufen zu lassen. So lässt sich die tatsächliche Wirkung prüfen, ohne von Anfang an das Risiko einer vollständigen Ablösung des alten Prozesses tragen zu müssen.
Tipp zur Anbindung: Wenn unterschiedliche Modelle jeweils Ausführung und Überprüfung übernehmen sollen, können Sie sie einheitlich über APIYI aufrufen. APIYI bietet API-Aufrufe für die in diesem Artikel behandelten Modelle, ist mit den Schnittstellenformaten von OpenAI und Anthropic kompatibel; bei der Anbindung müssen Sie in der Regel nur
base_url,api_keyundmodelgemäß der Dokumentation konfigurieren. Dokumentation: https://docs.apiyi.com
Häufige Fehlermuster bei der externen Validierung komplexer AI-Aufgaben
Auch externe Validierung kann zur Formsache werden. Die folgenden Probleme sollten bereits in der Designphase berücksichtigt werden – sonst erzeugt das Validierungsergebnis nur ein trügerisches Sicherheitsgefühl.
| Fehlermuster | Typisches Erscheinungsbild | Gegenmaßnahme |
|---|---|---|
| Kriterien ändern | Fehlgeschlagene Testfälle löschen oder Assertions lockern | Validator schreibgeschützt machen und Änderungen prüfen |
| Überanpassung an das Validierungs-Set | Metriken steigen kontinuierlich, versagen aber bei neuen Daten | Eine finale Abnahmedatenmenge zurückhalten |
| Zirkuläre Beweisführung | Mit vom Modell generierten Daten die Schlussfolgerungen des Modells validieren | Auf ursprüngliche Logs und Primärmaterialien zurückgreifen |
| Nur die Form prüfen | Format korrekt, Inhalt falsch | Geschäftsregeln ergänzen und Stichproben abgleichen |
| Rollenspiel | Dialog wirkt wie ein Experte, die Ergebnisse verbessern sich aber nicht | Konkrete Methodenausführung und Belege verlangen |
Die „Überprüfung durch ein zweites Modell“ verdient eine besondere Erwähnung. Sie ist besser als die Selbstbewertung, weil sie einen Teil der blinden Flecken aufdeckt, bleibt aber eine urteilbasierte Überprüfung und kann Tests oder echte Daten nicht ersetzen. Bei der Überprüfung sollte man am besten nur die Aufgabenkriterien, das Originalmaterial und das Endergebnis bereitstellen, nicht die vorherige Konversation, um den Einfluss der ursprünglichen Argumentation auf das Urteil zu verringern.
Beispiele für die Gestaltung externer Validierung bei verschiedenen komplexen AI-Aufgaben
Die folgenden Beispiele können als Ausgangspunkt für das Design dienen; konkrete Schwellenwerte müssen je nach Geschäftskontext festgelegt werden.
| Aufgabe | Vorgehen nur mit Selbstbewertung | Design der externen Validierung |
|---|---|---|
| Anwendungsabsturz beheben | Modell erläutert die Funktionsweise der Reparatur und erklärt sie für abgeschlossen | Systemübergreifend reproduzieren und bestätigen, dass der Fehler nach dem Fix nicht mehr auftritt |
| Signale für Abwanderung finden | Modell liefert einen plausiblen Attributionsbericht | Mit Daten, die nicht in der Exploration verwendet wurden, die Vorhersagefähigkeit prüfen |
| Ursachen der Abwanderung prüfen | Modell übernimmt die Einschätzung „Das Onboarding neuer Nutzer ist problematisch“ | In den Rohdaten nach stützenden und widerlegenden Belegen suchen |
| Ladegeschwindigkeit optimieren | Modell listet Optimierungen auf und schätzt den Nutzen | In einer festen Umgebung messen und mit der Zielschwelle vergleichen |
| Ein Business-Review neu aufsetzen | Modell argumentiert, dass die neue Lösung fortschrittlicher ist | Nach historischem Backtesting ein Quartal parallel zum bestehenden Prozess laufen lassen |
Ob sich eine Aufgabe für ein solches Design eignet, lässt sich an einer einfachen Regel ablesen: Sind die Kosten eines Fehlers höher als die Kosten der Validierung? Wenn es nur darum geht, eine E-Mail umzuschreiben, reicht oft ein einmaliges Durchlesen. Wenn das Ergebnis jedoch Online-Systeme oder die Ressourcenallokation beeinflusst, sollte eine externe Validierung vorgesehen werden.
Häufige Fragen (FAQ)
F1: Was ist externe Validierung bei tiefen KI-Aufgaben?
Damit ist gemeint, Ergebnisse anhand von Belegen zu prüfen, die unabhängig von der Einschätzung des Modells selbst sind – zum Beispiel automatisierte Tests, Leistungsmessungen, Backtests mit zurückgehaltenen Daten und Expertenprüfungen. Die Kernanforderung: Die Bewertungskriterien dürfen nicht vom Modell, das das Ergebnis erzeugt hat, ad hoc festgelegt werden.
F2: Worin unterscheidet sich externe Validierung von der Selbstprüfung des Modells?
Eine Selbstprüfung des Modells kann offensichtliche Lücken schnell aufdecken, doch Ersteller und Bewerter teilen dieselben Annahmen. Externe Validierung führt eine unabhängige Evidenzquelle ein und eignet sich daher besser, um zu beurteilen, ob ein Ergebnis tatsächlich belastbar ist. Beide Ansätze lassen sich kombinieren, aber die Selbstprüfung darf nicht als abschließende Abnahmegrundlage dienen.
F3: Sind Modelle immer stärker geworden – ist externe Validierung dann noch nötig?
Rieseberg ist der Ansicht, dass sich dieses Problem mit zunehmend leistungsfähigeren Modellen irgendwann lösen könnte, empfiehlt aber ausdrücklich, mindestens bis Oktober 2026 an der externen Validierung festzuhalten. Das ist eine pragmatische Einschätzung für die aktuelle Phase. Solange die Zuverlässigkeit der Selbsteinschätzung von Modellen nicht belegt ist, sollten risikoreiche Aufgaben weiterhin unabhängig geprüft werden.
F4: In welchen Szenarien ist externe Validierung am wichtigsten?
Im Wesentlichen bei folgenden Aufgabentypen:
– **Fehlerbehebung in der Technik**: Absturzbehebungen, Performance-Optimierungen und Datenmigrationen.
– **Datenanalyse und Forschung**: Churn-Analysen, Kausalitätsbeurteilungen und das Aufspüren von Prognosesignalen.
– **Langlaufende Agenten-Prozesse**: Aufgaben, bei denen das Modell mit wenig menschlichem Eingreifen kontinuierlich weiterarbeiten muss.
F5: Wie baut man über die API eine modellübergreifende Gegenprüfung auf?
Über APIYI lässt sich das einheitlich anbinden, die Schnittstelle ist kompatibel zu den Formaten von OpenAI und Anthropic:
1. Laut der APIYI-Dokumentation https://docs.apiyi.com die Schnittstellenadresse und den API Key konfigurieren.
2. Auf der Preisseite https://docs.apiyi.com/models die verfügbaren Modelle und deren Kosten prüfen.
3. Für Ausführung und Gegenprüfung jeweils ein anderes `model` konfigurieren; die Prüfanfrage enthält nicht den Gesprächsverlauf der Ausführungsphase.
4. Die Prüfmeinungen getrennt von den Testergebnissen dokumentieren und Testergebnisse sowie Datenbelege als vorrangige Grundlage heranziehen.
F6: Wie lassen sich die Kosten einer externen Validierungsschleife abschätzen?
Die Gesamtkosten hängen in der Regel von der Anzahl der Iterationen, der Kontextlänge, der Ausgabelänge und der Anzahl der Prüfmodelle ab. Empfehlenswert ist, zunächst einige Runden mit einer kleinen Stichprobe zu laufen, den tatsächlichen Verbrauch pro Runde zu erfassen und daraus zusammen mit der Iterationsobergrenze das Budget zu schätzen. Dieser Artikel nennt keine konkreten Einzelpreise; Modellpreise, Abrechnungsgrundlagen, Preise für Ein- und Ausgabe sowie Cache-Preise richten sich nach den tatsächlichen Angaben auf der APIYI-Preisseite https://docs.apiyi.com/models.
F7: Welche Grenzen hat die externe Validierung?
Tests können nur die definierten Szenarien abdecken, Backtests garantieren nicht, dass historische Muster weiterhin gelten, und Shadow-Runs dauern verhältnismäßig lange. Eine bestandene Validierung bedeutet lediglich, dass ein Ergebnis unter den festgelegten Bedingungen gestützt wird – nicht, dass es absolut richtig ist. Bei rechtlichen, finanziellen und geschäftskritischen Entscheidungen sollte die abschließende Beurteilung weiterhin bei den zuständigen Verantwortlichen liegen.
Kernpunkte zur externen Validierung von tiefen AI-Aufgaben
- Grundprinzip: Verlasse dich bei der Abnahme nicht auf die Selbstbewertung des Modells – das Urteil muss aus unabhängigen Belegen kommen.
- Standards vorab festlegen: Definiere die Erfolgsbedingungen, bevor die Arbeit beginnt, damit Erfolg nicht im Nachhinein neu definiert wird.
- Datentrennung: Prüfe die Ergebnisse des Modells mit Daten, die es noch nie gesehen hat, um Zirkelschlüsse zu vermeiden.
- Werkzeuge zuerst: Validatoren, die laufen und sofort Rückmeldung geben, sind am besten für autonome Iteration geeignet.
- Passende Umgebung: Das Modell braucht Zugriff auf Daten, Werkzeuge und eine Laufzeitumgebung, um sich selbst korrigieren zu können.
- Gestaffelte Gegenprüfung: Ein zweites Modell hilft, blinde Flecken zu finden, ersetzt aber keine Tests und echten Daten.
- Flexible Anbindung: Über APIYI lassen sich mehrere Modelle einheitlich aufrufen, was die Hürden für Kreuzprüfungen senkt.
Zusammenfassung
Beim Design der externen Validierung von tiefen AI-Aufgaben lohnt es sich, diese drei Punkte im Kopf zu behalten:
- Zuerst das Ziel in überprüfbare Kriterien verwandeln: Ohne Erfolgsbedingungen lässt sich nicht beurteilen, ob eine Aufgabe wirklich erledigt ist.
- Belege von der Argumentation des Modells unabhängig machen: Daten isolieren, Validatoren schützen und vollständige Laufprotokolle aufbewahren.
- Prüfmethoden nach Risiko kombinieren: Werkzeuge liefern schnelles Feedback, Gegenprüfungen decken blinde Flecken auf, und parallele Läufe zeigen die tatsächliche Wirkung.
Im nächsten Schritt kannst du dir eine tiefe Aufgabe aus deinem Alltag schnappen, zuerst einen Validierungsvertrag aufschreiben und dann das Modell loslegen lassen. Das reduziert nicht nur Fehler, sondern gibt dir auch den Mut, anspruchsvollere Ziele zu setzen – denn egal wie kühn das Ziel ist, die Ergebnisse lassen sich immer überprüfen.
Wenn du einen Ablauf für die Ausführung und Gegenprüfung mit mehreren Modellen aufbauen möchtest, kannst du ihn über APIYI testen. Die Anbindung ist unter https://docs.apiyi.com beschrieben; maßgeblich für Modellpreise und Abrechnungsmodalitäten sind die tatsächlichen Daten unter https://docs.apiyi.com/models.
📚 Referenzen
- Wie man sich größere Ziele setzt: Ein Praxisleitfaden für KI-Nutzer: InfoQ-Übersetzung ins Chinesische
- Link:
infoq.cn/article/F1ms7x7KI1p7UfocCywh -
Beschreibung: Enthält praktische Methoden in den drei Richtungen Höhe, Tiefe und Breite
-
How to be more ambitious: A tutorial for humans with models: Originaltext von Felix Rieseberg
- Link:
felixrieseberg.com/how-to-be-more-ambitious-a-tutorial-for-humans-with-models -
Beschreibung: Ursprüngliche Quelle für externe Validierungsempfehlungen sowie Fallbeispiele zu Crash-Fixes und Nutzerabwanderung
-
APIYI-Dokumentationszentrum: Hinweise zur Schnittstellenanbindung
- Link:
docs.apiyi.com -
Beschreibung: Dient zum Nachschlagen der Anbindungskonfiguration für OpenAI- und Anthropic-kompatible Formate
-
APIYI-Modell- und Preisseite: Modell- und Abrechnungsinformationen
- Link:
docs.apiyi.com/models - Beschreibung: Modellpreise, Abrechnungsgrundlagen und Cache-Preise richten sich nach dieser Seite
Autor: APIYI-Team
Technischer Austausch: Sie können uns gerne über die Startseite der APIYI-Website kontaktieren; weitere Materialien finden Sie im Dokumentationszentrum unter docs.apiyi.com