
Anmerkung des Autors: Am Beispiel einer Anfrage zur Qualitätskontrolle im Kundenservice wird untersucht, wie bei GPT-6.2 Sol in der Responses API die Abnahme der Ausgabe, die Beibehaltung des Sitzungszustands und der Abruf von Hintergrundresultaten funktionieren.
Fazit vorweg: Wenn GPT-6.2 Sol in ein Produktionssystem integriert wird, muss dieselbe Geschäftsaufgabe in vier Verhaltensweisen aufgeteilt und für jede separat ein Abnahmekriterium definiert werden. Diese vier sind: sofortige Rückmeldung in der Oberfläche, maschinell speicherbare Ergebnisse, Kontext über mehrere Runden hinweg und der finale Zustand. Streaming-Ereignisse dienen nur der Anzeige; bevor etwas in die Datenbank geschrieben wird, muss die vollständige Antwort vorliegen und sowohl die Schema- als auch die Geschäftsvalidierung bestanden haben. Bei Informationen über mehrere Runden hinweg muss zuerst festgelegt werden, wer den Zustand hält. Hintergrundaufgaben richten sich ausschließlich nach der Response-ID und dem Endzustand; Benachrichtigungen können mehrfach eintreffen, Schreibvorgänge müssen idempotent sein.
Um diese vier Punkte umzusetzen, gibt es zwei Voraussetzungen. Erstens: Wenn integrierte oder benutzerdefinierte Tools benötigt werden, folgt man der Migrationsanleitung für GPT-6.2 und verwendet die Responses API; dieser Artikel behandelt ausschließlich das Laufzeitverhalten von Responses. Zweitens: Bei einem Aufruf über eine Aggregationsplattform richtet sich die Verfügbarkeit von Funktionen wie Hintergrundmodus und Webhooks nach der aktuellen Konfiguration der Plattform. Bei APIYI (apiyi.com) sind für gpt-6.2-sol die beiden Endpunkte responses und chat öffentlich gelistet.
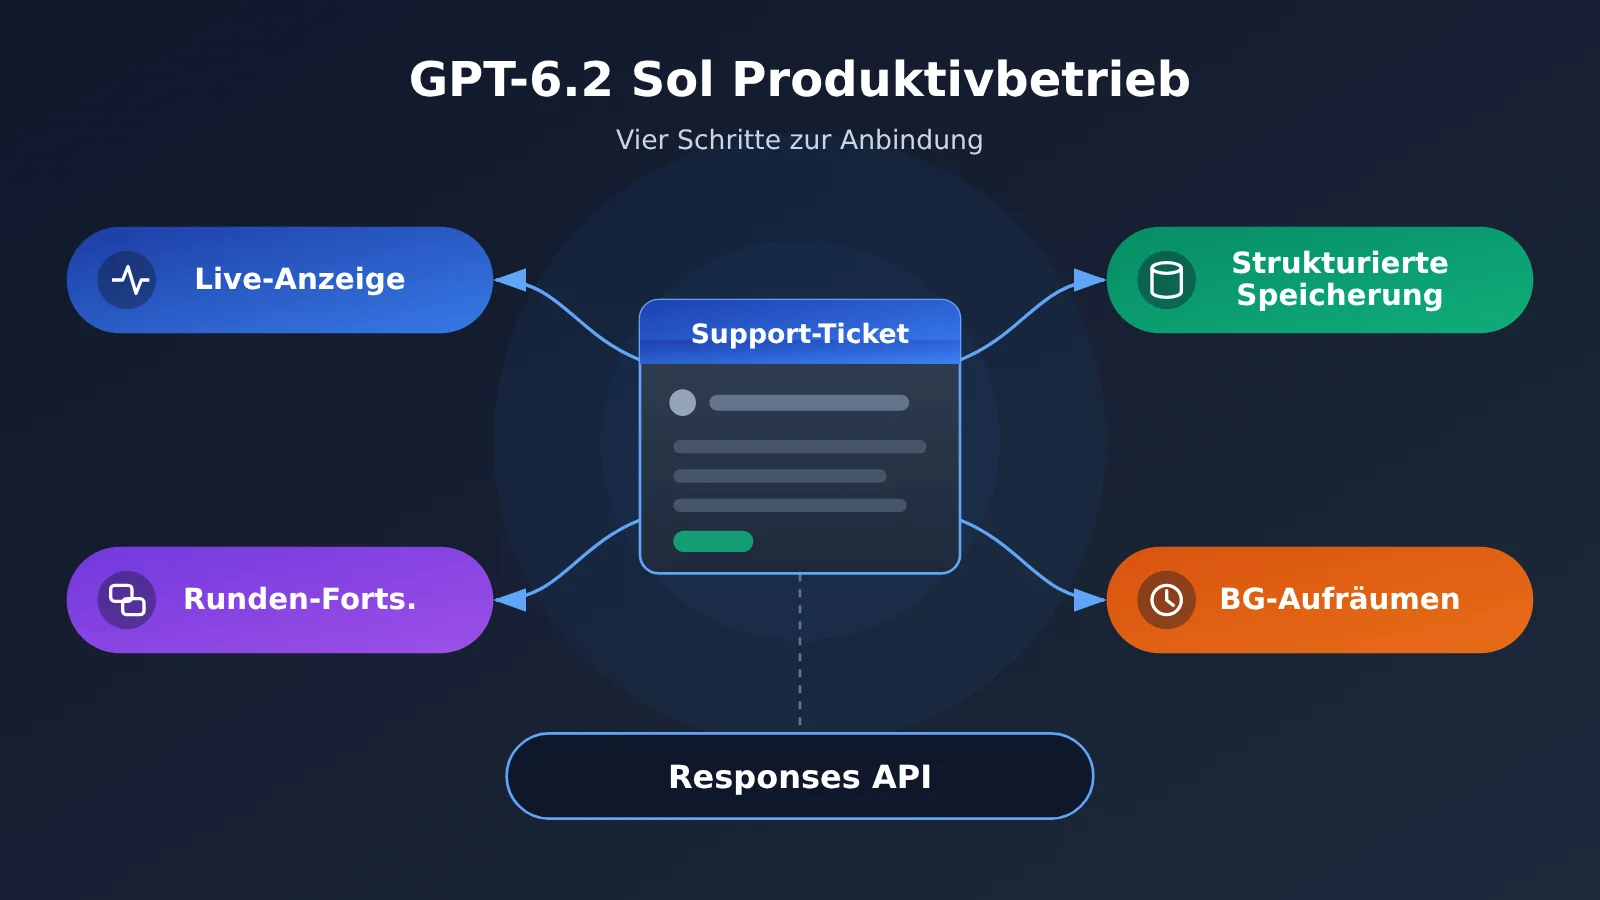
Wissenslandkarte zur Produktionsanbindung von GPT-6.2 Sol
Der gesamte Artikel folgt einem Ablauf: Anfrage senden → Anzeigen → Fortsetzen → Zurücklesen → Abnahme. Das folgende Ablaufdiagramm zeigt die Ergebnisse jedes Schritts und die entsprechenden Abschnittsnummern im Text.
Anfrage senden (model=gpt-6.2-sol,Responses API)
  │
  ├─▶ Anzeigen【Abschnitt 1】
  │     Inkrementelle Ereignisse → Seite zeigt Qualitätsprüfungshinweise in Echtzeit
  │     Terminale Ereignisse → Ladevorgang beenden; vollständige Antwort → Schema + Fachvalidierung → Persistieren / manuelle Nachprüfung
  │
  ├─▶ Fortsetzen【Abschnitt 2】
  │     Selbst verwaltete Historie / previous_response_id / Conversation
  │     Dauerhafte Regeln (developer) und Anweisungen der aktuellen Runde (instructions) getrennt halten
  │
  ├─▶ Zurücklesen【Abschnitt 3】
  │     background-Übermittlung → Antwort-ID speichern → Webhook-Signaturprüfung und Deduplizierung → per ID zurücklesen → Endzustand speichern
  │
  └─▶ Abnahme【Abschnitt 4】
        Erfolg / unvollständig / doppelte Benachrichtigung / Client-Verbindungsabbruch / Schema-Änderung
Anbindungsindex für GPT-6.2 Sol
| Abschnitt | Beantwortete Frage | Was er für den weiteren Text liefert | Was man danach umsetzen kann |
|---|---|---|---|
| 1. Streaming und strukturierte Ausgabe | Wie die Seite den Stream anzeigt, wie die Maschine das Ergebnis entgegennimmt | Definiert die Kriterien für „abgeschlossen“ und „persistierbar“ | Anzeigepfad und Persistenzpfad unterscheiden |
| 2. Mehrrundenstatus | Wie die nächste Anfrage an die vorherige Runde anknüpft | Legt fest, wer den Status hält und welche Aufbewahrungsbedingungen gelten | Nur den Fokus der aktuellen Runde ändern, ohne den Präfix zu beschädigen |
| 3. Hintergrundaufgaben | Wie das Ergebnis persistiert wird, nachdem der Benutzer die Seite verlassen hat | Die Beziehung zwischen Antwort-ID, Aufgaben-ID und Endzustand | Signaturprüfung, Deduplizierung und idempotentes Schreiben implementieren |
| 4. Abnahme vor dem Produktivstart | Welche Verhaltensweisen vorab geprüft werden müssen | Fasst die Prüfkriterien der ersten drei Abschnitte zusammen | Erzeugt eine nachvollziehbare Regressionsaufzeichnung |
Die Abschnitte 1 bis 3 entsprechen jeweils einem Ausführungspfad. Wenn Sie nur einen davon umsetzen, können Sie gezielt nachschlagen. Abschnitt 4 baut auf den in den ersten drei Abschnitten definierten Zuständen auf und sollte zuletzt gelesen werden.
Wichtige Begriffe zu GPT-6.2 Sol
| Begriff | Erklärung |
|---|---|
| SSE | Ein Protokoll, bei dem der Server über eine einzige HTTP-Verbindung Ereignisse sequenziell an den Client pusht. |
| Structured Outputs | Eine API-Funktion, die verlangt, dass strukturierte Inhalte aus einer erfolgreichen Antwort einem unterstützten JSON Schema entsprechen. |
| Ablehnungsantwort | Ein Inhaltselement, das zurückgegeben wird, wenn das Modell die Aufgabe ausdrücklich ablehnt; es erfordert einen separaten Ablauf. |
| Sitzungsstatus | Der für nachfolgende Anfragen aufbewahrte Kontext wie Nachrichten, Tool-Ergebnisse usw. |
| Verschlüsseltes Reasoning-Element | Ein verschlüsseltes Antwort-Element, mit dem der Reasoning-Status fortgesetzt wird und das zusammen mit dem Kontext zurückgesendet werden kann. |
| Präfix | Die Kontextsequenz am Anfang der aktuellen Anfrage, die mit der vorherigen Runde exakt übereinstimmt. |
| Fertigstellungsfenster | Der Zielzeitraum für die Fertigstellung dieser Antwort, den der Dienst nach Annahme der Hintergrundanfrage festlegt. |
| Webhook | Eine signierte Benachrichtigung, die der Server aktiv an eine von der Anwendung angegebene URL sendet. |
| Endzustand | Der finale Zustand, nachdem eine Aufgabe abgeschlossen, fehlgeschlagen, unvollständig oder abgebrochen ist. |
| Idempotenz | Die Eigenschaft, dass die wiederholte Verarbeitung desselben Callbacks oder derselben Aufgabe nur einmal eine fachliche Wirkung erzeugt. |
1. GPT-6.2 Sol Streaming-Ausgabe und strukturierte Abnahme
1.1 Die zwei Ausgabepfade von GPT-6.2 Sol
Zuerst ein Szenario aus der Kundendienst-Qualitätsprüfung. Ein diensthabender Mitarbeiter öffnet einen Ticket-Datensatz, und die Seite muss sofort die Aufsichtshinweise des Modells anzeigen. Das Ergebnis derselben Analyse soll außerdem in die Qualitätsprüfungsdatenbank geschrieben werden, damit es in die Tagesendstatistik einfließt. Diese beiden Anforderungen definieren „Fertig“ unterschiedlich, deshalb müssen sie über zwei getrennte Pfade abgewickelt werden.
| Pfad | Konsument | Abhängiges Signal | Bedingung für „Fertig“ | Ziel bei Fehlschlag |
|---|---|---|---|---|
| Anzeigepfad | Mitarbeiterseite | Inkrementereignis response.output_text.delta |
Empfang von response.completed oder einem terminalen Fehlerereignis |
Seitenhinweis, bereits angezeigter Inhalt bleibt erhalten |
| Datenbankpfad | Qualitätsprüfungsdatenbank | Vollständiges Antwortobjekt | Schema-Validierung und Geschäftsvalidierung bestehen beide | Zurückgewiesen, unvollständig, Formatfehler gehen jeweils in die manuelle Nachprüfung |
Wenn bei einer Streaming-Anfrage stream=true gesetzt ist, pusht der Server die Ereignisse nacheinander über HTTP SSE. Die Seite muss lediglich den Text aus response.output_text.delta anhängen und anzeigen. Der Ladezustand darf erst mit dem terminalen Ereignis enden – dass die Textausgabe stoppt, bedeutet noch nicht, dass die Aufgabe abgeschlossen ist.
1.2 Beispiel für die Streaming-Anzeige mit GPT-6.2 Sol
Das folgende Beispiel dient ausschließlich der Veranschaulichung. Es übergibt den inkrementellen Text an das Frontend und beendet das Warten, sobald der Endzustand erreicht ist:
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # APIYI: OpenAI-kompatibler Endpunkt
)

stream = client.responses.create(
    model="gpt-6.2-sol",
    input=[
        {"role": "developer", "content": "你是客服质检督查员,只依据工单原文给出意见。"},
        {"role": "user", "content": "工单 #A1024:客户三次催单未获回复……"},
    ],
    stream=True,
)

for event in stream:
    if event.type == "response.output_text.delta":
        push_to_page(event.delta)          # In Echtzeit auf der Seite anhängen
    elif event.type == "response.completed":
        finish_loading(event.response.id)  # Ladevorgang im Endzustand abschließen
    elif event.type in ("response.failed", "response.incomplete"):
        show_error(event.type)             # Fehler und unvollständige Antworten getrennt anzeigen
push_to_page, finish_loading und weitere sind Funktionen aus der Anwendungslogik. Die vollständige Liste der Endzustandsereignisse finden Sie in der offiziellen Dokumentation zu Streaming-Antworten.
1.3 Abnahmereihenfolge für strukturierte Ausgaben bei GPT-6.2 Sol
In der Responses API wird die strukturierte Ausgabe in text.format deklariert und nicht in der Nachricht. Sobald der Aufnahmepfad die vollständige Antwort erhalten hat, wird in der folgenden Reihenfolge entschieden:
- Antwortstatus prüfen. Unvollständige Antworten (
status= incomplete) gehen direkt in die manuelle Nachprüfung – es wird nicht versucht, halbfertiges JSON zu parsen. - Inhaltselemente prüfen. Tritt ein Inhaltselement vom Typ Ablehnung (Refusal) auf, wird der Ablehnungs-Ablauf durchlaufen; es wird nicht als Formatfehler behandelt.
- JSON parsen und Schema-Validierung durchführen.
- Geschäftsvalidierung durchführen: Das ursprüngliche Ticket existiert, fehlende Felder müssen klar erkennbar sein und dürfen nicht stillschweigend ergänzt werden.
Vollständigen Code für die strukturierte Aufnahme mit GPT-6.2 Sol anzeigen
import json
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

QA_SCHEMA = {
    "type": "object",
    "properties": {
        "ticket_id": {"type": "string"},
        "verdict": {"type": "string", "enum": ["合格", "需整改", "信息不足"]},
        "issues": {"type": "array", "items": {"type": "string"}},
        "missing_fields": {"type": "array", "items": {"type": "string"}},
    },
    "required": ["ticket_id", "verdict", "issues", "missing_fields"],
    "additionalProperties": False,
}

resp = client.responses.create(
    model="gpt-6.2-sol",
    input=[{"role": "user", "content": "请质检工单 #A1024:……"}],
    text={"format": {"type": "json_schema", "name": "qa_result",
                     "schema": QA_SCHEMA, "strict": True}},
)

def route(resp):
    if resp.status == "incomplete":
        return ("manual_review", "incomplete", resp.incomplete_details)
    for item in resp.output:
        for part in getattr(item, "content", []) or []:
            if part.type == "refusal":
                return ("manual_review", "refusal", part.refusal)
    try:
        data = json.loads(resp.output_text)
    except json.JSONDecodeError:
        return ("manual_review", "bad_json", None)
    if not ticket_exists(data["ticket_id"]):
        return ("manual_review", "unknown_ticket", data)
    return ("save", "ok", data)

print(route(resp), resp.id)
Beachten Sie: Eine bestandene Schema-Validierung bedeutet nur, dass die Struktur korrekt ist – nicht, dass auch der Inhalt stimmt. Ob die Ticketnummer existiert und ob fehlende Felder wahrheitsgemäß gekennzeichnet sind, muss in der Geschäftsschicht geprüft werden.
🎯 Technischer Hinweis: In der Testumgebung können Sie über APIYI apiyi.com gleichzeitig sowohl Stream- als auch Nicht-Stream-Anfragen starten und den Endzustand sowie das Aufnahmeergebnis desselben Tickets auf beiden Pfaden vergleichen. So lässt sich im Voraus bestätigen, dass sich die Frontend-Ladelogik und die Aufnahme-Verzweigungen nicht gegenseitig stören.
2. Zustandskontinuität bei mehrrundigen Konversationen mit GPT-6.2 Sol
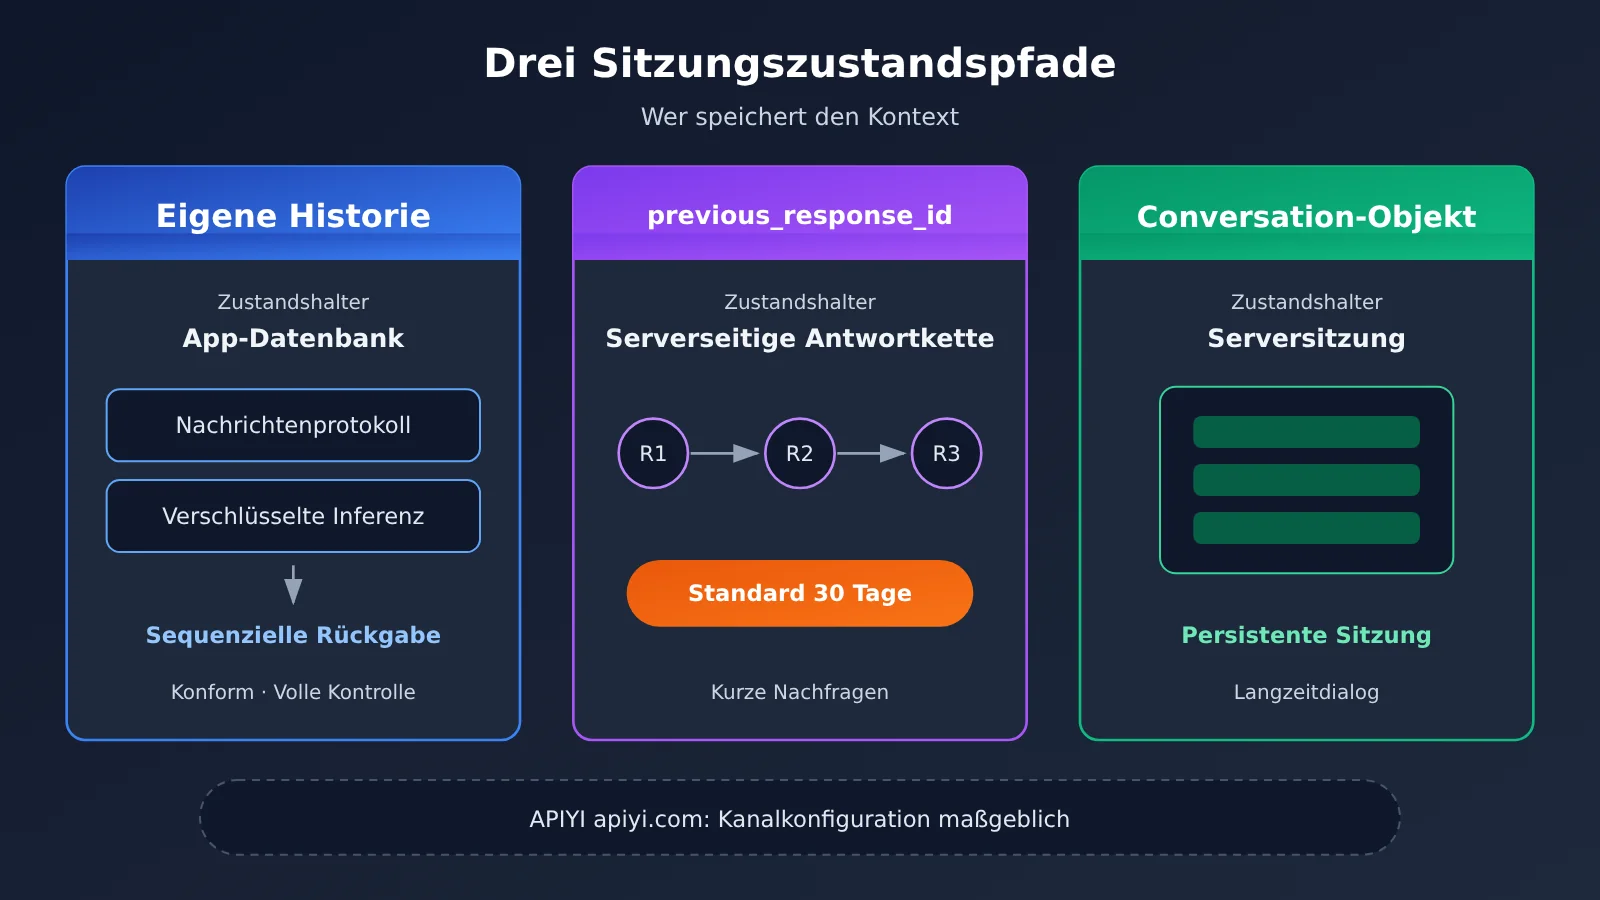
2.1 Vergleich der drei Zustandspfade von GPT-6.2 Sol
Ein Bearbeiter ergänzt im selben Ticket neue Fakten und möchte, dass das Modell die Analyse aus der vorherigen Runde fortsetzt. Dann stellt sich zuerst die Frage: Wer speichert den Kontext?
| Pfad | Zustandshalter | Aufbewahrungsbedingung | Geeignete Szenarien | Verfügbare Plattform |
|---|---|---|---|---|
| Selbstverwalteter Verlauf | Die Anwendung selbst | Von der Anwendung festgelegt; Nachrichten und erforderliche Response-Elemente müssen in der ursprünglichen Reihenfolge zurückübermittelt werden | Bei Compliance-Anforderungen oder wenn volle Kontrolle über den Kontext erforderlich ist | Offizielle API, APIYI apiyi.com |
previous_response_id |
Serverseitige Response-Kette | Fortsetzung nur möglich, solange die Response verfügbar ist; Response-Objekte werden standardmäßig 30 Tage aufbewahrt | Kurzfristige aufeinanderfolgende Rückfragen | Abhängig von der aktuellen Kanal-Konfiguration |
| Conversation-Objekt | Serverseitiges Conversation-Objekt | Einträge, die an einer Conversation hängen, unterliegen den Aufbewahrungsregeln dieses Objekts | Dialoge, die längerfristig gespeichert werden müssen | Abhängig von der aktuellen Kanal-Konfiguration |
Wenn Sie den Verlauf selbst verwalten und zugleich ein durchgängiges Reasoning ermöglichen möchten, dürfen Sie nicht nur Text zurückübermitteln. Alle erforderlichen Response-Elemente müssen aufbewahrt und in der richtigen Reihenfolge erneut übergeben werden – einschließlich der verschlüsselten Reasoning-Elemente.
2.2 GPT-6.2 Sol – nur den Prüfschwerpunkt ändern
Angenommen, in der zweiten Runde soll nur der Prüfschwerpunkt von „Reaktionszeit“ auf „Formulierungskonformität“ geändert werden. Die richtige Vorgehensweise: Die allgemeinen QA-Regeln stehen in der ersten developer-Nachricht der Kette, der nur für diese Runde geltende Schwerpunkt steht im Top-Level-instructions. instructions wirkt sich nur auf die Anfrage aus, in der es mitgegeben wird, und beeinflusst spätere Runden nicht.
first = client.responses.create(
    model="gpt-6.2-sol",
    input=[
        {"role": "developer", "content": "通用质检规则:依据工单原文;缺项必须列出……"},
        {"role": "user", "content": "质检工单 #A1024,关注响应时效。"},
    ],
)

second = client.responses.create(
    model="gpt-6.2-sol",
    previous_response_id=first.id,
    instructions="本轮只审查话术合规,不重复时效结论。",  # Gilt nur für diese Anfrage
    input=[{"role": "user", "content": "补充:坐席第二次回复使用了模板话术。"}],
)
Das hat noch einen weiteren Vorteil: Die erste Regel bleibt unverändert, und auch das Präfix bleibt stabil.
2.3 Das Risiko von Präfixänderungen bei GPT-6.2 Sol
GPT-6.2 kann in mehreren Situationen zugehörige Reasoning-Elemente löschen: beim Umschreiben alter Historie, bei einem teilweisen Modellwechsel (etwa einem Downgrade) sowie beim Wechsel von Benutzer oder Organisation. Bei einer Standard-Single-Agent-Sitzung, die fortgeführt werden soll, gilt: Wenn die Reasoning-Stufe oder das Ausgabe-Schema angepasst werden soll, hängt man ein passendes configuration_update-Element an, statt die alte Konfiguration rückwirkend zu verändern. Die konkreten Felder dieses Elements richten sich nach dem GPT-6.2-Migrationsleitfaden.
Wenn langfristige Regeln aktualisiert werden müssen, hängt man eine neue developer-Nachricht ans Ende des Kontexts an, statt die alten Regeln zu bearbeiten oder frühere Tool- und Schema-Konfigurationen anzufassen. Selbst wenn das Präfix stabil bleibt, hängt ein Cache-Treffer weiterhin von der konkreten Anfrage und den Verarbeitungsbedingungen ab – man sollte ihn nicht als garantiertes Ergebnis betrachten.
3. GPT-6.2 Sol: Hintergrundaufgaben in der Datenbank ablegen
3.1 Hintergrund-Einreichung und Fertigstellungsfenster bei GPT-6.2 Sol
Zusammenfassungen von Tickets, die zum Tagesende noch geprüft werden müssen, können lange dauern – und die Agenten bleiben nicht die ganze Zeit auf der Seite. Solche Aufgaben reichen Sie mit background: true ein. Speichern Sie die zurückgegebene Response-ID sofort dauerhaft und ordnen Sie sie eindeutig der Geschäftsvorgangs-ID zu.
Das Fertigstellungsfenster wählen Sie nach der akzeptablen Wartezeit; der Standardwert ist soonest. 2h und 8h sind rabattierte Fenster im Standard-Tarif, derzeit ein öffentliches Betatest-Feature, und beim Einreichen darf kein Streaming aktiviert sein. Parameternamen und Speicheranforderungen für das Fertigstellungsfenster entnehmen Sie der Dokumentation zum Hintergrundmodus.
| Fertigstellungsfenster | Einordnung | Streaming | Geeignete QS-Aufgaben |
|---|---|---|---|
soonest (Standard) |
So schnell wie möglich | Gemäß Dokumentation zum Hintergrundmodus | Prüfungen, die während der Schicht nochmals angesehen werden müssen |
2h |
Rabattiertes Fenster im Standard-Tarif, öffentlicher Test | nicht aktiviert | Zusammenfassung nach Schichtende |
8h |
Rabattiertes Fenster im Standard-Tarif, öffentlicher Test | nicht aktiviert | Batch-Zusammenfassungen zum Tagesende |
3.2 Webhook-Signaturprüfung, Deduplizierung und Zurücklesen bei GPT-6.2 Sol
Solange die Aufgabe in der Warteschlange steht oder läuft, genügt es, dieselbe ID kontinuierlich abzufragen. Wenn ein Abschlussereignis eintrifft, gehen Sie in dieser Reihenfolge vor:
- Signatur prüfen. Bei fehlgeschlagener Prüfung direkt verwerfen.
- Mit
webhook-iddeduplizieren. Dieselbe Benachrichtigung kann erneut zugestellt werden. - Anhand von
event.data.iddie vollständige Response zurücklesen. Die Benachrichtigung selbst dient nicht als Ergebnis. - Endzustand und Ergebnis idempotent anhand der Aufgaben-ID schreiben.
Code zum Abholen der GPT-6.2 Sol-Hintergrundaufgaben anzeigen
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

# Einreichen
job = client.responses.create(
    model="gpt-6.2-sol",
    background=True,
    input=[{"role": "user", "content": "汇总今日待审工单摘要:……"}],
)
db.save_task(task_id="QA-20261120-01", response_id=job.id, status=job.status)

# Webhook-Verarbeitung
def on_webhook(headers, raw_body):
    event = verify_and_parse(headers, raw_body)        # Signaturprüfung, bei Fehler Exception werfen
    if db.seen_webhook(headers["webhook-id"]):         # Deduplizieren
        return 200
    db.mark_webhook(headers["webhook-id"])
    resp = client.responses.retrieve(event.data.id)    # vollständige Response zurücklesen
    task_id = db.task_by_response(resp.id)
    db.upsert_result(task_id, status=resp.status,      # idempotent anhand der Aufgaben-ID schreiben
                     body=resp.output_text if resp.status == "completed" else None)
    return 200
Wenn der Nutzer die Seite schließt und später zurückkehrt, muss das Frontend nur die Geschäftsvorgangs-ID verwenden, um die lokale Datenbank abzufragen. Ist der Status noch nicht terminal, fragt der Server mit der gespeicherten Response-ID weiter ab.
Besondere Aufmerksamkeit gilt der Datenaufbewahrung. Der Hintergrundmodus speichert Response-Daten vorübergehend, um das Zurücklesen zu ermöglichen. Das gilt auch bei gesetztem store: false oder wenn die Organisation ZDR aktiviert hat – prüfen Sie daher anhand der Dokumentation zur Datenkontrolle, ob das akzeptabel ist.
💡 Integrationshinweis: Webhook-Callback-Adresse und Hintergrundmodus erfordern Unterstützung auf Kanalseite. Bevor Sie über APIYI apiyi.com integrieren, prüfen Sie am besten, ob in der aktuellen Kontogruppe Hintergrundmodus und Callback-Funktion freigeschaltet sind. Falls noch nicht, können Sie die Zustandsmaschine zunächst über Polling der Response-ID zum Laufen bringen.
4. Abnahmecheckliste für den Produktivstart von GPT-6.2 Sol
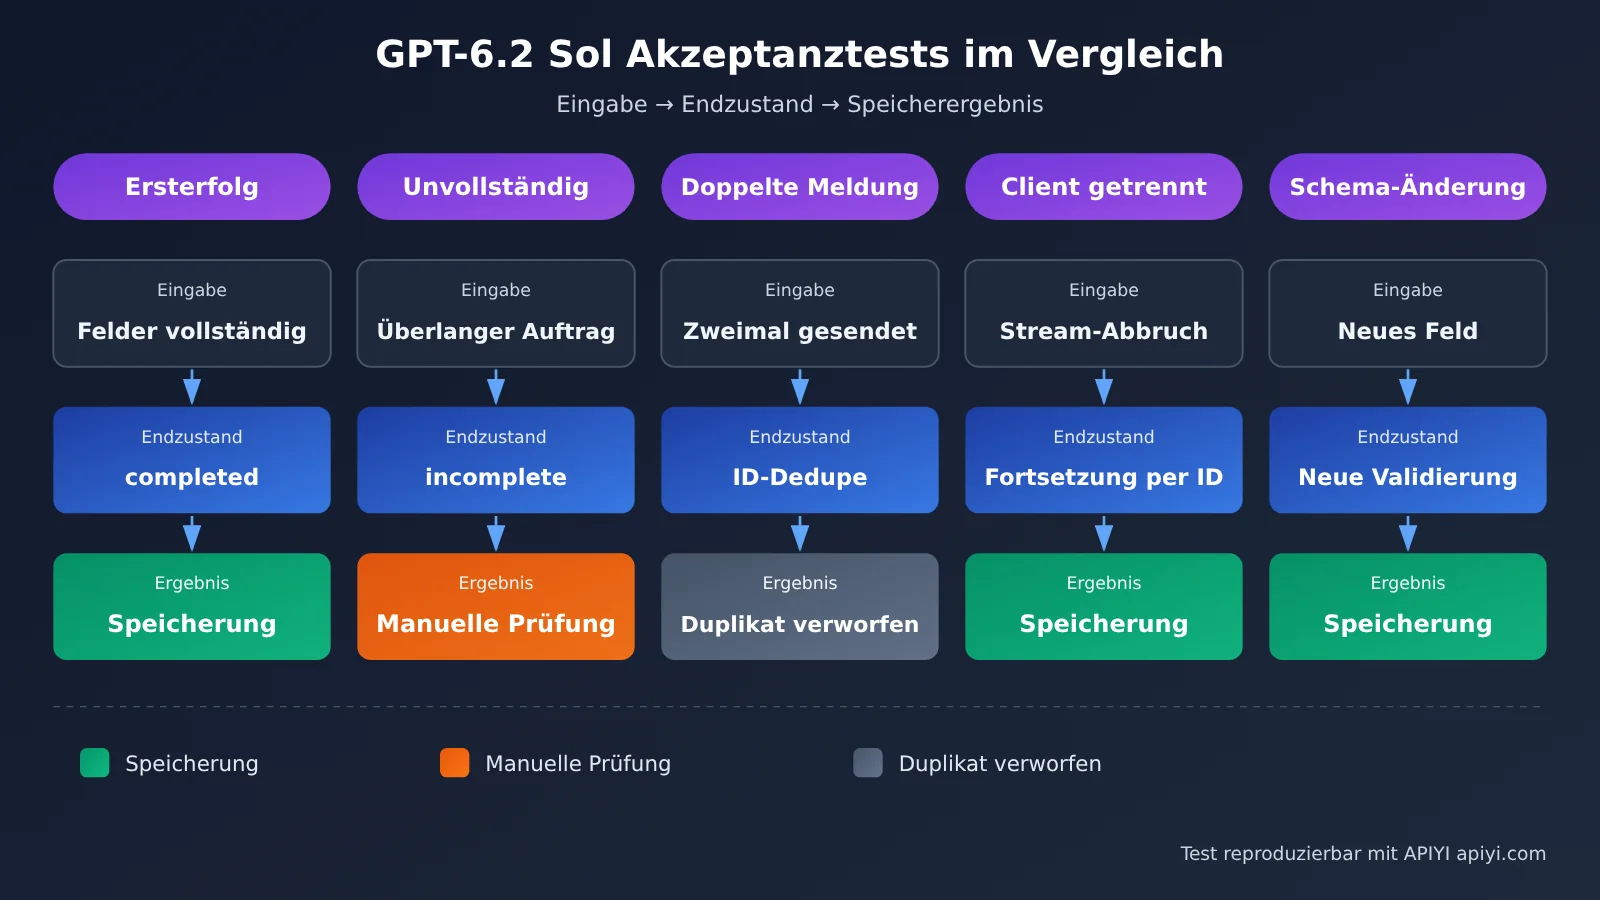
4.1 Synthetische Abnahmetabelle für GPT-6.2 Sol
Die folgende Abnahmetabelle greift das synthetische Fallbeispiel der Kundenservice-Qualitätsprüfung auf und setzt die Bewertungskriterien der drei vorangegangenen Abschnitte Punkt für Punkt in ausführbare Testfälle um.
| Testfall | Eingabebedingung | Erwarteter Status bzw. erwartetes Ergebnis |
|---|---|---|
| Einmaliger Erfolg | Ein tatsächlich vorhandenes Ticket mit vollständigen Feldern | Endstatus completed; Schema- und Fachvalidierung bestanden; genau ein Ergebnis wird unter der Task-ID gespeichert |
| Einmalige unvollständige Antwort | Künstlich reduziertes Ausgabelimit oder ein übermäßig langes Ticket | Status incomplete; kein JSON-Parsing; Übergabe an die manuelle Prüfung mit dokumentiertem Grund |
| Einmalige doppelte Benachrichtigung | Dieselbe webhook-id wird zweimal zugestellt |
Die zweite Zustellung wird dedupliziert; die Ergebnistabelle enthält nur einen Datensatz |
| Einmaliger Client-Abbruch | Browser-Verbindung wird während des Streamings getrennt | Der Status wird über die gespeicherte Response-ID wiederhergestellt; das gespeicherte Ergebnis ist unabhängig von der Seite |
| Einmalige Schema-Änderung | Mitten in der Sitzung wird ein Pflichtfeld hinzugefügt | Die Anpassung erfolgt über ein zusätzliches Konfigurationsupdate, ohne die alte Konfiguration zu überschreiben; neue Ergebnisse werden nach dem neuen Schema validiert |
Für jeden Testfall müssen vier Angaben gespeichert werden: die aufgerufene Modell-ID (gpt-6.2-sol), die Laufzeitparameter, die Response-ID und die Konfigurationsversion der Anwendung. Treten Probleme auf, lassen sich mit diesen vier Angaben genau die betreffende Anfrage lokalisieren.
4.2 Maßstab für Regressionstests bei GPT-6.2 Sol
| Punkt | Erfasster Inhalt | Erläuterung |
|---|---|---|
| Modell | gpt-6.2-sol |
Verweist auf die öffentlich dokumentierte ID der Modellkarte |
| Endpunkt | Responses | Funktionsaufrufe und integrierte Tools laufen über diesen Pfad |
| Reasoning-Stufe | Die tatsächlich verwendete Stufe | Weder Responses noch Chat Completions akzeptieren none |
| Verbrauch | usage.output_tokens und der darin enthaltene Unterposten für Reasoning-Tokens |
Die Abrechnung der Ausgabe enthält bereits die Reasoning-Tokens |
| Abrechnungsstufe | Ob die Eingabe einer einzelnen Anfrage 272K überschreitet | Die öffentliche Preisschnittstelle von APIYI staffelt bei 272.000 Eingabe-Tokens; maßgeblich für die tatsächliche Abrechnung ist die Rechnung |
Bei der Migration eines Altsystems sind Endpunkt, Anfrageparameter, mehrstufige Eingaben, Reasoning-Kontext und Caching getrennt zu prüfen. Nach abgeschlossener Prüfung werden mit derselben Testfallmenge sowohl Beispielanfragen als auch Produktionsanfragen regressiv getestet.
🚀 Abnahmeempfehlung: Die fünf Testfalltypen lassen sich in die CI aufnehmen und laufen dann bei jeder Schema-Änderung oder jedem Kanalwechsel automatisch durch. Mit dem einheitlichen Key von APIYI apiyi.com lassen sich auf demselben Testsatz die Verhaltensunterschiede verschiedener Gruppen vergleichen.
Wenn alle fünf Testfälle der Abnahmetabelle bestehen und sich jeder einzelne anhand der Response-ID zurückverfolgen lässt, ist die Qualitätsprüfungskette bereit für den Produktivbetrieb.
Referenzen
- GPT-6.2 Sol Modellkarte: Modell-ID, Kontext und Abrechnungsregeln
- Link:
developers.openai.com/api/docs/models/gpt-6.2-sol
- Link:
- GPT-6.2 Migrationsleitfaden: Endpunktauswahl, Präfixänderungen und Konfigurationsupdates
- Link:
developers.openai.com/api/docs/guides/latest-model
- Link:
- Streaming-Antworten und strukturierte Ausgaben: SSE-Events und
text.format- Link:
developers.openai.com/api/docs/guides/streaming-responses
- Link:
- Sitzungsstatus:
previous_response_idund Conversations- Link:
developers.openai.com/api/docs/guides/conversation-state
- Link:
- Hintergrundmodus und Webhook: Abschlussfenster, Signaturprüfung und Deduplizierung
- Link:
developers.openai.com/api/docs/guides/background
- Link:
Autor: APIYI-Team
Technischer Austausch: Kontaktieren Sie uns gerne über die Startseite der APIYI-Website; weitere Integrationsinformationen finden Sie im Dokumentationszentrum unter docs.apiyi.com









