Autor-Hinweis: Wenn neue Modelle in Scharen erscheinen, prüfen Sie zuerst, ob der Modelltyp überhaupt im Sortiment ist. Bei bereits gelisteten Modellen ändern Sie nur die Modell-ID; vor dem Wechsel vergleichen Sie Preis, Endpoint und Gruppe. Mit ein und demselben Schlüssel lässt sich der Test erledigen – Sie müssen nicht für jeden Anbieter ein weiteres Konto anlegen.
Am 2026-11-09 veröffentlichte Anthropic Claude Fable 5.2. Eine Woche später, am 2026-11-16, trug Alibaba Cloud Qwen4-Max in die Liste der neu gelisteten Modelle ein. Für Anwendungsentwickler, die neue Modelle anbinden wollen, liegt die Schwierigkeit meist nicht im Aufrufcode, sondern im Prozess: Für jedes neue Modell eines Anbieters muss man ein Konto registrieren, einen Schlüssel beantragen, die Zahlungsmethode hinterlegen und danach noch einmal die Konfiguration anpassen. Dieser Artikel stellt die dreistufige Testmethode vor, bei der ein Schlüssel und ein Wechsel der Modell-ID genügen – damit Sie mit demselben Aufruf zuerst die bereits gelisteten Modelltypen testen können.
Das ist kein weiterer Rückblick auf eine Launch-Präsentation. Die im Text genannten Modelltypen und Preise richten sich nach der Modellübersicht von APIYI apiyi.com (auf der Seite ist als Datenstand der 2026-11-16, 09:39, UTC+8, angegeben; Quelle ist die Echtzeit-Pricing-Schnittstelle des Systems) sowie nach der Herstellerdokumentation. Wir liefern keine eigenen Benchmark-Ergebnisse, sondern beschreiben nur, was vor dem Test zu prüfen, was zu ändern und was abzugleichen ist.
Kernwert: Nach dem Lesen dieses Artikels können Sie mit demselben Schlüssel aus einer Umgebungsvariable zwischen claude-fable-5-2 und der Qwen-Serie hin- und herwechseln und vorher genau abklären, wie sich dieser Modellwechsel auf Ihre Rechnung auswirkt.
Neue Modelle testen: Worauf es beim Wechsel der Modell-ID mit einem Schlüssel ankommt
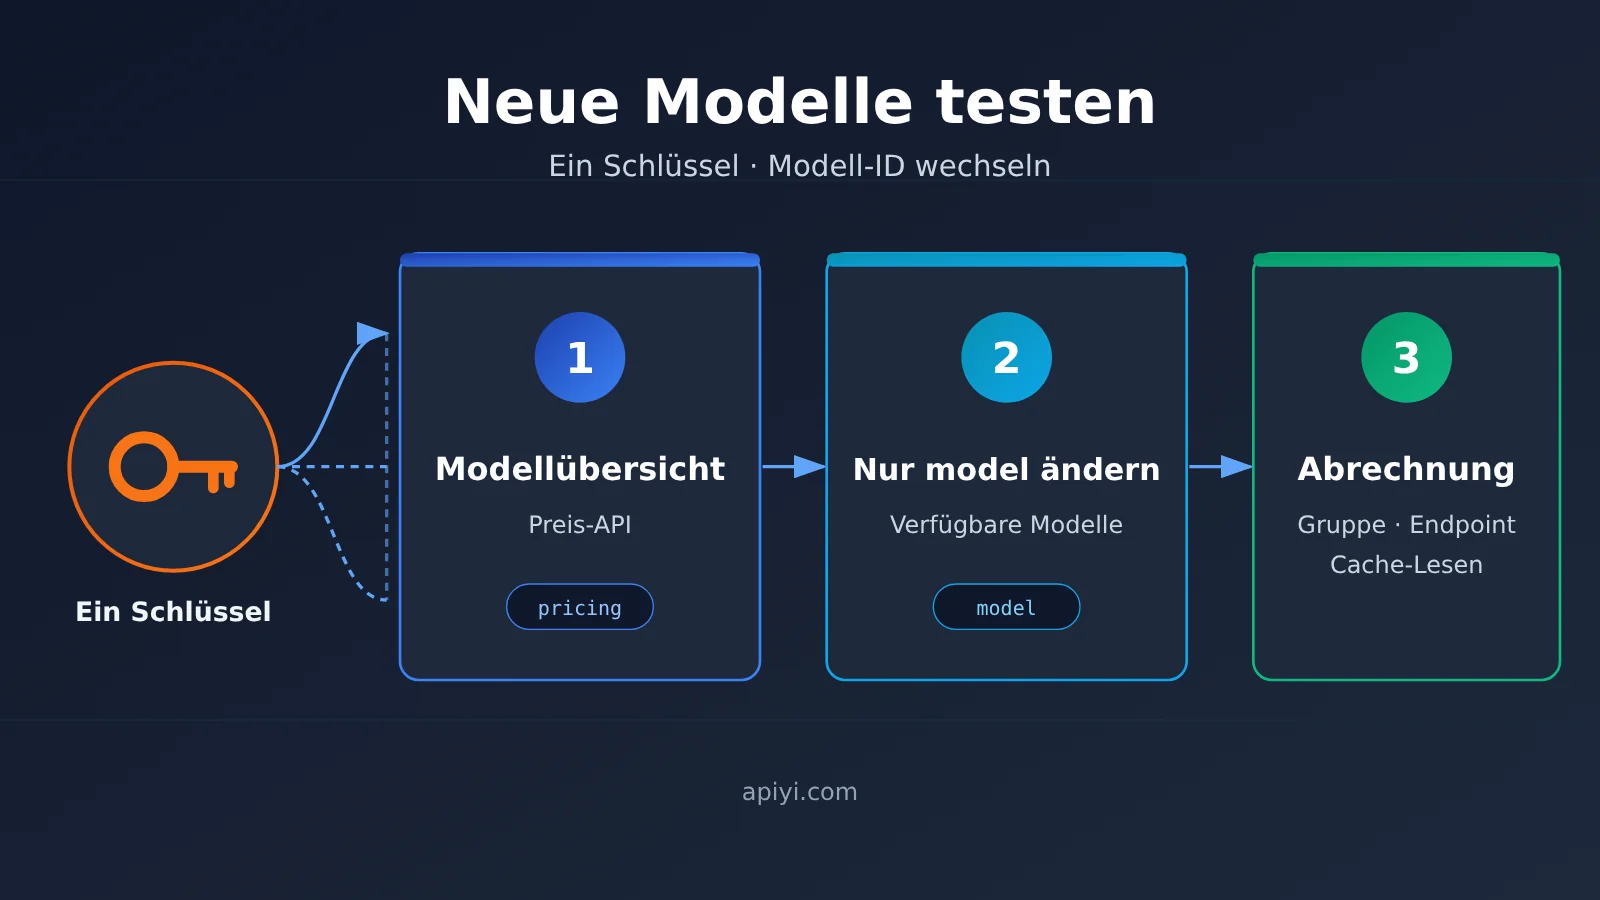
Wenn neue Modelle in großer Zahl erscheinen, ist der häufigste Fehler nicht der Code, sondern dass man das model ändert, ohne vorher zu prüfen, ob dieses Modell überhaupt aufrufbar ist und zu welchem Preis. Die folgende Tabelle zeigt das Gerüst der dreistufigen Vorgehensweise; die einzelnen Punkte werden anschließend ausgeführt.
| Schritt | Was zu tun ist | Warum |
|---|---|---|
| ① Gesamttabelle und Preis-API prüfen | In der Modell-Gesamttabelle und der Preis-API nach der Ziel-Modell-ID suchen | Zuerst prüfen, ob das Modell verfügbar ist; der Preis richtet sich nach dieser Zeile |
② Bei verfügbaren Modellen nur model ändern |
base_url und Schlüssel unverändert lassen, nur das Feld model ersetzen |
Derselbe Aufrufaufbau deckt mehrere Modelle ab |
| ③ Gruppe, Endpoint und Cache-Lesevorgänge prüfen | Eingabepreis, Ausgabepreis, Cache-Lesevorgänge, Endpoint und Gruppe abgleichen | Ein Modellwechsel verändert die Abrechnung und möglicherweise auch das Aufrufprotokoll |
Warum „mit einem Schlüssel die Modell-ID wechseln“ funktioniert
In der APIYI-Dokumentation zu Tokens steht: Wenn für ein Token keine Modell-Whitelist gesetzt ist, stehen alle 200+ ausgewählten Modelle der Plattform zur Verfügung; ist eine Whitelist gesetzt, lassen sich nur die darin angegebenen Modelle aufrufen. Damit „mit einem Schlüssel das Modell wechseln“ funktioniert, muss also eine Voraussetzung erfüllt sein: Das verwendete Token darf das Zielmodell nicht über die Whitelist aussperren. Wenn du projektweise isolierst, unterstützt die Dokumentation auch separate Tokens für verschiedene Projekte, jeweils mit eigenem Kontingent, eigener Gültigkeitsdauer und eigenen Protokollen.
Ein weiteres leicht übersehenes Konzept ist die Gruppe. Laut Dokumentation sind Gruppen Ressourcenkanäle; verschiedene Modelle können unterschiedliche Gruppen erfordern. Ein Token kann höchstens eine Standardgruppe und zwei Fallback-Gruppen haben; im Zweifel Default verwenden. Das bedeutet: Ob ein Aufruf nach dem Wechsel der Modell-ID funktioniert, hängt nicht nur davon ab, ob das Modell verfügbar ist, sondern auch davon, ob die Gruppe, in der es liegt, die Gruppeneinstellungen deines Tokens abdeckt.
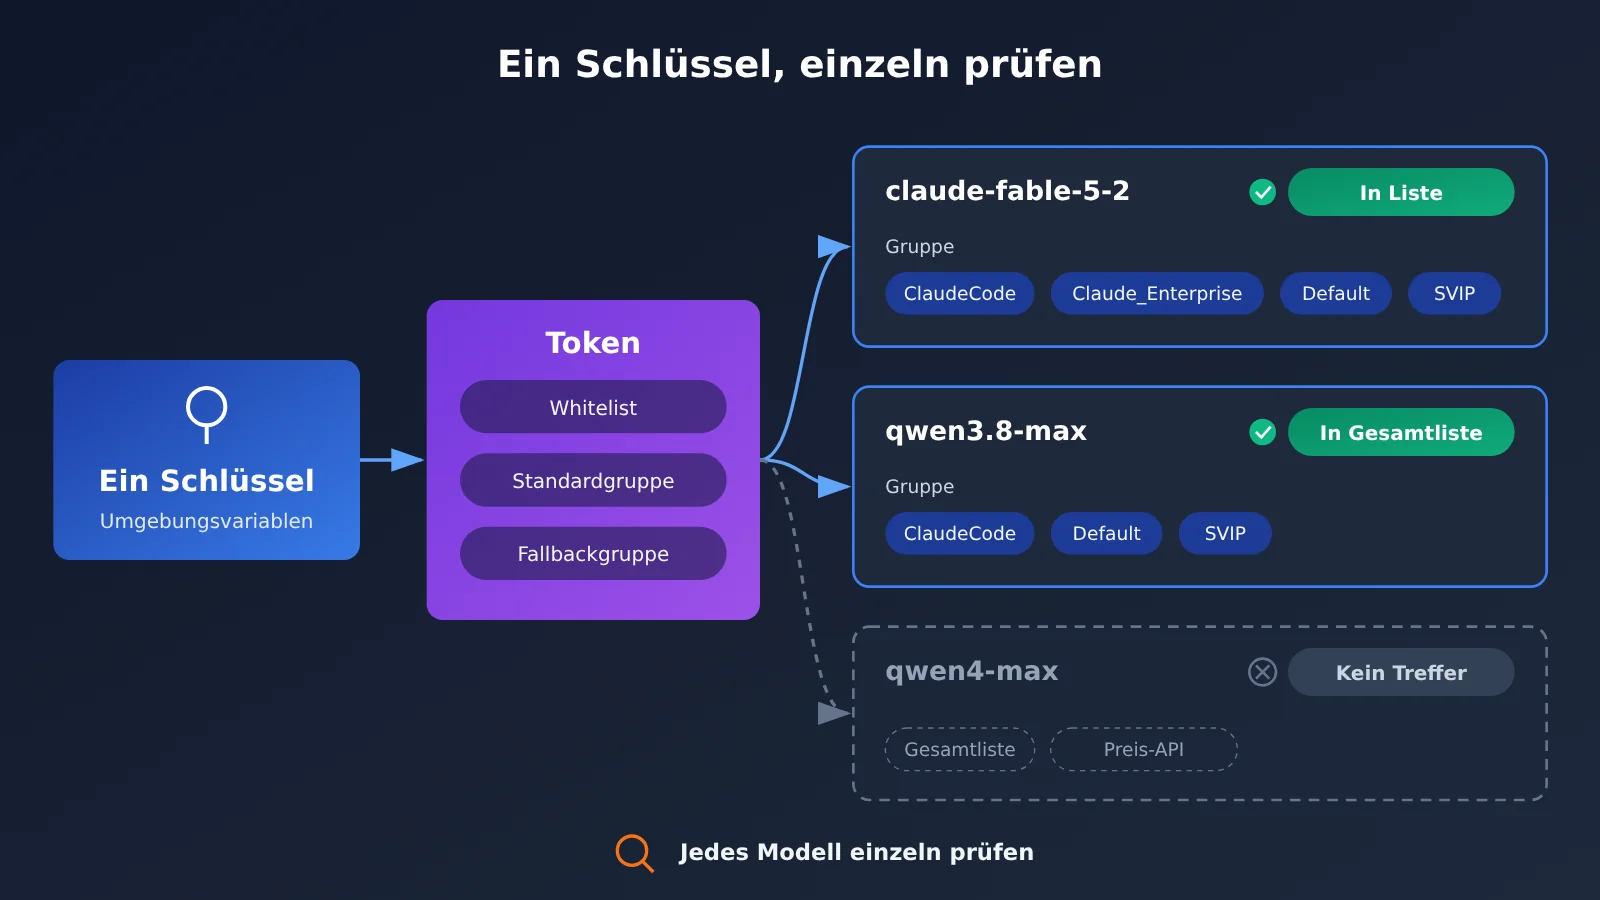
Wie man ein neues Modell testet – Schritt 1: Modelltabelle und Preis-API prüfen
Bevor Sie Code anfassen, machen Sie zwei Abfragen: erstens die Modelltabelle docs.apiyi.com/models.md, zweitens die Preis-API https://api.apiyi.com/api/pricing. Die Tabelle eignet sich gut zum manuellen Durchsehen und für Preisvergleiche, die Preis-API lässt sich prima in Skripte einbauen, um in CI oder im Config-Center automatisch zu prüfen, „ob dieses model in der Preisliste steht“. Erst wenn beide Ergebnisse übereinstimmen, geht es weiter zum nächsten Schritt.
Am Beispiel der zwei neuen Modelle dieser Woche fallen die Ergebnisse deutlich unterschiedlich aus:
| Modell-ID | Hersteller-Ankündigung | APIYI-Modelltabelle | Preis-API vom 2026-11-17 | Testempfehlung |
|---|---|---|---|---|
claude-fable-5-2 |
Anthropic-Ankündigung vom 2026-11-09 | verfügbar (zusätzlich claude-fable-5-2-thinking) |
vorhanden | einfach model ändern und testen |
qwen4-max |
Alibaba Cloud, am 2026-11-16 als gelistet vermerkt | im Abschnitt Alibaba nicht enthalten | nicht in der Antwort (kein qwen4) | erst mit einem benachbarten Modell die Kette zum Laufen bringen |
qwen3.8-max |
bestehendes Modell | verfügbar | vorhanden | als Ersatz-Testobjekt für die Qwen-Kette |
Noch ein Detail: claude-fable-5-2 hat in der APIYI-Dokumentation keine eigene Modellbeschreibungsseite – die entsprechende Adresse liefert 404. Für den Preis gilt daher nur die Zeile aus der Modelltabelle; nicht aus anderen Quellen zusammenstückeln.
🎯 Technischer Tipp: Machen Sie „Preis-API prüfen“ zu einem festen Prüfschritt vor dem Release. Wenn in der Konfiguration ein neuer
model-String auftaucht, fragen Sie zuerst per Skript die Preis-API von APIYI apiyi.com ab und bestätigen Sie, dass er existiert. So vermeiden Sie die Fehlermeldung „Modell nicht vorhanden“ erst nach dem Go-Live.
Claude Fable 5.2 ist verfügbar: einfach die Modell-ID ändern und testen
Laut der Ankündigung von Anthropic vom 09.11.2026 lautet die Entwickler-Modell-ID claude-fable-5-2. Demnach ist die Generierung bis zu 30 % schneller als bei Fable 5.1, der offizielle Preis liegt bei $8 pro Million Token für Input und $40 für Output. Optional gibt es außerdem einen offiziellen Fast Mode für $16 Input und $80 Output. In der APIYI-Übersichtstabelle fehlt die Zeile für den Fast Mode – die Konfiguration sollte man also nicht an den Erwartungen des Fast Mode ausrichten.
Dieselbe Ankündigung erklärt außerdem, dass Fable und Mythos auf derselben Basis aufsetzen: Fable ist für alle Nutzer offen, Mythos erfordert dagegen ein Verifikationsprogramm für Life Sciences oder Cybersecurity. Die aktuellen Modelle in der Anthropic-Modellübersicht sind Claude Fable 5.2, Claude Opus 5.5, Claude Sonnet 5.5, Claude Haiku 5.5 sowie das verifikationspflichtige Mythos 5.2 – ein Modell namens Fable 5.5 gibt es nicht. Die Empfehlung der Ankündigung: Bei den meisten Coding- und Wissensaufgaben startet man mit Claude Opus 5.5, steigt bei Bedarf auf Fable um, und für leichtere Aufgaben nimmt man Sonnet 5.5 oder Haiku 5.5.
Bei APIYI sind claude-fable-5-2 und claude-fable-5-2-thinking beide textbasiert und werden nach Verbrauch abgerechnet: Input $8, Output $40, Cache-Read $0.2 (pro Million Token). Der Endpunkt unterstützt sowohl chat als auch messages, die Gruppen sind ClaudeCode, Claude_Enterprise, Default und SVIP. Diese Preisgruppe gilt nur für diese beiden Fable-Modelle und nicht für die Preise anderer Claude-Modelle.
Qwen4-Max testen: Zuerst mit dem bereits verfügbaren qwen3.8-max die Qwen-Kette durchgängig zum Laufen bringen
Schauen wir zuerst auf die Herstellerseite. Die Modellseite von Alibaba Cloud nennt als Aufruf-ID qwen4-max: Eingabe unterstützt Text, Bilder und Videos, Ausgabe ist Text, das Kontextfenster umfasst 1,000,000; maximaler Input 991,808, maximaler Output 131,072; im Denkmodus maximaler Input 983,616, maximaler Output 262,144, maximale Chain-of-Thought 262,144. Es unterstützt Tool-Aufrufe, strukturierte Ausgabe, explizites Caching und implizites Caching, ist kompatibel mit OpenAI Chat Completions, Responses und Anthropic Messages, unterstützt aber keine Batch-Inferenz und kein Modell-Fine-Tuning. Die Seite „Modellverfügbarkeit und Updates“ von Alibaba Cloud führt es unter dem Datum 2026-11-16, das Service-Deployment beschränkt sich auf das chinesische Festland.
Preise muss man nach Quelle und Währung getrennt betrachten und darf sie nicht zu einer einzigen Zahl zusammenziehen. Die Originalseite des Modells bei Alibaba Cloud Bailian nennt Preise in Renminbi: Denk- und Nicht-Denkmodus liegen in derselben Stufe, für Deployment in China (Festland) und „global“ sind es pro Million Token 10 Yuan beim Input und 30 Yuan beim Output, für internationales Deployment 10.938 Yuan beim Input und 32.813 Yuan beim Output. Auf derselben Seite steht außerdem ein Freikontingent von 1 Million Token, gültig 90 Tage ab Aktivierung von Bailian, ab Modellveröffentlichung oder ab Genehmigung des Antrags – je nachdem, was später liegt. Das sind die Preise von Bailian und das Kontingent von Bailian, mit APIYI hat das nichts zu tun. Der Beitrag des offiziellen Qwen-Accounts vom 2026-11-16 nennt dagegen ein anderes Preisschema in US-Dollar: Input $1.5, Output $4.5, implizites Caching $0.075 (pro Million Token), und weist darauf hin, dass die API über QwenCloud bereitgestellt wird. Bei APIYI ist qwen4-max derzeit noch nicht gelistet; wir nehmen das Modell so schnell wie möglich auf. Modell und Preis richten sich nach der Modellliste der Plattform.
Für die Qwen-Schiene heißt das also: Zuerst mit dem bereits in der Übersichtstabelle vorhandenen qwen3.8-max die Aufrufkette, die Eingabeaufforderungs-Vorlagen, die Parsing-Logik und das Abrechnungs-Monitoring durchgängig zum Laufen bringen. Bei APIYI kostet es $1.65 beim Input, $4.95 beim Output und $0.20625 beim Cache-Read (pro Million Token); die Endpunkte sind chat und messages, die Gruppen sind ClaudeCode, Default und SVIP. Sobald qwen4-max in der Preis-API auftaucht, musst du in der Regel nur das model ändern und dann nach Schritt drei noch einmal alles gegenprüfen.
Schnellstart: ein Schlüssel, nur die Modell-ID wechseln
Im Folgenden zeige ich die Minimal-Konfiguration anhand von Inline-Code – durchgehend mit nur einem Schlüssel.
- Schlüssel in eine Umgebungsvariable legen: zum Beispiel
export APIYI_API_KEY=你的密钥. Schreib den Schlüssel nicht ins Repository und checke ihn nicht in Konfigurationsdateien ein. - Client nur einmal initialisieren: In Python geht das mit
client = OpenAI(api_key=os.environ["APIYI_API_KEY"], base_url="https://api.apiyi.com/v1"), der zugehörige Chat-Completions-Pfad ist/v1/chat/completions. - Modell-ID als Konfigurationswert: zum Beispiel
MODEL=claude-fable-5-2, im Aufruf dannclient.chat.completions.create(model=os.environ["MODEL"], messages=[...]). - Für den Wechseltest nur eine Stelle ändern:
MODELaufqwen3.8-maxsetzen und dieselbe Testsuite erneut laufen lassen – base_url, Schlüssel und Nachrichtenstruktur bleiben unverändert. - Das
model-Feld jeder Anfrage protokollieren: Halte im Log fest, welche Modell-ID verwendet wurde, dann kannst du die Kosten später nach Modell aufschlüsseln.
Der Vorteil: Bei Vergleichstests bleibt als einzige Variable nur das Modell selbst übrig. Gleiche Eingabeaufforderungen, gleicher Parsing-Code – ein anderer String genügt, und du siehst die Unterschiede zwischen den Modellausgaben. So lassen sich die Ergebnisse auch direkt in deine Evaluierungstabelle übernehmen.
🚀 Schnellstart: Falls du noch keinen Schlüssel hast, kannst du dich bei APIYI apiyi.com registrieren – neue Nutzer erhalten ein kostenloses Testkontingent. Am besten legst du dir ein eigenes Token speziell für die „Evaluierung neuer Modelle“ an, getrennt von der Produktionsumgebung in Sachen Kontingent, Gültigkeit und Logs.
Schritt 3 vor dem Wechsel der Modell-ID: Gruppen, Endpunkte und Cache-Lesen prüfen
Das model-Feld zu ändern ist einfach, aber es kann still und leise zwei Dinge verändern: die Abrechnung und das Protokoll. Die folgende Checkliste lohnt sich vor jedem Wechsel:
| Prüfpunkt | Wo nachsehen | Häufige Stolperfallen |
|---|---|---|
| Eingabepreis / Ausgabepreis | entsprechende Zeile in der Modellübersicht | Beim selben Hersteller unterscheiden sich die Preise je Modell stark – nicht nach dem Motto „gleiche Serie“ schätzen |
| Cache-Lesepreis | Spalte „Cache-Lesen“ in der Übersicht | Bei langen System-Eingabeaufforderungen wirkt sich der Cache-Lesepreis direkt auf die Kosten aus |
| Endpunkt | Spalte „Endpunkt“ in der Übersicht (chat / messages) | Läuft der Code über /v1/chat/completions, muss das Modell auch chat unterstützen |
| Gruppe | Spalte „Gruppe“ in der Übersicht + Gruppeneinstellung des Tokens | Verschiedene Modelle können verschiedene Gruppen brauchen – nicht davon ausgehen, dass alle in Default liegen |
| Whitelist | Token-Einstellungen | Ist beim Token eine Whitelist gesetzt und die neue Modell-ID nicht eingetragen, wird der Aufruf abgelehnt |
Betrachtet man die beiden Modelle aus diesem Fall nebeneinander, wird der Unterschied deutlicher:
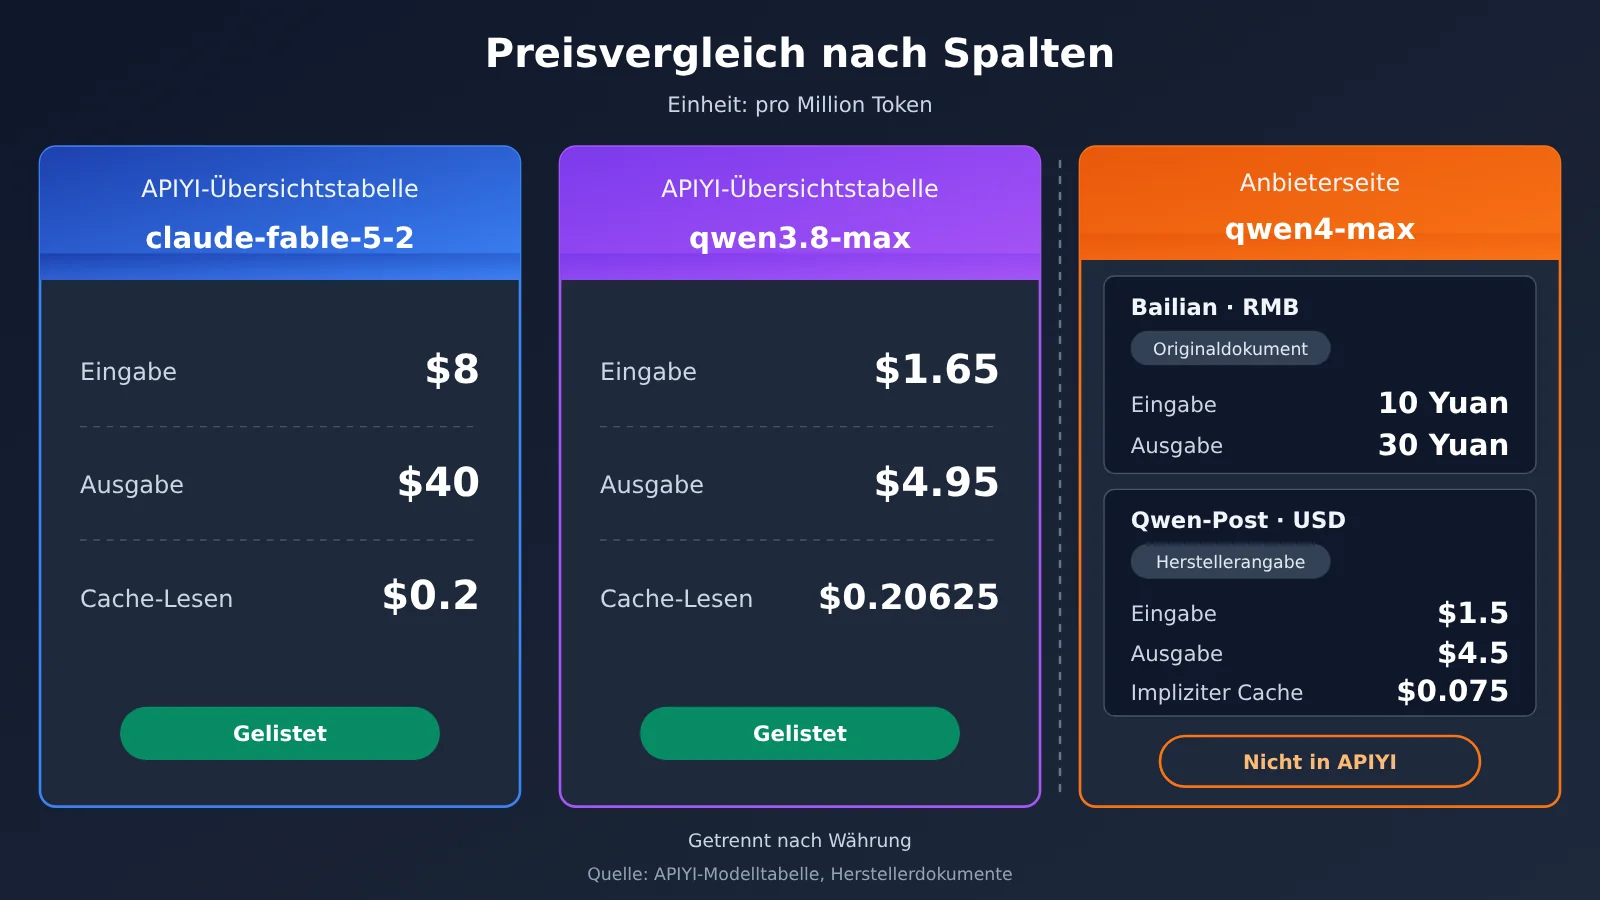
| Modell-ID | Preisquelle | Eingabe | Ausgabe | Cache-Lesen | Endpunkt | Verfügbare Plattformen |
|---|---|---|---|---|---|---|
claude-fable-5-2 |
APIYI-Modellübersicht | $8 | $40 | $0.2 | chat, messages | APIYI apiyi.com, Anthropic offiziell |
qwen3.8-max |
APIYI-Modellübersicht | $1.65 | $4.95 | $0.20625 | chat, messages | APIYI |
qwen4-max |
Originaltext der Bailian-Modellseite (Festland / global) | 10 元 | 30 元 | — | herstellerseitig mit mehreren Protokollen kompatibel | Alibaba Cloud Bailian |
qwen4-max |
Eigenangabe im offiziellen Qwen-Beitrag | $1.5 | $4.5 | impliziter Cache $0.075 | — | QwenCloud |
Alle Preise in der Tabelle gelten pro Million Token. USD- und RMB-Preise stammen aus unterschiedlichen Quellen – bitte getrennt betrachten und nicht umrechnen, addieren oder direkt vergleichen. Auch die Gruppen gilt es einzeln zu prüfen: claude-fable-5-2 hat eine Claude_Enterprise-Gruppe, qwen3.8-max nicht. Wenn die Standardgruppe deines Tokens Claude_Enterprise ist, brauchst du beim Wechsel zu Qwen eine Fallback-Gruppe, die die Gruppe des Modells enthält.
💡 Empfehlung: In der Testphase solltest du die Standardgruppe des Tokens auf Default setzen und 1 bis 2 Fallback-Gruppen konfigurieren, die die zu testenden Modelle abdecken. Zu welchen Gruppen ein bestimmtes Modell gehört, entnimmst du der APIYI-Modellübersicht.
Häufig gestellte Fragen (FAQ)
F1: Was genau bedeutet „ein Schlüssel, nur Modell-ID tauschen“?
Das heißt, dass base_url, Schlüssel und Anfragestruktur unverändert bleiben und Sie nur das Feld `model` austauschen, um das Modell zu wechseln. Voraussetzung ist, dass das Zielmodell bereits auf der Plattform gelistet ist, das Token nicht durch eine Whitelist blockiert wird und die zugehörige Gruppe verfügbar ist.
F2: Kann man qwen4-max jetzt direkt testen?
Stand 17.11.2026 ist `qwen4-max` weder in der APIYI-Übersichtstabelle noch in der Preis-API zu finden. Es empfiehlt sich, zuerst mit `qwen3.8-max` die Qwen-Kette zum Laufen zu bringen und danach regelmäßig die Preis-API von APIYI apiyi.com abzufragen, um nach dem Erscheinen auf das Modell umzuschalten.
F3: Lässt sich das kostenlose Kontingent von 1 Million Tokens bei Bailian auch in APIYI nutzen?
Nein. Das ist das Bailian-Kontingent, wie es im Original auf der Modellseite von Alibaba Cloud Bailian steht, und gilt nur bei Bailian. APIYI hat sein eigenes kostenloses Testkontingent für neue Nutzer – das sind zwei verschiedene Dinge.
F4: Lässt sich der fast mode von Claude Fable 5.2 über APIYI aufrufen?
In der APIYI-Übersichtstabelle gibt es keine Zeile für den fast mode; gelistet sind `claude-fable-5-2` und `claude-fable-5-2-thinking`. Die Preise von 16 $ / 80 $ für den fast mode sind die offiziellen Preise von Anthropic.
F5: Nach dem Ändern des model kommt ein Fehler – was zuerst prüfen?
Der Reihe nach abklopfen: Ist das Modell in der Übersichtstabelle, enthält die Token-Whitelist es, deckt die Gruppe des Tokens die Gruppe dieses Modells ab, und unterstützt der Endpunkt den von Ihnen gewählten Pfad. Wenn Sie das selbst nicht beurteilen können, sehen Sie sich in APIYI apiyi.com die Aufrufprotokolle des entsprechenden Tokens an, um zu lokalisieren, an welcher Stelle die Ablehnung erfolgt.
F6: Kann man für alle Modelle einfach nur die Default-Gruppe verwenden?
Davon sollte man nicht ausgehen. Die Dokumentation empfiehlt, bei Unsicherheit Default zu verwenden, weist aber auch darauf hin, dass verschiedene Modelle unterschiedliche Gruppen benötigen können. Maßgeblich ist die Übersichtstabelle pro Modell; bei Bedarf sollte man eine Ausweichgruppe konfigurieren.
Wie man neue Modelle testet: ein Schlüssel, wechselnde Modell-ID – die Kernpunkte (Key Takeaways)
- Erst prüfen, dann ändern: Schlag die Ziel-ID sowohl in der Modellübersicht als auch über die Preis-API nach, bevor du an der Konfiguration drehst.
- Nur
modelanfassen: Bei Modellen, die bereits live sind, bleibenbase_urlund Schlüssel unverändert. - Fable-Preise getrennt betrachten: Die $8 / $40 / $0.2 pro Cache-Read für
claude-fable-5-2gelten nicht für andere Claude-Modelle. - Qwen erst über die alte Route laufen lassen: Mit
qwen3.8-maxden Ablauf verifizieren, erst nach dem Livegang vonqwen4-maxumschalten. - Währungen separat lesen: Die RMB-Preise von Bailian und die USD-Preise im Qwen-Beitrag stammen aus unterschiedlichen Quellen – nicht zu einer einzigen Zahl zusammenrechnen.
- Gruppen einzeln abgleichen: Ein Token hat höchstens 1 Standardgruppe plus 2 Fallback-Gruppen – nicht einfach alles im Default lassen.
Zusammenfassung
Wenn neue Modelle im Rudel auftauchen, hängt die Testeffizienz am Prozess – nicht daran, wie viele Accounts du angelegt hast:
- Übersicht und Preis-API prüfen: Bestätigen, dass das Modell live ist; maßgeblich ist die entsprechende Zeile in der Übersicht.
- Bei live geschalteten Modellen nur
modeländern: Ein Schlüssel, ein Aufruf-Setup – damit deckst du mehrere Anbieter ab. - Gruppen, Endpunkte und Cache-Reads abgleichen: Ein Modellwechsel ändert die Rechnung und unter Umständen auch das Protokoll – vor dem Umschalten Punkt für Punkt prüfen.
Diese Woche passt genau zu beiden Wegen: claude-fable-5-2 lässt sich direkt testen, bei Qwen bringst du zuerst mit qwen3.8-max die Route zum Laufen. Empfohlen: über APIYI apiyi.com mit einem einzigen Schlüssel diesen Test durchziehen und die Energie für die Bewertung der Modelle selbst behalten.
📚 Referenzen
-
APIYI-Modellübersicht: Grundlage für die Prüfung von Preisen, Endpunkten und Gruppen
- Link:
docs.apiyi.com/models.md - Hinweis: Auf der Seite ist vermerkt, dass die Daten am 2026-11-16 um 09:39 (UTC+8) aktualisiert wurden; Quelle ist die Echtzeit-Preisschnittstelle des Systems.
- Link:
-
APIYI-Hinweise zu Tokens und Gruppen: Whitelist, separate Tokens, Standard- und Fallback-Gruppen
- Link:
docs.apiyi.com/faq/token-and-groups.md - Hinweis: Erklärt die Voraussetzungen dafür, mit einem einzigen Schlüssel zwischen Modellen zu wechseln.
- Link:
-
Ankündigung zu Anthropic Claude Fable und Mythos 5.2: Modell-IDs, offizielle Preise und Fast Mode
- Link:
anthropic.com/claude-fable-and-mythos-5-2 - Hinweis: Enthält Verifizierungsanforderungen für Mythos und Empfehlungen zur Modellauswahl.
- Link:
-
Anthropic-Modellübersicht: aktuelle Liste der Claude-Modelle
- Link:
platform.claude.com/docs/en/about-claude/models/overview - Hinweis: Bestätigt die vorhandenen Modellnamen.
- Link:
-
Alibaba Cloud Bailian Qwen4-Max-Modellseite: Spezifikationen, RMB-Preisangaben und kostenloses Kontingent bei Bailian
- Link:
help.aliyun.com/zh/model-studio/qwen4-max - Hinweis: Preise und Kontingent stammen unverändert aus der Bailian-Dokumentation.
- Link:
-
Alibaba Cloud: Modellveröffentlichungen und Aktualisierungen: Veröffentlichungsdatum und Bereitstellungsumfang von qwen4-max
- Link:
help.aliyun.com/zh/model-studio/newly-released-models - Hinweis: Erfassungszeitpunkt: 2026-11-16.
- Link:
-
Offizieller Qwen-Blog und Beitrag im offiziellen Account: USD-Preisangaben aus erster Hand und QwenCloud
- Link:
qwen.ai/blog?id=qwen4-max - Hinweis: Die USD-Preise sind offizielle Angaben und sollten getrennt von den RMB-Preisen bei Bailian betrachtet werden.
- Link:
Autor: APIYI-Technikteam
Technischer Austausch: Kontaktieren Sie uns gern über die Startseite der APIYI-Website. Weitere Informationen zu Modellen und Gruppen finden Sie im Dokumentationszentrum.