Zusammenfassung: DeepSeek Harness kann über die „benutzerdefinierte Modell-API“ Gateways wie APIYI anbinden. Entwickler konfigurieren für jedes Protokoll separat einen Anbieter, tragen die vom Gateway tatsächlich unterstützten Modell-IDs ein und binden je nach Aufgabenanforderung zusätzlich Websuche-Tools ein.
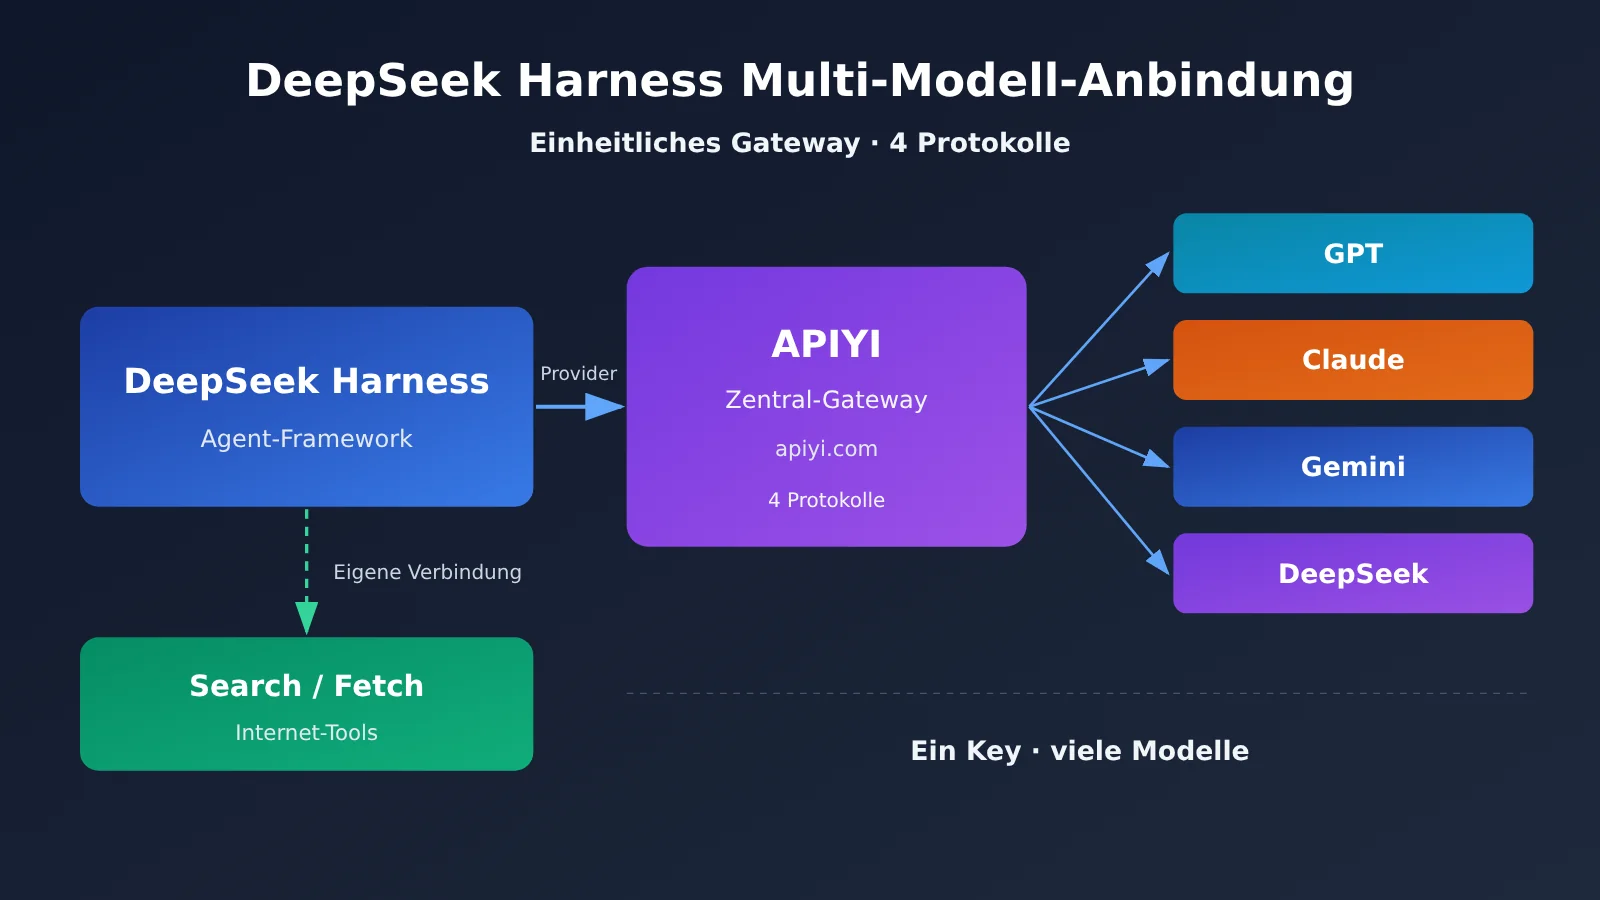
DeepSeek Harness unterstützt das Hinzufügen von Drittanbieter-API-Gateways als benutzerdefinierte Modellanbieter. Zur Auswahl stehen vier Protokolle: OpenAI Chat Completions, OpenAI Responses, Anthropic Messages und Gemini API. Dadurch kann eine Harness-Instanz über ein einheitliches Gateway wie APIYI apiyi.com gleichzeitig Modelle mehrerer Hersteller aufrufen. Ob die Anbindung gelingt, hängt von vier Dingen ab: Übereinstimmung von Protokoll und Base-URL, Konsistenz der Modell-ID mit dem Gateway, Kompatibilität der Inferenz- und Ausgabeparameter sowie die separate Planung der Websuche-Tools.
Im Folgenden wird zunächst der Modell-Adapter-Mechanismus von Harness und die Rolle des Gateways dabei erläutert. Anschließend wird anhand der Einstellungsoberfläche Schritt für Schritt eine benutzerdefinierte Anbieterkonfiguration durchgeführt und eine Konfigurationsdateivorlage für APIYI bereitgestellt. Danach werden die häufigsten Kompatibilitätsprobleme und Fehlercodes zusammengefasst, die auftreten, wenn die Schnittstelle erreichbar ist, der Aufruf aber fehlschlägt. Darauf folgt die Unterscheidung zwischen der serverseitig in DeepSeek integrierten Suche und den beiden eigenständigen Websuche-Routen Search / Fetch von APIYI. Zum Schluss werden ein mehrschichtiges Design und Empfehlungen für die Bereitstellung eines Multi-Modell-Agenten gegeben.
Zum Einstieg: Terminologie zur Multi-Modell-Anbindung im DeepSeek Harness
| Begriff | Erklärung |
|---|---|
| Harness | Das Laufzeitgerüst eines Agents. Es kümmert sich um die Modellanbindung, Tool-Aufrufe, den Kontext, Sitzungen und die Ausführungsschleife für Tasks |
| API Gateway | Ein Gateway, das API-Anfragen an mehrere Modelle einheitlich weiterleitet und verwaltet – nach außen gibt es nur einen einzigen Einstiegspunkt |
| Base URL | Die Basisadresse für API-Anfragen. Je nach Protokoll unterscheidet sich das Pfadpräfix der Adresse |
| Provider | Ein im Harness konfigurierter Modellanbieter. Er entspricht jeweils einem Satz aus Adresse, Protokoll und Schlüssel |
| Model ID | Die Kennung des in einer Anfrage angegebenen Modells. Sie muss mit dem Namen übereinstimmen, den das Gateway tatsächlich anbietet |
| Chat Completions | Eine Dialog-Schnittstelle im OpenAI-Stil – das am häufigsten genutzte Protokoll kompatibler Gateways |
| Responses API | OpenAIs Schnittstelle für strukturierte Antworten, ausgelegt auf Tool-Aufrufe und mehrstufige Interaktion |
| Anthropic Messages | Eine Nachrichten-Schnittstelle im Anthropic-Stil und das native Protokoll der Claude-Modellreihe |
| Reasoning Effort | Der Parameter für die Denkstufe des Modells, etwa off, low, medium, high, max |
| Tool Calling | Modell oder Agent entscheiden, ein externes Tool aufzurufen, und verwenden das Ergebnis für die weitere Schlussfolgerung |
| Search / Fetch | Search übernimmt die Websuche und liefert eine Ergebnisliste zurück; Fetch ruft den Textinhalt einer angegebenen Webseite ab |
| API Key | Anmeldedaten zur Identitätsprüfung. Sie bestimmen, auf welche Modelle und Schnittstellen eine Anfrage zugreifen darf |
1 Warum DeepSeek Harness für die Anbindung mehrerer Modell-APIs geeignet ist
1.1 Der Provider-Mechanismus von DeepSeek Harness
DeepSeek Harness wurde am 13. August 2026 als Developer Preview unter der MIT-Lizenz als Open Source veröffentlicht. Die Kernarchitektur folgt dem Prinzip „Everything is a Plugin“. Modelladapter, Tools, Skills, Speicher und Sitzungsverwaltung sind austauschbare Plugins. Die Modellanbindung wird dadurch zu einem offenen Konfigurationseintrag und nicht zu einer fest im Produkt verdrahteten Bindung an einen Hersteller.
Auf Modellebene können Nutzer mehrere Provider hinzufügen und innerhalb einer Sitzung zwischen Modellen wechseln. Für jeden Provider lassen sich API-Schlüssel, Base URL, Modellname, API-Protokoll, Kontextlänge, maximale Ausgabe-Token, Bild-Eingabefähigkeit und Reasoning-Stufe konfigurieren. API-Proxy-Dienste, unternehmensinterne Gateways und selbst gehostete Modellservices können jeweils als eigenständige Provider angebunden werden.
Zu beachten ist, dass sich Harness noch in der Developer Preview befindet und die offizielle Dokumentation auf mögliche Breaking Changes in künftigen Versionen hinweist. Vor dem Einsatz in der Produktion sollten Sie die Version fixieren und die Konfiguration sichern.
1.2 Die Rolle des API-Gateways in DeepSeek Harness
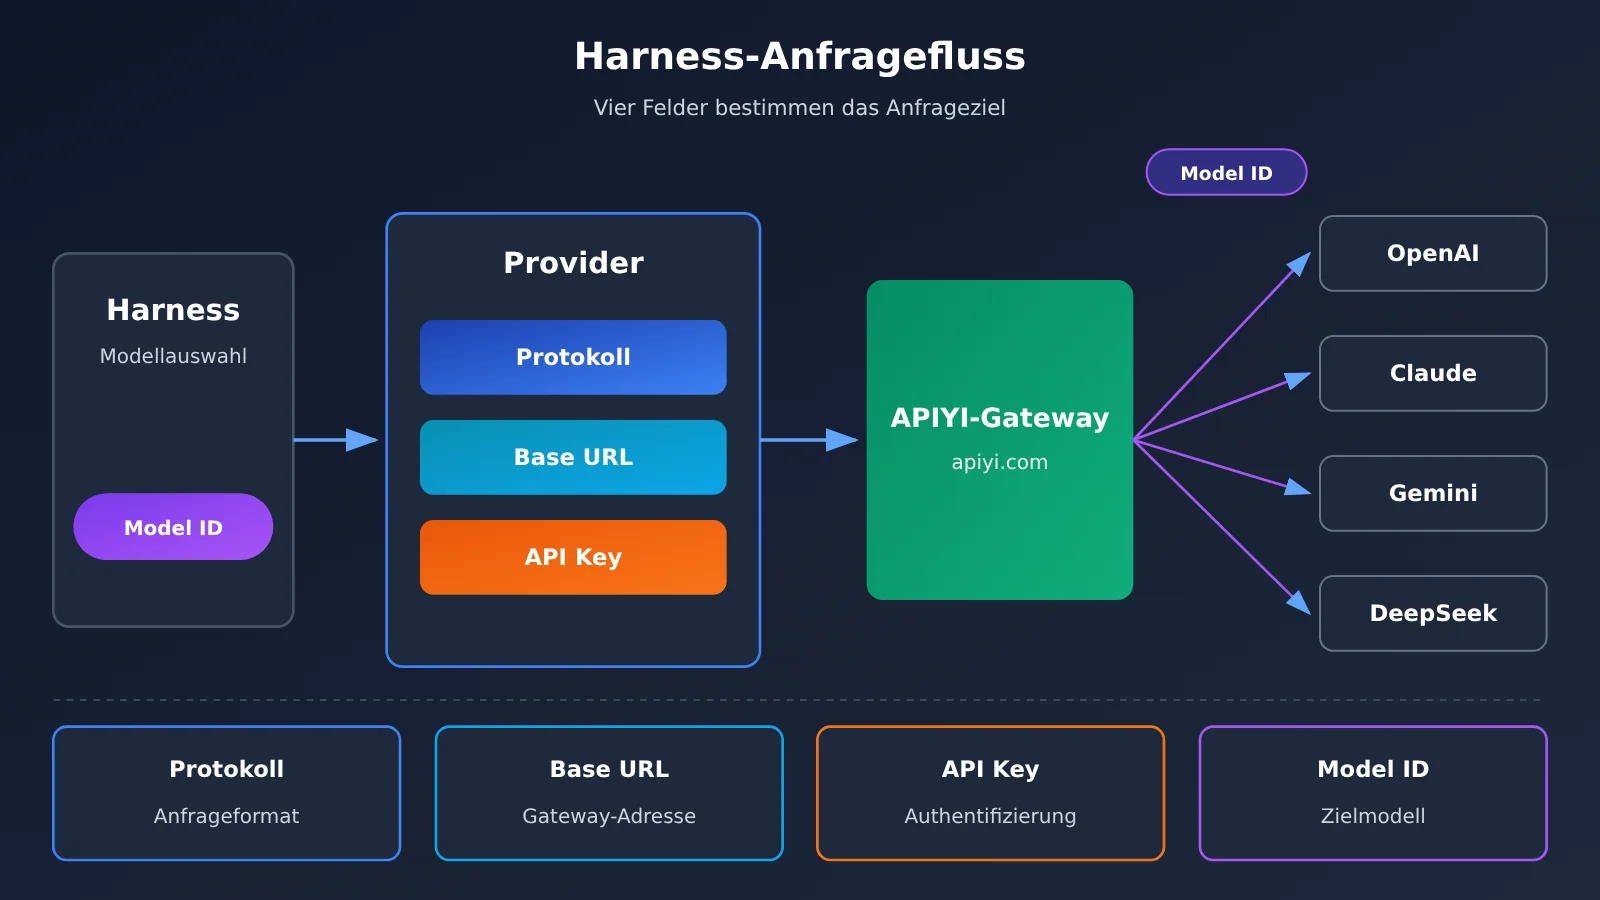
Aus Sicht von Harness ist ein Gateway einfach ein Provider. Vier Felder bestimmen, wohin eine Anfrage geht: Die Base URL verweist auf die Gateway-Adresse, das Protokoll legt das Format von Anfrage und Antwort fest, der API-Schlüssel weist die Identität des Aufrufers nach, und die Model ID sagt dem Gateway, an welches Modell es die Anfrage weiterleiten soll.
Am Beispiel von APIYI apiyi.com: Die Plattform stellt OpenAI-, Claude-, Gemini- und DeepSeek-Modelle über einen einzigen API-Schlüssel bereit und bietet drei Protokollzugänge: OpenAI-kompatibel, Anthropic-native sowie Gemini. In Harness müssen Sie dann nur noch je nach Protokoll den passenden Provider anlegen. Ein Modellwechsel besteht lediglich im Ändern der Model ID, und Sie müssen weder für jeden Hersteller ein separates Konto beantragen noch Schlüssel pflegen.
2 DeepSeek Harness: Einen benutzerdefinierten Modell-Provider von Grund auf einrichten
2.1 Die Modellkonfiguration von DeepSeek Harness öffnen
Am schnellsten starten Sie Harness lokal über den offiziellen npm-Befehl – Node.js muss dafür vorher installiert sein:
npx @deepseek-ai/dsh web
# Öffnet standardmäßig die lokale Web-UI: http://127.0.0.1:3080
Sobald die Oberfläche geladen ist, klicken Sie der Reihe nach auf Einstellungen → Modelle → Modell-Provider hinzufügen → Benutzerdefinierte Modell-API. Danach erscheint das Formular für die Provider-Konfiguration. Die offizielle Desktop-Version gibt es als Installationspaket für macOS Apple Silicon und Windows 64-Bit – der Konfigurationspfad ist in beiden Fällen identisch.
2.2 Anbieterinformationen für DeepSeek Harness ausfüllen
| Einstellung | Zweck | Ausfüllhinweis |
|---|---|---|
| Provider ID | Eindeutige Kennung des Anbieters | Muss kleingeschrieben sein; nach dem Erstellen kann die ID nicht umbenannt werden, z. B. apiyi |
| Anzeigename | Name, der im Modellmenü angezeigt wird | Kann als „APIYI OpenAI-kompatibel“ angegeben werden |
| API-Protokoll | Format von Anfrage und Antwort | Muss zur Base URL passen, siehe 2.3 |
| Base URL | Adresse des API-Dienstes | Versionspräfix beachten, siehe 2.4 |
| API-Schlüssel | Anmeldeinformationen zur Authentifizierung | Wird in einer Zugangsdatendatei gespeichert; die Oberfläche zeigt nur eine maskierte Vorschau |
| Model ID | Name des tatsächlich aufgerufenen Modells | Muss exakt mit der Modellliste des Gateways übereinstimmen |
| Kontextfenster / Max. Ausgabetokens | Kontext- und maximale Ausgabelänge | Entsprechend den tatsächlichen Modellspezifikationen eintragen |
| Eingabetyp | Text- oder Bildeingabe | Bilder nur bei Vision-Modellen aktivieren |
| Reasoning Effort | Denkstufe und Parameterzuordnung | Nur die vom Modell tatsächlich unterstützten Stufen hinzufügen |
Die Provider ID kann nicht umbenannt werden, weil Modellkonfigurationen, frühere Sitzungen und Verweise auf Zugangsdaten alle auf diese ID zeigen. Wenn Sie sie ersetzen müssen, erstellen Sie zuerst einen neuen Anbieter und löschen dann den alten.
Die Schaltfläche „Verfügbare Modelle abrufen“ im Formular versucht, die Modellliste vom Gateway zu lesen. Wenn das Gateway keine standardisierte Modellliste bereitstellt oder das zurückgegebene Format von Harness nicht erkannt wird, können Sie die Model ID einfach manuell hinzufügen; das Ergebnis ist dasselbe.
2.3 Das API-Protokoll für den DeepSeek-Harness auswählen
Die API für benutzerdefinierte Modelle im Harness unterstützt vier Protokolle: OpenAI Chat Completions, OpenAI Responses, Anthropic Messages und die Gemini API. Ein Anbieter kann jeweils nur an ein Protokoll gebunden werden. Wenn ein Gateway also Zugänge für drei Protokolle bereitstellt, müssen drei Anbieter angelegt werden.
Die Wahl des Protokolls richtet sich nach der Modellfamilie. Bei GPT, DeepSeek und den meisten chinesischen Modellen ist OpenAI Chat Completions die sicherste Option; für die Claude-Reihe bietet sich Anthropic Messages an, um die nativen Eigenschaften zu erhalten; die Gemini-Reihe nutzt die Gemini API. Das Responses-Protokoll eignet sich für Szenarien, die strukturierte Antworten und Tool-Aufrufe erfordern – vorausgesetzt, das Gateway und das Zielmodell unterstützen diese Schnittstelle.
2.4 DeepSeek-Harness-Instanz mit APIYI konfigurieren
Die offizielle Zuordnung zwischen Protokoll und Base-URL bei APIYI sieht folgendermaßen aus:
| Protokoll | APIYI Base-URL | Passende Modelle | Verfügbare Plattformen |
|---|---|---|---|
| OpenAI-kompatibel (Chat Completions) | https://api.apiyi.com/v1 |
GPT, DeepSeek und weitere | APIYI apiyi.com, offizielle APIs der Anbieter |
| Anthropic nativ | https://api.apiyi.com |
Claude-Serie | APIYI, Anthropic offiziell |
| Gemini | https://api.apiyi.com/v1beta |
Gemini-Serie | APIYI, Google offiziell |
Beim Anthropic-Protokoll wird die Root-Domain verwendet, der Adapter hängt die weiteren Pfadteile selbst an. Wenn man hinter der Root-Domain zusätzlich /v1 schreibt, kann es zu doppelten Pfaden und damit zu einem 404 kommen. Wie das Responses-Protokoll angebunden wird, sollte man zunächst in der APIYI-Dokumentation zur Responses API nachsehen und die Angaben erst dann eintragen.
Neben der Konfiguration über die Oberfläche unterstützt Harness auch das manuelle Bearbeiten der Konfigurationsdatei unter $DSH_HOME/profiles/web/cordis.patch.yml. Unten ein Vorlage für den APIYI-OpenAI-kompatiblen Provider, aufgebaut nach der offiziellen Konfigurationsstruktur:
- id: llm-pi-ai
  config:
    providers:
      apiyi:
        apiKeyEnv: APIYI_API_KEY          # Schlüssel aus der Umgebungsvariable lesen
        api: openai-completions           # OpenAI Chat-Completions-Protokoll
        baseURL: https://api.apiyi.com/v1 # APIYI OpenAI-kompatibler Einstiegspunkt
        models:
          - id: MODEL_ID_FROM_APIYI       # durch die tatsächlich im Konto verfügbare Modell-ID ersetzen
So geht man vor:
- Umgebungsvariable
APIYI_API_KEYsetzen; MODEL_ID_FROM_APIYIdurch den tatsächlich in der APIYI-Konsole verfügbaren Modellnamen ersetzen;- Konfiguration speichern und im Harness-Modellauswähler den Provider
apiyisamt passendem Modell wählen; - Eine einfache Unterhaltung starten, um zu prüfen, ob die Schnittstelle korrekt funktioniert.
Die Vorlage zeigt die offizielle Konfigurationsstruktur; für Modellnamen gilt die Liste, die im eigenen Konto tatsächlich aufrufbar ist. Änderungen an der Modellkonfiguration greifen in der Regel erst bei der nächsten Anfrage, ein Neustart der Web-UI ist nicht nötig. Die Konfiguration über die Oberfläche eignet sich für das alltägliche Hinzufügen von Modellen und das Ändern von Schlüsseln, die Konfigurationsdatei für fortgeschrittene Einstellungen wie Kompatibilitätsparameter, Inferenzmodus, Timeouts und Wiederholversuche.
Bevor man Harness anbindet, empfiehlt es sich, Key und Model ID zunächst mit einem separaten Skript zu prüfen. So lassen sich die beiden Fragen „Gateway funktioniert“ und „Harness ist korrekt konfiguriert“ getrennt voneinander eingrenzen:
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["APIYI_API_KEY"],
    base_url="https://api.apiyi.com/v1"  # APIYI apiyi.com OpenAI-kompatibler Einstiegspunkt
)

resp = client.chat.completions.create(
    model="MODEL_ID_FROM_APIYI",  # muss mit der in Harness eingetragenen Model ID übereinstimmen
    messages=[{"role": "user", "content": "Stell dich in einem Satz vor"}],
    max_tokens=100
)
print(resp.choices[0].message.content)
🚀 Tipp für den schnellen Einstieg: Neue Nutzer können sich bei APIYI apiyi.com registrieren und ein kostenloses Testguthaben erhalten. Prüft zuerst mit dem obigen Skript, ob die Model ID funktioniert, und tragt sie dann in die Harness-Konfiguration ein – das verkürzt die Fehlersuche insgesamt deutlich.
3 DeepSeek Harness: Schnittstelle erreichbar – warum der Modellaufruf trotzdem fehlschlägt
Die offizielle Harness-Dokumentation weist ausdrücklich darauf hin: Auch wenn API-Adresse und API-Schlüssel korrekt sind, kann das Gateway Anfragen weiterhin ablehnen. Der Grund dafür ist, dass verschiedene kompatible Schnittstellen unterschiedliche Anforderungen an Nachrichtenrollen, Ausgabelänge und Reasoning-Parameter stellen. Die folgenden drei compat-Parameter beheben solche Probleme und sollten je nach dem tatsächlich von der Schnittstelle zurückgegebenen Fehler bei Bedarf aktiviert werden.
3.1 Kompatibilität mit der Developer-Rolle
Die neue OpenAI-Spezifikation führt role: developer ein, einige kompatible Gateways akzeptieren jedoch nur system. Wenn „alle Anfragen fehlschlagen“ oder „nur Reasoning-Modelle fehlschlagen“, können Sie die Developer-Rolle deaktivieren:
compat:
  supportsDeveloperRole: false
Nach dem Aktivieren dieser Option passt der Adapter die Rollenbehandlung in der Anfrage an, sodass die Anfrage dem vom Gateway akzeptierten Format entspricht.
3.2 Kompatibilität der maximalen Ausgabeparameter
Die neuen OpenAI-Schnittstellen verwenden max_completion_tokens, um die maximale Ausgabe anzugeben, während einige Gateways nur das traditionelle max_tokens akzeptieren. Beide bedeuten dasselbe, aber ein abweichender Feldname führt zu einem Fehler bei der Parameterprüfung. Die entsprechende Einstellung lautet:
compat:
  maxTokensField: max_tokens
3.3 Kompatibilität des DeepSeek-Denkmodus
Einige DeepSeek-Modelle aktivieren den Denkmodus standardmäßig. Wenn in Harness die Inferenzstufe auf off gesetzt wird, lassen einige kompatible Protokolle lediglich die Inferenzparameter weg, und das Modell denkt gemäß dem Standardverhalten weiter – das führt dazu, dass sich „off“ nicht abschalten lässt. Offiziell wird dafür ein spezielles Denkformat für DeepSeek bereitgestellt:
compat:
  thinkingFormat: deepseek
Nach der Aktivierung sendet der Adapter beim Deaktivieren des Denkens explizit {"thinking": {"type": "disabled"}} und beim Aktivieren {"thinking": {"type": "enabled"}}. Das offizielle Beispiel bezieht sich auf das DeepSeek-V4-Modell hinter einem OpenAI-kompatiblen Gateway. In einem Multi-Modell-Gateway kann dieser Parameter nur für DeepSeek-Modelle separat gesetzt werden, während Modelle wie GPT und Claude die Standardeinstellungen beibehalten.
Bei den Inferenzstufen erlaubt Harness, die in der Benutzeroberfläche angezeigten Werte off, low, medium, high und max auf die von der API tatsächlich akzeptierten Parameterwerte abzubilden. Wenn nur die vom Modell tatsächlich unterstützten Stufen in die Konfiguration aufgenommen werden, lässt sich vermeiden, dass Anfragen fehlschlagen, nachdem Benutzer eine ungültige Stufe ausgewählt haben. Ein vollständiges Beispiel mit den drei kombinierten Kompatibilitätsparametern sieht so aus:
- id: llm-pi-ai
  config:
    providers:
      apiyi:
        apiKeyEnv: APIYI_API_KEY
        api: openai-completions
        baseURL: https://api.apiyi.com/v1
        compat:
          supportsDeveloperRole: false
          maxTokensField: max_tokens
        models:
          - id: MODEL_ID_FROM_APIYI
3.4 Häufige Fehler im DeepSeek Harness schnell beheben
| Fehler oder Symptom | Mögliche Ursache | Vorgehen |
|---|---|---|
| MISSING_CREDENTIAL | Schlüssel nicht konfiguriert | API-Schlüssel und Namen der Umgebungsvariablen prüfen |
| UNKNOWN_MODEL | Modell-ID nicht registriert | Unter dem Anbieter die korrekte Modell-ID hinzufügen |
| HTTP 401 | Schlüssel ungültig oder Rechte unzureichend | Schlüsselinhalt und zugehörige Gruppe prüfen |
| HTTP 404 | Falscher Pfad der Base URL | Protokoll und Versionspräfix prüfen (/v1, Root-Domain, /v1beta) |
| Modellliste leer | Gateway unterstützt die standardmäßige Modelllisten-API nicht | Modell-ID manuell hinzufügen |
| Alle Anfragen schlagen fehl | Rollen- oder Parameterformatkonflikt | Kompatibilitätsparameter in compat prüfen |
| Nur Reasoning-Modelle schlagen fehl | Developer-Rolle nicht kompatibel | supportsDeveloperRole: false setzen |
| „off“ deaktiviert das Denken nicht | Modell hat Denken standardmäßig aktiviert | thinkingFormat: deepseek setzen |
| Such-API gibt 503 zurück | Token-Gruppe hat keine Tool-Berechtigung | Auf Token der Gruppe default oder svip wechseln |
| Chat funktioniert, Internetzugriff nicht verfügbar | Suchwerkzeug nicht integriert oder Protokoll nicht unterstützt | Tool-Funktionen und Client-Konfiguration prüfen |
Die ersten acht Punkte stammen aus der offiziellen Konfigurationsdokumentation von Harness, die Fragen zu Gruppen aus der offiziellen APIYI-Dokumentation. Für die Fehlersuche wird die Reihenfolge von oben nach unten empfohlen: zuerst die Anmeldedaten prüfen, dann die Modell-ID, danach den Pfad und erst zuletzt die Parameterkompatibilität.
4 Websuche-Fähigkeit für DeepSeek Harness ergänzen
4.1 Integrierte Modellsuche und separate Such-API unterscheiden
Ein erfolgreicher normaler Chat-Aufruf belegt nur, dass der API-Schlüssel gültig ist, die Modell-ID stimmt und das Dialogprotokoll grundsätzlich kompatibel ist. Für die Websuche-Fähigkeit muss zusätzlich das Modell die entsprechenden Tools unterstützen, die Anfrage die Tools korrekt deklarieren, der API-Dienst das Tool-Protokoll unterstützen und Harness die Tool-Antworten verarbeiten können – oder der Entwickler integriert die Suche separat auf Anwendungsseite. Ein erfolgreicher Chat und eine erfolgreiche Websuche sind daher zwei unabhängige Validierungsschritte.
Im DeepSeek-Ökosystem gibt es zwei technische Wege für die Websuche-Fähigkeit:
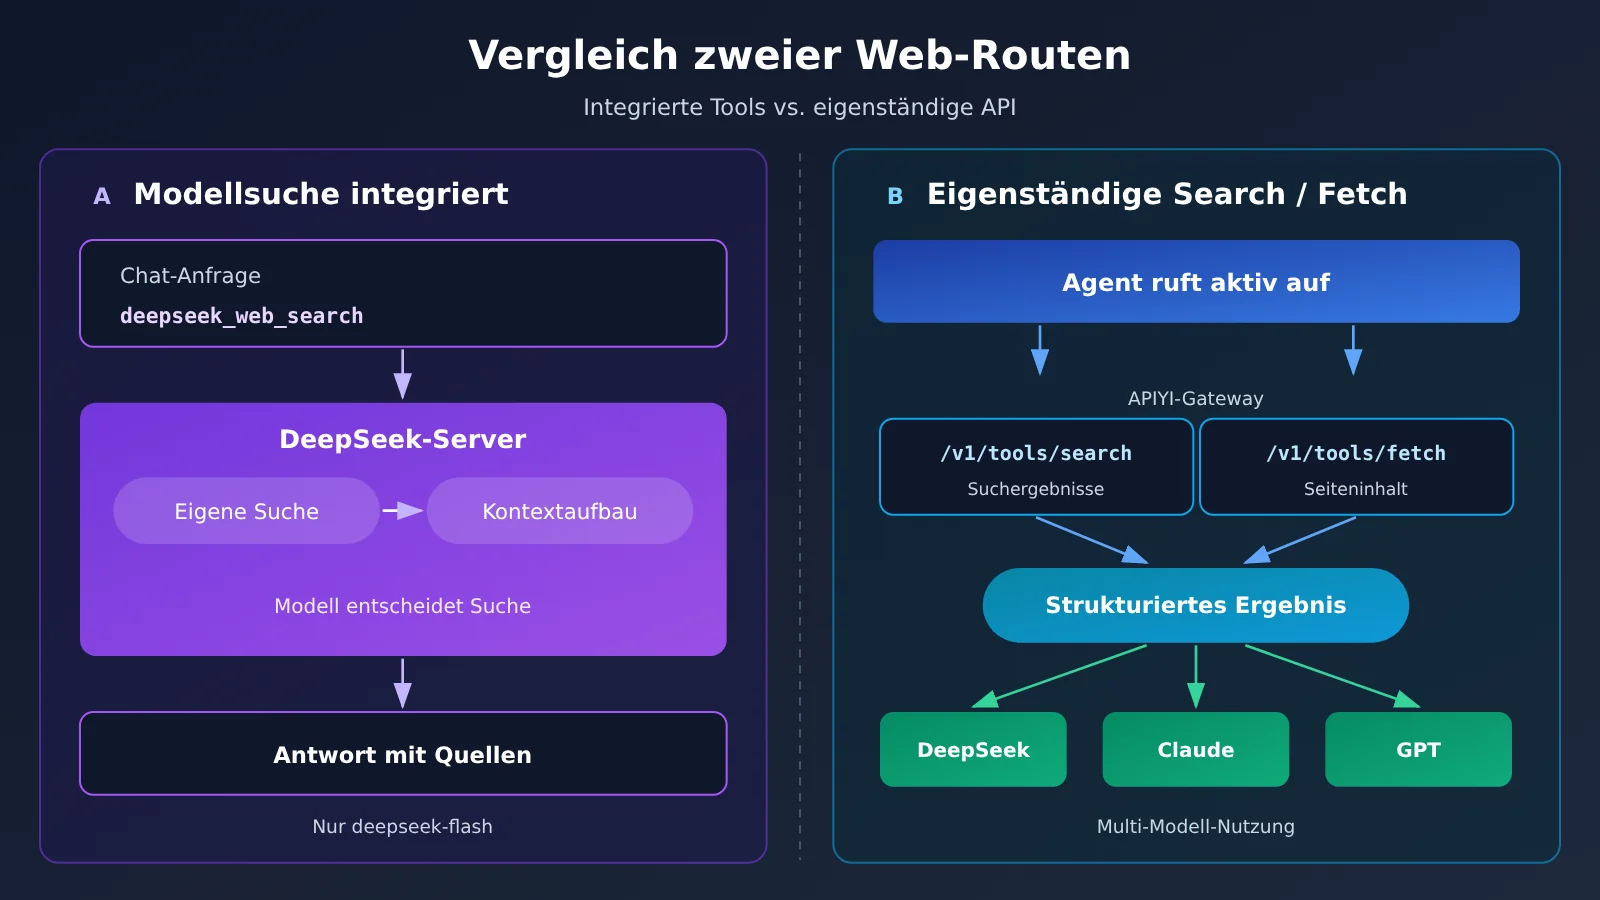
| Dimension | Route A: In das Modell integrierte serverseitige Tools | Route B: Unabhängige Search-/Fetch-API |
|---|---|---|
| Aufrufart | Im Dialogrequest deepseek_web_search, deepseek_read_url deklarieren |
Programm ruft aktiv /v1/tools/search, /v1/tools/fetch auf |
| Wer die Suche auslöst | Modell entscheidet selbstständig | Entwickler oder Agent-Tool-Logik |
| Tool-Ausführung | DeepSeek-Server führt Suche und Kontextzusammensetzung aus | Client verarbeitet Ergebnisse selbst |
| Modellabdeckung | Offizielle Ankündigung nennt ausdrücklich deepseek-flash |
Modellunabhängig, beliebige Modelle können Ergebnisse wiederverwenden |
| Abrechnungsgrundlage | Nach tatsächlicher Anzahl Suchbegriffe, abgerufener Webseiten usw. | Nach erfolgreichen Anfragen, verbraucht keine Modell-Tokens |
| Derzeit verfügbare Kanäle | Offizielle DeepSeek-API | Offizielle DeepSeek-API, APIYI |
4.2 Wie die integrierte Suche des Modells funktioniert
Am 13. November 2026 hat DeepSeek mehrere Anwendungsfunktionen freigegeben, die hinter der App stecken – darunter die Websuche und das Lesen von Links, die als serverseitige Tools bereitgestellt werden. Es genügt, sie in der Tool-Liste der Anfrage zu deklarieren:
[
  {"type": "deepseek_web_search", "name": "deepseek_web_search"},
  {"type": "deepseek_read_url", "name": "deepseek_read_url"}
]
Nach der Deklaration entscheidet das Modell selbst, ob eine Internetverbindung nötig ist, und formuliert die Suchbegriffe. Der DeepSeek-Server führt die Suche aus und liefert eine Antwort mit Quellenangaben zurück. Ist der Denkmodus aktiviert, wird die Suche zu einem mehrstufigen Ablauf: Das Modell kann mehrere Schlüsselwörter suchen, Webseiten öffnen, innerhalb einer Seite nachschlagen und die Ergebnisse gegeneinander abgleichen. Laut offizieller Dokumentation antwortet es nach bis zu etwa 20 Tool-Aufrufen. deepseek_read_url erkennt ausschließlich URLs in der letzten Benutzernachricht und berücksichtigt maximal 10 verschiedene Links.
Entwickler müssen weiterhin die zurückgegebenen Inhaltsblöcke, die Zitationsinformationen, die Streaming-Ereignisse und den Gesprächsverlauf über mehrere Runden verarbeiten. Laut offizieller Ankündigung wird diese vollständige Tool-Integration auf Konversationsebene von deepseek-flash (DeepSeek-V4.1-Flash) getragen. Der Dokumentation von APIYI zufolge ist die kompatible Nutzung solcher integrierten Suchen über ein Gateway mit Clients wie Harness oder Claude Code noch in Planung. Wer derzeit Weg A verwenden möchte, sollte sich direkt mit der offiziellen DeepSeek-API verbinden.
4.3 Eigenständige Search-/Fetch-Integration über APIYI
APIYI hat am 21. Oktober 2026 eigenständige Tool-Schnittstellen für DeepSeek Search & Fetch freigeschaltet, entsprechend deepseek-search und deepseek-fetch. Search liefert strukturierte Suchergebnisse zurück, Fetch ruft eine angegebene Webseite ab und gibt den Markdown-Textkörper zurück. Bei der Anfrage muss keine Modell-ID übergeben werden, es werden auch keine Modell-Tokens verbraucht; abgerechnet wird nach erfolgreichen Aufrufen.
Das folgende Beispiel sucht zuerst und ruft anschließend die Webseite auf Platz eins ab:
import os
import requests

BASE = "https://api.apiyi.com/v1/tools"  # Eigenständige Tool-Schnittstelle von APIYI
headers = {"Authorization": f"Bearer {os.environ['APIYI_API_KEY']}"}

search = requests.post(
    f"{BASE}/search",
    headers=headers,
    json={"query": "DeepSeek Harness Plugins", "count": 5},
    timeout=60,
)
search.raise_for_status()
results = search.json()["results"]

if results:
    url = results[0]["url"]
    fetch = requests.post(
        f"{BASE}/fetch",
        headers=headers,
        json={"url": url},
        timeout=60,
    )
    if fetch.ok:
        print(fetch.json()["content"])
Besondere Beachtung verdienen die Token-Gruppen: Die Gruppen default und svip können diese beiden Schnittstellen aufrufen, Tokens der Gruppe ClaudeCode können sie nicht direkt nutzen – in der Dokumentation ist ein Fall mit Rückgabe 503 festgehalten. Die Selbsttests in der APIYI-Dokumentation zeigen, dass Search fünf Ergebnisse in etwa 1,8 Sekunden zurückliefert und 20 parallele Anfragen alle mit 200 antworten; Fetch gibt bei nicht erreichbaren Seiten einen Fehler zurück und berechnet nichts. Diese Zahlen stammen aus den Tests der Plattform selbst, das tatsächliche Verhalten hängt vom Netzwerk und der Zielseite ab. Zum Preis: Die Dokumentation nennt 0,90 US-Dollar pro 1000 Aufrufe als Plattformpreis; mit dem Auflade-Bonus liegt der effektiv gezahlte Betrag darunter – maßgeblich ist die Konsole.
Damit ein Agent im Harness diese Logik selbstständig nutzen kann, muss man sie als Tool-Plugin kapseln. Harness-Plugins werden in TypeScript geschrieben und registrieren Tools über das Kontextobjekt ctx; beim Entladen des Plugins räumt das Framework die registrierten Tools und Events automatisch auf. Beim Kapseln empfiehlt es sich, search und fetch als zwei getrennte Tools zu registrieren, damit das Modell zuerst die Ergebnisliste erhält und dann entscheidet, welche Seiten es abrufen will.
💡 Technischer Hinweis: Eigenständige Search/Fetch sind vom Modell entkoppelt – dieselben Suchergebnisse lassen sich verschiedenen Modellen wie GPT, Claude oder DeepSeek zur Weiterverarbeitung übergeben. Über APIYI apiyi.com verwalten Sie Modellaufrufe und Suchtools mit einem einzigen Key gemeinsam, was im Harness den Vergleich der Antwortqualität verschiedener Modelle auf Basis derselben Materialien erleichtert.
5 Wie ein Multi-Modell-Agent im DeepSeek Harness gestaltet werden sollte
5.1 Unterschiedliche Modelle je nach Aufgabe wählen
Der Wert der Multi-Modell-Integration liegt darin, Modelle aufgabenbezogen zuzuweisen. Ein Programmier-Agent kann ein Modell erhalten, das auf Code spezialisiert ist. Für häufige Aufgaben wie Dokumentenorganisation oder das Überarbeiten von Zusammenfassungen eignen sich kostengünstigere Modelle. Für Screenshot-Analyse und Diagrammverständnis ist dagegen ein Vision-Modell erforderlich, das Bildeingaben unterstützt; in Input Type muss dafür die Bildoption aktiviert werden.
Am Beispiel der offiziellen DeepSeek-Modelle: DeepSeek-V4.1-Flash unterstützt Bildverständnis, DeepSeek-V4-Pro nicht – und auch die Preise unterscheiden sich um ein Mehrfaches. Konfiguriert man sie im Harness als zwei Model IDs unter demselben Anbieter und wechselt je nach Aufgabe in der Sitzung zwischen ihnen, lassen sich Qualität und Kosten in Einklang bringen.
5.2 Modellaufrufe und Suchfunktionen im DeepSeek Harness schichtenweise verwalten
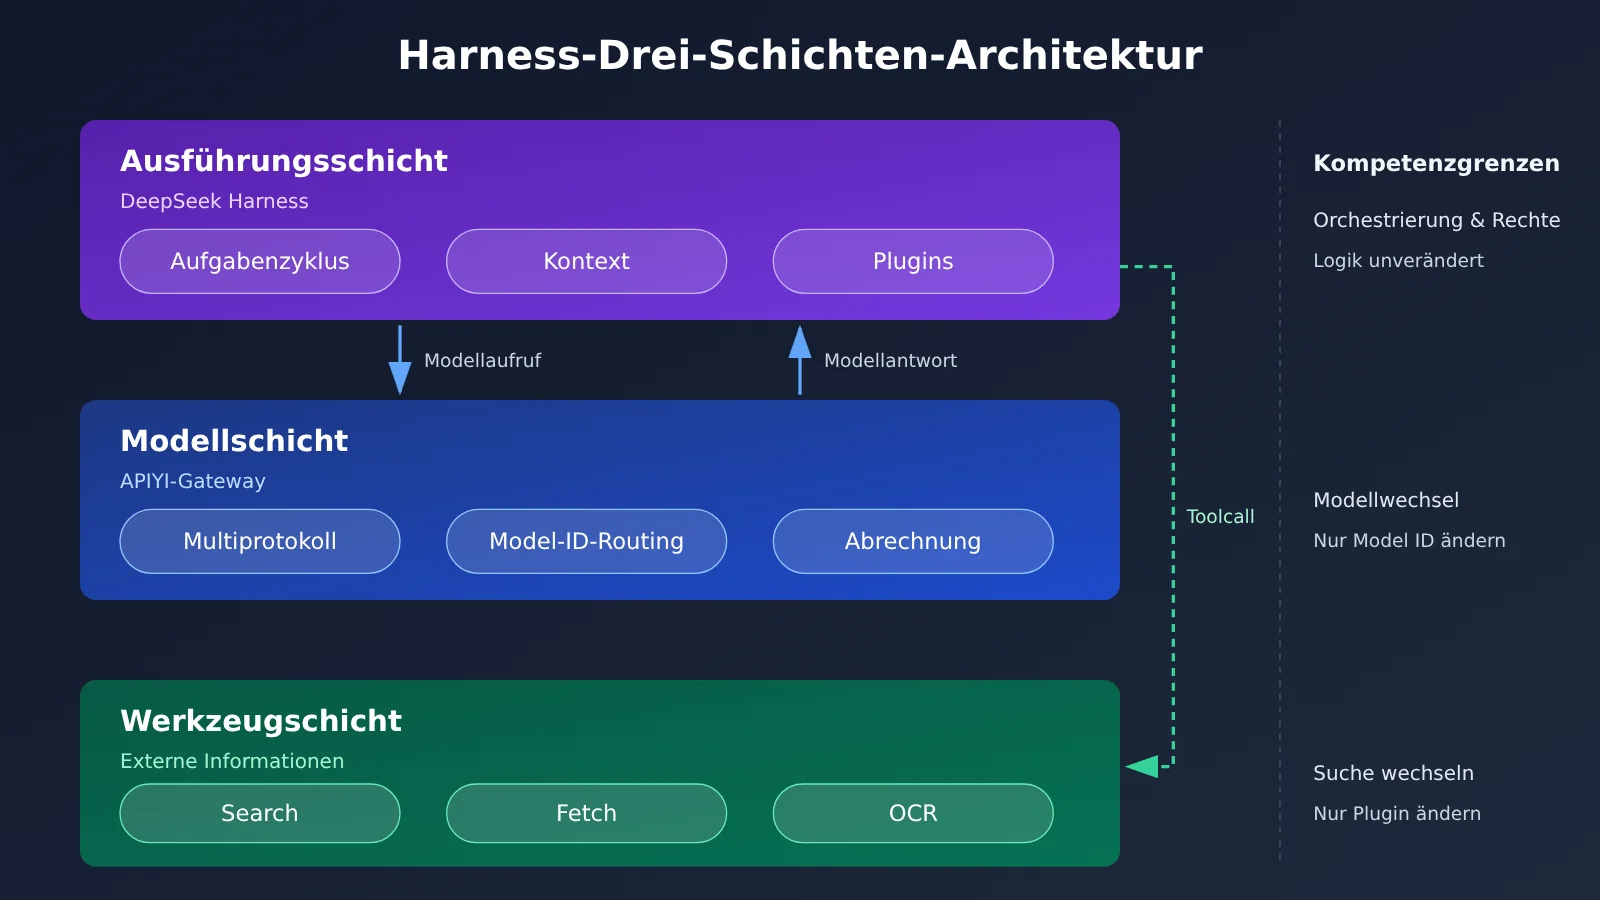
Empfohlen wird eine dreischichtige Struktur. Die Ausführungsschicht liegt beim Harness und umfasst Aufgabenschleife, Kontextkomprimierung, Plugin-Laden und Berechtigungskontrolle. Die Modellschicht wird von einem API-Gateway übernommen, das Protokollkonvertierung, Modell-Routing und Abrechnung regelt. Die Werkzeugschicht bezieht externe Informationen über separate Schnittstellen wie Search / Fetch. Jede der drei Schichten ist austauschbar: Ein Modellwechsel ändert nur die Model ID, ein Wechsel des Suchdienstes nur das Werkzeug-Plugin – die Ausführungslogik bleibt unverändert.
Die Schichtung bringt auch Sicherheitsvorteile. Eine kontrollierte Evaluierung des Harness durch das Tencent Zhuque Lab ergab, dass nicht vertrauenswürdige Inhalte wie Webseiten, Dateien und Skills das Verhalten des Agenten durch indirekte Eingabeaufforderungs-Injection (Prompt-Injection) beeinflussen können. Sind Werkzeug- und Ausführungsschicht getrennt, lässt sich ein einheitlicher Filter- und Bestätigungsschritt einfügen, bevor Suchergebnisse in den Kontext gelangen oder sensible Werkzeuge ausgeführt werden.
5.3 Praktische Empfehlungen für den Einsatz des DeepSeek Harness
- Modellkonfiguration: Ein Protokoll entspricht einem Anbieter. Die Provider ID in Kleinbuchstaben festlegen und danach nicht mehr ändern; Model IDs grundsätzlich aus der Gateway-Konsole kopieren.
- Schlüsselverwaltung: Der Harness speichert Schlüssel in
$DSH_HOME/.credentials.yaml. Die Konfigurationsdatei referenziert nur Umgebungsvariablen, damit keine Klartext-Keys in gemeinsam genutzte Konfigurationen oder Code-Repositories gelangen. - Kompatibilitätstests: Bei jedem neu angebundenen Modell nacheinander normale Unterhaltung, deaktivierten Denkmodus, lange Ausgaben und Bildeingabe prüfen und erst bei Bedarf, abhängig von der Fehlermeldung, den Parameter
compataktivieren. - Werkzeugaufrufe: Die Anzahl der Plugins begrenzen. Rückmeldungen aus der Community zeigen, dass nach der Installation von mehr als einem Dutzend Plugins Kontextüberläufe und ein erhöhter Token-Verbrauch auftreten können. Suchwerkzeuge bleiben stabiler, wenn ihre Beschreibungen knapp sind.
- Kostenerfassung: Modell-Tokens und Werkzeugaufrufe werden getrennt abgerechnet; es empfiehlt sich, sie im Gateway-Backend getrennt zu erfassen. In der APIYI-Konsole unter apiyi.com lässt sich die Nutzung pro Key einsehen. So können verschiedenen Agenten eigene Keys zugewiesen und Kosten eindeutig zugeordnet werden.
Außerdem sollten Sie vor einem Upgrade des Harness die Konfiguration unter $DSH_HOME sichern. In der Community wurde ein Fall dokumentiert, bei dem nach einem Versionsupgrade die Konfiguration von Drittanbieter-Plugins verloren ging und die Wiederherstellung mehrere Stunden dauerte.
Häufig gestellte Fragen (FAQ)
F1: Kann DeepSeek Harness nur DeepSeek-Modelle verwenden?
Harness unterstützt über eine benutzerdefinierte Modell-API die Anbindung beliebiger Dienste, die mit einem der vier Protokolle kompatibel sind – darunter OpenAI, Claude, Gemini sowie verschiedene API-Gateways und selbst gehostete Modellservices. Die offiziellen DeepSeek-Modelle sind dabei nur eine von mehreren Optionen.
F2: Warum muss ich für dasselbe Gateway mehrere Anbieter erstellen?
Harness legt fest, dass ein Anbieter jeweils nur an ein Protokoll gebunden ist. APIYI bietet gleichzeitig drei Zugänge: OpenAI-kompatibel, Anthropic und Gemini. Wenn Sie GPT, Claude und Gemini jeweils über ihre nativen Protokolle aufrufen möchten, müssen Sie drei Anbieter anlegen; die Base-URLs lauten dann `/v1`, Root-Domain und `/v1beta`.
F3: Wie finde ich heraus, welche Modell-ID ich eintragen muss?
Probieren Sie zuerst die Funktion „Verfügbare Modelle abrufen“ aus. Wenn darüber keine Modelle gelesen werden können, kopieren Sie den exakten Namen aus der Modellliste in der APIYI-Konsole unter apiyi.com und fügen ihn manuell hinzu. Modell-IDs unterscheiden sich in Groß-/Kleinschreibung und Versionssuffix; jede Abweichung löst UNKNOWN_MODEL oder einen Gateway-Fehler aus.
F4: Kann ich deepseek_web_search direkt nutzen, wenn ich über APIYI angebunden bin?
Derzeit unterstützt APIYI die eigenständigen Search-/Fetch-Schnittstellen von DeepSeek. Die Kompatibilität für den Aufruf der in das Modell integrierten Suche über Clients wie Harness ist jedoch noch in Planung. Aktuell empfiehlt es sich, `/v1/tools/search` und `/v1/tools/fetch` von APIYI als Agent-Tools zu kapseln. Wenn Sie die integrierte Suche benötigen, verbinden Sie sich direkt mit der offiziellen DeepSeek-API.
F5: Warum liefert die Suchschnittstelle 503 zurück, während der Chat einwandfrei funktioniert?
Die häufigste Ursache ist die Token-Gruppe. Tokens der Gruppe ClaudeCode können eigenständige Tool-Schnittstellen nicht direkt aufrufen. Verwenden Sie stattdessen einen Key aus der Gruppe default oder svip. Im APIYI-Backend unter apiyi.com können Sie für das Suchtool einen eigenen Token in der passenden Gruppe anlegen und getrennt vom Key für Modellaufrufe verwalten.
F6: Welche Einschränkungen gibt es bei der Multi-Modell-Anbindung von DeepSeek Harness?
Harness ist noch eine Developer Preview, die Konfigurationsstruktur kann sich mit Versionen ändern. Die einzelnen Gateways reichen Responses, Inferenzparameter und Tool-Protokolle unterschiedlich stark durch, was für jedes Modell separat geprüft werden muss. Zu viele Plugins treiben die Kontext- und Token-Kosten in die Höhe, und die Ergebnisqualität bei komplexen Aufgaben hängt auch von der Plugin-Konfiguration und der Steuerung des Ausführungsprozesses ab.
Zusammenfassung
Der offene Modell-Adaptermechanismus von DeepSeek Harness ermöglicht es einem Agent-Framework, über ein einheitliches Gateway Modelle mehrerer Anbieter aufzurufen. Bei der Umsetzung sollten Sie folgende Punkte beachten:
- Das Protokoll bestimmt den Anbieter: Für jedes Protokoll einen Provider anlegen; der Versionspräfix der Base URL muss strikt zum Protokoll passen.
- Modell-ID aus dem Gateway übernehmen: Aus der Konsole kopieren; wenn sich die Liste nicht auslesen lässt, manuell hinzufügen.
- Kompatibilitätsparameter nach Bedarf aktivieren: Die drei Optionen developer-Rolle,
max_tokens-Feld und DeepSeek-Thinking-Format decken die meisten Fälle von „Verbindung klappt, Nutzung nicht“ ab. - Netzwerkfunktionen separat planen: Die integrierte Suche läuft über die offizielle DeepSeek-API; eigenständige Search-/Fetch-Aufrufe können über das Gateway laufen und als Tools gekapselt werden.
- Schichtung und Governance: Ausführungsebene, Modellebene und Tool-Ebene trennen; Schlüssel, Versionen und Kosten getrennt verwalten.
Empfehlung: Zunächst mit einem Modell den Ablauf „Skriptvalidierung → Harness-Konfiguration → einfache Konversation“ durchspielen und dann schrittweise weitere Modelle und Suchtools ergänzen. Am besten holen Sie sich über APIYI apiyi.com ein kostenloses Testkontingent und validieren mit einem einzigen API-Schlüssel mehrere Modelle sowie Search/Fetch im Gesamtdurchlauf.
📚 Referenzen
- DeepSeek Harness – Dokumentation zur Modellkonfiguration: Felder für benutzerdefinierte Provider und compat-Kompatibilitätsparameter
- Link:
deepseek-harness.github.io/deepseek-harness/guide/providers -
Beschreibung: Offizielle Erläuterungen zu supportsDeveloperRole, maxTokensField und thinkingFormat
-
DeepSeek Harness GitHub-Repository: Quellcode, Releases und Startoptionen
- Link:
github.com/deepseek-ai/deepseek-harness -
Beschreibung: Hinweise zu Versionsupdates und zur Developer-Preview-Phase
-
DeepSeek-Dokumentation zu den Netzwerk-Tools: deepseek_web_search und deepseek_read_url
- Link:
api-docs.deepseek.com/zh-cn/guides/web_tools/ -
Beschreibung: Deklaration der integrierten Suche, Einschränkungen und Abrechnungsgrundlage
-
APIYI Base-URL-Konfigurationsleitfaden: Erläuterung der drei Protokollpfade
- Link:
help.apiyi.com/apiyi-base-url-v1-claude-gemini-endpoint-config-guide.html -
Beschreibung: Einsatzszenarien für
/v1, Root-Domain und/v1beta -
APIYI-Dokumentation zu DeepSeek Search & Fetch: Schnittstellen für eigenständige Tools und Gruppierungsanforderungen
- Link:
docs.apiyi.com/api-capabilities/deepseek-search-fetch/overview - Beschreibung: Request-Parameter, Token-Gruppierung und Abrechnungshinweise
Autor: APIYI-Team
Technischer Austausch: Bei Problemen während der Konfiguration kontaktieren Sie uns gern über die Startseite von APIYI apiyi.com; weitere Schnittstellenbeschreibungen finden Sie im Dokumentationszentrum unter docs.apiyi.com