Anmerkung des Autors: Wer Modellkosten nur anhand des Preises pro Million Token vergleicht, trifft leicht die falsche Wahl. Dieser Artikel stellt einen Berechnungsansatz vor: „Preis pro Token × tatsächlicher Token-Verbrauch“. Außerdem zeigt er Schritt für Schritt, wie du die Ergebnisse mit einer kleinen Stichprobe eigener Aufgaben überprüfst.
Viele Teams schauen bei der Modellauswahl zuerst auf die Preisliste. Wenn Modell A pro Million Token nur ein paar Zehntel Yuan kostet und Modell B mehrere Dollar, halten sie A für günstiger. Doch die Monatsrechnung entspricht oft nicht den Erwartungen: Manchmal verursacht das „günstige“ Modell sogar höhere Kosten. Dieser Artikel erklärt die Berechnung der tatsächlichen Kosten anhand von „Preis pro Token × tatsächlicher Token-Verbrauch, unter Berücksichtigung des Caches“. So kannst du schon bei der Modellauswahl die Kosten realistisch einschätzen.
Dies ist keine weitere Übersicht von Preislisten. Preise ändern sich, die Berechnungsmethode bleibt. Wir leiten aus öffentlich zugänglichen Einzelbeispielen einen allgemeinen Ansatz ab und zeigen, wie du ihn mit deinen eigenen Aufgaben überprüfst.
Das bringt dir der Artikel: Du kannst erklären, warum ein niedriger Listenpreis nicht automatisch eine niedrige Rechnung bedeutet. Außerdem kannst du mit 20 bis 50 echten Anfragen die Kosten pro Aufgabe für jedes Modell auf deiner Auswahlliste ermitteln.
Die wichtigsten Punkte zu den tatsächlichen Modellkosten
| Punkt | Erklärung | Einfluss auf die Modellauswahl |
|---|---|---|
| Der Stückpreis ist nur ein Faktor | Rechnung = Anzahl der Token je Kategorie × jeweiliger Stückpreis, anschließend aufsummiert | Wer nur den Stückpreis vergleicht, betrachtet nur die halbe Formel |
| Unterschiede bei der Tokenisierung | Derselbe Text wird von verschiedenen Modellen in unterschiedlich viele Token zerlegt | Die Eingabekosten müssen anhand der tatsächlichen Tokenzahl jedes Modells berechnet werden |
| Reasoning-Token | Der Denkprozess von Reasoning-Modellen wird meist als Ausgabe abgerechnet, ist für Nutzer aber nicht sichtbar | Die sichtbare Antwort kann kurz, die Rechnung aber trotzdem hoch sein |
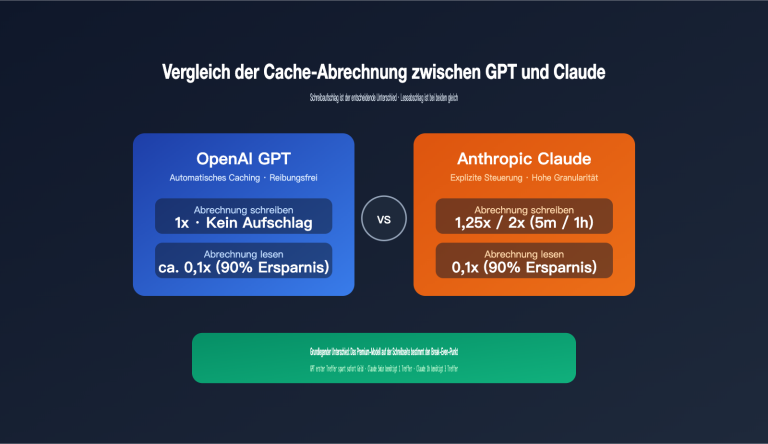
| Cache-Treffer | Wiederholte Präfixe werden bei einem Cache-Treffer zum niedrigeren Cache-Preis abgerechnet | Besonders relevant bei langen System-Eingabeaufforderungen und mehrstufigen Dialogen |
| Erfolgsquote und Wiederholungen | Bei falschen Antworten oder ungeeignetem Format muss der Vorgang erneut ausgeführt werden | Effektive Kosten = Kosten pro Durchlauf ÷ Erfolgsquote |
Warum der Preis pro Million Token allein nicht die tatsächlichen Kosten zeigt
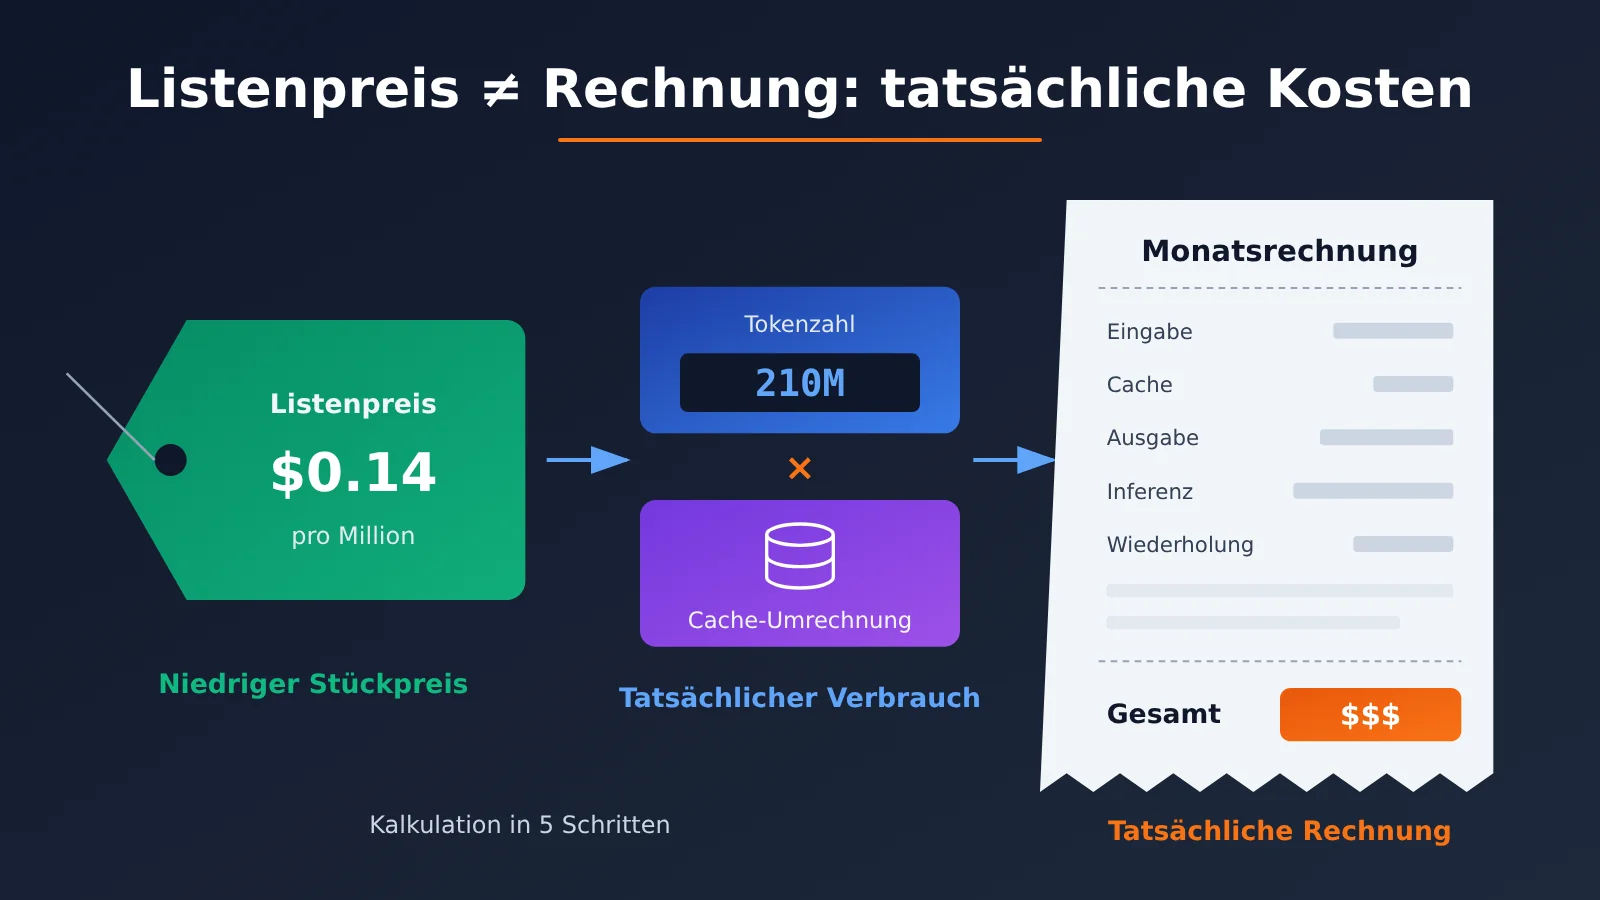
Der Preis pro Million Token sagt aus, was ein einzelnes Token kostet. Auf der Rechnung steht dagegen, was die Erledigung einer Aufgabe kostet. Dazwischen liegt eine entscheidende Variable: wie viele Token dafür benötigt werden. Die Unterschiede zwischen den Modellen sind dabei oft größer als die Preisunterschiede.
Ein typisches Beispiel liefert eine Berechnung aus einem Drittanbieter-Blog vom 1. August 2026: DeepSeek V4 Flash und Gemini 3.6 Flash erreichen bei Artificial Analysis jeweils 50 Punkte. Ersteres kostet laut Preisliste $0.14/M, Letzteres $1.50/M – der Stückpreis unterscheidet sich also etwa um den Faktor 10. Im selben Test verbrauchte Ersteres jedoch rund 210 Millionen Token, Letzteres etwa 59 Millionen. Der Verbrauch war damit mehr als dreimal so hoch. Ein großer Teil des Preisvorteils wurde durch den höheren Verbrauch aufgezehrt; der tatsächliche Kostenunterschied lag weit unter dem Faktor 10.
Ein weiteres Beispiel sind Unterschiede bei der Tokenisierung. In einem Artikel derselben Quelle vom 12. August 2026 wurde ein und dasselbe Dokument von 9 Modellen gezählt. Das Ergebnis lag zwischen 614 und 957 Token – ein Unterschied von rund 56 % zwischen dem niedrigsten und dem höchsten Wert. Selbst wenn zwei Modelle also exakt denselben Eingabepreis haben, können sich die Kosten für dieselbe Eingabeaufforderung um mehr als die Hälfte unterscheiden.
💡 Hinweis zu den Daten: Die Zahlen stammen aus einzelnen Berechnungen eines Drittanbieter-Blogs. Testaufgaben, Modellversionen und Preise sind zeitabhängig. Die Ergebnisse zeigen daher lediglich, dass diese Effekte auftreten können; für Ihre Budgetplanung lassen sie sich nicht direkt übernehmen. Testen Sie Ihre eigenen Aufgaben selbst.
Modellabrechnung: Aus welchen Token-Kategorien setzen sich die tatsächlichen Kosten zusammen?
Um die Kosten genau zu berechnen, muss man zunächst wissen, welche Positionen abgerechnet werden. Bei den meisten Anbietern lässt sich die Abrechnung in die folgenden Kategorien aufteilen. Wie sie genau heißen und ob sie separat berechnet werden, steht in der jeweiligen offiziellen Dokumentation.
| Abrechnungsposition | Bedeutung | Übliche Preisberechnung | Leicht zu übersehen |
|---|---|---|---|
| Eingabe ohne Cache-Treffer | Neu gesendete Eingabeaufforderung, die nicht im Cache liegt | Eingabepreis | Der Tokenizer beeinflusst den Preis: Derselbe Text kann unterschiedlich viel kosten |
| Eingabe mit Cache-Treffer | Präfix, das mit einem früheren Request übereinstimmt | Cache-Lesepreis, meist deutlich niedriger als der Eingabepreis | Das Präfix muss für einen Cache-Treffer vollständig übereinstimmen |
| Cache-Schreibvorgang | Manche Anbieter berechnen das erstmalige Schreiben in den Cache separat | Kann über dem normalen Eingabepreis liegen | Bei niedriger Trefferquote kann es teurer werden |
| Sichtbare Ausgabe | Antwort, die Nutzer am Ende sehen | Ausgabepreis | Der Ausgabepreis ist meist ein Mehrfaches des Eingabepreises |
| Reasoning-Token | Interner Denkprozess des Modells | Meist zum Ausgabepreis berechnet | Erscheinen nicht in der Antwort, werden aber berechnet |
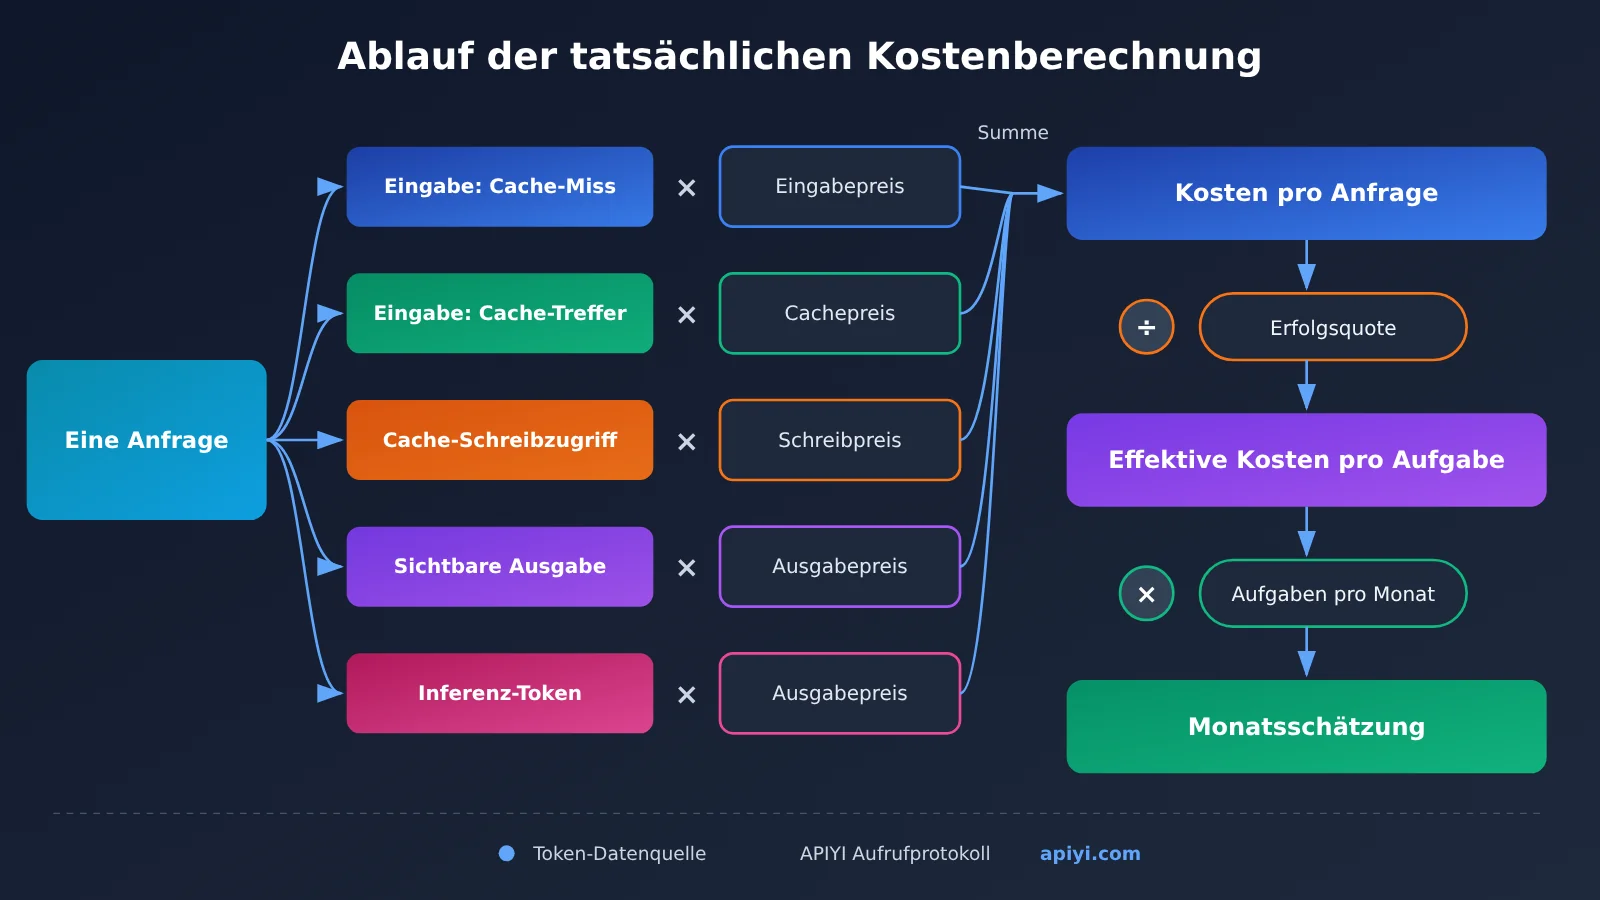
Als Formeln bilden diese Positionen das zentrale Berechnungsmodell dieses Artikels:
- Kosten pro Request = Eingabe-Token ohne Cache-Treffer × Eingabepreis + Token mit Cache-Treffer × Cache-Preis + Cache-Schreib-Token × Schreibpreis + (sichtbare Ausgabe + Reasoning-Token) × Ausgabepreis
- Effektive Kosten pro Aufgabe = Kosten pro Request × durchschnittliche Anzahl der Modellaufrufe ÷ Erfolgsquote der Aufgaben
- Monatliche Kostenschätzung = effektive Kosten pro Aufgabe × Anzahl der Aufgaben pro Monat
Der Einfluss des Caches wird oft unterschätzt. Ein Artikel derselben Quelle vom 6. August 2026 erwähnt, dass der Preis für Cache-Treffer bei DeepSeek V4 Flash rund 50-mal niedriger ist als der Preis für Eingaben ohne Cache-Treffer. Zwischen verschiedenen Hosting-Anbietern kann sich der Cache-Preis zudem um den Faktor 28 unterscheiden. Das zeigt: Auch beim selben Modell kann die Rechnung je nach Bezugsweg völlig anders ausfallen. Den Cache-Preis solltest du daher für den tatsächlich genutzten Anbieter prüfen.
Wie Reasoning-Token die tatsächlichen Kosten erhöhen
Reasoning-Modelle sind ein häufiger Grund dafür, dass ein niedriger Listenpreis zu einer hohen Rechnung führt. Ein Nutzer stellt nur eine kurze Frage und das Modell antwortet mit 200 Zeichen – intern hat es dafür aber möglicherweise erst mehrere Tausend Token verarbeitet. Diese werden normalerweise zum Ausgabetarif abgerechnet, der ohnehin um ein Mehrfaches höher liegt als der Eingabetarif.
Öffentliche Berechnungen Dritter zeigen denselben Effekt. Ein Artikel vom 4. August 2026 berichtet, dass Qwen 3.8 Max bei Artificial Analysis 3 Punkte mehr als DeepSeek V4 Flash erzielt, bei drei tatsächlich getesteten Aufgaben aber etwa 345-mal so viel kostet und rund sechsmal langsamer ist. Ein weiterer Artikel derselben Reihe nennt bei gleicher Testmethodik folgende Werte: Kimi K3 erreicht 57 Punkte bei Kosten von $2,437, DeepSeek V4 Flash 50 Punkte bei $72 und Qwen 3.7 Max nur 46 Punkte bei $1,604. Weniger Punkte bei höheren Kosten kommen also durchaus vor – oft liegt das am Token-Verbrauch.
Auch zwischen verschiedenen Versionen desselben Anbieters gibt es Unterschiede. Ein Artikel weist darauf hin, dass Claude Opus 4.5 bis 4.8 und Opus 5 denselben Listenpreis von $5/$25 haben, der gemessene Token-Verbrauch aber um etwa den Faktor 1,30 abweicht. Der Preis bleibt gleich, die Rechnung kann sich trotzdem um 30 % verändern. Das wird beim Upgrade auf eine neue Modellversion leicht übersehen.
Tatsächliche Kosten anhand des Tokenverbrauchs schätzen: Einstieg in 5 Schritten
Mit diesem Verfahren lässt sich anhand einer kleinen Stichprobe eine Kostenschätzung erstellen – ganz ohne komplexe Skripte. Das Grundprinzip ist einfach: Für dieselbe Aufgabe und dieselbe Eingabe werden Eingabe-, Ausgabe-, Cache- und Reasoning-Token getrennt erfasst.
Schritt 1: Repräsentative Aufgaben auswählen
Wählen Sie 20 bis 50 Anfragen aus Ihrer Produktionsumgebung oder aus realen Anforderungen. Decken Sie dabei die wichtigsten Typen ab, etwa kurze Fragen und Antworten, lange Dokumente und mehrstufige Dialoge. Bewahren Sie die vollständige System-Eingabeaufforderung und den Kontext auf, denn Cache-Treffer entstehen vor allem durch diese wiederkehrenden Präfixe. Testen Sie nicht nur mit einem einfachen „Hallo“ – damit lassen sich weder Unterschiede bei der Tokenisierung noch Cache-Effekte zuverlässig erfassen.
Schritt 2: Variablen konstant halten und Kandidatenmodelle einzeln aufrufen
Verwenden Sie für jedes Kandidatenmodell dieselbe System-Eingabeaufforderung, dieselbe Nutzereingabe sowie identische Einstellungen für max_tokens und Temperatur. Unterstützt ein Reasoning-Modell einen Parameter für die Reasoning-Intensität, halten Sie auch die gewählte Stufe fest: Je nach Stufe kann die Anzahl der Reasoning-Token stark variieren.
Ein einheitlicher Zugang spart bei diesem Schritt einiges an Aufwand. Über eine Plattform wie APIYI auf apiyi.com können Sie mit demselben API-Schlüssel und derselben OpenAI-kompatiblen Aufrufmethode zwischen Modellen verschiedener Anbieter wechseln. Für die gesamte Vergleichsreihe müssen Sie nur den Modellnamen ändern, statt bei jedem Anbieter ein Konto einzurichten, Guthaben aufzuladen und das SDK anzupassen.
Schritt 3: Token-Arten einzeln erfassen
Lesen Sie nach jedem Aufruf die Token-Zahlen aus dem Feld usage der Antwort. Im OpenAI-kompatiblen Format sind unter anderem folgende Felder üblich:
usage.prompt_tokens: Gesamtzahl der Eingabe-Tokenusage.prompt_tokens_details.cached_tokens: Anteil der Token aus dem Cacheusage.completion_tokens: Gesamtzahl der Ausgabe-Tokenusage.completion_tokens_details.reasoning_tokens: darin enthaltene Reasoning-Token
Die Feldnamen unterscheiden sich je nach Anbieter. Das Anthropic-Format verwendet beispielsweise cache_read_input_tokens und cache_creation_input_tokens, um zwischen Cache-Lese- und Schreibvorgängen zu unterscheiden. Maßgeblich ist jeweils die Dokumentation des Anbieters.
Wenn Sie die Antworten nicht selbst auswerten möchten, können Sie auch die Aufzeichnungen der Plattform nutzen. APIYI bietet Protokolle und Nutzungsstatistiken für jeden Aufruf. Damit lässt sich der Verbrauch derselben Stichprobe über verschiedene Modelle hinweg vergleichen. Ob Cache- und Reasoning-Token in den Protokollen separat aufgeführt und Cache-Treffer gesondert abgerechnet werden, entnehmen Sie bitte der Anzeige in der Konsole und den Abrechnungshinweisen der Plattform. Klären Sie das vor der Kostenberechnung.
🚀 Schnellstart: Führen Sie auf APIYI unter apiyi.com zunächst einen kleinen Vergleich mit 20 Beispielen durch. So sehen Sie, in welcher Größenordnung sich der Token-Verbrauch der einzelnen Modelle bewegt, bevor Sie die Stichprobe gegebenenfalls erweitern. Ein gemeinsames Guthaben hat den Vorteil, dass die Kosten für Tests mit mehreren Modellen in einem Konto zusammenlaufen und sich anschließend leichter abgleichen lassen.
Schritt 4: Ergebnisse in der Vorlage zusammenfassen
Tragen Sie die erfassten Ergebnisse in die folgende Vorlage ein, mit einer Zeile pro Modell. Geben Sie bei den Einzelpreisen unbedingt das Abfragedatum und die Quelle an.
| Feld | Ausfüllhinweise | Datenquelle |
|---|---|---|
| Modell und Version | Genaue Versionsnummer oder Datumssuffix angeben | Aufrufparameter |
| Einzelpreise und Abfragedatum | Je eine Spalte für Eingabe, Ausgabe, Cache-Lesezugriffe und Cache-Schreibzugriffe | Offizielle Preisseite oder Preisseite der verwendeten Plattform |
| Durchschnittliche Eingabe-Token ohne Cache-Treffer | Mittelwert der Stichprobe | usage in der Antwort oder Plattformprotokolle |
| Durchschnittliche Token mit Cache-Treffer | Mittelwert der Stichprobe und Trefferquote berechnen | usage in der Antwort oder Plattformprotokolle (z. B. Nutzungsstatistik von APIYI) |
| Durchschnittliche sichtbare Ausgabe-Token | Gesamtausgabe abzüglich des Reasoning-Anteils | usage in der Antwort |
| Durchschnittliche Reasoning-Token | Bei Reasoning-Modellen separat erfassen | usage in der Antwort |
| Erfolgsquote der Aufgaben | Anteil der Aufgaben, die nach manueller oder regelbasierter Prüfung bestanden haben | Prüfprotokolle |
| Effektive Kosten pro Aufgabe | Nach der vorherigen Formel berechnen | Gesamtauswertung |
Schritt 5: Anhand der effektiven Kosten pro Aufgabe entscheiden
Entscheidend für den Vergleich sind nicht die Einzelpreise, sondern die „effektiven Kosten pro Aufgabe“. Die folgende Rechnung verwendet Beispielpreise. Die Zahlen sind frei erfunden und stellen keine echten Modellpreise dar.
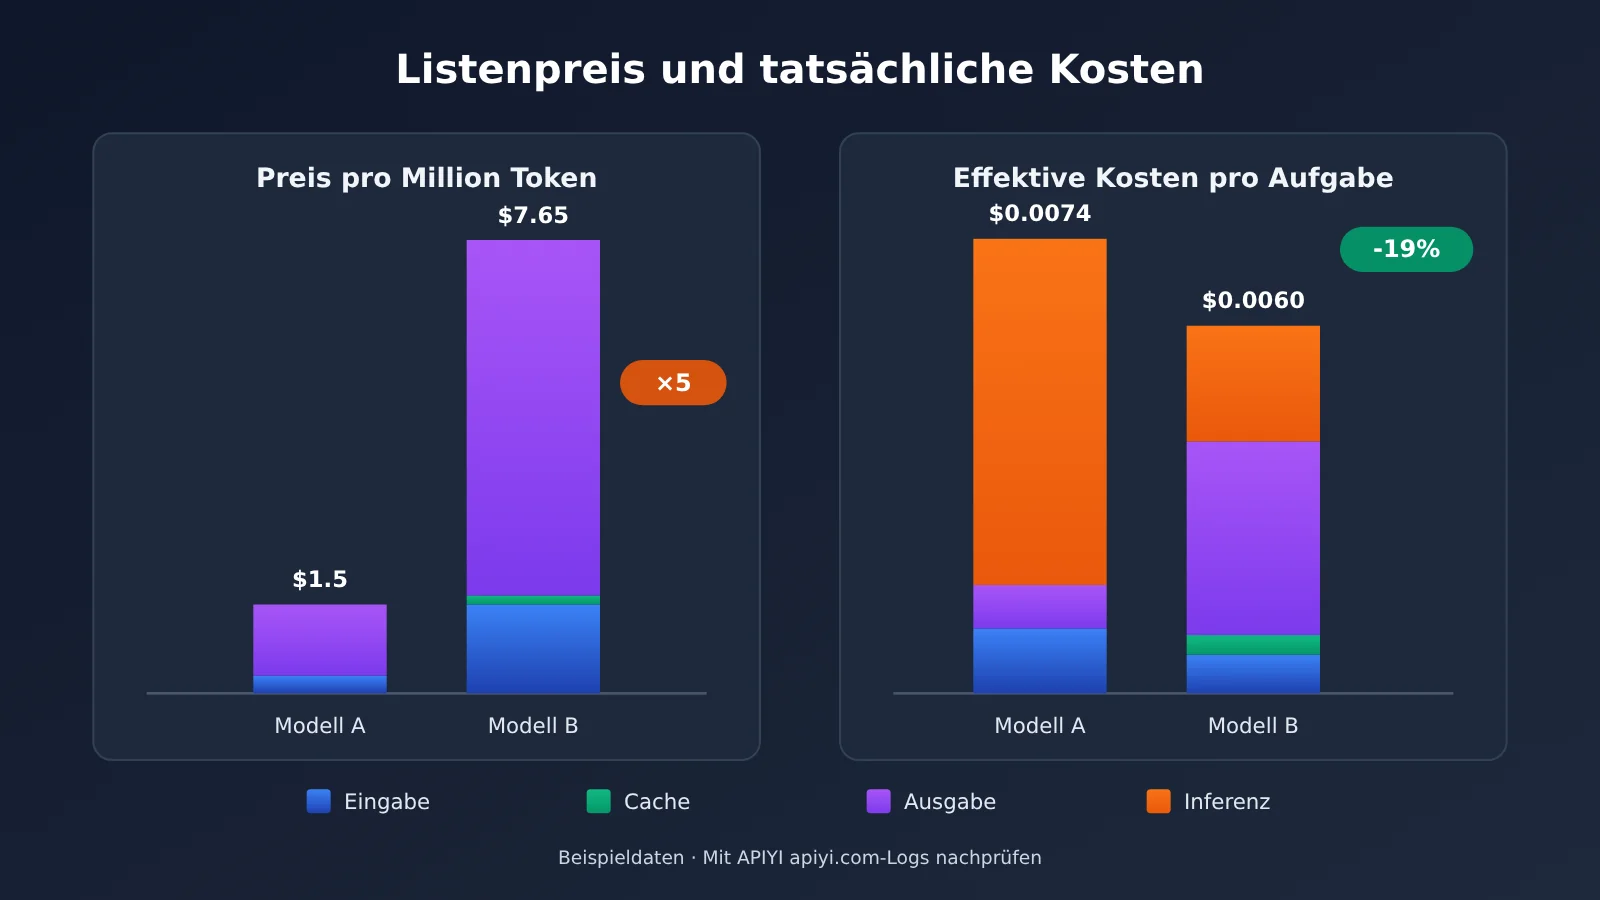
Angenommen, Modell A kostet $0.3/M für Eingabe und $1.2/M für Ausgabe. Modell B kostet $1.5/M für Eingabe, $6/M für Ausgabe und $0.15/M für Cache-Lesezugriffe. Seine Einzelpreise sind damit fünfmal so hoch wie die von A.
| Berechnungsposten | Modell A (niedriger Listenpreis) | Modell B (hoher Listenpreis) |
|---|---|---|
| Eingabe-Token ohne Cache-Treffer | 3,000 | 400 |
| Token mit Cache-Treffer | 0 | 2,000 |
| Sichtbare Ausgabe- + Reasoning-Token | 500 + 4,000 | 500 + 300 |
| Eingabekosten | $0.0009 | $0.0006 + $0.0003 |
| Ausgabekosten | $0.0054 | $0.0048 |
| Kosten pro Anfrage | $0.0063 | $0.0057 |
| Erfolgsquote der Aufgaben | 85% | 95% |
| Effektive Kosten pro Aufgabe | ca. $0.0074 | ca. $0.0060 |
In diesem Beispielszenario ist die Tokenisierung von Modell B kompakter, sodass die Eingabe insgesamt 600 Token weniger umfasst. Der Grossteil seiner langen System-Eingabeaufforderung wurde aus dem Cache geladen; ausserdem ist sein Reasoning-Prozess deutlich kürzer. Im Ergebnis liegen die effektiven Kosten von B trotz des fünfmal höheren Listenpreises rund 19 % unter denen von A. In der Praxis kann das Ergebnis auch umgekehrt ausfallen. Genau deshalb sollten Sie den Vergleich mit Ihren eigenen Aufgaben wiederholen.
Worauf Sie bei der Berechnung der tatsächlichen Kosten achten sollten
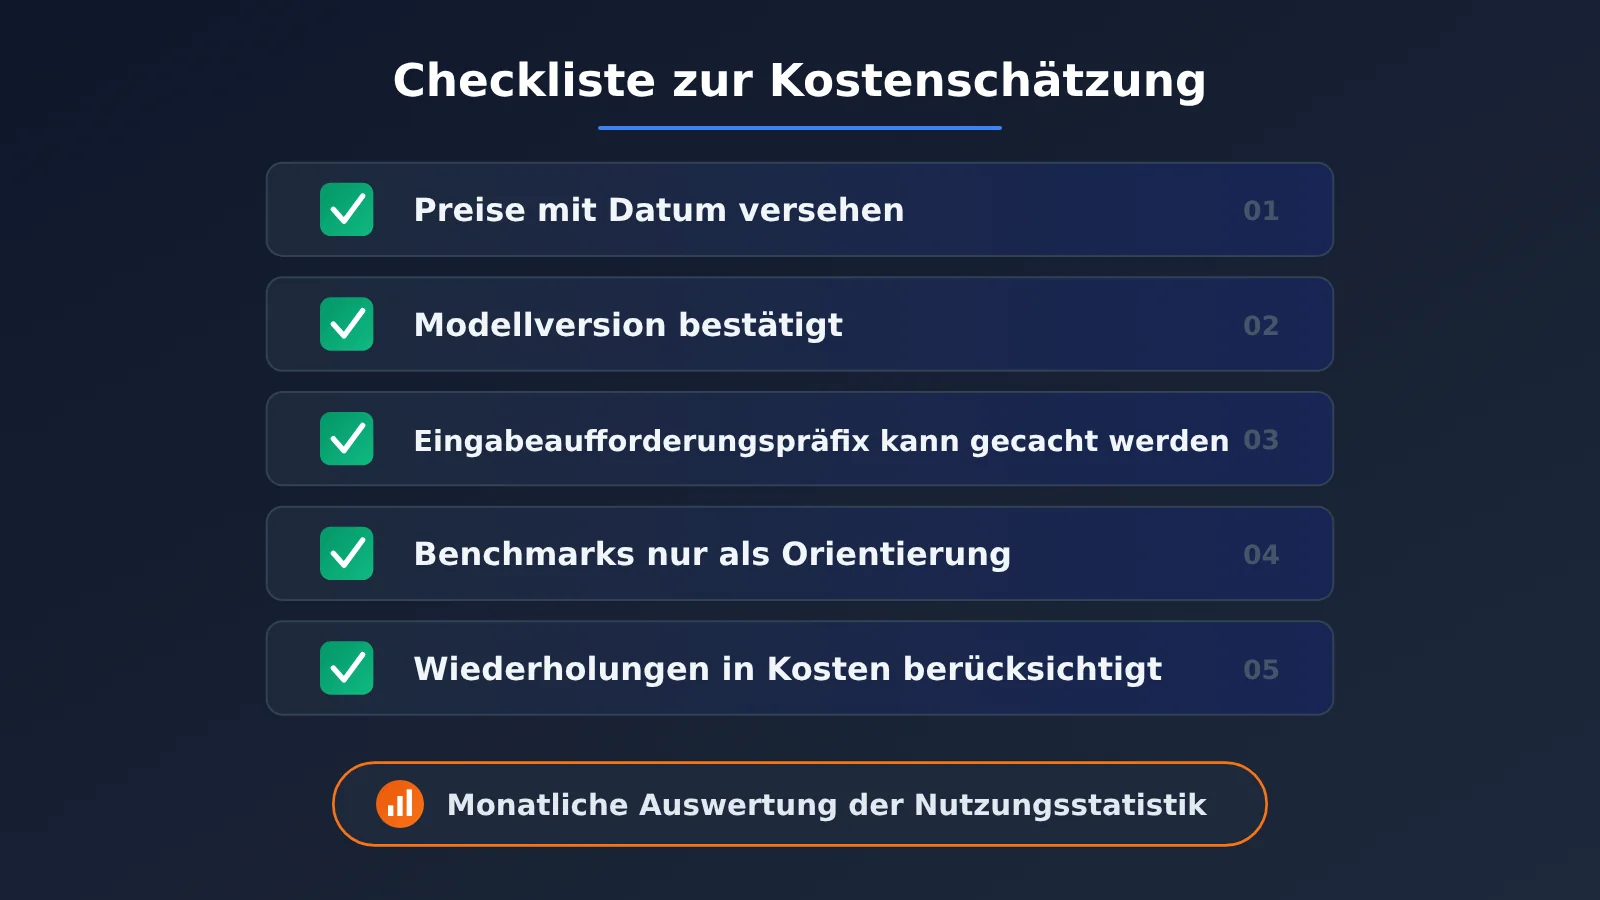
Die Berechnung selbst ist nicht kompliziert. Einige Fallstricke können das Ergebnis aber verzerren – prüfen Sie deshalb vorab die folgenden Punkte:
- Preise immer mit Datum angeben: Modellpreise ändern sich häufig. In einer Quelle wird beispielsweise erwähnt, dass für DeepSeek V4 Pro 0813 ab dem 16. August 2026 unterschiedliche Preise für Spitzen- und Nebenzeiten gelten. Die Preise für dasselbe Modell können je nach Tageszeit und Anbieter variieren.
- Prüfen, auf welche Version ein Modellalias verweist: Einem Artikel zufolge ruft ein scheinbar „am häufigsten genutzter“ Modellname tatsächlich eine ältere Version auf. Halten Sie bei der Berechnung die Modellkennung aus der Antwort fest. So vermeiden Sie, Version A zu testen und Version B produktiv einzusetzen.
- Cache-Treffer setzen identische Präfixe voraus: Stehen dynamische Inhalte wie Zeitstempel oder Nutzer-IDs am Anfang der Eingabeaufforderung, ändert sich das Präfix bei jeder Anfrage. Cache-Treffer sind dann kaum möglich. Verwenden Sie bei der Berechnung dieselbe Struktur für die Eingabeaufforderung wie im Produktivbetrieb.
- Benchmarks von Drittanbietern nur als Orientierung nutzen: Gesamtbewertungen etwa von Artificial Analysis und aufgabenbezogene Kosten spiegeln die Aufgabenverteilung der jeweiligen Testorganisation wider – nicht unbedingt Ihren Anwendungsfall.
- Wiederholungsversuche einrechnen: Erneute Aufrufe wegen 429-Ratenbegrenzungen, Formatfehlern oder unzureichender Antworten verursachen ebenfalls Kosten. Berechnen Sie die Erfolgsquote anhand der tatsächlichen Bewertungsergebnisse.
💰 Tipp zur Kostenoptimierung: Nach der Berechnung können Sie die „effektiven Kosten pro erfolgreich erledigter Aufgabe“ als Hauptkriterium für die Modellauswahl nutzen und Benchmark-Ergebnisse sowie Latenz als Rahmenbedingungen berücksichtigen. Bei APIYI apiyi.com genügt zum Wechseln des Modells eine Änderung des Modellnamens. So können Sie die Produktivkonfiguration schnell anpassen, wenn sich die Ergebnisse Ihrer Berechnung ändern, und den tatsächlichen Verbrauch weiterhin anhand der Aufrufprotokolle überwachen.
Häufig gestellte Fragen (FAQ)
F1: Was sind die „tatsächlichen Kosten“ eines Modells?
Die tatsächlichen Kosten sind die Gebühren, die für die Erledigung einer konkreten Aufgabe anfallen – nicht der Listenpreis pro Million Token. Dafür wird die tatsächliche Anzahl jeder Token-Art (Eingabe ohne Cache-Treffer, Cache-Treffer, Cache-Schreibvorgänge, sichtbare Ausgabe und Reasoning) mit dem jeweiligen Einzelpreis multipliziert. Unter Berücksichtigung von Erfolgsquote und Wiederholungsversuchen ergeben sich daraus die effektiven Kosten pro Aufgabe.
F2: Warum ist die Token-Anzahl für dasselbe Dokument je nach Modell unterschiedlich?
Jedes Modell verwendet einen anderen Tokenizer, der chinesische Texte, Code und Satzzeichen unterschiedlich fein zerlegt. In einer veröffentlichten Berechnung wurde dasselbe Dokument bei 9 Modellen mit 614 bis 957 Token gezählt. Die Eingabekosten müssen daher anhand der Token-Anzahl berechnet werden, die das jeweilige Modell selbst meldet. Die Zählung eines Modells lässt sich nicht auf andere übertragen.
F3: Müssen Reasoning-Token immer in die Kosten einbezogen werden?
Ja. Die meisten Anbieter zählen Reasoning-Token zur Ausgabe und berechnen sie zum Ausgabepreis. Sie erscheinen zwar nicht im Antworttext, können aber einen Großteil der Ausgabe ausmachen. Bei der Kostenberechnung für Reasoning-Modelle empfiehlt es sich, `reasoning_tokens` separat zu erfassen und Modelle bei gleicher Reasoning-Intensität zu vergleichen.
F4: Wie viel lässt sich durch Cache-Treffer sparen?
Das hängt von den Cache-Preisen des Anbieters und deiner Trefferquote ab. In den Referenzmaterialien wird für DeepSeek V4 Flash ein Preis für Cache-Treffer genannt, der bei etwa 1/50 des Preises ohne Treffer liegt. Zwischen verschiedenen Hosting-Anbietern können sich die Cache-Preise allerdings um das 28-Fache unterscheiden. Besonders viel lässt sich bei langen System-Eingabeaufforderungen, festen Wissensdatenbank-Präfixen und mehrstufigen Dialogen sparen. Die konkreten Werte findest du in den Preisangaben des jeweiligen Anbieters.
F5: Wie lassen sich die Kosten mehrerer Modelle schnell mit einer kleinen Stichprobe berechnen?
Dafür empfiehlt sich eine Plattform, die einen einheitlichen Zugang zu mehreren Modellen bietet:
1. Bei APIYI auf apiyi.com registrieren und einen API-Schlüssel erhalten
2. 20 bis 50 echte Aufgabenbeispiele vorbereiten und Eingabeaufforderungen sowie Parameter unverändert lassen
3. Die Modelle durch Wechseln des Modellnamens nacheinander aufrufen und die verschiedenen Token-Arten anhand der Aufrufprotokolle und Nutzungsstatistiken zusammenfassen
4. Die effektiven Kosten pro Aufgabe anhand der Vorlage in diesem Artikel berechnen
So lässt sich der gesamte Vergleich mit einem Konto und einer einheitlichen Aufrufmethode durchführen. Das spart den Aufwand für mehrere Konten und Abrechnungen.
F6: Lassen sich „Kosten pro Aufgabe“ aus Blogs Dritter direkt übernehmen?
Für die Budgetplanung ist das nicht zu empfehlen. Solche Daten helfen dabei, Modellkombinationen zu entdecken, bei denen möglicherweise Unterschiede im Token-Verbrauch bestehen, und die Auswahl einzugrenzen. Da sich Testaufgaben, Modellversionen, Preise und Cache-Bedingungen von deinem Anwendungsfall unterscheiden, solltest du die endgültigen Zahlen mit eigenen Beispielen überprüfen.
F7: Welche Grenzen hat diese Berechnungsmethode?
Eine kleine Stichprobe bildet nur die darin enthaltenen Aufgabentypen ab. Ändert sich die Verteilung der Aufgaben im Betrieb, ist ein erneuter Test nötig. Zudem unterscheiden die Protokolle mancher Plattformen nicht zwischen Cache- und Reasoning-Token. In diesem Fall musst du die Daten selbst aus dem Feld `usage` der Modellantwort erfassen. Auch Preise und Modellversionen ändern sich. Deshalb empfiehlt sich nach jeder Preisanpassung oder jedem Upgrade eine neue Testrunde.
Die wichtigsten Erkenntnisse zur Berechnung der tatsächlichen Modellkosten
- Der Stückpreis ist nur die halbe Rechnung: Die Kosten ergeben sich aus dem Preis pro Token und dem tatsächlichen Tokenverbrauch.
- Unterschiede bei der Tokenisierung sind relevant: Dasselbe Dokument kann je nach Modell mehr als 50 % unterschiedlich viele Tokens ergeben.
- Reasoning-Tokens erhöhen die Ausgabekosten: Auch der unsichtbare Denkprozess wird als Ausgabe berechnet.
- Cache-Preise unterscheiden sich je nach Anbieter: Trefferquote und Cache-Preis bestimmen gemeinsam die Kosten bei langen Eingabeaufforderungen.
- Entscheidend sind die effektiven Kosten pro Aufgabe: Erfolgsquote und Wiederholungsversuche gehören in die Rechnung.
- Ein einheitlicher Zugang vereinfacht Vergleichstests: Über die einheitliche Schnittstelle und die Aufrufprotokolle von APIYI lassen sich dieselben Beispiele einfacher mit mehreren Modellen testen.
Fazit
Um die tatsächlichen Modellkosten anhand von Tokenverbrauch und Cache-Nutzung zu schätzen, kommt es auf drei Punkte an:
- Rechnung aufschlüsseln: Nicht im Cache gefundene Eingabe, Cache-Treffer, Cache-Schreibvorgänge, sichtbare Ausgabe und Reasoning-Tokens getrennt erfassen und jeweils mit dem passenden Preis multiplizieren.
- Mit eigenen Aufgaben testen: Benchmarks und Preise von Drittanbietern dienen nur als Orientierung. Verlässlich sind Messwerte für dieselbe Aufgabe mit derselben Eingabe.
- Effektive Kosten pro Aufgabe vergleichen: Erfolgsquote und Wiederholungsversuche einrechnen und das Budget anhand des monatlichen Aufgabenvolumens planen.
Modellpreise ändern sich und neue Modelle kommen ständig hinzu. Diese Berechnungsmethode bleibt trotzdem langfristig nutzbar. Vor der nächsten Modellauswahl empfiehlt sich ein Vergleich mit 20 echten Beispielen, bevor Sie entscheiden, welches Modell Sie produktiv einsetzen. Wenn Sie schnell zwischen den Modellen verschiedener Anbieter wechseln möchten, bietet APIYI unter apiyi.com einen einheitlichen Zugang. Über die Aufrufprotokolle können Sie den tatsächlichen Verbrauch jedes Modells direkt prüfen.
📚 Quellen
- Ofox.ai Blog, Seite 23: Enthält Artikelzusammenfassungen zum Vergleich des Tokenverbrauchs von DeepSeek V4 Flash und Gemini 3.6 Flash, zu Unterschieden bei Cache-Preisen und zu Kostenberechnungen für die Qwen-Serie.
- Link:
ofox.ai/blog/page/23/ -
Hinweis: Die Artikel wurden im August 2026 veröffentlicht. Die Daten stammen aus einmaligen Berechnungen eines Drittanbieters und dienen nur zur Orientierung.
-
Ofox.ai Blog, Seite 22: Enthält unter anderem einen Vergleich der Tokenanzahl desselben Dokuments bei 9 Modellen, Informationen zu Unterschieden im Tokenverbrauch zwischen Claude-Versionen und zur zeitabhängigen Preisgestaltung von DeepSeek V4 Pro.
- Link:
ofox.ai/blog/page/22/ -
Hinweis: Geeignet, um konkrete Beispiele für Unterschiede bei der Tokenisierung und zwischen Modellversionen kennenzulernen.
-
Ofox.ai Blog, Seite 25: Enthält einen Vergleich der Kosten für eine einzelne Aufgabe bei Kimi K3, GLM-5.2 und Opus 4.8.
- Link:
ofox.ai/blog/page/25/ - Hinweis: Preise und Benchmark-Ergebnisse können sich ändern. Bitte prüfen Sie vor der Nutzung die offiziellen Preisseiten der jeweiligen Anbieter.
Autor: APIYI-Technikteam
Technischer Austausch: Kontaktieren Sie uns gerne über die Startseite von APIYI unter apiyi.com. Weitere Informationen zur Anbindung finden Sie im Dokumentationszentrum unter docs.apiyi.com.