Anmerkung der Redaktion: Am Beispiel eines Projekts zur Umweltrisikobewertung bei Heimstaden zeigt dieser Artikel, wie Nicht-Entwickler mit Codex Datenquellen erschließen, Daten bereinigen und Prozesse aufbauen – und warum die Verantwortung für Methodik und menschliche Validierung bei den Fachexperten bleiben muss.
Viele Geschäftsanalysten kennen ihre Branche, können aber nicht programmieren. Wenn Daten für ein Projekt über Dutzende öffentliche Quellen verstreut sind und in unterschiedlichen Formaten vorliegen, mussten sie bisher auf ein Technikteam warten oder externe Berater beauftragen. Anhand eines öffentlich dokumentierten Praxisbeispiels erklärt dieser Artikel, wie Nicht-Entwickler beim Aufbau von Datenverarbeitungsprozessen mit Codex die Arbeit zwischen Mensch und KI aufteilen können. Im Mittelpunkt stehen zwei Grundsätze: Die Verantwortung für die Methodik und die menschliche Validierung bleiben beim Menschen.
Dies ist kein Werbetext nach dem Motto „KI erledigt alles für dich“. Das Fallbeispiel enthält beeindruckende Zahlen, lässt aber auch viele Details offen. Deshalb trennen wir klar zwischen bekannten Fakten und Schlussfolgerungen.
Das nehmen Sie mit: Sie erfahren, welche Aufgaben ein Programmieragent in Datenprojekten übernehmen kann und welche Verantwortung Sie selbst behalten sollten. Außerdem sehen Sie, wie aus einer einmaligen Analyse eine Fähigkeit wird, die ein Team dauerhaft weiterentwickeln kann.
Die wichtigsten Punkte: Datenverarbeitung mit Codex für Nichtentwickler
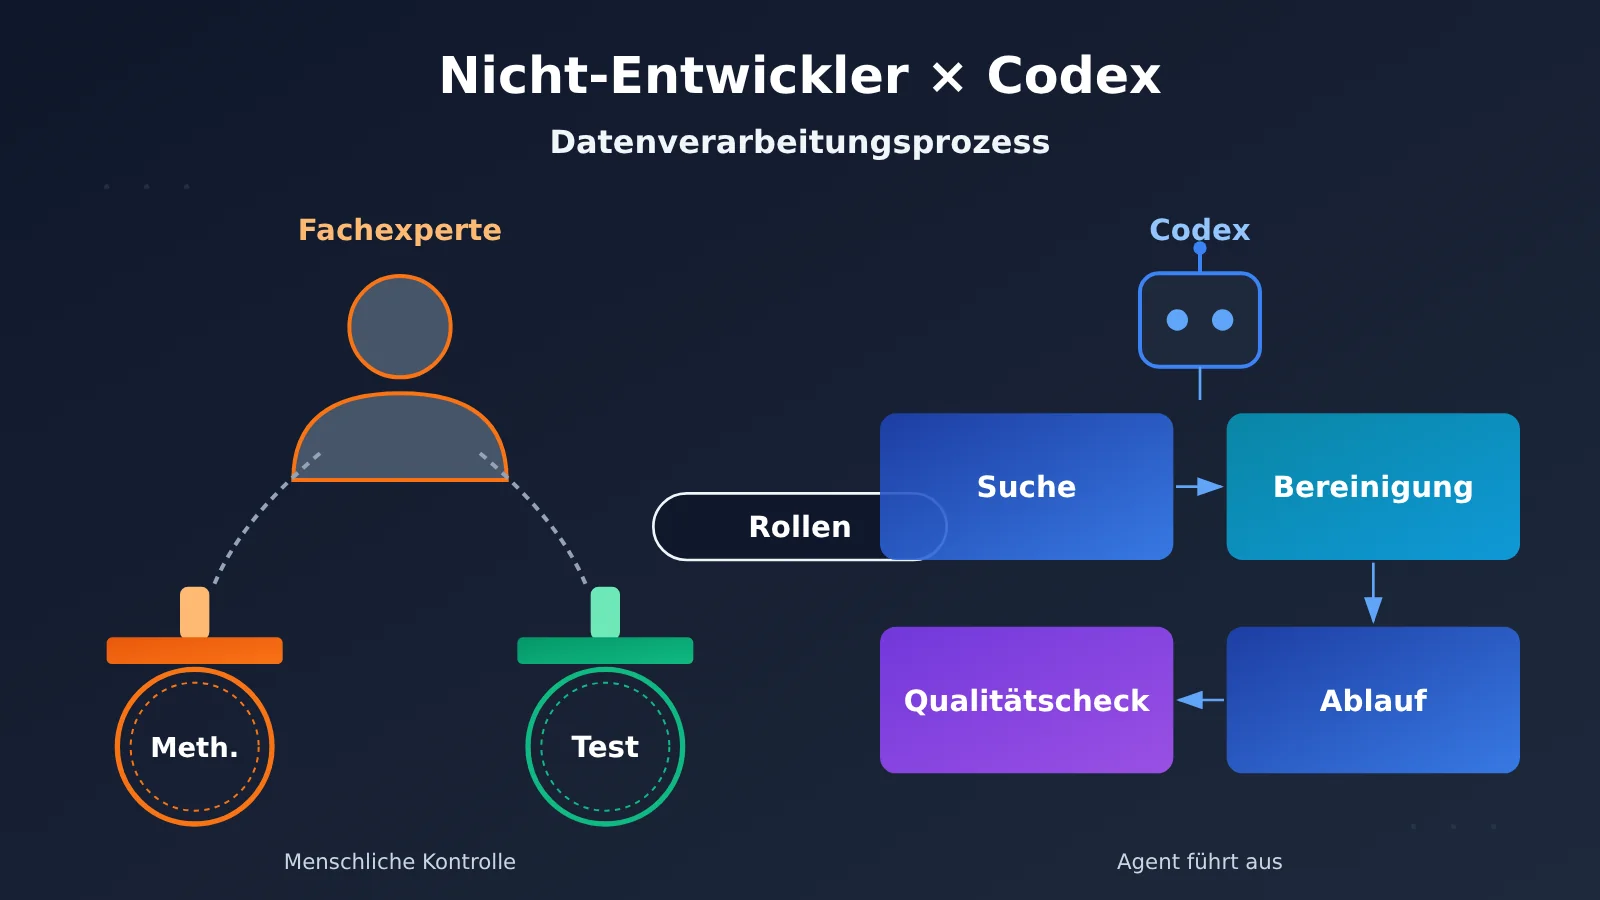
Am 3. November 2026 veröffentlichte OpenAI eine Kundengeschichte über Heimstaden, einen Betreiber von Wohnimmobilien in Europa. Darin geht es unter anderem um die Nachhaltigkeitsanalystin Julia Erlandsen: Obwohl sie keinen Hintergrund in der Softwareentwicklung hat, führte sie mithilfe von Codex eine Umweltrisikobewertung für das gesamte Immobilienportfolio durch. Die folgende Tabelle fasst zusammen, was sich aus diesem Beispiel lernen lässt.
| Punkt | Aussage im Beispiel | Nutzen für Leser |
|---|---|---|
| Art des Problems | Die Informationen sind vorhanden, aber auf verschiedene öffentliche Quellen, Formate und Datensätze verteilt | Hilft, Projekte mit verstreuten Daten zu erkennen, für die sich ein Agent besonders gut eignet |
| Aufgaben des Agenten | Datenrecherche, Bereinigung und Standardisierung, Qualitätsprüfung sowie Entwicklung eines wiederholbaren Verarbeitungsprozesses | Zeigt, welche Arbeitsschritte sich abgeben lassen |
| Aufgaben der Fachperson | Methodik und Validierung bleiben unter der Kontrolle der Analystin | Sichert die Glaubwürdigkeit der Ergebnisse |
| Ergebnis im großen Maßstab | 20.112 Immobilien bewertet und mehr als 6 Millionen Zeilen nutzbarer Daten erzeugt | Zeigt, dass auch Nichtentwickler größere Datenmengen verarbeiten können |
| Langfristiger Nutzen | Aus einem einmaligen Projekt wird eine wiederholbare Fähigkeit – ohne externe Beratung | Die Methodik bleibt im eigenen Haus und lässt sich selbst weiterentwickeln |
Die Aufgabenverteilung im Codex-Datenverarbeitungsprozess
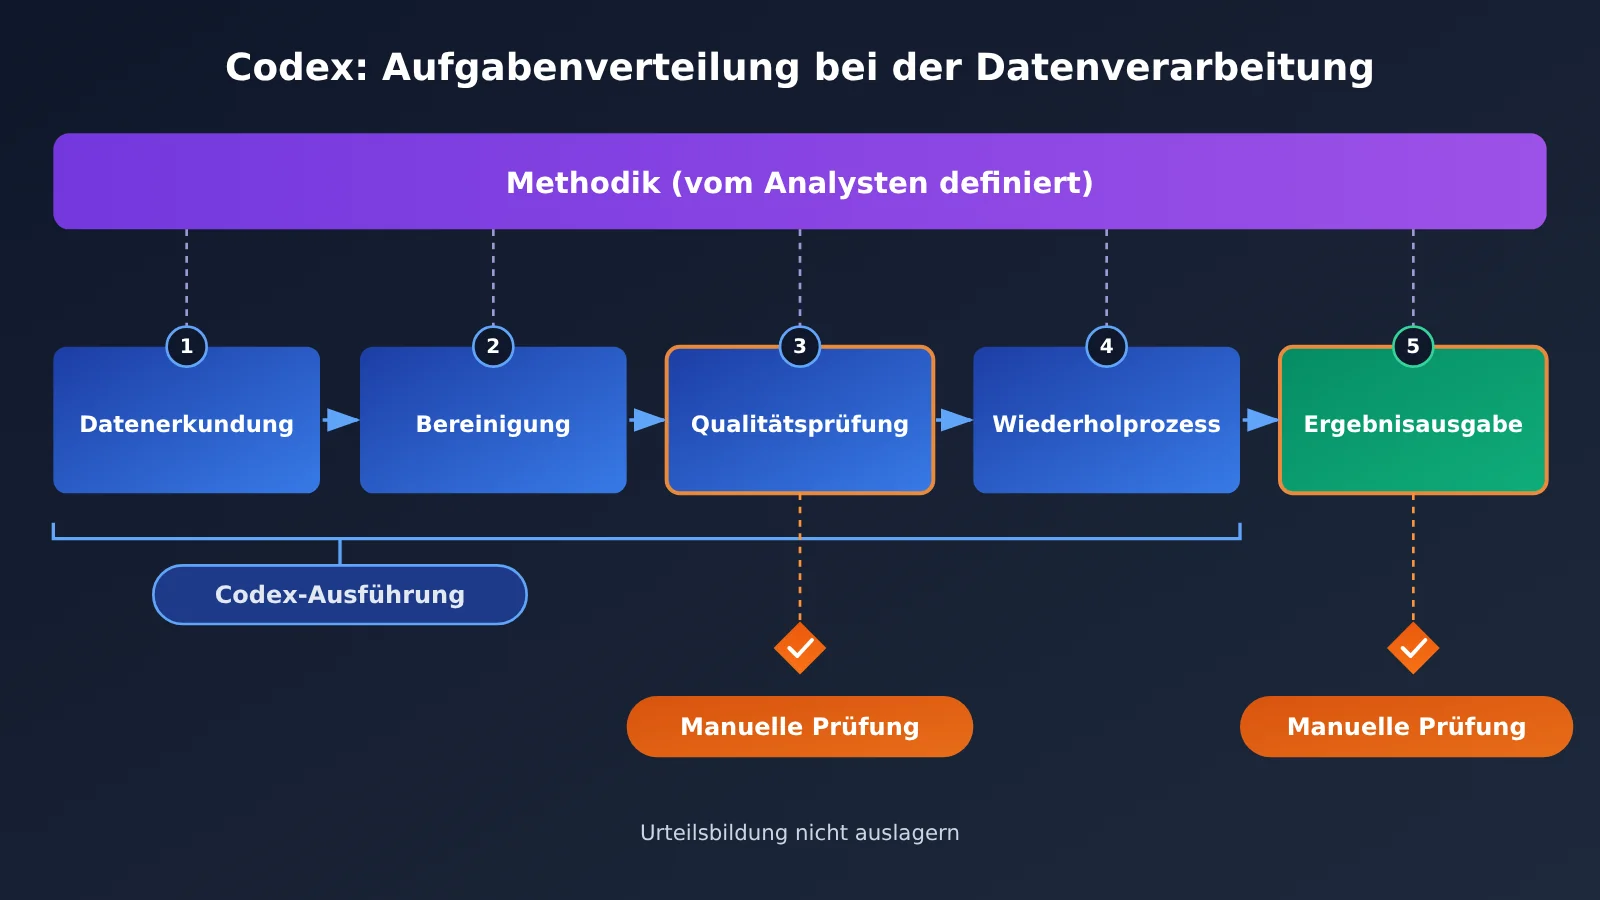
Der entscheidende Satz in diesem Beispiel ist kurz: Codex unterstützt bei der Datenrecherche, Bereinigung, Standardisierung und Qualitätsprüfung sowie bei der Entwicklung eines wiederholbaren Verarbeitungsprozesses. Julia behält dagegen die Kontrolle über Methodik und Validierung. Damit ist eine klare Grenze gezogen: Alles, was die Frage betrifft, wie Daten bereinigt und in einen funktionsfähigen Prozess eingebunden werden, lässt sich dem Agenten überlassen. Welche Maßstäbe für die Risikobewertung gelten und ob die Ergebnisse stimmen, muss dagegen ein Mensch entscheiden.
Diese Grenze ist wichtig, weil die Umweltrisikobewertung letztlich in Klimarisikobewertungen, die Einhaltung von Berichtspflichten und Investitionsentscheidungen einfließt. Beruht die Methodik auf Standardannahmen des Agenten, kann die Analystin Investoren oder Prüfern nicht erklären, wie die Schlussfolgerungen zustande kamen. Julias eigene Worte unterstreichen das: „Wir besitzen diese Methodik jetzt und können sie selbst weiterentwickeln.“ Mit „besitzen“ ist gemeint, dass sie die Bewertungslogik versteht und kontrolliert – nicht nur, dass ihr eine Ergebnistabelle vorliegt.
Grundsätze für die Aufgabenverteilung bei der Datenverarbeitung mit Codex für Nicht-Entwickler
Aus der Aufgabenverteilung im Fallbeispiel lässt sich eine allgemeinere Übersicht ableiten. Die Spalte „Details im Fallbeispiel offengelegt?“ zeigt, ob der Originaltext Einzelheiten nennt. Die Empfehlungen in der Tabelle basieren auf unserer Erfahrung mit typischen Datenprojekten und beschreiben nicht zwangsläufig das tatsächliche Vorgehen von Heimstaden.
| Schritt | Aufgabe des Programmieragenten | Aufgabe der Fachexperten | Details im Fallbeispiel offengelegt? |
|---|---|---|---|
| Datenrecherche | Potenzielle Datenquellen suchen und auflisten, die Bedeutung von Feldern erklären | Beurteilen, ob die Quellen verlässlich und für den Bewertungszweck geeignet sind | Keine konkreten Datenquellen genannt |
| Bereinigung und Standardisierung | Formate, Einheiten und Kodierungen vereinheitlichen sowie Koordinaten und Adressen abgleichen | Entscheiden, wie mit fehlenden und widersprüchlichen Werten umgegangen wird | Keine Regeln genannt |
| Qualitätsprüfung | Automatisierte Prüfungen schreiben und eine Liste mit Auffälligkeiten ausgeben | Festlegen, was als Auffälligkeit gilt, und Stichproben prüfen | Keine Methoden oder Fehlerraten genannt |
| Prozessaufbau | Die Schritte zu einem wiederholt ausführbaren Prozess zusammenfassen | Sicherstellen, dass die Prozesslogik mit der Methodik übereinstimmt | Nur als „wiederholbar“ beschrieben |
| Methodik und Schlussfolgerungen | Berechnungen nach Anweisung ausführen | Bewertungsrahmen, Gewichtungen und Schwellenwerte festlegen und die Verantwortung für die Ergebnisse tragen | Ausdrücklich den Analysten vorbehalten |
Aus dieser Tabelle lassen sich fünf Grundsätze für die Aufgabenverteilung ableiten:
- Die Ausführung lässt sich delegieren, das Urteil nicht. Der Agent kann eine vage Aufgabe wie „die Daten aufbereiten“ gut in konkrete Schritte übersetzen. Ob ein Schwellenwert sinnvoll ist, können aber nur Menschen mit Branchenkenntnis beurteilen.
- Erst die Methodik dokumentieren, dann den Agenten beauftragen. Der Bewertungsrahmen sollte in einem Dokument stehen, das du selbst erklären kannst – nicht in einzelnen Anweisungen über den Chat verstreut sein.
- Die Überprüfung braucht eine unabhängige Perspektive. Wenn der Agent, der den Prozess erstellt hat, auch seine eigenen Ergebnisse prüft, findet er nur einen Teil der möglichen Probleme. Manuelle Stichproben und der Abgleich mit externen Referenzwerten bleiben unverzichtbar.
- Der Prozess muss wiederholbar sein. Ein einmalig von Hand erstelltes Ergebnis lässt sich nicht weiterentwickeln. Erst ein Prozess, der sich erneut ausführen lässt, ist ein dauerhafter Wert.
- Für die Schlussfolgerungen sind immer Menschen verantwortlich. Auch die übergreifende KI-Strategie von Heimstaden betont, dass Mitarbeitende Entscheidungen prüfen und freigeben. KI-generierte Inhalte müssen vor der Veröffentlichung von Menschen überprüft werden.
🎯 Technischer Tipp: Wenn dein Datenprozess an einer Stelle ein großes Sprachmodell benötigt, etwa um unstrukturierte Textbeschreibungen in Risikostufen einzuordnen, kannst du über APIYI apiyi.com mehrere gängige Modelle mit derselben Schnittstelle aufrufen. Wenn verschiedene Modelle dieselben Stichproben beurteilen, lassen sich systematische Verzerrungen einzelner Modelle leichter erkennen. Das ist zugleich eine kostengünstige Möglichkeit zur Überprüfung.
Schnelleinstieg in die Datenverarbeitung mit Codex für Nicht-Entwickler
Der Fallbericht verrät weder, welche Variante von Codex Julia verwendet hat, noch wie genau sie damit interagiert und gearbeitet hat. Die folgenden Schritte sind daher keine Nachbildung des Falls. Sie orientieren sich an der beschriebenen Aufgabenverteilung und bieten Analysten ohne Entwicklerhintergrund einen Einstieg. Wie gefordert, gibt es hier keinen Code: Eine Checkliste zeigt stattdessen, was Sie dem Agenten bei jedem Schritt geben und was Sie selbst prüfen sollten.
Schritt 1: Die Methodik in natürlicher Sprache dokumentieren
Halten Sie vor dem Start die Bewertungslogik in einem Dokument fest, zum Beispiel unter dem Namen methodology.md. Es sollte mindestens das Bewertungsziel, die benötigten Kennzahlen, deren jeweilige Berechnungsgrundlage, die Schwellenwerte für die Risikostufen und den Umgang mit fehlenden Daten beschreiben. Dieses Dokument hält fest, dass die Verantwortung für die Methodik bei Ihnen liegt. Wenn Sie den Agenten später mit Änderungen am Ablauf beauftragen, sollte es immer als Grundlage dienen.
Schritt 2: Den Agenten Datenquellen finden lassen, aber selbst entscheiden
Teilen Sie dem Agenten das Ziel der Bewertung mit und bitten Sie ihn, mögliche Datenquellen samt ihren Feldern, Aktualisierungsintervallen und bekannten Einschränkungen aufzulisten. Prüfen Sie für jede Quelle, ob sie verlässlich ist und ob ihre Abdeckung zur Verteilung Ihrer Vermögenswerte passt. Lassen Sie den Agenten die heruntergeladenen Rohdaten am besten in einem separaten Verzeichnis raw ablegen und niemals verändern. Alle weiteren Verarbeitungsschritte erfolgen auf Kopien.
Schritt 3: Bereinigen und standardisieren – jede Änderung dokumentieren
Teilen Sie dem Agenten Ihre Standardisierungsregeln mit, etwa für Adressformate, Koordinatensysteme, Einheiten und Datumsformate. Lassen Sie ihn daraus einen Verarbeitungsablauf erstellen. Entscheidend ist, dass jeder Umwandlungsschritt ein Änderungsprotokoll ausgibt: Wie viele Zeilen wurden gelöscht, wie viele Einträge zusammengeführt und welche Datensätze konnten nicht zugeordnet werden? So können Sie anhand der Protokolle beurteilen, ob die Verarbeitung sinnvoll ist, ohne den Code verstehen zu müssen.
Schritt 4: Die Qualität in zwei Stufen prüfen
Die erste Stufe übernimmt der Agent: Er erstellt automatische Prüfungen auf doppelte und fehlende Werte, Werte ausserhalb des zulässigen Bereichs und fehlgeschlagene Zuordnungen von Assets. Die Auffälligkeiten gibt er als Liste aus. Die zweite Stufe übernehmen Sie: Wählen Sie zufällig einen Teil der Assets aus und prüfen Sie ihn manuell auf eine Weise, mit der Sie vertraut sind. Stichprobenumfang und Toleranzgrenzen sollten Sie vorab im Methodikdokument festhalten und zusätzlich in einer Tabelle wie validation_log dokumentieren.
Schritt 5: Den Prozess wiederholbar machen
Wenn die Ergebnisse verlässlich sind, lassen Sie den Agenten den gesamten Prozess so aufbereiten, dass er sich mit einem Klick erneut ausführen lässt. Dazu soll er eine Anleitung schreiben, mit der auch eine Kollegin oder ein Kollege ohne Programmierkenntnisse den Prozess ausführen kann. Erst dann wird aus einer einmaligen Analyse eine wiederverwendbare Lösung.
| Phase | Ihre Eingabe für den Agenten | Was Sie prüfen müssen | Häufiges Risiko |
|---|---|---|---|
| Methodik | Bewertungsziel und Branchenwissen | Ihr selbst erstelltes Methodikdokument | Kennzahlen sind unklar definiert und müssen später mehrfach überarbeitet werden |
| Datensuche | Ziel und Abdeckungsbereich | Quellenliste und Beschreibung der Einschränkungen | Nicht vertrauenswürdige oder veraltete Daten werden eingebunden |
| Bereinigung und Standardisierung | Standardisierungsregeln | Änderungsprotokoll für jeden Schritt | Daten werden stillschweigend gelöscht und das Ergebnis wirkt nur auf den ersten Blick sauber |
| Qualitätsprüfung | Definition von Auffälligkeiten und Stichprobenumfang | Liste der Auffälligkeiten und Ergebnisse der manuellen Stichprobe | Automatische Prüfungen werden ungeprüft übernommen, systematische Fehler übersehen |
| Prozessverstetigung | Anforderungen an Ausführung und Aktualisierung | Wiederholbarer Prozess und Anleitung | Nur der Agent „weiss“, wie der Prozess ausgeführt wird |
🚀 Schnellstart: Wenn Sie in Schritt 3 oder 4 ein Grosses Sprachmodell benötigen, um Textfelder zu verstehen – etwa zur Auswertung beschreibender Risikoinformationen in öffentlichen Berichten verschiedener Länder –, können Sie zunächst auf APIYI apiyi.com die Ausgaben mehrerer Modelle anhand kleiner Stichproben vergleichen. Wählen Sie das zuverlässigste Modell und binden Sie es erst dann in den eigentlichen Prozess ein. So setzen Sie nicht von Anfang an den gesamten Datenbestand auf ein einziges Modell.
Der Codex-Datenverarbeitungsprozess im Vergleich
| Ansatz | Verbleib der Methodik | Wiederholbarkeit | Zuverlässigkeit der Validierung | Hauptproblem |
|---|---|---|---|---|
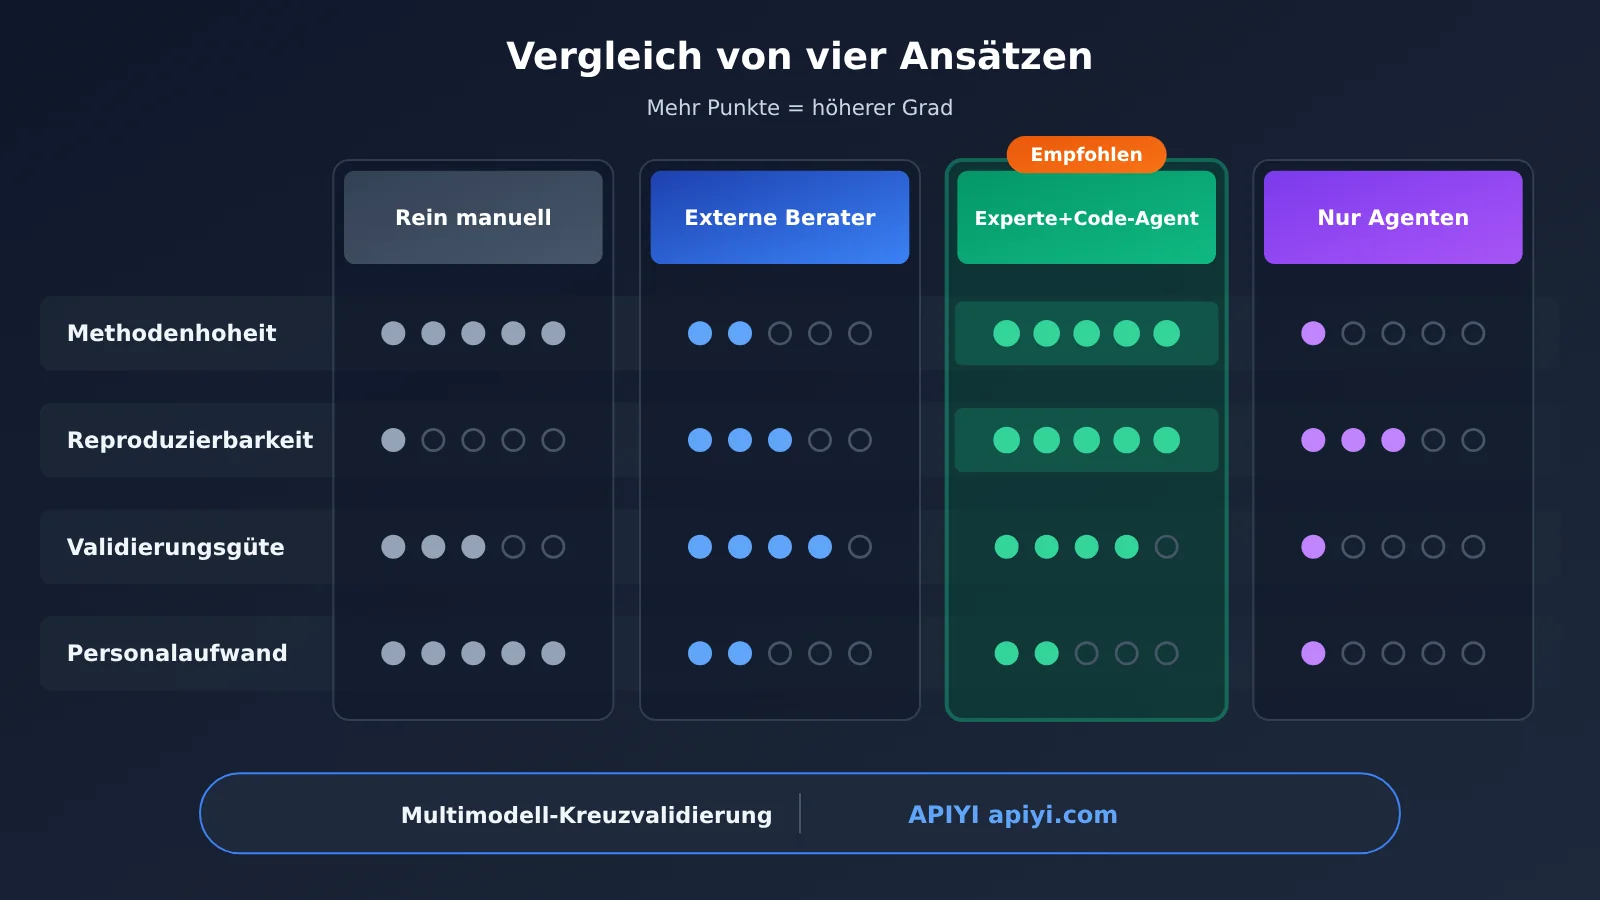
| Rein manuelle Bearbeitung | Beim Experten | Gering, oft schwer erneut durchzuführen | Abhängig von der Sorgfalt des Einzelnen | Hoher Personalaufwand; im Fallbeispiel auf 5 Personen für 1 Jahr geschätzt |
| Externe Beratung | Oft bei den Beratern | Mittel, abhängig von den gelieferten Ergebnissen | Relativ hoch, aber wenig transparent | Für spätere Aktualisierungen müssen erneut Dienstleistungen eingekauft werden |
| Experte + Programmieragent | Beim Experten | Hoch, der Prozess lässt sich erneut durchführen | Hoch, sofern die menschliche Validierung gründlich erfolgt | Der Experte muss seine Methodik strukturiert aufbereiten können |
| Vollständig an einen Agenten delegiert | Unklar, in Standardannahmen verborgen | Mittel | Gering, die Herkunft der Schlussfolgerungen ist schwer zu erklären | Die Schlussfolgerungen lassen sich gegenüber Dritten nicht verantworten |
Einordnung des Vergleichs
Vergleich mit externer Beratung: Externe Berater haben gewisse Vorteile bei der fachlichen Erfahrung und der Geschwindigkeit, mit der sie Ergebnisse liefern. Die Methodik bleibt jedoch häufig bei ihnen. Soll die Bewertung im nächsten Jahr aktualisiert werden, sind erneut Abstimmungen und Zahlungen nötig. Beim Ansatz „Experte + Programmieragent“ bleibt die Methodik dagegen in der Organisation. Heimstaden weist ausdrücklich darauf hin, dass das Projekt die ansonsten nötige Beauftragung externer Berater vermieden hat.
Vergleich mit der vollständigen Delegation an einen Agenten: Das gesamte Projekt einem Agenten zu überlassen, scheint am einfachsten zu sein und liefert schnell Ergebnisse. Allerdings trifft der Agent bei vielen Details eigene Annahmen – etwa dazu, wie fehlende Werte ergänzt oder Ausreißer ausgeschlossen werden. Diese Annahmen entsprechen möglicherweise nicht den Branchenkonventionen. Bei Bewertungen, die Compliance-Berichte und Investitionsentscheidungen stützen sollen, halten solche Schlussfolgerungen kritischen Nachfragen nur schwer stand.
Die Zahlen zur Personaleinsparung sollten nüchtern betrachtet werden. Im Original ist davon die Rede, dass der „geschätzte Aufwand für die Lieferung“ von 5 Personen über 1 Jahr auf 2 Personen über 2 Monate sank. Grob in Personenmonate umgerechnet sind das etwa 60 gegenüber 4 Personenmonaten. Es handelt sich jedoch um eine eigene Schätzung des Unternehmens, die nicht unabhängig überprüft wurde. Auch die Rollenverteilung zwischen den beiden beteiligten Personen wird nicht erläutert.
💡 Empfehlung: Wenn Ihr Team bereits über eine Methodik verfügt und ihm lediglich die technischen Umsetzungsmöglichkeiten fehlen, ist „Experte + Programmieragent“ der vielversprechendste Ansatz. Für die Teile des Prozesses, die Modellaufrufe benötigen, können Sie über die einheitliche Schnittstelle von APIYI apiyi.com zwischen verschiedenen Modellen wechseln und sie vergleichen. Auch bei einem späteren Modellwechsel müssen Sie so nicht den gesamten Prozess neu schreiben.
Was über den Codex-Fall zur Datenverarbeitung bekannt ist – und was nicht
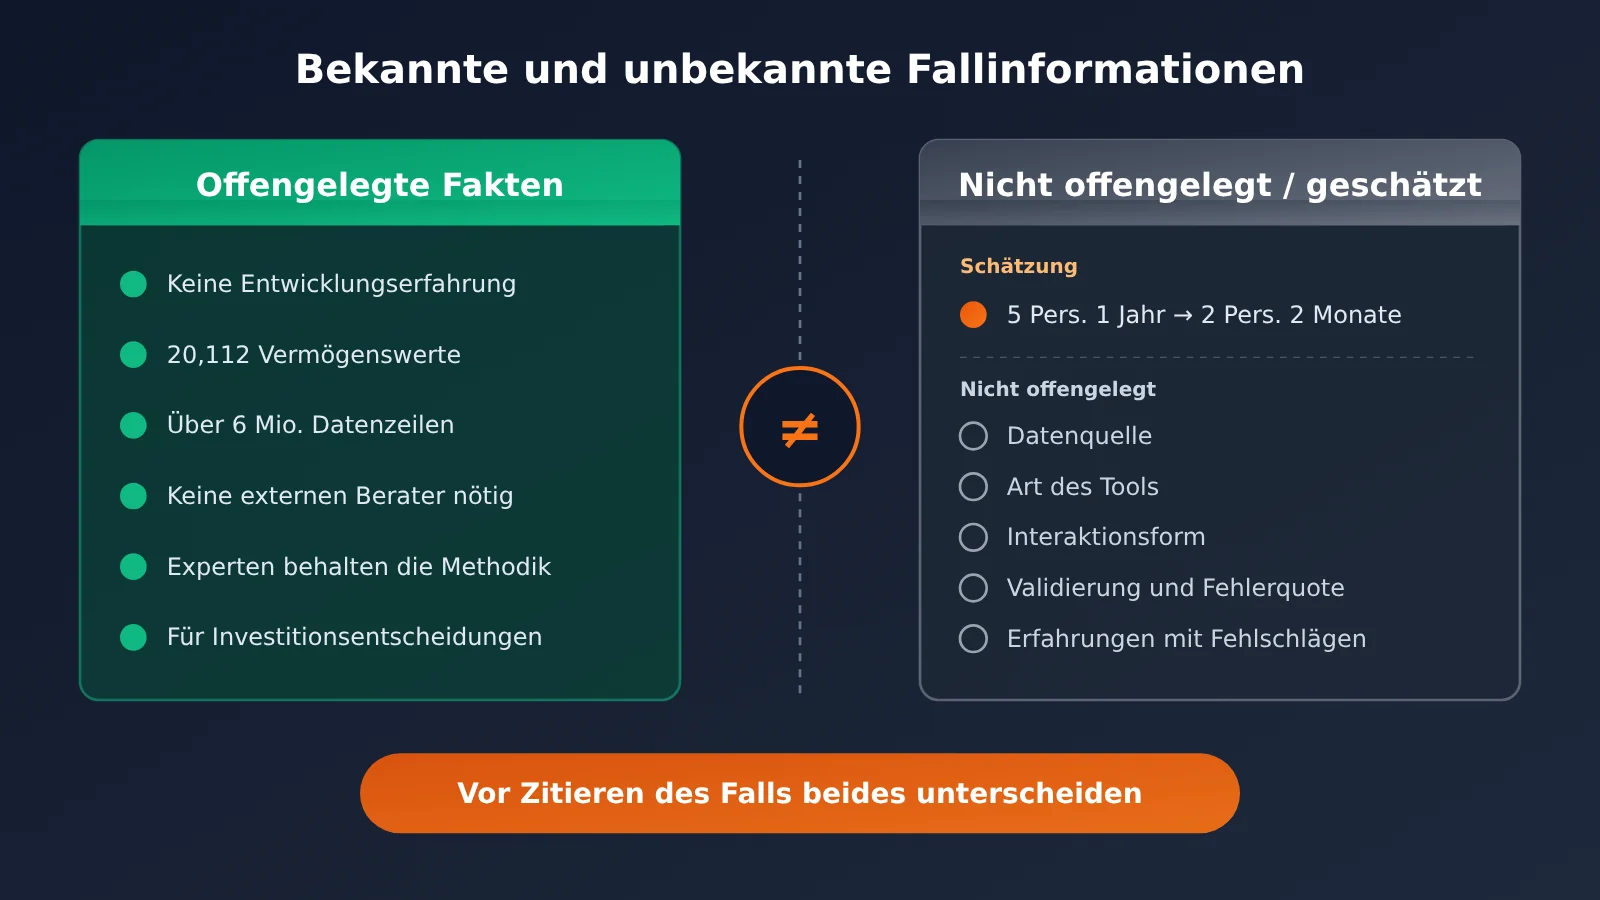
Um nicht zu viel in das Fallbeispiel hineinzulesen, trennen wir die ausdrücklich genannten Informationen von den Angaben, die nicht offengelegt wurden.
| Kategorie | Inhalt |
|---|---|
| Offengelegt | Der Analyst hatte keinen Hintergrund in der Softwareentwicklung; Codex unterstützte bei der Datenrecherche, Bereinigung und Standardisierung, Qualitätskontrolle und Prozessentwicklung; der Analyst blieb für Methodik und Validierung verantwortlich; 20.112 Vermögenswerte wurden bewertet und mehr als 6 Millionen Datenzeilen erzeugt; externe Berater waren nicht nötig; die Ergebnisse flossen in Klimarisikobewertungen, Berichte und Investitionsentscheidungen ein |
| Schätzung | Der Aufwand für die Umsetzung sank von einem Jahr mit 5 Personen auf 2 Monate mit 2 Personen. Das ist eine Schätzung des Unternehmens |
| Nicht offengelegt | Konkrete Datenquellen; Nutzungsform von Codex (Desktop, CLI oder andere); Art der Interaktion und Arbeitsablauf; konkrete Validierungsmethoden und Fehlerrate; Schwierigkeiten und gescheiterte Ansätze während der Nutzung |
Diese Lücken schmälern nicht den Wert des Beispiels für die Aufteilung der Aufgaben. Sie bedeuten aber, dass sich die Effizienzzahlen nicht einfach auf andere Projekte übertragen lassen. In der Praxis dürfte die Klärung der Methodik und die manuelle Validierung oft mehr Zeit beanspruchen als das Schreiben der Prozesse durch den Agenten. Eine Aussage der Heimstaden-Geschäftsleitung sollte man sich merken: KI kann einen schlechten Prozess nicht reparieren, aber einen guten Prozess erheblich verstärken.
Häufig gestellte Fragen (FAQ)
F1: Was bedeutet es konkret, wenn Nichtentwickler mit Codex Datenverarbeitungsprozesse erstellen?
Fachexperten ohne Programmierkenntnisse beschreiben einem Programmieragenten ihre Anforderungen in natürlicher Sprache. Der Agent übernimmt technische Aufgaben wie Datenbeschaffung, Bereinigung, Prüfung und Erstellung des Prozesses. Die Experten definieren die Methodik und prüfen die Ergebnisse. Das Projekt zur Umweltrisikobewertung von Heimstaden ist ein öffentlich dokumentiertes Beispiel dafür.
F2: Wie unterscheidet sich das davon, ChatGPT direkt Fragen zu Daten zu stellen?
Fragen und Antworten eignen sich meist für einmalige Aufgaben; die Ergebnisse lassen sich nur schwer reproduzieren. Ein Programmieragent erstellt dagegen einen Prozess, der sich wiederholt ausführen lässt. Nach einer Datenaktualisierung kann er erneut gestartet und bei einer Änderung der Methodik angepasst werden. Genau das ist gemeint, wenn aus einem komplexen Analyseprojekt eine wiederholbare Fähigkeit wird.
F3: Wann wurde dieses Beispiel veröffentlicht?
OpenAI veröffentlichte das Beispiel am 3. November 2026. Es zeigt, wie Programmieragenten in jüngerer Zeit in Unternehmen eingesetzt werden. Konkrete Zahlen und Werkzeuge können sich ändern. Das Prinzip „Ausführung an den Agenten delegieren, Entscheidungen den Experten überlassen“ bleibt aber länger relevant.
F4: Für welche Datenprojekte eignet sich diese Aufgabenteilung besonders?
– **Zusammenführung öffentlicher Daten aus mehreren Quellen**: etwa Umwelt-, Klima- oder Bevölkerungsdatensätze verschiedener Institutionen
– **Regelmässige Berichte**: Compliance- und Offenlegungsberichte, die jedes Quartal oder jedes Jahr erstellt werden müssen
– **Massenbewertung auf Portfolioebene**: wenn Tausende Datensätze nach einheitlichen Kriterien bewertet werden müssen
F5: Wie kann ich schnell loslegen, wenn der Prozess ein Grosses Sprachmodell aufrufen muss?
Registrieren Sie sich zunächst bei APIYI apiyi.com und rufen Sie über dieselbe Schnittstelle mehrere gängige Modelle auf. Vergleichen Sie anhand einer kleinen Auswahl repräsentativer Beispiele deren Klassifizierungs- oder Extraktionsergebnisse. Wenn die Ergebnisse stabil sind und einheitlichen Kriterien entsprechen, können Sie die Modelle in den regulären Prozess einbinden. Der Vergleich mehrerer Modelle kann auch die manuelle Validierung unterstützen.
F6: Wie gründlich sollte die manuelle Validierung sein?
Das Beispiel legt weder die Validierungsmethode noch die Fehlerquote offen. Üblicherweise legt man vorab den Stichprobenumfang und akzeptable Fehlergrenzen fest, prüft alle von automatischen Kontrollen markierten Auffälligkeiten einzeln und kontrolliert unauffällige Ergebnisse anhand zufälliger Stichproben. Zusätzlich werden die Ergebnisse mit bekannten externen Referenzwerten verglichen. Alle Prüfprotokolle sollten für spätere Audits aufbewahrt werden.
F7: Welche Grenzen hat dieses Modell?
Erstens beruhen die Effizienzangaben auf Schätzungen des Unternehmens und wurden nicht unabhängig überprüft. Zweitens müssen auch Nichtentwickler in der Lage sein, ihre Methodik klar zu beschreiben – sonst verstärkt der Agent nur die Unklarheiten. Drittens erwähnt das Beispiel keine Schwierigkeiten oder gescheiterten Versuche. In der Praxis kann ein Prozess Fehler produzieren, die man selbst nicht versteht. Dann ist gegebenenfalls Unterstützung von technischen Kollegen bei der Fehlersuche nötig.
F8: Warum ist es so wichtig, die Methodik selbst zu beherrschen?
Wenn das Team die Methodik selbst beherrscht, kann es sie bei der nächsten Datenaktualisierung, neuen regulatorischen Anforderungen oder Rückfragen von Investoren direkt anpassen und erklären – ohne erneut Berater hinzuzuziehen. Genau diese langfristige Eigenständigkeit meint Julia mit: „Wir besitzen diese Methodik jetzt und können sie selbst weiterentwickeln.“
Die wichtigsten Erkenntnisse zum Codex-Datenverarbeitungsprozess für Nicht-Entwickler
- Klare Aufgabenteilung: Agenten übernehmen Datensuche, Bereinigung, Qualitätskontrolle und Abläufe; Methodik und Validierung bleiben bei den Fachleuten.
- Erst die Methodik: Zunächst den Bewertungsrahmen dokumentieren, dann die Agenten nach diesem Dokument arbeiten lassen.
- Unabhängige Validierung: Automatische Prüfungen, manuelle Stichproben und der Abgleich mit externen Benchmarks sind alle drei unverzichtbar.
- Wiederholbarkeit ist entscheidend: Ein Prozess, der sich erneut ausführen lässt, ist ein wertvolles Gut. Ein einmaliges Ergebnis lässt sich nicht weiterentwickeln.
- Zahlen mit Vorsicht betrachten: Die Reduktion von 5 Personen über 1 Jahr auf 2 Personen über 2 Monate ist eine Schätzung und lässt sich nicht ohne Weiteres übertragen.
- Modellvergleiche unterstützen die Validierung: Wo ein Großes Sprachmodell benötigt wird, lassen sich über die einheitliche Schnittstelle von APIYI mehrere Modelle für Gegenprüfungen nutzen.
Fazit
Wenn Menschen ohne Entwicklerhintergrund mit Codex Datenverarbeitungsprozesse aufbauen, sind nicht die Effizienzzahlen das Wichtigste, sondern die klare Aufgabenverteilung:
- Der Agent übernimmt die Ausführung: Datensuche, Bereinigung und Standardisierung, Qualitätsprüfungen und die Einrichtung wiederholbarer Prozesse lassen sich an ihn delegieren.
- Fachleute treffen die Entscheidungen: Die Entwicklung der Methodik und die Validierung der Ergebnisse sind entscheidend dafür, dass Schlussfolgerungen vertrauenswürdig und nachvollziehbar sind.
- Kompetenzen bleiben erhalten: Wer die Methodik selbst beherrscht und Prozesse erneut ausführen kann, macht aus einem einmaligen Projekt eine Fähigkeit, die sich im Unternehmen kontinuierlich weiterentwickeln lässt.
Wenn Sie gerade an einem Projekt arbeiten, dessen Daten verstreut sind und für das keine technischen Ressourcen verfügbar sind, schreiben Sie zunächst die Methodik auf und beginnen Sie mit einem Pilotprojekt in kleinem Rahmen. Bei Prozessschritten mit Aufrufen großer Sprachmodelle können Sie über APIYI apiyi.com die Leistung mehrerer Modelle über eine einheitliche Schnittstelle vergleichen. Das bietet eine zusätzliche Absicherung bei der manuellen Validierung.
📚 Quellen
- OpenAI-Kundenbeispiel – Heimstaden: Heimstaden modernisiert die Verwaltung von Wohnimmobilien mit ChatGPT und Codex.
- Link:
openai.com/index/heimstaden/ - Hinweis: Einzige Quelle für die Fakten zum Fallbeispiel in diesem Artikel; enthält die Aufgabenverteilung und Schätzwerte für das Projekt zur Bewertung von Umweltrisiken.
Autor: Das Technikteam von APIYI
Technischer Austausch: Kontaktieren Sie uns gerne über die Startseite von APIYI. Weitere Informationen zur Anbindung von Modellen finden Sie im Dokumentationszentrum unter docs.apiyi.com.