Anmerkung des Autors: Ausgehend vom Design des DeepSeek-Superagenten analysieren wir, wie Router und Worker in einem Multiagentensystem auf Modelle verteilt werden – und wie Cache-Lese-Token die Architekturkosten beeinflussen.
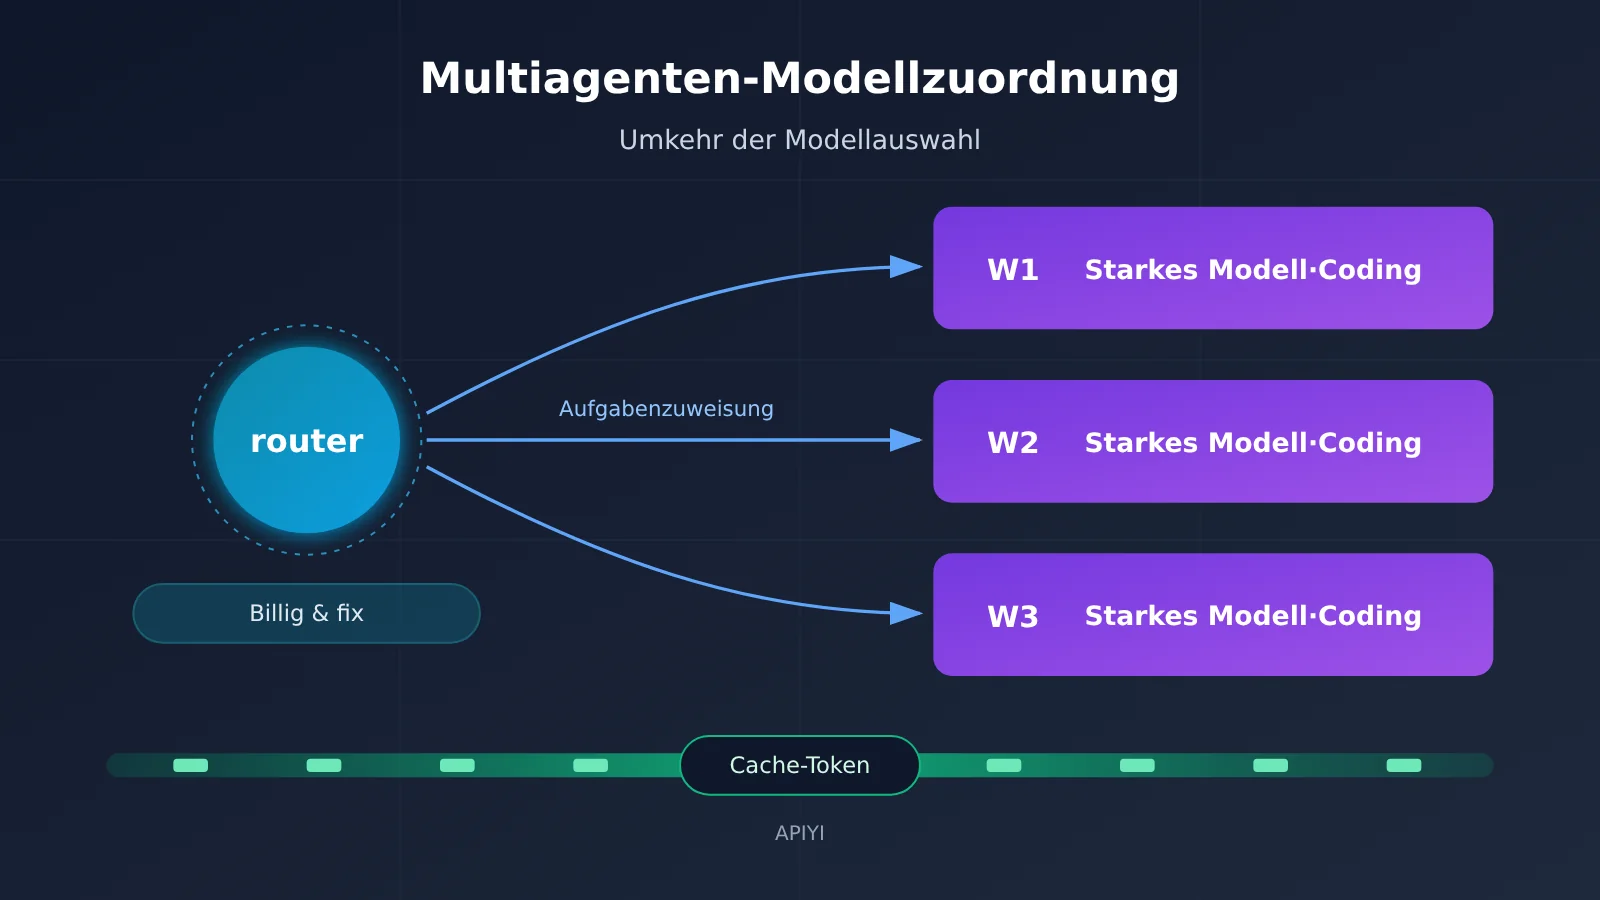
Beim Aufbau eines Multiagentensystems für die Softwareentwicklung statten die meisten den „Kommandanten“ mit dem stärksten Modell aus und lassen die ausführenden Agenten günstigere Modelle nutzen. Das vom DeepSeek-Harness-Team im November 2026 veröffentlichte Design eines Superagenten verfolgt den umgekehrten Ansatz: ein günstiges Modell für den Router, starke Modelle für die Worker. Der Router, der den Dialog führt und Aufgaben verteilt, nutzt ein leichtgewichtiges Modell. Die Worker, die den Code schreiben, verwenden das stärkste Modell.
Dieser Artikel gibt nicht einfach eine Nachricht wieder. Wir übersetzen die Architektur in konkrete Entscheidungshilfen für die Modellwahl: Welche Fähigkeiten braucht der Router, welche die Worker? Wie lassen sich Cache-Lese-Token schätzen? Und wann lohnt sich ein günstiges Modell? DeepSeek selbst bezeichnet die zitierten Testergebnisse lediglich als „indikativ“ – wir zeigen, wo ihre Grenzen liegen.
Der praktische Nutzen: Nach der Lektüre können Sie für Ihr Multiagentensystem einen Plan zur rollenbasierten Modellverteilung erstellen und anhand der Cache-Lese-Token die Größenordnung der Kosten grob abschätzen.
Die wichtigsten Punkte zur Modellzuweisung in Multi-Agenten-Systemen
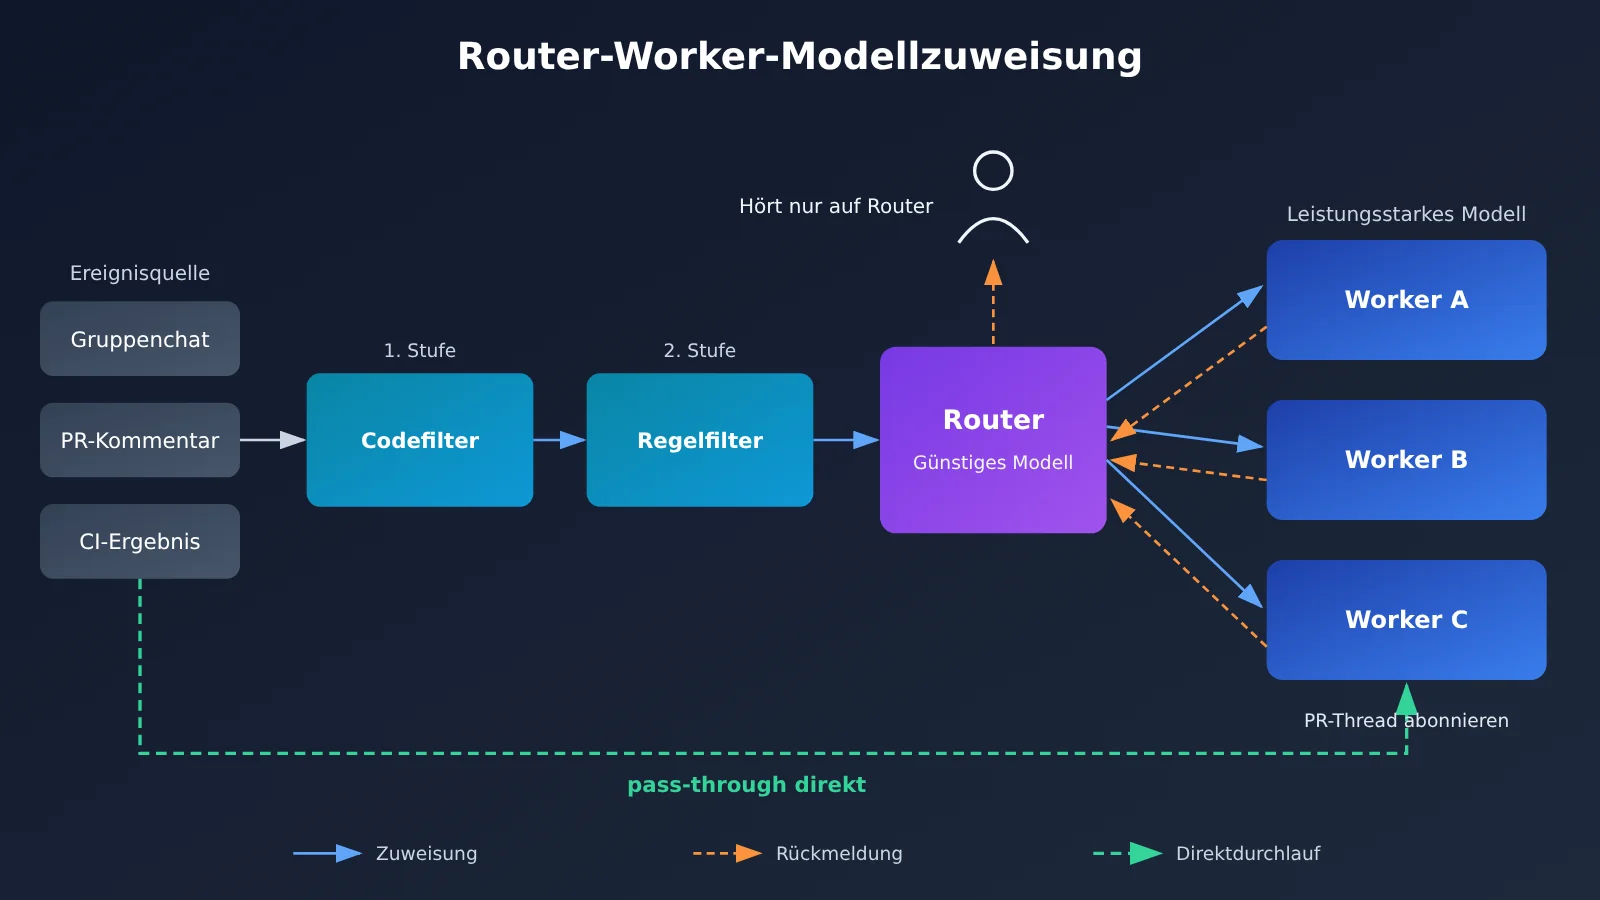
DeepSeeks Architektur besteht aus zwei Ebenen. Der router ist eine langlebige Sitzung: Er kommuniziert mit Menschen, verteilt Aufgaben und behält die Beziehungen zwischen ihnen im Blick. Jeder worker übernimmt jeweils nur eine Aufgabe und arbeitet mit einem eigenen, unbelasteten Kontext. Er kommuniziert nie direkt mit Menschen, sondern meldet seinen Status ausschließlich an den router. Aus dieser Arbeitsteilung ergibt sich folgende Modellzuweisung als Ausgangspunkt:
| Rolle | Kernaufgabe | Schreibt Code? | Empfohlene Modellklasse | Begründung |
|---|---|---|---|---|
| router | Kommunikation, Aufgabenverteilung, Nachverfolgung von Aufgabenbeziehungen | Nein, Shell-Zugriff ist nicht nötig | Leichtgewichtig, günstig, schnell | Einfache Aufgaben, aber häufige Aufrufe; Latenz und Preis pro Aufruf sind wichtiger |
| worker | Eine einzelne Aufgabe übernehmen und den Code schreiben | Ja | Das stärkste derzeit verfügbare Coding-Modell | Die Codequalität bestimmt unmittelbar das Ergebnis |
| Trigger-Filterschicht | Rauschen aus Gruppenchats und CI-Benachrichtigungen herausfiltern | Nein | Erste Stufe mit gewöhnlichem Code, zweite Stufe mit einem kleinen Modell | Die meisten Ereignisse müssen nicht an ein Modell weitergegeben werden |
Warum die Modellzuweisung bei Multi-Agenten-Systemen „umgekehrt“ sein sollte
DeepSeek geht davon aus, dass der Engpass beim KI-gestützten Programmieren nicht mehr die Fähigkeiten der Modelle sind, sondern die Aufmerksamkeit der Menschen. Eine Person kann üblicherweise nur 3 bis 5 aktive Agentensitzungen gleichzeitig verfolgen. Bei mehr Sitzungen verliert sie leicht den Überblick: Welche wartet auf eine Freigabe, welche steckt fest und welche beiden bearbeiten unbemerkt denselben PR?
Der Wert des routers liegt deshalb nicht darin, besonders „intelligent“ zu sein, sondern Aufgaben zuverlässig zu verteilen und den Überblick zu behalten. Er zerlegt Aufgaben nicht, sondern weist sie nur zu und verfolgt ihren Status. Das unterscheidet ihn vom verbreiteten Muster, bei dem ein Hauptagent Aufgaben in einzelne Schritte zerlegt.
Da der router weder tiefgehend nachdenken noch Code schreiben muss, wäre das teuerste Modell an dieser Stelle verschwendet. Der Code entsteht bei den workern, und seine Qualität entscheidet über Erfolg oder Misserfolg der Lieferung. Dort sollte das Budget für leistungsstarke Modelle hinfließen. Das ist mit der „umgekehrten Modellwahl“ gemeint: Je näher eine Rolle am Nutzer ist, desto leichtgewichtiger das Modell; je näher sie am Code ist, desto leistungsfähiger.
Welche Fähigkeiten brauchen router und worker?
Erst wenn die Aufgaben der Rollen in konkrete Fähigkeiten aufgeschlüsselt sind, lassen sich passende Modelle auswählen. Die folgende Liste hilft bei der Bewertung von Kandidaten.
| Fähigkeit | Anforderungen an router | Anforderungen an worker | Hinweis zur Modellauswahl |
|---|---|---|---|
| Anweisungen befolgen und klassifizieren | Hoch: Aufgaben müssen zuverlässig zugeordnet werden | Mittel | Beim router vor allem die Genauigkeit der Aufgabenzuweisung testen |
| Langer Kontext und Rückverfolgung | Mittel: Details werden schrittweise über IDs und Zusammenfassungen erschlossen | Hoch: Muss viel Code lesen | Beim worker auf Kontextfenster und Codesuche achten |
| Qualität der Codegenerierung | Nicht erforderlich | Höchste Priorität | Beim worker-Budget nicht sparen |
| Antwortlatenz | Hohe Priorität: Trifft häufig Entscheidungen | Mittel: Einzelne Aufgaben dürfen etwas länger dauern | Für den router schnelle Modelle der Flash-Klasse wählen |
| Preissensibilität | Sehr hoch: Große Datenmengen werden aus dem Cache gelesen | Mittel | Der Einzelpreis des routers wirkt sich auf die Gesamtkosten aus |
| Tool-Aufrufe | Wenige: Shell-Zugriff ist nicht zwingend nötig | Viele: Muss Code ausführen und testen | Rollen durch Berechtigungsgrenzen einschränken |
Eine weitere Anforderung an den router wird leicht übersehen: Er darf strukturell nicht selbst Hand anlegen können. DeepSeek hat dem router bewusst keine Shell-Berechtigung gegeben, damit er Aufgaben nicht direkt ausführen kann. Bei der Modellauswahl muss der router also nicht „alles können“ – es ist sogar gewollt, dass er „nur Aufgaben verteilt“.
Cache-Token-Kosten bei der Modellzuweisung für mehrere Agenten
Ein günstiger router allein reicht nicht: Der größte Kostenfaktor dieser Architektur sind die Token für Cache-Lesezugriffe. Der router läuft in einer langfristigen Sitzung und liest den zwischengespeicherten Kontext immer wieder ein. Gleichzeitig laufen mehrere worker parallel, die jeweils ebenfalls große Mengen an Kontext lesen. Die Testdaten von DeepSeek zeigen das Problem anschaulich.
| Testmetrik | Wert | Erläuterung |
|---|---|---|
| Nachrichten pro Runde | ca. 300 | Davon sind etwa 20 tatsächliche Arbeitsaufträge |
| Durchschnittliche Bearbeitungszeit des Superagenten | 12,4 Minuten | Am langsamen Ende waren es 15,7 Minuten |
| Langsamer Vergleichswert bei einer einzelnen Sitzung | 29,5 Minuten | Als Referenz |
| Entscheidungslast des router | Anstieg von ca. 1 auf ca. 40 Entscheidungen pro Minute | Die Dauer pro Entscheidung sank von 6,4 auf 1,6 Sekunden |
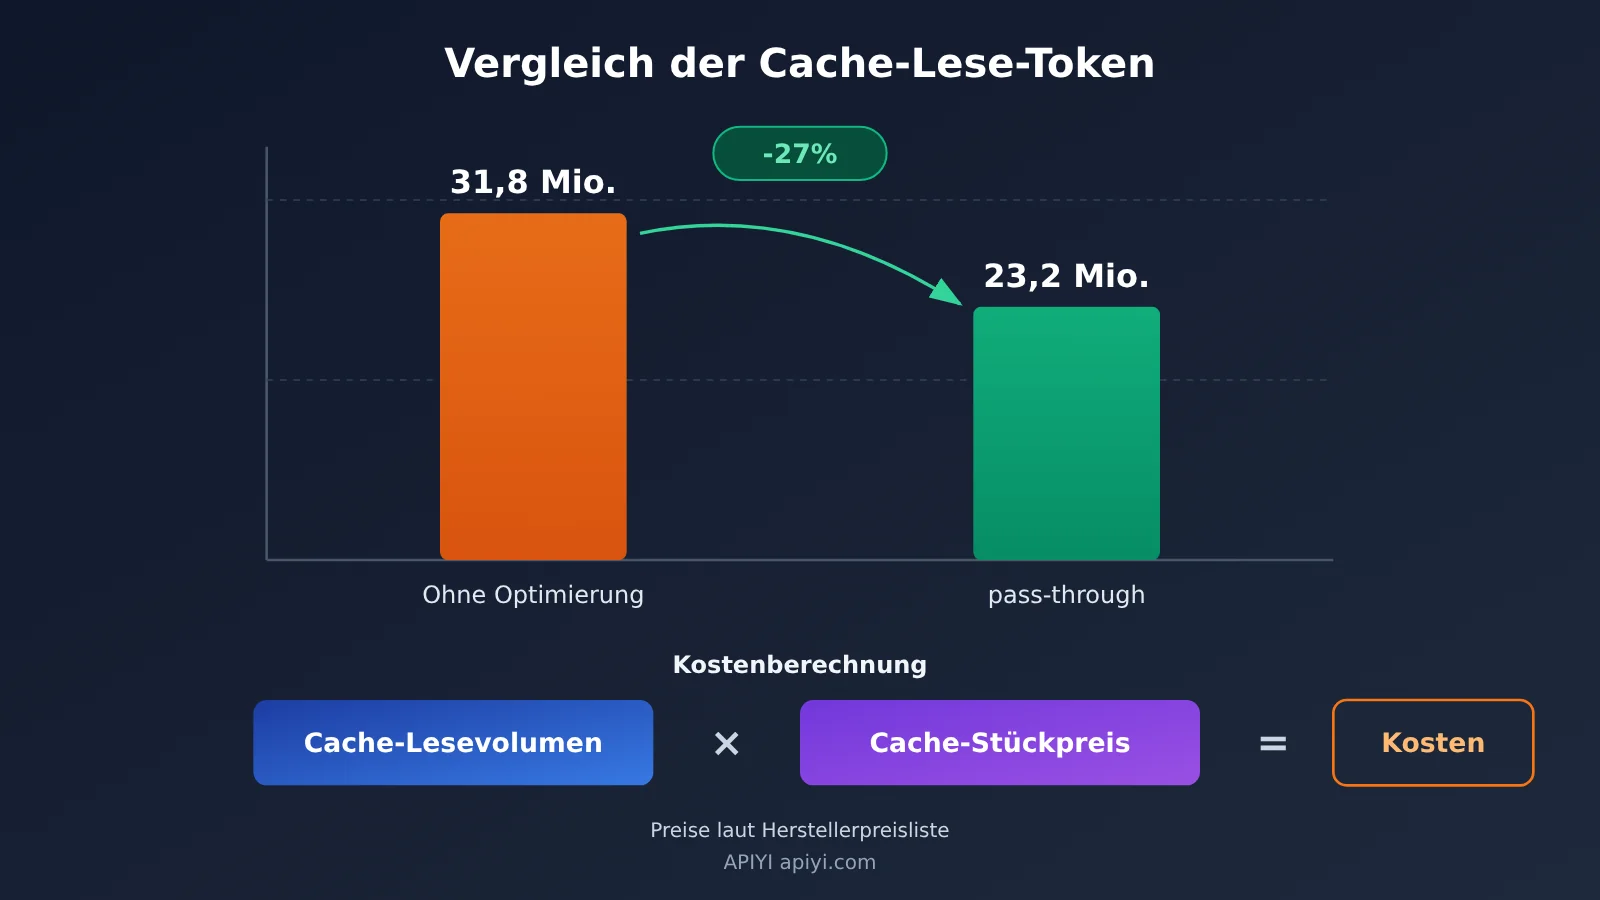
| Token für Cache-Lesezugriffe | 23,2 Millionen | Mit aktivierter Pass-through-Optimierung |
| Cache-Lesezugriffe ohne Optimierung | 31,8 Millionen | Wenn worker den Thread nicht direkt abonnieren |
| Cache-Kosten | ca. 7 US-Dollar | Nach DeepSeeks eigenem Flash-Tarif für Zeiten mit geringer Auslastung |
Kosten der Modellverteilung in Multi-Agenten-Systemen anhand der Cache-Lesemenge schätzen
Die Kosten eines Durchlaufs lassen sich in drei Teile aufteilen: Cache-Lese-Token mal Cache-Lesepreis, nicht im Cache gefundene Eingabe-Token mal Eingabepreis und Ausgabe-Token mal Ausgabepreis. In einer Router-Worker-Architektur macht der erste Posten oft den mit Abstand größten Anteil aus. Deshalb solltest du bei der Modellauswahl vor allem auf den Cache-Lesepreis achten.
Aus den berichteten Zahlen lässt sich ein Näherungswert ableiten: Rund 7 US-Dollar für 23,2 Millionen Cache-Lese-Token entsprechen etwa 0,3 US-Dollar pro Million Token. Das ist kein offizieller Preis, sondern lediglich eine Schätzung auf Basis der berichteten Zahlen. Maßgeblich ist die aktuelle Preisliste des jeweiligen Modellanbieters. Mit diesem Richtwert kannst du die Cache-Lesepreise infrage kommender Modelle einsetzen und schnell abschätzen, um welchen Faktor ein teureres Modell die Kosten für dieselbe Arbeitslast erhöhen würde.
Auch die Pass-through-Optimierung selbst ist bemerkenswert: Nachdem ein Worker einen Thread abonniert hat, erreichen ihn neue Ereignisse direkt, ohne dass der Router sie weiterleiten muss. Dadurch sank die Cache-Lesemenge von 31,8 auf 23,2 Millionen Token – eine Reduktion um rund 27 %. Optimierungen auf Architekturebene können die Rechnung also ebenso direkt senken wie der Wechsel zu einem günstigeren Modell.
Drei Grenzen der Originaldaten
- Das Programmieren wurde simuliert: Im Test ersetzte ein Tool, das lediglich Zeit verbraucht, das „Code schreiben“. Gemessen wurde das Scheduling-Verhalten, nicht die Codequalität. Daraus lässt sich also nicht ableiten, welches Modell sich am besten für Worker eignet.
- Die Daten sind nur als Anhaltspunkt zu verstehen: DeepSeek bezeichnet die Zahlen ausdrücklich als indikativ, nicht als Ergebnisse eines strengen Benchmark-Tests.
- Der Preisvergleich mit der Sonnet-Klasse ist widersprüchlich: Die Zusammenfassung des Berichts nennt bei einer Schätzung auf Sonnet-Niveau rund 4,64 US-Dollar. Im Haupttext heißt es dagegen, dieselbe Nutzung wäre in der höheren Preisklasse „deutlich teurer“. Bevor der Originalartikel von DeepSeek geprüft wurde, sollte dieser konkrete Preisvergleich nicht zitiert werden.
Schnelleinstieg: Modelle in Multi-Agenten-Systemen zuweisen
Um den oben beschriebenen Ansatz im eigenen System umzusetzen, kannst du wie folgt vorgehen. Hier gibt es keinen Code: Alle Konfigurationsoptionen sind inline beschrieben, damit du sie leichter mit deinem Framework abgleichen kannst.
- Erst Rollen aufteilen, dann Modelle wählen: Liste alle Rollen auf, die in deinem System Modelle aufrufen. Unterscheide mindestens zwischen router, worker und Trigger-Filterung. Halte für jede Rolle fest, ob sie Code schreibt und ob sie Tools benötigt.
- Modellnamen konfigurierbar machen: Lege für jede Rolle eigene Parameter wie
router_model,worker_modelundfilter_modelan. Schreibe Modellnamen nicht fest in den Anwendungscode. - Delegation durch die Systemstruktur sicherstellen: Entziehe dem router ausführende Tools wie die Shell. Die Experimente von DeepSeek zeigen: Ein Agent mit einer einzelnen Sitzung delegierte bei neutraler Eingabeaufforderung in keinem von fünf Durchläufen; der langsamste Durchlauf dauerte fast eine halbe Stunde. Selbst als die Eingabeaufforderung ausdrücklich Delegation verlangte, hielt der Agent die Aufgabe in einem von fünf Fällen für zu klein und erledigte sie selbst.
- Erst filtern: Filtere bei Trigger-Ereignissen zunächst mit gewöhnlichem Code anhand der Ereignisquelle und einer Allowlist irrelevante Ereignisse heraus. Nur die verbleibenden Ereignisse gehen an das Modell, das sie nach den Teamregeln beurteilt.
- Aus dem Cache gelesene Token erfassen: Erfasse pro Durchlauf drei Token-Kategorien: Cache-Lesezugriffe, nicht gecachte Eingabe und Ausgabe. Berechne damit anhand der obigen Formel die Kosten pro Durchlauf.
- Modelle vergleichen: Lass den Aufgabensatz unverändert und ersetze nur
router_model. Beobachte, wie sich Zuweisungsgenauigkeit, Latenz und Kosten ändern, bevor du dich für ein günstigeres Modell entscheidest.
Bei Schritt 2 und Schritt 6 beeinflusst die Art der Anbindung direkt, wie effizient du experimentieren kannst. Wenn router und worker von verschiedenen Anbietern stammen und du für jeden eigene Schlüssel und SDK-Konfigurationen pflegst, musst du bei jedem Wechsel vieles anpassen. Über eine Plattform mit einheitlicher Schnittstelle wie APIYI apiyi.com kannst du mit demselben API-Schlüssel und demselben OpenAI-kompatiblen Anfrageformat arbeiten. Du änderst nur den Parameter model, um router und worker Modelle verschiedener Anbieter zuzuweisen. Das senkt den Aufwand für Vergleichstests erheblich.
🚀 Tipp für den Schnelleinstieg: Konfiguriere für einen ersten Prototyp auf APIYI apiyi.com die Modellparameter für router und worker mit demselben Schlüssel. Führe dann dieselben Aufgaben aus und erfasse den Token-Verbrauch. Welche Modelle verfügbar sind – etwa Modelle der Flash-Klasse von DeepSeek –, siehst du in der aktuellen Modellliste der Plattform.
Wann sich günstige Modelle für einzelne Rollen im Multi-Agenten-System lohnen
Günstige Modelle eignen sich nicht für jede Aufgabe. Die folgende Tabelle hilft bei der Entscheidung, für welche Rollen ein günstigeres Modell sinnvoll ist.
| Szenario | Empfehlung | Grund | Zugang |
|---|---|---|---|
| Die Rolle übernimmt nur die Verteilung, Nachverfolgung und Prüfung von Cache-Kontext | Günstiges, schnelles Modell wählen | Die Aufgaben sind einfach; Preis pro Aufruf und Latenz bestimmen das Nutzererlebnis | APIYI apiyi.com oder offizielle API des Anbieters |
| Die Rolle erzeugt und ändert Code | Leistungsstarkes Modell wählen | Die Codequalität entscheidet über das Ergebnis | APIYI apiyi.com oder offizielle API des Anbieters |
| Die gelesene Cache-Menge erreicht einen zweistelligen Millionenbereich und der Vorgang läuft täglich | Preis für Cache-Lesezugriffe vorrangig senken | Die Cache-Kosten steigen linear mit der Anzahl der Durchläufe | Anhand der Preisliste des Anbieters berechnen |
| Gelegentliche, einfache Einzelaufgaben | Nutzungsbasierte Abrechnung reicht aus | Das Nutzungsvolumen ist gering; eine komplexere Architektur lohnt sich nicht | Beliebiger nutzungsbasierter Zugang |
| Häufige, tokenintensive Automatisierungsaufgaben | Monatspaket oder Tarif mit hohen Limits prüfen | Die Grenzkosten einzelner Durchläufe schlagen sich nicht mehr auf der Rechnung nieder | Abhängig von den jeweiligen Abo-Bedingungen |
Als Vergleichspunkt für die letzte Zeile: Einem zeitgleich erschienenen Bericht zufolge kostet der Claude Code Pass 9,99 US-Dollar pro Monat. Für offene Modelle wie Kimi K3.1 Pro, GLM 5.3 und DeepSeek V4.1 Flash bietet er etwa zwei- bis fünfmal so hohe Ratenlimits sowie Nutzungsobergrenzen für fünf Stunden, eine Woche und einen Monat. Der Bericht kommt ausserdem zu dem Schluss, dass schnelle, günstige Modelle für Routing-Entscheidungen oder die Prüfung von Cache-Kontext auch technisch besser geeignet sind – und nicht nur Geld sparen. Solche Angebote binden dich allerdings an die Modelle im Paket. Wenn ein Worker ein Modell ausserhalb des Pakets benötigt, brauchst du dafür weiterhin einen separaten Zugang.
Risiken und Grenzen der Modellzuweisung in Multi-Agenten-Systemen
Die Modellzuweisung löst Kosten- und Arbeitsteilungsfragen, aber nicht die grundlegenden Probleme dieser Architektur. DeepSeek räumt zwei ungelöste Fragen ein: Erstens das Langzeitgedächtnis. Es bleibt schwierig, nach mehreren Monaten Systembetrieb relevante Informationen aus der Vergangenheit zu erhalten, ohne das Kontextfenster zu sprengen. Zweitens Prompt-Injection: Jeder Agent, der externe Ereignisse wie Gruppenchats oder PR-Kommentare liest, kann manipuliert werden. Da Router und Worker über eine gemeinsame Cloud-Schleife verbunden sind, könnte eine kompromittierte Ereignisquelle theoretisch Anweisungen an jeden Rechner weiterverbreiten, mit dem das System in Kontakt kommt.
Das wirkt sich direkt auf die Modellzuweisung aus. Nur weil der Router ein günstiges Modell nutzt, darf sein Schutz nicht vernachlässigt werden – schließlich kommt er als Erster mit externen Ereignissen in Kontakt. Bei DeepSeeks interner Einführung wurden proaktive Aktionen zunächst nur im Modus „Das hätte ich getan“ protokolliert, statt sofort ausgeführt zu werden. Ein Beispiel ist die Strategie „still reproduzieren und beheben“: Meldet jemand einen Bug, versucht der Agent im Hintergrund, ihn zu reproduzieren. Erst wenn er den Fehler bestätigt und behoben hat, reicht er während der laufenden Unterhaltung einen PR ein. Gelingt die Reproduktion nicht, sendet er nichts. Bei der Einführung eines neuen Systems ist es sicherer, zunächst die Logs zu beobachten und erst danach schrittweise mehr Befugnisse zu erteilen.
Außerdem ist der Prototyp DSH Super Agent auf GitHub ausdrücklich als Forschungscode und nicht als fertiges Produkt gekennzeichnet. Seine Designideen als Inspiration zu nutzen, ist sinnvoll; eine direkte Bereitstellung in der Produktionsumgebung ist jedoch nicht zu empfehlen.
Häufig gestellte Fragen (FAQ)
Q1: Was bedeutet „umgekehrte Modellauswahl“ in einem Multi-Agenten-System?
Der Router nutzt ein leichtgewichtiges, günstiges Modell, während für den Worker das leistungsstärkste Modell zum Einsatz kommt. Der Router übernimmt nur die Kommunikation, Zuweisung und Nachverfolgung von Aufgaben und schreibt keinen Code. Der Worker programmiert selbst – deshalb sollte das Budget für das leistungsstarke Modell beim Worker liegen und nicht bei der „Kommandozentrale“.
Q2: Wie unterscheidet sich die Router-Worker-Architektur von einem Hauptagenten, der Aufgaben zerlegt?
Beim Hauptagenten-Modell zerlegt der Hauptagent die Aufgabe in einzelne Schritte. Dafür braucht er ausgeprägte Schlussfolgerungsfähigkeiten. DeepSeeks Router zerlegt Aufgaben nicht, sondern weist sie nur zu und verfolgt ihren Fortschritt. Deshalb reicht ein leichteres Modell aus. Der Nachteil: Der Worker muss die gesamte Aufgabe selbstständig erledigen können.
Q3: Wann wurde dieses Design veröffentlicht? Kann man DSH Super Agent direkt einsetzen?
Der entsprechende Bericht erschien am 3. November 2026. DSH Super Agent ist ein Forschungsprototyp, der zusammen mit dem Artikel über das Design auf GitHub veröffentlicht wurde. Offiziell ist er kein unterstütztes Produkt und eignet sich nur dazu, die Architektur zu verstehen.
Q4: Kann ein einzelner Agent allein durch eine Eingabeaufforderung lernen, Aufgaben zu delegieren?
DeepSeeks Tests zeigen, dass das nicht zuverlässig funktioniert: Bei einer neutralen Eingabeaufforderung gab es in fünf Durchläufen keine einzige Delegierung. Selbst bei einer Eingabeaufforderung, die Delegierung ausdrücklich betonte, wurde in einem Durchlauf nicht delegiert. Zuverlässige Delegierung erfordert eine strukturelle Trennung, etwa durch separate Sitzungen und das Entfernen von Ausführungswerkzeugen – nicht einfach längere Eingabeaufforderungen.
Q5: Wie lassen sich Modelle verschiedener Anbieter für Router und Worker bequem im selben System konfigurieren?
Entscheidend ist, die Modellnamen als separate Konfigurationseinstellungen pro Rolle anzulegen und einen einheitlichen Zugriffsweg zu verwenden:
1. Bei APIYI auf apiyi.com registrieren und einen API-Schlüssel abrufen
2. In der Systemkonfiguration den Parameter `model` für Router und Worker getrennt festlegen
3. Für Vergleichstests das Anfrageformat beibehalten und nur den Modellnamen austauschen
So muss nicht für jeden Anbieter eine eigene SDK-Konfiguration gepflegt werden. Welche Modelle verfügbar sind, zeigt die aktuelle Liste der Plattform.
Q6: Lassen sich die Kostendaten aus dem Original direkt für die Budgetplanung verwenden?
Davon ist abzuraten. Die Programmierung wurde simuliert, die Daten sind nur Anhaltswerte und die Aussagen zum Preisvergleich mit Modellen der Sonnet-Klasse sind nicht durchgehend konsistent. Besser ist es, die aus dem Cache gelesene Token-Menge mit eigenen Aufgaben zu messen und mit dem aktuellen Einzelpreis zu multiplizieren. Auf APIYI unter apiyi.com können Sie dieselben Aufgaben jeweils mit einem anderen Modell ausführen und so Daten für Ihren eigenen Anwendungsfall erhalten.
Q7: Welche bekannten Einschränkungen hat diese Architektur?
Es gibt drei wesentliche Einschränkungen: Das Erinnerungsvermögen lässt bei langer Laufzeit nach; beim Einlesen externer Ereignisse besteht das Risiko einer Eingabeaufforderungsinjektion; und die Menge der aus dem Cache gelesenen Token ist sehr hoch, wodurch die Kosten bei teuren Modellen deutlich steigen. Zudem fehlen derzeit Daten dazu, wie gut bestimmte Modelle als Router funktionieren. Das muss man selbst testen.
Die wichtigsten Erkenntnisse zur Modellzuweisung in Multi-Agenten-Systemen
- Umgekehrte Modellwahl: Der Router nutzt ein günstiges, leichtgewichtiges Modell, die Worker schreiben Code mit leistungsstarken Modellen.
- Aufmerksamkeit als Engpass: Menschen können meist nur 3 bis 5 Sitzungen gleichzeitig im Blick behalten. Der Router bündelt die Kommunikation.
- Delegation durch Struktur: Dem Router die Ausführungswerkzeuge zu entziehen, ist deutlich zuverlässiger als die Eingabeaufforderung anzupassen.
- Cache-Zugriffe als größter Kostenfaktor: In einem Testlauf wurden 23,2 Millionen Tokens aus dem Cache gelesen. Entscheidend ist der Preis pro Token.
- Auch die Architektur senkt Kosten: Pass-through reduzierte die Cache-Lesezugriffe um rund 27 %.
- Daten vorsichtig verwenden: Die Codierung wurde simuliert, die Ergebnisse sind nur richtungsweisend. Preisvergleiche müssen überprüft werden.
- Über eine einheitliche Schnittstelle experimentieren: Bei APIYI apiyi.com genügt es, den Parameter
modelzu ändern, um verschiedene Zuweisungen zu vergleichen.
Zusammenfassung
Das Grundprinzip lautet: Der Router nutzt ein günstiges Modell, die Worker leistungsstarke Modelle. Für die Modellzuweisung in Multi-Agenten-Systemen sind drei Punkte entscheidend:
- Nach Aufgaben auswählen: Rollen, die keinen Code schreiben, sondern Aufgaben verteilen und nachverfolgen, nutzen günstige, schnelle Modelle. Für die Codierung kommen leistungsstarke Modelle zum Einsatz.
- Cache-Kosten einrechnen: Aus dem Cache gelesene Tokens sind bei dieser Architektur ein wesentlicher Kostenfaktor. Vergleichen Sie bei der Auswahl vor allem die Preise für Cache-Lesezugriffe.
- Anhand eigener Tests entscheiden: Die Daten aus dem Original liefern nur eine Orientierung. Kosten und Qualität sollten Sie mit Ihren eigenen Aufgaben messen.
Bauen Sie zunächst mit einer kleinen Auswahl an Aufgaben einen Router-Worker-Prototyp und machen Sie die Modellnamen pro Rolle konfigurierbar. Tauschen Sie dann schrittweise das Router-Modell aus und beobachten Sie, wie sich die Genauigkeit der Aufgabenzuweisung und die Kosten verändern. Für diesen Vergleich können Sie über APIYI apiyi.com mit einem einzigen Schlüssel auf Modelle verschiedener Anbieter zugreifen. So basiert Ihre Entscheidung auf eigenen Daten.
📚 Quellen
- DeepSeek’s Super Agent Harness: Fixing the Attention Bottleneck in AI Coding: Einordnung des Designs von DeepSeeks Super-Agent
- Link:
mindstudio.ai/blog/deepseek-super-agent-harness-design -
Inhalt: Router-Worker-Architektur, Delegationsexperimente, Daten zu gecachten Tokens und offene Fragen
-
Claude Code Pass Pricing: What’s in the $9.99/Month Plan: Einordnung des Monatsabos mit hohen Nutzungslimits
- Link:
mindstudio.ai/blog/claude-code-pass-pricing - Inhalt: Abwägung zwischen nutzungsbasierter Abrechnung und Monatsabo für Multi-Agenten- und tokenintensive Workflows
Autor: APIYI-Technikteam
Technischer Austausch: Kontaktieren Sie uns über die APIYI-Startseite apiyi.com, um über die Modellzuweisung in Multi-Agenten-Systemen zu sprechen. Weitere Informationen zur Integration finden Sie im Dokumentationszentrum unter docs.apiyi.com.