Anmerkung des Autors: Dieser Artikel analysiert die Token-Kosten langer Agent-Aufgaben, erklärt den hohen Anteil der Eingabe-Token und zeigt, wie sich der Kontext für eine bessere Wiederverwendung des Präfix-Caches strukturieren lässt.
Viele Teams bemerken das Problem erst beim Blick auf die Monatsrechnung, nachdem sie einen mehrstufigen Agenten in ihr Produkt eingebunden haben: Ein Nutzer stellt nur eine Anfrage, verbraucht aber zigmal so viele Token wie in einem gewöhnlichen Dialog. Der erste Gedanke lautet meist: „Das Modell gibt zu viel Text aus.“ Also wird die Ausgabelänge begrenzt. Tatsächlich entsteht der Großteil der Kosten auf der Eingabeseite – vor allem durch den bisherigen Kontext, der in jeder Runde erneut mitgegeben wird.
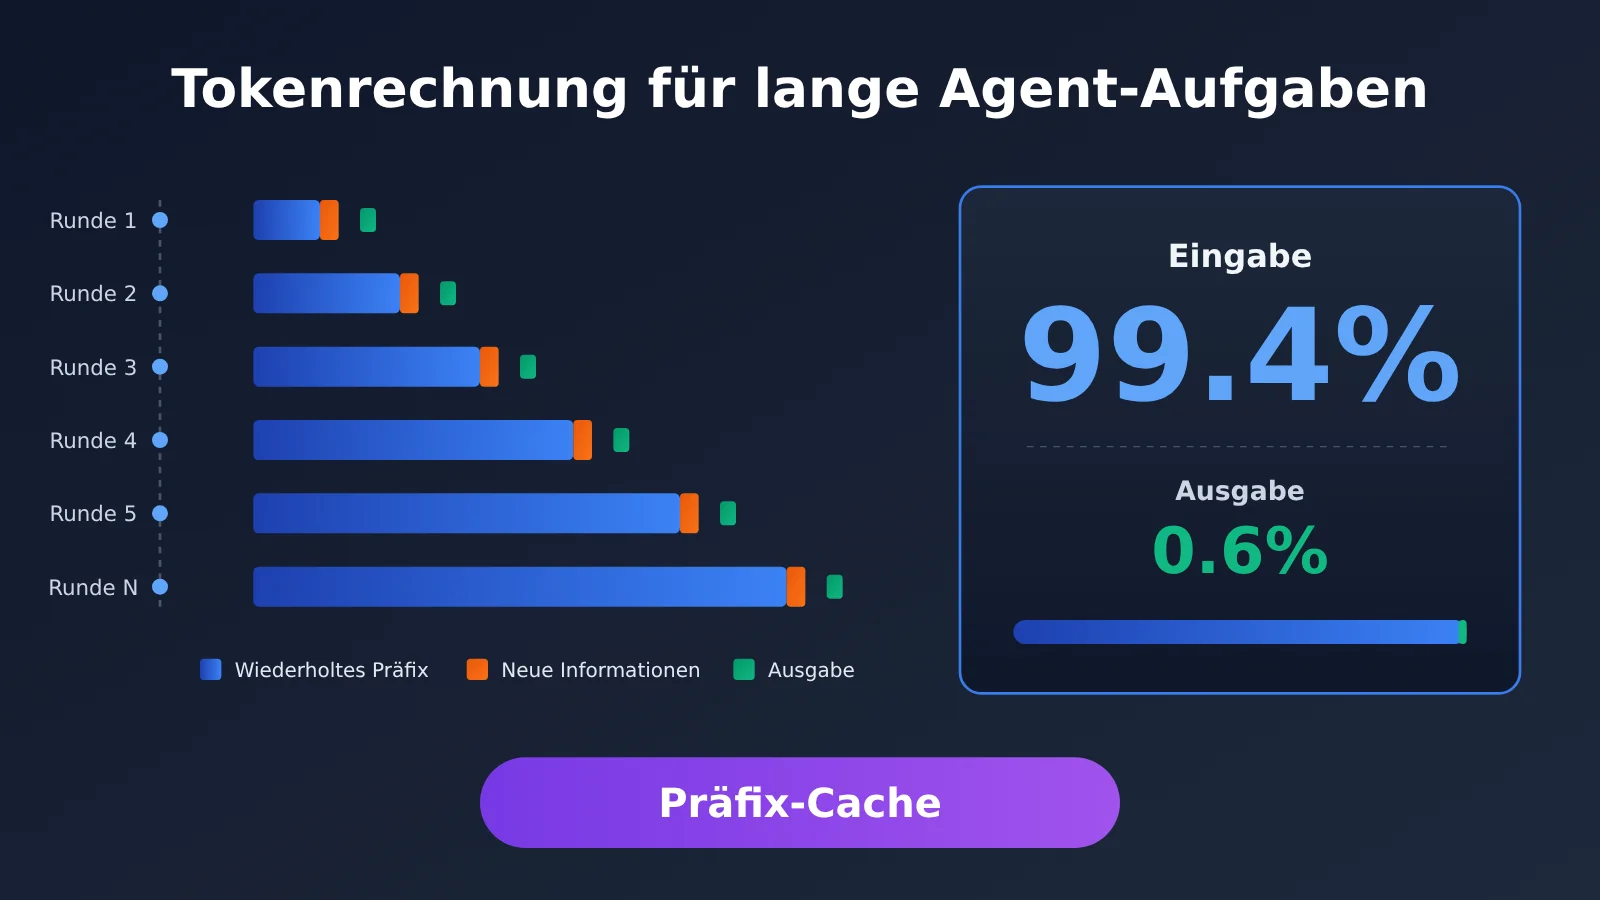
Das ist keine bloße Vermutung. Kürzlich veröffentlichte Erfahrungsberichte aus der Praxis liefern konkrete Zahlen: In chinesischen Produktionsumgebungen löst eine Nutzeranfrage im Durchschnitt etwa 7.2 Modellaufrufe aus. Bei einer Aufrufkette mit 50 Schritten entfallen rund 99.4% der Token auf die Eingabe und nur etwa 0.6% auf die Ausgabe. Teams, die Inferenz-Engines entwickeln, beschreiben Agent-Workloads ähnlich: lange Präfixe, kurze Ausgaben und mehrstufige Schleifen.
Das nehmen Sie mit: Nach der Lektüre verstehen Sie die Token-Kostenstruktur langer Agent-Aufgaben und wissen, warum Präfix-Caching Kosten senkt. Außerdem lernen Sie 5 Methoden kennen, mit denen sich der Kontext direkt auf Anwendungsebene besser organisieren lässt.
Die wichtigsten Punkte zu Token-Kosten bei langen Agent-Aufgaben
Die folgende Tabelle fasst die Ergebnisse zusammen. In den nächsten Abschnitten gehen wir auf die einzelnen Punkte ein.
| Punkt | Erklärung | Nutzen für dich |
|---|---|---|
| Die Zahl der Aufrufe vervielfacht sich | Eine Nutzeranfrage führt im Schnitt zu etwa 7,2 Modellaufrufen. Bei komplexen Aufgaben sind mehr als 50 Schritte keine Seltenheit | Kosten solltest du pro „Aufgabe“ schätzen, nicht pro „Anfrage“ |
| Der Eingabeanteil dominiert | In einer Aufrufkette mit 50 Schritten entfallen etwa 99,4 % auf die Eingabe und 0,6 % auf die Ausgabe | Konzentriere dich beim Sparen zuerst auf die Eingabe. Kürzere Ausgaben bringen vergleichsweise wenig |
| Wiederholter Kontext ist die Hauptursache | Bei jedem Schritt wird der bisherige Kontext erneut mitgeschickt. Derselbe Inhalt wird dadurch wiederholt abgerechnet | So erkennst du, wo die Kosten tatsächlich entstehen |
| Präfix-Caching ermöglicht Wiederverwendung | Identische Präfixe können aus dem Cache geladen werden. Das spart wiederholte Prefill-Berechnungen | Ein stabil strukturierter Kontext ist günstiger |
| Die Struktur bestimmt die Trefferquote | Eingabeaufforderungen und Werkzeugstrukturen stabil halten, veränderliche Informationen ans Ende setzen und den Verlauf bei Bedarf komprimieren | So lassen sich Kosten senken, ohne das Modell zu wechseln |
Token-Kosten bei langen Agent-Aufgaben im Detail
Der größte Unterschied zwischen einem Agenten und einem gewöhnlichen Chat liegt in der „Schleife“. Beim Erstellen einer PPT-Präsentation muss das System beispielsweise nacheinander Material lesen, Inhalte planen, einzelne Folien erzeugen, Werkzeuge für die Erstellung aufrufen und das Ergebnis prüfen. Für den Nutzer ist das eine Aufgabe. Im System besteht sie jedoch aus mehreren Schlussfolgerungsrunden und Werkzeugaufrufen. Dabei kann in jedem Schritt der Kontext erneut eingelesen werden. Ist das Ergebnis nicht zufriedenstellend, muss der Agent zurückgehen und es überarbeiten.
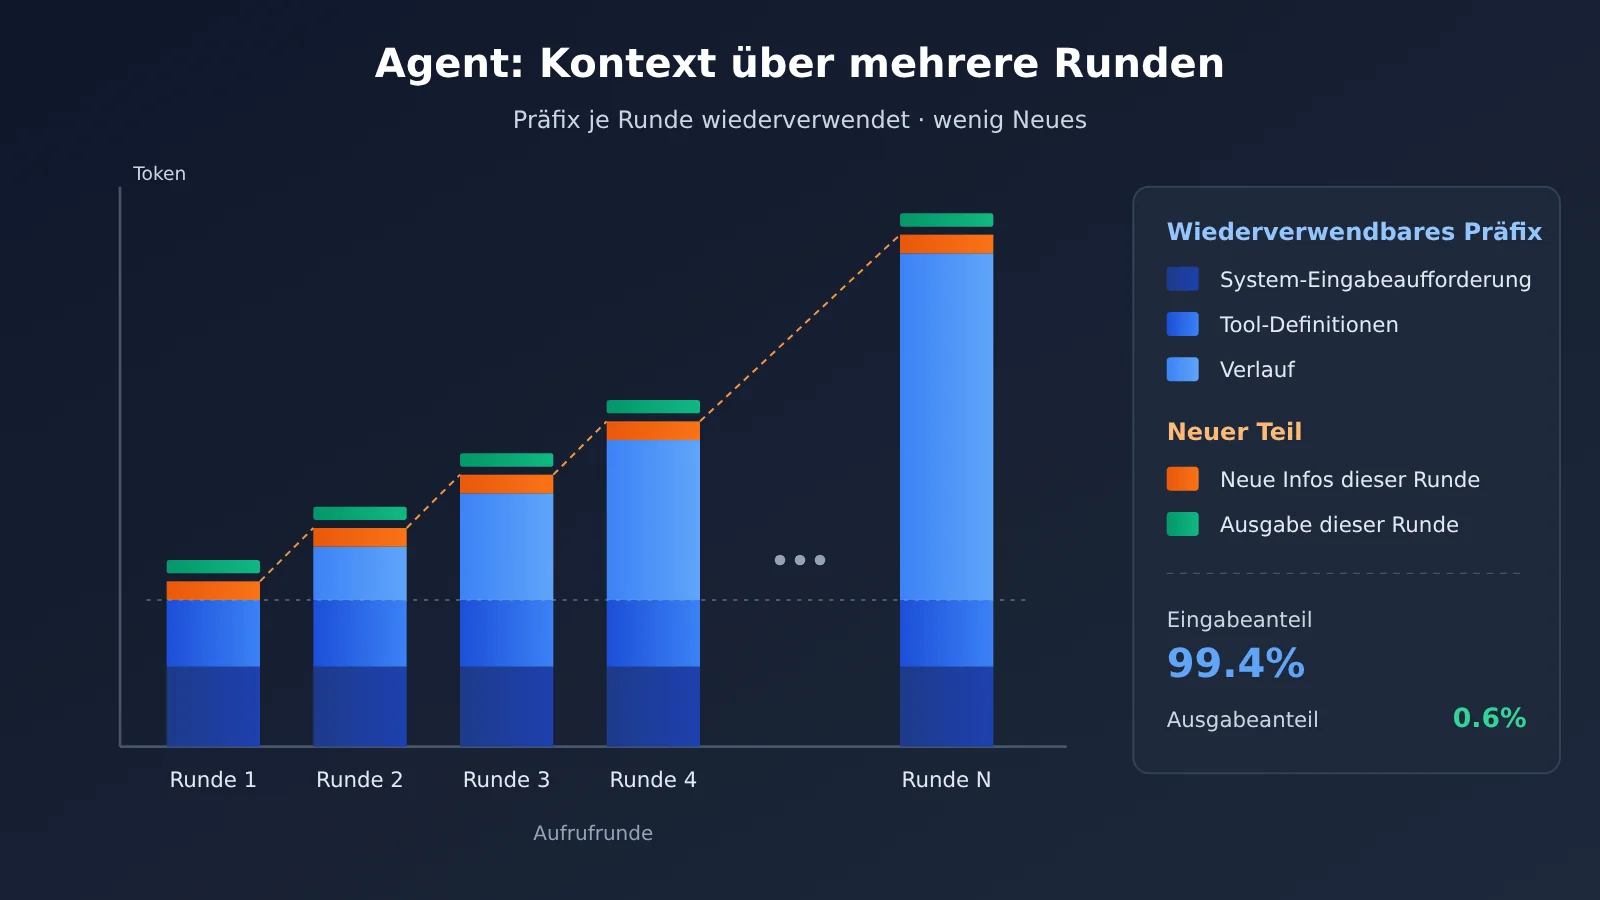
Bei jedem Aufruf erhält das Modell „System-Eingabeaufforderung + Werkzeugdefinitionen + den gesamten bisherigen Verlauf + neue Informationen dieser Runde“. Der Verlauf wird immer länger, während pro Runde nur wenig Inhalt hinzukommt. Über Dutzende Runden hinweg wird dasselbe Präfix deshalb immer wieder abgerechnet. So summiert sich der Eingabeanteil auf 99,4 %.
Warum lange Agent-Aufgaben viel mehr Eingabe- als Ausgabe-Token benötigen
Aus Sicht der Inference Engine wird das besonders deutlich. TokenSpeed erläutert es am Beispiel eines Coding Agents: Das Modell denkt weiter, ruft Tools auf, erhält Ergebnisse und denkt erneut nach. Der gesamte Prozess besteht aus vielen kurzen Anfragen. Schon die erste Anfrage kann einen Präfix-Kontext von mehreren Zehntausend Token enthalten, während die Ausgabe in den folgenden Durchläufen oft nur wenige Hundert Token umfasst.
Die folgende Tabelle stellt Chat- und Agent-Workloads gegenüber. So kannst du besser einschätzen, zu welcher Kategorie deine Anwendung gehört.
| Merkmal | Traditioneller Chat-Workload | Langer Agent-Workload |
|---|---|---|
| Anfrageform | Eine Frage, eine vollständige Antwort | Viele kurze Anfragen mit Tool-Aufrufen |
| Präfixlänge | Meist relativ kurz | Schon zu Beginn mehrere Zehntausend Token, wächst mit jeder Runde |
| Ausgabe pro Runde | Relativ lang | Oft nur wenige Hundert Token |
| Wiederverwendung des Kontexts | Wird einmal geladen und danach freigegeben | Dasselbe Präfix wird während der Aufgabe immer wieder mitgesendet |
| Hauptkostenfaktor | Eingabe und Ausgabe fallen beide ins Gewicht | Die Eingabe, insbesondere das wiederholte Präfix, macht den Grossteil aus |
Wie Präfix-Caching bei langen Agent-Aufgaben funktioniert
Die Inference Engine verarbeitet eine Anfrage in zwei Phasen: In der Prefill-Phase berechnet sie die gesamte Eingabe und erzeugt den KV Cache. In der Decode-Phase generiert sie anschliessend die Ausgabe-Token einzeln. Bei Agent-Aufgaben muss das Präfix mit seinen mehreren Zehntausend Token in jeder Runde die Prefill-Phase durchlaufen. Genau diese Berechnung verursacht die Kosten. Wurde dasselbe Präfix bereits berechnet und liegt das Ergebnis noch im Cache, lässt es sich direkt wiederverwenden. Die entsprechende Prefill-Berechnung entfällt.
Das Team der Inference Engine betrachtet die Wiederverwendungsrate des KV Cache als entscheidenden Faktor für die Inferenzkosten. Laut dem Vortrag soll DeepSeek eine Cache-Wiederverwendungsrate von über 99 % erreichen, während die meisten Systeme derzeit zwischen 70 % und 80 % liegen. Bei Agent-Workloads liegt die Präfix-Trefferquote in der Prefill-Phase meist über 90 %. Bei einem Treffer müssen nur noch wenige Hundert zusätzliche Token berechnet werden.
Ein leicht zu übersehendes Detail: Der Präfix-Cache wird von Anfang an abschnittsweise abgeglichen. TokenSpeed orientierte sich anfangs an SGLang und verwaltete den Präfix-Cache mit einem Radix Tree. Jeder Knoten im Baum entsprach einer Token-Sequenz; eine Anfrage wurde von der Wurzel aus entlang des Baums abgeglichen. Später wechselte TokenSpeed zwar zu einem Flat-KV-Design, doch die Wiederverwendung erfolgt weiterhin in logischen Blöcken fester Grösse von 128 Token. Für Anwendungsentwickler ist die Konsequenz einfach: Unterscheidet sich vorne auch nur ein Token, lässt sich der nachfolgende Inhalt nicht wiederverwenden.
Kontext so strukturieren, dass Agenten bei langen Aufgaben den Präfix-Cache häufiger treffen
Wer versteht, wie der Cache Übereinstimmungen erkennt, weiß auch, wo die Optimierung ansetzt: Der Anfang jeder Anfrage sollte möglichst lang und unverändert bleiben. Das WorkBuddy-Team hält dafür Eingabeaufforderungen und Tool-Strukturen stabil, setzt veränderliche Informationen ans Ende des Kontexts und komprimiert den Verlauf, sobald der Kontext zu lang wird. Daraus ergeben sich fünf konkrete Maßnahmen:
| Maßnahme | Konkretes Vorgehen | Häufiges Gegenbeispiel |
|---|---|---|
| 1. System-Eingabeaufforderung stabil halten | Die System-Eingabeaufforderung bleibt Wort für Wort gleich; Versionsänderungen werden gebündelt veröffentlicht | Aktuelle Uhrzeit, Benutzernamen oder zufällige Beispiele am Anfang einfügen |
| 2. Tool-Struktur stabil halten | Reihenfolge der Tool-Liste und Parameterbeschreibungen unverändert lassen | Tools in jeder Runde nach Bedarf hinzufügen oder entfernen oder eine instabile Serialisierungsreihenfolge verwenden |
| 3. Veränderliche Informationen ans Ende setzen | Zeitstempel, Beobachtungen der aktuellen Runde und dynamische Zustände am Ende anhängen | Den „aktuellen Fortschritt“ an den Anfang der System-Eingabeaufforderung schreiben |
| 4. Verlauf nur ergänzen, nicht umschreiben | Bereits gesendeten Verlauf unverändert lassen und neue Inhalte nur hinten anhängen | Frühere Nachrichten in jeder Runde neu formatieren oder umsortieren |
| 5. Verlauf in Abständen komprimieren | Bei zu langem Kontext den Verlauf an einem Kontrollpunkt einmal komprimieren und danach weiter ergänzen | In jeder Runde eine neue Zusammenfassung erstellen, sodass sich das Präfix ständig ändert |
Lange Agent-Aufgaben mit fester Eingabeaufforderung und Werkzeugstruktur
Die Punkte 1 und 2 werden am leichtesten übersehen. Viele Frameworks fügen das aktuelle Datum in die System-Eingabeaufforderung ein oder wählen Werkzeuge je nach Schritt dynamisch aus. Beides verändert den Anfang jeder Anfrage, sodass der Präfix-Cache bereits ab dem ersten Token nicht mehr greift. Zuverlässiger ist es, in der System-Eingabeaufforderung nur Regeln und Rollen festzulegen und Informationen wie das Datum als normale Nachricht ans Ende zu stellen. Alle verfügbaren Werkzeuge werden einmalig aufgelistet; eine Eingabeaufforderung legt fest, welche davon in der jeweiligen Phase verwendet werden dürfen. Die Werkzeugliste selbst bleibt unverändert.
Auch auf die Serialisierung kommt es an. Wenn die JSON-Felder derselben Werkzeugdefinition in verschiedenen Prozessen in unterschiedlicher Reihenfolge stehen, entstehen auf Byte-Ebene unterschiedliche Präfixe. Sortieren Sie die Werkzeugdefinitionen daher vor dem Senden immer gleich und erfassen Sie den Hashwert des Präfixes im Log. So lässt sich leichter untersuchen, warum der Cache nicht greift, obwohl scheinbar nichts geändert wurde.
Verlauf komprimieren oder Cache wiederverwenden: ein Zielkonflikt bei langen Agent-Aufgaben
Bei Punkt 5 gibt es einen Zielkonflikt. Das Komprimieren des Verlaufs verkürzt die Eingabe, verändert aber auch das Präfix. Dadurch greift der Cache in dieser Runde nicht. Wer nach jeder Runde komprimiert, verzichtet somit jedes Mal auf die Wiederverwendung. Sinnvoller ist ein Schwellenwert: Komprimieren Sie beispielsweise, wenn der Kontext eine bestimmte Länge erreicht oder eine Teilaufgabe abgeschlossen ist. Die komprimierte Version dient dann als neues stabiles Präfix, an das Sie nur noch Inhalte anhängen, statt es umzuschreiben.
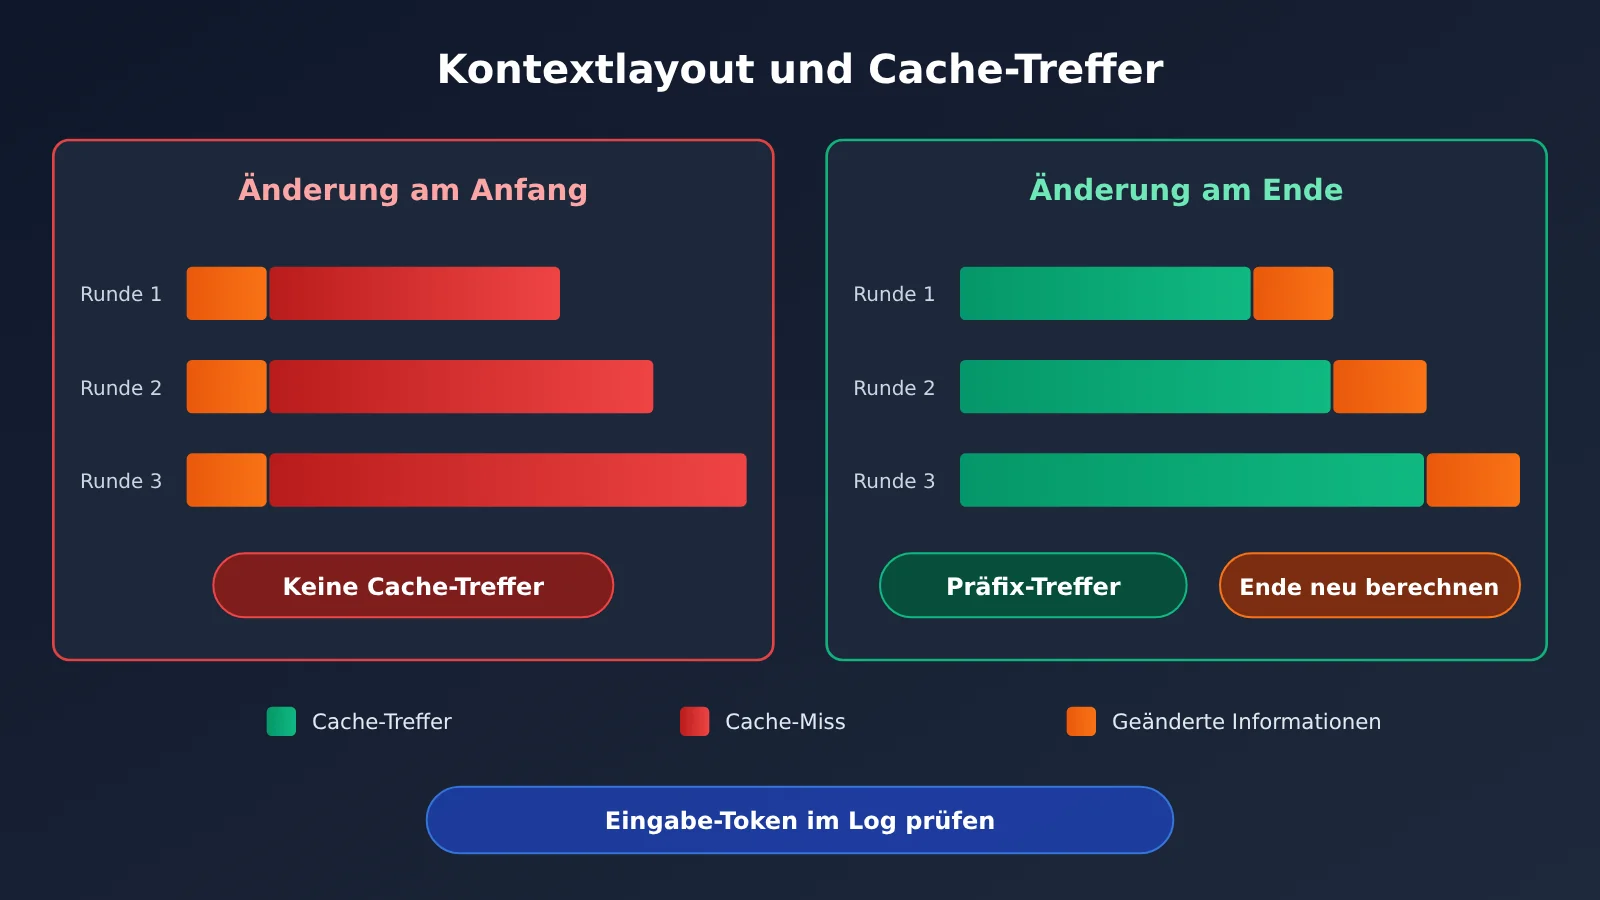
Bei einer einzelnen Anfrage machen die beiden oben gezeigten Layouts kaum einen Unterschied. Bei langen Aufgaben über mehrere Dutzend Runden kann die Rechnung jedoch deutlich unterschiedlich ausfallen. Um herauszufinden, welches Layout Ihre Anwendung verwendet, prüfen Sie am besten in den Aufruflogs, wie sich die Eingabe-Token von Runde zu Runde verändern. APIYI apiyi.com bietet eine einheitliche Abrechnung, Nutzungsstatistiken und Aufruflogs. So lassen sich Daten mehrerer Modelle an einem Ort vergleichen und die Zusammensetzung der Rechnung untersuchen.
Schnellstart: Token-Kosten bei langen Agent-Aufgaben optimieren
Dieser Abschnitt enthält keinen Code, sondern eine Reihe konkreter Schritte. Gehen Sie sie einfach der Reihe nach durch.
Schritt 1: Token-Kosten nach Aufgaben aufschlüsseln
- Erstellen Sie für jede Nutzeraufgabe eine Aufgaben-ID und erfassen Sie diese bei jedem Modellaufruf innerhalb der Aufgabe im Log.
- Protokollieren Sie anhand der
usage-Informationen jeder Antwort die Anzahl der Eingabe- und Ausgabe-Token. Manche Anbieter geben zusätzlich die Anzahl der aus dem Cache abgerufenen Token zurück. Die genauen Feldnamen stehen in der jeweiligen offiziellen Dokumentation. - Fassen Sie pro Aufgabe drei Kennzahlen zusammen: Anzahl der Aufrufe, Verhältnis von Eingabe- zu Ausgabe-Token und Anteil der Cache-Treffer.
Wenn Sie Modelle mehrerer Anbieter nutzen, sind die Logs oft nicht einheitlich aufgebaut. Über den zentralen Zugang von APIYI können Sie Nutzungsdetails und Aufrufprotokolle aller Modelle in einer Konsole einsehen. Zusammen mit den selbst erfassten Aufgaben-IDs erhalten Sie so ein vollständiges Bild davon, wie viel jede Aufgabe kostet und an welcher Stelle die Kosten entstehen.
Schritt 2: Herausfinden, wo das Präfix verändert wird
- Vergleichen Sie zwei aufeinanderfolgende Anfragen derselben Aufgabe Abschnitt für Abschnitt: Sind System-Eingabeaufforderung, Tool-Definitionen und Nachrichtenverlauf wortwörtlich identisch?
- Prüfen Sie insbesondere, an welcher Stelle dynamische Felder wie Zeitstempel, Zufallszahlen oder Nutzerstatus auftauchen.
- Prüfen Sie, ob die Serialisierungsreihenfolge der Tool-Definitionen und Nachrichten über mehrere Anfragen hinweg stabil bleibt.
Schritt 3: Die 5 Maßnahmen umsetzen und erneut testen
- Verschieben Sie dynamische Inhalte ans Ende und halten Sie System-Eingabeaufforderung und Tool-Liste unverändert.
- Legen Sie einen Schwellenwert für die Komprimierung des Verlaufs fest und komprimieren Sie an Kontrollpunkten statt nach jeder Runde.
- Führen Sie vor und nach der Anpassung dieselben Testaufgaben aus. Vergleichen Sie pro Aufgabe die Anzahl der Eingabe-Token und den Anteil der Cache-Treffer.
🚀 Tipp für den Einstieg: Vergleichen Sie die Versionen vor und nach der Anpassung unbedingt mit denselben Aufgaben und demselben Modell. Andernfalls sind die Daten nicht aussagekräftig. Über die einheitliche Schnittstelle von APIYI müssen Sie für erneute Tests mit einem anderen Modell nicht jede Schnittstelle einzeln anpassen. Auch die Nutzungsstatistiken liegen zentral vor. So lassen sich die Variablen „Strukturoptimierung“ und „Modellunterschiede“ getrennt betrachten.
Grenzen der Kostenschätzung
WorkBuddy hat eine Beispielrechnung veröffentlicht: Bei der dort angenommenen Aufgabengröße und den Listenpreisen des TokenHub-Flaggschifftarifs könnten die geschätzten Kosten pro Aufgabe bei einer Cache-Trefferquote von 90 % von rund 21,06 Yuan auf rund 3,36 Yuan sinken. Diese Zahlen gelten jedoch für eine bestimmte Kontextlänge und bestimmte Preisbedingungen. Die vollständigen Annahmen wurden nicht veröffentlicht, sodass sich die Rechnung nicht überprüfen lässt. Sie lässt sich nicht direkt auf Ihre Anwendung übertragen.
| Einflussfaktor | Warum sich das Ergebnis verändert | Was Sie prüfen sollten |
|---|---|---|
| Kontextlänge | Je länger das Präfix, desto größer die Einsparung durch die Cache-Wiederverwendung | Durchschnittliche Präfixlänge Ihrer Aufgaben |
| Cache-Abrechnung | Anbieter gewähren unterschiedliche Rabatte für Cache-Treffer | Cache-Preise in der offiziellen Dokumentation des Zielmodells |
| Bedingungen für die Cache-Nutzung | Regeln zu Mindestlänge, Gültigkeitsdauer und anderen Faktoren unterscheiden sich | Bedingungen für die Cache-Nutzung und den Ablauf in der offiziellen Dokumentation |
| Abstand zwischen Aufrufen | Bei einem zu langen Abstand zwischen zwei Runden ist der Cache möglicherweise bereits abgelaufen | Ob die Ausführungsdauer der Tools zur Gültigkeitsdauer des Caches passt |
| Anzahl der Aufgabenschritte | Je mehr Schritte, desto stärker summieren sich wiederholte Präfixe | Verteilung der Schrittzahlen bei tatsächlichen Aufgaben |
Ergänzende Maßnahmen für geringere Token-Kosten bei langen Agent-Aufgaben
Neben der Struktur des Kontexts wurden in derselben Präsentation zwei anwendungsseitige Strategien vorgestellt, die sich mit Präfix-Caching kombinieren lassen.
- Modell passend zum Schritt wählen: Das WorkBuddy-Team berichtet, dass sich rund 80 % der einfachen Schritte an ein leichtgewichtiges Modell übertragen lassen. Die Kosten pro Aufgabe sanken dadurch um etwa 57 %. Für Schritte wie das Aufbereiten von Informationen oder das Konvertieren von Formaten ist nicht unbedingt ein Spitzenmodell nötig.
- Fehler je nach Ursache behandeln: Bei Zeitüberschreitungen, abgelehnten Anfragen oder Anbieter-Ausfällen können Sie je nach Ursache die Zahl der Wiederholungsversuche begrenzen, den Kontext anpassen oder das Modell wechseln. Unbegrenzte Wiederholungen führen dazu, dass dasselbe lange Präfix immer wieder berechnet wird.
Zu beachten ist: Ein Modellwechsel bedeutet auch einen Wechsel zu einem anderen Cache. Die Wiederverwendung des Präfixes beginnt dann von vorn. Beim Routing sollten aufeinanderfolgende Schritte derselben Teilaufgabe daher möglichst beim selben Modell bleiben. Modellwechsel erfolgen am besten an den Grenzen zwischen Teilaufgaben.
Häufig gestellte Fragen (FAQ)
Q1: Was ist Präfix-Caching bei lang laufenden Agent-Aufgaben?
Beim Präfix-Caching speichert der Inferenzdienst bereits berechnete Eingabepräfixe als KV Cache. Beginnen spätere Anfragen mit demselben Präfix, kann er es direkt wiederverwenden und spart die erneute Prefill-Berechnung. Da ein Agent in jeder Runde große Teile desselben Verlaufs mitsendet, eignet sich dieser besonders gut für die Wiederverwendung.
Q2: Was unterscheidet Präfix-Caching von der Komprimierung des bisherigen Kontexts?
Präfix-Caching reduziert den Eingabeinhalt nicht, sondern macht die Berechnung wiederholter Teile günstiger. Die Komprimierung des Verlaufs verkürzt dagegen die Eingabe, verändert aber das Präfix und verhindert dadurch in dieser Runde einen Cache-Treffer. Beide Verfahren sollten zusammenspielen: Im Normalbetrieb nur Inhalte anhängen, um Cache-Treffer zu ermöglichen, und den Verlauf erst an einem Checkpoint komprimieren.
Q3: Gilt der Eingabeanteil von 99,4 % für alle Agenten?
Nicht unbedingt. Diese Zahl stammt aus einem Erfahrungsbericht über eine Aufrufkette mit 50 Schritten. Bei Aufgaben mit weniger Schritten und längeren Ausgaben pro Runde fällt der Eingabeanteil geringer aus. Bei einer Struktur mit langem Präfix, kurzer Ausgabe und vielen Durchläufen macht die Eingabe aber normalerweise den Großteil aus. Am besten prüfen Sie das anhand Ihrer eigenen Logs.
Q4: Bei welchen Agent-Szenarien lohnt sich die Optimierung des Präfix-Cachings besonders?
– **Coding-Agenten**: Der Repository-Kontext ist lang, und Dateien lesen, Code ändern und Tests ausführen wiederholt sich häufig
– **Dokument- oder PPT-Erstellung**: Nach dem Einlesen des Materials werden die Seiten einzeln erstellt, wobei sich das Präfix stark wiederholt
– **Datenanalyse-Agenten**: Tabellenstrukturen und Kennzahlenbeschreibungen bleiben gleich, pro Runde kommen nur Abfrageergebnisse hinzu
Q5: Wie lässt sich die Verteilung von Eingabe- und Ausgabe-Token in der eigenen Anwendung schnell nachvollziehen?
Am einfachsten fassen Sie die Nutzungsdaten jeder Runde nach Aufgaben-ID zusammen. Wenn Ihre Anwendung mehrere Modelle nutzt, können Sie diese einheitlich über APIYI auf apiyi.com aufrufen. Die Plattform bietet Nutzungsstatistiken und Aufruf-Logs, mit denen sich die Verteilung von Eingabe und Ausgabe nach Modell und Zeitraum prüfen lässt. Welche Modelle das Prompt-Caching unterstützen und wie es abgerechnet wird, entnehmen Sie bitte der Plattformdokumentation.
Q6: Welche bekannten Einschränkungen hat Präfix-Caching?
– Die Voraussetzungen unterscheiden sich je nach Anbieter, etwa bei Mindestlänge und Gültigkeitsdauer. Prüfen Sie deshalb jeweils die offizielle Dokumentation
– Dauert die Ausführung eines Tools zu lange, kann der Cache bereits vor der nächsten Runde ablaufen
– Ein Modellwechsel oder eine Änderung der System-Eingabeaufforderung macht den gesamten Cache ungültig
– Der Rabatt für Cache-Treffer variiert je nach Modell. Wie viel sich tatsächlich sparen lässt, muss in der Praxis geprüft werden
Die wichtigsten Erkenntnisse zu Token-Kosten bei langen Agent-Aufgaben
- Kosten pro Aufgabe betrachten: Eine Anfrage umfasst im Schnitt etwa 7,2 Aufrufe; lange Aufgaben können mehr als 50 Schritte haben.
- Eingabe-Token sind der Hauptkostentreiber: In einer Kette mit 50 Schritten machen sie etwa 99,4 % aus. Kürzere Ausgaben sparen daher nur begrenzt Kosten.
- Cache-Abgleich beginnt am Anfang: Unterscheidet sich dort auch nur ein Token, lässt sich der nachfolgende Inhalt nicht wiederverwenden.
- Die Struktur ist wichtiger als das Modell: Eingabeaufforderungen und Tool-Struktur stabil halten, veränderliche Informationen ans Ende setzen.
- Komprimierung gezielt einsetzen: An definierten Kontrollpunkten komprimieren, statt das Präfix in jeder Runde umzuschreiben.
- Berechnungen nicht pauschal übertragen: Veröffentlichte Kostenangaben hängen von bestimmten Kontextlängen und Preisen ab. Eigene Messungen sind nötig.
- Erst beobachten, dann optimieren: Mit Nutzungsstatistiken und Aufrufprotokollen von APIYI die Kostenstruktur aufschlüsseln.
Fazit
Die wichtigsten Erkenntnisse zu Token-Kosten bei langen Agent-Aufgaben:
- Kostenstruktur: Der Grossteil der Kosten entsteht durch den Gesprächsverlauf, der in jeder Runde erneut übergeben wird. Eingabe-Token machen den überwiegenden Anteil aus.
- Prinzip der Kostenoptimierung: Präfix-Caching spart bei wiederholten Präfixen die Prefill-Berechnung. Die Trefferquote hängt von der Struktur des Kontexts ab.
- Praktische Umsetzung: Eingabeaufforderungen und Tools stabil halten, veränderliche Informationen ans Ende setzen, den Verlauf nur erweitern und regelmässig komprimieren. Ergänzend lässt sich für jeden Schritt ein passendes Modell wählen.
Am besten eine Woche lang die Protokolle nach Aufgaben aufschlüsseln und den eigenen Eingabeanteil sowie die Cache-Trefferquote ermitteln. Anschliessend lassen sich die fünf Massnahmen aus diesem Artikel Schritt für Schritt umsetzen. Wer mehrere Modelle nutzt, kann sie über APIYI auf apiyi.com einheitlich anbinden und Nutzung sowie Aufrufprotokolle zentral einsehen. So lässt sich die tatsächliche Wirkung jeder Optimierung anhand derselben Daten bewerten.
📚 Quellen
- Die nächste Generation von LLM-Inferenz-Engines für Agentic Reasoning entwickeln: Zusammenfassung des TokenSpeed-Vortrags auf der AICon 2026 in Shenzhen
- Link:
infoq.cn/article/YwAayF1ylWb7oN4P0lyC -
Inhalt: Merkmale von Agent-Workloads mit „langem Präfix und kurzer Ausgabe“, Wiederverwendungsrate des KV-Cache und Architektur des Präfix-Cachings
-
Vom Modellaufruf zur Aufgabenerledigung: Wie MaaS in der Agent-Produktion Einzug hält: Zusammenfassung der Tencent-Cloud-Veranstaltung zu MaaS
- Link:
infoq.cn/article/zZutPTX8bsr6NWQYNC3A - Inhalt: Von WorkBuddy vorgestellte Daten zu Aufrufzahlen, Eingabeanteil, Präfix-Caching und Modellrouting
Autor: APIYI-Technikteam
Technischer Austausch: Bei Fragen zu Multi-Modell-Aufrufen und Nutzungsanalysen kontaktieren Sie uns gerne über APIYI unter apiyi.com. Weitere Informationen finden Sie im Dokumentationszentrum unter docs.apiyi.com.