Die offizielle Pricing-Seite von Together AI hat die drei Preise für Qwen4-Max – Eingabe, Ausgabe und Cache-Lesen – zeitlich begrenzt auf 70 % des Preises der internationalen Deployment-Variante von Alibaba Cloud Model Studio in Singapur gesenkt. Auf der Seite ist angegeben, dass die Aktion bis 2026-11-23 gültig ist.
Das Fazit gilt nur unter Bedingungen: Nur wenn Ihre Aufgabe bis zum Stichtag validiert werden kann, überwiegend auf Text- und Bildeingaben beruht und die von Together noch nicht einzeln veröffentlichten Längenobergrenzen nicht berührt, lohnt es sich, diesen 70-%-Preis für einen frühen Test zu nutzen. Andernfalls sollten Sie anhand der „Kosten pro erfolgreicher Aufgabe“ entscheiden, ob ein Wechsel sinnvoll ist, und zugleich eine zweite Abrechnung auf Basis des Preises nach Aktionsende vorbereiten. Dieser 70-%-Preis ist lediglich eine Preisliste und noch keine von Ihnen validierte Bereitstellung.
Was Sie nach dem Lesen dieses Artikels erfahren?
- Die konkreten Werte der Together-AI-70-%-Aktion, die Berechnungsgrundlage und das Ablaufdatum sowie die Seite, auf der die einzelnen Zahlen stehen.
- Wie Sie die Preise abgleichen, wenn die Modell-Detailseite von Together und die Pricing-Seite voneinander abweichen.
- Welche von Alibaba Cloud offiziell veröffentlichten Kontextfenster, Ausgabeobergrenzen und Cache-Abrechnungen nicht direkt auf das Routing von Together übertragen werden können.
- Eine Abnahmemethode für den Wechsel bei kurzen Texten, langem Kontext und Bildaufgaben sowie Rechenbeispiele mit Nenner und Annahmen.
- Endpunkt, Gruppe und Katalogpreis von
qwen4-maxbei APIYI sowie der Unterschied zur Together-Aktion.
Index: Der Hauptteil teilt die überprüfbaren Fakten zunächst in vier Gruppen: den 70-%-Preis von Together und seine Laufzeit, die Unterschiede bei gleichnamigen Modellen auf verschiedenen Seiten, die offiziellen Spezifikationen von Alibaba Cloud und die Listing-Informationen von APIYI. Bei jeder Zahlengruppe werden Zuordnung und Bedingungen angegeben. Danach folgt der Analyse- und Bewertungsteil: die möglichen Preisbildungsmechanismen hinter dem 70-%-Preis (alle sind Vermutungen), die Methode und der Code zur Berechnung der Kosten pro erfolgreicher Aufgabe mit demselben Aufgabensatz sowie die Punkte, die beim Prüfen von APIYI als unabhängige Alternative einzeln kontrolliert werden müssen.
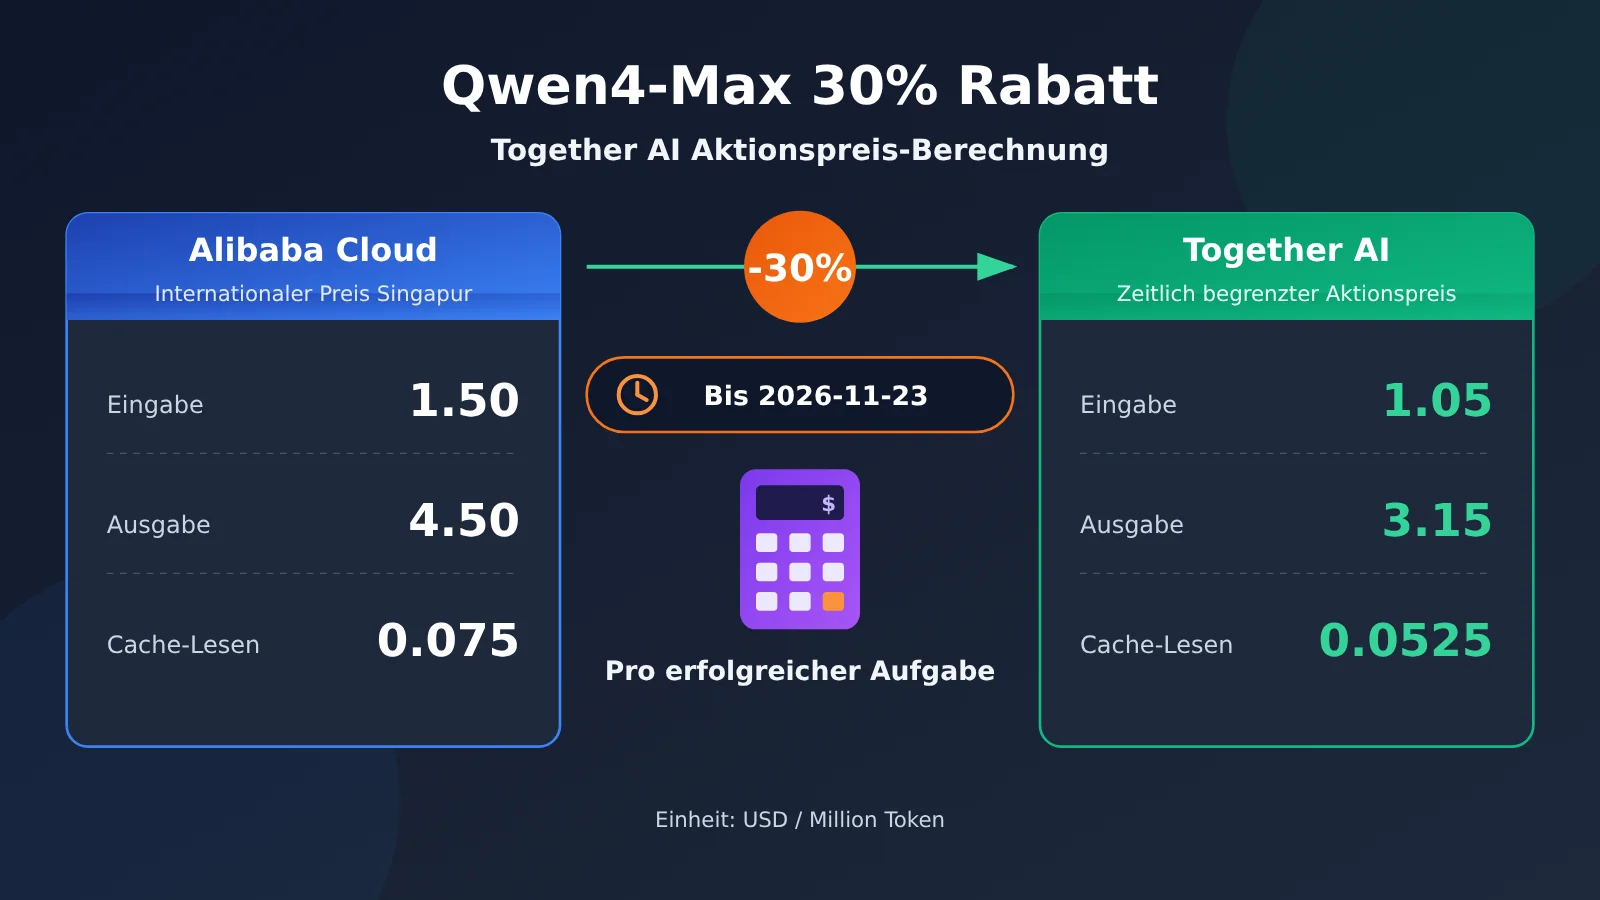
Wichtige Begriffe zum 30-%-Rabatt auf Qwen4-Max
| Konzept | Kurze Erklärung |
|---|---|
| Serverless-Inferenz | Die Laufzeitinstanzen werden vom Anbieter verwaltet; Anwendungen rufen sie über öffentliche Schnittstellen nutzungsbasiert auf, ohne das Modell selbst bereitstellen zu müssen |
| Internationale Bereitstellung | Eine regionale Bereitstellungs- und Abrechnungsvariante des Alibaba-Cloud-Modellservices; Preise und Regeln ändern sich je nach gewählter Region |
| Token | Maßeinheit dafür, wie Modelle Text und andere Informationen verarbeiten; Eingabe, Ausgabe, Cache und weitere Abrechnungsposten werden getrennt berechnet |
| Cache-Lesen | Eine Anfrage verwendet bereits verarbeitete Eingaben erneut und wird nach dem Lesetarif abgerechnet; für Cache-Schreiben gelten eigene Preise und Gültigkeitsdauern |
| Kontextfenster | Gesamtlänge, die für eine einzelne Inferenz verfügbar ist; Anbieter können zusätzlich maximale Eingabe und maximale Ausgabe getrennt begrenzen |
| Eingabemodalität | Datentypen, die der Modellservice akzeptiert, zum Beispiel Text, Bilder und Videos |
| Kosten pro erfolgreicher Aufgabe | Gesamte Inferenzausgaben geteilt durch die Anzahl der abgenommenen Aufgaben; Ausgaben durch Fehlschläge und Wiederholungsversuche werden ebenfalls eingerechnet |
Überblick über die Auswirkungen des 30-%-Rabatts auf Qwen4-Max
- Anwendungsentwickler und Einkaufsverantwortliche: Der Listenpreis sinkt um 30 %, aber der Stichtag liegt nur noch etwa drei Tage entfernt, und die Seite nennt weder Zeitzone noch genaue Uhrzeit. Wer die Abnahme nicht mehr rechtzeitig abschließen kann, geht ein größeres Risiko ein, wenn er sein Langfristbudget auf dem Aktionspreis aufbaut.
- Teams mit langem Kontext oder Agent-Szenarien: Bei Aufgaben, bei denen Eingabe-Token den größten Anteil haben, fällt die Ersparnis am deutlichsten aus. Allerdings veröffentlicht Together die Obergrenzen für Eingabe und Ausgabe nicht einzeln; der Abschneidepunkt muss daher zuerst in der Praxis getestet werden.
- Wer Videoverständnis benötigt: Die offizielle Modellseite von Alibaba führt Videoeingaben auf, die Together-Modellseite nennt derzeit jedoch ausdrücklich nur Text und Bilder. Bevor eine klare Aussage oder Testergebnisse vorliegen, sollten Videoaufgaben nicht dorthin verlagert werden.
Qwen4-Max zu 30 % Rabatt: die Fakten zu den Zugangskosten
Together AI: Preis und Laufzeitende für Qwen4-Max mit 30 % Rabatt
Die Zahlen in der folgenden Tabelle wurden am 2026-11-20 abgerufen; alle Angaben in US-Dollar pro Million Token. Die Together-Zahlen stammen von der offiziellen Pricing-Seite, auf der Qwen4 Max als PROMO gekennzeichnet ist. Die Alibaba-Cloud-Zahlen stammen aus der Preisliste von Model Studio für das internationale Deployment in Singapur.
| Abrechnungsposten | Zeitlich begrenzter Preis auf der Together-Pricing-Seite | Alibaba Cloud – internationales Deployment in Singapur | Verhältnis |
|---|---|---|---|
| Eingabe | 1.05 | 1.50 | 0.70 |
| Ausgabe | 3.15 | 4.50 | 0.70 |
| Cache-Lesen | 0.0525 | 0.075 | 0.70 |
| Gültigkeit | Auf der Seite angegeben bis 2026-11-23; Zeitzone und Uhrzeit nicht angegeben | Rollierende Preisliste | — |
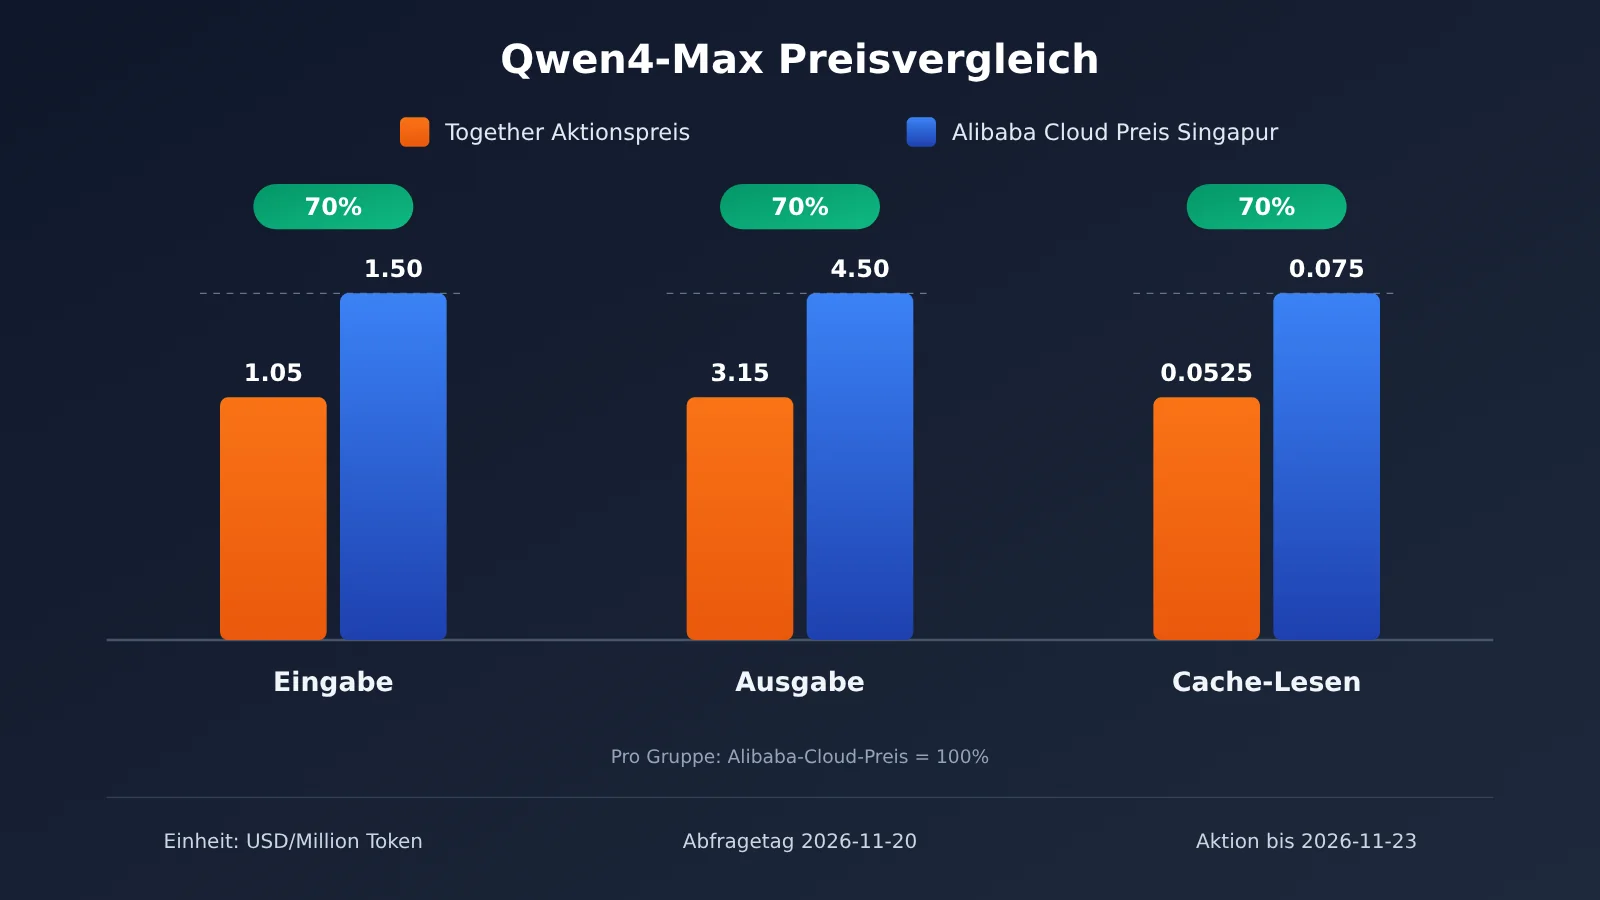
Der „Listenpreis“ auf der Together-Pricing-Seite stimmt Punkt für Punkt mit dem Alibaba-Cloud-Preis für Singapur überein; alle drei Verhältnisse liegen exakt bei 0.70. Dieser Rabatt von 30 % gilt nur für die Referenz „internationales Deployment in Singapur“, diese drei Abrechnungsposten und diese Aktion. Wer mit Preisen aus anderen Alibaba-Cloud-Regionen vergleicht oder andere Cache-Regeln berücksichtigt, muss den Rabatt neu berechnen und kann die 30 % nicht einfach übernehmen.
Diese Preisinformation tauchte zuerst in einem Artikel von OrcaRouter vom 2026-11-19 auf, doch der Originaltext nannte die Plattform nicht; der Autor stellte außerdem klar, dass sein eigener Dienst dieses Modell nicht anbietet. Die derzeit einzige Quelle, bei der sich dieselben drei Preisstufen überprüfen lassen, ist die Pricing-Seite von Together AI selbst – zitieren sollte man daher diese Seite.
Preisunterschiede bei Qwen4-Max zwischen Together AIs Modellseite und Pricing-Seite
Die Modell-Detailseite von Together (Seitenmarkierung 2026-11-15) nennt die Aufruf-ID Qwen/Qwen4-Max sowie ein Serverless-Aufrufbeispiel, zeigt aber einen anderen Preis: Eingabe 1,43, Ausgabe 4,28, Cache-Lesen 0,0713 (US-Dollar pro Million Token). Da die beiden öffentlichen Seiten desselben Anbieters unterschiedliche Zahlen nennen, sollte man beim Zitieren des 30-Prozent-Rabatts ausdrücklich „den auf der offiziellen Pricing-Seite vermerkten Aktionspreis“ angeben und das Recherchedatum festhalten; maßgeblich für die tatsächliche Abrechnung ist die Nutzungsübersicht des Kontos.
| Dimension | Öffentliche Angaben von Together | Offizielle Angaben von Alibaba Cloud |
|---|---|---|
| Aufruf-ID | Qwen/Qwen4-Max, mit Serverless-Beispiel |
Modellseite in Model Studio |
| Eingabemodalitäten | Modellseite nennt ausdrücklich Text und Bild | Text-, Bild- und Videoeingabe, Textausgabe |
| Gesamtkontext | Beworben mit 1 Mio. Gesamtfenster | 1 Mio. Token Gesamtkontext |
| Maximale Eingabe | Nicht einzeln bestätigt | Ohne Reasoning 991.808 / Mit Reasoning 983.616 |
| Maximale Ausgabe | Nicht einzeln bestätigt | Ohne Reasoning 131.072 / Mit Reasoning 262.144 |
| Cache-Lesen | Pricing-Seite 0,0525; Modellseite 0,0713 | Singapur 0,075 |
| Cache-Schreiben | Nicht öffentlich ersichtlich | 5 Minuten 1,875; 1 Stunde 3 (US-Dollar pro Million) |
Die offizielle Modellseite von Alibaba Cloud wurde am 2026-11-18 aktualisiert. Laut der Beschreibung im OrcaRouter-Artikel teilen sich im Reasoning-Modus der Denkprozess und die Antwort ein Budget von 262.144 Token. Diese Obergrenzen, Modalitäten und Cache-Regeln gehören zur eigenen Bereitstellung von Alibaba Cloud und dürfen nicht ohne Weiteres als Fähigkeiten des Together-Routings gelten. Außerdem gab es frühere Beschreibungen, die erwähnten, dass auf der Together-Seite einmal ein Hinweis auf das Warten auf die Freischaltung erschien. Inzwischen zeigt die Modellseite Aufruf-ID und Beispiel, doch in diesem Prüfungsdurchlauf wurde nicht verifiziert, ob ein tatsächlicher Aufruf erfolgreich ist.
APIYI qwen4-max: Einführungsinformationen und Listenpreis
APIYI (apiyi.com) hat am 17. November 2026 um 16:07 Uhr eine Ankündigung veröffentlicht und qwen4-max freigeschaltet. Auch im öffentlichen Modellregister, das am 20. November 2026 um 15:17 Uhr (UTC+8) erstellt wurde, ist diese ID aufgeführt. Sollte es im APIYI-Blog zuvor geheißen haben, das Modell sei „noch nicht verfügbar“, so gelten jetzt diese aktuelle Ankündigung und das Register.
| Position | Öffentliche Preisliste von APIYI |
|---|---|
| Modell-ID | qwen4-max |
| Endpunkte | chat, responses, messages |
| Token-Gruppen | ClaudeCode, CodexResponses, default, svip |
| Listenpreis (USD / Million Token) | Eingabe 1.50, Ausgabe 4.50, Cache-Lesen 0.075 |
| Überprüfung | Basierend auf offizieller Ankündigung und Register; kein kostenpflichtiger Aufruf durchgeführt |
Diese Listenpreise stimmen zahlenmäßig mit dem internationalen Bereitstellungspreis von Alibaba Cloud in Singapur überein. Es handelt sich nicht um eine Together-Promotion und auch nicht um einen APIYI-Rabatt. Kontogruppierung, Token-Berechtigungen und die Abrechnungsweise der Plattform beeinflussen, ob ein Aufruf möglich ist und wie hoch der letztlich zu zahlende Betrag ausfällt.
Qwen4-Max mit 30 % Rabatt: Lohnt sich der Wechsel? Analyse und Einschätzung
Qwen4-Max mit 30 % Rabatt: mögliche Preisbildungsmechanismen (Spekulation)
Der Originalbeitrag von OrcaRouter führt drei Erklärungen an. Sie werden im Folgenden einzeln dargestellt – alle sind reine Vermutungen. Die öffentlich zugänglichen Seiten von Together bestätigen lediglich die Aktion selbst und das ausdrücklich genannte Ablaufdatum; wer den Rabatt trägt, wird dort nicht offengelegt.
- Herstellerzuschuss (Vermutung): Der Modellanbieter subventioniert den Einführungspreis auf einer Drittanbieter-Plattform, um sein neues Modell zu bewerben. Trifft das zu, kehrt der Preis nach dem Ende der Förderung mit hoher Wahrscheinlichkeit zum Basispreis zurück.
- Großhandelspreis (Vermutung): Die Plattform hat einen niedrigeren Einkaufspreis erhalten und kann den Vorteil langfristig weitergeben. In diesem Fall würde man aber in der Regel weder PROMO noch ein Ablaufdatum auszeichnen – das passt nicht recht zum aktuellen Erscheinungsbild der Seite.
- Verlust als Lockangebot (Vermutung): Die Plattform nimmt kurzfristige Verluste in Kauf, um neue Nutzer zu gewinnen. In diesem Fall hängt die Dauer des Rabatts von der Strategie der Plattform ab und lässt sich nicht vorhersagen.
Der Originalbeitrag nennt Ende Dezember als Beobachtungspunkt, die bereits veröffentlichte Frist ist jedoch der 23. November. Bei der Budgetplanung sollte man zunächst vom Ablauf am 23. November ausgehen und erst nach einer offiziellen Verlängerung aktualisieren.
Kosten pro erfolgreicher Aufgabe für Qwen4-Max anhand derselben Aufgabensammlung berechnen
Ein Vergleich anhand der Token-Listenpreise übersieht leicht die Kosten, die durch Fehlschläge, Wiederholungsversuche und Kürzungen entstehen. Ein soliderer Ansatz besteht darin, Aufgabensammlung, Eingabeaufforderungen und Abnahmeregeln festzulegen, dieselben Beispiele jeweils auf die Kandidaten-Routen zu schicken, bei jedem Aufruf Eingabe, Ausgabe, Cache-Treffer, Fehlschläge, Wiederholungsversuche und Latenz zu protokollieren und anschließend die Gesamtausgaben durch die Anzahl der die Abnahme bestehenden Aufgaben zu teilen. Es empfiehlt sich, mindestens drei Arten von Beispielen vorzubereiten:
- Kurztext-Aufgaben: zum Beispiel Klassifizierung, Extraktion, Umschreiben; hier zählt vor allem, ob Erfolgsquote und Ausgabelänge stabil bleiben.
- Langkontext-Aufgaben: zum Beispiel eine Anfrage mit rund 400.000 Token senden und beobachten, wo gekürzt wird und ob das Ausgabebudget im Denkmodus ausreicht.
- Bildaufgaben: bei den Bild-Eingaben, die Together ausdrücklich unterstützt, prüfen, ob Erkennungsergebnis und Abrechnung den Erwartungen entsprechen.
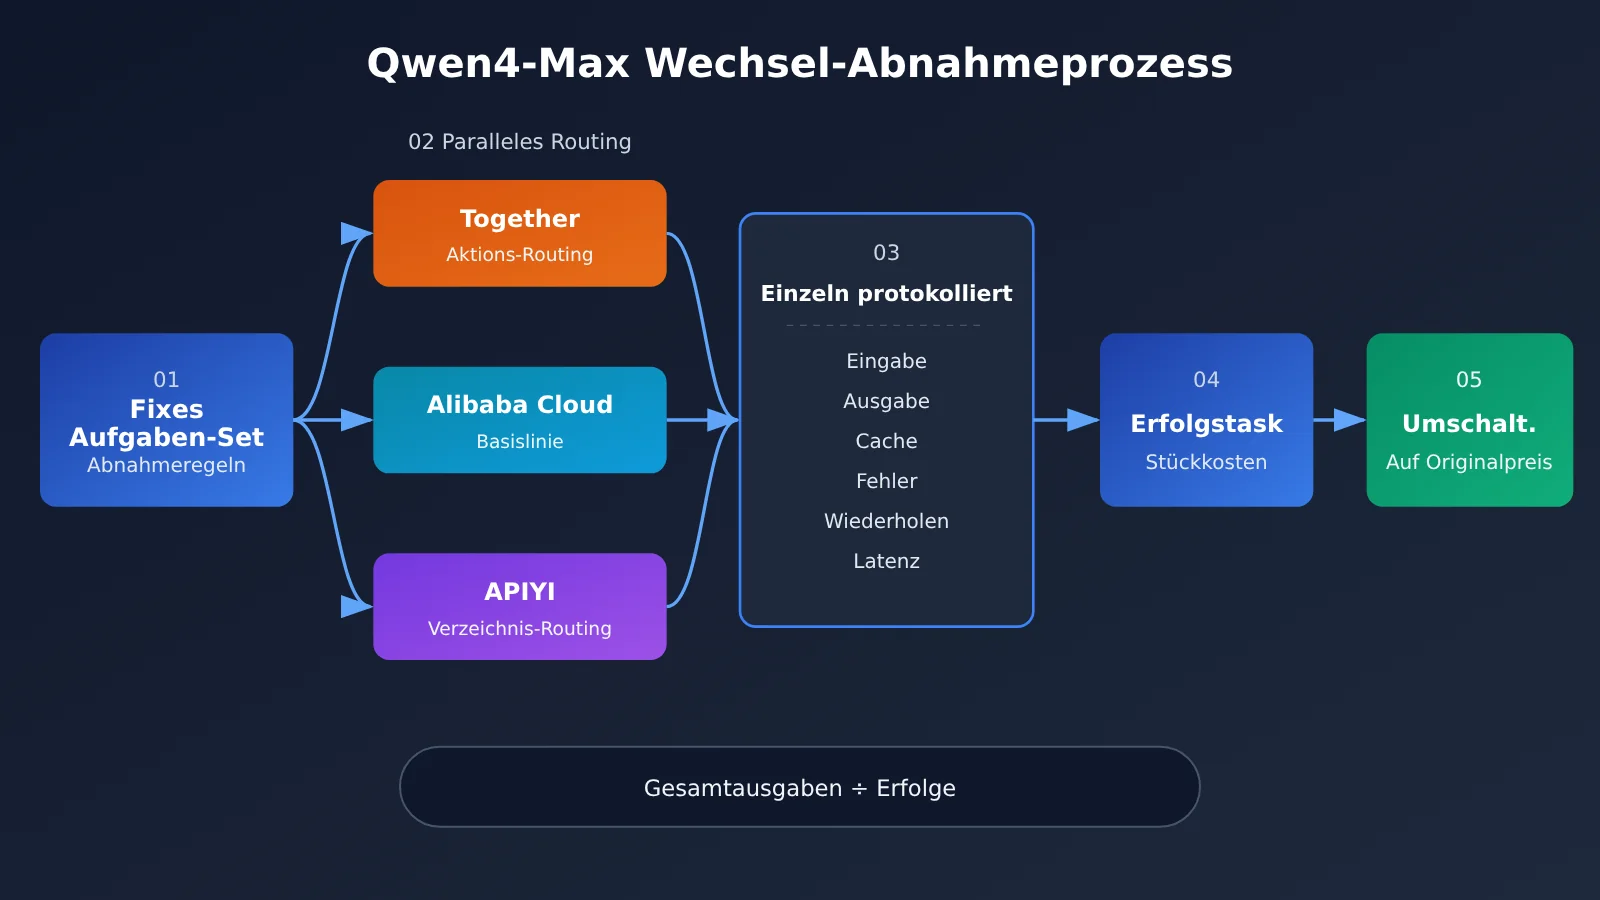
Das Kurztext-Rechenbeispiel in der folgenden Tabelle besteht aus hypothetischen Daten, um zu zeigen, wie der Nenner gewählt werden sollte. Das Langkontext-Rechenbeispiel übernimmt die Berechnung von OrcaRouter: pro Runde 200,000 Eingabe, 30,000 Ausgabe, insgesamt 40 Runden, ohne Cache, beide Seiten nach den Singaporeer Listenpreisen berechnet.
| Rechenbeispiel | Annahmen und Nenner | Together-Aktionspreis | Nach Aktionsende (angenommen zurück zum Pricing-Seiten-Listenpreis 1.50/4.50) | Differenz |
|---|---|---|---|---|
| Kurztext (hypothetisch) | pro Aufruf 2,000 Eingabe, 500 Ausgabe; 100 Aufgaben, 8 Wiederholungsversuche, insgesamt 108 Aufrufe; 92 bestehen die Abnahme | 108 × 0.003675 ≈ 0.397, ÷ 92 ≈ 0.00431 pro erfolgreicher Aufgabe | 108 × 0.00525 ≈ 0.567, ÷ 92 ≈ 0.00616 | ca. 0.00185 pro erfolgreicher Aufgabe |
| Langkontext-Agent (OrcaRouter-Rechenbeispiel) | 40 Runden = 1 Durchlauf, kein Cache, angenommen alles erfolgreich | pro Runde 0.3045, pro Durchlauf 12.18 | pro Runde 0.435, pro Durchlauf 17.40 | pro Durchlauf 5.22 |
Nach diesem Rechenbeispiel beträgt die Differenz bei 1,000 Durchläufen pro Monat etwa 5,220 US-Dollar, bei zehn Durchläufen nur etwa 52 US-Dollar. Zu beachten ist, dass das Ergebnis anders ausfällt, wenn der Preis nach Aktionsende auf die Stufe 1.43/4.28 auf der Modellseite zurückgeht. Deshalb sollte die Preisspalte idealerweise drei Sätze gleichzeitig führen – „Aktionspreis“, „Pricing-Listenpreis“ und „Modellseiten-Preis“ – und erst nach Vorliegen der Rechnung mit den tatsächlichen Stückpreisen abgleichen.
Codebeispiel für den Kostentest von Qwen4-Max
Das folgende minimale Beispiel zeigt einen OpenAI-kompatiblen Aufruf. Am Beispiel der APIYI-Route: Wenn Sie auf eine andere Route wechseln, ändern Sie einfach base_url und die Modell-ID auf die Werte, die der jeweilige Anbieter veröffentlicht.
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # OpenAI-kompatible Schnittstelle von APIYI
)

resp = client.chat.completions.create(
    model="qwen4-max",
    messages=[{"role": "user", "content": "用一句话说明缓存读计费"}]
)
print(resp.choices[0].message.content, resp.usage)
Vollständiges Skript ansehen, das nach „Kosten pro erfolgreicher Aufgabe“ abrechnet
import time
import openai

# Einheit: USD / Million Token; drei Preissätze getrennt erfassen und nach Erhalt
# der Rechnung durch die tatsächlich gezahlten Stückpreise ersetzen
PRICES = {
    "together_promo": {"in": 1.05, "out": 3.15, "cache_read": 0.0525},
    "list_price":     {"in": 1.50, "out": 4.50, "cache_read": 0.075},
    "together_model_page": {"in": 1.43, "out": 4.28, "cache_read": 0.0713},
}

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Durch die zu testende Route ersetzen
)

def run_task(prompt, validate, model="qwen4-max", max_retries=2):
    """Gibt die Verbrauchsaufzeichnungen jedes Aufrufs zurück sowie die Angabe,
    ob die Aufgabe die Abnahme letztlich bestanden hat"""
    records = []
    for attempt in range(max_retries + 1):
        t0 = time.time()
        try:
            r = client.chat.completions.create(
                model=model,
                messages=[{"role": "user", "content": prompt}],
            )
            u = r.usage
            details = getattr(u, "prompt_tokens_details", None)
            cached = getattr(details, "cached_tokens", 0) or 0
            ok = validate(r.choices[0].message.content)
            records.append({"in": u.prompt_tokens - cached, "cache": cached,
                            "out": u.completion_tokens, "ok": ok,
                            "latency": time.time() - t0})
            if ok:
                return records, True
        except Exception as e:
            records.append({"in": 0, "cache": 0, "out": 0, "ok": False,
                            "latency": time.time() - t0, "error": str(e)})
    return records, False

def cost_per_success(all_records, passed, price):
    total = sum(r["in"] * price["in"] + r["out"] * price["out"]
                + r["cache"] * price["cache_read"] for r in all_records) / 1e6
    return total / passed if passed else float("inf")
Das Cache-Feld im Skript hängt davon ab, ob die Schnittstelle cached_tokens zurückgibt. Bei verschiedenen Routen können die Rückgabefelder unterschiedlich sein – maßgeblich ist am Ende immer die Abrechnung der Plattform. Für die Kosten des Schreibens in den Cache (Alibaba Cloud unterscheidet offiziell zwei Stufen: 5 Minuten und 1 Stunde) gibt es auf der Together-Seite keinen öffentlich veröffentlichten Preis; diese sollten beim Testen separat erfasst werden.
🚀 Test-Tipp: Bis zum Stichtag ist die Zeit knapp. Sie können daher zuerst bei APIYI auf apiyi.com mit dem Gratis-Kontingent für neue Nutzer das Beispielset und das Abrechnungsskript durchlaufen lassen. Wenn die Abnahmeregeln und das Log-Format passen, richten Sie dasselbe Skript anschließend auf die Together-Route, um einen Vergleich zu erhalten. So lässt sich die Testzeit im Aktionsfenster vollständig für den Preisvergleich nutzen.
Checkliste zur Prüfung von APIYI qwen4-max als eigenständige Ausweichoption
Der Katalogpreis von APIYI entspricht dem Preis von Alibaba Cloud in der Region Singapur. Der Zweck besteht darin, nach Ablauf der Promo oder wenn die Validierung der Together-Route fehlschlägt, einen weiteren stabilen Kanal zum Listenpreis bereitzustellen – und nicht eine günstigere Option. Bei der Anbindung über APIYI apiyi.com empfiehlt es sich, in vier Schritten zu prüfen:
- Katalogprüfung: Prüfen Sie im Registry-Eintrag von
qwen4-max, ob Endpunkt und Gruppierung die Protokolle enthalten, die Sie verwenden möchten, z. B.responsesodermessages. - Kontoprüfung: Stellen Sie sicher, dass die Gruppe, zu der das aktuelle Token gehört, die Berechtigung für Aufrufe hat. Dass das Modell im Katalog steht, bedeutet nicht, dass Ihr Konto es aufrufen kann.
- Abrechnungsprüfung: Führen Sie einen Durchlauf mit dem Beispieldatensatz aus und vergleichen Sie den tatsächlich gezahlten Stückpreis Punkt für Punkt mit dem Katalogpreis.
- Funktionsprüfung: Position der Abschneidung bei langem Kontext, Ausgabe im Denkmodus und Unterstützung für Multimodalität testen Sie jeweils direkt über die Route; übernehmen Sie nicht einfach die offiziellen Schwellenwerte von Alibaba Cloud.
Wenn Ihre Arbeitslast bis zum 2026-11-23 abgeschlossen werden kann und die berechneten Kosten pro erfolgreich abgeschlossener Aufgabe tatsächlich niedriger ausfallen, können Sie zunächst eine Weile den Promo-Preis von Together nutzen und gleichzeitig eine Ausweichroute zum Listenpreis sowie ein zweites Budget vorhalten. Wenn die Zeit für die Validierung nicht reicht oder Sie auf Videoeingaben oder sehr lange Ausgaben angewiesen sind, ist es sicherer, den Ablauf zunächst über eine kompatible Schnittstelle wie APIYI apiyi.com zum Katalogpreis zum Laufen zu bringen und erst nach einer Verlängerung oder Vervollständigung der Spezifikationen durch Together die Preise erneut zu vergleichen.
Referenzen
-
Together AI Pricing: Aktionspreis und Gültigkeitszeitraum für Qwen4 Max
- Link:
together.ai/pricing - Hinweis: Auf der Seite ist kein Veröffentlichungsdatum angegeben; der Recherchestand dieses Artikels ist der 20.11.2026
- Link:
-
Together AI Qwen4 Max – Modellseite: Aufruf-ID, Serverless-Beispiel und eine weitere Preisstufe
- Link:
together.ai/models/qwen4-max - Hinweis: Seite ist mit dem 15.11.2026 datiert
- Link:
-
Alibaba Cloud Model Studio Model Prices: Preise für die internationale Bereitstellung in Singapur und Preise für Cache-Schreibvorgänge
- Link:
alibabacloud.com/help/en/model-studio/model-pricing - Hinweis: fortlaufend aktualisierte Preistabelle
- Link:
-
Alibaba Cloud Qwen4-Max – Modellseite: Kontextfenster, Ein- und Ausgabegrenzen sowie Modalitäten
- Link:
alibabacloud.com/help/en/model-studio/qwen4-max - Hinweis: aktualisiert am 18.11.2026
- Link:
-
OrcaRouter-Originalartikel: Quelle für die Meldung zum Rabatt von 30 Prozent und Rechenbeispiele für Agent-Szenarien
- Link:
orcarouter.ai/blog/qwen-4-max-30-percent-price-cut-third-party - Hinweis: veröffentlicht am 19.11.2026; die Erklärung des Preismechanismus darin ist eine Vermutung des Autors
- Link:
-
APIYI-Launch-Ankündigung und Modellregister:
qwen4-max-Endpunkt, Gruppierung und Listenpreis- Link:
docs.apiyi.com/live/2026-11/qwen4-max-launch - Hinweis: Ankündigung veröffentlicht am 17.11.2026, Register erzeugt am 20.11.2026
- Link:
Autor: APIYI-Technikteam
Technischer Austausch: Kontaktieren Sie uns gerne über die Startseite der APIYI-Website unter apiyi.com; weitere Integrationsunterlagen finden Sie im Dokumentationszentrum.