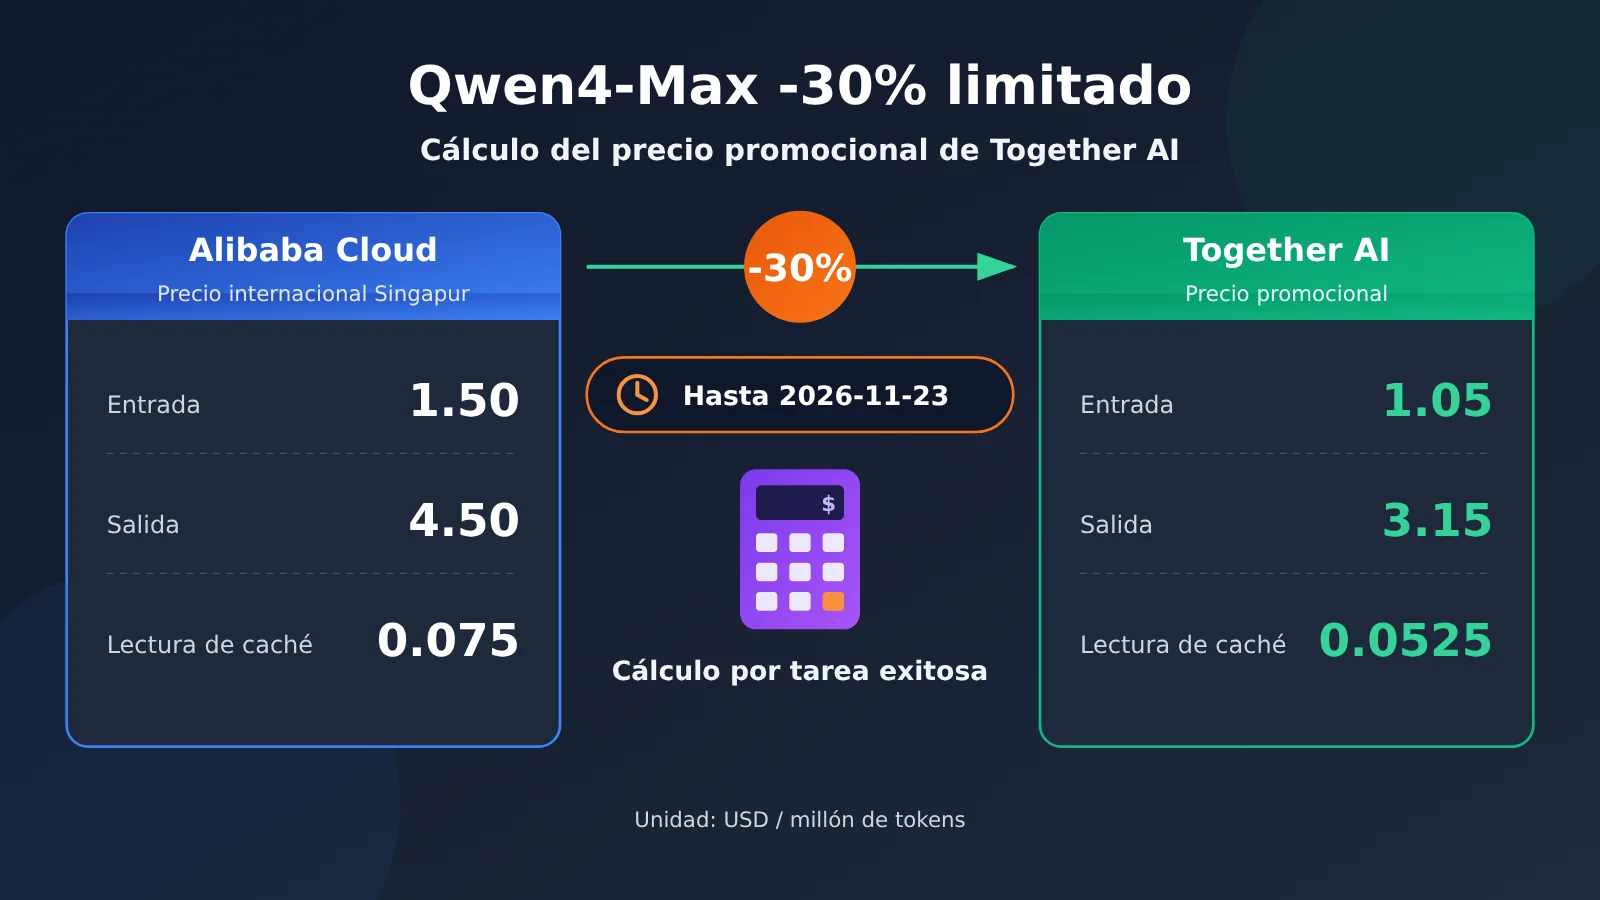
La página oficial de Pricing de Together AI ajustó por tiempo limitado los tres precios de Qwen4-Max —entrada, salida y lectura de caché— al 70 % del precio de despliegue internacional en Singapur de Alibaba Cloud Model Studio; la página indica que la oferta está vigente hasta el 2026-11-23.
La conclusión está condicionada: solo si puedes completar la validación de tus tareas antes de la fecha límite, si dependen principalmente de entradas de texto e imagen y si no superan los límites de longitud que Together todavía no ha detallado uno por uno, esta tarifa al 70 % merece la pena probarla cuanto antes. De lo contrario, conviene usar el «costo por tarea exitosa» para decidir si cambiar, y preparar una segunda factura con el precio posterior a la promoción. Esta tarifa al 70 % es solo una tabla de precios; todavía no equivale a un despliegue que ya hayas validado.
¿Qué puedes aprender al leer este artículo?
- Los valores concretos de la tarifa al 70 % de Together AI, la base de cálculo y la fecha de vencimiento, y de qué página procede cada una de esas cifras.
- Cómo cuadrar las cuentas cuando no coinciden el precio de la página de detalles del modelo de Together y el de la página Pricing.
- Qué elementos de la ventana de contexto, los límites de salida y la facturación de caché que Alibaba Cloud publica oficialmente no se pueden trasladar directamente al enrutamiento de Together.
- Un método de aceptación del cambio para tareas de texto corto, contexto largo e imágenes, junto con ejemplos de cálculo con denominador y supuestos.
- El endpoint, el grupo y el precio de catálogo con los que APIYI publica
qwen4-max, y en qué se diferencia de la promoción de Together.
Índice: El texto principal empieza dividiendo los hechos verificables en cuatro grupos: el precio al 70 % de Together y su plazo, las diferencias del mismo modelo entre páginas, las especificaciones oficiales de Alibaba Cloud y la información de APIYI sobre la puesta a disposición de qwen4-max; cada cifra lleva indicada su atribución y sus condiciones. Después viene la sección de análisis y valoración, que trata, en este orden, el posible mecanismo de fijación de precios que hay detrás de la tarifa al 70 % (siempre como especulación), el método y el código para calcular el costo por tarea exitosa con un mismo lote de tareas, y los puntos que hay que comprobar uno por uno si se usa APIYI como alternativa independiente.
Conceptos clave que conviene conocer sobre el descuento del 30 % en Qwen4-Max
| Concepto | Explicación breve |
|---|---|
| Inferencia serverless | Las instancias en ejecución las gestiona el proveedor; la aplicación llama a una interfaz pública y paga por uso, sin tener que desplegar el modelo por su cuenta |
| Despliegue internacional | Una forma concreta de definir región y despliegue dentro del servicio de modelos de Alibaba Cloud; los precios y las reglas cambian según la región elegida |
| Token | Unidad de medida con la que el modelo procesa texto y otro tipo de información; los conceptos facturables como entrada, salida y caché se calculan por separado |
| Lectura de caché | La solicitud reutiliza entradas ya procesadas anteriormente y se factura según la tarifa de lectura; la escritura de caché tiene otro precio y otra vigencia |
| Ventana de contexto | Longitud total disponible en una sola inferencia; el proveedor también puede limitar por separado la entrada máxima y la salida máxima |
| Modalidad de entrada | Tipos de datos que acepta el servicio del modelo, por ejemplo texto, imagen o video |
| Costo por tarea exitosa | El gasto total de inferencia dividido entre las tareas que superan la validación; también se incluye lo gastado en fallos y reintentos |
Impacto del descuento del 30 % en Qwen4-Max de un vistazo
- Desarrolladores de aplicaciones y responsables de compras: el precio de lista baja un 30 %, pero a la fecha límite le quedan apenas unos tres días y la página no especifica ni la zona horaria ni la hora exacta de cierre. Si no hay tiempo para completar la validación, planificar el presupuesto a largo plazo con el precio promocional es bastante arriesgado.
- Equipos con contextos largos o escenarios de agentes: en las tareas donde los tokens de entrada son la mayor parte, el ahorro es el más evidente. Ahora bien, Together no detalla por separado los límites de entrada y de salida, así que primero hay que medir experimentalmente dónde se produce el truncamiento.
- Quienes necesitan comprensión de video: la página oficial del modelo en Alibaba lista la entrada de video, mientras que la página del modelo en Together, por ahora, solo indica texto e imagen de forma explícita. Hasta contar con una aclaración clara o con resultados de pruebas reales, no conviene migrar allí las tareas de video.
Costo de acceso a Qwen4-Max con descuento del 30 %: hechos objetivos
Precio con descuento del 30 % de Qwen4-Max en Together AI y fecha de finalización
Las cifras de la siguiente tabla se consultaron el 2026-11-20 y están en USD por millón de tokens. Las de Together provienen de su página oficial de precios (Pricing), donde Qwen4 Max aparece marcado como PROMO. Las de Alibaba Cloud provienen del precio de despliegue internacional en Singapur de la lista de precios de Model Studio.
| Concepto de facturación | Precio por tiempo limitado en la página Pricing de Together | Precio de despliegue internacional de Alibaba Cloud en Singapur | Proporción |
|---|---|---|---|
| Entrada | 1.05 | 1.50 | 0.70 |
| Salida | 3.15 | 4.50 | 0.70 |
| Lectura de caché | 0.0525 | 0.075 | 0.70 |
| Vigencia | Indicada en la página hasta 2026-11-23, sin zona horaria ni hora | Lista de precios de vigencia continua | — |
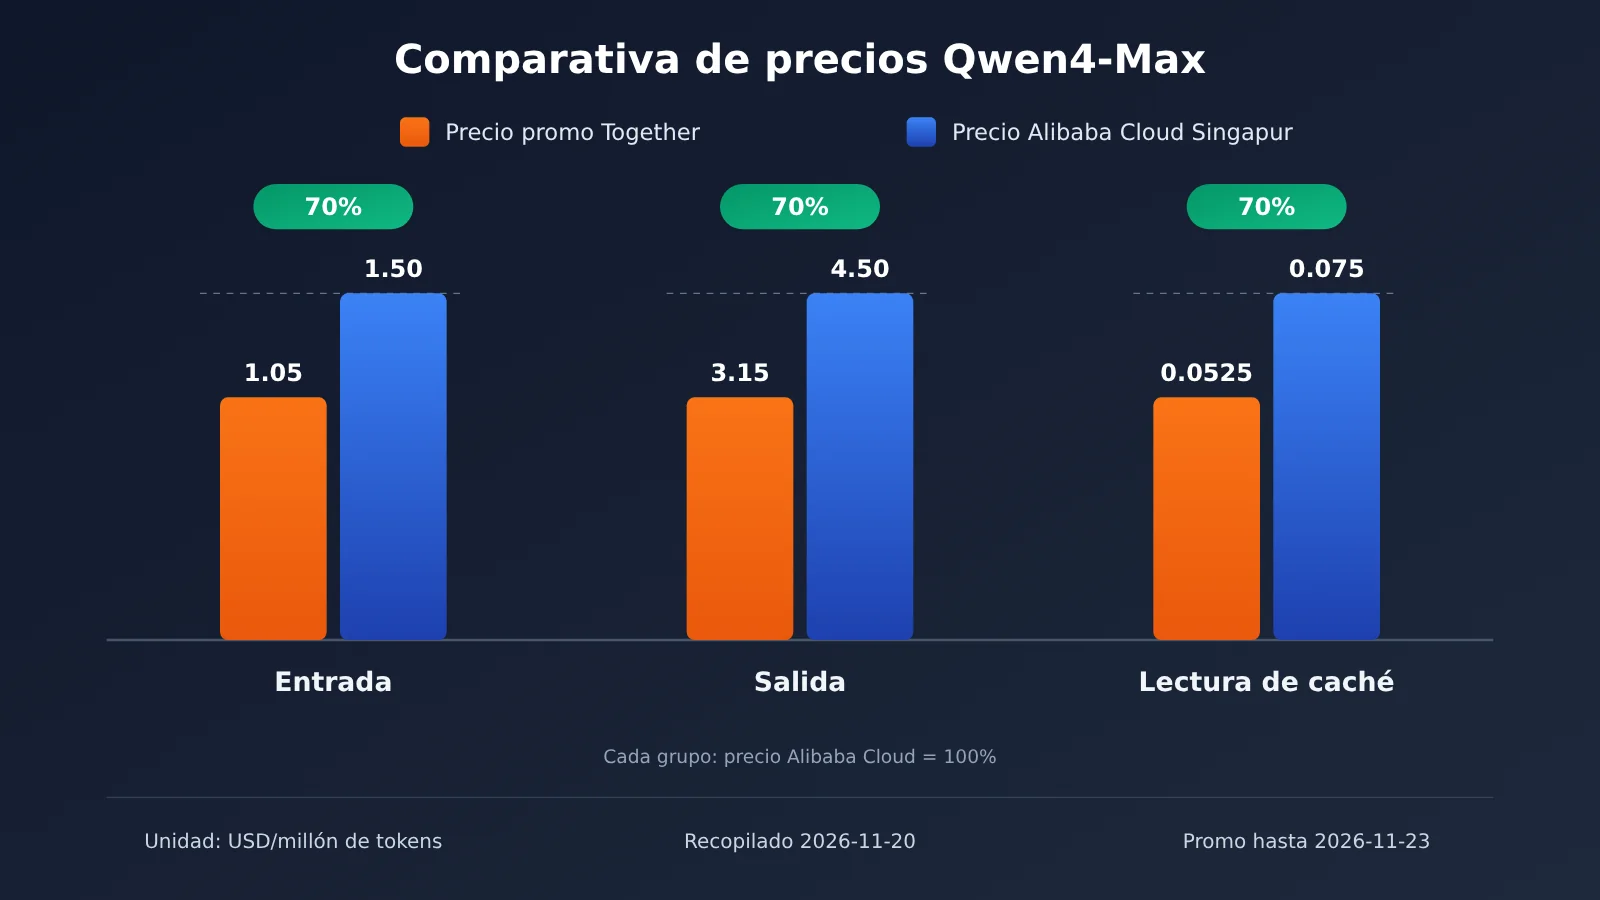
El “precio original” de la página Pricing de Together coincide partida por partida con el precio de Alibaba Cloud en Singapur, y las tres proporciones son exactamente 0.70. Este descuento del 30 % solo corresponde a la referencia de despliegue internacional en Singapur, estos tres conceptos de facturación y esta campaña. Si comparas con precios de Alibaba Cloud en otras regiones, o si intervienen reglas de caché diferentes, tendrás que recalcular el descuento; no puedes reutilizar directamente ese 30 %.
Esta noticia de precios apareció por primera vez en un artículo de OrcaRouter del 2026-11-19, pero el texto original no nombraba la plataforma y el autor además aclaraba que su propia compañía no ofrece este modelo. Por ahora, la fuente donde se pueden verificar esos mismos tres niveles de precio es la propia página Pricing de Together AI, así que, al citar, toma esa página como referencia.
Diferencias de precio de Qwen4-Max entre la página del modelo y la página de Pricing de Together AI
La página de detalles del modelo de Together (marcada con fecha 2026-11-15) publica el ID de invocación Qwen/Qwen4-Max y un ejemplo de invocación Serverless, pero el precio que muestra esa página es otro: entrada 1.43, salida 4.28, lectura de caché 0.0713 (USD/millón de tokens). Los números de las dos páginas públicas del mismo proveedor no coinciden, así que al citar el precio con descuento del 30% conviene especificar que se trata del «precio promocional indicado en la página oficial de Pricing» y anotar la fecha de consulta; la liquidación real debe basarse en el detalle de uso de la cuenta.
| Dimensión | Información pública de Together | Información oficial de Alibaba Cloud |
|---|---|---|
| ID de invocación | Qwen/Qwen4-Max, con ejemplo Serverless |
Página del modelo en Model Studio |
| Modalidad de entrada | La página del modelo lista explícitamente texto e imagen | Entrada de texto, imagen y video; salida de texto |
| Contexto total | Se promociona una ventana total de 1 millón | Contexto total de 1 millón de tokens |
| Entrada máxima | No confirmada ítem por ítem | Sin razonamiento 991,808 / Con razonamiento 983,616 |
| Salida máxima | No confirmada ítem por ítem | Sin razonamiento 131,072 / Con razonamiento 262,144 |
| Lectura de caché | Página de Pricing 0.0525; página del modelo 0.0713 | Singapur 0.075 |
| Escritura de caché | No publicada | 5 minutos 1.875; 1 hora 3 (USD/millón) |
La página oficial del modelo de Alibaba Cloud se actualizó el 2026-11-18. Según la descripción del artículo de OrcaRouter, en modo razonamiento el contenido de pensamiento y la respuesta comparten un presupuesto de 262,144 tokens. Estos límites, modalidades y reglas de caché corresponden al despliegue propio de Alibaba Cloud y no deben tomarse directamente como capacidades del enrutamiento de Together. Además, algunas descripciones anteriores mencionaban que la página de Together mostraba un aviso de que estaba pendiente de lanzamiento. Ahora la página del modelo ya ofrece el ID de invocación y el ejemplo, pero esta ronda de verificación no comprobó si la invocación real funciona.
Información del lanzamiento de qwen4-max en APIYI y precio de catálogo
APIYI (apiyi.com) publicó un anuncio el 17/11/2026 a las 16:07 y lanzó qwen4-max. El registro público de modelos generado el 20/11/2026 a las 15:17 (UTC+8) también incluye este ID. La afirmación anterior del blog de APIYI de que “aún no está disponible” queda supeditada a este anuncio y a este registro, que son los más recientes.
| Elemento | Información pública del catálogo de APIYI |
|---|---|
| ID del modelo | qwen4-max |
| Endpoints | chat, responses, messages |
| Grupos de tokens | ClaudeCode, CodexResponses, default, svip |
| Precio de catálogo (USD / millón de tokens) | Entrada 1.50, salida 4.50, lectura de caché 0.075 |
| Método de verificación | Basado en el anuncio oficial y el registro; no se realizaron llamadas de pago |
Estos precios de catálogo coinciden numéricamente con los del despliegue internacional de Alibaba Cloud en Singapur. No se trata de una promoción de Together ni de un descuento de APIYI. La agrupación de cuentas, los permisos de tokens y la forma de liquidación de la plataforma influyen en si se puede invocar el modelo y en el importe final realmente pagado.
¿Vale la pena cambiar a Qwen4-Max con un 30% de descuento? Análisis y valoración
Posibles mecanismos de precios detrás del descuento del 30% de Qwen4-Max (especulaciones)
El texto original de OrcaRouter plantea tres explicaciones. Las detallo a continuación, y todas son solo especulaciones: la página pública de Together únicamente confirma la promoción en sí y la fecha de vencimiento anunciada de forma explícita, pero no revela quién asume el descuento.
- Subsidio del proveedor (especulación): el proveedor del modelo, para dar a conocer el nuevo modelo, subvenciona el precio de lanzamiento en plataformas de terceros. Si es así, lo más probable es que, una vez terminado el subsidio, el precio vuelva al precio base.
- Precio mayorista (especulación): la plataforma consiguió un precio de compra más bajo y puede mantener el descuento a largo plazo. Pero este escenario normalmente no se etiquetaría como PROMO ni llevaría fecha límite, lo que no encaja del todo con lo que muestra la página actual.
- Pérdidas para atraer tráfico (especulación): la plataforma acepta pérdidas a corto plazo a cambio de nuevos usuarios. En este caso, la duración del descuento depende de la estrategia de la plataforma y no se puede predecir.
El texto original toma como punto de observación el final de diciembre, pero el plazo ya anunciado es el 23 de noviembre. A la hora de elaborar el presupuesto, conviene calcular primero con el vencimiento del día 23 y actualizar después si se publica algún anuncio de prórroga.
Calcular el costo por tarea exitosa de Qwen4-Max con un mismo lote de tareas
Comparar solo los precios por token suele dejar fuera los costos que traen consigo los fallos, los reintentos y los truncamientos. Lo más sensato es fijar un conjunto de tareas, las indicaciones y las reglas de aceptación, enviar las mismas muestras a cada ruta candidata, registrar en cada invocación la entrada, la salida, los aciertos de caché, los fallos, los reintentos y la latencia, y después dividir el gasto total entre el número de tareas que pasaron la aceptación. Conviene preparar al menos tres tipos de muestras:
- Tareas de texto corto: por ejemplo clasificación, extracción o reescritura; lo importante aquí es la tasa de éxito y si la longitud de salida se mantiene estable.
- Tareas de contexto largo: por ejemplo enviar una solicitud de unos 400.000 tokens y observar dónde se produce el truncamiento, además de si el presupuesto de salida alcanza en modo de razonamiento.
- Tareas con imágenes: sobre las entradas de imagen que Together ya admite de forma explícita, verificar si el resultado del reconocimiento y el cobro coinciden con lo esperado.
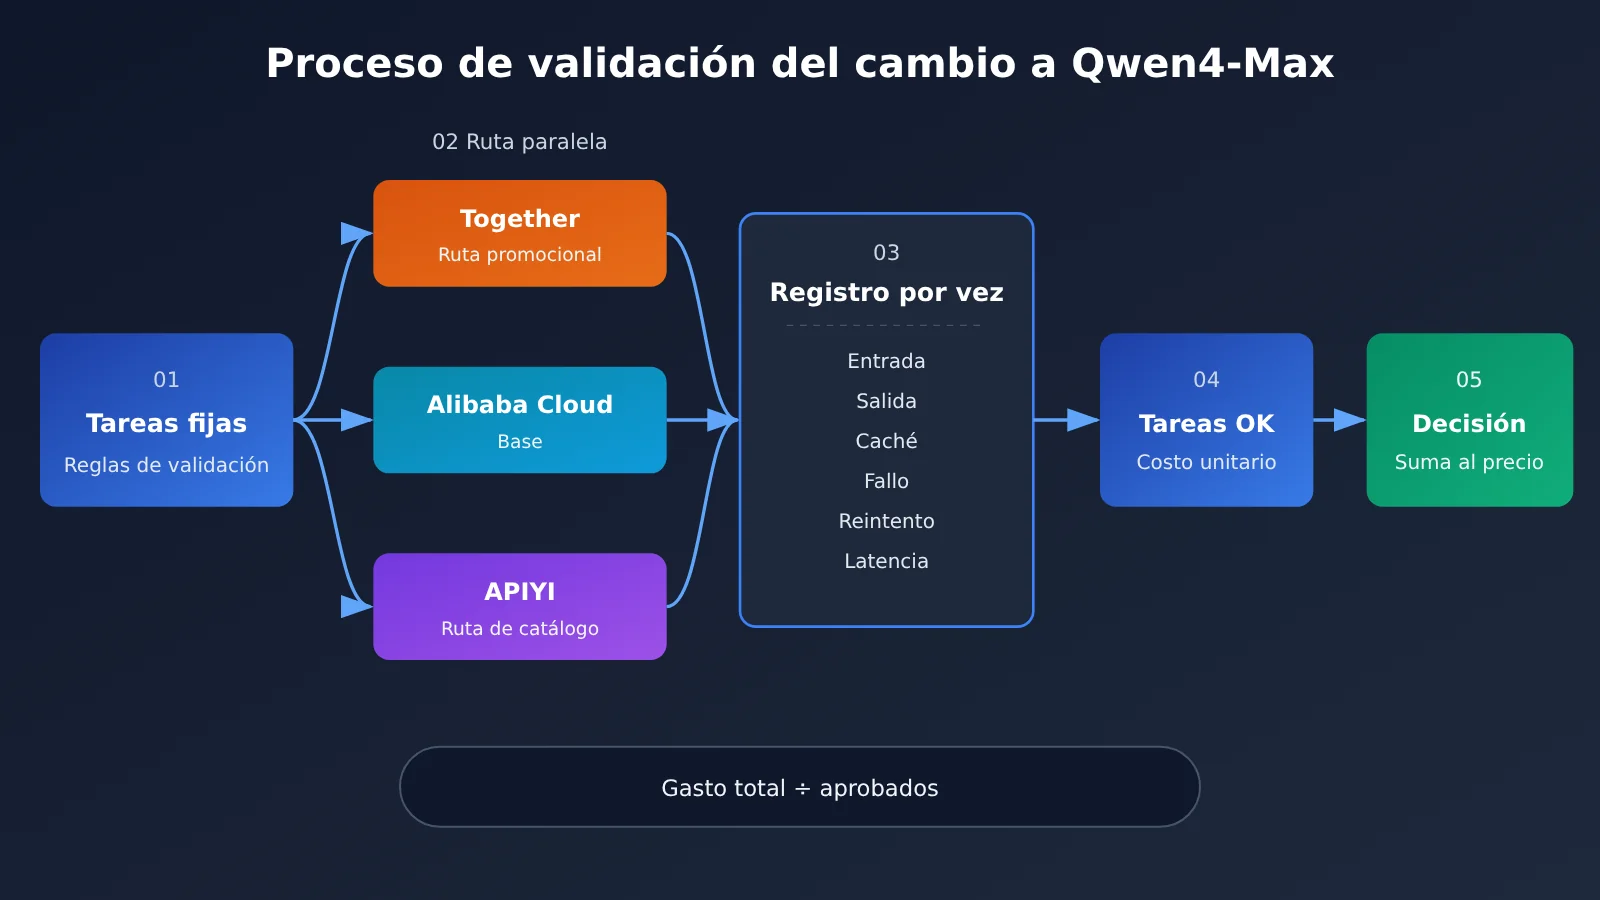
El ejemplo de texto corto de la tabla siguiente son datos hipotéticos, pensados para mostrar cómo se debe construir el denominador. El ejemplo de contexto largo toma el cálculo de OrcaRouter: 200.000 de entrada y 30.000 de salida por ronda, 40 rondas, sin usar caché, con los precios de ambos lados calculados según la referencia de Singapur.
| Ejemplo | Supuestos y denominador | Precio promocional de Together | Tras el fin de la promoción (suponiendo un regreso al precio original de 1,50/4,50 de la página Pricing) | Diferencia |
|---|---|---|---|---|
| Texto corto (hipotético) | 2.000 de entrada y 500 de salida por vez; 100 tareas, 8 reintentos, 108 invocaciones en total; 92 pasan la aceptación | 108 × 0,003675 ≈ 0,397, ÷ 92 ≈ 0,00431 por tarea exitosa | 108 × 0,00525 ≈ 0,567, ÷ 92 ≈ 0,00616 | Aprox. 0,00185 por tarea exitosa |
| Agente de contexto largo (ejemplo de OrcaRouter) | 40 rondas equivalen a 1 ejecución, sin caché, suponiendo que todas tienen éxito | 0,3045 por ronda, 12,18 por ejecución | 0,435 por ronda, 17,40 por ejecución | 5,22 por ejecución |
Según este ejemplo, al ejecutar mil veces al mes la diferencia ronda los 5.220 dólares, mientras que al ejecutar diez veces apenas son unos 52 dólares. Hay que tener en cuenta que, si al terminar la promoción el precio vuelve al nivel de 1,43/4,28 de la página del modelo, el resultado será distinto. Por eso conviene mantener en la columna de precios las tres variantes a la vez —»precio promocional», «precio original de Pricing» y «precio de la página del modelo»— y contrastarlas con el precio real una vez que llegue la factura.
Ejemplo de código para la prueba de costos de Qwen4-Max
El siguiente ejemplo minimalista muestra una invocación compatible con OpenAI. Tomando como ejemplo la ruta de APIYI, al cambiar a otra ruta basta con reemplazar base_url y el ID del modelo por los valores publicados por el proveedor correspondiente.
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Interfaz compatible con OpenAI de APIYI
)

resp = client.chat.completions.create(
    model="qwen4-max",
    messages=[{"role": "user", "content": "用一句话说明缓存读计费"}]
)
print(resp.choices[0].message.content, resp.usage)
Ver el script completo que contabiliza el «costo por tarea exitosa»
import time
import openai

# Unidad: USD / millón de tokens; registrar los tres conjuntos de precios por separado y, cuando llegue la factura, sustituirlos por el precio unitario realmente pagado
PRICES = {
    "together_promo": {"in": 1.05, "out": 3.15, "cache_read": 0.0525},
    "list_price":     {"in": 1.50, "out": 4.50, "cache_read": 0.075},
    "together_model_page": {"in": 1.43, "out": 4.28, "cache_read": 0.0713},
}

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Reemplazar con la ruta que se va a probar
)

def run_task(prompt, validate, model="qwen4-max", max_retries=2):
    """Devuelve el registro de uso de cada llamada y si la tarea finalmente supera la validación"""
    records = []
    for attempt in range(max_retries + 1):
        t0 = time.time()
        try:
            r = client.chat.completions.create(
                model=model,
                messages=[{"role": "user", "content": prompt}],
            )
            u = r.usage
            details = getattr(u, "prompt_tokens_details", None)
            cached = getattr(details, "cached_tokens", 0) or 0
            ok = validate(r.choices[0].message.content)
            records.append({"in": u.prompt_tokens - cached, "cache": cached,
                            "out": u.completion_tokens, "ok": ok,
                            "latency": time.time() - t0})
            if ok:
                return records, True
        except Exception as e:
            records.append({"in": 0, "cache": 0, "out": 0, "ok": False,
                            "latency": time.time() - t0, "error": str(e)})
    return records, False

def cost_per_success(all_records, passed, price):
    total = sum(r["in"] * price["in"] + r["out"] * price["out"]
                + r["cache"] * price["cache_read"] for r in all_records) / 1e6
    return total / passed if passed else float("inf")
El campo de caché del script depende de si la interfaz devuelve cached_tokens. Los campos devueltos pueden variar según la ruta, así que al final lo que manda es la factura de la plataforma. El costo de escritura en caché (Alibaba Cloud lo divide oficialmente en dos tramos: 5 minutos y 1 hora) no tiene precio público del lado de Together, por lo que conviene registrarlo por separado durante las pruebas.
🚀 Sugerencia para las pruebas: El tiempo antes de la fecha límite es muy ajustado. Primero puedes usar el crédito gratuito para nuevos usuarios en APIYI apiyi.com para ejecutar de principio a fin el conjunto de ejemplos y el script de contabilidad, confirmar que las reglas de validación y el formato del registro no tienen problemas y, después, apuntar el mismo script a la ruta de Together para comparar. Así, todo el tiempo de pruebas dentro de la ventana promocional se puede dedicar a comparar precios.
Lista de verificación para usar qwen4-max de APIYI como alternativa independiente
El precio de catálogo de APIYI es igual al de Alibaba Cloud en Singapur; su función es ofrecer otra vía estable facturada a precio de lista cuando termina la promoción o cuando falla la validación de la ruta de Together, no ser una opción más barata. Al integrar en APIYI apiyi.com, se recomienda verificar en cuatro pasos:
- Verificación del catálogo: Comprueba si el endpoint y el grupo de
qwen4-maxen el registro incluyen el protocolo que vas a usar, por ejemploresponsesomessages. - Verificación de la cuenta: Confirma si el grupo en el que se encuentra el token actual tiene permiso de invocación; que el modelo aparezca en el catálogo no significa que tu cuenta pueda invocarlo.
- Verificación de la facturación: Ejecuta una ronda con el conjunto de muestras y compara ítem por ítem el precio unitario realmente pagado con el precio de catálogo.
- Verificación de capacidades: La posición de truncamiento en contextos largos, la salida en modo de razonamiento y el soporte multimodal se deben medir en la práctica según la ruta, sin aplicar directamente los umbrales oficiales de Alibaba Cloud.
Si tu carga de trabajo puede completar la aceptación antes del 2026-11-23 y el costo calculado por tarea exitosa resulta realmente más bajo, puedes usar primero el precio promocional de Together durante un tiempo, manteniendo a la vez una ruta alternativa a precio de lista y un segundo presupuesto. Si no llegas a tiempo para validar, o si dependes de entrada de video o de salidas muy largas, lo más prudente es poner en marcha el flujo primero a precio de catálogo en una interfaz compatible como APIYI apiyi.com, y volver a comparar precios cuando Together anuncie una extensión o complete las especificaciones.
Referencias
-
Precios de Together AI: precio promocional y vigencia de Qwen4 Max
- Enlace:
together.ai/pricing - Descripción: la página no indica fecha de publicación; la fecha de consulta para este artículo es 2026-11-20
- Enlace:
-
Página del modelo Qwen4 Max de Together AI: ID de invocación, ejemplo Serverless y otro nivel de precios
- Enlace:
together.ai/models/qwen4-max - Descripción: la página está marcada con fecha 2026-11-15
- Enlace:
-
Precios de modelos de Alibaba Cloud Model Studio: precio de despliegue internacional en Singapur y precio de escritura en caché
- Enlace:
alibabacloud.com/help/en/model-studio/model-pricing - Descripción: lista de precios que se actualiza de forma continua
- Enlace:
-
Página del modelo Qwen4-Max de Alibaba Cloud: ventana de contexto, límites de entrada y salida, y modalidades
- Enlace:
alibabacloud.com/help/en/model-studio/qwen4-max - Descripción: actualizada el 2026-11-18
- Enlace:
-
Artículo original de OrcaRouter: origen de la noticia del descuento del 30% y ejemplo de cálculo para escenarios de agentes
- Enlace:
orcarouter.ai/blog/qwen-4-max-30-percent-price-cut-third-party - Descripción: publicado el 2026-11-19; la explicación del mecanismo de precios que aparece allí es una suposición del autor
- Enlace:
-
Anuncio de lanzamiento y registro de modelos de APIYI: endpoint
qwen4-max, grupos y precio de catálogo- Enlace:
docs.apiyi.com/live/2026-11/qwen4-max-launch - Descripción: anuncio publicado el 2026-11-17; registro generado el 2026-11-20
- Enlace:
Autor: equipo técnico de APIYI
Contacto técnico: puedes contactarnos desde la página principal del sitio oficial de APIYI, apiyi.com; encontrarás más material de integración en el centro de documentación.