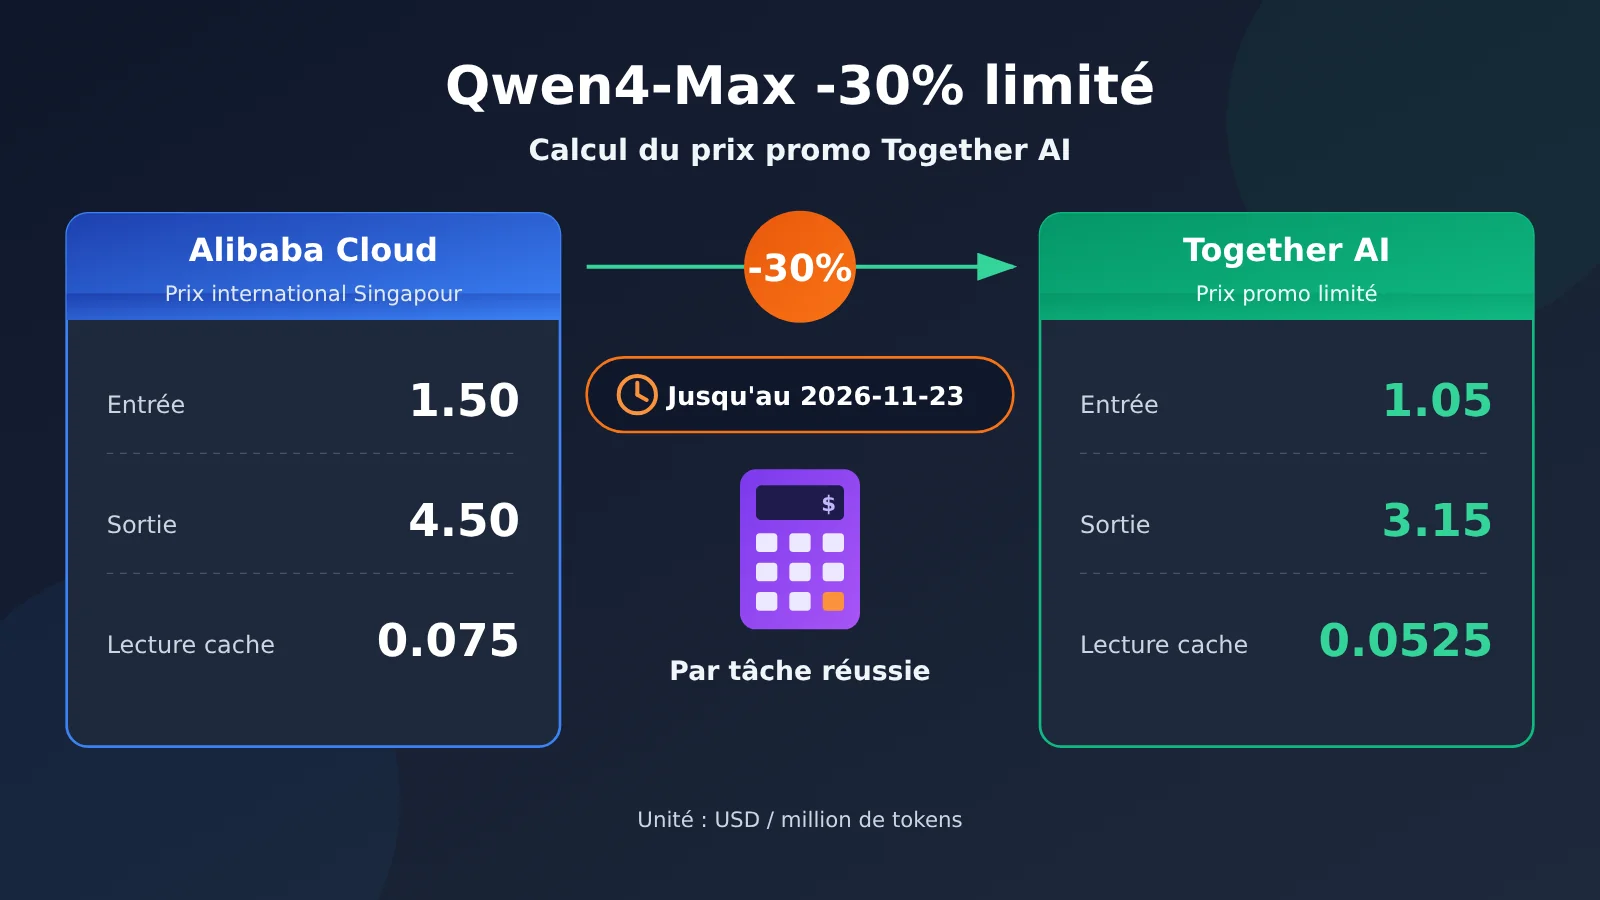
La page Pricing officielle de Together AI a ramené, pour une durée limitée, les trois tarifs de Qwen4-Max — entrée, sortie et lecture du cache — à 70 % du prix de déploiement international de Model Studio d’Alibaba Cloud à Singapour. La page indique que l’offre est valable jusqu’au 2026-11-23.
La conclusion est conditionnelle : ce tarif à 70 % ne vaut la peine d’être testé en priorité que si vos tâches peuvent être validées avant la date limite, reposent principalement sur des entrées texte et image et ne se heurtent pas aux limites de longueur que Together n’a pas encore détaillées publiquement une par une. Sinon, décidez si vous basculez en vous appuyant sur le « coût par tâche réussie », et préparez une seconde facture sur la base des prix applicables après la fin de l’offre. Ce tarif à 70 % est une grille tarifaire ; il ne correspond pas encore à un déploiement que vous avez validé.
Ce que vous apprendrez à la lecture de cet article
- Les valeurs exactes de la remise de Together AI, sa base de calcul et sa date d’expiration, ainsi que la page d’où vient chaque chiffre.
- Comment rapprocher les comptes quand la page de détail du modèle Together et la page Pricing affichent des prix différents.
- Parmi les fenêtres de contexte, limites de sortie et règles de facturation du cache publiées officiellement par Alibaba Cloud, lesquelles ne peuvent pas être reprises telles quelles pour le routage Together.
- Une méthode de validation du basculement pour les tâches de texte court, de contexte long et d’images, avec des exemples de calcul comportant un dénominateur et des hypothèses.
- Les endpoints, groupes et prix catalogue de
qwen4-maxlistés sur APIYI, ainsi que leur différence avec la promotion Together.
Sommaire : le corps de l’article commence par répartir les faits vérifiables en quatre groupes : le tarif à 70 % de Together et sa date d’expiration ; les différences entre pages pour un modèle de même nom ; les spécifications officielles d’Alibaba Cloud ; et les informations de mise en ligne sur APIYI. Chaque chiffre est accompagné de son origine et de ses conditions. Vient ensuite la partie analyse et interprétation, qui aborde successivement le mécanisme de tarification possible derrière cette remise (purement spéculatif), la méthode et le code pour calculer le coût par tâche réussie sur un même lot de tâches, ainsi que les points à vérifier un par un si l’on considère APIYI comme solution de repli indépendante.
Qwen4-Max à -30 % : les notions à connaître
| Concept | Explication rapide |
|---|---|
| Inférence serverless | Les instances d’exécution sont gérées par le fournisseur ; l’application appelle le service à la demande via une API publique, sans avoir à déployer le modèle soi-même. |
| Déploiement international | Mode de déploiement et de zone géographique proposé par les services de modèles Alibaba Cloud ; les prix et les règles varient selon la région choisie. |
| Token | Unité de mesure pour le texte et les autres informations traitées par le modèle ; les entrées, les sorties, le cache et les autres postes de facturation sont calculés séparément. |
| Lecture du cache | La requête réutilise une entrée déjà traitée auparavant et est facturée selon le tarif de lecture du cache ; l’écriture dans le cache a son propre tarif et sa propre durée de validité. |
| Fenêtre de contexte | Longueur totale disponible pour une seule inférence ; le fournisseur peut en outre limiter séparément la longueur maximale en entrée et en sortie. |
| Modalités d’entrée | Types de données acceptés par le service de modèle, par exemple texte, image ou vidéo. |
| Coût par tâche réussie | Dépenses totales d’inférence divisées par le nombre de tâches validées ; les dépenses générées par les échecs et les nouvelles tentatives sont aussi comptabilisées. |
Qwen4-Max à -30 % : aperçu des impacts
- Développeurs d’applications et responsables des achats : le prix affiché baisse de 30 %, mais il ne reste plus qu’environ trois jours avant la date limite, et la page n’indique ni le fuseau horaire ni l’heure exacte de fin. S’il n’est pas possible de terminer la validation à temps, établir un budget à long terme sur la base du prix promotionnel comporte un risque important.
- Équipes travaillant sur des scénarios à contexte long ou sur des agents : pour les tâches où les tokens d’entrée représentent la majorité, les économies sont les plus visibles. Toutefois, Together ne publie pas séparément les limites maximales d’entrée et de sortie ; il faut d’abord déterminer empiriquement où la troncature se produit.
- Équipes ayant besoin de compréhension vidéo : la page officielle du modèle chez Alibaba mentionne l’entrée vidéo, alors que la page du modèle chez Together ne liste actuellement de manière explicite que le texte et les images. Tant qu’on ne dispose pas d’une explication claire ou de résultats de tests, il n’est pas conseillé d’y migrer les tâches vidéo.
Coût d’accès à Qwen4-Max à 70 % du prix : les faits
Le tarif à 70 % de Together AI pour Qwen4-Max et sa date d’expiration
Les chiffres du tableau ci-dessous ont été relevés au 2026-11-20 ; ils sont exprimés en dollars US par million de tokens. Ceux de Together proviennent de sa page Pricing officielle, qui marque Qwen4 Max comme PROMO. Ceux d’Alibaba Cloud proviennent de la grille tarifaire de Model Studio, pour le prix du déploiement international à Singapour.
| Poste de facturation | Prix limité dans le temps de la page Pricing de Together | Prix du déploiement international Singapour d’Alibaba Cloud | Ratio |
|---|---|---|---|
| Entrée | 1.05 | 1.50 | 0.70 |
| Sortie | 3.15 | 4.50 | 0.70 |
| Lecture du cache | 0.0525 | 0.075 | 0.70 |
| Validité | Indiqué sur la page jusqu’au 2026-11-23, sans fuseau horaire ni heure | Grille tarifaire évolutive | — |
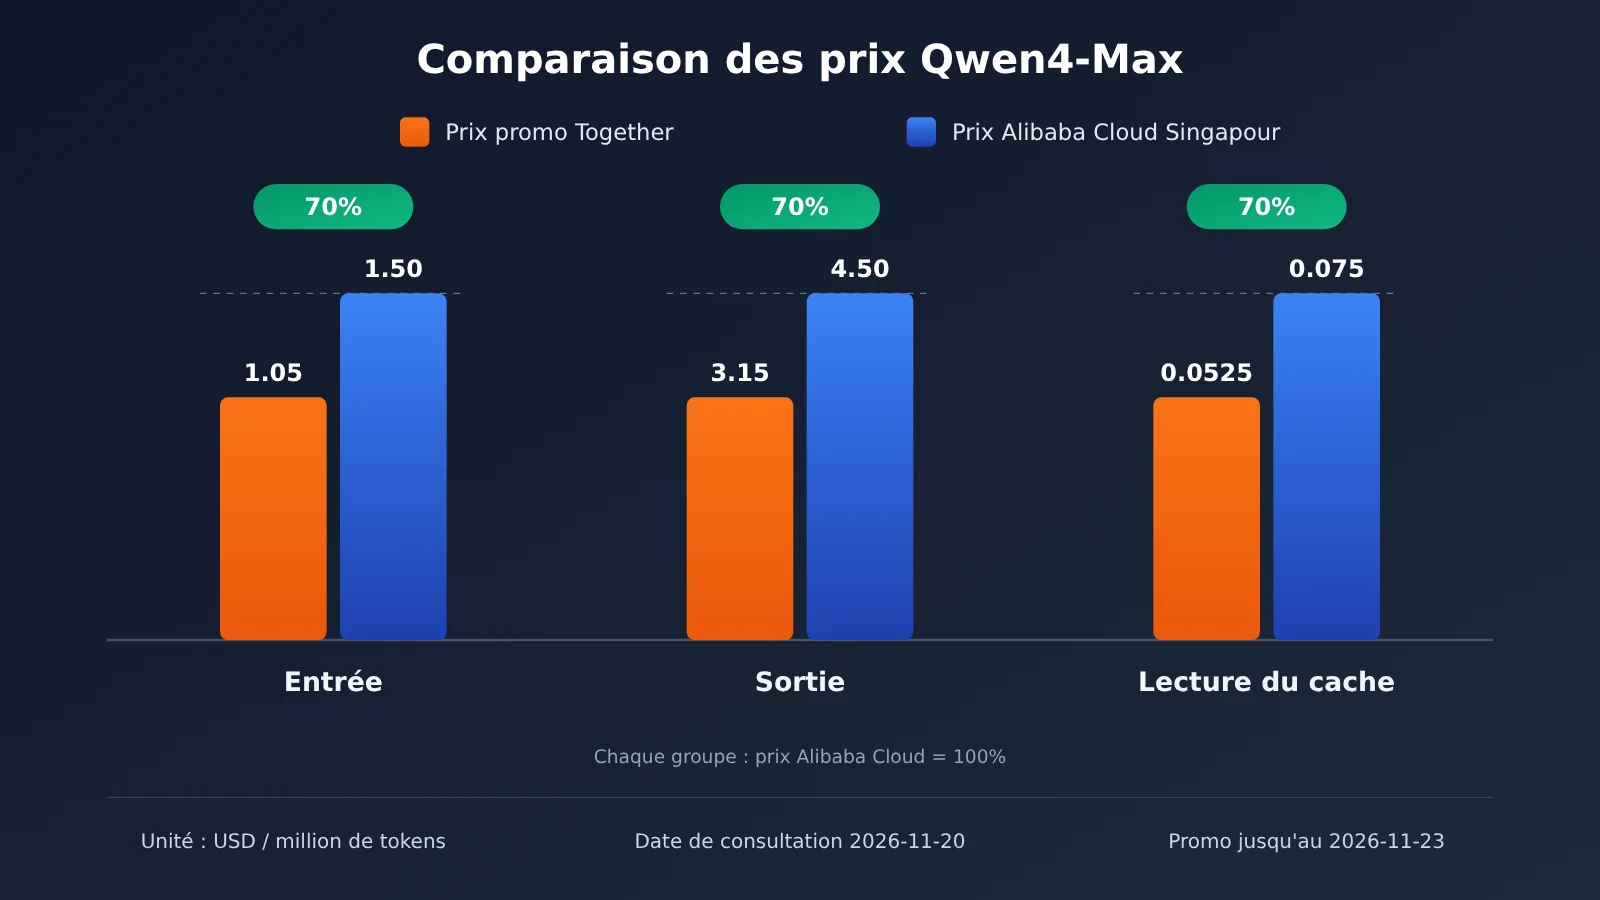
Le « prix de référence » affiché sur la page Pricing de Together est identique, poste par poste, au prix Singapour d’Alibaba Cloud, et le ratio des trois postes vaut exactement 0.70. Cette remise de 30 % ne concerne donc que le déploiement international à Singapour comme base de comparaison, ces trois postes de facturation et cette campagne précise. Si vous comparez avec les tarifs d’Alibaba Cloud dans d’autres régions, ou si des règles de cache différentes entrent en jeu, il faut recalculer la remise : impossible de reconduire tel quel le 30 %.
Cette information tarifaire est apparue pour la première fois dans un article d’OrcaRouter daté du 2026-11-19, mais l’article ne nommait pas la plateforme, et son auteur précisait que la sienne ne proposait pas ce modèle. Aujourd’hui, la source où l’on peut vérifier ces trois mêmes niveaux de prix est la page Pricing de Together AI elle-même ; c’est donc elle qu’il faut citer.
Écart de prix du Qwen4-Max entre la page du modèle et la page Pricing de Together AI
La page de détail du modèle Together (page marquée 2026-11-15) rend publique l’ID d’appel Qwen/Qwen4-Max ainsi qu’un exemple d’appel Serverless, mais le prix affiché sur cette page correspond à une autre grille tarifaire : entrée 1.43, sortie 4.28, lecture du cache 0.0713 (USD par million de tokens). Les chiffres de deux pages publiques d’un même fournisseur ne concordent pas ; par conséquent, si vous citez la promotion à -30 %, précisez qu’il s’agit du « prix promotionnel indiqué sur la page Pricing officielle » et notez la date de consultation. Le règlement final s’effectue selon le détail de consommation du compte.
| Dimension | Informations publiques de Together | Informations officielles d’Aliyun |
|---|---|---|
| ID d’appel | Qwen/Qwen4-Max, avec un exemple Serverless |
Page du modèle dans Model Studio |
| Modalités d’entrée | La page du modèle liste explicitement texte et image | Entrées texte, image et vidéo ; sortie texte |
| Contexte total | Fenêtre totale de 1 million annoncée | Contexte total de 1 million de tokens |
| Entrée maximale | Non confirmé point par point | Sans réflexion : 991,808 / avec réflexion : 983,616 |
| Sortie maximale | Non confirmé point par point | Sans réflexion : 131,072 / avec réflexion : 262,144 |
| Lecture du cache | Page Pricing : 0.0525 ; page du modèle : 0.0713 | Singapour : 0.075 |
| Écriture dans le cache | Non publié | 5 minutes : 1.875 ; 1 heure : 3 (USD/million) |
La page officielle du modèle Aliyun a été mise à jour le 2026-11-18. Selon la description donnée dans l’article OrcaRouter, en mode réflexion, le contenu de réflexion et la réponse partagent un budget de 262,144 tokens. Ces limites, modalités et règles de cache sont propres au déploiement d’Aliyun et ne doivent pas être directement considérées comme des capacités du routage Together. Par ailleurs, une description antérieure mentionnait qu’un message « en attente de mise en ligne » avait déjà été affiché sur la page Together. Aujourd’hui, la page du modèle fournit bien l’ID d’appel et un exemple, mais cette vérification n’a pas testé si l’appel réel aboutit.
APIYI qwen4-max : informations de lancement et prix catalogue
APIYI (apiyi.com) a publié une annonce le 2026-11-17 à 16:07 pour le lancement de qwen4-max. Cet ID figure également dans le registre public des modèles généré le 2026-11-20 à 15:17 (UTC+8). Désormais, cette dernière annonce et le registre font foi, plutôt que la mention « pas encore disponible » publiée auparavant dans le blog d’APIYI.
| Élément | Informations du catalogue public d’APIYI |
|---|---|
| ID du modèle | qwen4-max |
| Points de terminaison | chat, responses, messages |
| Groupes de tokens | ClaudeCode, CodexResponses, default, svip |
| Prix catalogue (USD / million de tokens) | entrée 1.50, sortie 4.50, lecture du cache 0.075 |
| Méthode de vérification | D’après l’annonce officielle et le registre ; aucun appel payant n’a été effectué |
Ces prix catalogue affichent les mêmes valeurs que le tarif du déploiement international d’Alibaba Cloud à Singapour. Ce n’est pas une promotion Together, ni une remise APIYI. Le groupe de compte, les permissions du token et le mode de facturation de la plateforme influencent tous la possibilité d’appeler le modèle ainsi que le montant final réellement facturé.
Qwen4-Max avec 30 % de remise : vaut-il la peine de changer ? Analyse et avis
Mécanismes de tarification possibles derrière la remise de 30 % sur Qwen4-Max (hypothèses)
Le texte original d’OrcaRouter avance trois explications. Voici chacune d’elles — il ne s’agit à chaque fois que de suppositions : la page publique de Together permet uniquement de confirmer la promotion elle-même et la date d’expiration indiquée explicitement, sans révéler qui supporte la remise.
- Subvention du fournisseur (hypothèse) : le fournisseur du modèle, pour faire la promotion d’un nouveau modèle, subventionne le prix de lancement sur une plateforme tierce. Si c’est le cas, une fois la subvention terminée, le prix reviendra très probablement au tarif de référence.
- Prix de gros (hypothèse) : la plateforme a obtenu un prix d’achat plus bas et peut donc répercuter la baisse sur la durée. Mais en général, ce genre de situation ne s’accompagne pas d’une mention PROMO ni d’une date limite, ce qui cadre mal avec ce qu’affiche la page actuelle.
- Vente à perte pour attirer du trafic (hypothèse) : la plateforme accepte une perte à court terme pour gagner de nouveaux utilisateurs. Dans ce cas, la durée de la remise dépend de la stratégie de la plateforme et il est impossible de la prévoir.
Le texte original retient la fin décembre comme point d’observation, mais la date limite déjà annoncée est le 23 novembre. Pour établir un budget, mieux vaut d’abord partir du principe que la promotion expire le 23, puis mettre à jour si une prolongation est annoncée par la suite.
Calculer le coût par tâche réussie de Qwen4-Max à partir d’un même lot de tâches
Comparer uniquement sur la base du prix au token fait facilement passer à côté des coûts occasionnés par les échecs, les nouvelles tentatives et la troncature. La méthode la plus sûre consiste à figer un ensemble de tâches, les invites et les règles d’acceptation, puis à faire tourner les mêmes échantillons sur les routes candidates, en consignant pour chaque appel les entrées, les sorties, les hits de cache, les échecs, les nouvelles tentatives et la latence, avant de diviser la dépense totale par le nombre de tâches validées. Je recommande de prévoir au moins trois types d’échantillons :
- Tâches de texte court : par exemple classification, extraction, réécriture ; l’important est surtout de vérifier le taux de réussite et la stabilité de la longueur de sortie.
- Tâches à contexte long : par exemple envoyer une requête d’environ 400,000 token, observer où elle est tronquée et si le budget de sortie suffit en mode réflexion.
- Tâches d’image : sur les entrées d’image explicitement prises en charge par Together, vérifier que le résultat de reconnaissance et la facturation correspondent à ce qui est attendu.
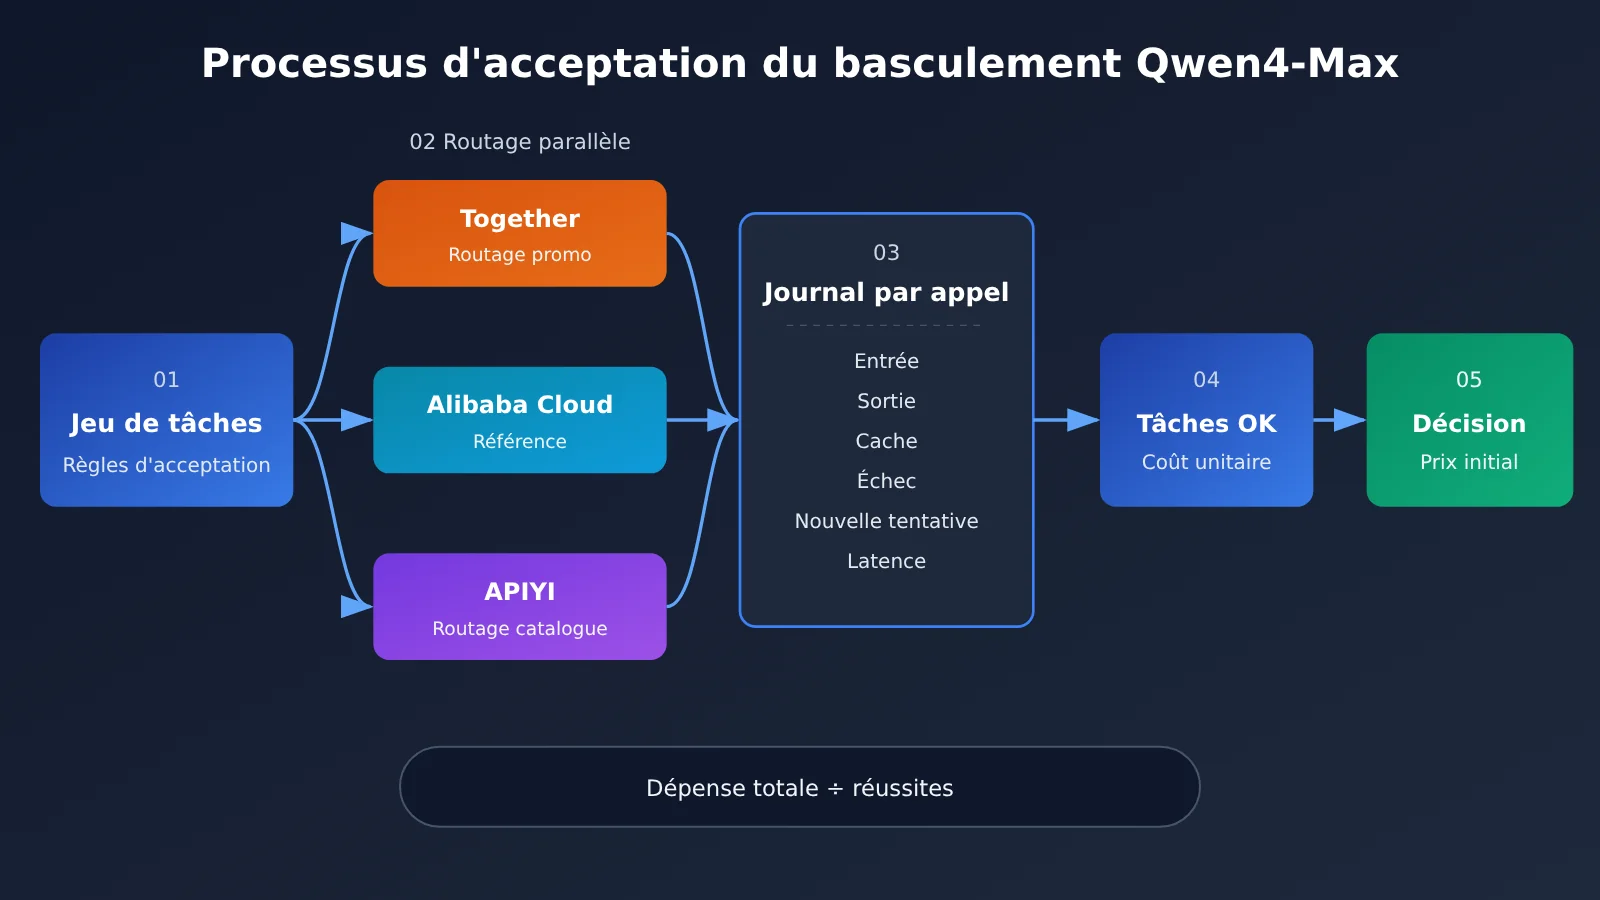
L’exemple de texte court du tableau ci-dessous est constitué de données hypothétiques ; il montre comment choisir le dénominateur. L’exemple de contexte long reprend le calcul d’OrcaRouter : 200,000 tokens en entrée et 30,000 en sortie par tour, sur 40 tours, sans utiliser de cache, les deux solutions étant calculées selon les tarifs de référence de Singapour.
| Exemple | Hypothèses et dénominateur | Prix promo Together | Après fin de l’offre (hypothèse de retour au prix original de la page Pricing, 1.50/4.50) | Écart |
|---|---|---|---|---|
| Texte court (hypothèse) | 2,000 entrées et 500 sorties par appel ; 100 tâches, 8 nouvelles tentatives, soit 108 appels ; 92 validées | 108 × 0.003675 ≈ 0.397, ÷ 92 ≈ 0.00431 par tâche réussie | 108 × 0.00525 ≈ 0.567, ÷ 92 ≈ 0.00616 | environ 0.00185 par tâche réussie |
| Agent à contexte long (cas OrcaRouter) | 40 tours = 1 exécution, sans cache, en supposant que tout réussit | 0.3045 par tour, 12.18 par exécution | 0.435 par tour, 17.40 par exécution | 5.22 par exécution |
Avec cet exemple, pour mille exécutions par mois, l’écart représente environ 5,220 dollars ; pour dix exécutions, seulement environ 52 dollars. Attention : si, après la fin de l’offre, le prix revient à la tranche 1.43/4.28 indiquée sur la page du modèle, le résultat change encore. Il est donc préférable de conserver trois jeux de prix dans la colonne correspondante — « prix promotionnel », « prix original Pricing » et « prix de la page du modèle » — puis, une fois la facture émise, de les comparer au prix unitaire réel.
Exemple de code pour tester les coûts de Qwen4-Max
L’exemple minimal ci-dessous montre un appel compatible avec OpenAI. On prend ici la route APIYI comme point de départ ; pour passer à un autre service proxy API, il suffit de remplacer base_url et l’ID du modèle par les valeurs publiées par le fournisseur concerné.
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # APIYI, interface compatible OpenAI
)

resp = client.chat.completions.create(
    model="qwen4-max",
    messages=[{"role": "user", "content": "用一句话说明缓存读计费"}]
)
print(resp.choices[0].message.content, resp.usage)
Voir le script complet qui comptabilise le « coût par tâche réussie »
import time
import openai

# Unité : dollars US / million de tokens ; les trois grilles tarifaires sont notées séparément,
# puis remplacées par le prix réellement payé une fois la facture émise
PRICES = {
    "together_promo": {"in": 1.05, "out": 3.15, "cache_read": 0.0525},
    "list_price":     {"in": 1.50, "out": 4.50, "cache_read": 0.075},
    "together_model_page": {"in": 1.43, "out": 4.28, "cache_read": 0.0713},
}

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # à remplacer par la route à tester
)

def run_task(prompt, validate, model="qwen4-max", max_retries=2):
    """Renvoie l'enregistrement d'usage de chaque appel, ainsi que le fait que la tâche ait finalement passé l'acceptation"""
    records = []
    for attempt in range(max_retries + 1):
        t0 = time.time()
        try:
            r = client.chat.completions.create(
                model=model,
                messages=[{"role": "user", "content": prompt}],
            )
            u = r.usage
            details = getattr(u, "prompt_tokens_details", None)
            cached = getattr(details, "cached_tokens", 0) or 0
            ok = validate(r.choices[0].message.content)
            records.append({"in": u.prompt_tokens - cached, "cache": cached,
                            "out": u.completion_tokens, "ok": ok,
                            "latency": time.time() - t0})
            if ok:
                return records, True
        except Exception as e:
            records.append({"in": 0, "cache": 0, "out": 0, "ok": False,
                            "latency": time.time() - t0, "error": str(e)})
    return records, False

def cost_per_success(all_records, passed, price):
    total = sum(r["in"] * price["in"] + r["out"] * price["out"]
                + r["cache"] * price["cache_read"] for r in all_records) / 1e6
    return total / passed if passed else float("inf")
Le champ de cache utilisé dans le script dépend du fait que l’interface renvoie ou non cached_tokens. Les champs retournés peuvent varier d’une route à l’autre, et c’est de toute façon la facture de la plateforme qui fait foi au final. Les frais d’écriture en cache (Alibaba Cloud distingue officiellement deux paliers, 5 minutes et 1 heure) n’ont pas de tarif public côté Together : lors des tests, il faut les enregistrer séparément.
🚀 Conseil de test : le temps presse avant la date butoir. Vous pouvez d’abord faire tourner le jeu d’exemples et le script de comptabilisation sur APIYI apiyi.com avec le crédit gratuit réservé aux nouveaux utilisateurs, vérifier que les règles d’acceptation et le format des journaux sont corrects, puis pointer le même script vers la route Together pour la comparaison. Ainsi, tout le temps de test disponible dans la fenêtre promotionnelle sert vraiment à comparer les prix.
Checklist pour utiliser APIYI qwen4-max comme option de repli indépendante
Chez APIYI, le prix catalogue est identique à celui d’Alibaba Cloud à Singapour. Son intérêt n’est pas d’être une option moins chère, mais d’offrir un second canal stable facturé au prix normal, au cas où la promotion se terminerait ou où la validation du routage Together échouerait. Pour une intégration via APIYI apiyi.com, je vous conseille de vérifier quatre points :
- Vérification du catalogue : regardez si l’endpoint et le groupe de
qwen4-maxdans le registre couvrent bien le protocole que vous comptez utiliser, par exempleresponsesoumessages. - Vérification du compte : assurez-vous que le groupe auquel appartient votre jeton actuel dispose des droits d’appel. La présence d’un modèle au catalogue ne garantit pas que votre compte puisse l’invoquer.
- Vérification de la facturation : lancez une passe sur votre jeu d’exemples et comparez poste par poste le prix unitaire réellement payé avec le prix catalogue.
- Vérification des capacités : le point de troncature du contexte long, la sortie en mode réflexion et la prise en charge multimodale doivent tous être mesurés sur la route réellement utilisée, sans reprendre tel quel les seuils officiels d’Alibaba Cloud.
Si votre charge de travail peut être validée avant le 2026-11-23 et que le coût par tâche réussie que vous calculez est bel et bien plus faible, vous pouvez commencer par tourner un moment au prix promotionnel de Together, tout en conservant une route de repli au prix normal et un second budget. Si vous n’avez pas le temps de valider, ou si vous dépendez d’entrées vidéo ou de sorties très longues, le plus prudent est de faire tourner le processus au prix catalogue sur une interface compatible comme APIYI apiyi.com, puis de refaire la comparaison de prix quand Together annoncera une prolongation ou complétera les spécifications.
Références
-
Together AI Pricing : prix promotionnel et période de validité de Qwen4 Max
- Lien :
together.ai/pricing - Description : la page n’indique pas de date de publication ; date de consultation pour cet article : 2026-11-20
- Lien :
-
Page du modèle Qwen4 Max sur Together AI : ID d’appel, exemple Serverless et autre palier tarifaire
- Lien :
together.ai/models/qwen4-max - Description : page datée du 2026-11-15
- Lien :
-
Alibaba Cloud Model Studio Model Prices : tarifs du déploiement international à Singapour et prix de l’écriture en cache
- Lien :
alibabacloud.com/help/en/model-studio/model-pricing - Description : grille tarifaire mise à jour en continu
- Lien :
-
Page du modèle Qwen4-Max sur Alibaba Cloud : contexte, limites d’entrée/sortie et modalités
- Lien :
alibabacloud.com/help/en/model-studio/qwen4-max - Description : mise à jour le 2026-11-18
- Lien :
-
Article original d’OrcaRouter : source de l’information sur la réduction de 30 % et exemple de calcul pour un scénario d’agent
- Lien :
orcarouter.ai/blog/qwen-4-max-30-percent-price-cut-third-party - Description : publié le 2026-11-19 ; l’explication du mécanisme de tarification qu’il contient relève d’une supposition de l’auteur
- Lien :
-
Annonce de lancement et registre des modèles d’APIYI : point de terminaison
qwen4-max, groupes et prix catalogue- Lien :
docs.apiyi.com/live/2026-11/qwen4-max-launch - Description : annonce publiée le 2026-11-17, registre généré le 2026-11-20
- Lien :
Auteur : équipe technique APIYI
Échanges techniques : n’hésitez pas à nous contacter depuis la page d’accueil du site officiel APIYI, apiyi.com ; vous trouverez davantage de ressources d’intégration dans le centre de documentation.