

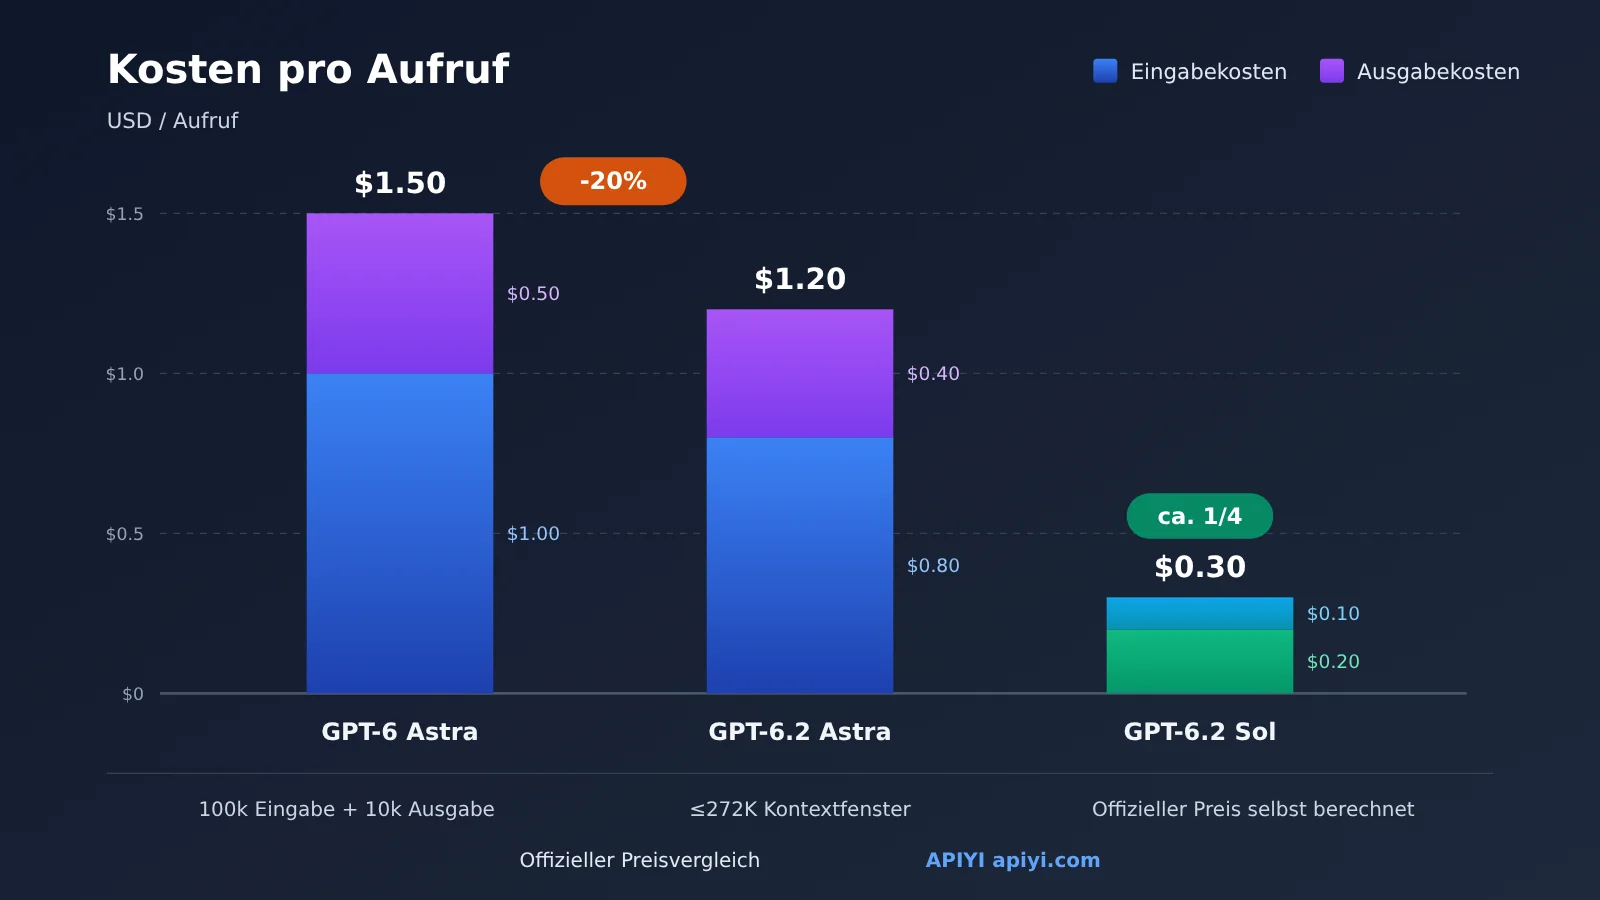
Nehmen wir eine Standardanfrage mit 100.000 nicht gecachten Eingabe-Token und 10.000 Ausgabe-Token, wobei die Eingabe 272K nicht überschreitet: Nach den offiziellen Standardpreisen kostet GPT-6 Astra etwa $1.50, GPT-6.2 Astra etwa $1.20. Pro Anfrage sind das $0.30 weniger – genau 20 %. Bei derselben Token-Menge kostet GPT-6.2 Sol nur rund $0.30. Wichtig: Hier sinkt der Stückpreis um 20 %. Cache, Langkontext-Stufen, die Menge der Reasoning-Ausgabe, Tool-Aufrufe und weitere Faktoren beeinflussen die Endkosten. Die tatsächliche Rechnung fällt daher nicht zwangsläufig im gleichen Verhältnis um 20 % niedriger aus.
Was Sie aus diesem Artikel mitnehmen können
- Welche offiziellen Standardpreise OpenAI am 17. November 2026 für GPT-6.2 Astra und Sol veröffentlicht hat.
- Wie sich die Kosten einer API-Anfrage berechnen – mit jeder Multiplikation, jeder Einheitenumrechnung und den zugrunde liegenden Annahmen.
- Wie stark Cache-Lesevorgänge, ein Langkontext über 272K und Änderungen bei den Ausgabe-Token die tatsächlichen Kosten von der „20 % günstiger“-Erwartung abweichen lassen.
- Wie Entwickler und Budgetverantwortliche ihre eigenen Aufrufkosten neu schätzen sollten.
Artikelaufbau: Dieser Artikel führt zunächst mit einer Konzepttabelle und einem Schnellüberblick über die Einflussfaktoren in den Hintergrund ein; Teil 1 „Objektive Fakten“ fasst offizielle Veröffentlichungsinformationen, die Preistabelle und offizielle Benchmarks zusammen und gibt drei selbst nachgerechnete Beispiele auf Basis der offiziellen Preise; Teil 2 „Analyse und Einschätzung“ erklärt die Lücke zwischen sinkendem Stückpreis und sinkender Rechnung, gibt Empfehlungen für verschiedene Rollen und enthält einen direkt ausführbaren Code zur Kostenschätzung.
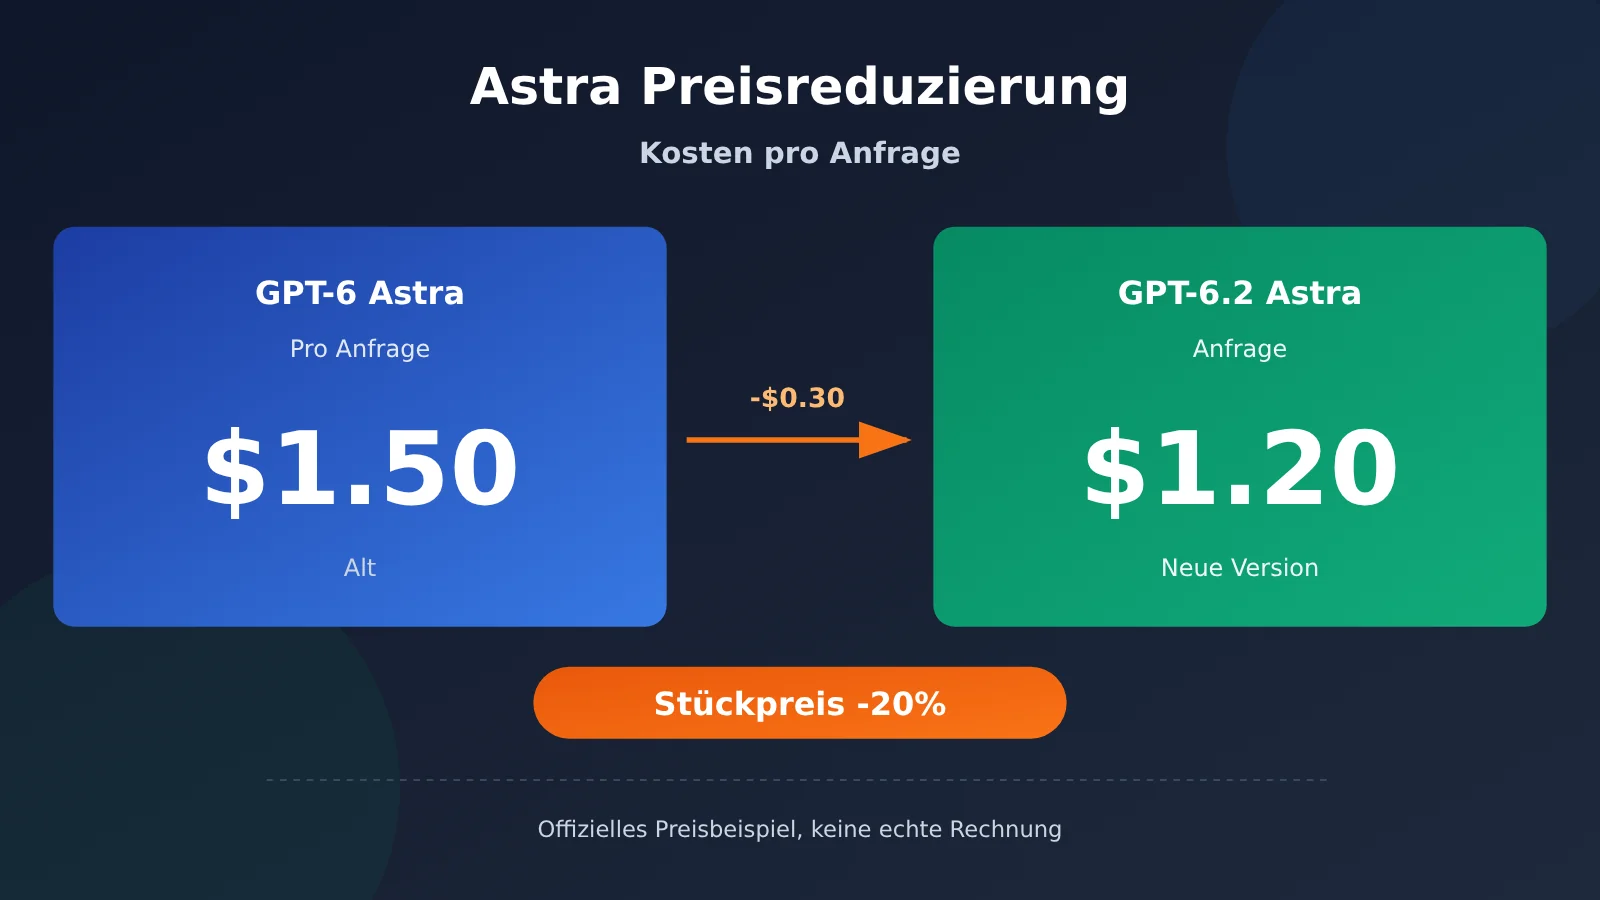
Wichtige Begriffe zur Preissenkung von GPT-6.2 Astra
| Begriff | Kurze Erklärung |
|---|---|
| Token | Die grundlegende Einheit, in der das Modell Text verarbeitet und abrechnet; die API bepreist pro „Million Token“ |
| Nicht gecachte Eingabe | In diesem Artikel der normale Eingabeteil, der weder als Cache-Lesen noch als Cache-Schreiben abgerechnet wird |
| Cache-Lesen | Der Teil einer Anfrage, der den Prompt-Cache trifft; der Stückpreis liegt deutlich unter dem für nicht gecachte Eingaben |
| Cache-Schreiben | Für geschriebene Token gilt ein eigener Gesamttarif; dieselben Token werden nicht zusätzlich mit der normalen Eingabegebühr belastet |
| Langkontext-Staffel | Überschreitet die Eingabe 272K Token, verdoppeln sich die Eingabe- und Cache-Tarife für die gesamte Anfrage, der Ausgabetarif steigt auf das 1,5-Fache |
| Reasoning-Stufe | Die Reasoning-Intensität, die das Modell vor der Antwort aufwendet; höhere Stufen verbrauchen in der Regel mehr Token |
| GDPval v2 / ALE / FrontierCode 2.0 | Die drei Benchmarks, die OpenAI in der Ankündigung zitiert; Evaluationsgegenstand und Messmethodik unterscheiden sich, die Ergebnisse lassen sich nicht ineinander umrechnen |
Auswirkungen der 20-prozentigen Preissenkung von GPT-6.2 Astra im Überblick
| Zielgruppe | Wichtigste Auswirkung |
|---|---|
| API-Entwickler | Bei Anfragen üblicher Länge sinken die Eingabe- und Ausgabestarife von Astra um 20 %, die Kosten fallen bei gleichem Aufrufvolumen entsprechend; Anfragen mit sehr langem Kontext müssen separat berechnet werden |
| Budgetverantwortliche | Das Stückpreis-Budget für Astra lässt sich um 20 % neu ansetzen; die tatsächliche Senkung hängt aber von Cache-Trefferquote, Kontextlänge und Ausgabemenge ab und sollte mit den Rechnungsdaten abgeglichen werden |
| Teams in der Auswahlphase | Der Standardtarif von Sol liegt bei etwa einem Viertel von Astra – für kostenempfindliche Aufgaben gibt es damit eine zusätzliche Option, die eine Bewertung verdient |
| Normale ChatGPT-Nutzer | Diese Runde richtet sich vor allem an ChatGPT Work, Codex und die API mit schrittweiser Freigabe; das normale Chat-Angebot ist nicht Teil dieser Runde |
1. Die objektiven Fakten zur 20-prozentigen Preissenkung von GPT-6.2 Astra
Die folgenden Informationen stammen von der offiziellen OpenAI-Release-Seite, der Modelldokumentation und der Preisseite; Stand der Überprüfung: 18. November 2026. Alle Benchmark-Daten sind offizielle Berichte und keine eigenen Messergebnisse unseres Teams.
1.1 Grundlegende Angaben zur Veröffentlichung von GPT-6.2 Astra und Sol
OpenAI hat am 17. November 2026 GPT-6.2 Astra und GPT-6.2 Sol veröffentlicht. Beide Modelle nehmen Text und Bilder als Eingabe und geben Text aus – Videos können sie nicht nativ erzeugen.
Zum Rollout-Umfang: Laut offizieller Angabe werden die neuen Modelle schrittweise für Nutzer von ChatGPT Work, Codex und der API freigeschaltet; das normale Chat-Angebot ist in dieser Runde nicht dabei. Der genaue Freischaltungszeitplan richtet sich nach der OpenAI-Hilfedokumentation.
1.2 Offizielle Standard-API-Preise für GPT-6.2 Astra
Die folgende Tabelle zeigt die Preise der offiziellen Standard-Stufe von OpenAI bei einer Eingabe von höchstens 272K Token. Die Einheit ist US-Dollar pro Million Token – es handelt sich nicht um das Angebot von APIYI. Die Ausgabemenge wird anhand der in usage abgerechneten Gesamtausgabetoken berechnet, einschließlich Reasoning-Token, und entspricht nicht der Länge des sichtbaren Textes.
| Modell | Nicht-Cache-Eingabe | Cache-Lesen | Ausgabe | Datenquelle |
|---|---|---|---|---|
| GPT-6 Astra (Vorgängergeneration) | $10 | $1.00 | $50 | OpenAI-Modellseite |
| GPT-6.2 Astra | $8 | $0.4 | $40 | OpenAI-Modellseite / Preisseite |
| GPT-6.2 Sol | $2 | $0.1 | $10 | OpenAI-Modellseite / Preisseite |
Bei den offiziellen Preisen sind außerdem zwei Abrechnungsregeln zu beachten:
- Cache-Schreibvorgänge werden zu einem eigenen Gesamttarif abgerechnet: Für Astra unter Standard mit kurzem Kontext beträgt die Schreibgebühr $10 pro Million Token für 30 Minuten und $20 pro Million Token für 12 Stunden – sie wird nicht zusätzlich auf die reguläre Eingabe von $8 aufgeschlagen. Dasselbe Eingabetoken muss entweder der regulären Eingabe, dem Cache-Lesen oder einem Cache-Schreibvorgang mit der entsprechenden Lebensdauer zugeordnet werden; eine doppelte Abrechnung ist nicht zulässig.
- Bei einer Eingabe von mehr als 272K Token werden der Eingabetarif und der Cache-Tarif der gesamten Anfrage mit dem 2-fachen berechnet, der Ausgabetarif mit dem 1,5-fachen.
Im Vergleich zur Vorgängergeneration sinkt bei Astra die Nicht-Cache-Eingabe von $10 auf $8 und die Ausgabe von $50 auf $40 – beide Positionen fallen um 20 %. Das ist die genaue Bedeutung von „20 % günstiger“: Der Standard-Stückpreis fällt um 20 %.
1.3 Offizielle Benchmark-Daten von GPT-6.2 Astra (nicht von unserem Team gemessen)
OpenAI hat in der Ankündigung mehrere Benchmark-Ergebnisse veröffentlicht. Die Benchmarks verwenden unterschiedliche Methoden und Maßstäbe; sie dürfen nicht vermischt interpretiert werden:
- GDPval v2: GPT-6.2 Astra erzielt 6.2 Prozentpunkte mehr als GPT-6 Astra und erzeugt 22 % weniger Ausgabe-Tokens; GPT-6.2 Sol erzielt 5.3 Prozentpunkte mehr als GPT-6.1 Sol.
- ALE: GPT-6.2 Astra verbessert sich um 5.2 Punkte. Dies ist ein anderer Benchmark und darf nicht mit den Prozentpunkten aus GDPval addiert oder verglichen werden.
- FrontierCode 2.0: Auf der max-Reasoning-Stufe erzielt Sol 0.5 Punkte weniger als Astra, bei Aufgabenkosten von etwa 1/5 der Kosten von Astra. Das gilt nur für diesen Test und diese Stufe und darf nicht als allgemeingültige Kostenaussage verwendet werden.
1.4 Beispiel zur Selbstberechnung der Kosten einer einzelnen GPT-6.2 Astra-Anfrage
Die folgenden drei Rechenbeispiele sind unsere Arithmetik auf Basis der offiziellen Standardpreise, keine API-Messungen und auch keine tatsächliche Abrechnung eines Kontos. Die Berechnungsformel lautet:
Kosten = Tokenanzahl ÷ 1,000,000 × Preis pro Million Token
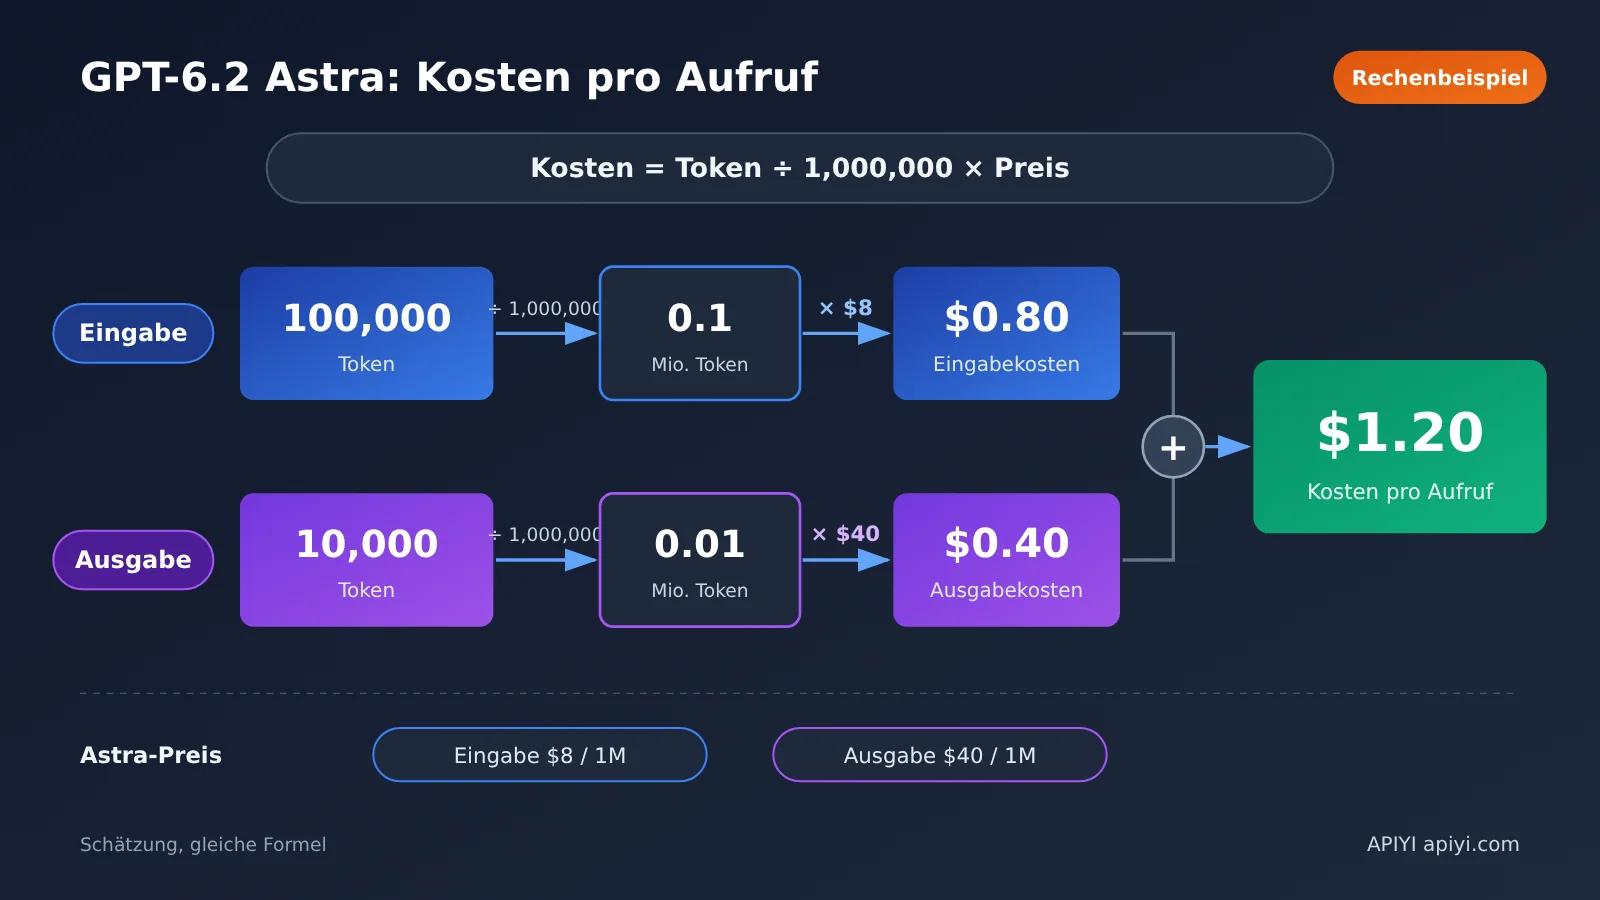
Rechenbeispiel 1: Standardanfrage – Vergleich zwischen altem und neuem Astra sowie Sol
Annahmen: Nicht gecachte Eingabe 100,000 Token, Ausgabe 10,000 Token, Eingabe unter 272K, keine Cache-Lese- oder Cache-Schreibvorgänge, keine Tool-Aufrufe, Abrechnung zum Standardpreis.
| Position | GPT-6 Astra | GPT-6.2 Astra | GPT-6.2 Sol |
|---|---|---|---|
| Eingabekosten | 0.1 × $10 = $1.00 | 0.1 × $8 = $0.80 | 0.1 × $2 = $0.20 |
| Ausgabekosten | 0.01 × $50 = $0.50 | 0.01 × $40 = $0.40 | 0.01 × $10 = $0.10 |
| Gesamt pro Anfrage | $1.50 | $1.20 | $0.30 |
| Relativ zu GPT-6 Astra | Basis | $0.30 weniger (-20 %) | $1.20 weniger (-80 %) |
Die „0.1“ in der Tabelle steht für 100,000 ÷ 1,000,000, „0.01“ für 10,000 ÷ 1,000,000. Wenn monatlich 10,000 identische Anfragen abgesetzt werden, ergäben sich unter diesen Annahmen für GPT-6 Astra etwa $15,000 und für GPT-6.2 Astra etwa $12,000. Das ist lediglich eine lineare Hochrechnung und keine Zusage zu tatsächlichen Kosten.
Rechenbeispiel 2: GPT-6.2 Astra-Anfrage mit Cache-Treffer
Annahmen: Gesamteingabe 100,000 Token, davon 80,000 Token durch Cache-Lesen abgedeckt, 20,000 Token als normaler, nicht gecachter Input, Ausgabe 10,000 Token; der Cache-Schreibanteil dieser Anfrage wird mit null angesetzt, die Kosten für den Aufbau des historischen Caches sind in diesem Beispiel nicht enthalten.
- Nicht gecachte Eingabe: 0.02 × $8 = $0.16
- Cache-Lesen: 0.08 × $0.4 = $0.032
- Ausgabe: 0.01 × $40 = $0.40
- Gesamt: ca. $0.592
Der Cache-Lesepreis des Vorgängermodells GPT-6 Astra liegt bei $1.00 pro Million Token, der der neuen Version bei $0.40 – ein Rückgang um 60 %. Bei derselben Tokenanzahl lägen die Kosten der Vorgängerversion bei $0.20 + $0.08 + $0.50 = $0.78; die neue Version käme auf $0.592, also $0.188 weniger, ein Rückgang um etwa 24.1 %. In beiden Fällen sind Cache-Schreibvorgänge, Tool- und sonstige Kosten nicht berücksichtigt; als vollständige Abrechnung sind die Zahlen nicht zu verstehen.
Rechenbeispiel 3: GPT-6.2 Astra Langkontext-Anfrage über 272K
Annahmen: normaler Input 300,000 Token (über 272K), Ausgabe 10,000 Token, Cache-Lese- und Cache-Schreibvolumen jeweils null.
- Eingabe: 0.3 × ($8 × 2) = $4.80
- Ausgabe: 0.01 × ($40 × 1.5) = $0.60
- Gesamt: $5.40
Beachten Sie, dass die Staffelung pro gesamter Anfrage berechnet wird. Sobald die Eingabe 272K überschreitet, wird die gesamte Eingabe dieser Anfrage mit dem doppelten Satz abgerechnet – nicht nur der überstehende Anteil.
Die Cache-Lebensdauer wird über prompt_cache_options.ttl der Responses API konfiguriert: Standard ist "30m", wählbar ist auch "12h"; für einen einzelnen expliziten Breakpoint lässt sich das mit prompt_cache_breakpoint.ttl überschreiben. Der Wert steht für die Mindest-Lebensdauer des Caches, nicht für die Frist zur Datenlöschung, und sollte nicht mit dem Parameter prompt_cache_retention älterer Modelle vermischt werden.
Übersteigt die Eingabe 272K, so kostet bei Astra in der Standard-Stufe die normale Eingabe, das Cache-Lesen, das Schreiben mit 30 Minuten, das Schreiben mit 12 Stunden und die Ausgabe jeweils $16, $0.80, $20, $40 und $60 pro Million Token; der Multiplikator gilt für die gesamte Anfrage, nicht nur für den überstehenden Teil.
1.5 Offizielle Quellen zu GPT-6.2 Astra
-
OpenAI-Ankündigung: openai.com/index/introducing-gpt-6-2-astra-sol/
- Modell dokumentation GPT-6 Astra: offizielle Preise des alten Modells
- Modell dokumentation GPT-6.2 Astra: offizielle Preise und Tarifbedingungen des neuen Modells
- Modell dokumentation GPT-6.2 Sol: developers.openai.com/api/docs/models/gpt-6.2-sol
- OpenAI-API-Preisseite: developers.openai.com/api/docs/pricing
- Hilfedokumentation zu ChatGPT Work und Codex: help.openai.com/en/articles/20001275-chatgpt-work-and-codex
2. Analyse und Einschätzung der 20-prozentigen Preissenkung von GPT-6.2 Astra
Das Folgende ist die Interpretation der Redaktion auf Basis der oben genannten Fakten. Es handelt sich um eine Analyse und Einschätzung, nicht um offizielle Schlussfolgerungen.
2.1 Warum eine 20-prozentige Preissenkung nicht unbedingt zu 20 % niedrigeren Rechnungen führt
Rechenbeispiel 1 ergibt genau 20 %, weil es nur zwei Posten enthält: nicht gecachte Eingabe und Standardausgabe. Beide sind um exakt 20 % gesunken. Rechnungen im echten Geschäft setzen sich jedoch meist aus mehreren Kostenarten zusammen. Jede Änderung eines Anteils lässt den Gesamtrückgang von 20 % abweichen.
| Kostenfaktor | Mögliche Auswirkung auf die tatsächliche Rechnung | Grundlage der Einschätzung |
|---|---|---|
| Cache-Lese- und -Schreibvorgänge | Der Preis für Cache-Lesevorgänge sinkt um 60 %, nicht um die 20 % der nicht gecachten Eingabe; die Berechnung muss nach der jeweiligen Token-Anzahl erfolgen, ein pauschaler Gesamtrückgang darf nicht vorausgesetzt werden; Cache-Schreibvorgänge nutzen eine eigene Gesamtrate und werden nicht zusätzlich auf die normalen Eingabekosten aufgeschlagen | Offizielle Preisliste |
| Long-Context-Staffelung | Bei Überschreitung von 272K steigt der Tarif für die gesamte Anfrage; bei langen Dokumenten können die Kosten pro Anfrage deutlich über Rechenbeispiel 1 liegen | Offizielle Abrechnungsregeln |
| Anzahl der Ausgabe-/Reasoning-Tokens | In GDPval v2 meldet der Anbieter 22 % weniger Ausgabe-Tokens. Wenn Ihre Aufgaben ähnliche Veränderungen aufweisen, kann die Ersparnis über 20 % liegen; bei einer höheren Reasoning-Stufe kann es aber auch teurer werden | Offizielle Evaluation (spezifische Aufgabe) |
| Tool-Aufrufe und Geschwindigkeitsstufen | Bei GPT-6.2 Astra kostet Fast das Doppelte der Standardrate im selben Kontext, Batch 50 %; Tool-Kosten werden je nach verwendetem Tool separat berechnet | Offizielle Modell- und Preisseite |
| Aufrufkanal | Bei Aufrufen über Drittanbieterplattformen wie APIYI apiyi.com gilt die tatsächliche Abrechnung des Anbieters; die offiziellen Preise lassen sich nicht direkt übertragen | Kanalunterschiede |
Ein leicht übersehener Punkt ist „22 % weniger Ausgabe“. Diese Zahl stammt aus der Evaluation GDPval v2. Wenn man sie direkt auf alle Geschäftsfälle überträgt und daraus schließt, „real spart man über 30 %“, behandelt man das Ergebnis einer offiziellen Bewertung in einer bestimmten Aufgabe als allgemeingültige Regel. Der sicherere Weg ist, mit den eigenen echten Anfragen einen kleinen Test durchzuführen, die Token-Anzahl im Feld usage zu erfassen und dann zu entscheiden.
2.2 Auswahlentscheidung zwischen GPT-6.2 Astra und Sol
Betrachtet man die Standard-Preisliste, kostet jede einzelne Position bei Sol etwa ein Viertel von Astra. In Rechenbeispiel 1 liegen die Kosten pro Aufruf bei Sol entsprechend bei nur einem Viertel von Astra. Die Ergebnisse von FrontierCode 2.0 zeigen, dass Sol in der max-Reasoning-Stufe nur einen geringen Abstand zu Astra aufweist – allerdings sagt die offizielle Dokumentation nicht, ob sich diese Schlussfolgerung auf andere Aufgaben übertragen lässt.
Unsere Einschätzung lautet daher: Für kostensensible Szenarien mit mittlerer Aufgabenkomplexität lohnt es sich, Sol zuerst zu evaluieren; für Szenarien mit hohen Qualitätsanforderungen oder komplexen Aufgaben ist die Einstiegshürde bei Astra durch die Preissenkung ebenfalls niedriger geworden. Welches Modell am Ende die Wahl ist, sollte man anhand eines A/B-Vergleichs mit dem eigenen Aufgabenpaket entscheiden.
💡 Empfehlung zur Auswahl: Wenn Sie in derselben Codebasis den Token-Verbrauch und die Ausgabequalität mehrerer Modelle vergleichen möchten, können Sie über eine OpenAI-kompatible Aggregationsschnittstelle wie APIYI apiyi.com zwischen den Modellen wechseln. Ob die GPT-6.2-Serie auf der Plattform bereits verfügbar ist und wie viel sie kostet, entnehmen Sie bitte der Modellliste und der Abrechnungsseite der Plattform.
2.3 Code zur Kostenschätzung für GPT-6.2 Astra
Das folgende Skript führt nur lokale Berechnungen aus und ruft keine API auf. Es teilt die Eingabe in vier sich nicht überschneidende Kategorien auf: normale Eingabe, Cache-Lesevorgänge, 30-Minuten-Schreibvorgänge und 12-Stunden-Schreibvorgänge; die Gesamteingabemenge entscheidet über die 272K-Stufe. Der Schreibpreis ist ein Gesamtpreis; auf die Schreib-Token wird nicht zusätzlich der normale Eingabepreis aufgeschlagen.
# OpenAI-Standardtarife, USD pro Million Token; ohne Tool-, Steuer- und sonstige Tarifstufenkosten
PRICES = {
    "gpt-6-astra":   {"input": 10.0, "cached": 1.0, "output": 50.0},
    "gpt-6.2-astra": {"input": 8.0, "cached": 0.4, "output": 40.0},
    "gpt-6.2-sol":   {"input": 2.0, "cached": 0.1, "output": 10.0},
}

def estimate_cost(model, ordinary_input, output_tokens, cached_read=0,
                  write_30m=0, write_12h=0):
    counts = (ordinary_input, output_tokens, cached_read, write_30m, write_12h)
    if any(n < 0 for n in counts):
        raise ValueError("token 数不得为负")
    p = PRICES[model]
    total_input = ordinary_input + cached_read + write_30m + write_12h
    im, om = (2.0, 1.5) if total_input > 272_000 else (1.0, 1.0)
    input_cost = (ordinary_input * p["input"] + cached_read * p["cached"]
                  + write_30m * p["input"] * 1.25
                  + write_12h * p["input"] * 2.5) * im
    return round((input_cost + output_tokens * p["output"] * om) / 1e6, 6)

print(estimate_cost("gpt-6-astra", 100_000, 10_000))  # 1.5
print(estimate_cost("gpt-6.2-astra", 100_000, 10_000))  # 1.2
print(estimate_cost("gpt-6.2-sol", 100_000, 10_000))  # 0.3
print(estimate_cost("gpt-6.2-astra", 20_000, 10_000, cached_read=80_000))  # 0.592
# Dieselben 100.000 Eingabe-Token werden komplett als 30-Minuten-Schreibvorgang abgerechnet: nicht 1.2 plus 1.0
print(estimate_cost("gpt-6.2-astra", 0, 10_000, write_30m=100_000))  # 1.4
Bei der Usage-Angabe von Responses sollte man zuerst die Cache-Lese- und Schreibmenge ermitteln und dann beide vom Gesamteingang abziehen, um die normale Eingabe zu erhalten. Bei gemischten Lebensdauern von 30 Minuten und 12 Stunden muss die Schreibmenge außerdem gemäß der tatsächlichen Abrechnungsdetails aufgeteilt werden; man darf nicht alle Schreibvorgänge mit einem einzigen Tarif abrechnen. Wenn dem Kanal Schreibdetails fehlen oder die Abrechnungsgrundlage abweicht, sollte man die Rechnung des Kanals zur Kontrolle heranziehen und nicht standardmäßig annehmen, die Schreibmenge sei null. Wenn die abgerechnete Ausgabe Reasoning-Token enthält, darf man die Reasoning-Menge nicht noch einmal addieren. In diesem Artikel wird die API nicht tatsächlich aufgerufen; ob Drittanbieterplattformen diese Konfigurationen unterstützen und wie sie diese abrechnen, richtet sich nach deren Dokumentation.
2.4 Empfehlungen nach der Preissenkung von GPT-6.2 Astra
Für Entwickler: Erfassen Sie zunächst die Verteilung der Eingabelängen Ihrer bestehenden Anfragen und prüfen Sie, wie viele Anfragen nahe an 272K liegen oder darüber hinausgehen. Ist der Anteil langkontextiger Anfragen hoch, können Sie die Eingabe durch Retrieval-Slicing, Zusammenfassungskompression und ähnliche Verfahren innerhalb der Preisstufe halten – die dadurch eingesparten Kosten können höher sein als die 20 % Preissenkung. Platzieren Sie außerdem feste System-Eingabeaufforderungen am Anfang der Anfrage, um die Cache-Trefferquote zu erhöhen.
Für Budgetverantwortliche: Betrachten Sie „20 % niedrigerer Standardpreis für Astra“ als Referenz für die Budgetbasis bei gleichem nicht gecachtem Eingabe- und Ausgabevolumen – nicht als Obergrenze der tatsächlichen Reduktion oder als garantierte Einsparung. Vergleichen Sie am besten die echten Abrechnungen aus je einem Zeitraum vor und nach der Migration und listen Sie die Veränderungen bei Cache, Langkontext und Ausgabe-Tokens getrennt auf. Teams, die über Plattformen wie APIYI apiyi.com aufrufen, sollten sich zusätzlich an der Abrechnungslogik der Plattformrechnung orientieren.
Weiterhin zu beachtende Folgeentwicklungen: offizielle Preisupdates, der Fortschritt bei der Kanalöffnung sowie die Frage, ob unabhängige Dritttests die offiziellen Daten reproduzieren können. Die offiziellen Tarife für Cache-Schreibvorgänge und Geschwindigkeitsstufen sind bereits ausgewiesen; bei der Kalkulation sollte man die gewählte Stufe prüfen und sie nicht als noch unveröffentlicht behandeln. Beim neuen Astra kostet ein Cache-Schreibvorgang im Standard-Kurzkontext mit 30-minütiger Aufbewahrung $10 pro Million Token, bei 12 Stunden $20 pro Million Token; alle drei Hauptbeispielrechnungen in diesem Artikel gehen davon aus, dass das Cache-Schreibvolumen in diesem Fall null ist – was nicht bedeutet, dass Standard-API-Anfragen zwangsläufig keine Schreibvorgänge enthalten.
Wenn Sie den Abrechnungsprüfungsprozess erst einmal durchspielen möchten, können Sie bei APIYI apiyi.com mit demselben Code die usage-Daten verschiedener Modelle vergleichen. Sobald die GPT-6.2-Serie in dem Kanal, den Sie nutzen, verfügbar ist, können Sie die tatsächlichen Token-Zahlen direkt in die oben genannte Schätzfunktion einsetzen.
Eine Preissenkung um 20 % ist ein klares Signal, doch die Zahl auf der Rechnung hängt davon ab, wie lang die Eingabe bei jeder Anfrage ist, wie oft der Cache greift und wie viel ausgegeben wird. Jede einzelne Multiplikation sauber durchzurechnen ist nützlicher, als sich eine Prozentzahl zu merken.
„Beware of little expenses; a small leak will sink a great ship.“
— Benjamin Franklin, Poor Richard’s Almanack
(Achte auf kleine Ausgaben; ein kleines Leck versenkt ein großes Schiff.)









