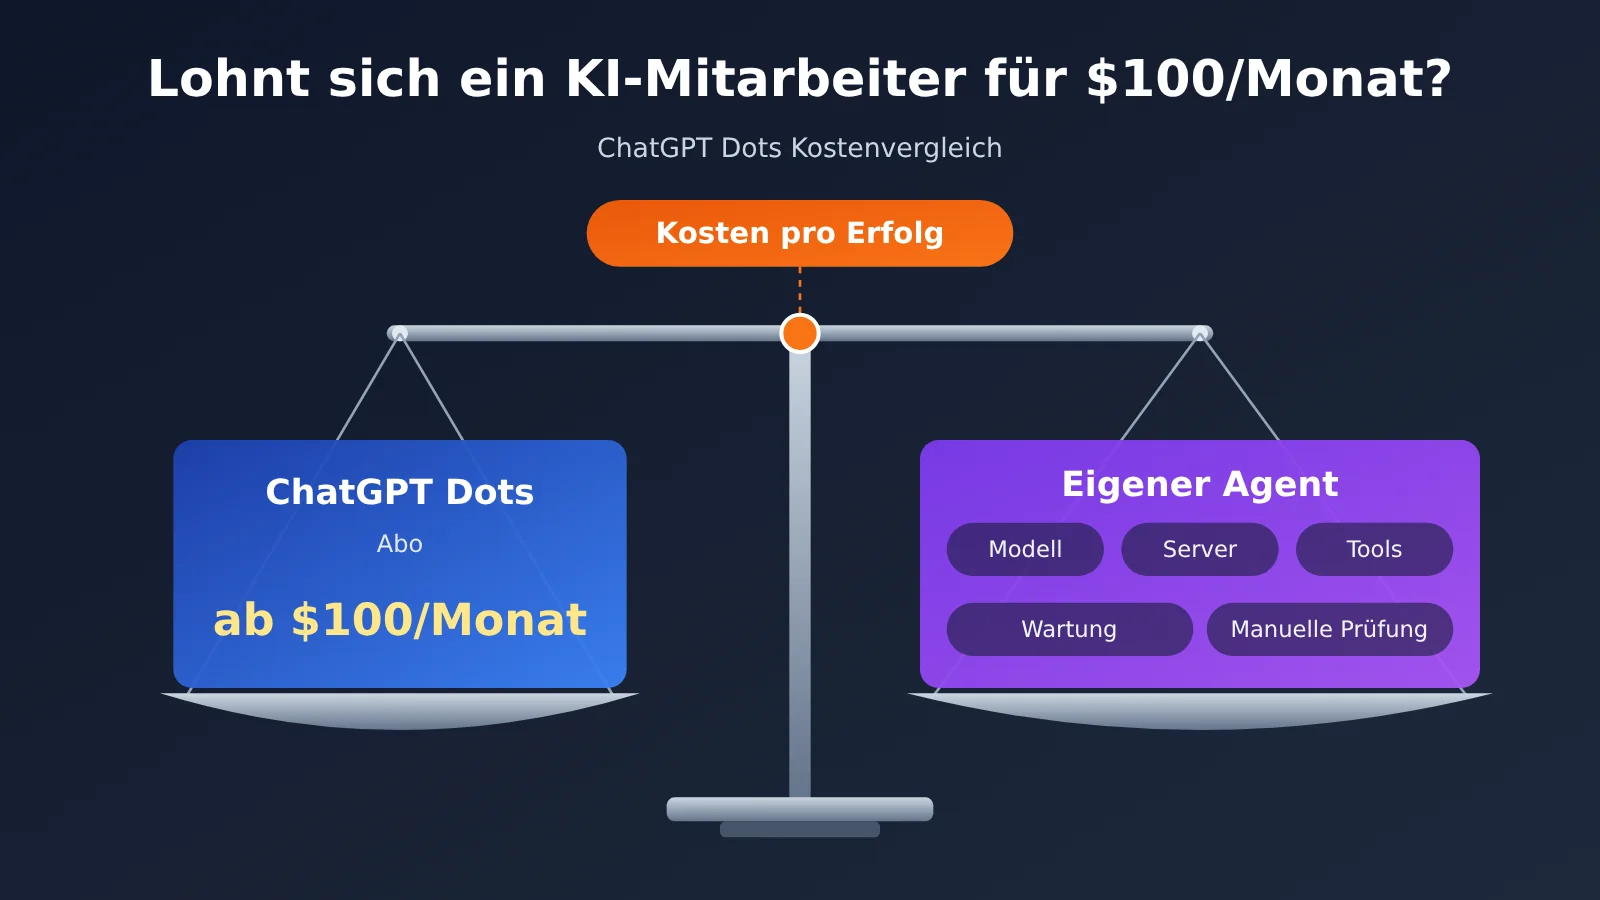
Hinweis des Autors: Vergleichen Sie das ChatGPT-Dots-Abonnement mit einem selbst betriebenen Agenten anhand der Kosten pro erfolgreich erledigter Aufgabe bei gleichem Lieferstandard – über Modelle, Infrastruktur, Wartung und manuelle Prüfung hinweg.
Kernaussage: Ob es sich lohnt, „monatlich 100 US-Dollar für einen KI-Mitarbeiter auszugeben“, hängt davon ab, ob die Gesamtkosten für die Erledigung einer standardkonformen Aufgabe unter demselben Lieferstandard liegen; Monatsgebühr und Token-Einzelpreis sind nur ein Teil davon. Nach offiziellen Angaben vom 16. November 2026 liegt die Einstiegshürde für Privatnutzer bei ChatGPT Dots beim Pro 100 (100 US-Dollar/Monat). Das Abonnement bündelt einen Cloud-Computer, langfristigen Kontext, Aufgabenkoordination und App-Anbindungen. In einem hypothetischen Szenario liegen die Modellkosten für 300 Aufgaben pro Monat bei einem selbst betriebenen Agenten bei etwa 33 bis 66 US-Dollar. Dabei sind Server, Tools, Entwicklungs- und Wartungsaufwand, fehlgeschlagene Versuche mit Wiederholungen sowie manuelle Prüfung noch nicht eingerechnet. Welcher Weg unterm Strich günstiger ist, lässt sich erst nach einem Praxistest mit derselben Aufgabensammlung beantworten.
Dieser Artikel zerlegt zunächst die Preislogik und den Funktionsumfang des Dots-Abonnements, teilt anschließend die Kosten eines selbst betriebenen Agenten in fünf Kategorien ein – Modell, Infrastruktur, Tools, Entwicklung und Wartung – und demonstriert anhand der Claude-Preise von APIYI die Berechnungslogik der Token-Kosten pro Aufgabe. Danach vergleicht er Dots, Einzelmodell-Agenten und Multi-Modell-Agenten anhand von sechs Dimensionen und liefert eine Methode für kontrollierte Vergleichstests mit den Kosten pro erfolgreich erledigter Aufgabe als Kern. Zum Schluss gibt er Empfehlungen für drei Bedarfsprofile – Privatnutzer, erfahrene Entwickler und Unternehmen – und stellt Kostenmanagement-Ansätze für die gemischte Nutzung von Abonnement und API vor.
To Know: 8 Begriffe für das Verständnis der Kosten von KI-Mitarbeitern
| Begriff | Erklärung |
|---|---|
| Pro-Abo | Monatlich bezahltes ChatGPT-Paket mit entsprechenden Vorteilen und Nutzungskontingenten; Pro 100, Pro 200 und Pro 500 können alle Dots nutzen |
| Dot | Ein dauerhaft präsenter persönlicher Agent in ChatGPT Dots, der über einen eigenen Cloud-Computer und Browser verfügt und delegierte Aufgaben kontinuierlich vorantreiben kann |
| Token | Die Einheit, mit der das Modell Eingabe- und Ausgabeinhalte misst; die API rechnet pro Million Token ab |
| Cache-Lesen | Wiederkehrende Präfixinhalte in einer Anfrage (z. B. System-Eingabeaufforderungen, Tool-Definitionen) verwenden bereits vorhandene Verarbeitungsergebnisse wieder; der Stückpreis liegt deutlich unter dem normaler Eingaben |
| Cache-Schreiben | Das erstmalige Speichern eines wiederverwendbaren Präfixes für spätere Anfragen; die Abrechnungsregeln richten sich nach der Plattformkonsole |
| Infrastrukturkosten | Die Kosten für Server, Container, Datenbanken, Speicher und Ausführungsumgebung, die für einen selbst gebauten Agent erforderlich sind |
| Aufgaben-Erfolgsquote | Der Anteil der Aufgaben, die nach einem oder mehreren Läufen gemäß einheitlichen Abnahmekriterien qualifiziert geliefert werden |
| Kosten pro erfolgreicher Aufgabe | Die Gesamtausgaben für alle Läufe (einschließlich fehlgeschlagener Wiederholungen), Infrastruktur und manuelle Prüfung, geteilt durch die Anzahl der qualifiziert gelieferten Aufgaben |
1 Was bekommt man für 100 US-Dollar pro Monat bei ChatGPT Dots?
1.1 Preislogik bei ChatGPT Dots: persönliches Pro vs. Enterprise
ChatGPT Dots wurde am 29. September 2026 von OpenAI offiziell vorgestellt. Die Positionierung: ein dauerhaft präsenter persönlicher KI-Agent. Nachdem der Nutzer ein Ziel delegiert hat, kann der Dot die Arbeit in der Cloud weiter vorantreiben, während der Nutzer unterwegs ist oder der Rechner ausgeschaltet bleibt – und übergibt die Sache erst dann wieder an den Nutzer, wenn eine Entscheidung ansteht.
Beim Preis von Dots muss man zwischen dem persönlichen Pro und dem Enterprise-Dot sauber trennen. Die folgende Tabelle basiert auf der offiziellen OpenAI-Hilfedokumentation, Stand der Recherche: 16. November 2026.
| Zielgruppe | Preislogik | Voraussetzungen | Separat abgerechnet |
|---|---|---|---|
| ChatGPT Pro 100 | 100 $/Monat | ab 18 Jahren; nicht im Europäischen Wirtschaftsraum, in Großbritannien und der Schweiz; schrittweise Freigabe | Delegierte Work-/Codex-Aufgaben verbrauchen das Kontingent des jeweiligen Produkts |
| ChatGPT Pro 200 | 200 $/Monat | wie oben | wie oben |
| ChatGPT Pro 500 | 500 $/Monat | wie oben | wie oben |
| Enterprise-Workspace | pauschaler Satz je Aufgabentyp oder nutzungsbasierte Abrechnung; der Betrag richtet sich nach dem Workspace-Vertrag bzw. dem Angebot | 04.11. bis 18.11.2026 kostenlose Admin-Vorschauphase, Dots, die ab dem 18.11. aktiviert werden, werden abgerechnet; jedes Mitglied kann 1 persönlichen Dot anlegen | An Work oder Codex delegierte Aufgaben werden nach den jeweiligen Standards separat berechnet |
In der Dots-Beschreibung für das persönliche Pro ist keine separate monatliche Dot-Abonnengebühr aufgeführt – die Pro-Monatsgebühr ist die Einstiegshürde. OpenAI weist zugleich darauf hin, dass die vom Dot delegierten ChatGPT-Work- oder Codex-Aufgaben nach den Kontingentregeln des jeweiligen Produkts berechnet werden; der Verbrauch hängt von Faktoren wie Modell, Kontext, Reasoning, Tool-Aufrufen und Retrieval ab. 100 $/Monat entsprechen also einem begrenzten Nutzungskontingent, und in den offiziellen Unterlagen ist auch nicht veröffentlicht, wie vielen Aufgaben die Deep-Work-Nutzung eines persönlichen Pro-Dots entspricht.
1.2 Die im Dots-Abo gebündelten Fähigkeiten eines KI-Mitarbeiters
Vergleicht man Dots mit einem direkten API-Aufruf, liegt der Blick schnell nur auf dem „Modell“. Tatsächlich bündelt das Abo aber eine komplette Laufzeitumgebung – all das, was man beim Selbstbau erst einmal implementieren müsste:
- Cloud-Computer und Browser: Jeder Dot hat seinen eigenen Cloud-Computer, kann Websites öffnen, Dokumente aufbereiten und Berichte erstellen; Nutzer können die Arbeit jederzeit einsehen und die Steuerung übernehmen.
- Langzeitkontext: kombiniert ChatGPT Memory, die eigenen Notizen des Dots, Materialien der aktuellen Aufgabe und Daten aus freigegebenen Anwendungen.
- Koordination mehrerer Projekte: komplexe Aufgaben aufteilen, Hintergrund-Recherche-Agenten parallel starten, Ergebnisse zusammenführen und bei Blockaden den Nutzer um Eingreifen bitten.
- Dauerbetrieb: unterstützt geplante Aufgaben und Ereignisüberwachung, etwa die wöchentliche Prüfung von Wettbewerbern oder die Beobachtung neuer Bugs in Slack.
- Proaktive Recherche: Wenn keine neuen Nachrichten eingehen, durchsucht der Dot freigegebene Datenquellen – dieser Vorgang ist rein lesend, anschließende Aktionen müssen den normalen Freigabeprozess durchlaufen.
- App-Anbindung und Kommunikationskanäle: Laut offizieller Beschreibung zum Start umfasst das anbindbare Plugin-Ökosystem mehr als 4.000 Anwendungen; erreichbar ist der Dot über Kanäle wie ChatGPT, Slack und Microsoft Teams.
- Berechtigungen und Sicherheitsmechanismen: Custom Rules legen die Ausführungsgrenzen fest, Auto-review prüft vor Aktionen wie dem Versand von E-Mails, und Vorgänge wie Passwortänderungen oder das Verschieben von Geldern muss der Nutzer zwingend selbst übernehmen.
Praxistests von Drittanbietern liefern einen Anhaltspunkt für die Grenzen dieser Fähigkeiten. Im Test von Axios vom 20. Oktober 2026 erstellte Dots ein 38-seitiges WNBA-Gedenkprogrammheft und generierte in 47 Sekunden ein 12-seitiges Fotogedenkalbum – allerdings tauchten im Programmheft fragwürdige Statistiken auf, und der Shopping-Teil musste vom Nutzer selbst in der Target-App abgeschlossen werden. Das Fazit des Autors: Solche Agenten eignen sich für Recherche und Vorbereitung, die Ergebnisse brauchen aber weiterhin menschliche Redaktion und Faktenprüfung. Genau dieses Fazit bestimmt, dass das später beschriebene Kostenmodell eine menschliche Prüfung enthalten muss.
2 Die vollständigen Kosten eines selbstgebauten KI-Mitarbeiter-Agents
2.1 Die fünf Kostenarten eines selbstgebauten Agents
Wenn man mit APIs einen Agent baut, der dauerhaft arbeitet, besteht die Rechnung aus weit mehr als nur den Modellaufrufen. Man kann die Kosten in fünf Kategorien aufteilen:
- Modellkosten: Eingaben, Ausgaben, Cache-Lese- und Schreibvorgänge sowie Inferenzverbrauch – sie ändern sich linear mit der Aufgabenmenge.
- Infrastrukturkosten: Cloud-Server, Container, Datenbanken, Speicher. Ein Teil davon ist eine feste Monatsmiete, ein Teil variiert mit der Last.
- Werkzeugkosten: Such-APIs, Headless-Browser, Daten-Schnittstellen von Drittanbietern – meist pro Aufruf abgerechnet.
- Entwicklungskosten: Erstentwicklung, Systemintegration, Rechtekonzept. Der Aufwand konzentriert sich auf die Anfangsphase.
- Wartungskosten: Monitoring und Alarme, Fehlersuche, Regressionstests nach Modell-Upgrades – sie fallen laufend an.
Als Formel:
$$C_{self}=C_{API}+C_{infra}+C_{tools}+C_{dev}+C_{maintenance}$$
Die Kostenstruktur beim Abo-Weg sieht so aus:
$$C_{subscription}=C_{plan}+C_{extra\ usage}+C_{human\ review}$$
In beiden Wegen steckt Personalzeit. Beim Selbstbau verteilt sie sich auf Entwicklung, Wartung und Prüfung; beim Abo vor allem auf Aufgaben-Delegation, Ergebnisprüfung und Freigaben.
2.2 Ein Design für einen selbstgebauten KI-Mitarbeiter-Agent
Im Folgenden ein Design, das zur Kostenkalkulation dient und zeigt, welche Komponenten ein selbstgebauter Agent braucht. Die Preise für die einzelnen Komponenten setzt du bitte mit den tatsächlichen Angeboten deines Cloud-Anbieters an – eine Deployment-Messung dieses Designs wurde in diesem Artikel nicht durchgeführt.
- Scheduling-Schicht: Zeitgesteuerte Trigger oder Message-Queue, zuständig für wiederkehrende Aufgaben wie „jeden Morgen um 8 Uhr Lagebericht erstellen“.
- Orchestrierungs-Schicht: Das Agent-Framework übernimmt Schrittplanung, Tool-Aufrufe und Zwischenzustand (etwa der Checkpointer von LangGraph oder der Workflow des OpenAI Agents SDK).
- Modell-Schicht: Modellaufrufe über eine OpenAI-kompatible Schnittstelle, Routing je nach Aufgabenschwierigkeit zu unterschiedlichen Modellen.
- Werkzeug-Schicht: Suche, Web-Scraping, Headless-Browser, Dateigenerierung.
- Zustands-Schicht: Datenbank für Aufgabenprotokolle, Langzeitnotizen und Deduplizierungsinformationen.
- Freigabe-Schicht: Aktionen mit Außenwirkung, Zahlungen oder Löschvorgänge landen in einer Warteschlange für manuelle Freigabe.
- Beobachtungs-Schicht: Erfasst pro Aufruf Token, Laufzeit und Fehlerursachen – als Datenquelle für die Kostenrechnung.
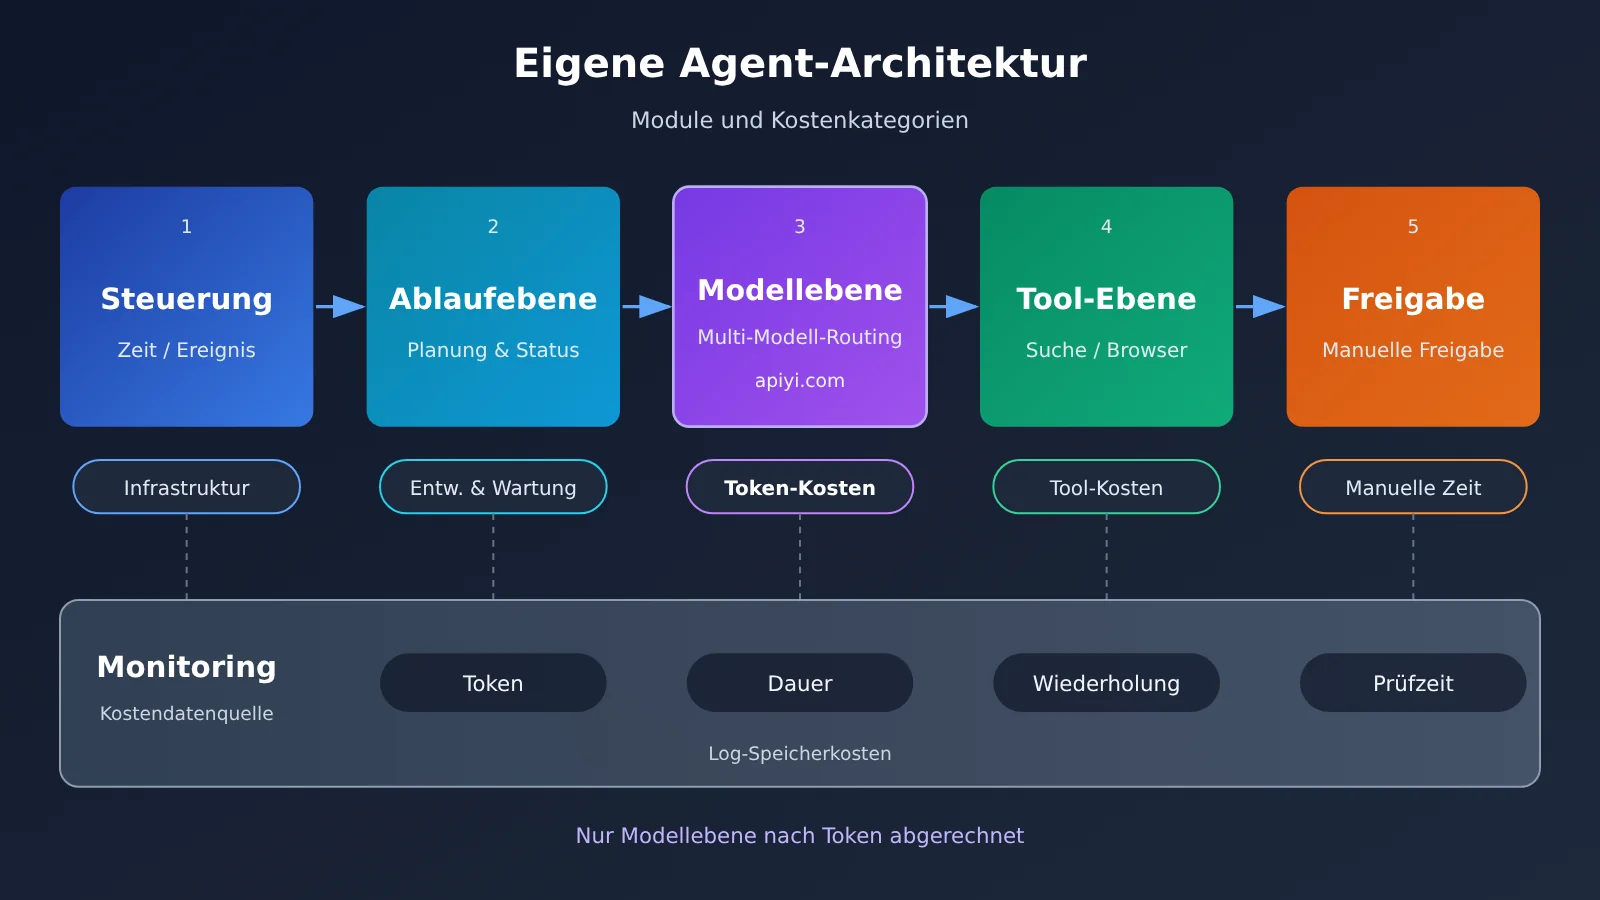
Von den sieben Komponenten in diesem Bild lassen sich nur die Kosten der Modell-Schicht direkt aus dem Token-Preis berechnen. Die Kosten der übrigen Komponenten hängen von der Architekturwahl und den Fähigkeiten des Teams ab. Genau deshalb sind Token-Kosten nur ein Teil der Selbstbaukosten.
3 Wie viele Token eine Aufgabe eines KI-Mitarbeiters verbraucht
3.1 Abrechnungsunterschiede bei Eingabe, Ausgabe und Caching
Eine Aufgabe eines Agenten umfasst in der Regel mehrere Modellaufrufe: einmal für die Planung, dann nach jedem Tool-Aufruf eine erneute Inferenz und schließlich eine Zusammenfassung. In jeder Runde werden der System-Prompt, die Tool-Definitionen und die bisherigen Schritte erneut als Eingabe gesendet. Deshalb sind die Eingabe-Token eines Agenten oft deutlich höher als die Ausgabe-Token.
Genau hier kommt das Caching ins Spiel. System-Prompt und Tool-Definitionen bleiben über mehrere Aufrufe hinweg unverändert. Wenn der Cache greift, wird nach dem Preis für Cache-Lesen abgerechnet – etwa ein Zwanzigstel des normalen Eingabepreises. Das Schreiben in den Cache erfolgt beim erstmaligen Speichern des Präfixes; der Preis dafür richtet sich nach der Plattform-Konsole und ist in den Beispielen dieses Artikels nicht berücksichtigt.
3.2 Berechnung der Modellkosten pro Aufgabe mit APIYI-Preisen
Die folgenden Preise stammen aus den am 13. November 2026 von APIYI veröffentlichten Claude-Modellpreisen; maßgeblich sind die Konsole und die Modellliste zum Zeitpunkt des Aufrufs. Der Aufgabenumfang ist ein hypothetisches Beispiel zur Demonstration des Algorithmus: pro Aufgabe 30.000 Token Eingabe und 5.000 Token Ausgabe, 300 Aufgaben pro Monat. Dieses Beispiel hat nichts mit dem tatsächlichen durchschnittlichen Verbrauch von Dots oder irgendeiner anderen Plattform zu tun.
| Berechnungsposten | Claude Opus 5.5 | Claude Sonnet 5.5 |
|---|---|---|
| Eingabepreis / Ausgabepreis / Cache-Lesepreis (pro Million Token) | $4 / $20 / $0.20 | $2 / $10 / $0.10 |
| Kosten pro Aufgabe (ohne Cache) | 30,000×$4/10⁶ + 5,000×$20/10⁶ = $0.22 | 30,000×$2/10⁶ + 5,000×$10/10⁶ = $0.11 |
| Monatliche Kosten für 300 Aufgaben (ohne Cache) | $66 | $33 |
| Kosten pro Aufgabe (angenommen, 20.000 Eingabe-Token treffen auf einen Cache-Lesevorgang) | $0.04 + $0.004 + $0.10 = $0.144 | $0.02 + $0.002 + $0.05 = $0.072 |
| Monatliche Kosten für 300 Aufgaben (inkl. Annahme zur Cache-Lesung) | $43.2 | $21.6 |
| Verfügbare Plattformen | APIYI, offizielle API | APIYI, offizielle API |
Unter dieser Annahme liegen die reinen Modellkosten unter der Monatsgebühr von $100 für Pro 100. Dieses Ergebnis zeigt lediglich, dass die Modellebene günstig ist. Es enthält weder Infrastruktur, Tools, Entwicklungs- und Wartungsaufwand noch manuelle Prüfung und berücksichtigt auch keine Wiederholungsläufe nach Fehlern.
3.3 Den tatsächlichen Token-Verbrauch von KI-Mitarbeiteraufgaben im Code erfassen
Für die Kostenkalkulation müssen Annahfewerte durch echte Verbrauchsdaten ersetzt werden. Das folgende Minimalbeispiel ruft einmal ein Modell auf und liest das zurückgegebene usage-Feld aus:
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # OpenAI-kompatible APIYI-Schnittstelle
)

resp = client.chat.completions.create(
    model="claude-sonnet-5.5",  # Maßgeblich ist der tatsächliche Name in der APIYI-Modellliste
    messages=[{"role": "user", "content": "汇总今天的 AI 行业新闻要点"}]
)
print(resp.usage)  # Anzahl der Eingabe- und Ausgabe-Token, für die Kostenkalkulation
Vollständige Implementierung ansehen: jeden Lauf protokollieren und Kosten pro erfolgreicher Aufgabe berechnen
import time
import openai
from dataclasses import dataclass, field

# Preis pro eine Million Token (USD), maßgeblich ist die Konsole zum Zeitpunkt des Aufrufs
PRICES = {
    "claude-opus-5.5":   {"input": 4.0, "output": 20.0, "cache_read": 0.20},
    "claude-sonnet-5.5": {"input": 2.0, "output": 10.0, "cache_read": 0.10},
}

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

@dataclass
class RunRecord:
    task_id: str
    model: str
    input_tokens: int
    output_tokens: int
    cached_tokens: int
    seconds: float
    cost: float
    passed: bool = False          # manuelle Bewertung nach einheitlichen Abnahmekriterien
    review_minutes: float = 0.0   # Zeit für manuelle Prüfung und Korrektur

@dataclass
class Ledger:
    runs: list = field(default_factory=list)

    def call(self, task_id: str, model: str, messages: list) -> str:
        start = time.time()
        resp = client.chat.completions.create(model=model, messages=messages)
        usage = resp.usage
        details = getattr(usage, "prompt_tokens_details", None)
        cached = getattr(details, "cached_tokens", 0) or 0
        p = PRICES[model]
        uncached_input = usage.prompt_tokens - cached
        cost = (uncached_input * p["input"]
                + cached * p["cache_read"]
                + usage.completion_tokens * p["output"]) / 1_000_000
        self.runs.append(RunRecord(task_id, model, usage.prompt_tokens,
                                   usage.completion_tokens, cached,
                                   time.time() - start, cost))
        return resp.choices[0].message.content

    def cost_per_success(self, hourly_rate: float, fixed_cost: float = 0.0) -> float:
        """(Kosten aller Läufe + Fixkosten + Prüfungsaufwand) / Anzahl qualifizierter Aufgaben"""
        api = sum(r.cost for r in self.runs)
        review = sum(r.review_minutes for r in self.runs) / 60 * hourly_rate
        passed_tasks = {r.task_id for r in self.runs if r.passed}
        if not passed_tasks:
            return float("inf")
        return (api + fixed_cost + review) / len(passed_tasks)

ledger = Ledger()
text = ledger.call("news-1116", "claude-sonnet-5.5",
                   [{"role": "user", "content": "汇总今天的 AI 行业新闻要点"}])
ledger.runs[-1].passed = True
ledger.runs[-1].review_minutes = 8
print(ledger.cost_per_success(hourly_rate=30, fixed_cost=0))
🚀 Tipp für den schnellen Einstieg: Für ein Kosten-Vergleichsexperiment kannst du zunächst in APIYI apiyi.com mit demselben API-Schlüssel einmal Opus und einmal Sonnet aufrufen, das obige Ledger in deinen Agenten einbinden und nach einer Woche echter Aufgaben einen Blick ins Kontobuch werfen. Die Plattform rechnet nutzungsbasiert ab, neue Nutzer erhalten ein kostenloses Testkontingent – ideal, um schon vor der eigentlichen Entwicklung echte Token-Daten zu gewinnen.
4 Warum sich die Kosten für KI-Mitarbeiter je nach Modell so stark unterscheiden
Im hypothetischen Beispiel aus Abschnitt 3 liegen die Modellkosten pro Aufgabe bei Opus 5.5 doppelt so hoch wie bei Sonnet 5.5. Betrachtet man nur diese Spalte, spart Sonnet monatlich $33. Die endgültigen Kosten einer Agent-Aufgabe hängen jedoch auch von der Erfolgsquote und der manuellen Prüfung ab. Die folgende Darstellung mit einer Reihe hypothetischer Parameter zeigt, wie sich dieser Effekt auswirkt.
Angenommen, die Qualitätsrate von Opus bei einem Durchlauf liegt bei 90 %, die von Sonnet bei 60 %, und nicht bestandene Aufgaben werden so lange erneut ausgeführt, bis sie bestehen. Nach Erwartungswert berechnet, liegen die Modellkosten pro bestandener Aufgabe bei etwa $0.22÷0.9 ≈ $0.24 bzw. $0.11÷0.6 ≈ $0.18. Der Unterschied bei der Erfolgsquote hat damit bereits einen Großteil des Vorteils beim Stückpreis aufgezehrt.
Noch stärker wirkt sich die menschliche Arbeitszeit aus. Angenommen, der auf eine Stunde umgerechnete Lohn der Prüfperson beträgt $30, dann kostet eine Minute manuelle Arbeit etwa $0.5. Wenn die Ausgabe von Sonnet pro Aufgabe im Schnitt nur eine Minute mehr Korrektur benötigt, übersteigen die zusätzlichen $0.5 bereits die gesamte Preisdifferenz zwischen den beiden Modellen. Bei Aufgaben aus den Bereichen Intelligence und Reporting, bei denen Daten Punkt für Punkt geprüft werden müssen, wird die Prüfzeit oft in Minuten gemessen. In solchen Fällen senkt ein stabileres Modell die Gesamtkosten.
Umgekehrt gilt: Bei einfachen Aufgaben mit festem Format, die sich leicht automatisch prüfen lassen – etwa Klassifikation, Zusammenfassung oder Feldextraktion –, kann die Erfolgsquote des günstigeren Modells nahe an der des teureren Modells liegen. Für solche Aufgaben ist Sonnet oder ein noch günstigeres Modell sinnvoller. Beide Richtungen lassen sich erst dann fundiert beurteilen, wenn man die Erfolgsquoten mit echten Aufgaben gemessen hat.
5 Sechsdimensionen-Vergleich von KI-Mitarbeitern: Dots, Einzelmodell-Agent und Multi-Modell-Agent
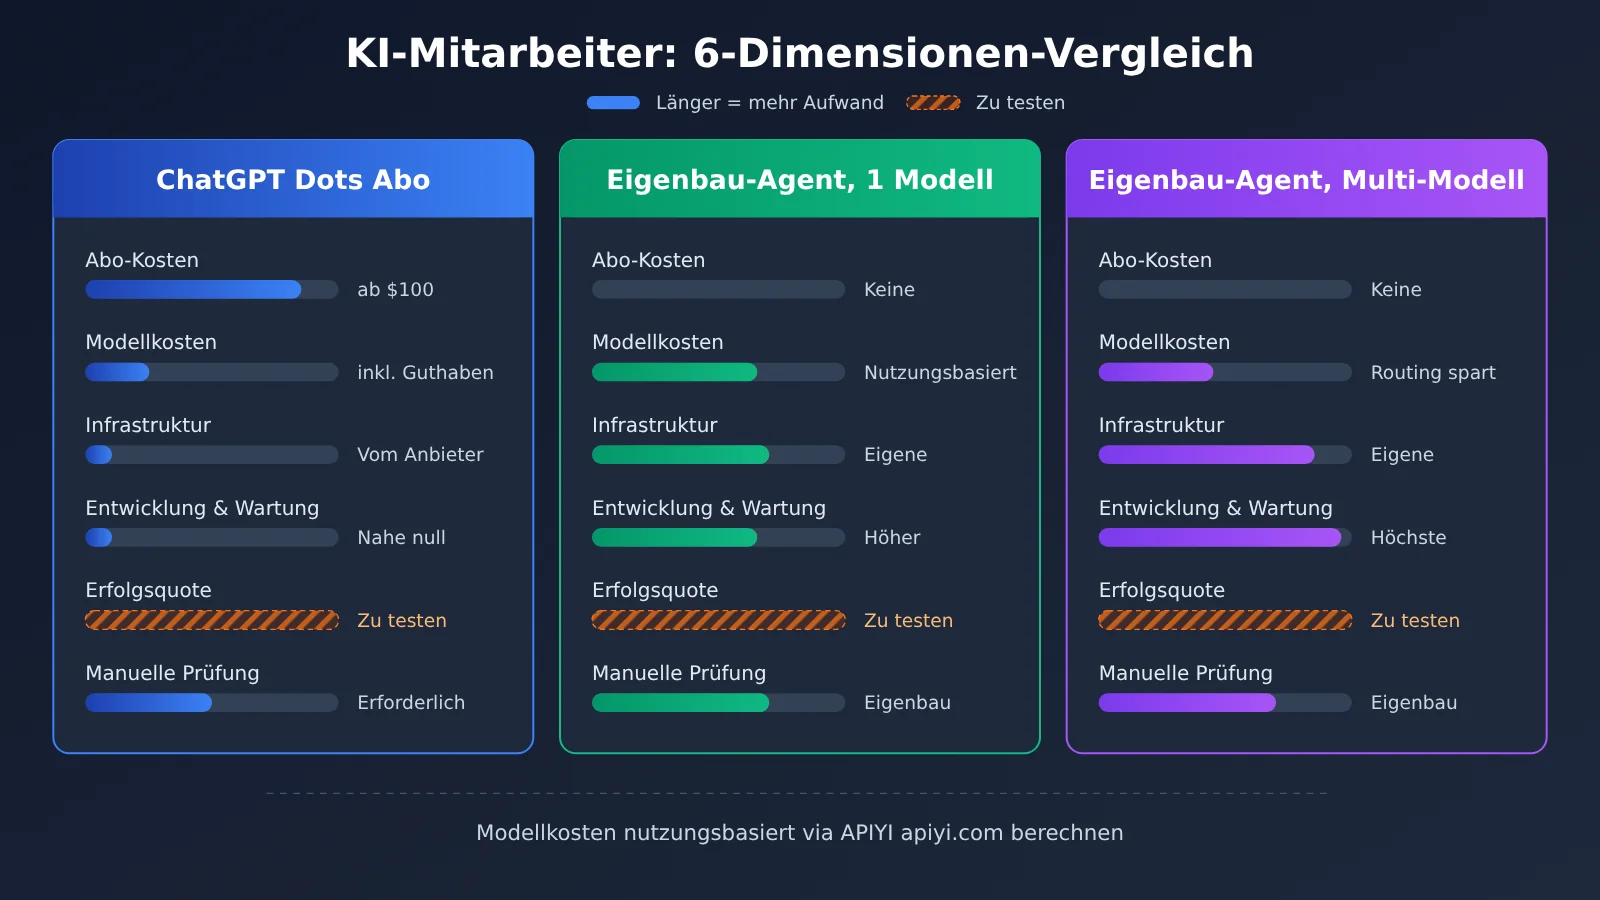
| Dimension | ChatGPT Dots | Einzelmodell-Agent (selbst gebaut) | Multi-Modell-Agent (selbst gebaut) |
|---|---|---|---|
| Abo-Kosten | Privat: Pro ab 100 $/Monat; Unternehmen nach Vertrag | Keine | Keine |
| Modellkosten | Im Abo-Kontingent enthalten; Delegation an Work/Codex wird separat abgerechnet | Abrechnung pro Token, wächst linear mit der Aufgabenmenge | Abrechnung pro Token, durch Routing nach Schwierigkeit lässt sich der Durchschnittspreis senken |
| Infrastruktur | Cloud-Computer und Browser werden offiziell bereitgestellt | Eigene Server, Datenbank und Browserumgebung | Wie beim Einzelmodell, zusätzlich Routing- und Evaluierungslogik |
| Entwicklung und Wartung | Nahezu keine Entwicklung, vor allem Konfiguration von Regeln und Berechtigungen | Hoher anfänglicher Entwicklungsaufwand, kontinuierliche Wartung | Höchste Komplexität bei Entwicklung und Wartung |
| Aufgaben-Abschlussrate | Muss an den eigenen Aufgaben gemessen werden; unabhängige Tests zeigen, dass manuelle Prüfung weiterhin nötig ist | Hängt vom Modell und der Engineering-Qualität ab, muss gemessen werden | Hängt von der Routing-Strategie ab, muss gemessen werden |
| Manuelle Prüfung | Erforderlich, Auto-review und Freigabemechanismen unterstützen dabei | Erforderlich, Freigabeprozess muss selbst gebaut werden | Erforderlich, Freigabeprozess muss selbst gebaut werden |
| Modellanbindung | In OpenAI-Produkten integriert | Über die einheitliche Schnittstelle von APIYI | Mit einem einzigen APIYI-API-Schlüssel lassen sich mehrere Modelle aufrufen |
Vergleichsanalyse Dots: Dots hat klare Vorteile bei der Out-of-the-Box-Nutzung, der app-übergreifenden Zusammenarbeit und dem langen Kontext – Cloud-Computer, ein Ökosystem mit 4.000+ Apps und die Kommunikation über mehrere Kanäle erfordern keine Entwicklung. Die Grenzen liegen darin, dass die Kontingentregeln bis hin zur Anzahl der Aufgaben intransparent sind und die Ausführungslogik nicht tiefgehend angepasst werden kann; das private Pro unterliegt zudem regionalen und altersbezogenen Beschränkungen.
Vergleichsanalyse Einzelmodell-Agent: Der Kostenaufbau ist am klarsten, Token und Kosten jedes Aufrufs lassen sich präzise erfassen, und die Ausführungslogik ist vollständig kontrollierbar. Der Preis dafür: Browser, Scheduling, Zustandsverwaltung und Freigaben müssen selbst gebaut werden, und die Aufgaben-Abschlussrate hängt vollständig von der Engineering-Kompetenz des Teams ab.
Vergleichsanalyse Multi-Modell-Agent: Er übergibt einfache Schritte an günstige Modelle und überlässt die entscheidende Reasoning-Arbeit starken Modellen – bei hoher Aufgabenlast bietet sich hier die größte Chance, die Kosten pro erfolgreich abgeschlossener Aufgabe zu senken. Die Anforderungen an das Evaluierungssystem sind am höchsten: Man muss laufend überwachen, wie hoch die Erfolgsrate jedes Modells bei jeder Art von Schritt ist.
6 Erfolgreiche Aufgabenkosten als Maßstab dafür, ob sich ein KI-Mitarbeiter rechnet
6.1 Kosten pro erfolgreicher Aufgabe und ROI-Formel
Das einheitliche Messkriterium lautet:
$$C_{successful\ task}=\frac{C_{all\ runs}+C_{infrastructure}+C_{review}}{N_{successfully\ completed\ tasks}}$$
Der Zähler umfasst alle Läufe (inklusive Fehlschlägen und Wiederholungen), die auf diesen Zeitraum umgelegten Infrastrukturkosten sowie die manuelle Prüfung; im Nenner stehen ausschließlich die qualifiziert gelieferten Aufgaben. Bei Dots wird der Posten „Laufkosten“ im Zähler durch die monatliche Abonnementgebühr und die zusätzliche Nutzung ersetzt.
Darauf aufbauend lässt sich das Verhältnis von Aufwand und Ertrag berechnen:
$$ROI=\frac{V_{time\ saved}-C_{total}}{C_{total}}$$
Für die Zeitersparnis multipliziert man die tatsächliche Dauer, die ein Mensch für diese Aufgabe gebraucht hätte, mit einem realistischen Personalkostensatz. Dass ein Modell ein Dokument in wenigen Sekunden erzeugt, sagt nur etwas über die Generierungsgeschwindigkeit aus – von der eingesparten Arbeitszeit muss man Prüfung und Korrektur abziehen.
6.2 Vergleichsexperiment zu den Kosten eines KI-Mitarbeiters bei drei Aufgabentypen
Empfohlen sind drei repräsentative Daueraufgaben: tägliche KI-Nachrichtenrecherche, wöchentliches Wettbewerber-Monitoring und monatlicher Datenanalysebericht. Mit denselben Eingangsmaterialien und demselben Lieferstandard führt man sie jeweils mit ChatGPT Dots, APIYI + Single-Model-Agent sowie APIYI + Multi-Model-Agent aus und protokolliert bei jedem Lauf die folgenden Punkte:
| Erfasster Punkt | Erfassungsmethode | Zweck |
|---|---|---|
| Start- und Endzeit | Zeitstempel im Aufgabenprotokoll | tatsächliche Lieferdauer berechnen |
| Anzahl der Modellaufrufe | Zählung in der Orchestrierungsschicht | Schleifen und übermäßige Aufrufe erkennen |
| Input- / Output- / Cache-Token | usage-Feld der API-Rückgabe |
Modellkosten und Cache-Ertrag berechnen |
| Anzahl der Tool-Aufrufe | Zählung in der Tool-Schicht | Kosten für Suche, Browser usw. berechnen |
| Fehlschläge und Wiederholungen | Klassifikation der Fehlerursachen | zusätzlichen Verbrauch berechnen |
| Manuelle Korrekturzeit | Zeitmessung durch die Prüfer | tatsächlichen Personaleinsatz berechnen |
| Endergebnis der Abnahme | Bewertung nach vorab festgelegter Checkliste als bestanden / nicht bestanden | Erfolgsquote der Aufgaben und Nenner berechnen |
Auf der Dots-Seite bekommt man keine Token-Details; dort lassen sich Abonnementgebühr, Kontingentverbrauch, Abschlusszeit, manuelle Korrekturzeit und Abnahmeergebnis erfassen. Am Ende werden alle drei Routen in „wie viel Geld und wie viele Arbeitsminuten jede qualifizierte Aufgabe gekostet hat“ umgerechnet. Der Versuchszeitraum sollte mindestens einen vollständigen monatlichen Berichtszyklus abdecken; bei zu kleiner Stichprobe verzerren einzelne Fehlschläge das Ergebnis stark.
7 Wann Sie ein Dots-Abo wählen und wann Sie einen KI-Mitarbeiter-Agent selbst bauen
7.1 Privatanwender: das Dots-Abo hat Vorrang
- Alltagsaufgaben delegieren: Terminplanung, Meeting-Vorbereitung, E-Mail-Sortierung, Reiseplanung – bei solchen app-übergreifenden Aufgaben sind Dots‘ App-Anbindungen und der Cloud-Computer direkt einsatzbereit.
- Kein System pflegen wollen: Ein selbst gebauter Agent muss laufend gewartet und aktualisiert werden; für Privatanwender ist der Zeitaufwand meist höher als die Abo-Gebühr.
- Voraussetzungen: Alters- und Regionsvorgaben erfüllen und die Pro-Kontingentregeln akzeptieren; bei sehr geringem monatlichem Aufgabenvolumen sollte man die 100-Dollar-Hürde gegen die tatsächliche Nutzungshäufigkeit abwägen.
7.2 Power-Entwickler: Selbstbau oder Hybridmodell
- Individuelle Ausführungslogik nötig: das Abrufen von Informationen in festem Format, die Überwachung bestimmter Datenquellen, die tiefe Integration in interne Systeme.
- Feingranulare Kostenkontrolle nötig: Modellwahl pro Schritt, Nutzung von Caches, Abrechnung jeder einzelnen Einheit anhand der Aufrufprotokolle.
- Technische Fähigkeiten vorhanden: Wer Scheduling, Statusverwaltung und Freigaben selbst aufbauen kann, kann die Entwicklungskosten über langfristige Aufgaben amortisieren.
7.3 Unternehmensteams: auf Vertragsangebot und Compliance achten
- Bereits vorhandener Enterprise-Arbeitsbereich: Dots lässt sich vom Administrator zentral konfigurieren; Daten aus Business-, Enterprise- und Edu-Arbeitsbereichen werden standardmäßig nicht für das Modelltraining verwendet; die Abrechnung erfolgt nach dem Angebot für den jeweiligen Arbeitsbereich.
- Anbindung an interne Systeme oder private Prozesse nötig: Ein selbst gebauter Agent bietet mehr Kontrolle über Ausführungsumgebung, Datenfluss und Audit-Protokolle.
- Groß angelegte Standardaufgaben: Wenn das Aufgabenvolumen groß genug und der Prozess stabil genug ist, hat ein selbst gebauter Multi-Modell-Agent eher die Chance, die Kosten pro Aufgabe zu senken – vorausgesetzt, man belegt das mit kontrollierten Vergleichsexperimenten.
8 Hybride Lösung für KI-Mitarbeiter: Abonnement und API-Nutzung nach Verbrauch kombiniert
Abonnements und APIs lassen sich nach Aufgabentyp aufteilen, sodass jede Seite das übernimmt, was sie am besten kann:
- Tägliche Interaktion und Aufgaben, die menschliches Urteilsvermögen erfordern: an Dots oder ein bestehendes ChatGPT-Abo übergeben, um den langfristigen Kontext und die Freigabemechanismen zu nutzen.
- Stabile, automatisch prüfbare Batch-Aufgaben: über die API nach Verbrauch abrechnen und an kostengünstige Modelle geben.
- Anspruchsvolle Schlussfolgerungen und kritische Ergebnisse: leistungsfähigere Modelle aufrufen und einen höheren Stückpreis gegen eine geringere Nacharbeitsquote eintauschen.
- Zu Spitzenzeiten: Wenn das Abo-Kontingent knapp wird, Aufgaben, die sich auslagern lassen, auf Pay-per-Use umstellen.
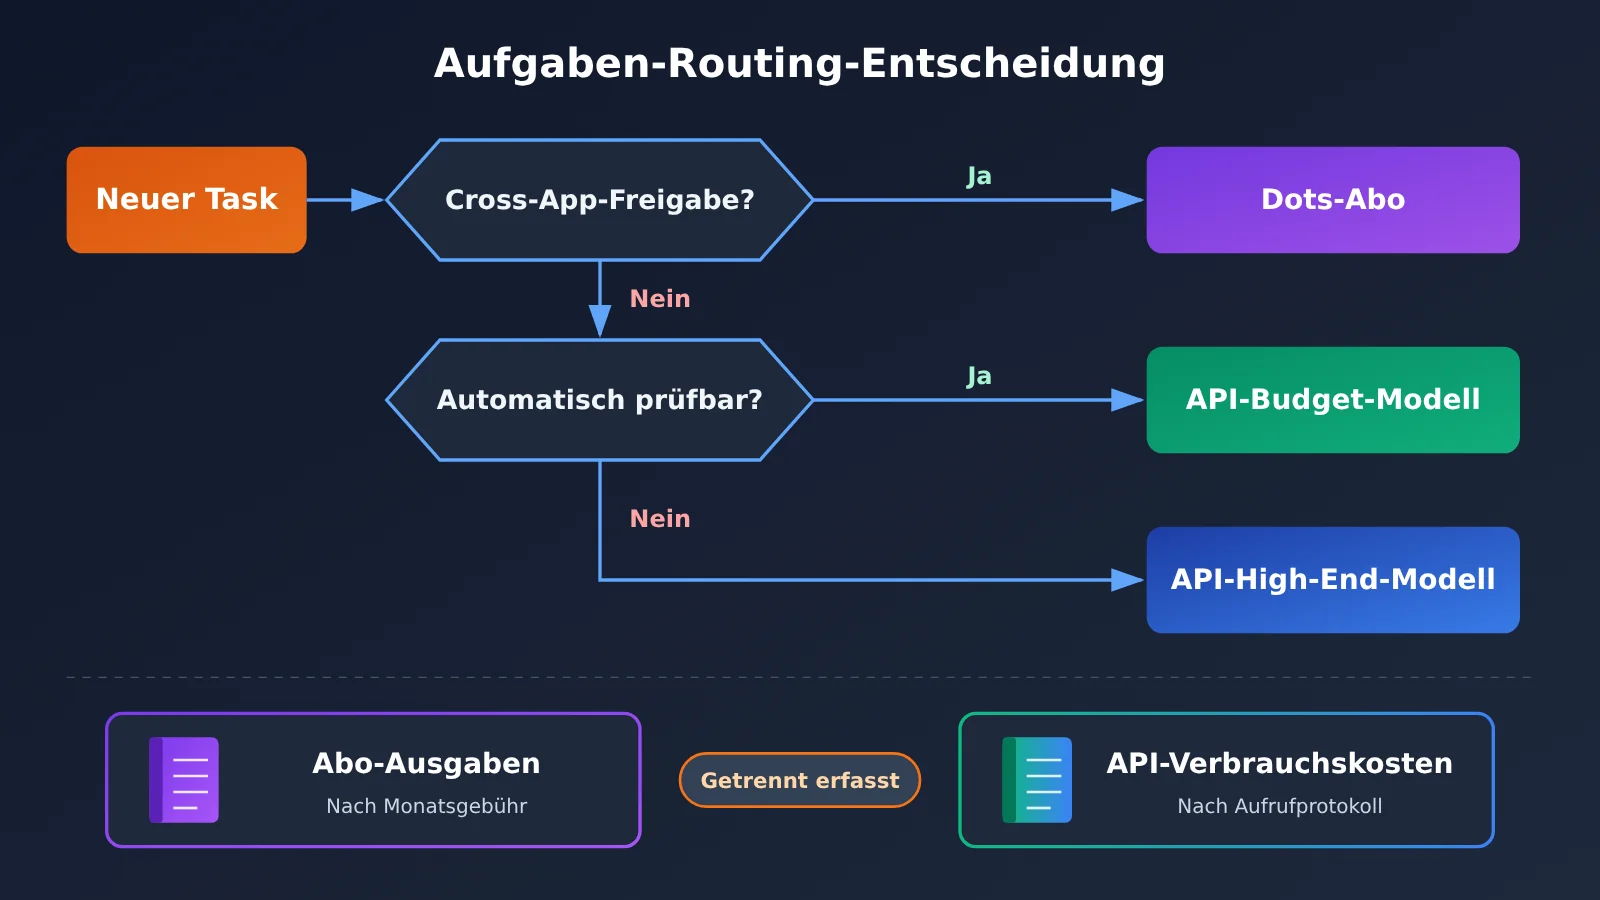
Der Kern der hybriden Lösung ist die getrennte Abrechnung: Abo-Ausgaben werden über die Monatsgebühr verbucht, API-Ausgaben über das Aufrufprotokoll, und eine Aufgabe wird immer nur der Route zugerechnet, die sie tatsächlich ausgeführt hat – so vermeiden Sie doppelte Zählung.
💡 Entscheidungshilfe: Übernehmen Sie die tägliche Arbeit zunächst mit Dots oder einem bestehenden Abo und wählen Sie gleichzeitig ein bis zwei standardisierte Aufgabenklassen aus, die Sie über APIYI apiyi.com mit mehreren Modellen in Vergleichstests laufen lassen. Entscheiden Sie anhand der Kostendaten eines Monats erfolgreicher Aufgaben, welche Aufgaben zur API wandern und welche im Abo bleiben – das ist solider, als von Anfang an pauschal für das eine oder das andere zu entscheiden.
Häufig gestellte Fragen (FAQ)
Q1: Was ist ChatGPT Dots?
ChatGPT Dots ist ein dauerhaft präsenter persönlicher KI-Agent, den OpenAI am 29. September 2026 veröffentlicht hat. Er verfügt über einen eigenen Cloud-Computer und einen eigenen Browser, kann delegierte Aufgaben über Sitzungen und Anwendungen hinweg kontinuierlich vorantreiben und gibt sie aktiv an den Nutzer zurück, wenn eine menschliche Entscheidung nötig ist.
Q2: Was kostet Dots bei privater Nutzung pro Monat?
Stand 16. November 2026 müssen Privatnutzer ChatGPT Pro abonnieren. Pro 100, Pro 200 und Pro 500 kosten monatlich $100, $200 bzw. $500; alle drei Stufen können Dots nutzen, und offiziell wird keine separate Dot-Monatsgebühr ausgewiesen. Über Dot delegierte Work- oder Codex-Aufgaben werden nach dem Kontingent des jeweiligen Produkts abgerechnet.
Q3: Wie wird Dots in der Enterprise-Version abgerechnet?
Berechtigte Unternehmens-Workspaces können entweder einen festen Satz pro Arbeitstyp oder eine verbrauchsbasierte Abrechnung wählen; die konkreten Beträge richten sich nach dem für den Workspace geltenden Vertrag bzw. Angebot. Vom 4. bis 18. November 2026 gilt eine kostenlose Admin-Vorschauphase; Dots, die ab dem 18. November aktiviert werden, werden abgerechnet, und an Work oder Codex delegierte Aufgaben kosten zusätzlich.
Q4: Wenn die Modellkosten eines selbstgebauten Agenten unter $100 liegen, ist er dann billiger als Dots?
Dazu kommen noch Server, Datenbank, Such- und Browser-Tools, Entwicklung und Wartung sowie die manuelle Prüfung, und die Auswirkungen von Fehlschlägen mit Wiederholungsläufen müssen abgezogen werden. Erst wenn man die Kosten pro erfolgreich erledigtem Auftrag bei derselben Aufgabenserie und denselben Abnahmekriterien vergleicht, lässt sich sagen, welcher Weg günstiger ist.
Q5: Wie lassen sich die Modellkosten eines selbstgebauten Agenten schnell per API ermitteln?
So gehen Sie vor:
1. Bei APIYI apiyi.com registrieren, einen API-Schlüssel holen und das Testguthaben für neue Nutzer in Anspruch nehmen.
2. Im Code dieses Artikels `base_url` auf `https://api.apiyi.com/v1` setzen und das Ledger anbinden, das die Token jedes einzelnen Aufrufs protokolliert.
3. Mit echten Aufgaben getrennt Opus 5.5 und Sonnet 5.5 aufrufen, Abnahmeergebnis und Zeit für manuelle Korrekturen festhalten und daraus die Kosten pro erfolgreich erledigtem Auftrag berechnen.
Q6: Wie stark wirkt sich Caching auf die Agent-Kosten aus?
Bei mehrstufigen Agent-Aufrufen werden die System-Eingabeaufforderung und die Tool-Definitionen immer wieder mitgesendet; bei einem Cache-Treffer wird zum Preis für Cache-Lesen abgerechnet, und in der Claude-5.5-Reihe liegt dieser Preis etwa beim Zwanzigstel des normalen Input-Preises. Im hypothetischen Beispiel dieses Artikels sinken die Modellkosten pro Aufgabe um rund ein Drittel, wenn zwei Drittel des Inputs aus dem Cache kommen. Der Preis für das Schreiben in den Cache richtet sich nach der Konsole.
Q7: Kann Dots menschliche Arbeit vollständig ersetzen?
Sowohl die offiziellen Unterlagen als auch Praxistests von Drittanbietern zeigen, dass die Ergebnisse von Dots menschlich geprüft werden müssen. Im Axios-Test enthielt ein von Dots erstelltes Programmheft fragwürdige Daten, und Vorgänge rund um Konten und Geld muss der Nutzer weiterhin selbst übernehmen. Deshalb sollten die Kosten für die manuelle Prüfung immer in die Gesamtkosten einfließen.
Q8: Kann Dots Aufgaben unbegrenzt parallel bearbeiten?
Dots unterstützt mehrere Projekte und parallel laufende Hintergrund-Agenten, doch Ausführungsumgebung und Nutzungskontingente haben Grenzen. Ein Reddit-Nutzer berichtete, dass beim Start eigenständiger Aufgaben die Ausführungsumgebung nicht verfügbar war und er erst nach dem Verbinden mit einem lokalen Linux-Rechner fortfahren konnte; außerdem gab er an, nicht bestätigen zu können, wie die Kontingente der einzelnen Ausführungspfade berechnet werden.
Wichtigste Erkenntnisse zu den Kosten von KI-Mitarbeitern
- Vergleichsgrundlage: Entscheidend sind die Kosten pro erfolgreich abgeschlossener Aufgabe bei gleichem Lieferstandard; Monatsgebühr und Token-Preis sind jeweils nur ein Faktor.
- Privatpersonen und Unternehmen getrennt kalkulieren: Für Einzelpersonen beginnt Pro bei $100/Monat; für Unternehmen wird Dot nach Art der Arbeit oder Nutzung abgerechnet, maßgeblich ist der Vertrag.
- Das Abo bündelt die Umgebung: Cloud-Computer, Langzeitkontext, App-Anbindungen und Genehmigungsmechanismen sind Kosten, die bei einem Eigenbau zusätzlich anfallen.
- Modellkosten sind nur eine Ebene: Im Beispielszenario kosten 300 Aufgaben pro Monat an Modellgebühren $33–$66, ohne Infrastruktur und Personal.
- Die Erfolgsquote bestimmt die tatsächlichen Kosten: Jede zusätzliche Minute manueller Korrektur kann den gesamten Preisunterschied der beiden Modelle aufheben.
- Hybride Nutzung ist flexibler: Für die tägliche Delegation das Abo nutzen, standardisierte Batch-Aufgaben über APIYI nutzungsbasiert aufrufen und separat abrechnen.
Zusammenfassung
Ob es sich lohnt, monatlich 100 US-Dollar für einen KI-Mitarbeiter auszugeben, hängt davon ab, welche Aufgaben Sie ihm übertragen und welche Abnahmekriterien Sie ansetzen:
- Der Wert von Dots liegt in der sofort einsatzbereiten, kontinuierlichen Arbeitsfähigkeit: Cloud-Computer, app-übergreifende Zusammenarbeit und langfristiger Kontext ersparen Entwicklung und Wartung – ideal für Einzelnutzer und Teams, die geringen Wartungsaufwand schätzen.
- Der Vorteil eines selbst gebauten Agents liegt in Kontrolle und nachvollziehbaren Kosten: Anpassbare Ausführungslogik, jeder Aufruf lässt sich kostenmäßig verfolgen – passend für Teams mit stabiler technischer Kompetenz und hochstandardisierten Aufgaben.
- Die endgültige Entscheidung liefert ein kontrollierter Vergleichstest: Erfassen Sie bei drei Arten realer Aufgaben Token, Wiederholungen und manuelle Korrekturzeit und vergleichen Sie die Gesamtkosten pro bestandener Aufgabe.
Empfehlung: Behalten Sie zunächst das bestehende Abo für die tägliche Arbeit und wählen Sie eine standardisierte Aufgabe für einen API-Vergleichstest aus. Über APIYI apiyi.com können Sie mit einem einzigen API-Schlüssel mehrere Modelle anbinden, nutzungsbasiert abrechnen und den tatsächlichen Verbrauch erfassen – so entscheiden Daten darüber, welche Aufgaben sich für eine Migration lohnen.
📚 Referenzen
-
OpenAI: Introducing dots: Ankündigung zur Veröffentlichung von Dots, Produktpositionierung, Cloud-Computer und App-Ökosystem
- Link:
openai.com/index/introducing-dots - Beschreibung: Offizielle Primärquelle, veröffentlicht am 29.09.2026
- Link:
-
ChatGPT Learn: Meet dots / Tasks and memory: Produktüberblick, Abo-Berechtigung, langfristige Aufgaben und Erinnerungsmechanismus
- Link:
learn.chatgpt.com/docs/dots - Beschreibung: Maßgebliche Dokumentation zu Hintergrund-Agents, proaktiver Recherche und zeitgesteuerten Aufgaben
- Link:
-
ChatGPT Learn: Enterprise Dots 管理员指南: Einrichtung und Abrechnung von Enterprise-Arbeitsbereichen
- Link:
learn.chatgpt.com/docs/enterprise/dots-admin-guide - Beschreibung: Aktuelle Hinweise zu Pauschalpreisen und nutzungsbasierter Abrechnung für Unternehmen
- Link:
-
OpenAI Help Center: About ChatGPT Pro tiers: Preise und Kontingentregeln für Pro 100 / 200 / 500
- Link:
help.openai.com/en/articles/9793128-about-chatgpt-pro-tiers - Beschreibung: Offizielle Grundlage für die Preise von Privatabos
- Link:
-
OpenAI Help Center: Dots privacy, security, and safety FAQs: Berechtigungen, Freigaben, Auto-review und Datenrichtlinien
- Link:
help.openai.com/en/articles/20001529-dots-privacy-security-and-safety-faqs - Beschreibung: Pflichtlektüre zur Bewertung von manueller Prüfung und Sicherheitskosten
- Link:
-
Axios: I tested Dots and Muse: Praxisvergleich von Dots und Meta Muse durch Dritte
- Link:
axios.com/2026/10/20/battle-of-bots-openai-meta-ai-agents-test - Beschreibung: Konkrete Aufgabenleistung und Fehlerfälle
- Link:
-
APIYI: Token-Paketkontingente sind nicht direkt vergleichbar: Fünf-Schritte-Methode zum Vergleich von Abo und nutzungsbasierter Zahlung
- Link:
help.apiyi.com/token-plan-quota-subscription-vs-pay-as-you-go.html - Beschreibung: Berechnungsrahmen für die äquivalenten Kosten pro Aufgabe
- Link:
-
APIYI-Modellpreisliste: Aktuelle Preise für Modelle wie Claude
- Link:
docs.apiyi.com/models - Beschreibung: Vor dem tatsächlichen Aufruf gelten diese Angaben und die Konsole als Referenz
- Link:
Autor: APIYI-Team
Technischer Austausch: Kontaktieren Sie uns gerne über die Startseite der APIYI-Website; weitere Materialien zu Modellintegration und Abrechnung finden Sie im Dokumentationszentrum unter docs.apiyi.com