ملاحظة المؤلف: قراءة في تأثير Prompt Cache لمدة 12 ساعة من OpenAI على تكاليف GPT-6 API، مع معادلة استرداد التكلفة و5 معايير لتحديد السيناريوهات التي يوفر فيها تفعيل التخزين المؤقت المال، والسيناريوهات التي تكون فيها الفائدة محدودة.
أضافت OpenAI قدرة الاحتفاظ بالذاكرة المؤقتة لمدة 12 ساعة إلى Prompt Cache، وهي إشارة تستحق أن تعيد الفرق التي تستدعي GPT-6 API حساب تكاليفها من جديد. في السابق كانت الذاكرة المؤقتة صالحة عادةً خلال دقائق من الخمول فقط، وكثير من الطلبات منخفضة التكرار لم تكن تستفيد من الخصم إطلاقًا؛ أما الآن فقد اتسعت نافذة التخزين المؤقت، وأصبحت مجموعة كبيرة من الطلبات التي “تعود بعد بضع ساعات” لديها فرصة للوصول إلى الذاكرة المؤقتة.
هذا ليس شعارًا تسويقيًا من نوع “فعّل التخزين المؤقت وستوفر النصف تلقائيًا”. فما إذا كان التخزين المؤقت يوفر المال يعتمد على استقرار البادئة (prefix)، وطول الفاصل الزمني بين الطلبات، وحجم البادئة الواحدة، وما إذا كانت كتابة الذاكرة المؤقتة تترتب عليها تكلفة إضافية. تستخدم هذه المقالة معادلة بسيطة لاسترداد التكلفة لمساعدتك في تحديد ما إذا كان نشاطك التجاري يحتاج فعلاً إلى تفعيل التخزين المؤقت لمدة 12 ساعة.
القيمة الأساسية: فهم تغيّر آلية Prompt Cache لمدة 12 ساعة في 5 دقائق، وتعلّم استخدام 5 معايير لتحديد متى يوفر التخزين المؤقت في GPT-6 API المال فعلاً.
نظرة سريعة على أهم معلومات Prompt Cache لمدة 12 ساعة من OpenAI
نبدأ بجدول يوضح أهم معلومات هذا التحديث. بما أن الأسعار والمعلمات الرسمية تتغير باستمرار، فإن أي نسب فوترة في الجدول تعتمد على وثائق OpenAI الرسمية وصفحة الأسعار.
| البند | التفاصيل |
|---|---|
| ما الجديد | إضافة خيار الاحتفاظ بذاكرة التخزين المؤقت للموجه (Prompt Cache) لمدة 12 ساعة |
| الجهة الناشرة | OpenAI |
| النماذج المعنية | GPT-6 API وغيره من النماذج التي تدعم Prompt Caching (وفق قائمة النماذج الرسمية) |
| منطق الفوترة | تُحسب رموز الإدخال المتطابقة مع ذاكرة التخزين المؤقت بسعر وحدة أقل من سعر الإدخال العادي، ويُرجى الرجوع إلى صفحة الأسعار الرسمية لمعرفة الخصم الدقيق |
| التغيير الأساسي | تمديد مدة الاحتفاظ بذاكرة التخزين المؤقت من “الانتهاء بعد خمول بدقائق” إلى 12 ساعة كحد أقصى |
| نطاق التأثير | موجهات النظام الطويلة، وتعريفات أدوات الوكيل (Agent)، والمعرفة الثابتة في RAG، والمحادثات متعددة الأدوار، وغيرها من السيناريوهات |
كيف يعمل Prompt Cache
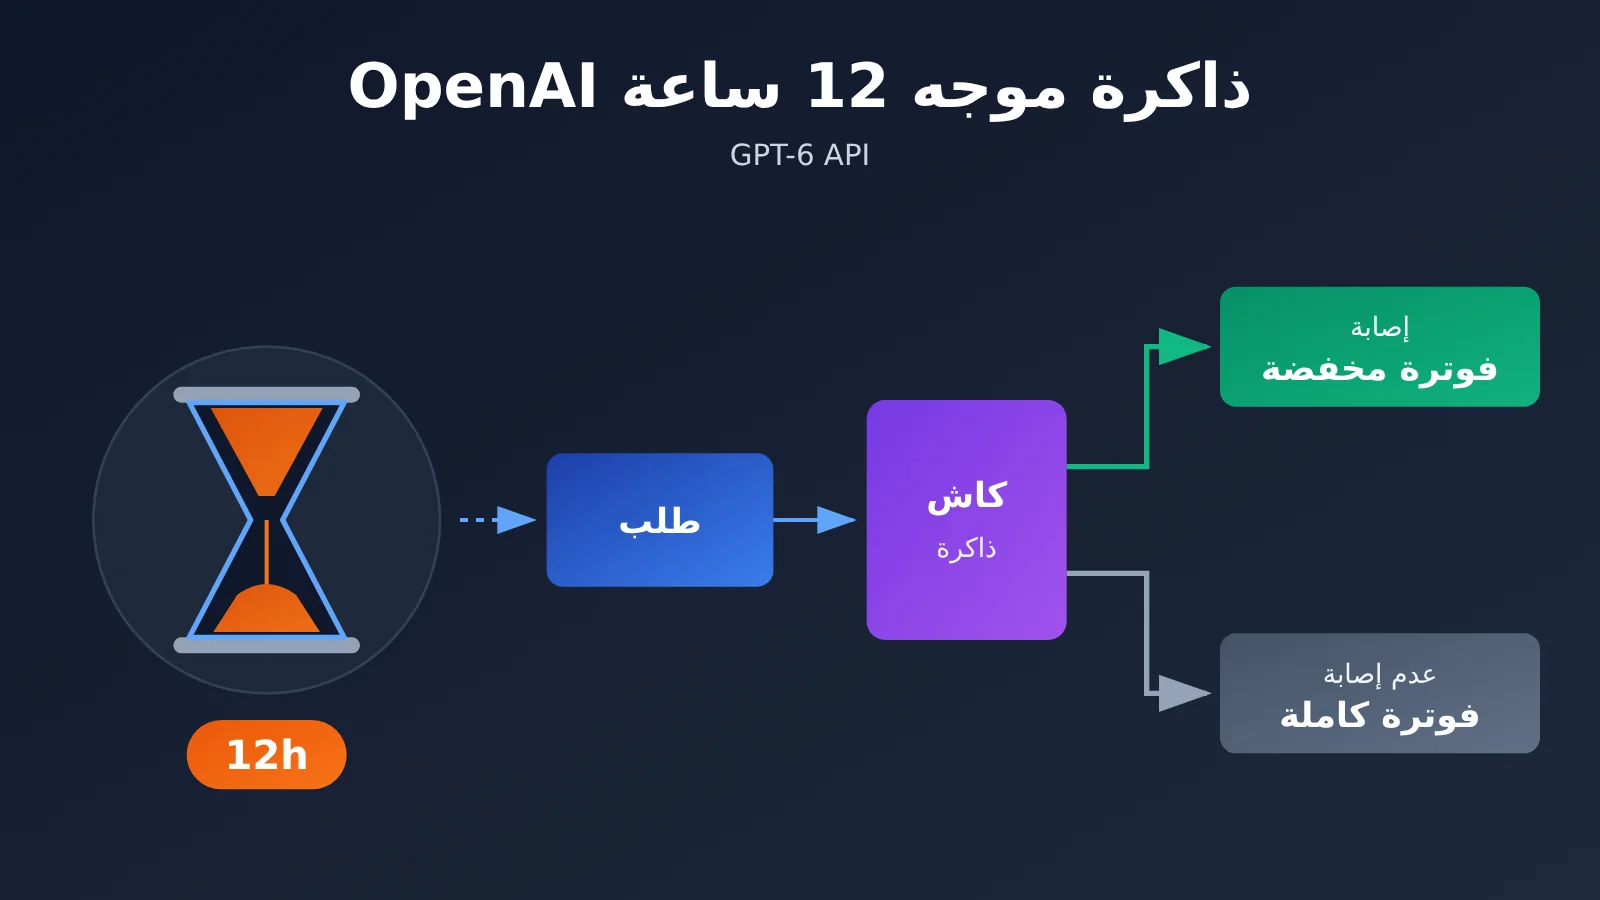
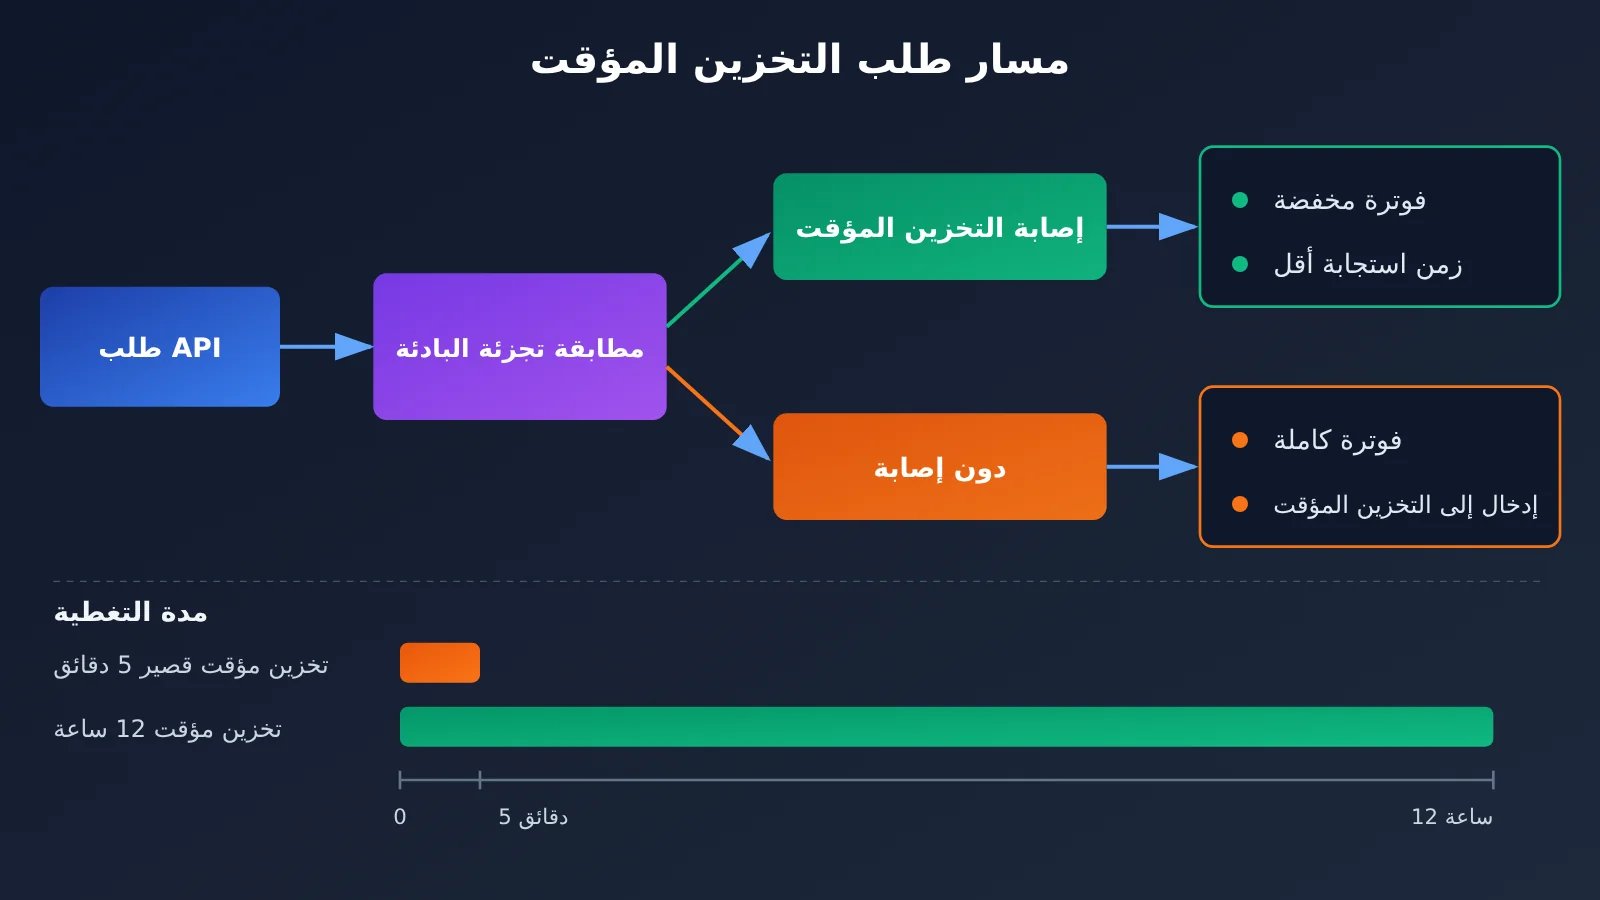
يعتمد التخزين المؤقت للموجهات من OpenAI (Prompt Caching) على آلية “مطابقة البادئة”. عندما يكون الجزء الأول من الطلب (موجه النظام، تعريفات الأدوات، المستندات الثابتة، إلخ) مطابقًا تمامًا لطلب حديث سابق، ويبلغ طوله الحد الأدنى الذي تحدده الجهة الرسمية، تُحتسب هذه الرموز (tokens) كتطابق في ذاكرة التخزين المؤقت، وتُحسب بسعر مخفّض، كما ينخفض زمن استجابة الرمز الأول بشكل ملحوظ.
من المهم الانتباه إلى أن ذاكرة التخزين المؤقت لا تتعرف إلا على الجزء المتطابق بشكل متواصل بدءًا من الرمز الأول. فإذا أُدخل طابع زمني أو معرّف مستخدم في منتصف البادئة، فلن يتطابق أي محتوى بعد ذلك. لذلك، تصميم بنية الموجه أهم من مجرد تفعيل التخزين المؤقت أو عدمه: ضع المحتوى الثابت في البداية والمحتوى الديناميكي في النهاية.
الفرق بين التخزين المؤقت لمدة 12 ساعة والتخزين المؤقت القصير
كان التخزين المؤقت القصير السابق يُمسح بعد دقائق من الخمول، ولم تكن الطلبات عالية التكرار والمتواصلة فقط هي التي تحقق تطابقًا مستقرًا. أما الاحتفاظ لمدة 12 ساعة فيوسّع “نافذة التطابق” من دقائق إلى نصف يوم، ما يغيّر مباشرة بنية التكلفة في السيناريوهات منخفضة التكرار.
| بُعد المقارنة | التخزين المؤقت القصير الافتراضي | تخزين مؤقت لمدة 12 ساعة |
|---|---|---|
| مدة الاحتفاظ | ينتهي بعد خمول بدقائق | حتى نحو 12 ساعة |
| معدل الطلبات المناسب | طلبات عالية التكرار ومتواصلة | طلبات متوسطة أو منخفضة التكرار ومتقطعة |
| السيناريوهات النموذجية المستفيدة | خدمة العملاء الفورية، والاستدعاءات المتتابعة بالجملة | عودة المستخدم إلى المحادثة بعد عدة ساعات، والمهام المجدولة خلال اليوم |
| استقرار معدل التطابق | يتأثر كثيرًا بتقلبات حركة المرور | أكثر ملاءمة لفترات انخفاض حركة المرور |
| التكلفة الإضافية | عادةً لا توجد رسوم إضافية للكتابة | يعتمد وجود رسوم إضافية على ما تنص عليه الجهة الرسمية |
متى يوفر تخزين GPT-6 API المؤقت المال فعلاً: معادلة نقطة التعادل
كثير من المقالات تكتفي بالقول إن “التخزين المؤقت يوفر المال”، لكنها لا توضح كم يوفر، ولا تحت أي شروط. في السطور التالية سنستخدم معادلة عامة لتحويل المسألة إلى أرقام، وكل ما عليك هو إدخال معاملات عملك الخاص.
اشتقاق معادلة التعادل لذاكرة الموجه (Prompt Cache)
لنضع المتغيرات التالية:
L: عدد tokens البادئة القابلة للتخزين المؤقتP: سعر الإدخال العاديd: نسبة سعر إصابة الذاكرة المؤقتة إلى السعر العادي (0 < d < 1)w: نسبة التكلفة الإضافية عند الكتابة الأولى في الذاكرة المؤقتة (عندما لا توجد رسوم إضافية w = 0)N: عدد مرات استدعاء البادئة نفسها خلال فترة صلاحية الذاكرة المؤقتة
بدون استخدام التخزين المؤقت، تكون التكلفة الإجمالية للبادئة N × L × P. ومع استخدامه، تُحسب المرة الأولى بسعر الكتابة، وتُحسب المرات التالية بسعر الإصابة، فتكون التكلفة الإجمالية L × P × (1 + w) + (N − 1) × L × P × d.
وبطرح التكلفتين نحصل على شرط تعادل بسيط جدًا: N > 1 + w / (1 − d). وتوضح هذه المعادلة أمرين: إذا لم تكن هناك رسوم إضافية على الكتابة (w = 0)، فبمجرد إعادة استخدام البادئة نفسها مرة واحدة خلال فترة الصلاحية يبدأ التوفير؛ أما إذا كانت هناك رسوم إضافية على الكتابة، فيجب أن يتجاوز عدد مرات إعادة الاستخدام حدًا معينًا للوصول إلى نقطة التعادل، وكلما كان الخصم أكبر (أي d أصغر) كان الوصول إلى التعادل أسرع.
حساب نقطة التعادل في سيناريوهات مختلفة
فيما يلي حساب توضيحي باستخدام “معاملات مفترضة”، والغرض منه فقط بيان طريقة استخدام المعادلة، وهو لا يمثل أسعار OpenAI الفعلية. سنفترض أن سعر إصابة الذاكرة المؤقتة يمثل نسبة معينة من السعر العادي، ونراقب عدد مرات الاستدعاء اللازمة للتعادل مع وجود رسوم كتابة إضافية وبدونها.
| السيناريو المفترض | رسوم الكتابة الإضافية w | خصم الإصابة d | عدد الاستدعاءات اللازم للتعادل N | النتيجة |
|---|---|---|---|---|
| بدون رسوم كتابة إضافية | 0 | أي قيمة | N > 1 | إعادة الاستخدام مرة واحدة تكفي للتوفير |
| رسوم كتابة إضافية صغيرة | منخفضة | خصم كبير | نحو مرتين | مجدٍ في الغالبية العظمى من السيناريوهات |
| رسوم كتابة إضافية مرتفعة | مرتفعة | خصم صغير | أكثر من 3 مرات | مجدٍ فقط في سيناريوهات إعادة الاستخدام الكثيف |
يتضح من الحساب أن القيمة الحقيقية للتخزين المؤقت لمدة 12 ساعة لا تكمن في “الخصم نفسه”، بل في جعل N أكبر. فالطلب الذي كان يصل مرة كل بضع ساعات يجعل N قريبًا من 1 في ظل التخزين المؤقت القصير، فلا مجال للحديث عن التوفير أصلًا؛ أما عندما تمتد المدة إلى 12 ساعة، تُعاد البادئة نفسها استخدامها عدة مرات في اليوم، وعندها فقط يظهر أثر التوفير الحقيقي.
🚀 ابدأ سريعًا: إذا أردت التحقق من معادلة التعادل على حركة مرور حقيقية، فأنصحك باستخدام APIYI عبر apiyi.com لمقارنة إصابة الذاكرة المؤقتة بين نماذج مختلفة باستخدام مفتاح API نفسه. تعتمد المنصة واجهة متوافقة مع OpenAI، ويمكن للمستخدمين الجدد الحصول على حصة تجريبية مجانية.
كيفية التحقق من إصابة ذاكرة التخزين المؤقت للموجه (Prompt Cache) في GPT-6 API
أكثر طريقة موثوقة لمعرفة ما إذا كانت ذاكرة التخزين المؤقت توفّر لك المال فعلاً هي قراءة حقل usage الموجود في الاستجابة. إذ تُرجع الواجهات المتوافقة مع OpenAI عدد الرموز (tokens) التي أصابت ذاكرة التخزين المؤقت في هذه المرة داخل usage.prompt_tokens_details.cached_tokens، ويمكنك الاعتماد على ذلك لحساب معدل الإصابة الحقيقي.
مثال بسيط جدًا
يُرسل الكود التالي طلبين متتاليين بنفس البادئة، راقب ما إذا كانت قيمة cached_tokens في الطلب الثاني أكبر من 0:
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # واجهة APIYI الموحدة، متوافقة مع OpenAI
)

SYSTEM_PROMPT = "أنت مستشار تقني خبير……(هنا ضع موجهًا ثابتًا طويلاً يتجاوز الحد الأدنى للتخزين المؤقت)"

for i in range(2):
    resp = client.chat.completions.create(
        model="gpt-6",  # اعتمادًا على الاسم الفعلي في قائمة النماذج بالمنصة
        messages=[
            {"role": "system", "content": SYSTEM_PROMPT},
            {"role": "user", "content": f"السؤال رقم {i+1}: كيف يمكن تحسين تكلفة الواجهة؟"}
        ]
    )
    cached = resp.usage.prompt_tokens_details.cached_tokens
    print(f"الطلب رقم {i+1}، عدد tokens المخزنة مؤقتًا التي تمت إصابتها: {cached}")
عرض الكود الكامل للتنفيذ (مع إحصاءات معدل الإصابة ومفتاح توجيه التخزين المؤقت)
import openai
from dataclasses import dataclass, field

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

@dataclass
class CacheStats:
    total_prompt: int = 0
    total_cached: int = 0
    records: list = field(default_factory=list)

    def add(self, prompt_tokens: int, cached_tokens: int):
        self.total_prompt += prompt_tokens
        self.total_cached += cached_tokens
        self.records.append((prompt_tokens, cached_tokens))

    @property
    def hit_rate(self) -> float:
        if self.total_prompt == 0:
            return 0.0
        return self.total_cached / self.total_prompt


def build_messages(static_prefix: str, user_input: str) -> list:
    """ضع المحتوى الثابت في المقدمة والمحتوى الديناميكي في النهاية، لضمان استقرار البادئة"""
    return [
        {"role": "system", "content": static_prefix},
        {"role": "user", "content": user_input},
    ]


def ask(static_prefix: str, user_input: str, cache_key: str, stats: CacheStats,
        model: str = "gpt-6") -> str:
    resp = client.chat.completions.create(
        model=model,
        messages=build_messages(static_prefix, user_input),
        # يساعد prompt_cache_key في توجيه الطلبات ذات البادئة نفسها إلى التخزين المؤقت نفسه
        # لتفعيل الاحتفاظ لمدة 12 ساعة، أضف المعامل المقابل وفق وثائق OpenAI الرسمية
        extra_body={"prompt_cache_key": cache_key},
    )
    usage = resp.usage
    cached = getattr(usage.prompt_tokens_details, "cached_tokens", 0) or 0
    stats.add(usage.prompt_tokens, cached)
    return resp.choices[0].message.content


if __name__ == "__main__":
    stats = CacheStats()
    prefix = open("system_prompt.txt", encoding="utf-8").read()
    questions = ["كيف نصمم موجهًا صديقًا للتخزين المؤقت؟", "أين يجب وضع تعريفات الأدوات؟", "كيف نحسب معدل الإصابة؟"]

    for q in questions:
        ask(prefix, q, cache_key="kb-v1", stats=stats)

    print(f"معدل الإصابة الإجمالي للتخزين المؤقت: {stats.hit_rate:.1%}")
    for idx, (p, c) in enumerate(stats.records, 1):
        print(f"الطلب {idx}: prompt={p}, cached={c}")
توصية: شغّل أولاً على نسبة صغيرة من حركة المرور لمدة يوم واحد، ثم احسب معدل الإصابة الإجمالي وتوزيع الفواصل الزمنية بين الطلبات، وبعد ذلك قرر ما إذا كنت ستُفعّل التخزين المؤقت لمدة 12 ساعة في بيئة الإنتاج بالكامل. يمكنك الحصول على رصيد اختبار عبر APIYI apiyi.com لإنجاز هذا النوع من التحقق، دون الحاجة إلى فتح عدة حسابات رسمية منفصلة.
خمسة معايير لتقرير جدوى ذاكرة التخزين المؤقت للموجهات (Prompt Cache) لمدة 12 ساعة من ناحية التوفير
عند إنزال معادلة استرداد التكلفة إلى أرض الواقع في أعمالك، يمكن تلخيصها في المعايير الخمسة التالية. وكلما زاد عدد الشروط المتحققة، كان العائد من تفعيل الذاكرة المؤقتة لمدة 12 ساعة أوضح.
- البادئة طويلة بما يكفي: يجب أن يبلغ الجزء الثابت القابل للتخزين الحد الأدنى الرسمي، وكلما زاد طوله زاد إجمالي مبلغ الخصم. أما الموجهات القصيرة التي لا تتجاوز بضع مئات من الرموز (tokens)، فحتى لو تحققت الإصابة فيها، يبقى المبلغ الذي توفره محدودًا جدًا.
- البادئة مستقرة بما يكفي: موجه النظام، وتعريفات الأدوات، وترتيب المخطط (Schema) تبقى ثابتة على مدار اليوم. والتعديل المتكرر على الموجهات يؤدي إلى فشل الذاكرة المؤقتة مرارًا وتكرارًا.
- فاصل الطلبات يقع داخل نطاق 12 ساعة: إذا كانت البادئة نفسها تُستدعى مرة كل بضع عشرات من الدقائق أو كل بضع ساعات، فهذه بالتحديد أكبر منطقة مكسب إضافي تقدمها الذاكرة المؤقتة لمدة 12 ساعة مقارنة بالذاكرة القصيرة.
- عدد مرات إعادة الاستخدام يتجاوز حد استرداد التكلفة: احسب بالمعادلة
N > 1 + w / (1 − d)وتأكد من أن عدد مرات إعادة الاستخدام اليومية أعلى من الحد بشكل مستقر. - تكلفة الإدخال تشكل نسبة عالية: إذا كانت فاتورتك ناتجة بالأساس عن رموز الإخراج، فإن الذاكرة المؤقتة تحسّن جانب الإدخال فقط، وبالتالي ستُخفَّف نسبة الانخفاض الكلي.
مدى ملاءمة الذاكرة المؤقتة لمدة 12 ساعة لسيناريوهات الأعمال المختلفة
| سيناريو العمل | خصائص فاصل الطلبات | تأثير الذاكرة القصيرة | القيمة الإضافية لذاكرة 12 ساعة |
|---|---|---|---|
| روبوت خدمة العملاء الفوري | تردد عالٍ ومتواصل | جيد بالفعل | متوسط، يكمّل أساسًا فترات انخفاض الحركة |
| RAG لقاعدة المعرفة المؤسسية | تردد متوسط، بادئة مستندات ثابتة | تقلبات كبيرة | واضح، إعادة استخدام البادئة الثابتة عدة مرات يوميًا |
| جلسة وكيل برمجي | المستخدم يعود إلى الجلسة على فترات متقطعة | غالبًا ما تفشل | مرتفع جدًا، سياق طويل يُعاد استخدامه عبر ساعات |
| معالجة دفعية مجدولة يوميًا | دفعة كل بضع ساعات | غير فعالة أساسًا | مرتفع جدًا، القالب نفسه يُستخدم في عدة دفعات يوميًا |
| تحليل مستند طويل لمرة واحدة | استدعاء واحد فقط | غير فعالة | لا يكاد يُذكر، فالقيمة N = 1 لا تسترد التكلفة |
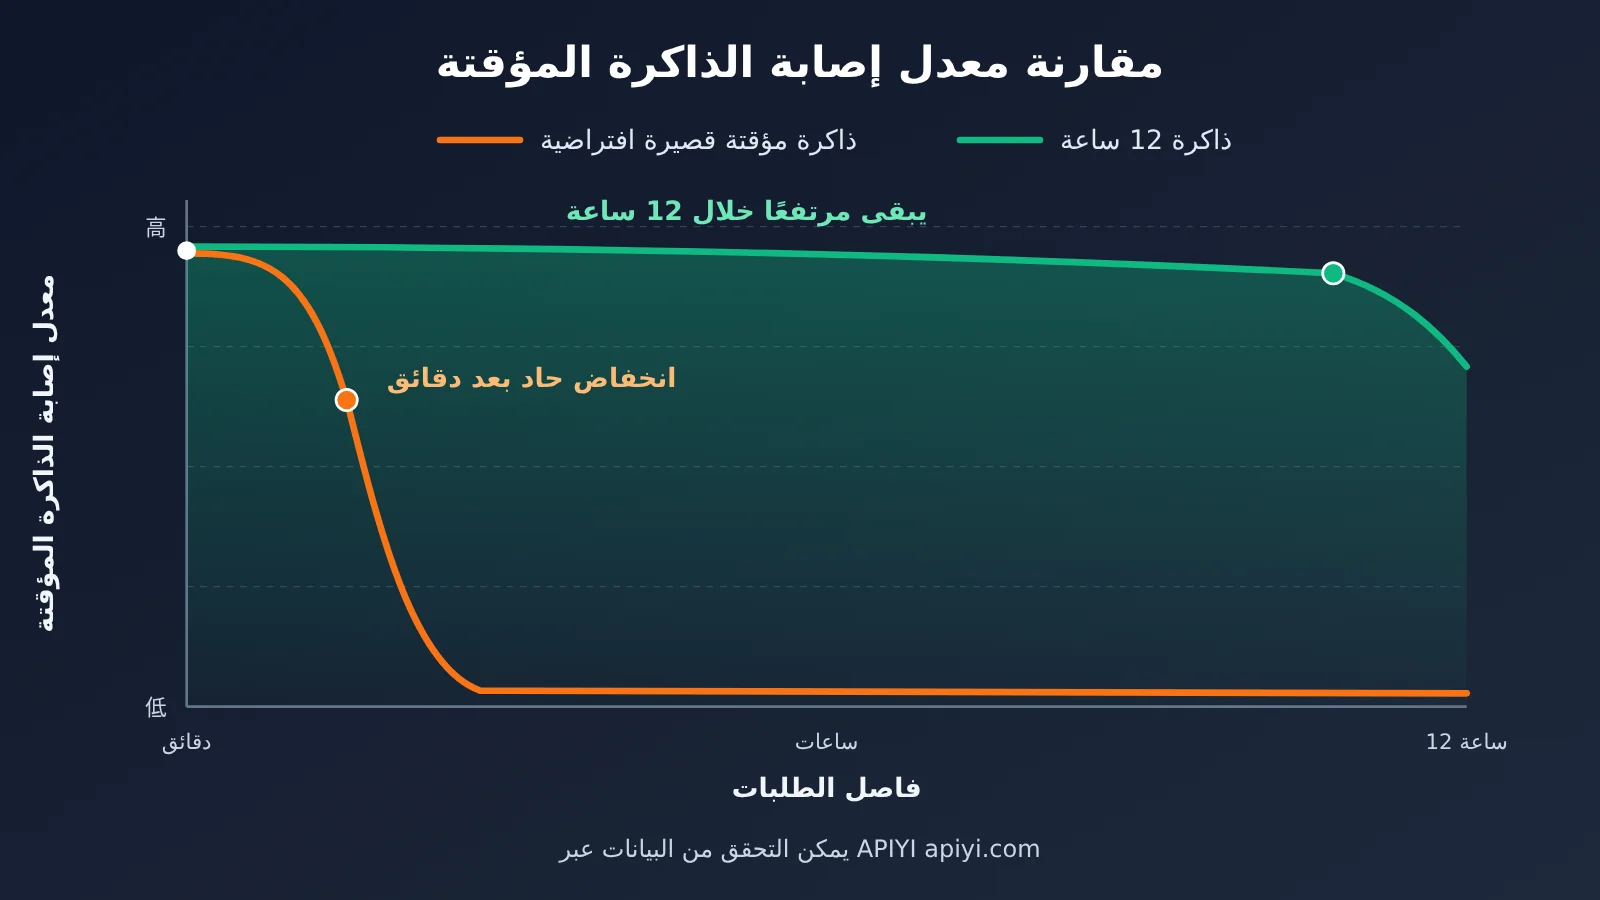
ملاحظة حول المقارنة: يعرض الرسم أعلاه الفرق في اتجاه معدل الإصابة بين استراتيجيتي التخزين المؤقت عند فواصل طلبات مختلفة. أما معدل الإصابة الفعلي فيعتمد على استقرار البادئة لديك وتوزيع الحركة، لذا يُستحسن إجراء المقارنة باستخدام سجلات طلباتك الحقيقية.
تحليل تأثير التخزين المؤقت للموجهات لمدة 12 ساعة في OpenAI
التأثير على المطورين
- هندسة الموجهات يجب أن ترتقي إلى «هندسة الكاش»: ينبغي تنظيم موجه النظام وتعريفات الأدوات والمعرفة الثابتة في كتل بادئة مستقرة، مع إدارة صريحة للإصدارات، حتى لا يؤدي تعديل بسيط إلى إبطال الكاش بالكامل.
- تقييم التكلفة ينتقل من «سعر الوحدة» إلى «سعر الوحدة الفعلي»: مع نفس GPT-6 API، قد يكون الفارق واضحًا في التكلفة الفعلية لكل ألف طلب بين فريق ذي نسبة إصابة عالية للكاش وفريق نسبة إصابته منخفضة، ولذلك ينبغي أن تصبح مراقبة cached_tokens مؤشرًا روتينيًا.
- وكلاء السياق الطويل أصبحوا أكثر جدوى: سياق مساعدي البرمجة والوكلاء البحثيين طويل جدًا في الغالب، وفي السابق كان المستخدم إذا ابتعد قليلًا ثم عاد يُعاد الحساب بالسعر الكامل، أما الآن فإن إعادة الاستخدام عبر الساعات تحسّن جدوى الجلسات الطويلة بشكل ملحوظ.
- تحسّن متزامن في زمن الاستجابة: الطلبات التي تصيب الكاش تحصل على زمن استجابة أقل لأول token، وهو مكسب إضافي للمنتجات الحساسة لتجربة التفاعل.
التأثير على القطاع
- الكاش أصبح بُعدًا تنافسيًا في تسعير النماذج: كبار المزوّدين يقدمون جميعًا حلولًا خاصة بهم لتخزين الموجهات مؤقتًا، وأصبحت مدة الاحتفاظ وحجم الخصم ومسألة فرض رسوم على الكتابة مراجع مهمة للمطورين عند اختيار النموذج.
- تزداد قيمة المقارنة بين النماذج على المنصات المجمّعة: قواعد الكاش تختلف كثيرًا بين المزوّدين، والمقارنة الأفقية للفواتير الفعلية عبر واجهة موحّدة أكثر دلالة من الاكتفاء بالنظر إلى الأسعار الرسمية.
- قد تُعاد مراجعة بنية RAG: عندما يمكن إعادة استخدام بادئة مستند طويل بتكلفة منخفضة لنصف يوم، فقد تتحول بعض حالات قواعد المعرفة الصغيرة والمتوسطة من «التقطيع والاسترجاع» إلى «إدخال المقطع كاملًا في السياق + الكاش».
مرجع لاختيار حل التخزين المؤقت بين النماذج
| اتجاه النموذج | خصائص الكاش (وفق الوثائق الرسمية لكل مزوّد) | حالات الاستخدام | المنصات المتاحة |
|---|---|---|---|
| GPT-6 API | كاش بادئة تلقائي، مع خيار احتفاظ جديد لمدة 12 ساعة | موجهات نظام طويلة، جلسات الوكلاء | APIYI apiyi.com، OpenAI الرسمي |
| سلسلة Claude | يتطلب تحديد نقاط توقف الكاش صراحةً، ويدعم مدد احتفاظ مختلفة | الحالات التي تحتاج تحكمًا دقيقًا في موضع الكاش | APIYI، Anthropic الرسمي |
| سلسلة Gemini | يدعم التخزين المؤقت الضمني والصريح للسياق | مستندات فائقة الطول، سياق متعدد الوسائط | APIYI، Google الرسمي |
💡 توصية للاختيار: تختلف قواعد الكاش كثيرًا بين النماذج، لذا يُنصح باختبار نفس موجه العمل على عدة نماذج وقياس نسبة الإصابة والفواتير فعليًا، ثم اتخاذ القرار مع مراعاة جودة النتائج.
الأسئلة الشائعة
س1: ما هو OpenAI Prompt Cache لمدة 12 ساعة؟
هو خيار إطالة مدة الاحتفاظ ضمن آلية OpenAI Prompt Caching. الطلبات التي تشترك في البادئة نفسها تُتاح لها فرصة إصابة الذاكرة المؤقتة لمدة تصل إلى نحو 12 ساعة، ويُحتسب جزء الـ input tokens الذي أصاب الذاكرة بسعر مخفّض، مع تقليل زمن الوصول إلى أول token.
س2: ما الفرق بين ذاكرة الـ 12 ساعة والذاكرة القصيرة الافتراضية؟
الذاكرة القصيرة الافتراضية تنتهي صلاحيتها بعد دقائق من الخمول، وهي مناسبة فقط للطلبات المتكررة عالية التردد. أما ذاكرة الـ 12 ساعة فتغطي الطلبات المتوسطة والمنخفضة التردد والمتقطعة. في السيناريوهات عالية التردد مثل خدمة العملاء الفورية، الفرق بينهما ضئيل؛ أما في السيناريوهات التي تفصلها ساعات مثل جلسات الـ Agent والمعالجة الدفعية المجدولة، فالزيادة التي تحققها ذاكرة الـ 12 ساعة ملموسة.
س3: هل تفعيل ذاكرة الـ 12 ساعة يوفر المال دائمًا؟
لا بالضرورة. إذا لم تكن هناك رسوم إضافية على كتابة الذاكرة، يبدأ التوفير بمجرد إعادة استخدام البادئة نفسها مرة واحدة خلال مدة الصلاحية؛ أما إذا وُجدت رسوم إضافية، فيجب أن يتجاوز عدد مرات إعادة الاستخدام `1 + w / (1 − d)` لتغطية التكلفة. في سيناريوهات الاستدعاء لمرة واحدة، أو البادئات المتغيرة باستمرار، أو البادئات القصيرة جدًا، تكون الفائدة محدودة للغاية.
س4: كيف أرفع نسبة إصابة الذاكرة المؤقتة في GPT-6 API؟
المبدأ الأساسي هو “الثابت في المقدمة والمتغيّر في المؤخرة”:
– ضع موجه النظام وتعريفات الأدوات والمستندات الثابتة في مقدمة الرسائل، وحافظ على ترتيبها دون تغيير
– ضع المحتوى المتغيّر مثل الطوابع الزمنية ومعرّفات المستخدمين ونتائج الاسترجاع في النهاية
– استخدم مفتاح توجيه تخزين مؤقت ثابت لكل نوع من الطلبات، لرفع احتمال التوجيه إلى الذاكرة المؤقّتة نفسها
– اجمع تحديثات الموجه وأطلقها دفعة واحدة، وتجنّب التعديلات الصغيرة المتكررة خلال اليوم
س5: كيف أختبر تأثير ذاكرة الـ 12 ساعة بسرعة عبر API؟
نوصي باستخدام منصة تجميع API تدعم نماذج متعددة للاختبار:
1. زُر APIYI على apiyi.com وسجّل حسابًا
2. احصل على مفتاح API وحصة اختبار مجانية
3. استخدم أمثلة الشيفرة في هذا المقال (استبدل base_url بـ `https://api.apiyi.com/v1`)، واقرأ `cached_tokens` لحساب نسبة الإصابة
تعتمد APIYI واجهة متوافقة مع OpenAI، فيكفي مفتاح واحد لمقارنة أداء الذاكرة المؤقتة لدى GPT وClaude وGemini.
س6: ما القيود المعروفة لـ Prompt Cache؟
الذاكرة المؤقتة تعمل فقط على البادئات المتتالية التي تبلغ الحد الأدنى للطول، وهي تحسّن تكلفة الجانب الداخلي فقط، ولا تُخفّض الـ output tokens. الذاكرة المؤقتة آلية “تُقدّم أفضل جهد ممكن”، وقد تحدث حالات عدم إصابة عند التزامن العالي أو تغيّر توجيه الحركة، لذا لا ينبغي اعتبار نسبة الإصابة ضمانًا بنسبة 100%. للحصول على طريقة الفوترة الدقيقة لمدة الـ 12 ساعة والنماذج المدعومة، يُرجى الرجوع إلى وثائق OpenAI الرسمية.
أبرز النقاط في التخزين المؤقت للموجه لمدة 12 ساعة
- الآلية الأساسية: تعتمد على المطابقة التامة للبادئة، ويُحتسب جزء رموز الإدخال المطابق بسعر مخفّض.
- التغيير الجوهري: امتدت مدة الاحتفاظ من دقائق إلى نحو 12 ساعة، لتغطي الطلبات منخفضة التكرار.
- صيغة التعادل: لا يبدأ التوفير إلا عندما يكون عدد مرات إعادة الاستخدام N > 1 + w / (1 − d).
- أكثر السيناريوهات استفادة: الجلسات الطويلة للوكيل، وRAG لقواعد المعرفة، والمعالجة المجمعة المجدولة خلال اليوم.
- سيناريوهات محدودة الفائدة: الاستدعاء لمرة واحدة، والبادئات القصيرة، والموجهات التي تتغير بوتيرة عالية.
- مفتاح التطبيق العملي: ضع المحتوى الثابت في المقدمة، وراقب معدل إصابة الذاكرة المؤقتة باستمرار عبر cached_tokens.
- طريقة التحقق: اختبر بحجم صغير عبر APIYI apiyi.com باستخدام حركة مرور حقيقية، ثم فعّل على النطاق الكامل.
الخلاصة
الأثر الأساسي للتخزين المؤقت للموجه لمدة 12 ساعة من OpenAI على تكلفة GPT-6 API:
- التوفير يعتمد على عدد مرات إعادة الاستخدام: تتيح نافذة الـ12 ساعة للطلبات متوسطة ومنخفضة التكرار إعادة استخدام البادئة نفسها عدة مرات، ورفع N من 1 هو القيمة الإضافية الحقيقية.
- تكلفة الكتابة تحدد عتبة التعادل: عندما لا توجد رسوم إضافية على الكتابة يكون الربح شبه مؤكد، وعند وجودها يجب حساب العتبة بصيغة التعادل.
- بنية الموجه أهم من مفتاح التشغيل: وضع المحتوى الثابت في المقدمة، وإدارة الإصدارات، ومراقبة معدل الإصابة، هي ما يحوّل خصم التخزين المؤقت إلى توفير فعلي في الفاتورة.
نوصي بالبدء من السيناريوهات عالية العائد مثل الموجهات النظامية الطويلة وجلسات الوكيل، وتشغيل حركة مرور حقيقية ليوم واحد لمعرفة معدل الإصابة، ثم تحديد نطاق التوسع الكامل. ولتسريع المقارنة بين تأثير التخزين المؤقت عبر نماذج متعددة، يُنصح باستخدام APIYI apiyi.com؛ فهي توفر حصة اختبار مجانية وواجهة موحدة متوافقة مع OpenAI.
📚 المراجع
- دليل OpenAI الرسمي لتخزين الموجهات المؤقت (Prompt Caching): آلية التخزين المؤقت، والحد الأدنى، وشرح حقل usage
- الرابط:
platform.openai.com/docs/guides/prompt-caching -
الوصف: المصدر الموثوق لفهم قواعد إصابة ذاكرة التخزين المؤقت وأحدث معامل لمدة الاحتفاظ
-
صفحة أسعار OpenAI API: سعر الوحدة للإدخال العادي والإدخال المخزّن مؤقتًا والإخراج لكل نموذج
- الرابط:
openai.com/api/pricing -
الوصف: عند التعويض في معادلة استرداد التكلفة، اعتمد على الأسعار اللحظية في هذه الصفحة
-
مرجع OpenAI API: شرح معاملات واجهتي Chat Completions و Responses
- الرابط:
platform.openai.com/docs/api-reference - الوصف: للاطلاع على طريقة استخدام المعاملات المتعلقة بالتخزين المؤقت مثل prompt_cache_key
المؤلف: فريق APIYI التقني
التواصل التقني: يسعدنا تواصلكم معنا عبر الصفحة الرئيسية لموقع APIYI للحصول على المزيد من حلول ربط النماذج وتحسين التكلفة