ملاحظة المؤلف: يقدّم هذا المقال سياق Gemini 4 Neon ومستويات التفكير الأربعة والأسعار، ويشرح كيفية إعداد المدخلين الأصلي والمتوافق في APIYI، ويستخدم طلبًا أدنى واحدًا لتحديد أخطاء الاتصال الشائعة.
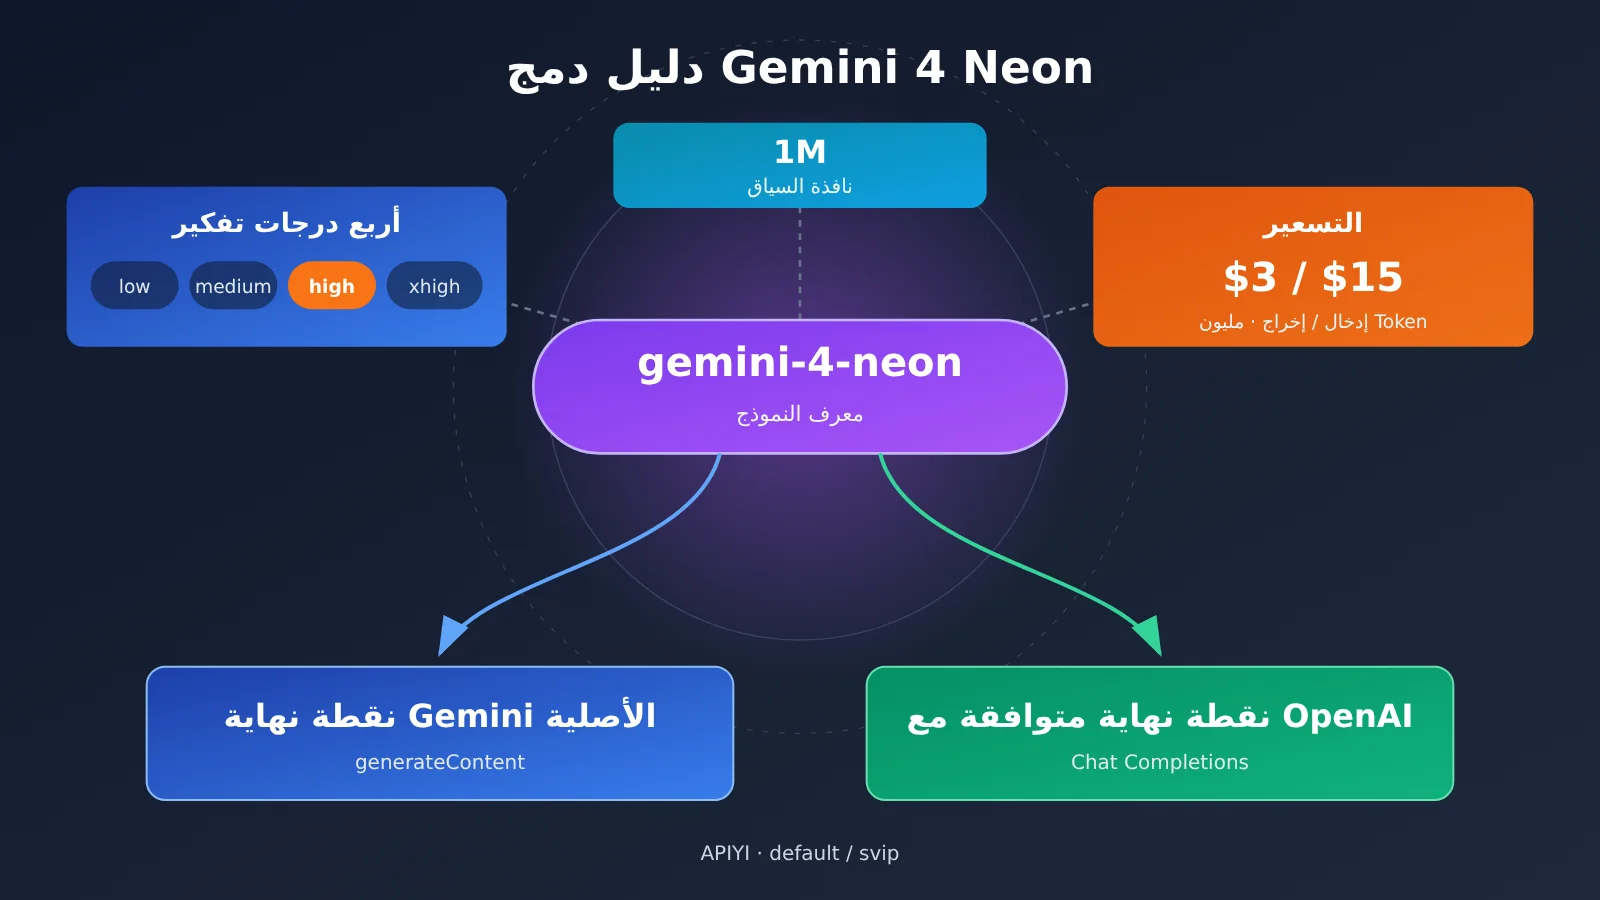
باختصار: أطلقت Google نموذج Gemini 4 Neon في 18 نوفمبر 2026، وأصدرته APIYI في 20 نوفمبر ضمن مجموعتَي default/svip، ومعرّف النموذج هو gemini-4-neon، والسعر المعلن 3 دولارات لكل مليون توكن إدخال، و15 دولارًا للإخراج، و0.15 دولار لقراءة التخزين المؤقت.إذا كنت تحتاج إلى التحكم في مستويات التفكير الأصلية، فالأفضل الاتصال بنقطة نهاية Gemini الأصلية؛ أما إذا كنت تريد فقط تبديل النموذج في عميل OpenAI الحالي، فنقطة النهاية المتوافقة أسهل. غير أن المسارين ينبغي أن يبدأ كلٌّ منهما بتشغيل أقصر طلب بنجاح، ثم تفعيل البث واستدعاء الأدوات ومستويات التفكير الأعلى بندًا بندًا.
هذا ليس خبرًا يعيد صياغة بيان إطلاق. المواصفات والأسعار ونتائج الاختبارات ومسارات التشخيص الواردة أدناه تُذكر مصادرها وشروط تطبيقها كلٌّ على حدة، وأمثلة الشفرة مبنية وفق الوثائق الرسمية. وتذكر ملاحظة إطلاق APIYI أنه لم يُجرِ قبل الإطلاق سوى التحقق من واجهة التسعير، دون أي استدعاء فعلي، لذلك لن يصف هذا المقال المدخلين المزدوجين أو استدعاء الأدوات بأنهما «تم اختبارهما فعليًا بنجاح».
القيمة الأساسية: بعد قراءة هذا المقال، ستتمكن من تأكيد مواصفات Neon وأساس الفوترة، وكتابة طلبين أدنيين أحدهما أصلي والآخر متوافق، واختيار مستوى التفكير بناءً على نتائج الاختبار، وتحديد المشكلة بسرعة انطلاقًا من أعراض الخطأ.
مصطلحات يجب فهمها قبل استخدام Gemini 4 Neon
هذه المفاهيم ستتكرر لاحقًا في هذا المقال. توحيد المصطلحات أولًا يجعل تشخيص المشكلات أقل عرضة للالتباس.
- معرّف النموذج: السلسلة الكاملة التي تحدد النموذج في الطلب، وهي في هذا المقال
gemini-4-neon. يجب نسخ حالة الأحرف والشرطات كما هي تمامًا، دون أي اختصار من عندك. - عنوان URL الأساسي (Base URL): العنوان الجذري الذي يبني عليه العميل مسار الطلب. يعتمد وجود بادئة إصدار مثل
/v1على الـ SDK المستخدم، والإعداد الخاطئ هو سبب شائع لخطأ 404. - نقطة نهاية Gemini الأصلية: تستقبل بروتوكول
generateContent، وهي مناسبة للحالات التي تحتاج إلى استخدام معاملات التفكير الأصلية. - نقطة نهاية متوافقة مع OpenAI: تستخدم صيغة Chat Completions، ويمكن لعملاء OpenAI الحاليين إعادة استخدام بنية الرسائل الأساسية مباشرة.
- مستوى التفكير: قيمة تعدادية تحدد قوة استدلال النموذج. يدعم Neon الأصلي المستويات
lowوmediumوhighوxhigh، وقد أشارت APIYI عند الإطلاق إلى أن المستوى الافتراضي هوhigh. - توقيع التفكير
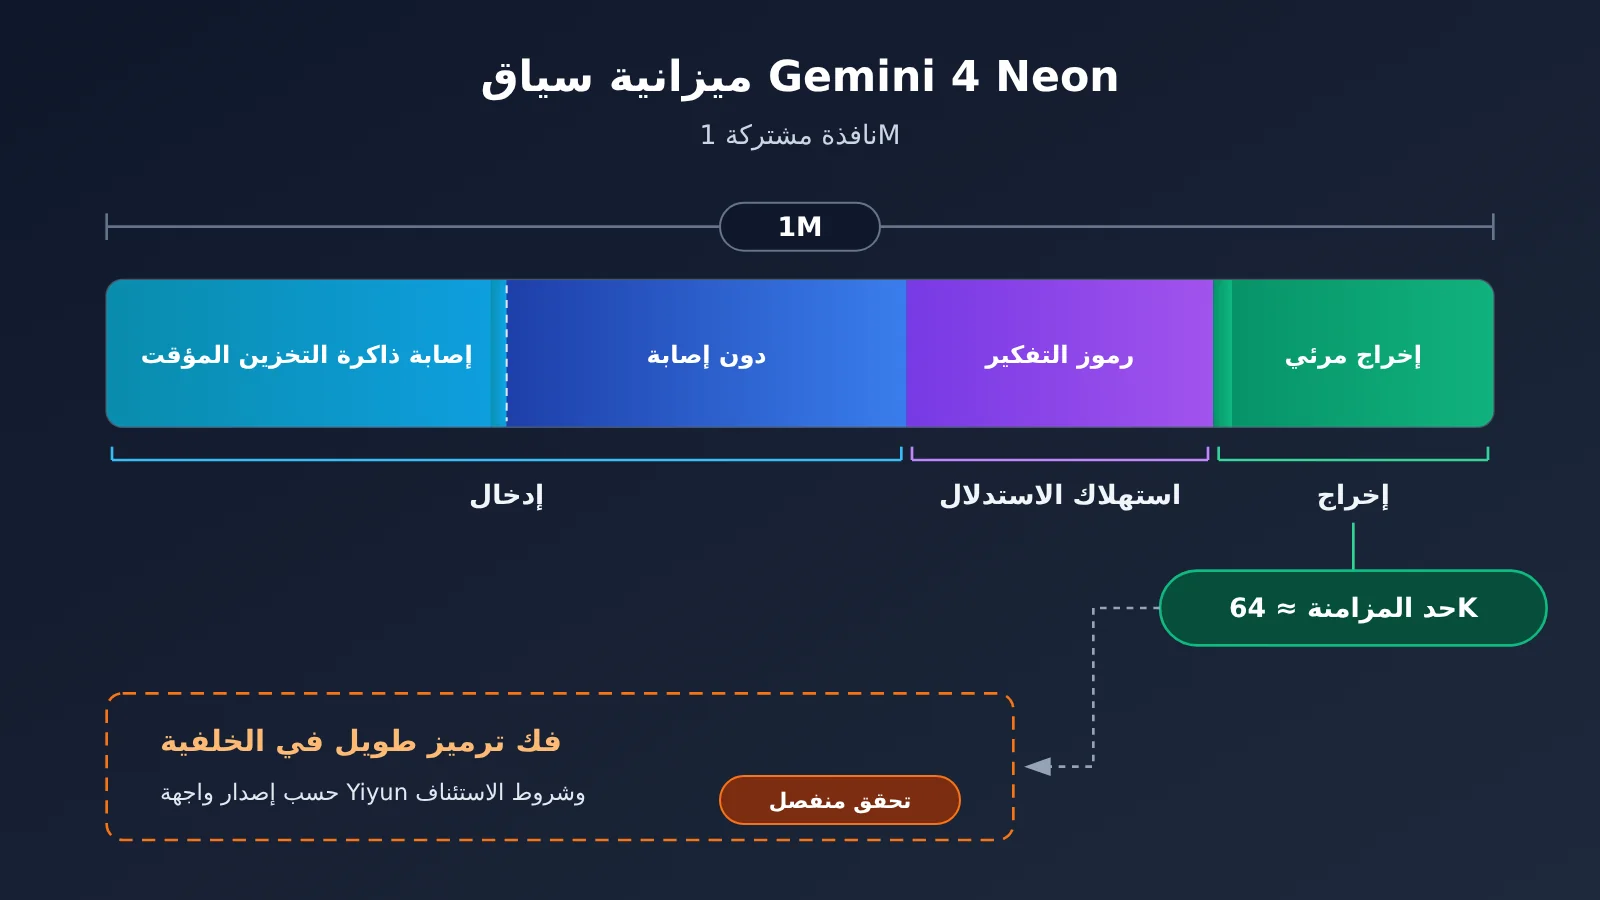
thoughtSignature: علامة سياق يعيدها النموذج. يجب الاحتفاظ بها وإعادتها وفق البروتوكول الأصلي عند استدعاء الأدوات عبر عدة جولات. - نافذة السياق: الميزانية الكلية المشتركة بين الإدخال والتفكير والإخراج. أما حجم الإخراج في توليد متزامن واحد، فيجب التحقق من حده الأعلى بشكل منفصل.
- سعر قراءة الذاكرة المؤقتة: سعر الفوترة المطبق عند إعادة استخدام مدخلات موجودة ومؤهلة، وهو أقل بكثير من سعر الإدخال القياسي.
Gemini 4 Neon: النقاط الأساسية — المعاملات والتسعير والمجموعات
وفقًا لإعلان إطلاق APIYI، يُعدّ Neon الفئة الوسطى في سلسلة Gemini 4، ويقع بين Carbon (المخصّصة لأصعب المهام) وHydrogen (المخصّصة للتنفيذ اليومي). أطلقت Google النموذج في 18 نوفمبر وأصبح متاحًا للعموم (GA) في اليوم نفسه، ثم أضافته APIYI في 20 نوفمبر.
| البند | المحتوى | المصدر والشروط |
|---|---|---|
| معرّف النموذج | gemini-4-neon |
سجل نماذج APIYI (أُنشئ في 2026-11-20) |
| المجموعات المتاحة | default، svip |
إعلان إطلاق APIYI (2026-11-20) |
| نقاط النهاية | Gemini الأصلي + متوافق مع OpenAI | إعلان إطلاق APIYI؛ لم يُختبر فعليًا قبل الإطلاق |
| نافذة السياق | 1M، مشتركة بين الإدخال والتفكير والإخراج | إعلان Google وArtificial Analysis يذكران 1M في كلٍّ منهما |
| الحد الأقصى للتوليد المتزامن | نحو 64K Token | وثائق إطلاق APIYI |
| مستويات التفكير | low/medium/high/xhigh، الافتراضي high | إعلان إطلاق APIYI |
| السعر المعلن (لكل مليون Token) | الإدخال $3، الإخراج $15، قراءة الذاكرة المؤقتة $0.15 | سجل APIYI؛ ويذكر الإعلان تطابقه بندًا ببند مع الموقع الرسمي، دون تاريخ انتهاء |
علاقة سياق Gemini 4 Neon بالحد الأقصى للإخراج
كثيرًا ما يُفهم سياق 1M خطأً على أنه «قادر على إخراج 1M دفعة واحدة». في الواقع، هذا الـ1M نافذة مشتركة بين الإدخال والتفكير والإخراج. وفق وثائق إطلاق APIYI، يبلغ الحد الأقصى للتوليد في الاستدعاء المتزامن نحو 64K توكن، أي أن الإدخال الطويل لا يمثل مشكلة، لكن لا تتوقع من طلب متزامن واحد أن يتجاوز إخراجه هذا الحجم.
تذكر وثائق Google Cloud قدرة على فك الترميز الطويل في الخلفية تصل إلى 1M كحد أقصى. لكنها تعتمد على إصدار معين من واجهة السحابة وعلى شروط استئناف، وهي ليست مثل الاستدعاء المتزامن العادي. بالنسبة إلى نقطة نهاية Chat Completions المتوافقة مع APIYI، لا توجد حاليًا نتائج استدعاء فعلية لفك الترميز الطويل يمكن التحقق منها. إذا كان العمل يحتاج إلى إخراج طويل جدًا، فمن المستحسن أن تصمم أولاً على أساس التوليد على مراحل، ثم تتحقق من فك الترميز الطويل بشكل منفصل.
كيف يمكن تقدير سعر Gemini 4 Neon
فيما يلي مثال محسوب وفق الأسعار المعلنة، ولا يمثل فاتورة حقيقية. لنفترض أن طلبًا واحدًا يتضمن إدخالاً مقداره 100K توكن وإخراجًا مرئيًا مقداره 5K توكن: تكون تكلفة الإدخال نحو $0.30، وتكلفة الإخراج نحو $0.075، والإجمالي نحو $0.375. إذا أصاب 80K من الإدخال الذاكرة المؤقتة، فسيُحسب هذا الجزء بسعر $0.15 ليكون نحو $0.012، ويُحسب المتبقي البالغ 20K بسعر $3 ليكون نحو $0.06، وستنخفض تكلفة الإدخال بشكل ملحوظ.
أما كيفية احتساب التوكنات التي تستهلكها عملية التفكير، والشروط التي تسري تحتها الذاكرة المؤقتة، فيجب الرجوع فيهما إلى الفاتورة الفعلية. تذكر أيضًا تحديثات إطلاق APIYI أنه اعتبارًا من 1 ديسمبر، وبعد انتهاء السعر محدود المدة لـ Carbon/Argon، ستعود الأسعار إلى $4/$20، وعندها سيكون السعر المعلن لـ Neon أقل منهما بنسبة 25%. هذه مقارنة أسعار وردت في إعلان المنصة، ولا تتعلق بمقارنة الفعالية.
البدء السريع مع Gemini 4 Neon: طلبان أدنى عبر المسار الأصلي والمسار المتوافق
ننصح بإرسال طلب واحد قصير عبر كل من المسارين، للتأكد من صحة معرّف النموذج والمجموعة والتوجيه، ثم إضافة الميزات الأخرى. الأمثلة أدناه مبنية وفق الوثائق الرسمية لكل من Google GenAI SDK و OpenAI SDK، والمفتاح دائمًا عنصر نائب.
| البند | نقطة النهاية الأصلية لـ Gemini | نقطة النهاية المتوافقة مع OpenAI |
|---|---|---|
| SDK الموصى به | Google GenAI SDK | OpenAI SDK |
| طريقة كتابة Base URL | عنوان URL الجذر للمنصة، مع إضافة api_version="v1beta" بشكل منفصل |
عنوان URL الجذر مع /v1 |
| بنية الطلب | contents[].parts[] |
messages[] |
| مستوى التفكير | generationConfig.thinkingConfig.thinkingLevel |
تعيين المعاملات عبر نقاط النهاية يحتاج إلى تحقق منفصل |
| الحالات المناسبة | الحاجة إلى تحكم دقيق في التفكير واستدعاء الأدوات على عدة دورات | التبديل السريع للشيفرة القائمة المبنية على OpenAI |
مثال على نقطة النهاية الأصلية لـ Gemini 4 Neon
تستخدم نقطة النهاية الأصلية عنوان URL الجذر للمنصة، ويُترك بادئة الإصدار لمعامل api_version في SDK. لا تكتب v1beta مرة أخرى داخل Base URL، وإلا فسيتم دمج المسارين وتتكرر البادئة.
from google import genai
from google.genai import types

client = genai.Client(
    api_key="YOUR_API_KEY",
    http_options=types.HttpOptions(
        base_url="https://api.apiyi.com",  # عنوان URL الجذر لمنصة APIYI، ويُحدد الإصدار عبر api_version
        api_version="v1beta",
    ),
)

resp = client.models.generate_content(
    model="gemini-4-neon",
    contents="用三句话解释什么是上下文窗口",
    config=types.GenerateContentConfig(
        thinking_config=types.ThinkingConfig(thinking_level="medium")
    ),
)
print(resp.text)
تسميات snake_case في SDK ستقابل في النهاية حقول camelCase داخل جسم طلب REST. إذا أرسلت طلب HTTP مباشرة، فسيكون هيكل جسم الطلب على النحو التالي تقريبًا، مع التركيز على المستويين:
{
  "contents": [
    { "role": "user", "parts": [ { "text": "用三句话解释什么是上下文窗口" } ] }
  ],
  "generationConfig": {
    "thinkingConfig": { "thinkingLevel": "medium" }
  }
}
هناك نقطتان يجب الانتباه إليهما. أولًا، مستوى thinkingBudget القديم ومستوى minimal لا ينطبقان على Gemini 4، ويجب حذفهما عند ترحيل الشيفرة. ثانيًا، توثيق Google يذكر أن Gemini 4 يتجاهل temperature وtopP، وعدم ملاحظة أي تأثير عند ضبط هذين المعاملين هو سلوك متوقع.
أمثلة على نقطة النهاية المتوافقة مع Gemini 4 Neon
تعد نقطة النهاية المتوافقة مناسبة للمشاريع التي تستخدم OpenAI SDK بالفعل. سنستخدم أدناه بنية messages الأساسية فقط، لنؤكد أولاً أن التوجيه والمجموعة يعملان.
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1",  # مدخل APIYI المتوافق مع OpenAI
)

resp = client.chat.completions.create(
    model="gemini-4-neon",
    messages=[{"role": "user", "content": "用三句话解释什么是上下文窗口"}],
)
print(resp.choices[0].message.content)
print(resp.choices[0].finish_reason)
في الاستجابة، يُنصح بتسجيل finish_reason إلى جانب النص الأساسي. وعندما يكون النص فارغًا، يكون هذا الحقل أول دليل. أما في نقطة النهاية الأصلية، فيقابل finish_reason حقل سبب الإنهاء، كما يقابل تقييم الأمان حقولًا ضمن النتائج المرشحة؛ وينبغي الاحتفاظ بها أيضًا عند استكشاف الأخطاء.
عرض كود التغليف مع معلومات التشخيص
import os
import time
import random
from openai import OpenAI, APIStatusError

client = OpenAI(
    api_key=os.environ["APIYI_API_KEY"],
    base_url=os.environ["APIYI_BASE_URL"],  # ضع عنوان المدخل المتوافق المذكور أعلاه
)

def ask_neon(prompt: str, max_retries: int = 3) -> str:
    """استدعاء gemini-4-neon وطباعة سبب الإنهاء والاستخدام لتسهيل التشخيص"""
    for attempt in range(max_retries + 1):
        try:
            resp = client.chat.completions.create(
                model="gemini-4-neon",
                messages=[{"role": "user", "content": prompt}],
            )
            choice = resp.choices[0]
            print("finish_reason:", choice.finish_reason)
            print("usage:", resp.usage)
            if not choice.message.content:
                print("正文为空:检查结束原因、安全状态与输出预算")
            return choice.message.content or ""
        except APIStatusError as e:
            print("status:", e.status_code, "body:", e.response.text)
            # أعد المحاولة فقط عند تحديد المعدل أو عدم التوفر المؤقت، وارفع الأخطاء الأخرى مباشرة
            if e.status_code in (429, 503) and attempt < max_retries:
                delay = (2 ** attempt) + random.uniform(0, 1)
                time.sleep(delay)
                continue
            raise
    return ""

if __name__ == "__main__":
    print(ask_neon("列出三个适合用长上下文的任务"))
🚀 بداية سريعة: عند إنشاء رمز مميز في لوحة تحكم APIYI على apiyi.com، تأكد من أن مجموعة الرمز تنتمي إلى
defaultأوsvip. ويمكن للمستخدمين الجدد تشغيل الطلبين البسيطين أعلاه مرة واحدة لكل منهما باستخدام حصة الاختبار المجانية أولاً. تشترك نقطة النهاية الأصلية والمتوافقة في المفتاح نفسه؛ وعند تبديل نقطة النهاية، ما عليك سوى تعديل Base URL وبينة الطلب.
كيف تختار مستوى التفكير في Gemini 4 Neon
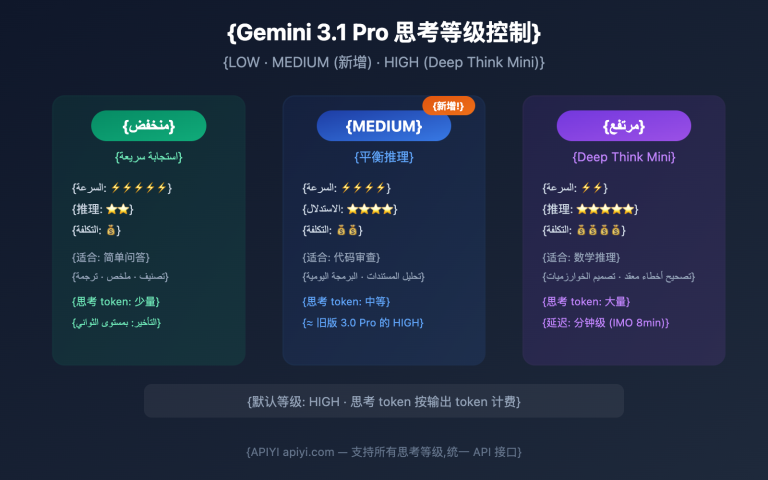
كلما ارتفع المستوى، أصبح الاستدلال أكثر شمولاً، لكن الوقت والتكلفة يزدادان أيضًا. اختبرت Artificial Analysis (AA) المستويات الأربعة لـ Neon بشكل مستقل ضمن Intelligence Index v5.0.1، وجاءت النتائج كما يلي.
| مستوى التفكير | مؤشر الذكاء لدى AA | متوسط الوقت لكل مهمة | الوصف |
|---|---|---|---|
low |
44 | نحو 3.7 دقيقة | الأولوية للسرعة |
medium |
55 | نحو 8.3 دقيقة | أعلى من low بمقدار 11 نقطة |
high (الافتراضي) |
60 | نحو 14.8 دقيقة | أعلى من medium بمقدار 5 نقاط |
xhigh |
61 | نحو 21.5 دقيقة | التكلفة المرجحة نحو $6.44 لكل مهمة تقييم |
من هذه البيانات، يظهر أن الانتقال من medium إلى high ما زال يحقق تحسنًا واضحًا، بينما يضيف الانتقال من high إلى xhigh نقطة واحدة فقط على المؤشر، مقابل نحو 6.7 دقيقة إضافية لكل مهمة في المتوسط. هذه الأرقام مأخوذة من مسار التقييم لدى AA، وتُحسب تكلفة المهمة وفق أوزان الاختبارات التسعة. أما الوقت والتكلفة في سيناريوهات مثل قراءة المستندات والأسئلة والأجوبة التفاعلية، فيجب قياسهما بنفسك. كما يجب قياس زمن الاستجابة من طرف إلى طرف ومعدل النجاح والفواتير الفعلية لدى APIYI بشكل منفصل.
يمكنك تحديد المستوى على هذا النحو: ابدأ بمستوى low أو medium للمهام الحساسة لزمن الاستجابة مثل الأسئلة والأجوبة؛ واحتفظ بالمستوى الافتراضي high عندما تحتاج إلى استدلال متعدد الخطوات؛ ولا تتحمل الوقت والتكلفة الإضافيين لـ xhigh إلا بعد التأكد على مجموعة الاختبارات الثابتة الخاصة بك من أنه يقدم تحسنًا ذا معنى.
مقارنة Gemini 4 Neon مع النماذج في الفئة نفسها
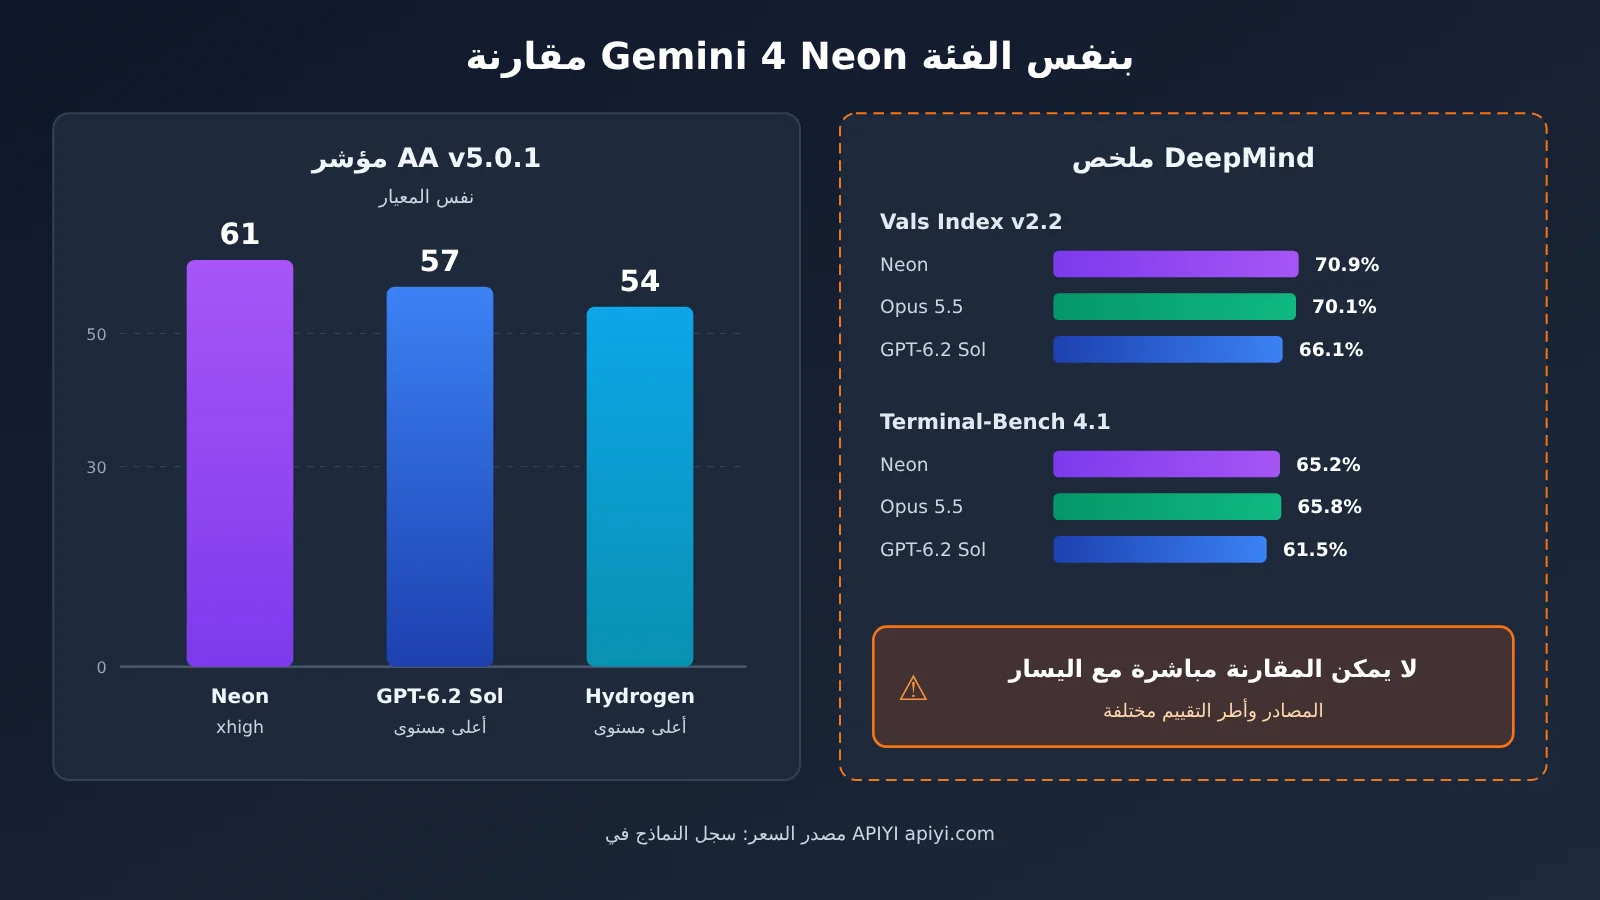
عند مقارنة النماذج المختلفة، يُفضّل الاعتماد على المعيار نفسه والمستويات القابلة للمقارنة. العمودان الأولان في الجدول أدناه مأخوذان من الإصدار نفسه لدى AA، أما الأسعار فمصدرها سجل APIYI.
| النموذج | مؤشر AA v5.0.1(أعلى مستوى) | الإدخال/الإخراج القياسي (لكل مليون Token) | المنصات المتاحة |
|---|---|---|---|
| Gemini 4 Neon | 61(xhigh) | $3/$15 | APIYI apiyi.com وغيرها |
| GPT-6.2 Sol | 57 | $2/$10 | APIYI وغيرها |
| Gemini 4 Hydrogen | 54 | وفق السجل | APIYI وغيرها |
سعر GPT-6.2 Sol المعلن أقل، فالإدخال والإخراج أرخص بنحو الثلث مقارنةً بـ Neon. لكن على المعيار نفسه لدى AA، تتفوق درجة Neon عند xhigh على أعلى مستوى لدى Sol بمقدار 4 نقاط. وينبغي الانتباه إلى أن فرق الدرجات لا يُترجم مباشرة إلى فرق في دقة الأعمال، كما يجب قياس زمن الاستجابة واستهلاك Token الفعلي لكل منهما على حدة.
وهناك مرجع آخر هو تجميع التقييمات الذي نشرته Google DeepMind: في Vals Index v2.2 بلغ Neon نسبة 70.9%، وClaude Opus 5.5 نسبة 70.1%، وGPT-6.2 Sol نسبة 66.1%؛ وفي Terminal-Bench 4.1 جاءت الدقة المعدّلة بالترتيب 65.2% و65.8% و61.5%. ويستخدم هذا التجميع بوضوح مصادر تقييم وأطر تشغيل مختلفة، وفي Terminal-Bench يتقدم Opus 5.5 قليلاً على Neon. يمكن اعتباره مرجعًا للاتجاه العام، لكن اختيار النموذج يجب أن يعتمد على دفعة المهام نفسها في سلسلة أدواتك الخاصة.
💡 توصية للاختيار: يُستحسن إعداد 20~50 سؤال اختبار ثابتًا يعكس أعمالك الحقيقية، ثم استدعاء مستويات Neon المختلفة والنماذج المرشحة بالتتابع على APIYI apiyi.com باستخدام مفتاح API نفسه، وتسجيل الدقة والوقت المستغرق والفاتورة قبل اتخاذ القرار.
استكشاف أخطاء التكامل الشائعة مع Gemini 4 Neon
عند ظهور مشكلة، ابدأ بالرجوع إلى أقصر طلب ورد في الفقرات السابقة واستخدمه كمرجع للمقارنة، وتأكد أولاً من أن المسار الأساسي يعمل بشكل سليم، ثم افحص كل ميزة جديدة على حدة.
| العرض | ما يجب فحصه أولاً | اتجاه الإصلاح |
|---|---|---|
| خطأ 404 / النموذج غير متاح | معرّف النموذج، مجموعة الرموز، التوجيه، بادئة الإصدار | انسخ gemini-4-neon كما هو؛ مع OpenAI SDK استخدم نقطة الدخول المتوافقة التي تحتوي على /v1، ومع GenAI SDK استخدم العنوان الجذري مضافًا إليه v1beta؛ وتجنّب تكرار بادئة الإصدار عند التركيب |
| خطأ 400 / سلوك غير مطابق بعد تبديل المستوى | معاملات التفكير الأصلية، وحقول جسم الطلب المتوافقة | تحقّق من سريان المستوى على النقطة الأصلية باستخدام thinkingLevel؛ واحذف thinkingBudget وminimal؛ ولا تخلط بين حقول البروتوكولين |
| استجابة 200 لكن النص فارغ | سبب الإنهاء، حالة الأمان، ميزانية الإخراج | تأكد من أن ميزانية الإخراج تستوعب التفكير والمخرجات المرئية معًا؛ وراجع معلومات تصفية الأمان |
| فشل استدعاء الأدوات في الجولة الثانية | thoughtSignature، ومطابقة استدعاء الأداة مع استجابتها |
أعد تمرير توقيع التفكير كما هو، واجعل كل استجابة أداة مقترنة بالاستدعاء الصحيح الخاص بها |
| خطأ 429 / خطأ 503 مؤقت من المنبع | جسم الخطأ، حدود الرموز، قيود التزامن | عند تحديد المعدل أو عدم التوفر لفترة قصيرة، استخدم تراجعًا أسيًا بعدد محاولات محدود مع تشتت عشوائي (jitter)؛ أما مشاكل الرصيد أو الصلاحيات فصحّح الإعدادات قبل إعادة الإرسال |
التمييز بين 404 و400 في Gemini 4 Neon
خطأ 404 يعني عادةً أن الطلب لم يُوجَّه إلى هذا النموذج أصلاً، فالمشكلة هنا مشكلة «لم يُعثر عليه»: معرّف مكتوب بشكل خاطئ، أو مجموعة رموز (token group) لا تتضمن هذا النموذج، أو أن عنوان URL صيغته مكرّرة مثل /v1/v1/... أو /v1beta/v1beta/.... أما خطأ 400 فيعني أن الطلب وصل فعلاً، لكن جسم الطلب لا يطابق البروتوكول، وأكثر الأسباب شيوعًا هو حشو حقول خاصة بنقطة النهاية الأصلية داخل طلب متوافق، أو استخدام معاملات قديمة من عصر Gemini 2.x.
تحتاج خريطة تحويل المعاملات بين نقاط النهاية المختلفة إلى اختبار قبول منفصل. فإذا حاولت التحكم في شدة التفكير عبر نقطة النهاية المتوافقة ولم تحصل على النتيجة المتوقعة، فارجع أولاً إلى نقطة النهاية الأصلية للتأكد من أن المستوى المطلوب يعمل فعلاً، ثم احكم بعدها: هل المشكلة في المعامل نفسه أم في عملية التحويل؟
الاستجابة بلا نص وفشل استدعاء الأدوات في Gemini 4 Neon
عندما تصلك استجابة HTTP 200 دون أي نص، فأول ما تنظر إليه هو سبب الإنهاء. إن كان الإنهاء بسبب تجاوز الطول، فمعنى ذلك أن عملية التفكير استهلكت ميزانية الإخراج ولم يتبقَّ مساحة لإخراج النص المرئي؛ وإن كان السبب متعلقًا بالسلامة، فستحتاج إلى تعديل محتوى الإدخال. ومستويات التفكير المرتفعة أكثر عرضةً للحالة الأولى.
أما فشل استدعاء الأدوات في الجولات المتعددة، فأغلبه مرتبط بـ thoughtSignature. ووفقًا لوثائق «بصمات التفكير» (Thought signatures) من Google، يجب إعادة البصمة التي يعيدها النموذج كما هي وبنفس البروتوكول في الجولات اللاحقة، مع ضرورة أن يقابل كل استدعاء أداة استجابةُ أداةٍ واحدة تقابله. عند التشخيص، يمكنك أولاً إزالة الأدوات والاعتماد على أقصر طلب ممكن بدون أدوات كنقطة مرجعية للمقارنة، ثم إعادة الأدوات تدريجيًا.
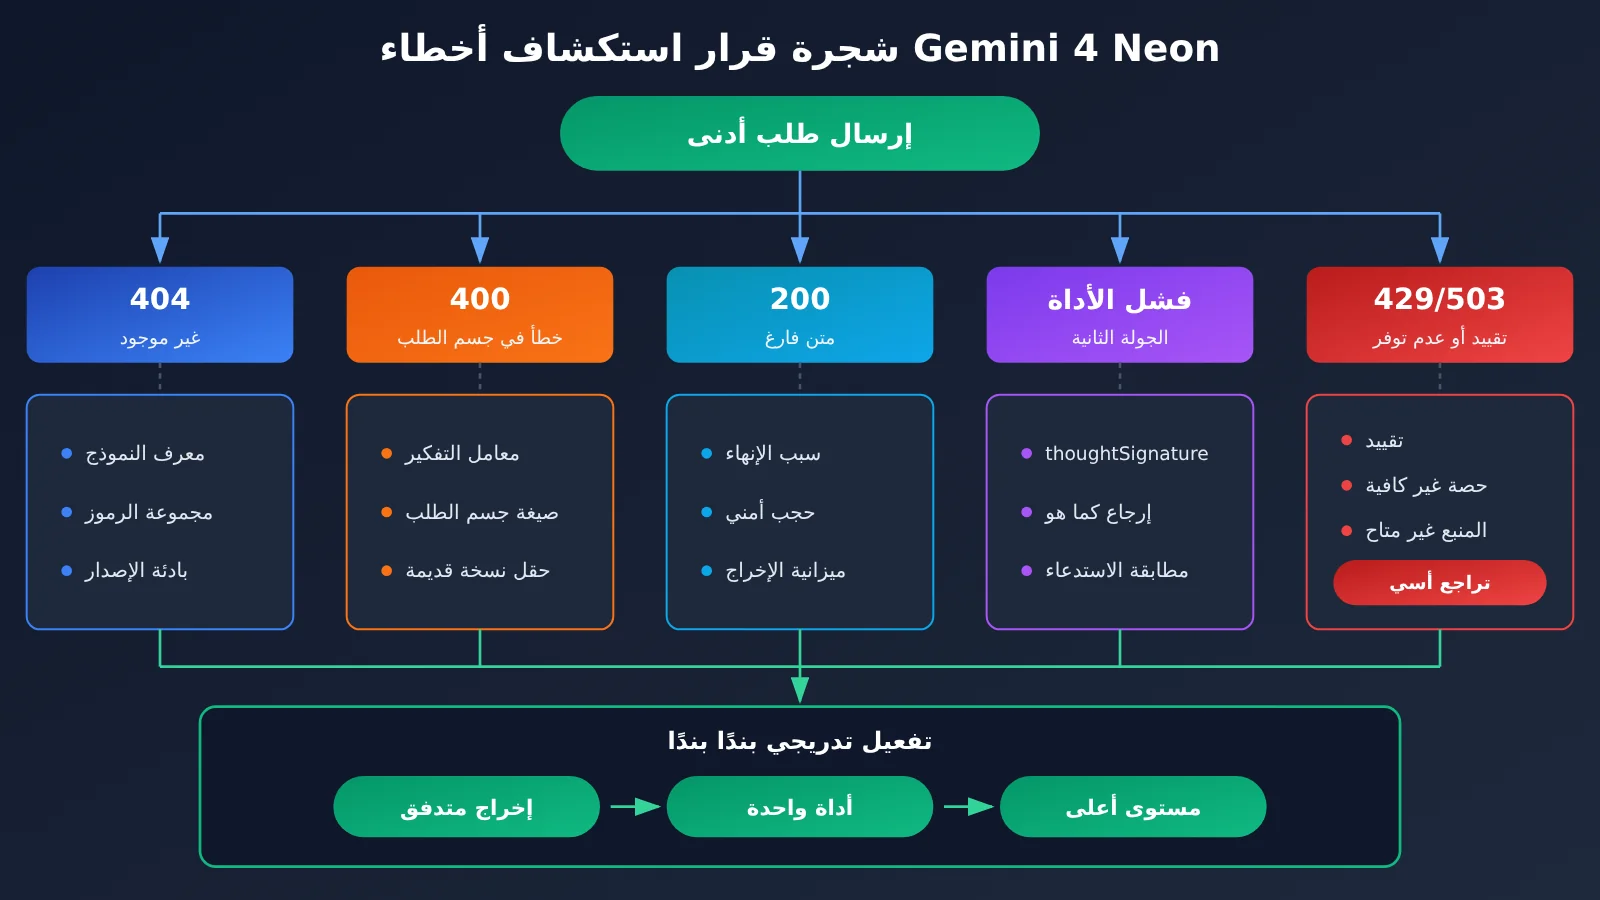
ترتيب التحقق الموصى به لـ Gemini 4 Neon
بعد نجاح أصغر طلب، يُنصح بتفعيل الميزات واحدة تلو الأخرى وفق الترتيب التالي، مع تأكيد النتيجة بشكل منفصل عند كل خطوة:
- طلب نصي خالص غير متدفق، ومن دون أدوات، وبالمستوى الافتراضي؛ للتأكد من أن
IDوالتجميع والتوجيه تعمل بشكل صحيح. - تفعيل الإخراج المتدفق، والتأكد من صحة تجميع الأجزاء وقراءة سبب الإنهاء.
- إضافة أداة واحدة، وتنفيذ الدورة الكاملة المكونة من جولتين: «الاستدعاء ← إرجاع النتيجة ← الإجابة النهائية»، مع فحص ما إذا كان
thoughtSignatureمحفوظًا. - التبديل بين
lowوmediumوxhighعلى نقطة النهاية الأصلية، ومقارنة النتائج وزمن التنفيذ والفاتورة باستخدام مجموعة اختبار ثابتة. - أخيرًا، إضافة التحسينات المرتبطة بالتكلفة مثل المدخلات الطويلة وإعادة استخدام الذاكرة المؤقتة.
الأسئلة الشائعة FAQ
Q1: ما هو Gemini 4 Neon؟
Gemini 4 Neon هو نموذج لغة كبير من الفئة المتوسطة أطلقتته Google في 18 نوفمبر 2026 وأصبح متاحًا للاستخدام العام (GA) في اليوم نفسه، ويقع في مرتبة بين Carbon وHydrogen. يوفّر نافذة سياق مشتركة بسعة 1M وأربعة مستويات لقوة التفكير، ومعرّف النموذج هو `gemini-4-neon`.
Q2: كيف أختار بين Gemini 4 Neon وGPT-6.2 Sol؟
على المقياس المرجعي نفسه AA Intelligence Index v5.0.1، حصل Neon في مستوى `xhigh` على 61 نقطة، بينما حصل Sol في أعلى مستوى لديه على 57 نقطة؛ إلا أنّ سعر Sol المعلن هو $2/$10، وهو أقل من $3/$15 الخاص بـ Neon. اختلاف النقاط لا يعني بالضرورة اختلاف دقة الأعمال، لذا يُنصح بمقارنة النتائج وزمن الاستجابة واستهلاك الـ Token الفعلي على مجموعة الاختبار الخاصة بك قبل اتخاذ القرار.
Q3: متى يمكن استخدام Gemini 4 Neon على APIYI؟
أطلقت APIYI هذا النموذج على منصّتها في 20 نوفمبر 2026، وفتحت المجموعتين `default` و`svip`. وبحسب إعلان الإطلاق، لا يوجد تاريخ انتهاء للسعر القياسي.
Q4: ما السيناريوهات المناسبة لـ Gemini 4 Neon؟
– **تحليل المستندات الطويلة**: تتيح نافذة 1M وضع كمّ كبير من المواد في طلب واحد، لكن الحد الأقصى للمخرجات المتزامنة في الطلب الواحد يبلغ نحو 64K.
– **الاستدلال متعدد الخطوات ومهام الـ Agent**: المستوى `high` الافتراضي يوازن بين جودة النتيجة والزمن، ويُنصح باستخدام نقطة النهاية الأصلية لاستدعاء الأدوات.
– **المعالجة بالدفعات مع ضبط التكلفة**: استخدم `low`/`medium` مع إعادة استخدام التخزين المؤقت لتقليل تكلفة كل عملية.
Q5: كيف أستدعي Gemini 4 Neon سريعًا عبر API؟
1. سجّل في APIYI على apiyi.com واحصل على رصيد تجريبي مجاني.
2. أنشئ رمز وصول (token) تابعًا للمجموعة `default` أو `svip`.
3. استخدم الشيفرة البرمجية الحالية الخاصة بـ OpenAI عبر نقطة الدخول المتوافقة؛ وإذا كنت بحاجة إلى التحكم في مستوى التفكير فاستخدم Google GenAI SDK للاتصال بنقطة النهاية الأصلية.
في الحالتين، يُنصح بتشغيل أصغر طلب ورد في هذا المقال أولًا للتأكد من سلامة المسار قبل إضافة مزايا أخرى.
Q6: ما القيود المعروفة لـ Gemini 4 Neon؟
– **حد المخرجات**: نافذة 1M مشتركة بين المدخلات والمخرجات، والحد الأقصى للتوليد المتزامن يبلغ نحو 64K؛ وتعتمد فك الترميز الطويل على واجهات سحابية معيّنة وشروط استئناف محدّدة.
– **تغيّر المعاملات**: لم يعد `thinkingBudget` و`minimal` صالحين، ويتم تجاهل `temperature` و`topP`.
– **حالة التحقق**: قبل الإطلاق على APIYI جرت مراجعة واجهة التسعير فقط، لذا يُنصح بالتحقق من نقطتي النهاية واستدعاء الأدوات بنفسك عبر طلباتك الخاصة على APIYI apiyi.com أولًا.
النقاط الرئيسية لـ Gemini 4 Neon
- هوية النموذج:
gemini-4-neon، الفئة المتوسطة من Gemini 4، أطلقتها Google في 18 نوفمبر. - حدود المواصفات: نافذة سياق مشتركة بسعة 1M، والحد الأقصى للتوليد المتزامن نحو 64K، أما الفكّ الطويل فيحتاج إلى تحقق منفصل.
- الأسعار المعلنة: لكل مليون توكن، الإدخال $3 والإخراج $15 وقراءة الذاكرة المؤقتة $0.15، والفاتورة الفعلية هي المرجع.
- اختيار المستوى: في اختبارات AA، الانتقال من
highإلىxhighيضيف نقطة واحدة فقط، مقابل زيادة نحو 6.7 دقيقة في زمن كل مهمة. - اختيار نقطة النهاية: للتحكم في مستوى التفكير استخدم نقطة النهاية الأصلية، ولإعادة استخدام الشيفرة الحالية استخدم نقطة النهاية المتوافقة.
- ترتيب استكشاف الأخطاء: ابدأ من أصغر طلب، ثم فعّل البث والأدوات والمستويات الأعلى بالترتيب.
الخلاصة
يمكن تلخيص نقاط الوصول إلى Gemini 4 Neon في ثلاثة أمور:
- تحقق من المواصفات أولاً: سعة 1M هي نافذة مشتركة، والإخراج المتزامن نحو 64K، والسعر المعلن $3/$15، وقراءة الذاكرة المؤقتة $0.15.
- جرّب نقطتي النهاية كلتيهما مرة واحدة: نقطة النهاية الأصلية تستخدم العنوان الجذر مع
v1beta، ونقطة النهاية المتوافقة تستخدم عنوانًا يتضمن/v1، ولا تخلط بين الحقول. - اختر المستوى بالبيانات: نتائج AA مجرد مرجع، والمرجع النهائي هو الأداء والزمن والفاتورة على مجموعة الاختبار الثابتة الخاصة بك.
بعد تأكيد طريقة الوصول، يُنصح بمقارنة مستويات Neon المختلفة والنماذج المرشحة الأخرى على APIYI apiyi.com باستخدام مفتاح API نفسه، ثم تحديد التكوين الافتراضي لبيئة الإنتاج.
📚 المراجع
-
تفاصيل إطلاق APIYI Gemini 4 Neon: المجموعات ونقاط النهاية والأسعار والحد الأقصى للإخراج
- الرابط:
docs.apiyi.com/live/2026-11/gemini-4-neon-launch - الوصف: نُشر في 2026-11-20، ويتضمن معلومات عن المستويات الأربعة للتفكير والمستوى الافتراضي
- الرابط:
-
إعلان إطلاق Google Gemini 4 Neon: معلومات الإطلاق الرسمية
- الرابط:
blog.google/innovation-and-ai/models-and-research/gemini-models/introducing-gemini-4-neon/ - الوصف: نُشر في 2026-11-18، ويتضمن توضيحات حول السياق والتموضع
- الرابط:
-
صفحة نموذج Artificial Analysis Gemini 4 Neon: تقييمات مستقلة للمستويات الأربعة
- الرابط:
artificialanalysis.ai/models/gemini-4-neon - الوصف: درجات Intelligence Index v5.0.1 وأوقات المعالجة، مع تحديث المؤشرات باستمرار
- الرابط:
-
Google Gemini API Troubleshooting و Thought signatures: وثائق استكشاف الأخطاء وإصلاحها وتوقيعات التفكير
- الرابط:
aistudio.google.com/docs/troubleshooting،aistudio.google.com/docs/thought-signatures - الوصف: معاني رموز الأخطاء وقواعد إعادة إرسال التوقيعات في استدعاءات الأدوات متعددة الجولات
- الرابط:
-
Gemini 4 Neon Model Evaluation: ملخص تقييمات DeepMind
- الرابط:
storage.googleapis.com/deepmind-media/gemini/gemini_4_neon_model_evaluation.pdf - الوصف: نتائج تقييم من مصادر وأطر متعددة، ويجب ذكر الإعدادات عند الاقتباس
- الرابط:
المؤلف: فريق APIYI التقني
التواصل التقني: إذا واجهت أي مشكلة أثناء عملية التكامل، يسعدنا تواصلك معنا عبر الموقع الرسمي لـ APIYI. ولمزيد من توضيحات الواجهات، راجع مركز التوثيق docs.apiyi.com