Примечание автора: в этой статье — контекст Gemini 4 Neon, четыре уровня интенсивности рассуждений и цены; рассказываю, как настроить в APIYI два входа — нативный и совместимый, — и как одним минимальным запросом выявить типичные ошибки подключения.
Если коротко: Gemini 4 Neon выпущен Google 18 ноября 2026 года, APIYI 20 ноября запустил его в группах default/svip. ID модели — gemini-4-neon, тариф — $3 за миллион входных токенов, $15 за выходные и $0.15 за чтение кеша.Если вам нужно управлять уровнями рассуждений нативно, подключайтесь к нативному эндпоинту Gemini; если вы просто меняете модель в существующем клиенте OpenAI, совместимый эндпоинт проще. Но в обоих случаях сначала добейтесь успешного выполнения самого короткого запроса, а затем по очереди включайте потоковую передачу, вызов инструментов и более высокие уровни рассуждений.
Это не новость-пересказ пресс-релиза. Параметры, цены, результаты бенчмарков и порядок диагностики ниже — с указанием источника и условий применимости; примеры кода построены по официальной документации. В описании запуска APIYI сказано, что перед запуском проверяли только API цен, без реальных вызовов, поэтому здесь не будет утверждения, что оба эндпоинта или вызов инструментов «уже проверены на практике».
Ключевая ценность: после прочтения вы сможете проверить спецификации Neon и правила тарификации, составить два минимальных запроса — к нативному и совместимому эндпоинтам, — выбрать уровень рассуждений по результатам тестов и быстро находить причину проблемы по симптомам ошибок.
Термины, которые нужно знать до подключения Gemini 4 Neon
Эти понятия будут встречаться в тексте не раз. Давайте сразу договоримся о формулировках — так при разборе проблем будет меньше путаницы.
- ID модели: полная строка, которая указывает модель в запросе; в этой статье —
gemini-4-neon. Регистр и дефисы нужно копировать как есть, сокращать по-своему нельзя. - Base URL: корневой адрес, к которому клиент добавляет путь запроса. Нужен ли префикс версии вроде
/v1— зависит от используемого SDK; ошибка в этой настройке — частая причина 404. - Собственный эндпоинт Gemini: принимает протокол
generateContent, подходит для сценариев, где нужны нативные параметры размышления. - OpenAI-совместимый эндпоинт: использует формат Chat Completions; если у вас уже есть клиент OpenAI, можно напрямую переиспользовать базовую структуру сообщений.
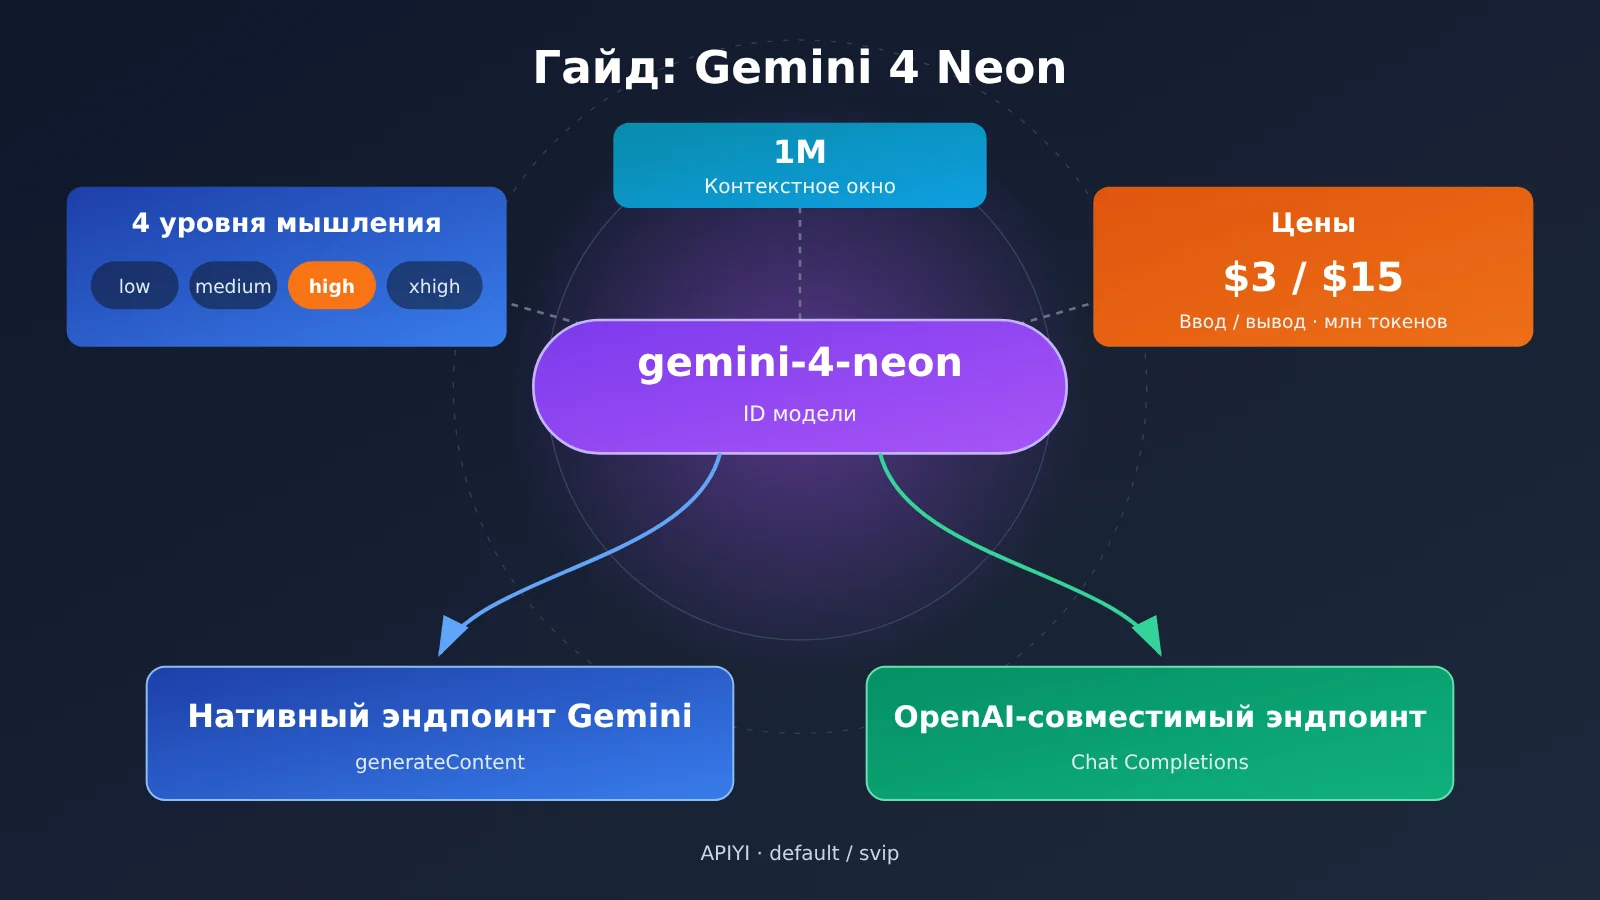
- Уровень размышления: перечисляемое значение интенсивности рассуждений модели. Neon нативно поддерживает
low,medium,high,xhigh, а в APIYI уровень по умолчанию динамически помечается какhigh. - Сигнатура размышления
thoughtSignature: контекстная метка, которую возвращает модель. При многораундовых вызовах инструментов её обязательно нужно сохранять и возвращать по исходному протоколу. - Контекстное окно: общий бюджет на вход, размышления и вывод. Сколько именно можно выдать за одну синхронную генерацию — нужно отдельно сверять по верхнему лимиту.
- Цена чтения кэша: тариф, который применяется при повторном использовании подходящего уже имеющегося входа; он существенно ниже стандартной цены входа.
Gemini 4 Neon: ключевые моменты — параметры, цены и группы
Согласно анонсу запуска APIYI, Neon — средняя модель в линейке Gemini 4: она позиционируется между Carbon (для самых сложных задач) и Hydrogen (для повседневных задач). Google выпустила её 18 ноября и в тот же день сделала общедоступной (GA), а APIYI подключила 20 ноября.
| Пункт | Содержание | Источник и условия |
|---|---|---|
| ID модели | gemini-4-neon |
Реестр моделей APIYI (сформирован 2026-11-20) |
| Доступные группы | default, svip |
Анонс запуска APIYI (2026-11-20) |
| Эндпоинты доступа | Нативный Gemini + эндпоинт, совместимый с OpenAI | Анонс запуска APIYI; до запуска не проверялось реальными вызовами |
| Контекстное окно | 1M, общее для входа, рассуждения и вывода | В анонсе Google и Artificial Analysis указано 1M |
| Лимит синхронной генерации | около 64K токенов | Документация запуска APIYI |
| Уровни рассуждения | low / medium / high / xhigh, по умолчанию high | Анонс запуска APIYI |
| Цена по прайс-листу (за миллион токенов) | вход $3, выход $15, чтение из кеша $0.15 | Реестр APIYI; в анонсе утверждается, что цены совпадают с официальным сайтом по каждой позиции и не имеют срока действия |
Связь контекста и лимита вывода Gemini 4 Neon
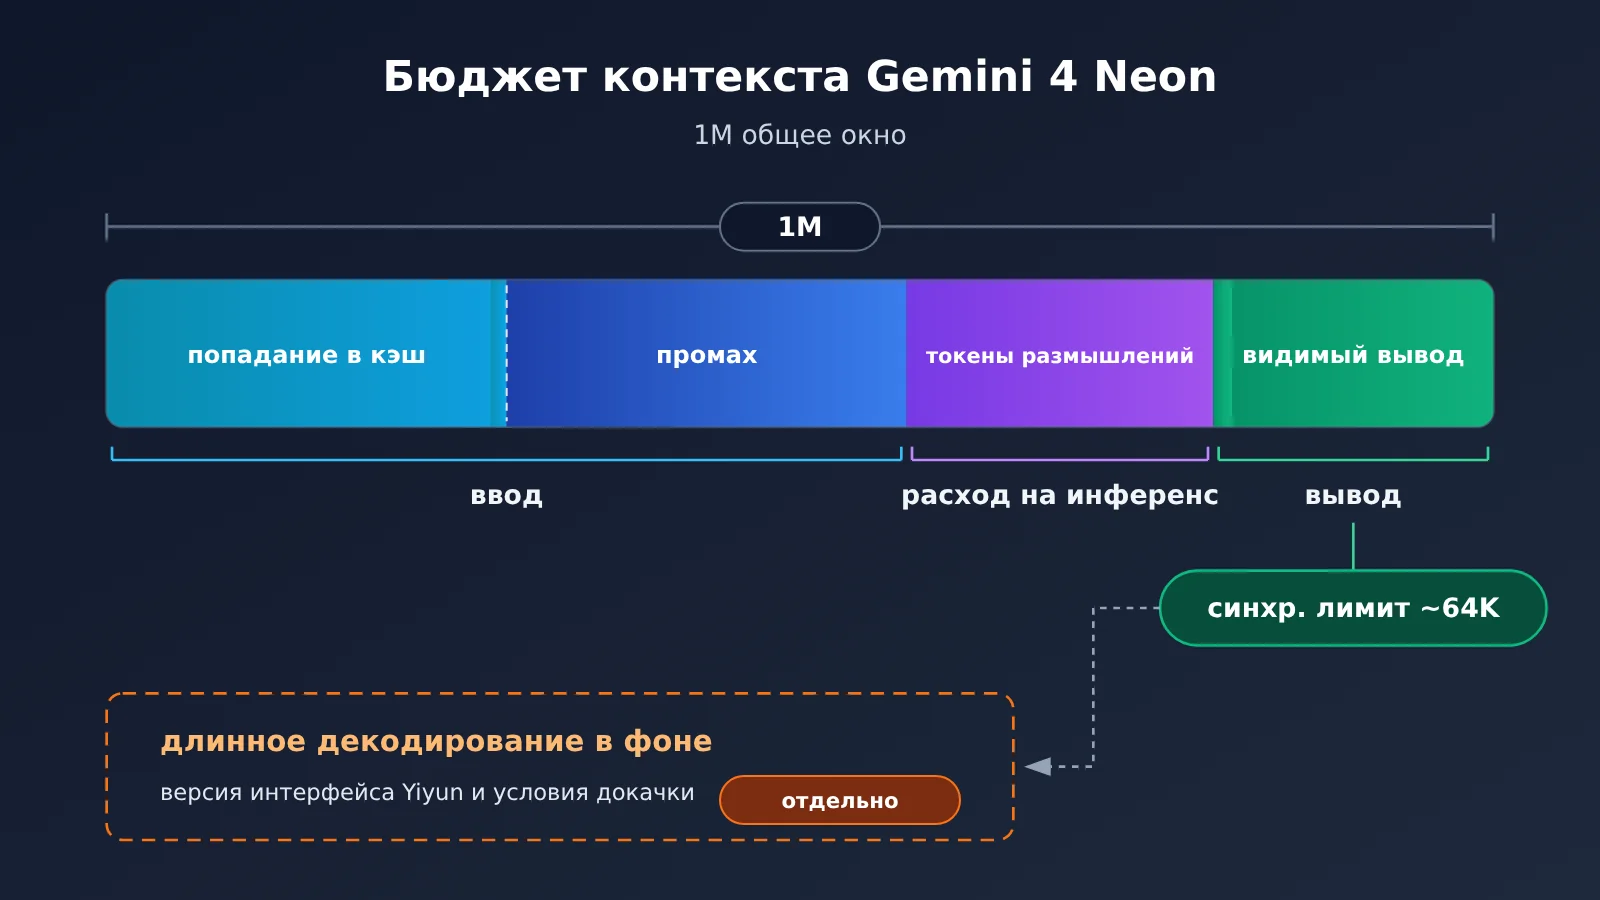
Контекст в 1M часто ошибочно воспринимают как «возможность за один раз выдать 1M». На самом деле эти 1M — общее окно для входа, рассуждения и вывода. Согласно документации запуска APIYI, лимит генерации при синхронном вызове составляет около 64K токенов: длинный вход — не проблема, но от одного синхронного запроса не стоит ждать вывода больше этого объёма.
В документации Google Cloud упоминается возможность фонового длительного декодирования — вплоть до 1M. Но она зависит от конкретной версии облачного интерфейса и условий возобновления передачи; это не то же самое, что обычный синхронный вызов. Для OpenAI-совместимого эндпоинта Chat Completions в APIYI сейчас нет проверяемых результатов реальных вызовов длительного декодирования. Если бизнесу нужен сверхдлинный вывод, лучше сначала проектировать генерацию по сегментам, а длительное декодирование проверять отдельно.
Как оценить стоимость Gemini 4 Neon
Ниже пример расчёта по прайс-листу; он не отражает реальный счёт. Предположим, в одном запросе 100K входных токенов и 5K токенов видимого вывода: стоимость входа около $0.30, вывода — около $0.075, итого около $0.375. Если 80K входных токенов из них попадут в кеш, эта часть по $0.15 составит около $0.012, оставшиеся 20K по $3 — около $0.06; стоимость входных токенов заметно снизится.
Как учитываются токены, расходуемые на рассуждение, и при каких условиях действует кеш, нужно проверять по фактическому счёту. В анонсе запуска APIYI также упоминается, что с 1 декабря после окончания срока действия временных цен Carbon / Argon возвращаются к $4 / $20; тогда цена Neon по прайс-листу будет на 25% ниже. Это ценовое сравнение из анонса платформы, а не сравнение эффективности.
Быстрый старт с Gemini 4 Neon: два минимальных запроса — нативный и совместимый
Рекомендуем сначала отправить по одному самому короткому запросу через каждый путь, убедиться, что ID модели, группа и маршрутизация настроены правильно, и только потом добавлять остальные функции. Примеры ниже построены по официальной документации Google GenAI SDK и OpenAI SDK; вместо ключей везде используются заполнители.
| Параметр сравнения | Нативный эндпоинт Gemini | Эндпоинт, совместимый с OpenAI |
|---|---|---|
| Рекомендуемый SDK | Google GenAI SDK | OpenAI SDK |
| Запись Base URL | Корневой адрес платформы, плюс api_version="v1beta" |
Корневой адрес с /v1 |
| Структура запроса | contents[].parts[] |
messages[] |
| Уровень рассуждений | generationConfig.thinkingConfig.thinkingLevel |
Сопоставление параметров между эндпоинтами нужно проверять отдельно |
| Подходящие сценарии | Нужен тонкий контроль рассуждений, многораундовые вызовы инструментов | Быстрое переключение существующего кода OpenAI |
Пример нативного эндпоинта Gemini 4 Neon
В нативном эндпоинте используйте корневой адрес платформы, а префикс версии передайте SDK через api_version. Не дублируйте v1beta в Base URL, иначе путь получится с повторением.
from google import genai
from google.genai import types

client = genai.Client(
    api_key="YOUR_API_KEY",
    http_options=types.HttpOptions(
        base_url="https://api.apiyi.com",  # Корневой адрес платформы APIYI, версия задаётся через api_version
        api_version="v1beta",
    ),
)

resp = client.models.generate_content(
    model="gemini-4-neon",
    contents="用三句话解释什么是上下文窗口",
    config=types.GenerateContentConfig(
        thinking_config=types.ThinkingConfig(thinking_level="medium")
    ),
)
print(resp.text)
Змеиный регистр в SDK в итоге соответствует camelCase-полям в теле REST-запроса. Если отправлять HTTP-запрос напрямую, тело запроса будет примерно таким — обратите внимание на два уровня:
{
  "contents": [
    { "role": "user", "parts": [ { "text": "用三句话解释什么是上下文窗口" } ] }
  ],
  "generationConfig": {
    "thinkingConfig": { "thinkingLevel": "medium" }
  }
}
Есть два момента. Во-первых, старые thinkingBudget и уровень minimal не применяются к Gemini 4 — при миграции кода их нужно удалить. Во-вторых, в документации Google указано, что Gemini 4 игнорирует temperature и topP; если при изменении этих параметров эффекта не видно, это ожидаемое поведение.
Пример совместимого эндпоинта Gemini 4 Neon
Совместимый эндпоинт подойдёт проектам, которые уже работают через OpenAI SDK. Ниже мы используем только самый базовый messages, чтобы сначала убедиться, что маршрутизация и группа работают.
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1",  # Точка входа OpenAI-совместимого API APIYI
)

resp = client.chat.completions.create(
    model="gemini-4-neon",
    messages=[{"role": "user", "content": "用三句话解释什么是上下文窗口"}],
)
print(resp.choices[0].message.content)
print(resp.choices[0].finish_reason)
Помимо самого текста ответа, советую сразу записывать и finish_reason. Если текст пустой — это первая подсказка. В нативном эндпоинте этому соответствуют поля причины завершения и рейтинга безопасности в результатах кандидатов — при разборе полётов их тоже стоит сохранять.
Посмотреть код-обёртку с диагностической информацией
import os
import time
import random
from openai import OpenAI, APIStatusError

client = OpenAI(
    api_key=os.environ["APIYI_API_KEY"],
    base_url=os.environ["APIYI_BASE_URL"],  # Укажите адрес совместимого эндпоинта из раздела выше
)

def ask_neon(prompt: str, max_retries: int = 3) -> str:
    """Вызывает gemini-4-neon, печатает причину завершения и расход, чтобы упростить диагностику"""
    for attempt in range(max_retries + 1):
        try:
            resp = client.chat.completions.create(
                model="gemini-4-neon",
                messages=[{"role": "user", "content": prompt}],
            )
            choice = resp.choices[0]
            print("finish_reason:", choice.finish_reason)
            print("usage:", resp.usage)
            if not choice.message.content:
                print("Текст пуст: проверьте причину завершения, статус безопасности и бюджет вывода")
            return choice.message.content or ""
        except APIStatusError as e:
            print("status:", e.status_code, "body:", e.response.text)
            # Повторяем только при лимитировании и кратковременной недоступности, остальные ошибки пробрасываем сразу
            if e.status_code in (429, 503) and attempt < max_retries:
                delay = (2 ** attempt) + random.uniform(0, 1)
                time.sleep(delay)
                continue
            raise
    return ""

if __name__ == "__main__":
    print(ask_neon("列出三个适合用长上下文的任务"))
🚀 Быстрый старт: создавая токен в консоли APIYI apiyi.com, проверьте, что его группа —
defaultилиsvip. Новичкам можно сначала прогнать оба минимальных запроса выше на бесплатной тестовой квоте. Нативный и совместимый эндпоинты используют один и тот же Key, так что при переключении эндпоинта достаточно поменять Base URL и структуру запроса.
Как выбрать уровень рассуждений Gemini 4 Neon
Чем выше уровень, тем полнее рассуждения, но тем больше времени и затрат. Artificial Analysis (AA) в Intelligence Index v5.0.1 независимо тестировала четыре уровня Neon; результаты ниже.
| Уровень рассуждений | Индекс интеллекта AA | Среднее время на задачу | Пояснение |
|---|---|---|---|
low |
44 | около 3,7 минуты | Приоритет — скорость |
medium |
55 | около 8,3 минуты | На 11 пунктов выше low |
high (по умолчанию) |
60 | около 14,8 минуты | На 5 пунктов выше medium |
xhigh |
61 | около 21,5 минуты | Взвешенная стоимость — около $6.44 за задачу оценки |
Судя по этим данным, переход с medium на high по-прежнему даёт заметный прирост, а с high на xhigh — всего 1 пункт индекса, при этом среднее время на задачу увеличивается примерно на 6,7 минуты. Эти цифры взяты из цепочки оценок AA; стоимость задачи рассчитывается с учётом весов девяти тестов. Для таких сценариев, как чтение документов и интерактивные вопросы-ответы, время и расходы придётся измерять самостоятельно. Сквозную задержку, долю успешных запросов и фактические расходы APIYI тоже нужно проверять отдельно.
Выбирать уровень можно так: для чувствительных к задержке задач с вопросами и ответами начинайте с low или medium; когда нужно многошаговое рассуждение, оставляйте high по умолчанию; и только если на вашем собственном фиксированном наборе тестов вы убедитесь, что xhigh даёт значимый прирост, стоит платить за него дополнительным временем и затратами.
Сравнение Gemini 4 Neon с моделями того же класса
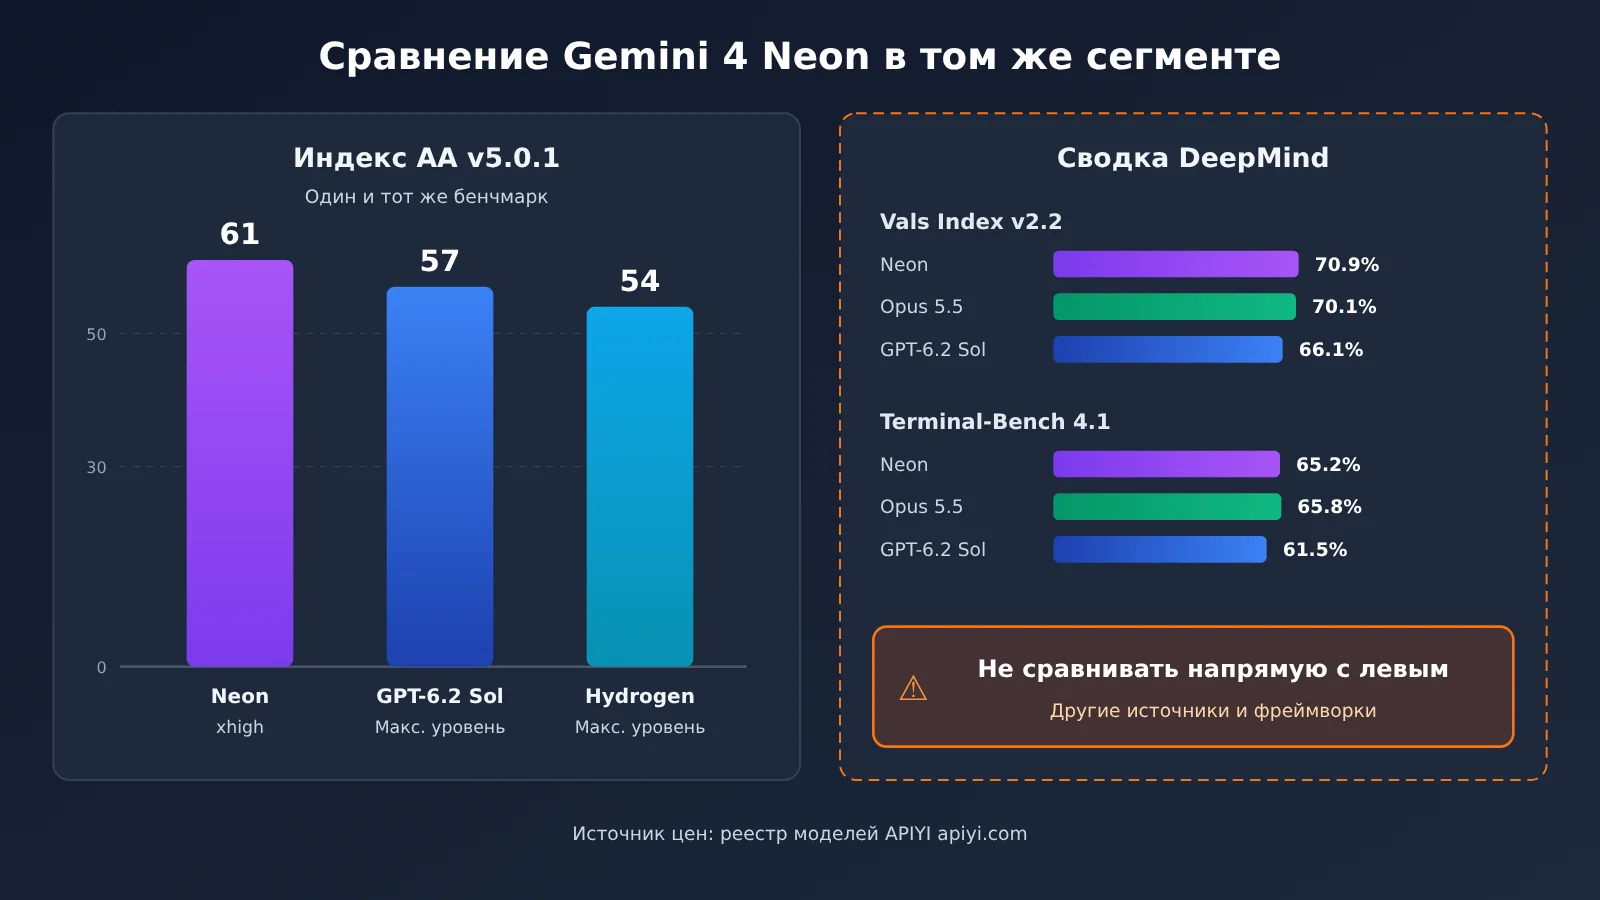
При сравнении моделей старайтесь использовать один и тот же бенчмарк и сопоставимые уровни. Первые две колонки таблицы ниже — из одной и той же версии AA, цены — из реестра APIYI.
| Модель | Индекс AA v5.0.1 (максимальный уровень) | Стандартный ввод/вывод (за миллион токенов) | Доступные платформы |
|---|---|---|---|
| Gemini 4 Neon | 61 (xhigh) | $3/$15 | APIYI apiyi.com и др. |
| GPT-6.2 Sol | 57 | $2/$10 | APIYI и др. |
| Gemini 4 Hydrogen | 54 | по данным реестра | APIYI и др. |
По прайсу GPT-6.2 Sol дешевле: и ввод, и вывод стоят на треть меньше, чем у Neon. Но на одном и том же бенчмарке AA результат Neon xhigh на 4 балла выше, чем у Sol на максимальном уровне. Важно: разницу в баллах нельзя напрямую пересчитывать в разницу в точности на реальных задачах, а задержку и фактический расход токенов у обеих моделей нужно измерять отдельно.
Ещё один ориентир — сводка оценок, опубликованная Google DeepMind: в Vals Index v2.2 Neon показывает 70,9%, Claude Opus 5.5 — 70,1%, GPT-6.2 Sol — 66,1%; в Terminal-Bench 4.1 скорректированная точность по порядку составляет 65,2%, 65,8% и 61,5%. В этой сводке явно использованы разные источники оценки и среды выполнения, а в Terminal-Bench Opus 5.5 даже чуть выше Neon. Её можно брать как ориентир по направлению, но выбор модели стоит делать по одной и той же партии задач в вашем собственном инструментарии.
💡 Рекомендация по выбору: подготовьте 20–50 фиксированных тестовых задач, отражающих реальные бизнес-сценарии, и на APIYI apiyi.com с одним и тем же API-ключом последовательно вызывайте разные уровни Neon и модели-кандидаты; принимайте решение после того, как запишете точность, время выполнения и суммы в счёте.
Распространённые ошибки при подключении Gemini 4 Neon
Если что-то пошло не так, сначала вернитесь к самому короткому запросу из предыдущего раздела и сверьтесь с ним — убедитесь, что базовая цепочка работает, а уже потом проверяйте по пунктам новые функции.
| Симптом | Что проверить в первую очередь | Как исправить |
|---|---|---|
| 404 / модель недоступна | ID модели, группировка токенов, маршрутизация, префикс версии | Скопируйте gemini-4-neon как есть; в OpenAI SDK используйте совместимую точку входа с /v1, в GenAI SDK — корневой адрес с v1beta; не добавляйте префикс версии повторно |
| 400 / поведение не соответствует после смены уровня | Нативные параметры размышления, поля совместимого тела запроса | На нативной конечной точке проверьте через thinkingLevel, применяется ли уровень; удалите thinkingBudget и minimal; не смешивайте поля двух протоколов |
| 200, но тело ответа пустое | Причина завершения, состояние безопасности, бюджет вывода | Убедитесь, что бюджета вывода хватает и на размышления, и на видимый вывод; проверьте информацию о фильтрации безопасности |
| Вызов инструмента не удаётся во второй попытке | thoughtSignature, сопоставление вызова инструмента с ответом |
Возвращайте подпись размышления как есть и сопоставляйте каждый ответ инструмента с правильным вызовом |
| 429 / кратковременный 503 от вышестоящего сервиса | Тело ошибки, лимит токенов, ограничения по параллелизму | При кратковременной перегрузке или недоступности используйте экспоненциальную задержку с джиттером и ограниченным числом попыток; при проблемах с балансом или правами исправьте конфигурацию и только потом отправляйте запрос |
Разница между 404 и 400 в Gemini 4 Neon
404 обычно означает, что запрос не был маршрутизирован на эту модель, то есть проблема в «не найдено»: ID написан с опечаткой, группа токена не включает эту модель, либо URL собрали с дублирующимся путём вроде /v1/v1/..., /v1beta/v1beta/.... 400 же означает, что запрос дошёл, но тело не соответствует протоколу — чаще всего это нативные поля, впихнутые в совместимый запрос, или старые параметры времён Gemini 2.x.
Сопоставление параметров между эндпоинтами нужно проверять отдельно. Если в совместимом эндпоинте вы пытаетесь управлять интенсивностью размышлений и не получаете ожидаемого результата, сначала вернитесь на нативный эндпоинт и убедитесь, что уровень действительно применяется, а уже потом решайте, это проблема самого параметра или проблема маппинга.
Gemini 4 Neon: пустой текст ответа и сбои вызова инструментов
Когда приходит HTTP 200, но текста нет, первым делом смотрите на причину завершения. Если это обрезка по длине — значит, процесс размышления уже занял бюджет вывода и видимому тексту места не осталось; если причина в безопасности — нужно править входные данные. На высоких уровнях размышления первый случай встречается чаще.
Сбои многораундовых вызовов инструментов чаще всего связаны с thoughtSignature. Согласно документации Google по Thought signatures, подпись, которую вернула модель, нужно передать в последующих раундах как есть, по исходному протоколу, и каждому вызову инструмента должен соответствовать ровно один ответ инструмента. При диагностике можно сначала убрать инструменты и сделать контрольный запрос без них — самый короткий, а затем постепенно добавлять инструменты обратно.
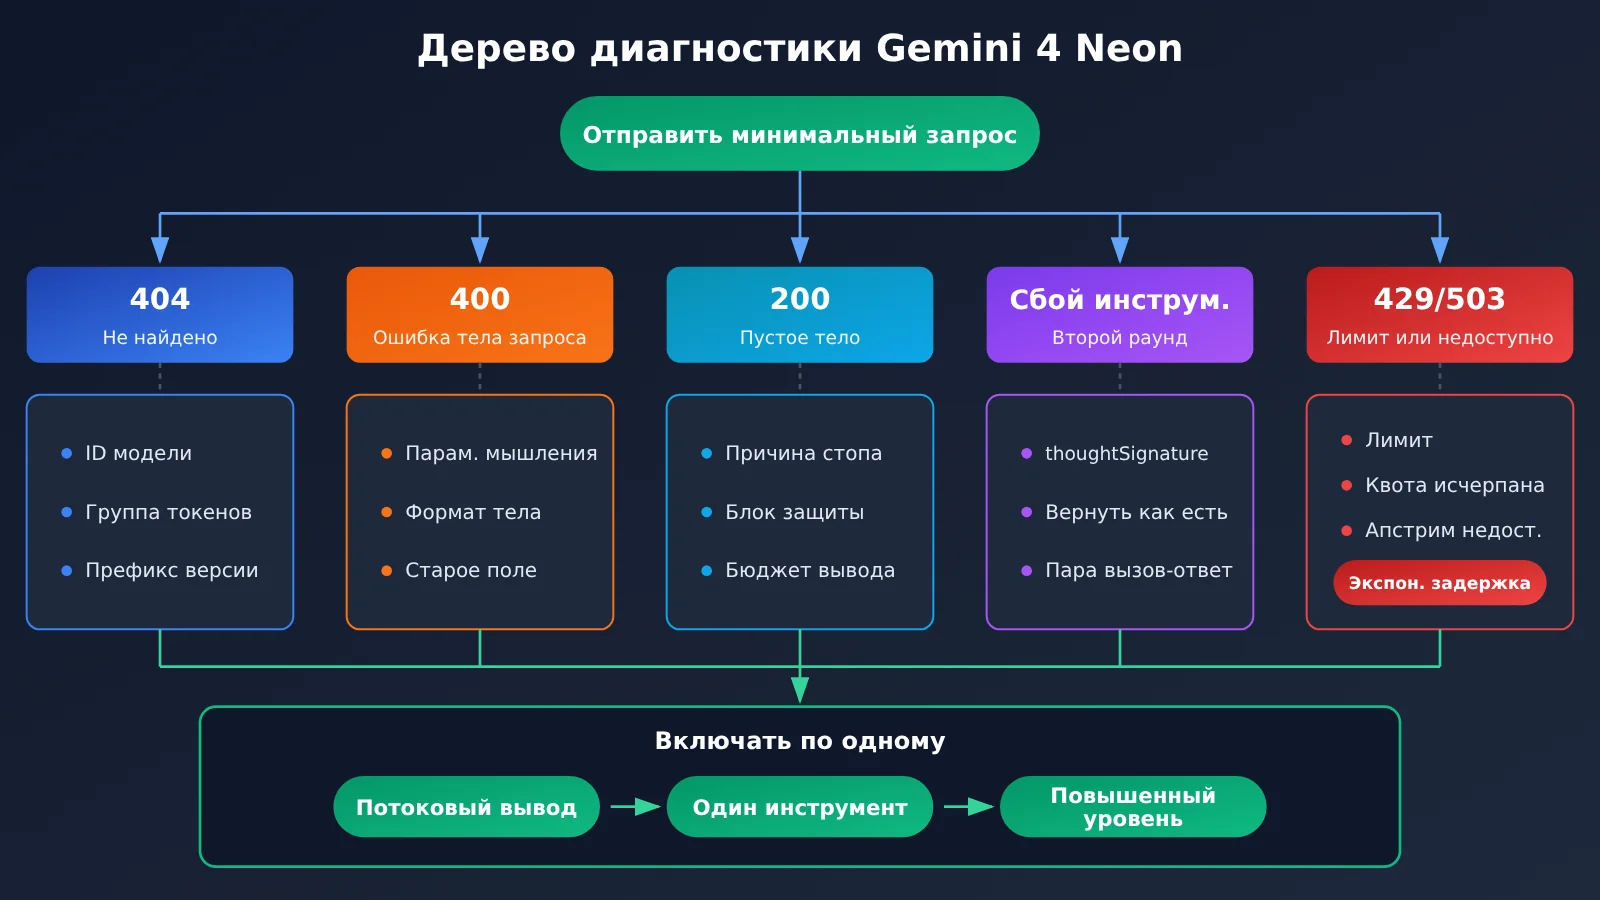
Рекомендуемый порядок проверки Gemini 4 Neon
После успешного выполнения минимального запроса рекомендуется включать функции по одной в указанном ниже порядке, отдельно подтверждая результат на каждом шаге:
- Чистый текстовый запрос без потоковой передачи, без инструментов и с уровнем по умолчанию — проверьте, что ID, группировка и маршрутизация работают нормально.
- Включите потоковый вывод и убедитесь, что склейка чанков и чтение причины завершения работают корректно.
- Добавьте один инструмент и пройдите полный цикл из двух раундов «вызов → возврат результата → финальный ответ», проверив, сохраняется ли
thoughtSignature. - На нативном эндпоинте переключите
low/medium/xhighи сравните качество, время выполнения и стоимость на фиксированном наборе тестов. - В конце добавьте оптимизации, связанные со стоимостью: длинный ввод, повторное использование кэша и т. п.
Частые вопросы (FAQ)
Вопрос 1: Что такое Gemini 4 Neon?
Gemini 4 Neon — это модель среднего уровня линейки Gemini 4, которую Google выпустила 18 ноября 2026 года, и в тот же день она стала общедоступной (GA). Она стоит между Carbon и Hydrogen. Модель даёт 1M общего контекстного окна и четыре уровня интенсивности рассуждений, а её ID — `gemini-4-neon`.
Вопрос 2: Как выбрать между Gemini 4 Neon и GPT-6.2 Sol?
На одном и том же бенчмарке AA Intelligence Index v5.0.1 Neon в режиме `xhigh` набирает 61 балл, а Sol в максимальном режиме — 57 баллов; при этом прайс-лист Sol — $2/$10, что ниже, чем $3/$15 у Neon. Разница в баллах не равна разнице в точности на реальных бизнес-задачах: сравните качество, задержку и фактический расход токенов на своём тестовом наборе, и уже потом решайте.
Вопрос 3: Когда Gemini 4 Neon появится в APIYI?
APIYI подключил эту модель 20 ноября 2026 года, открыв две группы: `default` и `svip`. По анонсу, стандартная цена действует бессрочно.
Вопрос 4: Для каких сценариев подходит Gemini 4 Neon?
— **Анализ длинных документов**: окно в 1M позволяет за один раз загрузить массу материалов, но лимит одного синхронного вывода — около 64K.
— **Многошаговые рассуждения и задачи для агентов**: режим `high` по умолчанию сочетает качество и время работы; для вызова инструментов рекомендуется нативный эндпоинт.
— **Пакетная обработка с контролем затрат**: используйте `low`/`medium` вместе с кэшированием, чтобы снизить стоимость одного запроса.
Вопрос 5: Как быстро вызвать Gemini 4 Neon через API?
1. Зарегистрируйтесь в APIYI apiyi.com и получите бесплатную тестовую квоту.
2. Создайте токен в группе `default` или `svip`.
3. Для существующего кода на OpenAI используйте совместимый вход; если нужен контроль уровня рассуждений, подключайтесь к нативному эндпоинту через Google GenAI SDK.
В обоих случаях сначала прогоните минимальный запрос из этой статьи, убедитесь, что цепочка работает нормально, и только потом добавляйте новые функции.
Вопрос 6: Какие известны ограничения у Gemini 4 Neon?
— **Лимит вывода**: 1M — это общее окно, лимит синхронной генерации — около 64K; длинное декодирование зависит от конкретных облачных интерфейсов и условий продолжения.
— **Изменения параметров**: `thinkingBudget` и `minimal` больше не применяются, `temperature` и `topP` игнорируются.
— **Статус проверки**: перед запуском в APIYI была проверена только ценовая часть API; двойные эндпоинты и вызов инструментов рекомендуется предварительно проверить на APIYI apiyi.com собственными запросами.
Gemini 4 Neon: ключевые выводы
- Модель:
gemini-4-neon, средний уровень Gemini 4, выпущена Google 18 ноября. - Ограничения спецификации: 1M общего контекста, лимит синхронной генерации — около 64K; длинное декодирование нужно проверять отдельно.
- Тарифы: за миллион токенов — вход $3, выход $15, чтение кеша $0.15; фактические суммы — по счёту.
- Выбор уровня: в тестах AA переход
high→xhighдаёт всего 1 балл, но на каждую задачу уходит примерно на 6.7 минуты больше. - Выбор эндпоинта: если нужно управлять уровнем мышления — используйте нативный эндпоинт; если переиспользуете существующий код — совместимый эндпоинт.
- Порядок диагностики: начинайте с минимального запроса, затем по очереди включайте стриминг, инструменты и более высокий уровень.
Итог
Ключевые моменты подключения Gemini 4 Neon можно свести к трём пунктам:
- Сначала сверьтесь со спецификациями: 1M — это общее окно, синхронный вывод — около 64K, тарифы — $3/$15, чтение кеша — $0.15.
- Прогоните оба эндпоинта по разу: для нативного используйте корневой адрес с
v1beta, для совместимого — адрес с/v1; не смешивайте поля. - Выбирайте уровень по данным: результаты AA — только ориентир; в конечном счёте ориентируйтесь на качество, время выполнения и счёт на собственном фиксированном тестовом наборе.
После того как определитесь со способом подключения, рекомендую на APIYI apiyi.com с одним и тем же API-ключом сравнить уровни Neon и другие модели-кандидаты, а затем выбрать конфигурацию по умолчанию для продакшена.
📚 Справочные материалы
-
Анонс APIYI Gemini 4 Neon: группы, эндпоинты, цены и лимиты вывода
- Ссылка:
docs.apiyi.com/live/2026-11/gemini-4-neon-launch - Описание: опубликован 2026-11-20, содержит информацию о четырёх уровнях мышления и уровне по умолчанию
- Ссылка:
-
Официальное объявление Google Gemini 4 Neon: информация о релизе от Google
- Ссылка:
blog.google/innovation-and-ai/models-and-research/gemini-models/introducing-gemini-4-neon/ - Описание: опубликован 2026-11-18, содержит сведения о контексте и позиционировании модели
- Ссылка:
-
Страница модели Artificial Analysis Gemini 4 Neon: независимая оценка всех четырёх уровней
- Ссылка:
artificialanalysis.ai/models/gemini-4-neon - Описание: оценка Intelligence Index v5.0.1 и время выполнения, метрики обновляются динамически
- Ссылка:
-
Google Gemini API Troubleshooting и Thought signatures: документация по устранению неполадок и подписям размышлений
- Ссылка:
aistudio.google.com/docs/troubleshooting,aistudio.google.com/docs/thought-signatures - Описание: значения кодов ошибок и правила возврата подписей при многораундовых вызовах инструментов
- Ссылка:
-
Gemini 4 Neon Model Evaluation: сводка оценок DeepMind
- Ссылка:
storage.googleapis.com/deepmind-media/gemini/gemini_4_neon_model_evaluation.pdf - Описание: результаты оценок из разных источников и фреймворков; при цитировании нужно указывать настройки
- Ссылка:
Автор: техническая команда APIYI
Техническая связь: если возникли вопросы при подключении, свяжитесь с нами через официальный сайт APIYI — дополнительную информацию по интерфейсам можно найти в центре документации docs.apiyi.com