Catatan penulis: Artikel ini membahas jendela konteks, empat tingkat intensitas pemikiran, dan harga Gemini 4 Neon; menjelaskan cara mengonfigurasi dua pintu masuk—native dan kompatibel—di APIYI; serta menggunakan satu permintaan minimal yang sama untuk melacak kesalahan integrasi yang umum.
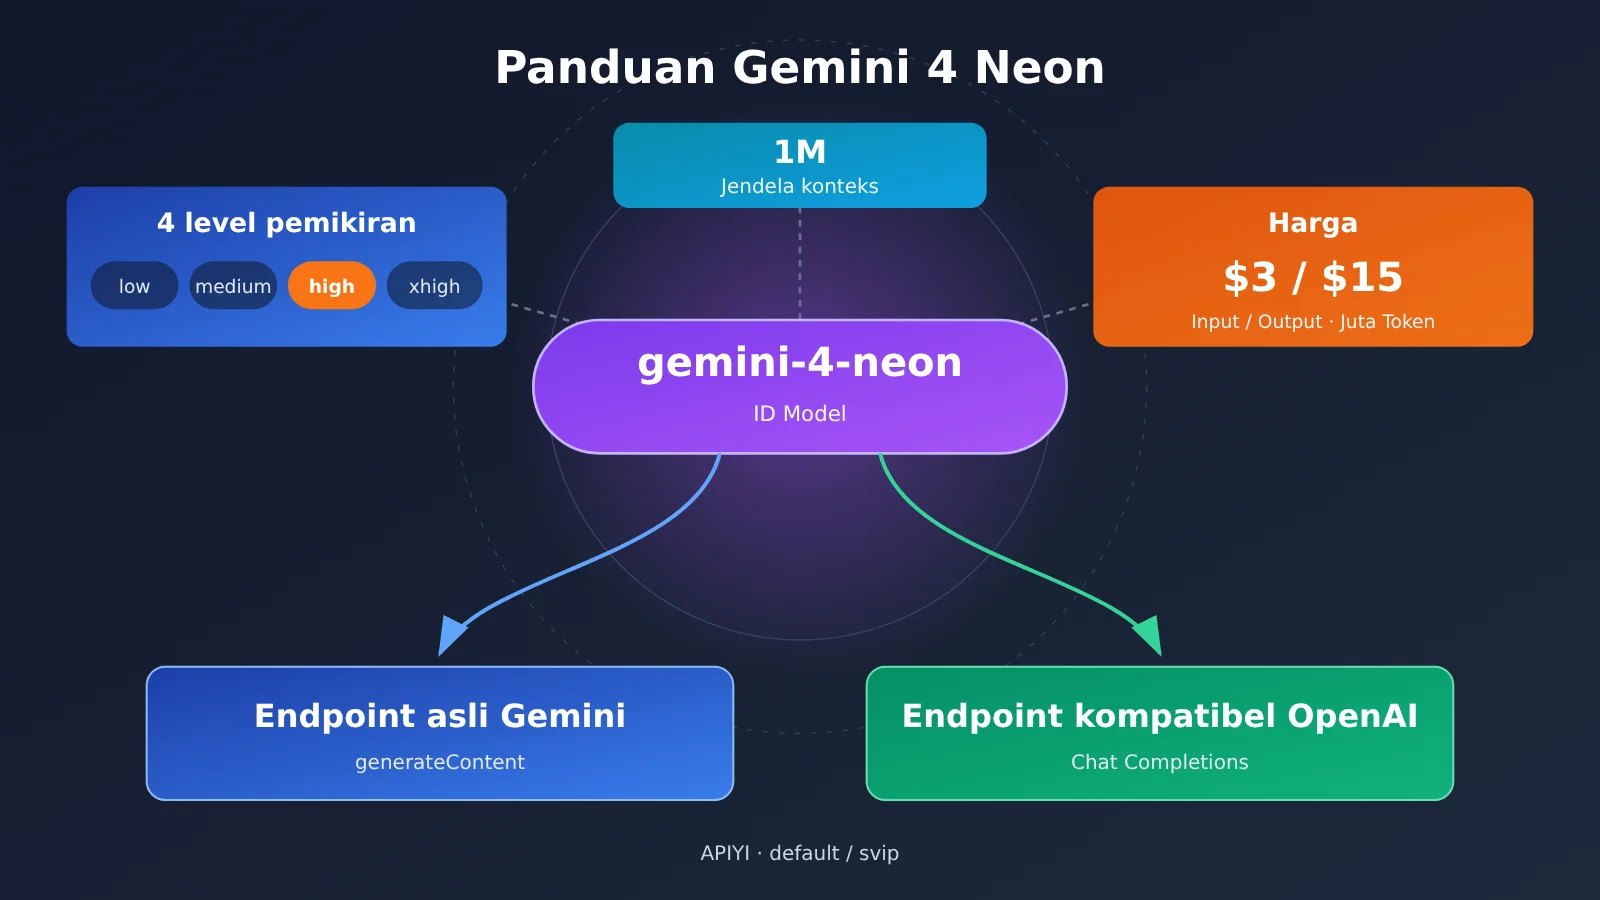
Ringkasan singkat: Gemini 4 Neon dirilis oleh Google pada 18 November 2026; APIYI meluncurkannya di grup default/svip pada 20 November; ID modelnya gemini-4-neon; harga resminya $3 per juta Token input, $15 output, dan $0.15 baca cache. Jika Anda memerlukan kontrol tingkat pemikiran native, utamakan endpoint native Gemini; jika hanya ingin mengganti model pada klien OpenAI yang sudah ada, endpoint kompatibel lebih praktis. Namun kedua jalur sebaiknya diuji dulu dengan permintaan terpendek, lalu aktifkan streaming, pemanggilan tool, dan tingkat pemikiran yang lebih tinggi satu per satu.
Ini bukan artikel berita yang sekadar mengutip siaran pers. Parameter, harga, skor benchmark, dan jalur penelusuran masalah di bawah ini mencantumkan sumber serta kondisi penerapannya masing-masing; contoh kode disusun mengikuti dokumentasi resmi. Keterangan peluncuran APIYI menyatakan bahwa sebelum peluncuran, hanya endpoint harga yang diperiksa dan tidak ada pemanggilan aktual. Oleh karena itu, artikel ini tidak akan menyebut endpoint ganda atau pemanggilan tool sebagai “sudah teruji dan berjalan”.
Nilai utama: Setelah membaca artikel ini, Anda dapat memastikan spesifikasi dan dasar penagihan Neon, menulis permintaan minimal untuk jalur native dan kompatibel, memilih tingkat pemikiran berdasarkan hasil pengujian, serta dengan cepat menemukan masalah berdasarkan gejala error.
Istilah yang perlu dipahami sebelum mengintegrasikan Gemini 4 Neon
Konsep-konsep berikut akan sering muncul lagi di bagian selanjutnya. Dengan menyamakan istilahnya lebih dulu, proses investigasi masalah tidak akan mudah membingungkan.
- ID model: string lengkap yang menentukan model dalam sebuah permintaan, pada artikel ini adalah
gemini-4-neon. Huruf besar-kecil dan tanda hubungnya harus disalin persis, jangan disingkat sendiri. - Base URL: alamat root yang dipakai klien untuk merangkai jalur permintaan. Perlu tidaknya menyertakan prefiks versi seperti
/v1bergantung pada SDK yang dipakai; salah konfigurasi di sini adalah penyebab paling umum munculnya 404. - Endpoint native Gemini: menerima protokol
generateContent, cocok untuk skenario yang membutuhkan parameter penalaran native. - Endpoint kompatibel OpenAI: menggunakan format Chat Completions, sehingga klien OpenAI yang sudah ada bisa langsung memakai ulang struktur pesan dasarnya.
- Tingkat penalaran: nilai enumerasi untuk intensitas penalaran model. Neon mendukung
low,medium,high, danxhighsecara native; APIYI menandai secara dinamis bahwa tingkat default adalahhighsaat dirilis. - Tanda tangan penalaran
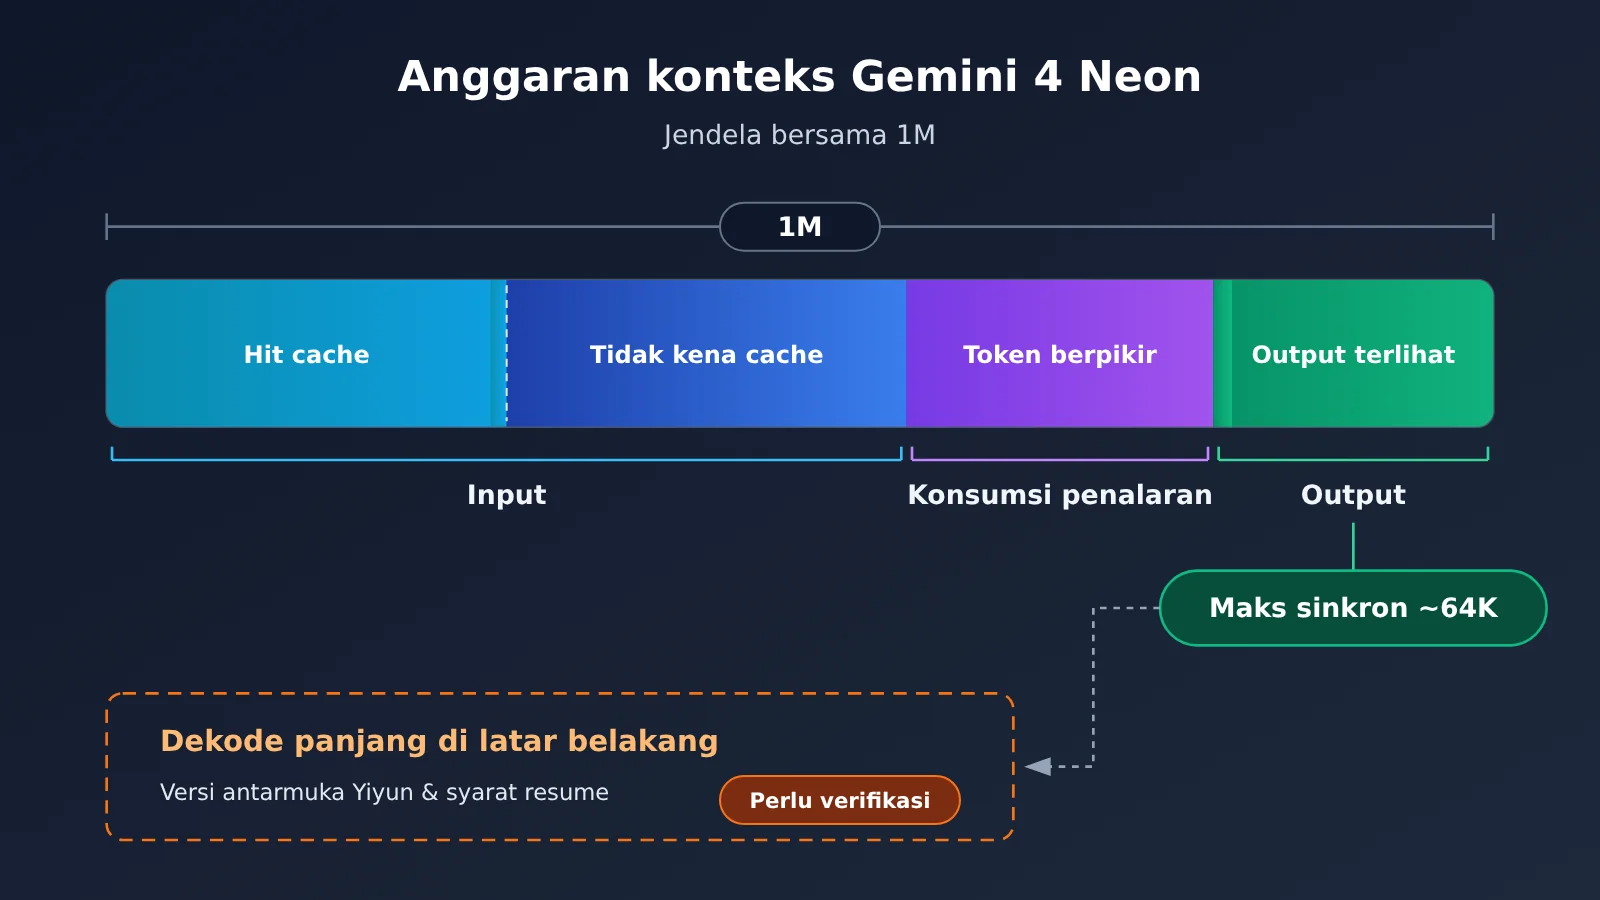
thoughtSignature: penanda konteks yang dikembalikan model. Pada pemanggilan alat multi-putaran, penanda ini wajib dipertahankan dan dikirim balik sesuai protokol aslinya. - Jendela konteks: total anggaran bersama untuk input, penalaran, dan output. Berapa banyak output yang bisa dihasilkan dalam satu generasi sinkron harus diperiksa batas atasnya secara terpisah.
- Harga baca cache: tarif per unit yang berlaku saat memakai ulang input yang sudah ada dan memenuhi syarat, jauh lebih murah daripada harga input standar.
Poin Inti Gemini 4 Neon: Parameter, Harga, dan Grup
Menurut pengumuman peluncuran APIYI, Neon adalah tier menengah dari seri Gemini 4, diposisikan di antara Carbon (untuk tugas tersulit) dan Hydrogen (untuk eksekusi harian). Google merilisnya pada 18 November dan langsung GA di hari yang sama, APIYI mengintegrasikannya pada 20 November.
| Poin | Isi | Sumber & ketentuan |
|---|---|---|
| ID Model | gemini-4-neon |
Registri model APIYI (dibuat 2026-11-20) |
| Grup yang tersedia | default, svip |
Pengumuman peluncuran APIYI (2026-11-20) |
| Endpoint integrasi | Gemini native + kompatibel OpenAI | Pengumuman peluncuran APIYI; belum diuji sebelum rilis |
| Jendela konteks | 1M, dipakai bersama oleh input/thinking/output | Pengumuman Google dan Artificial Analysis keduanya menyebut 1M |
| Batas generasi sinkron | sekitar 64K Token | Dokumen peluncuran APIYI |
| Tingkat thinking | low/medium/high/xhigh, default high | Pengumuman peluncuran APIYI |
| Harga (per juta Token) | input $3, output $15, cache read $0.15 | Registri APIYI; pengumuman menyatakan konsisten butir per butir dengan situs resmi, tanpa tanggal kedaluwarsa |
Hubungan jendela konteks dan batas output Gemini 4 Neon
Konteks 1M sering disalahartikan sebagai “bisa menghasilkan 1M sekaligus”. Sebenarnya 1M ini adalah jendela bersama untuk input, thinking, dan output. Menurut dokumen peluncuran APIYI, batas generasi panggilan sinkron sekitar 64K Token, artinya input panjang tidak masalah, tapi jangan berharap satu permintaan sinkron menghasilkan output melebihi besaran tersebut.
Dokumen Google Cloud menyebut kemampuan long decoding latar belakang yang bisa mencapai 1M. Tapi itu bergantung pada versi antarmuka cloud tertentu dan kondisi resume, yang bukan hal yang sama dengan panggilan sinkron biasa. Untuk endpoint Chat Completions yang kompatibel dengan APIYI, saat ini belum ada hasil panggilan nyata long decoding yang bisa diverifikasi. Jika bisnis butuh output super panjang, sebaiknya rancang dulu dengan generasi bertahap, lalu verifikasi long decoding secara terpisah.
Bagaimana mengestimasi harga Gemini 4 Neon
Berikut contoh perhitungan berdasarkan harga terdaftar, bukan tagihan nyata. Misalkan satu permintaan input 100K Token, output terlihat 5K Token: biaya input sekitar $0.30, output sekitar $0.075, total sekitar $0.375. Jika 80K input kena cache, bagian ini dihitung dengan tarif $0.15 sekitar $0.012, sisa 20K dihitung dengan tarif $3 sekitar $0.06, biaya input akan turun signifikan.
Bagaimana Token proses thinking dihitung dan dalam kondisi apa cache berlaku, semuanya harus mengacu pada tagihan aktual. Pengumuman peluncuran APIYI juga menyebut, mulai 1 Desember harga terbatas Carbon/Argon berakhir dan kembali ke $4/$20, saat itu harga terdaftar Neon 25% lebih rendah dari keduanya. Ini perbandingan harga dalam pengumuman platform, bukan perbandingan hasil.
Gemini 4 Neon Mulai Cepat: Dua Permintaan Minimal lewat Jalur Native dan Kompatibel
Sebaiknya kirim satu permintaan terpendek di masing-masing jalur dulu. Setelah memastikan ID model, grup, dan routing sudah benar, baru tambahkan fitur lain. Contoh di bawah ini disusun mengikuti dokumentasi resmi Google GenAI SDK dan OpenAI SDK, dan semua kunci memakai placeholder.
| Aspek | Endpoint Native Gemini | Endpoint Kompatibel OpenAI |
|---|---|---|
| SDK yang direkomendasikan | Google GenAI SDK | OpenAI SDK |
| Cara penulisan Base URL | Alamat root platform, ditambah api_version="v1beta" secara terpisah |
Alamat root dengan /v1 |
| Struktur permintaan | contents[].parts[] |
messages[] |
| Tingkat thinking | generationConfig.thinkingConfig.thinkingLevel |
Pemetaan parameter lintas endpoint perlu diuji terpisah |
| Cocok untuk | Butuh kontrol halus atas proses berpikir dan pemanggilan tool multi-putaran | Kode OpenAI yang sudah ada dan ingin cepat beralih |
Contoh Endpoint Native Gemini 4 Neon
Endpoint native memakai alamat root platform, dan prefiks versi diserahkan ke api_version milik SDK. Jangan menuliskan v1beta lagi di Base URL, karena nanti path-nya jadi berulang.
from google import genai
from google.genai import types

client = genai.Client(
    api_key="YOUR_API_KEY",
    http_options=types.HttpOptions(
        base_url="https://api.apiyi.com",  # Alamat root platform APIYI, versi ditentukan oleh api_version
        api_version="v1beta",
    ),
)

resp = client.models.generate_content(
    model="gemini-4-neon",
    contents="用三句话解释什么是上下文窗口",
    config=types.GenerateContentConfig(
        thinking_config=types.ThinkingConfig(thinking_level="medium")
    ),
)
print(resp.text)
Penamaan snake_case di SDK pada akhirnya dipetakan ke field camelCase di body permintaan REST. Kalau mengirim permintaan HTTP langsung, struktur body-nya kurang lebih seperti berikut, dan yang perlu diperhatikan ada dua level:
{
  "contents": [
    { "role": "user", "parts": [ { "text": "用三句话解释什么是上下文窗口" } ] }
  ],
  "generationConfig": {
    "thinkingConfig": { "thinkingLevel": "medium" }
  }
}
Ada dua hal yang perlu diperhatikan. Pertama, thinkingBudget dan tingkat minimal dari versi lama tidak berlaku untuk Gemini 4, jadi hapus saat memigrasikan kode. Kedua, dokumentasi Google mencatat bahwa Gemini 4 mengabaikan temperature dan topP; kalau mengubah dua parameter itu tidak terlihat efeknya, itu memang perilaku yang diharapkan.
Contoh Endpoint Kompatibel Gemini 4 Neon
Endpoint kompatibel cocok untuk proyek yang sudah memakai OpenAI SDK. Di bawah ini hanya menggunakan messages paling dasar, untuk memastikan routing dan grup sudah tersedia.
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1",  # Entri kompatibel OpenAI APIYI
)

resp = client.chat.completions.create(
    model="gemini-4-neon",
    messages=[{"role": "user", "content": "用三句话解释什么是上下文窗口"}],
)
print(resp.choices[0].message.content)
print(resp.choices[0].finish_reason)
Dalam respons, selain teks utama, sebaiknya catat juga finish_reason. Saat teks utama kosong, ini adalah petunjuk pertama. Pada endpoint native, field yang bersesuaian adalah alasan selesai dan rating keamanan di hasil kandidat; saat troubleshooting, keduanya juga perlu dicatat.
Lihat kode wrapper dengan informasi diagnostik
import os
import time
import random
from openai import OpenAI, APIStatusError

client = OpenAI(
    api_key=os.environ["APIYI_API_KEY"],
    base_url=os.environ["APIYI_BASE_URL"],  # Isi alamat entri kompatibel di atas
)

def ask_neon(prompt: str, max_retries: int = 3) -> str:
    """Panggil gemini-4-neon, cetak alasan selesai dan usage untuk memudahkan troubleshooting"""
    for attempt in range(max_retries + 1):
        try:
            resp = client.chat.completions.create(
                model="gemini-4-neon",
                messages=[{"role": "user", "content": prompt}],
            )
            choice = resp.choices[0]
            print("finish_reason:", choice.finish_reason)
            print("usage:", resp.usage)
            if not choice.message.content:
                print("正文为空:检查结束原因、安全状态与输出预算")
            return choice.message.content or ""
        except APIStatusError as e:
            print("status:", e.status_code, "body:", e.response.text)
            # Hanya ulangi untuk rate limit dan gangguan singkat; error lain langsung dilempar
            if e.status_code in (429, 503) and attempt < max_retries:
                delay = (2 ** attempt) + random.uniform(0, 1)
                time.sleep(delay)
                continue
            raise
    return ""

if __name__ == "__main__":
    print(ask_neon("列出三个适合用长上下文的任务"))
🚀 Mulai cepat: Saat membuat token di konsol APIYI apiyi.com, pastikan grup token termasuk
defaultatausvip. Pengguna baru bisa lebih dulu menjalankan dua permintaan minimal di atas masing-masing satu kali dengan kuota uji gratis. Native dan kompatibel memakai Key yang sama; saat beralih endpoint, cukup sesuaikan Base URL dan struktur permintaan.
Cara memilih tingkat pemikiran Gemini 4 Neon
Semakin tinggi tingkatnya, semakin menyeluruh penalaran yang dilakukan, tetapi waktu proses dan biaya juga akan meningkat. Artificial Analysis (AA) dalam Intelligence Index v5.0.1 menguji keempat tingkat Neon secara terpisah, dengan hasil sebagai berikut.
| Tingkat pemikiran | Indeks kecerdasan AA | Rata-rata waktu per tugas | Keterangan |
|---|---|---|---|
low |
44 | sekitar 3,7 menit | mengutamakan kecepatan |
medium |
55 | sekitar 8,3 menit | 11 poin lebih tinggi dari low |
high (default) |
60 | sekitar 14,8 menit | 5 poin lebih tinggi dari medium |
xhigh |
61 | sekitar 21,5 menit | biaya tertimbang sekitar $6,44/tugas evaluasi |
Dari data ini terlihat bahwa dari medium ke high masih ada peningkatan yang jelas, sedangkan dari high ke xhigh hanya bertambah 1 poin indeks, tetapi rata-rata per tugas memakan waktu sekitar 6,7 menit lebih lama. Angka-angka ini berasal dari jalur evaluasi AA, dengan biaya tugas dihitung berdasarkan bobot sembilan pengujian. Untuk skenario seperti membaca dokumen dan tanya jawab interaktif, waktu dan tagihan perlu diukur sendiri; latensi end-to-end, tingkat keberhasilan, dan tagihan aktual di APIYI juga perlu diuji secara terpisah.
Anda dapat menentukan tingkatannya seperti ini: untuk tugas tanya jawab yang sensitif terhadap latensi, mulailah dari low atau medium; ketika membutuhkan penalaran multi-langkah, pertahankan high sebagai default; hanya ketika Anda sudah memastikan pada kumpulan pengujian tetap Anda sendiri bahwa xhigh memberikan peningkatan yang berarti, barulah Anda mengeluarkan waktu dan biaya tambahan untuknya.
Perbandingan Gemini 4 Neon dengan Model Sejenis
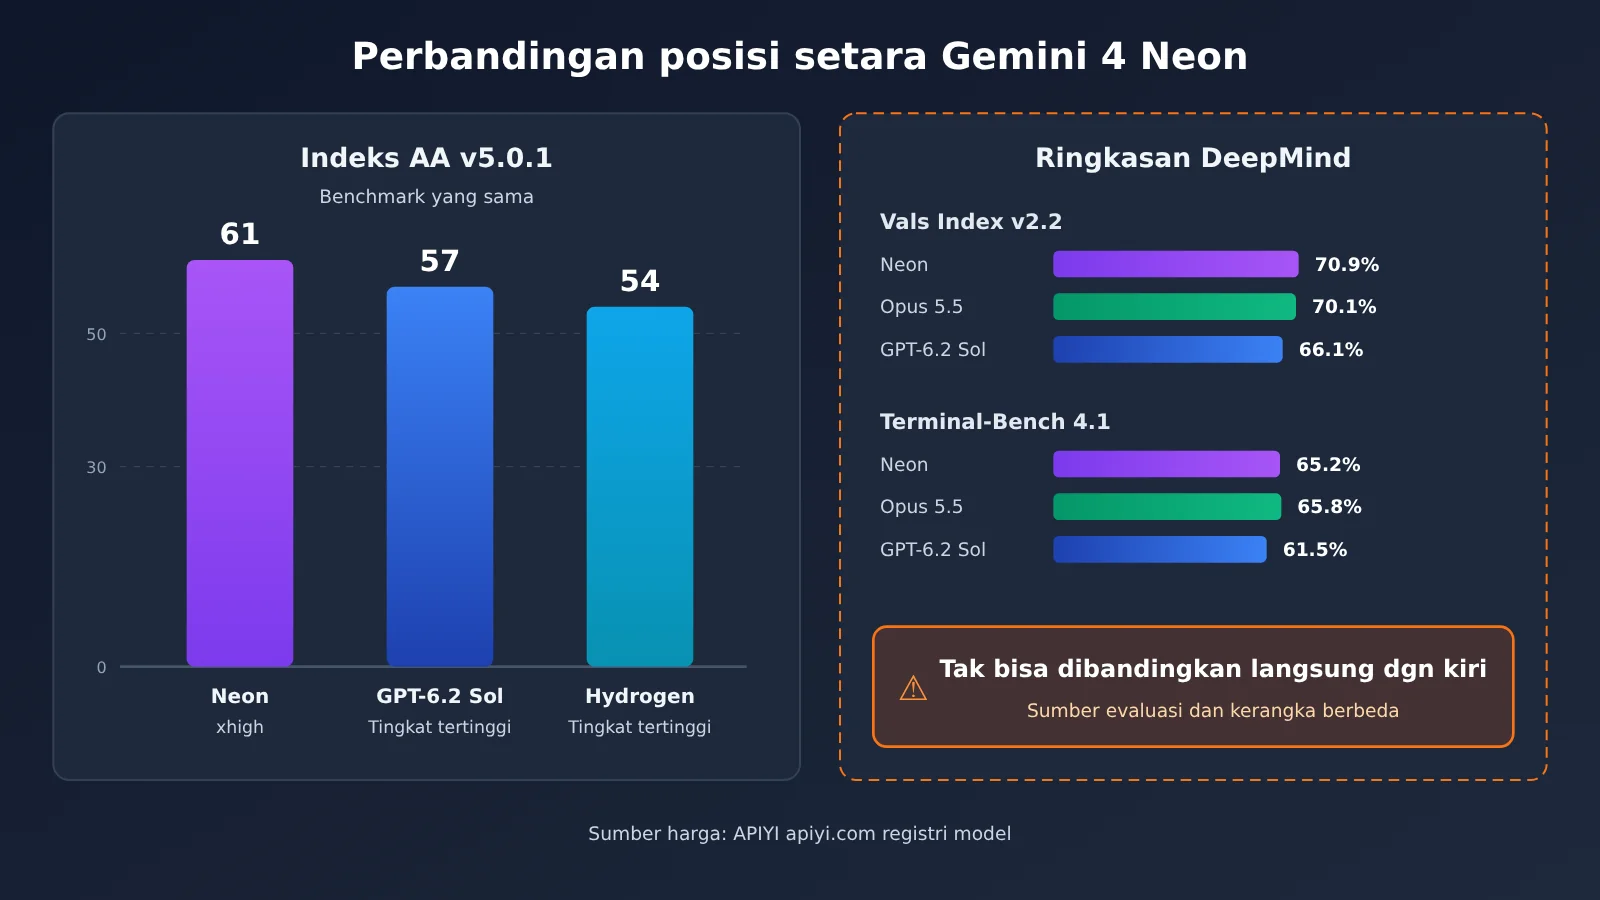
Perbandingan antar-model sebaiknya menggunakan benchmark yang sama dan tier yang setara. Dua kolom pertama pada tabel berikut berasal dari versi AA yang sama, sedangkan harga berasal dari registri APIYI.
| Model | Indeks AA v5.0.1 (tier tertinggi) | Input/Output standar (per sejuta token) | Platform yang tersedia |
|---|---|---|---|
| Gemini 4 Neon | 61 (xhigh) | $3/$15 | APIYI apiyi.com dll. |
| GPT-6.2 Sol | 57 | $2/$10 | APIYI dll. |
| Gemini 4 Hydrogen | 54 | Mengacu pada registri | APIYI dll. |
GPT-6.2 Sol memiliki harga terdaftar yang lebih rendah; baik input maupun output, harganya sepertiga lebih murah daripada Neon. Namun pada benchmark AA yang sama, skor Neon xhigh 4 poin lebih tinggi daripada tier tertinggi Sol. Perlu diingat bahwa selisih skor tidak dapat langsung dikonversi menjadi selisih akurasi bisnis; latensi dan konsumsi token aktual keduanya juga perlu diukur secara terpisah.
Referensi lain adalah ringkasan evaluasi yang dirilis Google DeepMind: pada Vals Index v2.2, Neon 70.9%, Claude Opus 5.5 70.1%, dan GPT-6.2 Sol 66.1%; akurasi yang disesuaikan pada Terminal-Bench 4.1 masing-masing 65.2%, 65.8%, dan 61.5%. Ringkasan ini jelas menggunakan sumber evaluasi dan kerangka kerja yang berbeda; pada Terminal-Bench, Opus 5.5 bahkan sedikit lebih tinggi daripada Neon. Ini bisa menjadi referensi arah, tetapi pemilihan model harus didasarkan pada kumpulan tugas yang sama di toolchain Anda sendiri.
💡 Saran pemilihan: Sebaiknya siapkan 20~50 soal uji tetap yang mewakili bisnis nyata, lalu di APIYI apiyi.com dengan kunci API yang sama, panggil secara berurutan setiap tier Neon dan model kandidat; catat akurasi, waktu eksekusi, dan tagihan sebelum mengambil keputusan.
Pemecahan Masalah Umum Integrasi Gemini 4 Neon
Saat muncul masalah, kembali dulu ke permintaan terpendek di atas sebagai pembanding. Pastikan jalur dasar berfungsi normal, lalu periksa fitur baru satu per satu.
| Fenomena | Pemeriksaan prioritas | Arah perbaikan |
|---|---|---|
| 404 / model tidak tersedia | ID model, grup token, rute, prefiks versi | Salin gemini-4-neon apa adanya; OpenAI SDK menggunakan endpoint kompatibel dengan /v1, GenAI SDK menggunakan alamat root ditambah v1beta; hindari penggabungan prefiks versi berulang |
| 400 / perilaku tidak sesuai setelah mengganti level | parameter thinking native, field body permintaan kompatibel | Di endpoint native, gunakan thinkingLevel untuk memastikan level berlaku; hapus thinkingBudget, minimal; jangan mencampur field dari kedua protokol |
| 200 tetapi body kosong | alasan selesai, status keamanan, anggaran output | Pastikan anggaran output dapat menampung pemikiran dan output yang terlihat sekaligus; periksa informasi filter keamanan |
| Pemanggilan tool gagal pada putaran kedua | thoughtSignature, pasangan pemanggilan tool dan respons |
Kembalikan signature thinking apa adanya, dan pastikan setiap respons tool cocok dengan pemanggilan yang benar |
| 429 / 503 sementara dari upstream | body error, batas kuota token, batasan konkurensi | Saat terjadi rate limit atau ketidaktersediaan jangka pendek, gunakan backoff eksponensial dengan jitter dan jumlah percobaan terbatas; untuk masalah saldo atau izin, perbaiki konfigurasi sebelum mengirim ulang |
Membedakan 404 dan 400 pada Gemini 4 Neon
404 biasanya berarti permintaan tidak dirutekan ke model ini—masalahnya ada pada “tidak ditemukan”: ID salah ketik, grup token tidak mencakup model tersebut, atau URL tersusun dengan jalur berulang seperti /v1/v1/... dan /v1beta/v1beta/.... Sementara itu, 400 berarti permintaan sudah sampai, tetapi body permintaan tidak sesuai protokol; yang paling umum adalah memasukkan field native ke dalam permintaan kompatibel, atau masih memakai parameter lama dari era Gemini 2.x.
Pemetaan parameter lintas endpoint perlu diuji secara terpisah. Jika Anda mencoba mengatur intensitas berpikir di endpoint kompatibel tetapi hasilnya tidak sesuai harapan, kembali dulu ke endpoint native untuk memastikan tingkat tersebut benar-benar berlaku, lalu tentukan apakah masalahnya ada pada parameter atau pada pemetaan.
Body kosong dan kegagalan pemanggilan tool pada Gemini 4 Neon
Saat menerima HTTP 200 tetapi tidak mendapatkan body, langkah pertama adalah memeriksa alasan berhenti. Jika terpotong karena panjang, berarti proses berpikir sudah menghabiskan anggaran output sehingga teks yang terlihat tidak punya ruang untuk dikeluarkan; jika karena alasan keamanan, Anda perlu menyesuaikan isi input. Tingkat berpikir yang tinggi lebih mudah memicu kasus pertama.
Kegagalan pemanggilan tool multi-turn sebagian besar berkaitan dengan thoughtSignature. Menurut dokumentasi Thought signatures dari Google, tanda tangan yang dikembalikan model perlu dibawa kembali apa adanya pada putaran berikutnya sesuai protokol asli, dan setiap pemanggilan tool harus memiliki respons tool yang berpasangan satu-satu. Saat menelusuri masalah, Anda bisa menghapus tool terlebih dahulu, gunakan permintaan tanpa tool yang paling singkat sebagai pembanding, lalu tambahkan tool kembali secara bertahap.
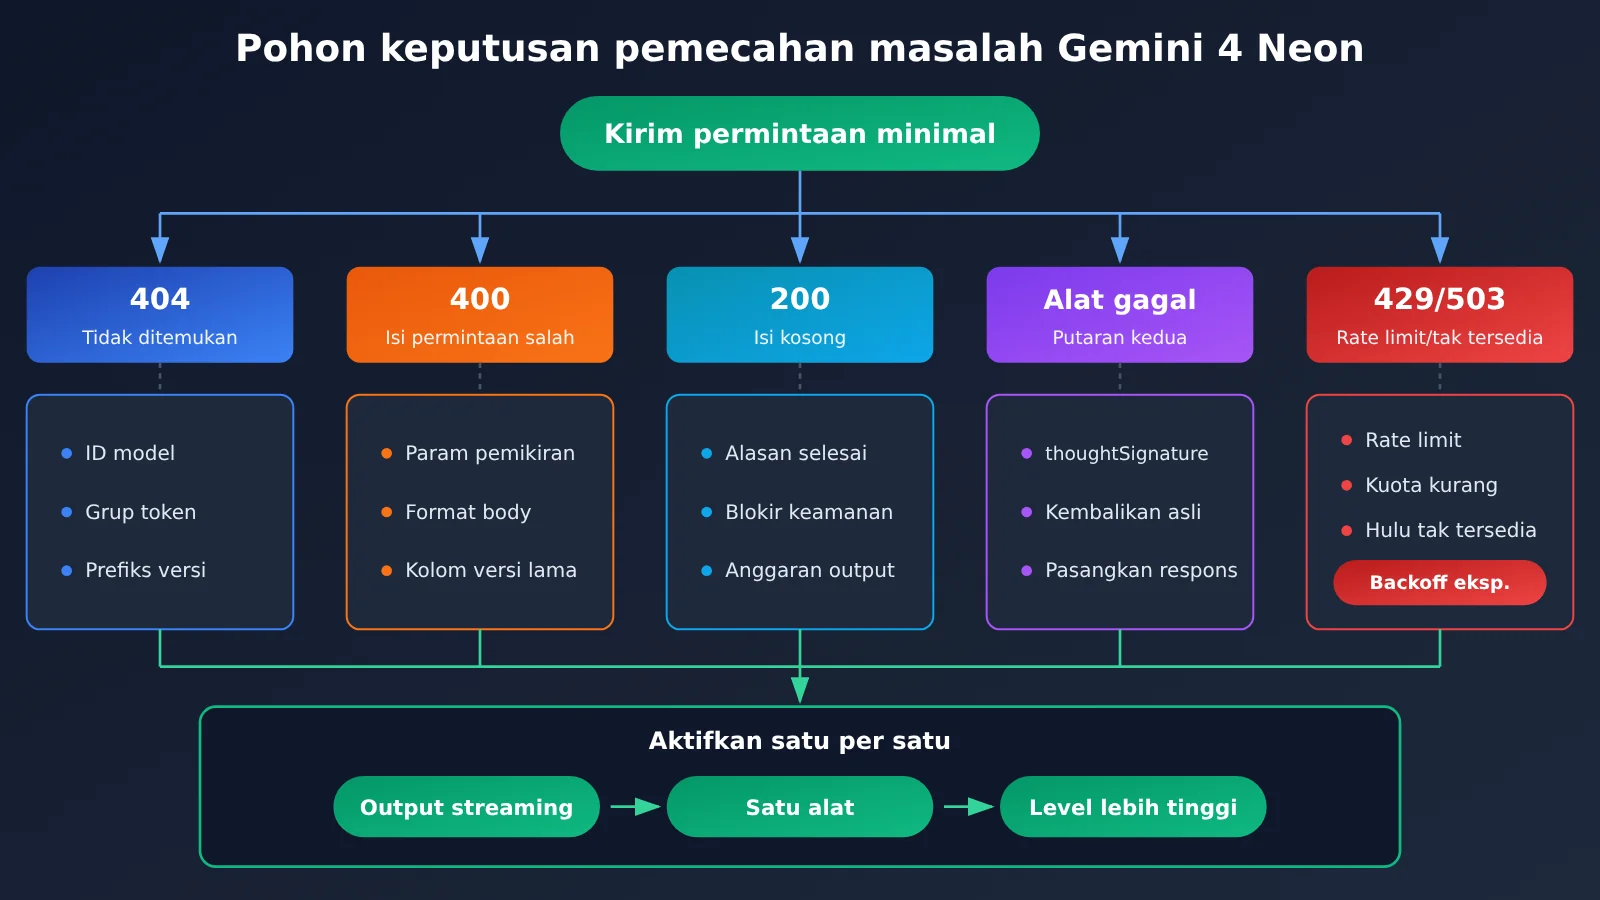
Urutan Validasi yang Direkomendasikan untuk Gemini 4 Neon
Setelah permintaan minimal berhasil, disarankan untuk mengaktifkan fitur satu per satu sesuai urutan berikut, dan konfirmasi hasilnya secara terpisah di setiap langkah:
- Permintaan teks murni non-streaming, tanpa tool, dengan tingkat default — pastikan ID, grup, dan routing berjalan normal.
- Aktifkan output streaming, pastikan penggabungan chunk dan pembacaan alasan berhenti sudah benar.
- Tambahkan satu tool, jalankan dua putaran lengkap “panggilan → kirim balik hasil → jawaban akhir”, lalu periksa apakah
thoughtSignaturetetap dipertahankan. - Beralih antara
low/medium/xhighdi endpoint native, dan bandingkan hasil, waktu proses, serta tagihan menggunakan set pengujian tetap. - Terakhir, tambahkan optimasi terkait biaya seperti input panjang dan penggunaan ulang cache.
FAQ Umum
Q1: Apa itu Gemini 4 Neon?
Gemini 4 Neon adalah model kelas menengah Gemini 4 yang dirilis Google pada 18 November 2026 dan resmi tersedia umum (GA) pada hari yang sama, dengan posisi di antara Carbon dan Hydrogen. Model ini menawarkan konteks bersama 1M dan empat tingkat intensitas berpikir, dengan ID model `gemini-4-neon`.
Q2: Bagaimana memilih antara Gemini 4 Neon dan GPT-6.2 Sol?
Pada benchmark yang sama, AA Intelligence Index v5.0.1, Neon `xhigh` memperoleh 61 poin, sedangkan tingkat tertinggi Sol adalah 57 poin; namun harga resmi Sol adalah $2/$10, lebih rendah daripada $3/$15 milik Neon. Perbedaan skor tidak sama dengan perbedaan akurasi bisnis; disarankan untuk membandingkan hasil, latensi, dan konsumsi Token aktual pada set pengujian Anda sendiri sebelum memutuskan.
Q3: Kapan Gemini 4 Neon dapat digunakan di APIYI?
APIYI meluncurkan model ini pada 20 November 2026, membuka dua grup `default` dan `svip`. Sesuai pengumuman peluncuran, harga standar tidak memiliki tanggal berakhir.
Q4: Skenario apa yang cocok untuk Gemini 4 Neon?
– **Analisis dokumen panjang**: Jendela 1M dapat menampung banyak materi sekaligus, tetapi batas output sinkron per permintaan sekitar 64K.
– **Penalaran multi-langkah dan tugas Agent**: Tingkat default `high` menyeimbangkan hasil dan waktu proses; untuk pemanggilan tool disarankan melalui endpoint native.
– **Pemrosesan batch dengan biaya terkendali**: Gunakan `low`/`medium` ditambah penggunaan ulang cache untuk menurunkan biaya per permintaan.
Q5: Bagaimana cara memanggil Gemini 4 Neon dengan cepat melalui API?
1. Daftar di APIYI apiyi.com dan klaim kuota pengujian gratis.
2. Buat token yang termasuk dalam grup `default` atau `svip`.
3. Kode OpenAI yang sudah ada dapat menggunakan endpoint kompatibel; jika perlu kontrol tingkat berpikir, gunakan Google GenAI SDK untuk mengakses endpoint native.
Untuk kedua jalur, disarankan menjalankan permintaan minimal pada artikel ini terlebih dahulu, lalu menambahkan fitur setelah jalur dipastikan berjalan normal.
Q6: Apa saja keterbatasan Gemini 4 Neon yang diketahui?
– **Batas output**: 1M adalah jendela bersama, batas generasi sinkron sekitar 64K; decoding panjang bergantung pada antarmuka cloud tertentu dan kondisi kelanjutan.
– **Perubahan parameter**: `thinkingBudget` dan `minimal` tidak lagi berlaku; `temperature` dan `topP` akan diabaikan.
– **Status validasi**: Sebelum peluncuran di APIYI, hanya antarmuka penetapan harga yang diperiksa; untuk endpoint ganda dan pemanggilan tool, disarankan untuk memverifikasi terlebih dahulu dengan permintaan Anda sendiri di APIYI apiyi.com.
Poin-Poin Utama Gemini 4 Neon
- Identitas model:
gemini-4-neon, varian menengah Gemini 4, dirilis Google pada 18 November. - Batas spesifikasi: jendela konteks bersama 1M, batas pembuatan sinkron sekitar 64K, decoding panjang perlu diverifikasi terpisah.
- Harga resmi: per juta Token, input $3, output $15, baca cache $0.15; tagihan sebenarnya tetap yang jadi acuan.
- Pilihan tingkat: dalam pengujian AA,
high→xhighhanya menambah 1 poin, tetapi waktu per tugas bertambah sekitar 6.7 menit. - Pilihan endpoint: untuk mengatur tingkat berpikir, pakai endpoint native; untuk memakai ulang kode yang sudah ada, pakai endpoint kompatibel.
- Urutan troubleshooting: mulai dari permintaan paling kecil, lalu aktifkan streaming, tool, dan tingkat yang lebih tinggi satu per satu.
Kesimpulan
Poin-poin penting dalam mengintegrasikan Gemini 4 Neon bisa diringkas jadi tiga:
- Cek spesifikasi dulu: 1M adalah jendela bersama, output sinkron sekitar 64K, harga resmi $3/$15, baca cache $0.15.
- Jalankan sekali di kedua endpoint: endpoint native memakai alamat root ditambah
v1beta, endpoint kompatibel memakai alamat dengan/v1; jangan mencampur field keduanya. - Pilih tingkat berdasarkan data: skor AA hanya referensi, pada akhirnya yang menentukan adalah hasil, waktu, dan tagihan pada set pengujian tetap Anda sendiri.
Setelah memastikan cara integrasi, sebaiknya bandingkan tiap tingkat Neon dan model kandidat lain memakai Key yang sama di APIYI apiyi.com, lalu tentukan konfigurasi default untuk lingkungan produksi.
📚 Referensi
-
Info peluncuran APIYI Gemini 4 Neon: grup, endpoint, harga, dan batas output
- Tautan:
docs.apiyi.com/live/2026-11/gemini-4-neon-launch - Keterangan: Dirilis pada 2026-11-20, berisi informasi empat tingkat penalaran dan tingkat default
- Tautan:
-
Pengumuman resmi Google Gemini 4 Neon: Informasi rilis resmi
- Tautan:
blog.google/innovation-and-ai/models-and-research/gemini-models/introducing-gemini-4-neon/ - Keterangan: Dirilis pada 2026-11-18, berisi penjelasan konteks dan positioning
- Tautan:
-
Halaman model Artificial Analysis Gemini 4 Neon: Evaluasi independen untuk empat tingkat
- Tautan:
artificialanalysis.ai/models/gemini-4-neon - Keterangan: Skor dan durasi Intelligence Index v5.0.1, metrik diperbarui secara dinamis
- Tautan:
-
Google Gemini API Troubleshooting dan Thought signatures: Dokumentasi penanganan masalah dan thought signature
- Tautan:
aistudio.google.com/docs/troubleshooting,aistudio.google.com/docs/thought-signatures - Keterangan: Makna kode error dan aturan pengembalian signature pada pemanggilan tool multi-putaran
- Tautan:
-
Gemini 4 Neon Model Evaluation: Ringkasan evaluasi DeepMind
- Tautan:
storage.googleapis.com/deepmind-media/gemini/gemini_4_neon_model_evaluation.pdf - Keterangan: Hasil evaluasi dari berbagai sumber dan framework; saat mengutip, cantumkan pengaturannya
- Tautan:
Penulis: Tim Teknis APIYI
Diskusi teknis: Jika Anda mengalami masalah selama proses integrasi, silakan hubungi kami melalui situs resmi APIYI. Untuk penjelasan API lainnya, lihat pusat dokumentasi docs.apiyi.com