طرح أحد العملاء مؤخرًا سؤالًا نموذجيًا في مجموعتنا: «نظامنا هذا من نوع images2، أيمكنه توليد مجموعة صور متكاملة للتجارة الإلكترونية؟» الجواب: نعم، لكن ليس عبر استدعاء واحد يُخرج المجموعة كاملة دفعة واحدة. فواجهة gpt-image-2 قائمة على مبدأ «مُوجّه واحد = عملية توليد واحدة»، وإذا أردت مجموعة تتضمن الصورة الرئيسية وصورة نقاط البيع وصورة المشهد وصفحة التفاصيل — كل منها بمحتوى مختلف — فلا بد من إدخال بعض التصميم على طريقة الاستدعاء.
يقسّم هذا المقال مجموعات صور gpt-image-2 للتجارة الإلكترونية إلى مسارين: الأول أن تحمل صورة واحدة معلومات متعددة الأبعاد، وهو مناسب للصور الطويلة في صفحة التفاصيل؛ والثاني أن يستخدم نموذجًا نصيًا أولًا لتفكيك المتطلبات وتوليد مُوجّه لكل صورة، ثم يستدعي gpt-image-2 بالتوازي، وهو المناسب للمجموعات متعددة الصور بالمعنى الحقيقي. بعد القراءة ستكون بحوزتك بنية سير عمل كاملة، وكود قابل للتشغيل، وعدد من الحيل الأساسية للحفاظ على اتساق أسلوب المجموعة بأكملها.
القيد الأساسي في مجموعات صور gpt-image-2: استدعاء واحد يقابل مُوجّهًا واحدًا
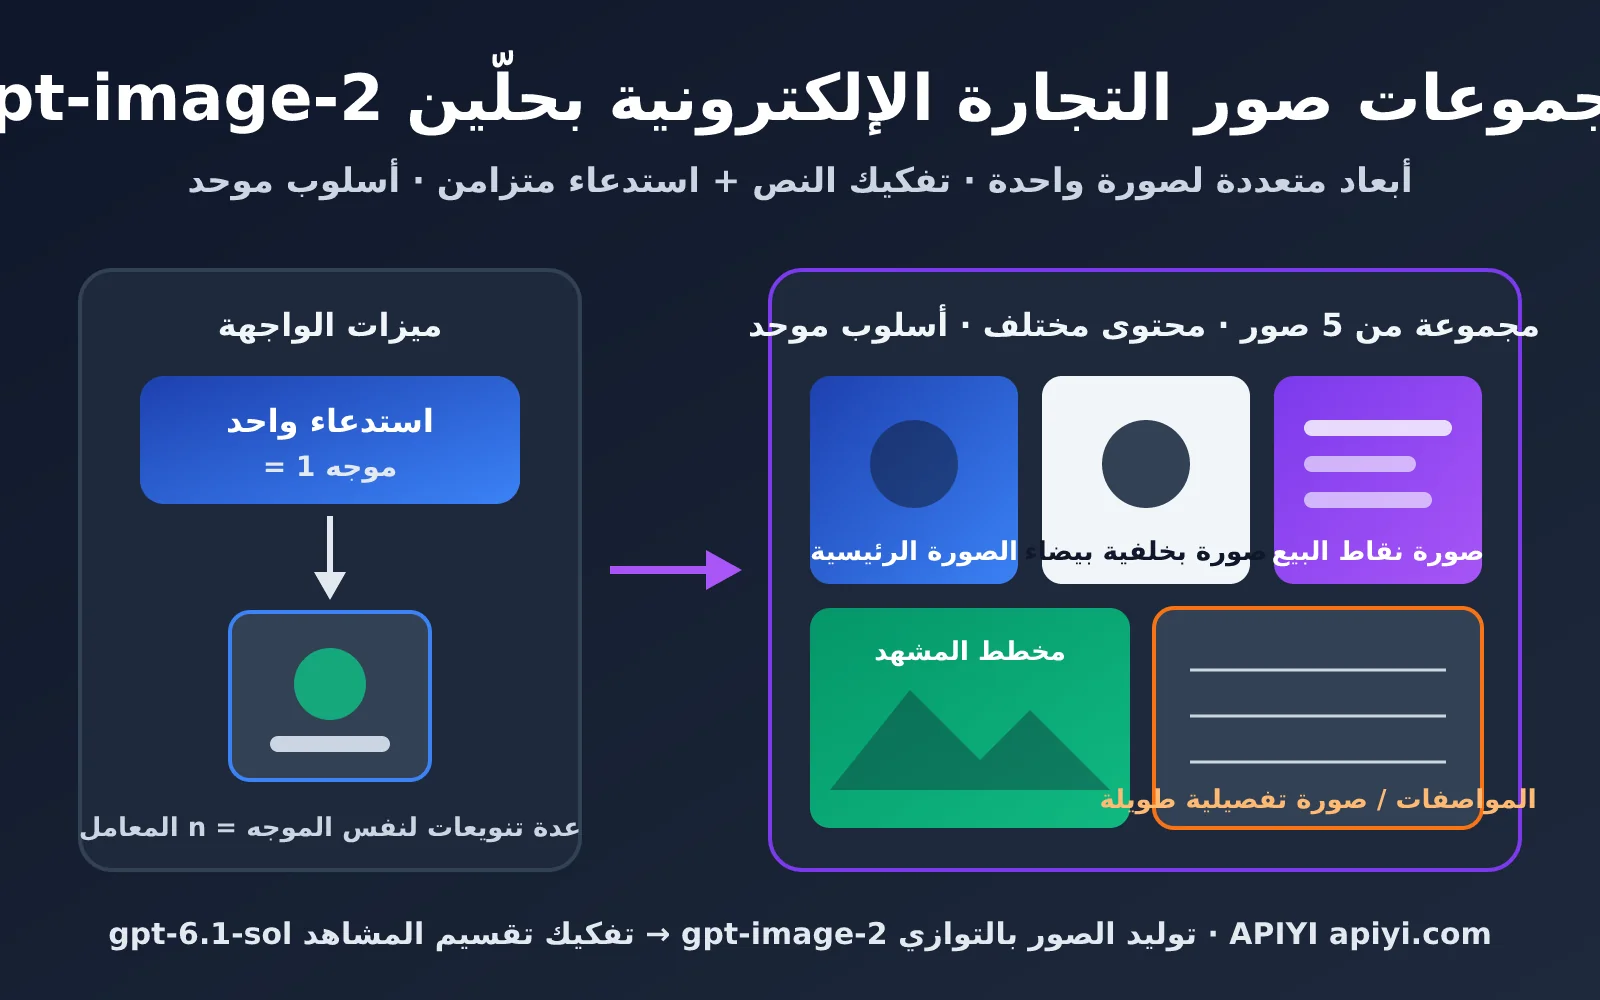
لنوضّح سلوك الواجهة أولًا، فكل تصاميم الحلول اللاحقة تُبنى على هذه الفرضية. تقبل /v1/images/generations و/v1/images/edits في gpt-image-2 مُوجّهًا واحدًا فقط في كل طلب. وتدعم سلسلتا gpt-image-2 و2.5 الرسميتان المعامل n، ويدعمه APIYI بدوره دعمًا كاملًا، لكن معنى n هو «توليد n نسخة من المُوجّه نفسه»، وليس «n مُوجّهًا يُنتج كل منها صورة واحدة».
لذا فإن n=5 يمنحك 5 إصدارات من المشهد نفسه، وهو مناسب لـ«توليد عدة نسخ واختيار أفضلها»، لكنه غير صالح لبناء مجموعة متكاملة. فجوهر مجموعة صور التجارة الإلكترونية هو عدة صور مختلفة المحتوى ومتسقة الأسلوب: الصورة الرئيسية تُبرز المنتج، وصورة نقاط البيع ترافقها نصوص تسويقية، وصورة المشهد تحتاج بيئة استخدام، وصورة المواصفات تحتاج أبعادًا وقياسات. مُوجّه كل صورة مختلف، ومن الطبيعي أن تحتاج إلى استدعاءات متعددة.
التحديات الحقيقية الثلاثة في مجموعات صور gpt-image-2 للتجارة الإلكترونية
بعد استيعاب القيد، ستدرك أن صعوبة بناء المجموعة ليست في «إنتاج عدة صور»، بل في الأمور الثلاثة التالية:
- اتساق العنصر الأساسي: المنتج في الصور الخمس يجب أن يكون المنتج نفسه، فلا يتغير اللون أو الشعار أو التركيب من صورة إلى أخرى.
- اتساق الأسلوب: درجة اللون، والإضاءة، وملمس الخلفية، وطابع الخطوط يجب أن تبدو وكأنها من يد مصمم واحد.
- توزيع المهام المعلوماتية: كل صورة تحمل مهمة تسويقية مختلفة، فلا تصلح خمس صور تتحدث كلها عن نقطة البيع نفسها.
هذه الأمور الثلاثة تحسم أن المجموعة لا تُبنى بـ«رمي جملة واحدة إلى النموذج»، بل تحتاج إلى تخطيط مسبق قبل الاستدعاء. والجدول التالي يوضّح البنية القياسية لمجموعة صور منصات التجارة الإلكترونية الشائعة، ويمكن اعتباره نقطة انطلاق للتخطيط.
| موضع الصورة في المجموعة | الاستخدام الأساسي | النسبة المقترحة | كثافة المعلومات | هل تحتاج نصًا |
|---|---|---|---|---|
| الصورة الرئيسية (الأولى) | معدل النقر في نتائج البحث | 1:1 | منخفضة، مع إبراز المنتج | اختياري، قليل |
| صورة بخلفية بيضاء | متطلبات المنصة والحملات الإعلانية | 1:1 | منخفضة جدًا | لا تحتاج |
| صورة نقاط البيع | إيصال 2-3 نقاط بيع جوهرية | 1:1 أو 3:4 | متوسطة | تحتاج |
| صورة المشهد | خلق أجواء الاستخدام | 1:1 أو 4:5 | متوسطة | اختياري |
| صورة المقاسات/المواصفات | تقليل الاستفسارات والإرجاع | 1:1 | عالية | تحتاج |
| الصورة الطويلة لصفحة التفاصيل | شرح المنتج بالكامل | 9:16 أو أطول | عالية جدًا | تحتاج |
🎯 نصيحة تخطيطية: قبل البدء بكتابة الكود، حدّد وفق الجدول أعلاه عدد الصور التي تحتاجها منصتك والمهمة التي تحملها كل صورة. ننصح بتشغيل 2-3 صور فردية يدويًا على APIYI apiyi.com باستخدام gpt-image-2، للتأكد من أن دقة استعادة المنتج وجودة عرض النصوص تطابق التوقعات، ثم الانتقال إلى سير العمل الجماعي للمجموعة.
الحل الأول: gpt-image-2 لصورة واحدة تحمل معلومات متعددة الأبعاد (صورة طويلة لصفحة التفاصيل)
المسار الأول هو «صورة واحدة تحكي القصة كاملة». يتمتع gpt-image-2 بقدرة قوية على عرض النصوص الصينية وفهم التخطيط، لذا يمكن تمامًا توزيع العنصر البصري الرئيسي والمزايا وجدول المواصفات في مناطق داخل صورة كبيرة عمودية. وبالنسبة لاحتياجات مثل الصور الطويلة لصفحات التفاصيل، وصور تجمع المزايا، والإنفوجرافيك، يكفي استدعاء واحد لإخراج منتج نهائي يحمل قدرًا كبيرًا من المعلومات.
أكبر ميزة في هذا المسار أنه لا يعاني بطبيعته من مشكلة الاتساق. فكل المحتوى موجود في الصورة نفسها ويولّده النموذج دفعة واحدة، لذا تكون درجة اللون والأسلوب موحّدة تلقائيًا، ولا تحتاج إلى كود تنسيق إضافي. أما العيب فهو أن مساحة الصورة الواحدة محدودة؛ فعندما يزداد المحتوى يصبح النص أصغر وأكثر ازدحامًا، كما لا يمكن فصل الصورة إلى صور رئيسية مستقلة للاستخدام في الإعلانات.
طريقة كتابة موجه مقسّم إلى مناطق لصورة تفاصيل طويلة باستخدام gpt-image-2
مفتاح تعدد الأبعاد في صورة واحدة هو وصف المناطق. لا تكتب فقرة طويلة مختلطة، بل اتبع ترتيب التصميم من الأعلى إلى الأسفل وأخبر النموذج بما يجب وضعه في كل منطقة. فيما يلي مثال على بنية موجه لصورة تفاصيل طويلة لمنتج ترمس حراري:
竖版 9:16 电商详情页长图,整体风格:简约北欧风,米白色背景,柔和自然光。
【顶部区域】产品主视觉:一只哑光墨绿色保温杯斜 45 度放置,标题文字“24 小时长效保温”。
【中部区域】三栏卖点,每栏一个线性图标加短文案:“316 不锈钢内胆”“一键弹盖单手开”“500ml 大容量”。
【底部区域】参数表格:容量 500ml、重量 320g、高度 22cm、材质 316 不锈钢。
所有文字使用清晰的无衬线中文字体,不要出现多余文字。
من حيث الأبعاد، يُنصح باستخدام نسبة 9:16 العمودية للصورة الطويلة، مثل فئة 2K 1152x2048. وإذا كنت بحاجة إلى مادة نهائية بدقة أعلى، يمكنك استخدام فئة 4K 2160x3840.
يحتاج حل الصورة الواحدة إلى استدعاء واحد فقط، وهو الأقل تكلفة ويضمن أسلوبًا موحّدًا بطبيعته؛ لكن المقابل هو محدودية سعة المعلومات، فعند تجاوز 5 مناطق يصبح النص عرضة للازدحام، ولا يمكن فصل أجزاء منه لاستخدامها كصورة رئيسية مستقلة في نتائج البحث. وهو الأنسب لصفحات تفاصيل ومجموعات مزايا المنتجات القياسية المعتمدة على المواصفات مثل الأجهزة المنزلية وملحقات الأجهزة الرقمية والمنتجات اليومية.
💡 نصيحة تطبيقية: عندما تتجاوز المناطق 5، يرتفع معدل أخطاء عرض النصوص بشكل واضح. يُنصح بتقسيم الصورة الطويلة إلى 2-3 «صور نصف شاشة» وتوليد كل منها على حدة، ثم دمجها عموديًا في صفحة التفاصيل. هذه الصور النصفية هي بحد ذاتها مجموعة صور صغيرة، ما ينقلك بطبيعة الحال إلى الحل الثاني.
الحل الثاني: تفكيك المطلوب بنموذج نصي + استدعاء gpt-image-2 عدة مرات لتوليد مجموعة صور للتجارة الإلكترونية
إذا كنت تريد مجموعة صور حقيقية متعددة (صورة رئيسية، وصورة مزايا، وصورة مشهد، كل منها مستقلة)، فأنت بحاجة إلى خط إنتاج صغير. الفكرة أن يُوكل إلى النموذج النصي «فهم الطلب وتخطيط اللقطات»، ويُوكل إلى gpt-image-2 «توليد الصور»، مع ربطهما عبر JSON منظم.
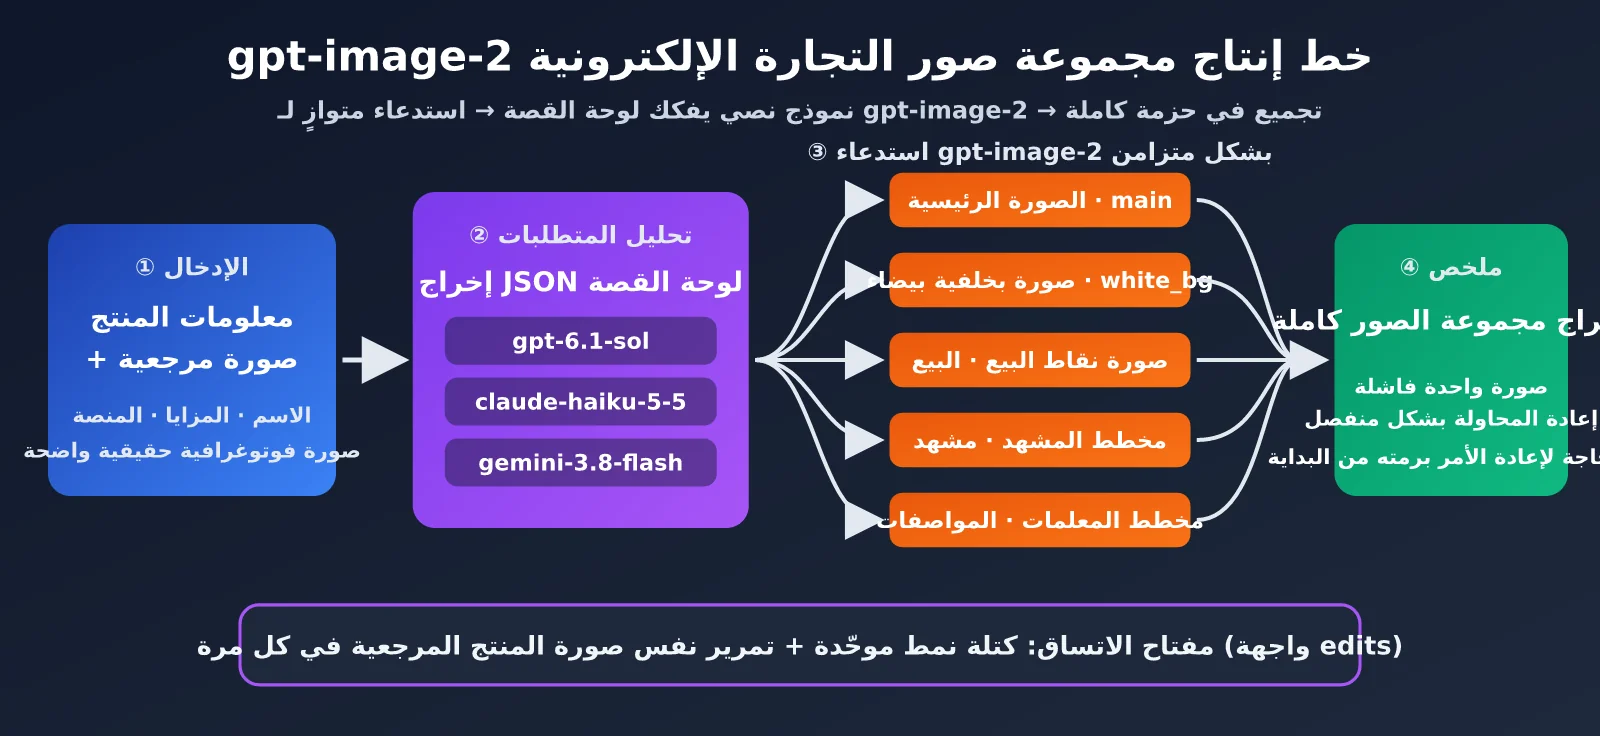
يتكوّن سير العمل الكامل من 4 خطوات:
- المدخلات: يقدّم التاجر اسم المنتج، والمزايا، والمنصة المستهدفة، وصورة واضحة واحدة على الأقل للمنتج الحقيقي.
- تحليل الطلب: يخرج النموذج النصي مصفوفة JSON، كل عنصر فيها هو لقطة لصورة واحدة، ويتضمن الغرض والموجه والأبعاد والنص التسويقي.
- توليد الصور بالتوازي: يمر البرنامج على مصفوفة اللقطات، ويستدعي gpt-image-2 مرة واحدة لكل لقطة، مع تمرير الصورة المرجعية نفسها للمنتج.
- التجميع والتحقق: اجمع كل النتائج، وأعد محاولة الصور الفاشلة بشكل فردي، ثم أخرج مجموعة الصور كاملة بالترتيب.
كيف تختار النموذج النصي: «عقل» مجموعة صور gpt-image-2
متطلبات خطوة تحليل الطلب من النموذج النصي هي: أن يفهم منطق التسويق في التجارة الإلكترونية، وأن يخرج JSON بشكل مستقر، وأن يكتب موجهات ذات حس بصري قوي. حاليًا، عدة نماذج حديثة على APIYI قادرة على ذلك:
| النموذج | التصنيف | السيناريو المناسب | سبب الاختيار |
|---|---|---|---|
| gpt-6.1-sol | الخيار الرائد الموصى به | منتجات عالية السعر، واستخلاص مزايا معقدة | أفضل جودة في النصوص التسويقية وتخطيط اللقطات |
| claude-haiku-5-5 | منخفض التكلفة وسريع | SKU بالجملة، وفئات موحّدة | التزام ثابت بالتعليمات، وإخراج JSON منظم |
| gemini-3.8-flash | منخفض التكلفة وسريع | كميات كبيرة، ومنتجات عابرة للحدود متعددة اللغات | سريع ومنخفض التكلفة، ونصوص متعددة اللغات طبيعية |
تحليل الطلب يُستدعى مرة واحدة فقط لكل مجموعة صور، واستهلاك الرموز (tokens) قليل، لذا تظل التكلفة الأساسية في توليد الصور. نوصي أولًا بضبط قالب الموجه باستخدام gpt-6.1-sol حتى يرضيك، ثم عند التشغيل بكميات كبيرة التبديل إلى claude-haiku-5-5 أو gemini-3.8-flash لخفض التكلفة. النماذج الثلاثة تمر عبر واجهة متوافقة مع OpenAI على APIYI apiyi.com، ولا يلزم عند التبديل سوى تغيير معامل model.
تصميم JSON للقطات مجموعة صور التجارة الإلكترونية باستخدام gpt-image-2
إجبار النموذج النصي على إخراج JSON ببنية ثابتة هو مفتاح تشغيل خط الإنتاج بأكمله باستقرار. فيما يلي تصميم الحقول الموصى به:
| الحقل | النوع | الوصف | مثال |
|---|---|---|---|
scene |
string | معرّف موضع الصورة في المجموعة | main / white_bg / selling |
purpose |
string | المهمة التسويقية لهذه الصورة | إبراز مظهر المنتج ورفع معدل النقر |
prompt |
string | الموجه الكامل المرسل إلى gpt-image-2 | ترمس حراري أخضر مطفي على طاولة خشبية… |
size |
string | أبعاد الإخراج | 2048x2048 |
text_overlay |
string | النص الذي يجب عرضه داخل الصورة | عزل حراري فعّال حتى 24 ساعة |
كود مبسّط لتوليد مجموعة صور باستخدام gpt-image-2
فيما يلي نسخة صغيرة قابلة للتشغيل: اطلب من النموذج النصي توليد اللقطات أولًا، ثم استدعِ واجهة edits في gpt-image-2 لكل لقطة على حدة (مع صورة المنتج المرجعية).
import json, base64
from openai import OpenAI

client = OpenAI(api_key="YOUR_APIYI_KEY", base_url="https://api.apiyi.com/v1")

plan = client.chat.completions.create(
    model="gpt-6.1-sol",
    response_format={"type": "json_object"},
    messages=[{"role": "user", "content": "为墨绿色 316 保温杯规划 5 张淘宝套图,输出 {\"shots\": [...]},"
               "每项含 scene/purpose/prompt/size/text_overlay,统一风格:北欧简约、米白背景、柔和自然光"}],
)
shots = json.loads(plan.choices[0].message.content)["shots"]

for s in shots:
    img = client.images.edit(model="gpt-image-2", image=open("cup.png", "rb"),
                             prompt=s["prompt"], size=s["size"])
    open(f"{s['scene']}.png", "wb").write(base64.b64decode(img.data[0].b64_json))
هذا الكود يعمل بشكل تسلسلي، لذا ستنتظر الصور الخمس واحدة تلو الأخرى. في القسم التالي سنحوّله إلى نسخة متوازية.
كيف تحافظ على اتساق أسلوب مجموعة صور gpt-image-2 للتجارة الإلكترونية
أكثر مشكلة شيوعًا عند الاستدعاء المتعدد أن تبدو الصور الخمس وكأنها من خمسة متاجر مختلفة. يمكن لدمج التقنيات التالية أن يرفع الاتساق إلى مستوى صالح للاستخدام التجاري:
- كتلة أسلوب (style block) موحّدة: اكتب درجة اللون والإضاءة والخلفية ولغة الكاميرا في فقرة نصية ثابتة، وألصقها في نهاية موجه كل لقطة. لا تدع النموذج النصي يكتب وصف الأسلوب بحرية في كل مرة.
- صورة مرجعية ثابتة للمنتج: مرّر الصورة الحقيقية نفسها للمنتج عبر واجهة edits في كل استدعاء، واذكر صراحة في الموجه «حافظ على لون المنتج وشعاره وبنيته دون تغيير كما في الصورة المرجعية». هذا هو الأسلوب الأكثر فعالية لضمان اتساق العنصر الرئيسي.
- معاملات ثابتة: استخدم مستوى
qualityنفسه لمجموعة الصور كاملة، وغيّر الأبعاد فقط عند الحاجة (مثلًا استخدام الوضع العمودي للصورة الطويلة). - استخدام معامل n للاختيار: للموضع الأهم مثل الصورة الرئيسية، يمكنك ضبط
n=2أوn=3لتوليد عدة بدائل، ثم اختيار الأفضل يدويًا. هذا هو الاستخدام الصحيح لمعامل n.
🎯 نصيحة للاتساق: كتلة الأسلوب هي «دليل العلامة التجارية» لمجموعة الصور كاملة. يُنصح ببناء قالب ثابت لكل متجر. عند استدعاء gpt-image-2 عبر APIYI apiyi.com، يمكنك حفظ كتلة الأسلوب في ملف إعدادات، وتشترك فيه كل وحدات SKU، ثم تحدّثه بشكل موحّد عند تغيّر الموسم.
استدعاء متزامن لمجموعة صور التجارة الإلكترونية عبر gpt-image-2: التسريع وزيادة الحجم
عند توليد مجموعة من 5 صور بشكل تسلسلي، فإن زمن الانتظار يساوي مجموع أزمنة توليد كل صورة، وكلما زاد عدد الصور زاد البطء. وبما أن كل لقطة من اللقطات مستقلة ولا تعتمد على غيرها، يمكنك تمامًا استدعاؤها بشكل متزامن، ليقترب زمن إنجاز المجموعة كاملة من زمن «أبطأ صورة» فيها.
لا يضع APIYI أي حد أقصى للتزامن على استدعاءات gpt-image-2، ويمكنك الاستخدام مباشرة تحت 500 RPM دون أي طلب إضافي. وبالنسبة لمعظم المتاجر، حتى لو شغّلت مجموعات صور لعشرات من وحدات SKU في الوقت نفسه، فلن تصل إلى هذا المستوى على الإطلاق.
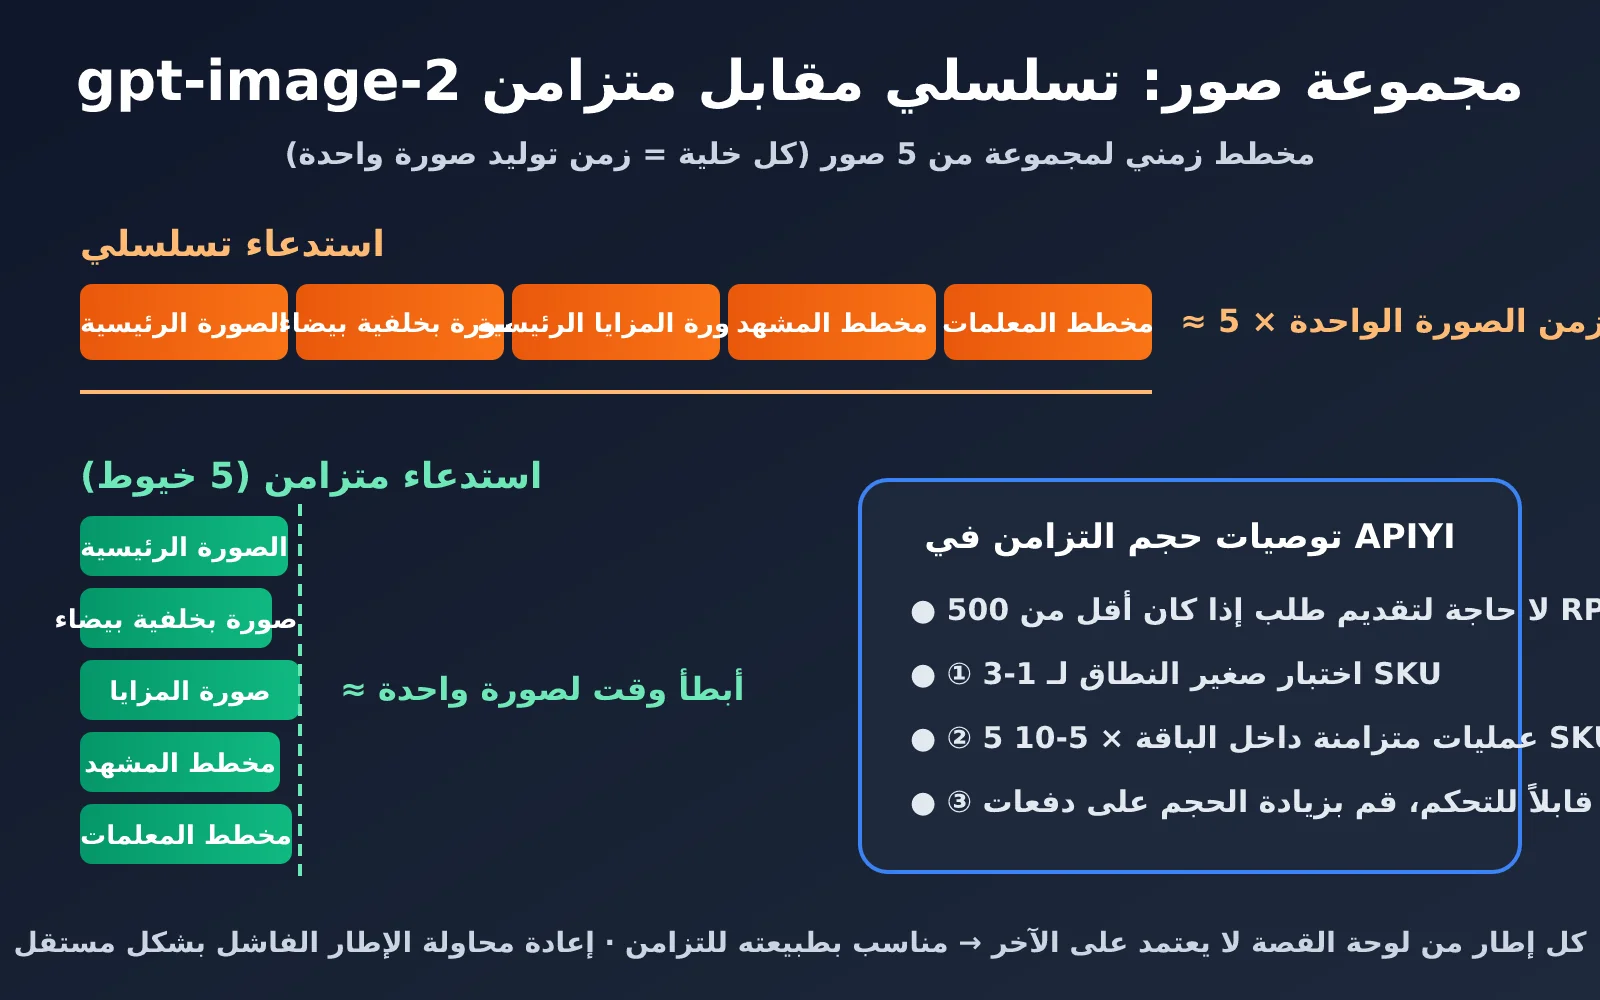
كود التزامن لمجموعة صور gpt-image-2
استبدل حلقة التسلسل أعلاه بمجمّع خيوط (Thread Pool) لتحصل على توليد متزامن للصور، مع إضافة إعادة المحاولة عند الفشل، حتى لا تؤدي صورة واحدة فاشلة إلى إعادة المجموعة كاملة من الصفر:
from concurrent.futures import ThreadPoolExecutor

def gen_one(s, retries=2):
    for i in range(retries + 1):
        try:
            img = client.images.edit(model="gpt-image-2", image=open("cup.png", "rb"),
                                     prompt=s["prompt"] + STYLE_BLOCK, size=s["size"])
            return s["scene"], img.data[0].b64_json
        except Exception as e:
            if i == retries:
                return s["scene"], None

with ThreadPoolExecutor(max_workers=5) as pool:
    results = dict(pool.map(gen_one, shots))
failed = [k for k, v in results.items() if v is None]
عرض النسخة الكاملة من الكود (تشمل كتلة النمط، ومعالجة عدة SKU دفعة واحدة، وإعادة توليد الصور الفاشلة، وحفظ النتائج على القرص)
import json, base64, time
from pathlib import Path
from concurrent.futures import ThreadPoolExecutor
from openai import OpenAI

client = OpenAI(api_key="YOUR_APIYI_KEY", base_url="https://api.apiyi.com/v1")

STYLE_BLOCK = (
    "。整体风格:北欧简约,米白色背景,柔和自然光,低饱和配色,"
    "保持参考图中产品的颜色、Logo 和结构完全不变,文字使用清晰无衬线中文字体。"
)

PLAN_PROMPT = """你是资深电商视觉策划。根据以下商品信息规划一套 {count} 张的{platform}套图。
商品信息:{product}
输出 JSON:{{"shots": [{{"scene": "...", "purpose": "...", "prompt": "...",
"size": "2048x2048", "text_overlay": "..."}}]}}
要求:每张图承担不同营销任务;prompt 只描述画面内容,不要描述整体风格;
需要文字时把文字原文写进 prompt 并用引号标出。"""


def plan_shots(product: str, platform: str = "淘宝", count: int = 5,
               model: str = "gpt-6.1-sol") -> list:
    """استخدام نموذج نصي لتقسيم اللقطات؛ عند العمل بالجملة يمكن استخدام claude-haiku-5-5 / gemini-3.8-flash"""
    resp = client.chat.completions.create(
        model=model,
        response_format={"type": "json_object"},
        messages=[{"role": "user", "content": PLAN_PROMPT.format(
            count=count, platform=platform, product=product)}],
    )
    return json.loads(resp.choices[0].message.content)["shots"]


def gen_one(shot: dict, ref_image: str, retries: int = 2):
    """توليد صورة واحدة، مع إعادة المحاولة بتراجع أُسّي عند الفشل"""
    for attempt in range(retries + 1):
        try:
            with open(ref_image, "rb") as f:
                img = client.images.edit(
                    model="gpt-image-2",
                    image=f,
                    prompt=shot["prompt"] + STYLE_BLOCK,
                    size=shot.get("size", "2048x2048"),
                )
            return shot["scene"], img.data[0].b64_json
        except Exception as e:
            print(f"[{shot['scene']}] المحاولة {attempt + 1} فشلت: {e}")
            time.sleep(2 ** attempt)
    return shot["scene"], None


def gen_image_set(sku: str, product: str, ref_image: str, workers: int = 5):
    shots = plan_shots(product)
    out_dir = Path("output") / sku
    out_dir.mkdir(parents=True, exist_ok=True)
    (out_dir / "plan.json").write_text(json.dumps(shots, ensure_ascii=False, indent=2))

    with ThreadPoolExecutor(max_workers=workers) as pool:
        results = dict(pool.map(lambda s: gen_one(s, ref_image), shots))

    # جولة إضافية لإعادة توليد الصور الفاشلة
    failed = [s for s in shots if results.get(s["scene"]) is None]
    for s in failed:
        results[s["scene"]] = gen_one(s, ref_image, retries=3)[1]

    for scene, b64 in results.items():
        if b64:
            (out_dir / f"{scene}.png").write_bytes(base64.b64decode(b64))
    print(f"{sku}: نجح {sum(1 for v in results.values() if v)}/{len(shots)} صورة")


if __name__ == "__main__":
    gen_image_set(
        sku="cup-green-500",
        product="墨绿色 316 不锈钢保温杯,500ml,24 小时保温,一键弹盖",
        ref_image="cup.png",
    )
ثلاث مراحل لرفع الحجم بشكل متزامن
على الرغم من عدم وجود حد أقصى للتزامن، فإننا ننصح برفع الحجم على مراحل: تحقّق من النتائج أولًا ثم وسّع النطاق، لتجنّب إنتاج مئات الصور غير المطابقة دفعة واحدة:
- اختبار محدود النطاق: اختر 1-3 من وحدات SKU، وشغّلها بشكل تسلسلي أو بتزامن منخفض، ثم افحص يدويًا دقة تمثيل المنتج، وصحة النصوص، واتساق النمط.
- تزامن متوسط: بعد استقرار النتائج، ارفع إلى 5 استدعاءات متزامنة لكل مجموعة مع 5-10 وحدات SKU في الوقت نفسه، وراقب نسبة الفشل ومتوسط زمن التنفيذ.
- التوسع بالجملة: بعد التأكد من أن نسبة الفشل تحت السيطرة، واصل رفع التزامن بحسب حجم العمل، فكل ما دون 500 RPM يمكن تشغيله مباشرة.
| طريقة الاستدعاء | زمن مجموعة من 5 صور | الاستقرار | المرحلة المناسبة |
|---|---|---|---|
| استدعاء تسلسلي | نحو 5 أضعاف زمن الصورة الواحدة | الأكثر استقرارًا وأسهل في التصحيح | مرحلة ضبط الموجهات |
| تزامن داخل المجموعة (5 خيوط) | يعادل تقريبًا زمن أبطأ صورة | مستقر | الإصدارات اليومية |
| عدة SKU + تزامن داخل المجموعة | قريب من زمن مجموعة واحدة | يحتاج إلى إعادة المحاولة | إصدارات الحملات الكبرى بالجملة |
🚀 نصيحة للتوسع: في حالات الإصدار المركّز قبل الحملات الكبرى، نوصي بالاعتماد على APIYI عبر apiyi.com واتباع نمط «عدة SKU + تزامن داخل المجموعة». المنصة لا تتطلب أي طلب إضافي تحت 500 RPM، ومع آلية إعادة توليد الصور الفاشلة يمكن إنجاز مجموعات صور كاملة لعشرات من وحدات SKU في وقت قصير جدًا.
كيف تختار خطة مجموعة صور التجارة الإلكترونية باستخدام gpt-image-2
الخطتان ليستا متعارضتين، بل غالبًا ما تُستخدمان معًا في العمل الفعلي. وفيما يلي توصيات حسب المنصات والسيناريوهات الشائعة:
| المنصة/السيناريو | الخطة المقترحة | عدد الصور المقترح | ملاحظات |
|---|---|---|---|
| الصورة الرئيسية في Taobao/Tmall | الخطة الثانية | 5 صور | صورة رئيسية، وخلفية بيضاء، ونقاط بيع، ومشهد، ومواصفات: صورة لكل منها |
| صفحة التفاصيل في Taobao/Pinduoduo | الخطة الأولى + الخطة الثانية | 3-6 صور نصف شاشة | تُولّد على أجزاء ثم تُدمج عموديًا |
| Listing على Amazon | الخطة الثانية | 7 صور | الصورة الأولى بخلفية بيضاء ومتوافقة تمامًا مع اللوائح، والباقي لنقاط البيع والمشاهد |
| صفحة منتج في متجر مستقل | الخطة الثانية | 4-6 صور | صور المشاهد ذات وزن أكبر لإبراز هوية العلامة التجارية |
| توصيات Xiaohongshu | الخطة الثانية | 3-6 صور | عمودية بنسبة 3:4، مع التركيز على مشاهد من الحياة اليومية |
| ملصق حملة/مجموعة نقاط بيع | الخطة الأولى | صورة واحدة | معلومات مركزة في صورة واحدة، وكفاءة انتشار عالية |
مبدأ الاختيار الأساسي بسيط: الصور التي ستُعرض أو تُنشر بشكل مستقل، استخدم لها الخطة الثانية؛ والمحتوى الذي يُقرأ متتابعًا داخل صفحة واحدة، استخدم له الخطة الأولى. وإذا لم تكن متأكدًا، ابدأ بالخطة الثانية للصورة الرئيسية وصور المشاهد، ثم استخدم الخطة الأولى لإخراج صورة طويلة تجمع نقاط البيع، فتكون التغطية الأوسع.
💡 اقتراح للجمع بينهما: تستخدم الخطتان النموذج نفسه gpt-image-2 ومفتاح API نفسه. ننصح بتغليف سيري العملين في خدمة واحدة تختار الخطة تلقائيًا حسب نوع المنتج، بحيث يكفي التاجر أن يرفع صورة واحدة للمنتج وبضعة أسطر من نقاط البيع.
الأسئلة الشائعة
هل يمكن لمعامل n في gpt-image-2 توليد مجموعة صور للتجارة الإلكترونية مباشرة؟
لا. تدعم سلسلة gpt-image-2 و2.5 الرسمية المعامل n، كما يدعمه APIYI، لكنه يولّد n نسخة مختلفة من الموجه نفسه. كل صورة في مجموعة صور التجارة الإلكترونية مختلفة المحتوى وتحتاج موجهًا مختلفًا، لذا يلزم استدعاء النموذج عدة مرات. المعامل n أنسب للاختيار الأفضل في موضع حساس مثل الصورة الرئيسية.
ماذا أفعل إذا ظهر المنتج بشكل مختلف في الصور المولدة؟
هذه أكثر مشكلة شيوعًا في مجموعات الصور. الطريقة الأكثر فعالية هي تمرير صورة حقيقية واحدة للمنتج عبر واجهة edits في كل استدعاء، وأن تكتب في الموجه: «حافظ على لون المنتج والشعار (Logo) وبنيته كما في الصورة المرجعية». وفي الوقت نفسه ثبّت وصف الأسلوب في كتلة أسلوب (style block)، ولا تدع نموذج النص يتصرف بحرية. يُفضّل استخدام صورة حقيقية بخلفية نظيفة وإضاءة متساوية كصورة مرجعية، فهذا يعطي أفضل محاكاة.
كيف أتعامل مع أخطاء عرض النص الصيني في الصورة؟
أصبحت قدرة gpt-image-2 على عرض النص الصيني قوية، لكن كلما زاد النص زاد احتمال الخطأ. ننصح بالحد من النص في كل صورة إلى جملتين أو ثلاث جمل قصيرة، ووضع النص الأصلي بين علامتي اقتباس في الموجه. وإذا ظهر خطأ في نص صورة ما، أعد توليد تلك الصورة وحدها دون إعادة المجموعة كاملة.
أي نموذج هو الأكثر توفيرًا لتفكيك النص؟
عند ضبط قالب الموجه استخدم gpt-6.1-sol، فهو الأفضل جودة في التخطيط؛ وبعد استقرار القالب والانتقال إلى التنفيذ بالجملة، يمكنك التبديل إلى claude-haiku-5-5 أو gemini-3.8-flash بتكلفة أقل وسرعة أكبر. تُستدعى هذه الخطوة مرة واحدة فقط لكل مجموعة صور، وتكلفتها أقل بكثير من توليد الصور نفسه. يمكن استدعاء النماذج الثلاثة على APIYI apiyi.com باستخدام مفتاح API نفسه.
هل أحتاج إلى طلب حصة للاستدعاءات المتزامنة؟
لا. لا يضع APIYI حدًا أقصى للاستدعاءات المتزامنة على gpt-image-2، ويمكنك استخدامه مباشرة ضمن 500 طلب في الدقيقة (RPM). ننصح باختبار 1-3 منتجات (SKU) على نطاق صغير أولًا، وبعد التأكد من النتائج ارفع عدد الاستدعاءات المتزامنة تدريجيًا.
الخلاصة
عند توليد مجموعة صور لمتجر إلكتروني باستخدام gpt-image-2، يكمن المفتاح في فهم طبيعة الواجهة البرمجية التي تعمل بمبدأ «استدعاء واحد مقابل موجه واحد». فالمعامل n يحل مشكلة الاختيار بين عدة نتائج، أما مجموعة الصور فهي تحتاج إلى عدة استدعاءات، كل منها بموجه مختلف. وانطلاقًا من هذا المبدأ، يمكن التعامل مع المحتوى الذي يُقرأ بشكل متسلسل، مثل صفحات التفاصيل ومجموعات نقاط البيع، عبر حل الصورة الواحدة متعددة الأبعاد بتوليد واحد؛ بينما تُنجَز الصور التي تحتاج إلى عرض مستقل، مثل الصورة الرئيسية وصور المشاهد، على دفعات عبر خط إنتاج يعتمد على تفكيك المتطلبات بنموذج نصي + الاستدعاء المتزامن.
ويتمحور كلا المسارين حول التحكم في الاتساق: فكتلة الأنماط الثابتة (style block) مع نفس الصورة المرجعية للمنتج هما العاملان الأساسيان لجعل عدة صور تبدو وكأنها خرجت من فريق تصميم واحد. أما من ناحية التزامن، فيمكن الانطلاق بلا قيود عندما تكون السرعة أقل من 500 طلب في الدقيقة (RPM)، والأكثر أمانًا هو اتباع ثلاث خطوات: «اختبار على نطاق صغير ← تزامن متوسط ← إطلاق على دفعات».
نوصي بإتمام خط الإنتاج بالكامل عبر منصة APIYI على apiyi.com، حيث تتولى نماذج gpt-6.1-sol وclaude-haiku-5-5 وgemini-3.8-flash تفكيك المتطلبات، ويتولى gpt-image-2 توليد الصور، مع مفتاح API واحد يربط جميع المراحل، مما يتيح لك بناء خدمة توليد مجموعات صور المتاجر الإلكترونية الخاصة بك بسرعة.
المؤلف: فريق APIYI | متخصصون في مشاركة المعرفة التقنية حول واجهات نماذج اللغة الكبيرة، وللمزيد من دروس ربط النماذج تفضّل بزيارة APIYI على apiyi.com