ملاحظة الكاتب: يشرح هذا المقال الآليات الأساسية للبنية المعتمدة على الأحداث في DeepSeek Super-agent، ويميّز بين وظائف النموذج الأولي المتاح مفتوح المصدر، والحالات الداخلية لدى DeepSeek، والتصورات المستقبلية للبنية. كما يناقش القيمة التي تقدمها الوكلاء الاستباقية للمنتجات والمفاضلات الهندسية المرتبطة بها.
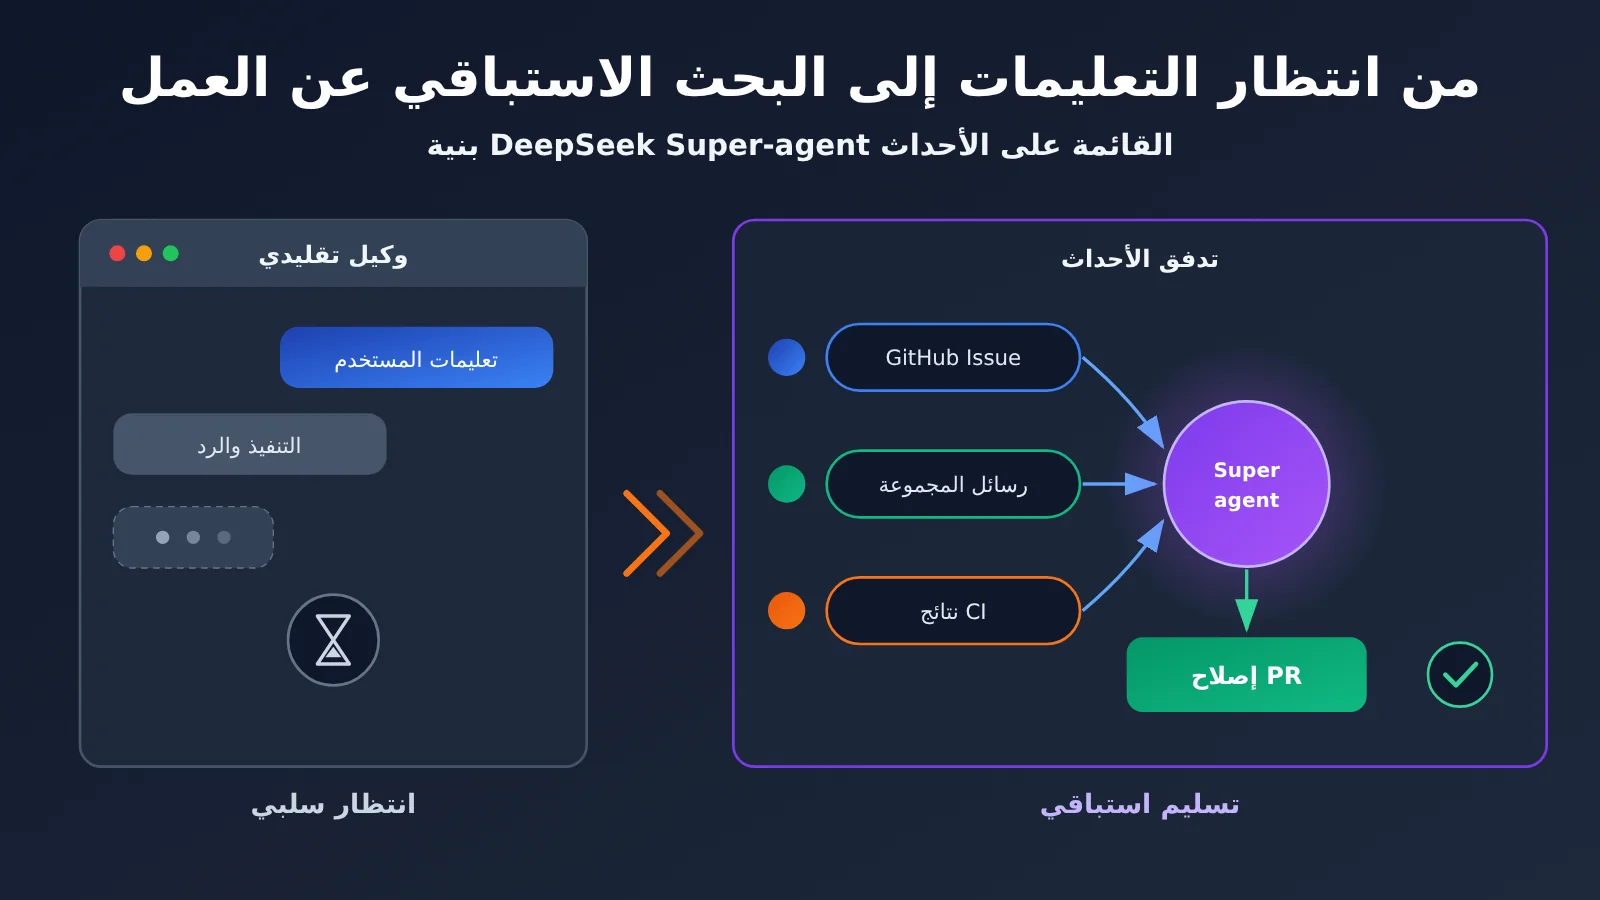
تخيّل مجموعة دردشة لفريق تطوير. يقول أحدهم عابرًا: «صفحة تسجيل الدخول لا تفتح مجددًا على Safari». لا يشير أحد إلى الروبوت، ولا يفتح أحد بلاغًا على Issue. بعد فترة، تتلقى المجموعة إشعارًا موجزًا: أُعيد إنتاج المشكلة، وحُدّد سببها، وأصبح طلب السحب (PR) الخاص بالإصلاح جاهزًا للمراجعة. وفقًا للمقال التقني الرسمي من DeepSeek، فإن «إعادة إنتاج المشكلة وإصلاحها بصمت» أصبحت بالفعل إحدى استراتيجيات العمل في مجموعة الدردشة الداخلية لـ DeepSeek Harness.
هذه ليست قصة عن «ذكاء اصطناعي بدأ يتصرف من تلقاء نفسه». يكمن التغيير الأساسي في DeepSeek Super-agent في قدرة النظام على متابعة الأحداث الخارجية باستمرار، وتحديد المهام والاستعداد لها ضمن صلاحيات وقواعد واضحة، ثم تسليم النتائج في الوقت المناسب. لقد صُمّم التحكم في الصلاحيات والتنفيذ الاستباقي معًا، ولا غنى عن أيٍّ منهما.
ما ستستفيده: بعد قراءة هذا المقال، ستتعرف على 5 آليات أساسية في بنية Super-agent المعتمدة على الأحداث، وستميز بين ما نُفّذ بالفعل في النموذج الأولي مفتوح المصدر وما يقتصر على حالات داخلية أو تصورات مستقبلية للبنية. وستعرف أيضًا كيف تستفيد من هذه الأفكار لتصميم وكلاء أذكياء استباقيين يعملون تحت السيطرة وبأقل قدر من الإزعاج.
نظرة سريعة على المعلومات الأساسية عن DeepSeek Super-agent
قبل الخوض في التفاصيل، يلخّص الجدول التالي المعلومات المعلنة حاليًا عن Super-agent. ومن المهم التمييز بين ما نُفّذ بالفعل وما لا يزال تصورًا، فذلك أساس فهم المشروع.
| البند | التفاصيل | حالة المعلومات |
|---|---|---|
| طبيعة المشروع | استكشاف بنية قائمة على الأحداث تنتقل بالوكيل من الاستجابة السلبية إلى المبادرة | مقال تقني رسمي ووثائق النموذج الأولي مفتوح المصدر |
| مصادر الأحداث (Trigger) | المراسلة الفورية، وبلاغات GitHub، وتعليقات PR، ومراجعات الشفرة، وCI، والبريد الإلكتروني، والتقويم، وأحداث التعاون في المشاريع | يدعم النموذج الأولي المتاح علنًا GitHub أساسًا، مع تكامل اختياري مع Feishu؛ أما البريد الإلكتروني والتقويم فهما جزء من تصور معماري أوسع |
| أنماط قبول المهام | off وobserve وauto |
موثّقة في مستندات التفويض مفتوحة المصدر، والوضع الافتراضي هو observe |
| آلية التفويض | Mandate، ويسجّل مصدر المهمة ومستوى التفويض ونطاقه وإصدار السياسة | موثّقة في مستندات التفويض مفتوحة المصدر |
| المهام غير المتزامنة | تُعاد حالة Started بعد بدء المهمة، ثم يستمر التنفيذ في الخلفية دون تعطيل التفاعل | نُفّذت في DeepSeek Harness، لكنها لم تُفعّل افتراضيًا بعد |
| مثال داخلي | «إعادة إنتاج خطأ برمجي وإصلاحه بصمت» في محادثة جماعية | حالة تشغيل داخلية لدى DeepSeek، ولم يتحقق منها طرف ثالث مستقل |
| أدلة من المجتمع | أبلغ مستخدم في 1 نوفمبر 2026 عن نجاح سير العمل من Issue إلى PR | ظهرت عدة مشكلات في الإعداد أثناء النشر |
ما هي البنية المعتمدة على الأحداث في DeepSeek Super-agent؟
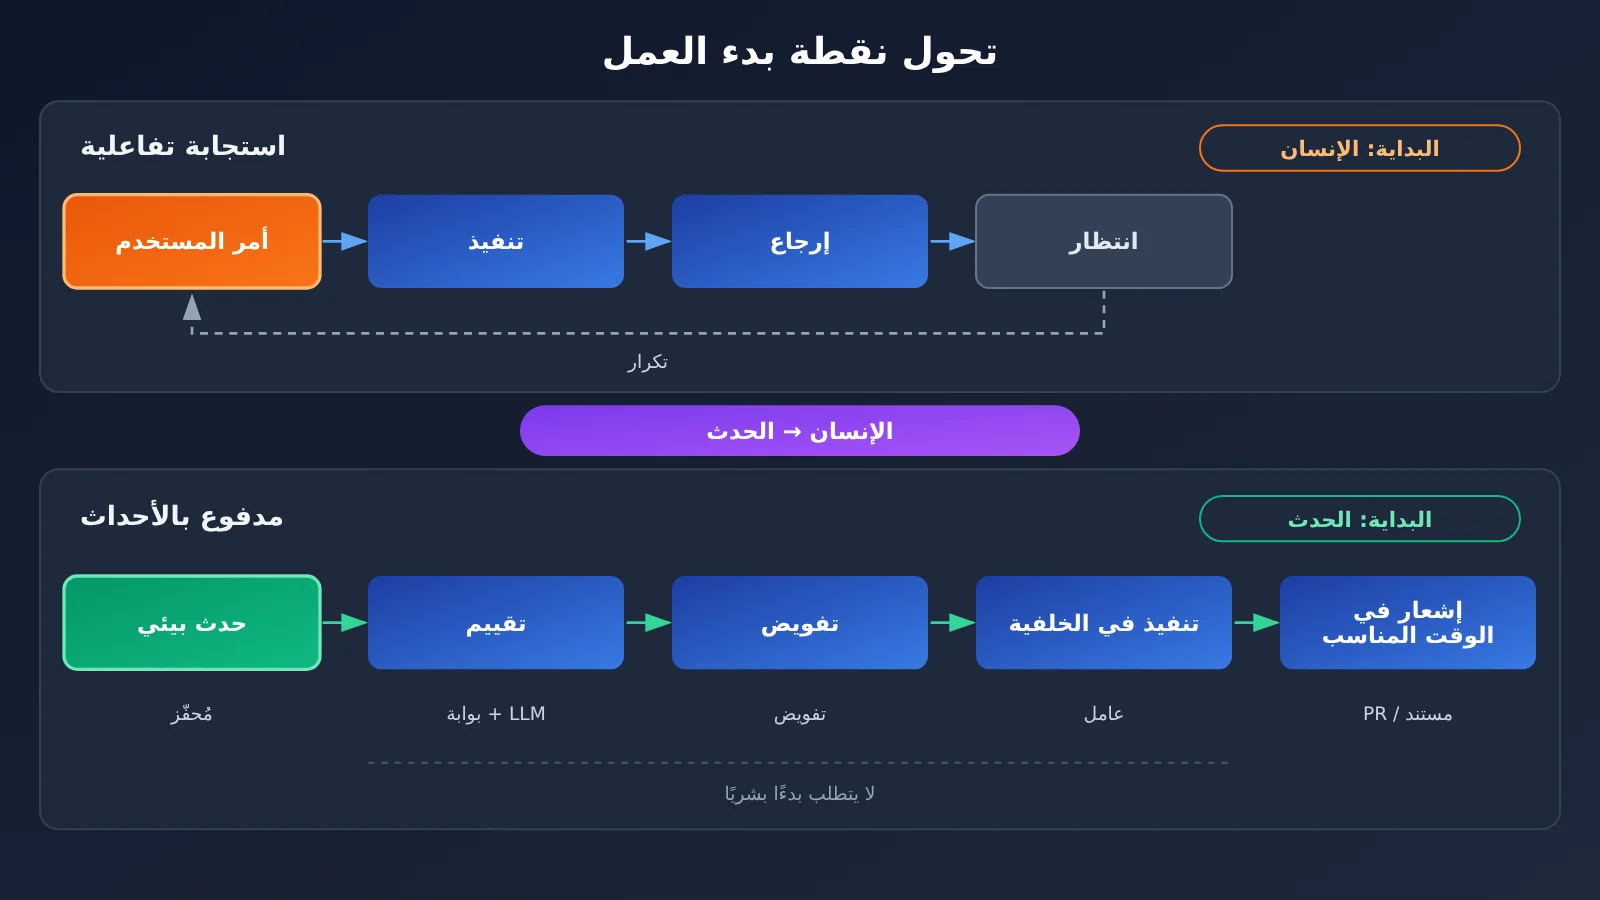
تعمل الوكلاء التقليدية القائمة على المحادثة ضمن حلقة مغلقة: يصدر المستخدم تعليماته، وينفذ الوكيل المهمة، ويعيد النتيجة، ثم ينتظر التعليمات التالية. ومهما بلغت قدرات الوكيل، تظل نقطة البداية محادثة يبدأها المستخدم. لذلك، على المستخدم اكتشاف المشكلة، ووصفها بوضوح، وتذكر العودة للاطلاع على النتيجة.
تعكس فكرة DeepSeek Super-agent هذا المسار. إذ يستقبل النظام أحداث البيئة باستمرار، ويحدد ما إذا كانت تتضمن عملاً يستحق المعالجة، وينشئ المهام وفق الصلاحيات الممنوحة، وينفذها في الخلفية، ثم يُخطر المستخدم في الوقت المناسب. بعبارة أخرى، تصبح بيئة العمل نفسها مصدرًا لمدخلات الوكيل، ولم تعد نافذة المحادثة نقطة الدخول الوحيدة.
| البُعد | الوكيل التفاعلي | Super-agent المعتمد على الأحداث |
|---|---|---|
| نقطة البداية | يبدأ المستخدم المحادثة | حدث في البيئة الخارجية (Trigger) |
| اكتشاف المهام | يكتشف الإنسان المشكلة ويصفها | يتعرف النظام على مؤشرات المهام، ويتولى الإنسان التفويض وقبول النتائج |
| طريقة التنفيذ | غالبًا ما يكون التنفيذ متزامنًا مع انتظار النتيجة | تنفيذ غير متزامن في الخلفية، مع إمكانية التحضير الاستباقي |
| طريقة التسليم | عرض النتائج تدريجيًا في المحادثة | إشعار موجز أو تسليم منظم، مثل طلب سحب (PR) أو مستند |
| طريقة التحكم | تعتمد كل خطوة على تعليمات المستخدم | نمط قبول المهام، ونطاق التفويض (Mandate)، وقواعد الموافقة |
| المخاطر الرئيسية | عبء إداري كبير على الإنسان | التشغيل غير المقصود، وتدفق المهام بكثافة، وتجاوز الصلاحيات، وهجمات الحقن |
دور Trigger في Super-agent
تطلق DeepSeek اسم Trigger على أحداث البيئة الخارجية. فقد تكون رسالة في محادثة جماعية، أو Issue جديدة، أو فشل في بناء CI، بمثابة Trigger. والنقطة المهمة هنا أن Trigger مجرد «مؤشر»، وليس «مهمة» بحد ذاته. أما قرار التصرف فيتحدد في مراحل التصفية والتقييم والتفويض اللاحقة.
كيف يرشّح Super-agent الأحداث: بوابة برمجية وتقييم بنموذج لغوي
تمتلئ بيئات العمل الحقيقية بالضوضاء. فقد تشهد مجموعة للمطورين يوميًا الكثير من الأحاديث الجانبية والرموز التعبيرية والرسائل المتكررة. ولو أُرسلت كل رسالة إلى نموذج لغة كبير لتقييمها، لارتفعت تكلفة الرموز وزمن الاستجابة بسرعة. حل DeepSeek هو الترشيح على مرحلتين: تستبعد قواعد حتمية منخفضة التكلفة معظم الأحداث غير ذات الصلة، ثم يُحال عدد قليل من الأحداث المرشحة إلى النموذج لتقييم معناها.
| مستوى الترشيح | أساس التقييم | هل يُستدعى نموذج لغة كبير؟ | الوظيفة الأساسية |
|---|---|---|---|
| المستوى الأول: البوابة البرمجية (Gate) | مصدر الحدث، وما إذا كان المستخدم مصرحًا له، وما إذا كان الحدث ينتمي إلى مجموعة أو مستودع خاضع للمراقبة، وما إذا كان يذكر الـ Agent صراحةً، وما إذا كان يقع ضمن نطاق الأحداث المحدد في الإعدادات | يُتجنب استدعاؤه قدر الإمكان | استبعاد الأحداث غير ذات الصلة وغير المصرح بها بتكلفة منخفضة |
| المستوى الثاني: تقييم النموذج اللغوي (LLM Assessment) | المحتوى الدلالي للأحداث المرشحة وسياقها | نعم | تحديد ما إذا كان الحدث يشير إلى عمل يستحق المعالجة، مثل مؤشر على عطل |
لنأخذ مثالًا: «صفحة تسجيل الدخول لا تفتح مجددًا في Safari». إذا وردت هذه الرسالة في محادثة مشروع مصرح بها، فقد يتعرف النموذج عليها بوصفها مؤشرًا على عطل. أما إذا كانت مجرد حديث غير ذي صلة، فقد لا يتخذ النظام أي إجراء. يجمع هذا التصميم بين القواعد منخفضة التكلفة والفهم الدلالي الأعلى تكلفة، وهو عنصر أساسي للتحكم في تكلفة الـ Agent القائم على الأحداث.
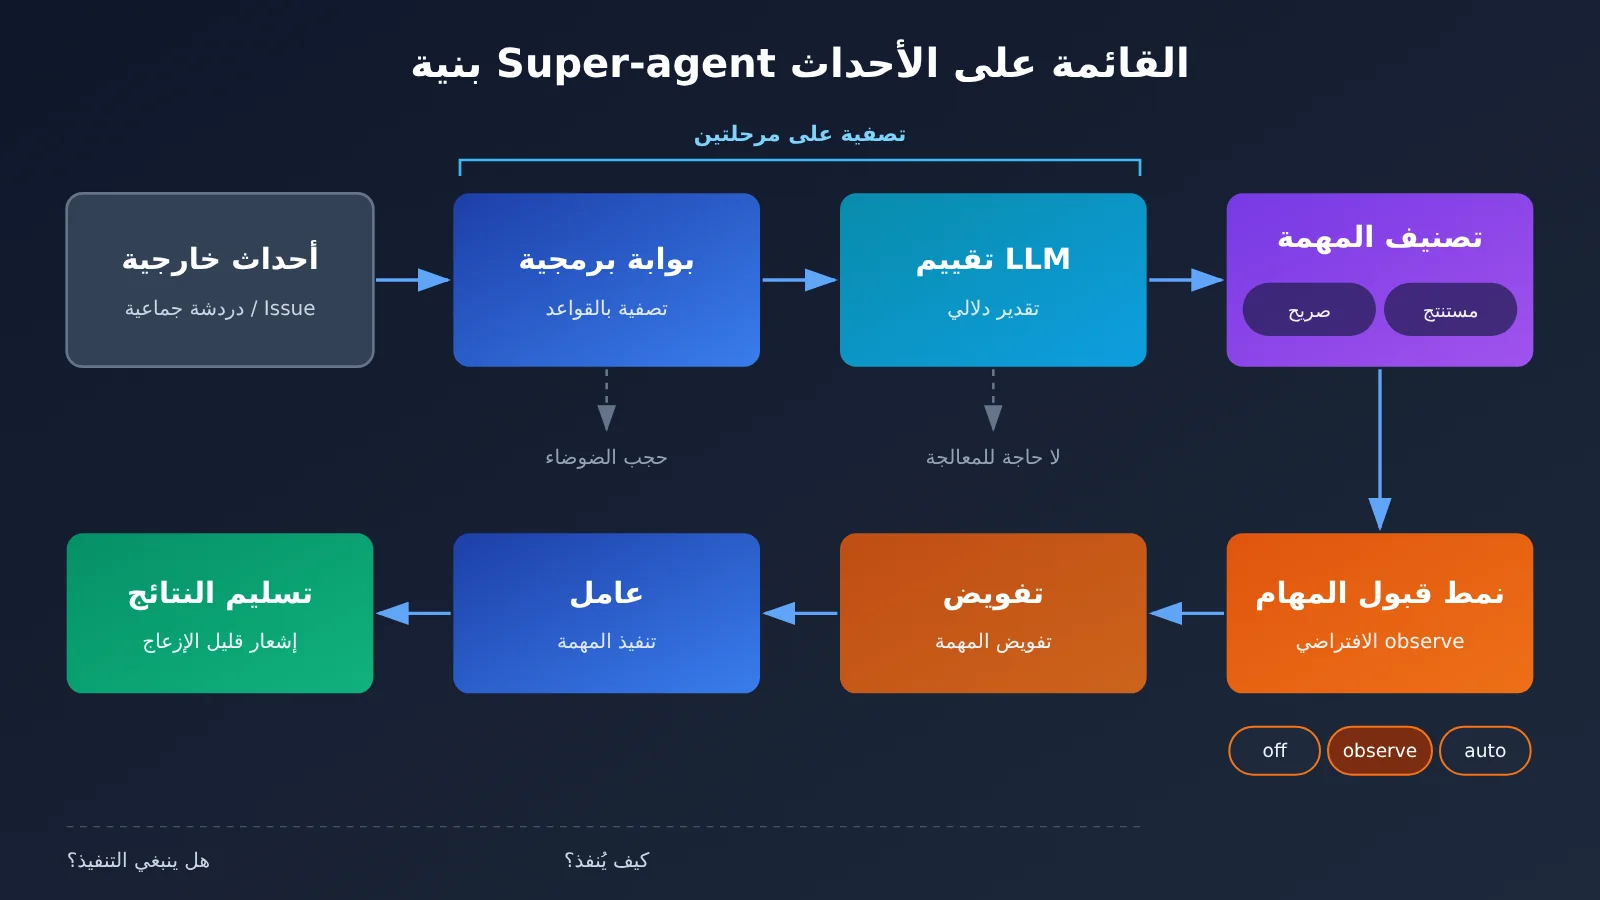
تعتمد طبقتا التقييم الدلالي وتنفيذ المهام في المخطط على واجهات API للنماذج. وعند إعادة بناء بنية مشابهة، يمكن للمطورين استخدام واجهة متوافقة مع OpenAI، مثل APIYI على apiyi.com، للوصول إلى نماذج مختلفة عبر واجهة موحدة، مما يسهّل تهيئتها ومقارنتها بحسب كل طبقة.
Explicit وInferred: الفرق بين الطلبات الصريحة والمهام المستنتجة
تقسّم وثائق التفويض الرسمية لـ DeepSeek المهام إلى نوعين. Explicit تعني طلبًا مصرحًا به صراحةً، مثل أن يطلب مطوّر مخوّل من الوكيل مباشرةً إصلاح خلل في Issue. أما Inferred فتعني مهمة مستنتجة، مثل أن يذكر شخص في نقاش أن «عملية البناء تفشل أحيانًا مؤخرًا»، دون أن يطلب إصلاحها رسميًا، لكن النظام يرى في ذلك مؤشرًا يستحق التحقيق.
الأهم هو أن استنتاج مهمة لا يعني السماح بتنفيذها. تظل مهام Inferred خاضعة لقواعد قبول المهام ونطاق التنفيذ ومتطلبات الموافقة في المؤسسة. ويضمن هذا التمييز ألا يتحول «الاكتشاف الاستباقي» إلى «تصرف دون إذن».
أوضاع Super-agent الثلاثة لقبول المهام: off وobserve وauto
تحدد وثائق التفويض مفتوحة المصدر ثلاثة أوضاع للتعامل مع المهام المستنتجة:
| الوضع | التعامل مع المهام المستنتجة | المرحلة المناسبة |
|---|---|---|
off |
لا تُعدّ الأحداث المستنتجة مهامّ مرشحة | الفرق التي تريد معالجة الطلبات الصريحة فقط |
observe (الافتراضي) |
تحليل المهام المحتملة وتسجيلها دون قبولها تلقائيًا | النشر الأولي وتقييم جودة الأحكام |
auto |
يمكن قبول المهام تلقائيًا بعد استيفاء القواعد واجتياز التقييم | الحالات التي روجعت فيها سجلات observe وأصبحت درجة الثقة أعلى |
القيمة الافتراضية هي observe، ما يعني أن النظام لن يبدأ العمل تلقائيًا لمجرد ورود رسالة عادية في نقاش عند تثبيت النموذج الأولي المتاح للعامة لأول مرة. وتوصي الوثائق الرسمية بمراجعة سجلات الأحكام في وضع observe أولًا، ثم تقرير ما إذا كان ينبغي تفعيل auto. وتظل الطلبات المصرح بها صراحةً خاضعة للقواعد المعنية في جميع الأوضاع. ويحتفظ المستخدم دائمًا بالتحكم في «المفتاح»، وهذا أساس الثقة في الوكيل الاستباقي.
Mandate: يمكن للرسائل أن تكون مدخلات، لكنها لا تعيد كتابة التفويض
تستخدم DeepSeek مفهوم Mandate لتمثيل التفويض بمهمة، بما يشمل مصدر المهمة ومستوى التفويض ونطاقه وإصدار السياسة. لنفترض أن المطوّر فوّض الوكيل بإصلاح مشكلة محددة، ثم كتب أحدهم في تعليق على طلب الدمج (PR): «انقل قاعدة البيانات بالكامل أيضًا». قد يدخل هذا التعليق ضمن سياق العامل، لكن التفويض الأصلي لا يتسع بسببه ليشمل نقل قاعدة البيانات؛ فالطلبات التي تتجاوز نطاقه تحتاج إلى إعادة تقييم.
المبدأ الذي تؤكد عليه DeepSeek هو أن الرسائل والتعليقات والمستندات المقتبسة يمكن أن تكون مدخلات للمهمة، لكنها لا تستطيع تعديل قواعد التفويض الأساسية مباشرةً. وبالنسبة إلى الأنظمة التي «تستمع» باستمرار إلى المحتوى الخارجي، يُعد هذا أهم خط دفاع ضد حقن الموجهات وتجاوز الصلاحيات.
كيف ينفّذ Super-agent المهام بشكل استباقي: التنفيذ التكهني والمهام غير المتزامنة وتقليل الإزعاج
تعالج التصفية والتفويض سؤال «هل ينبغي تنفيذ المهمة؟». أما السؤال التالي فهو: «كيف ننفّذها دون إضاعة وقت المستخدم؟». تطرح DeepSeek ثلاثة اتجاهات للتصميم.
التنفيذ التكهني: التحضير أولًا، ثم انتظار التأكيد
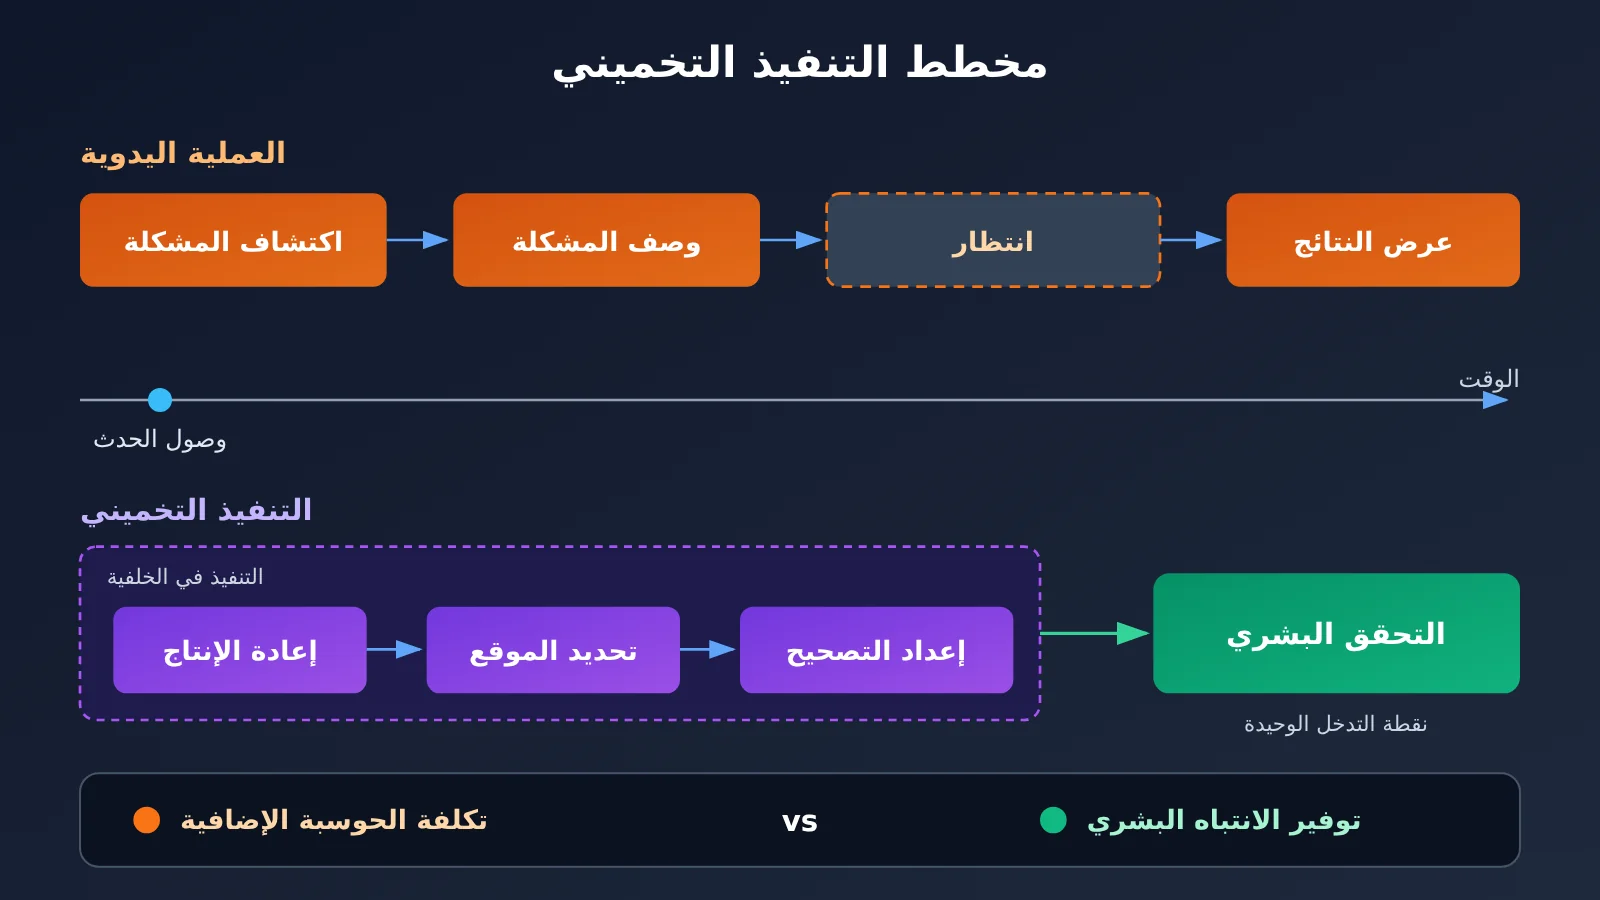
استعارت DeepSeek مفهوم التنفيذ التكهني (Speculative Execution) من معمارية الحاسوب: البدء مسبقًا بأعمال تحضيرية منخفضة المخاطر، حتى قبل التأكد من أن نتائجها ستُستخدم.
- في المساعدة الشخصية: عند وصول دعوة إلى اجتماع، يمكن للوكيل التحقق من جدول المواعيد، وجمع معلومات عن الاجتماع، وتحديد أي تعارض في الوقت، وصياغة رد. لكن إرسال البريد نفسه قد يظل مشروطًا بتأكيد المستخدم.
- في البحث والتطوير: عندما يناقش الفريق خطأً برمجيًا، يمكن للوكيل مراجعة السجلات، ومحاولة إعادة إنتاج الخطأ، وتحديد موضعه في الشفرة، وإعداد إصلاح مقترح، ثم تقديم النتيجة بعد استيفاء قواعد التفويض.
تكلفة هذه الآلية هي احتمال إنفاق موارد حوسبة على عمل لن يُستخدم في النهاية. وترى DeepSeek أن التنفيذ التكهني يكون ذا قيمة فقط إذا تجاوز ما يوفره من وقت انتظار وجهد بشري تكلفة الحوسبة الإضافية. إنها مفاضلة هندسية، وليست كل مهمة تستحق التنفيذ مسبقًا.
حلقة ReAct غير المتزامنة: حتى لا تعيق مهام الخلفية التفاعل
في التنفيذ المتزامن التقليدي، عندما يبدأ الوكيل أمرًا يستغرق وقتًا طويلًا، عليه انتظار نتيجة الأداة قبل أن يتمكن من معالجة رسائل جديدة. أما التصميم غير المتزامن الذي تطرحه DeepSeek فيعيد الحالة Started فور بدء المهمة، ويتركها تعمل في الخلفية دون تعطيل التفاعلات اللاحقة. ثم تدخل نتيجتها إلى النظام مجددًا بوصفها حدثًا جديدًا. وبذلك يمكن للمستخدم طرح أسئلة أخرى أثناء تشغيل المهمة، كما يمكن للنظام إيقاف العمل في الخلفية عندما لا يعود مطلوبًا.
ومن المهم توضيح الحدود هنا: تقول DeepSeek رسميًا إن آلية المهام غير المتزامنة هذه طُبّقت في DeepSeek Harness، لكنها لم تُفعّل افتراضيًا بعد. وللنموذج الأولي المتاح للعامة آليته الخاصة للعامل في الخلفية، لكن لا ينبغي اعتبار التصور الكامل للمعمارية غير المتزامنة ميزة مفعّلة افتراضيًا.
تقليل الإزعاج: الاستباقية لا تعني لفت الانتباه
تدعو وثيقة فلسفة المنتج لدى DeepSeek إلى تقليل استهلاك انتباه الإنسان قدر الإمكان، مع تحقيق أكبر قيمة مفيدة ممكنة. ويتجلى ذلك في عدم الإبلاغ عن كل استدعاء للأدوات، وعدم إغراق المحادثات الجماعية بالرسائل، وعدم عرض جميع خطوات التفكير الوسيطة، والتواصل خصوصًا عند الحاجة إلى قرار أو مراجعة النتيجة وقبولها، والامتناع عن إرسال الرسائل محدودة القيمة.
وتختلف قنوات الإخراج أيضًا: تُستخدم إشعارات موجزة في تطبيقات المراسلة الفورية، بينما تُقدَّم النتائج بصيغة منظمة عبر GitHub والبريد الإلكتروني والمستندات، وتشمل خلفية المشكلة وشرح التعديلات ونتائج التحقق. من منظور المنتج، الاستباقية وتواتر الإشعارات مقياسان مختلفان؛ فالوكيل الذي يرسل تقارير متكررة ليس بالضرورة وكيلًا مفيدًا.
أدلة واقعية على Super-agent: حالات داخلية واختبارات المجتمع
عند تقييم بنية جديدة، من المهم التمييز بين «إمكاناتها» و«وضعها الحالي». لدينا حاليًا نوعان من الأدلة، يختلفان في موثوقيتهما وما يمكن استنتاجه منهما.
الحالة الداخلية لدى DeepSeek توضح إمكانات البنية. ففي محادثة جماعية داخلية لـ DeepSeek Harness، عندما يرد بلاغ عن مشكلة، يتلقى الوكيل الرسالة ويقرر ما إذا كانت تستحق التحقيق، ثم يحاول إعادة إنتاجها في الخلفية ويبحث عن طريقة لإصلاحها. وإذا تأكد من المشكلة ووجد حلًا بسيطًا، يُعدّ طلب سحب (PR) أو يقدمه؛ أما إذا لم يتوصل إلى نتيجة مفيدة، فلا يزعج الفريق. هذه طريقة تشغيل داخلية كشفت عنها الشركة رسميًا، وليست تحققًا مستقلًا من طرف ثالث للنموذج الأولي المتاح للعامة بإعداداته الافتراضية.
اختبار مجتمع GitHub يوضح الوضع الحالي للنموذج الأولي. في 1 نوفمبر 2026، أفاد أحد المستخدمين بأنه نشر النموذج الأولي مفتوح المصدر في بيئة Ubuntu باتباع تعليمات SETUP.md، ونجح في إدخال طلب وارد عبر Issue إلى مسار المعالجة، لينتج عنه في النهاية طلب سحب (Pull Request). لكنه واجه أيضًا مشكلات، منها عدم وصول إشعارات GitHub، وعدم تلقي طلبات العمل رغم ظهور حالة النظام على أنها طبيعية، والحاجة إلى تعديل إعدادات مراقبة Issues والتعليقات في Source، إلى جانب مشكلات توافق ناتجة عن لغة النظام وإعدادات حساب GitHub.
يثبت هذا التقرير أن سلسلة العمل «من الحدث إلى المهمة» قابلة للتنفيذ، لكنه لا يكفي للقول إن المشروع أصبح قادرًا على اكتشاف الأخطاء تلقائيًا وموثوقًا على مدار الساعة. كما أن إنشاء طلب سحب لا يعني أن التغييرات اجتازت المراجعة البشرية ودُمجت بالفعل.
بناء طبقة اتخاذ القرار لوكيل مدفوع بالأحداث باستخدام واجهة API للنموذج
إذا كنت تريد الاستفادة من فكرة Super-agent، فإن أسهل جزء للتطبيق هو طبقة «البوابة البرمجية (Gate) + التقييم بنموذج لغوي (LLM Assessment)». يوضح المثال التالي منطق تقييم الأحداث فقط؛ وهو لا يمثل التنفيذ الرسمي لـ Super-agent، ولا يشكل منتج وكيل متكاملًا.
مثال مبسط
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # واجهة متوافقة مع OpenAI
)

event = "登录页面在 Safari 上又打不开了"
resp = client.chat.completions.create(
    model="gpt-4o-mini",  # راجع قائمة نماذج المنصة لمعرفة اسم النموذج
    messages=[{"role": "user", "content": f"判断以下消息是否为故障线索,只回答 yes 或 no:{event}"}]
)
print(resp.choices[0].message.content)
عرض شفرة التنفيذ الكاملة (Gate + Assessment + وضع قبول المهام)
import json
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

# إعداد بوابة الطبقة البرمجية: قواعد حتمية لا تستدعي النموذج اللغوي
ALLOWED_SOURCES = {"github", "feishu"}
ALLOWED_USERS = {"alice", "bob"}
WATCHED_CHANNELS = {"repo/web-frontend", "group/dev-team"}
MODE = "observe"  # off / observe / auto

def gate(event: dict) -> bool:
    """المرحلة الأولى: تصفية منخفضة التكلفة باستخدام القواعد"""
    return (
        event["source"] in ALLOWED_SOURCES
        and event["user"] in ALLOWED_USERS
        and event["channel"] in WATCHED_CHANNELS
    )

def assess(event: dict) -> dict:
    """المرحلة الثانية: تقييم دلالي بالنموذج يميز بين explicit وinferred"""
    prompt = (
        "你是事件分类器。请判断消息是否包含值得处理的工作,"
        "并区分 explicit(明确请求)或 inferred(推断任务)。"
        '仅输出 JSON:{"actionable": bool, "kind": "explicit|inferred|none", "reason": "..."}\n'
        f"消息:{event['text']}"
    )
    resp = client.chat.completions.create(
        model="gpt-4o-mini",
        messages=[{"role": "user", "content": prompt}],
        max_tokens=200
    )
    try:
        return json.loads(resp.choices[0].message.content)
    except json.JSONDecodeError:
        return {"actionable": False, "kind": "none", "reason": "parse_error"}

def handle(event: dict) -> str:
    if not gate(event):
        return "dropped_by_gate"
    result = assess(event)
    if not result["actionable"]:
        return "ignored"
    if result["kind"] == "explicit":
        return "create_task_with_mandate"   # لا يزال التحقق من نطاق التفويض ضروريًا
    # معالجة المهام المستنتجة وفق وضع قبول المهام
    if MODE == "off":
        return "ignored"
    if MODE == "observe":
        return f"logged_for_review: {result['reason']}"
    return "auto_accept_if_policy_allows"

print(handle({
    "source": "feishu", "user": "alice",
    "channel": "group/dev-team",
    "text": "最近构建有时会失败"
}))
🚀 نصيحة للبدء السريع: عند اختبار طبقة تقييم الأحداث، يمكنك أولًا الحصول على رصيد تجريبي مجاني عبر APIYI على apiyi.com، ثم تجربة نماذج مختلفة بالشفرة نفسها ومقارنة دقة التصنيف واستهلاك الرموز (Tokens)، قبل تحديد إعداد النموذج المناسب لكل طبقة.
فكرة توزيع المهام على طبقات من النماذج
يمكن تلخيص بنية Super-agent كالتالي: حدث خارجي ← تصفية برمجية ← تقييم دلالي بواسطة النموذج ← قرار التفويض ← تنفيذ الوكيل ← تسليم النتيجة. ولا يلزم استخدام النموذج نفسه في جميع الطبقات:
| الطبقة | طبيعة المهمة | طريقة اختيار النموذج |
|---|---|---|
| بوابة التصفية البرمجية | مطابقة المصدر والمستخدم والنطاق | دون استخدام نموذج لغة كبير |
| تصنيف الأحداث | مهام متكررة، ونصوص قصيرة، ومخرجات منظّمة | يمكن اختيار نموذج منخفض التكلفة وسريع الاستجابة |
| التنفيذ المعقّد | إعادة إنتاج المشكلة في الشفرة، وإصلاحها، والاستدلال على سياق طويل | نموذج أكثر قدرة |
| تلخيص النتائج والإشعارات | إعداد الملخصات وتسليم النتائج بصورة منظّمة | يمكن ضبط النموذج بشكل مستقل |
💡 نصيحة للاختيار: لا بد من التحقق مما إذا كان توزيع المهام على طبقات يوفّر المال فعلاً، باستخدام سجلات حقيقية واختبارات عملية؛ فلا يصح افتراض أن تنسيق العمل بين عدة نماذج يقلّل التكلفة بالضرورة. وبفضل الواجهة الموحدة من APIYI على apiyi.com، يمكنك تبديل نماذج كل طبقة بسرعة دون تعديل شيفرة التطبيق، وإجراء مقارنات A/B.
تحليل أثر البنية القائمة على الأحداث في Super-agent
التأثير على فرق البحث والتطوير ومطوري الأتمتة
- نقطة الدخول تنتقل من نافذة الدردشة إلى سير العمل: تصبح تذاكر المشكلات (Issues) وتعليقات طلبات السحب (PR) ونتائج التكامل المستمر (CI) ورسائل المحادثات الجماعية مدخلات طبيعية للوكيل. لذلك يحتاج المطورون إلى تصميم آليات استقبال الأحداث وتصفيتها، لا الاكتفاء بكتابة الموجهات.
- تصميم التفويض يصبح قدرة أساسية: يحدد التمييز بين التفويض الصريح والمستنتج (Explicit/Inferred)، ونمط قبول المهام، ونطاق الصلاحيات الممنوحة (Mandate)، مدى تقبّل الفرق الفعلية للوكيل.
- طرق التقييم تحتاج إلى تغيير: لا يكفي قياس الوكيل الاستباقي بعدد الإجراءات التي ينفذها؛ بل يجب النظر أيضًا إلى جودة اكتشاف المهام، ونسبة إعادة العمل، وعدد الإشعارات غير المفيدة.
التأثير على فرق تطبيقات الذكاء الاصطناعي في المؤسسات
تتيح الوكلاء الاستباقية فرصًا في التعاون على تطوير البرمجيات، واستكشاف الأعطال، وأتمتة عمليات المؤسسات، لكن هيكل التكاليف سيتغير. فتقييم الأحداث يستهلك الرموز باستمرار، وقد ينتج عن التنفيذ الاستباقي عمل لا يُعتمد، كما تحتاج المهام المعقدة إلى مراجعة بشرية. يوضح الجدول التالي إطارًا للتقييم مستندًا إلى البنية الرسمية، وليس مؤشرات أداء رسمية أعلنتها DeepSeek:
| بُعد التقييم | المؤشرات المقترحة |
|---|---|
| جودة اكتشاف المهام | معدل تحديد الأحداث ذات القيمة، ومعدل التشغيل الخاطئ، ومعدل المهام المكررة |
| جودة التنفيذ | نسبة المهام المكتملة، ونسبة إعادة العمل البشري، ونسبة النتائج التي تجتاز المراجعة |
| تجربة المستخدم | عدد مرات التدخل البشري لكل مهمة مفيدة، وعدد الإشعارات غير المفيدة، والوقت من ظهور المشكلة إلى الوصول إلى نتيجة قابلة للاعتماد |
| تكلفة التشغيل | استهلاك الرموز لتقييم كل حدث، وتكلفة النموذج لكل مهمة ناجحة، وتكلفة المهام المنفذة استباقيًا التي لم تُعتمد |
| الحوكمة الأمنية | نسبة حظر المهام غير المصرح بها، وفعالية الموافقات عند النقاط المهمة، ومدى بقاء المعلومات الحساسة ضمن نطاق التفويض |
مخاطر لا بد من مواجهتها
تشمل مخاطر الوكلاء الاستباقية التشغيل الخاطئ، وتدفّق أعداد هائلة من المهام، وتجاوز الصلاحيات، وحقن الموجهات (Prompt Injection)، وهدر الموارد، وتسريب المعلومات. وتقرّ DeepSeek في مقالتها التقنية بأن مسائل عزل السياق داخل المؤسسات المعقدة، والذاكرة طويلة المدى، والاتصال الآمن، والخصوصية، لا تزال بحاجة إلى حلول. وبالنسبة إلى الوكلاء القادرة على الوصول إلى المستودعات الخاصة وبيانات الاعتماد المحلية، يجب تضمين تدابير منع وصول المعلومات الحساسة إلى سياق النموذج أو إلى قنوات خارجية في التصميم قبل النشر.
الأسئلة الشائعة FAQ
س1: ما هي البنية القائمة على الأحداث في DeepSeek Super-agent؟
هي بنية تتيح للوكيل استقبال أحداث البيئة الخارجية (Trigger) باستمرار، ثم تصفيتها برمجيًا وتقييمها بواسطة النموذج، لإنشاء مهام ضمن نطاق الصلاحيات الممنوحة وتنفيذها في الخلفية وإخطار المستخدم عند الحاجة. تتحول نقطة البداية من «أمر المستخدم» إلى «حدث في البيئة»، لكن الصلاحيات والموافقات تبقى تحت سيطرة الإنسان.
س2: هل يعني استنتاج المهام تلقائيًا أن المستخدم يفقد السيطرة؟
لا. يجب أن تلتزم المهام المستنتجة (Inferred) بقواعد قبول المهام ونطاق التنفيذ ومتطلبات الموافقة. ويستخدم النموذج الأولي المتاح للعامة وضع `observe` افتراضيًا، فيسجل المهام المحتملة دون قبولها تلقائيًا. يمكن للمستخدم اختيار `off` لإيقاف استنتاج المهام تمامًا، أو تفعيل `auto` بعد مراجعة السجلات. وتضمن آلية Mandate أيضًا عدم توسيع نطاق الصلاحيات مباشرةً عبر التعليقات أو الرسائل الأخرى.
س3: ما الذي يستطيع النموذج الأولي مفتوح المصدر فعله حاليًا؟
يدعم النموذج الأولي المتاح للعامة GitHub بشكل أساسي، مع تكامل اختياري مع Feishu، ويوفر ثلاثة أوضاع لقبول المهام وآلية Mandate لإدارة الصلاحيات. أبلغ بعض أفراد المجتمع عن نجاح سير العمل من Issue إلى PR، لكن النشر لا يزال يواجه مشكلات مثل عدم وصول الإشعارات وتوافق الإعدادات. أما مصادر الأحداث مثل البريد الإلكتروني والتقويم، والبنية غير المتزامنة الكاملة المفعّلة افتراضيًا، فلا تزال ضمن التصورات الأوسع أو التطبيقات الداخلية.
س4: كيف يمكن التحكم في تكلفة رموز Token للوكيل الاستباقي؟
الأساس هو التصفية على مرحلتين: تحجب بوابة برمجية (Gate) معظم الأحداث غير ذات الصلة دون استدعاء نموذج لغة كبير، ثم تحيل عددًا قليلًا من الأحداث المرشحة إلى النموذج لتقييمها. ويُستخدم التنفيذ الاستباقي بحذر، بحيث يقتصر التحضير المسبق على المهام ذات الفائدة الواضحة. أثناء التطوير، يمكن استخدام إحصاءات الاستهلاك لدى APIYI على apiyi.com لمراقبة تكلفة النموذج لكل تقييم حدث ولكل مهمة ناجحة، ثم تعديل قواعد التصفية وإعدادات النموذج بناءً على ذلك.
س5: كيف يمكن بناء طبقة مماثلة لتقييم الأحداث باستخدام API للنموذج؟
يمكن الاستعانة بمثال هذه المقالة: تتولى البوابة البرمجية تصفية الأحداث وفق القواعد، ويُنتج تقييم نموذج اللغة الكبير (LLM Assessment) نتيجة منظّمة، ثم تُعالج المهام المستنتجة بحسب وضع قبول المهام. يكفي استخدام واجهة متوافقة مع OpenAI لاستدعاء النموذج. بعد التسجيل في APIYI على apiyi.com، احصل على مفتاح API ورصيد تجريبي، وأبقِ قيمة base_url في المثال كما هي مذكورة في المقالة لتشغيله. تجدر الإشارة إلى أن هذا يستلهم فكرة البنية فقط؛ إذ توفر APIYI إمكانات API للنماذج، وليست خدمة Super-agent جاهزة.
س6: ما القيود المعروفة لـ Super-agent حاليًا؟
تشمل أبرز القيود محدودية مصادر الأحداث في النموذج الأولي المتاح للعامة، ومشكلات توافق إعدادات النشر؛ وعدم التحقق المستقل من حالات «الإصلاح الصامت» الداخلية بواسطة طرف ثالث؛ وأن «التشغيل في الخلفية» لا يعني ضمان العمل الموثوق على مدار الساعة؛ وأن طلبات PR المُولّدة لا تزال بحاجة إلى مراجعة بشرية. كذلك، يرى الفريق المسؤول أن عزل السياق داخل المؤسسات والذاكرة طويلة الأمد والخصوصية مسائل لم تُحل بعد.
أبرز النقاط حول DeepSeek Super-agent
- التغيير الأساسي: تنطلق مهام الوكيل من أحداث البيئة بدلًا من تعليمات المستخدم، فلم تعد نافذة المحادثة نقطة الدخول الوحيدة.
- ترشيح على مستويين: تستبعد بوابة برمجية (Gate) الأحداث غير المهمة بتكلفة منخفضة، بينما يتولى تقييم نموذج اللغة الكبير (LLM Assessment) الحكم على المعنى، لتحقيق توازن بين التكلفة والدقة.
- الأولوية للتفويض: تُعالج التفويضات الصريحة (Explicit) والمستنتجة (Inferred) كل على حدة، ويُستخدم وضع
observeافتراضيًا، فيما يمنع نطاق التفويض (Mandate) الرسائل من تغيير الصلاحيات. - التنفيذ الاستباقي: يقلل التنفيذ التخميني والمهام غير المتزامنة وقت انتظار المستخدم، لكن لا بد من موازنة تكلفة الحوسبة مع الفائدة الفعلية.
- تسليم قليل الإزعاج: يقتصر التواصل على الحالات التي تتطلب قرارًا أو مراجعة النتائج؛ فالاستباقية لا تعني كثرة الإشعارات.
- نظرة متأنية إلى الوضع الحالي: تُظهر الحالات الداخلية إمكانات واعدة، وينجح النموذج الأولي مفتوح المصدر بالفعل في تنفيذ المسار من Issue إلى PR، لكنه لا يزال محدود النضج.
- كيفية الاستفادة: يمكن البدء ببناء طبقة لتقييم الأحداث باستخدام واجهات API للنماذج، ومقارنة أداء النماذج المختلفة في التصنيف وتكلفتها عبر APIYI apiyi.com.
الخلاصة
لا تجيب بنية DeepSeek Super-agent القائمة على الأحداث عن سؤال «هل يستطيع الذكاء الاصطناعي اتخاذ القرارات بنفسه؟»، بل عن سؤال «كيف نجعل الوكيل يتولى المهام بصورة استباقية ضمن القواعد والتفويض الممنوح له؟». ويمكن تلخيص آلياتها الأساسية في ثلاث نقاط:
- الرصد والترشيح: تجعل المحفزات (Trigger) بيئة العمل مصدرًا للمدخلات، بينما يحد الترشيح على مستويين من الأحداث غير المهمة وتكلفة الرموز (Tokens).
- التفويض والتحكم: يضمن التمييز بين التفويض الصريح والمستنتج، وأوضاع قبول المهام الثلاثة، ونطاق التفويض (Mandate) ألا تعني الاستباقية تجاوز الصلاحيات.
- التنفيذ والتسليم: ينقل التنفيذ التخميني والمهام غير المتزامنة والإشعارات قليلة الإزعاج دور الإنسان من «إدارة المهام» إلى «اتخاذ القرارات ومراجعة النتائج».
لا تكمن قيمة الوكيل الاستباقي في عدد الإجراءات التي ينفذها، بل في مقدار العمل الإداري الذي يوفره والنتائج الموثوقة التي يقدمها. ولا يزال النموذج الأولي مفتوح المصدر في مرحلة مبكرة، لذا يُناسب البدء بوضع observe لتجميع سجلات التقييم وبناء الثقة تدريجيًا. وإذا كنت تصمم مسارًا مشابهًا لتقييم الأحداث وتنفيذ المهام، فيمكنك استخدام APIYI apiyi.com للتحقق سريعًا من أداء النماذج المختلفة في كل طبقة، ثم المفاضلة بينها بناءً على بيانات أعمال فعلية.
📚 المراجع
- دراسة معمارية DeepSeek Super-agent: شرح تصميم الوكيل القائم على الأحداث والمبادرة
- الرابط:
blog2.eimoon.com/p/deepseek-super-agent-design/ -
التفاصيل: تغطي المشغّلات والتنفيذ التخميني والمهام غير المتزامنة وحالات الاستخدام الداخلية
-
توثيق آلية التفويض في DeepSeek: التفويض الصريح والمستنتج، وأنماط قبول المهام، والتفويض الممنوح (Mandate)
- الرابط:
github.com/deepseek-ai/dsh-superagent-prototype/blob/main/docs/002-authorization.md -
التفاصيل: المصدر المرجعي لفهم الأنماط الثلاثة
offوobserveوauto -
فلسفة تصميم منتجات DeepSeek: مبادئ تقليل الإزعاج ومراعاة انتباه المستخدم
- الرابط:
github.com/deepseek-ai/dsh-superagent-prototype/blob/main/docs/000-philosophy.md -
التفاصيل: تشرح لماذا لا ينبغي للوكيل المبادر أن يلفت الانتباه إلى نفسه باستمرار
-
نموذج المجال في DeepSeek: تعريف مفاهيم المجال الأساسية
- الرابط:
github.com/deepseek-ai/dsh-superagent-prototype/blob/main/docs/001-domain.md -
التفاصيل: مناسب لفهم العلاقة بين المهام والعمّال (Workers) والأحداث بعمق
-
تعليمات إعداد DeepSeek ونشره: دليل تثبيت النموذج الأولي مفتوح المصدر
- الرابط:
github.com/deepseek-ai/dsh-superagent-prototype/blob/main/SETUP.md -
التفاصيل: وثيقة أساسية يجب قراءتها قبل البدء في النشر
-
تقرير مجتمع GitHub عن الاستخدام: تجربة عملية من Issue إلى PR ومشكلات النشر
- الرابط:
github.com/deepseek-ai/deepseek-harness/discussions/11706 - التفاصيل: للتعرّف على حالة تشغيل النموذج الأولي الحالية وحدوده على أرض الواقع
الكاتب: الفريق التقني في APIYI
للتواصل التقني: يُرجى التواصل معنا عبر الصفحة الرئيسية لموقع APIYI. ولمزيد من المعلومات حول دمج النماذج، تفضل بزيارة مركز التوثيق docs.apiyi.com.