Примечание автора: в статье разобраны ключевые механизмы событийно-ориентированной архитектуры DeepSeek Super-agent. Мы разграничим функции уже открытого прототипа, внутренние кейсы DeepSeek и идеи будущей архитектуры, а также обсудим пользу проактивных агентов для продукта и инженерные компромиссы.
Представьте чат команды разработки. Кто-то между делом пишет: «Страница входа опять не открывается в Safari». Бота никто не упоминал, Issue никто не создавал. Через некоторое время в чате появляется короткое уведомление: проблему удалось воспроизвести, причина найдена, PR с исправлением готов и ждёт ревью. Согласно официальной технической статье DeepSeek, такое «тихое воспроизведение и исправление» уже используется как рабочая стратегия во внутреннем групповом чате DeepSeek Harness.
Это не история о том, как «ИИ начал действовать по собственной воле». Главное изменение в DeepSeek Super-agent — система может постоянно отслеживать внешние события, выявлять задачи и заранее готовиться к их решению в рамках чётко заданных прав и правил, а затем выдавать результат в подходящий момент. Контроль полномочий и проактивное выполнение задач изначально проектируются вместе: одно невозможно без другого.
Что вы узнаете: мы разберём 5 ключевых механизмов событийно-ориентированной архитектуры Super-agent, выясним, какие из них уже реализованы в открытом прототипе, а какие пока существуют только в виде внутренних кейсов или архитектурных идей. А ещё посмотрим, как использовать этот подход для создания проактивных агентов, которые работают под контролем и не отвлекают пользователей без необходимости.
DeepSeek Super-agent: главное
Прежде чем перейти к деталям, соберём публично доступную информацию о Super-agent в одной таблице. Обратите внимание на границу между тем, что уже реализовано, и тем, что пока остаётся концепцией: без этого сложно правильно оценить проект.
| Параметр | Детали | Статус |
|---|---|---|
| Назначение проекта | Исследование событийно-ориентированной архитектуры для перехода от пассивно реагирующего агента к проактивному | Официальная техническая статья и документация прототипа с открытым исходным кодом |
| Источники событий (Trigger) | Мессенджеры, GitHub Issue, комментарии к PR, ревью кода, CI, электронная почта, календарь, события совместной работы над проектом | Публичный прототип в основном поддерживает GitHub; интеграция с Feishu доступна опционально. Почта и календарь входят в более широкую архитектурную концепцию |
| Режимы приёма задач | off, observe, auto |
Описаны в документации по авторизации с открытым исходным кодом; по умолчанию — observe |
| Механизм авторизации | Mandate — запись источника задачи, уровня полномочий, области действия и версии политики | Описан в документации по авторизации с открытым исходным кодом |
| Асинхронные задачи | После запуска задачи возвращается Started, выполнение в фоне не блокирует взаимодействие | Реализовано в DeepSeek Harness, но пока не включено по умолчанию |
| Внутренний кейс | «Молчаливое воспроизведение и исправление» бага по сообщению в групповом чате | Пример работы внутри DeepSeek, не подтверждённый независимой стороной |
| Данные сообщества | 1 ноября 2026 года пользователь сообщил об успешном прохождении цепочки Issue → PR | В процессе развёртывания возникло несколько проблем с конфигурацией |
Что такое событийно-ориентированная архитектура DeepSeek Super-agent
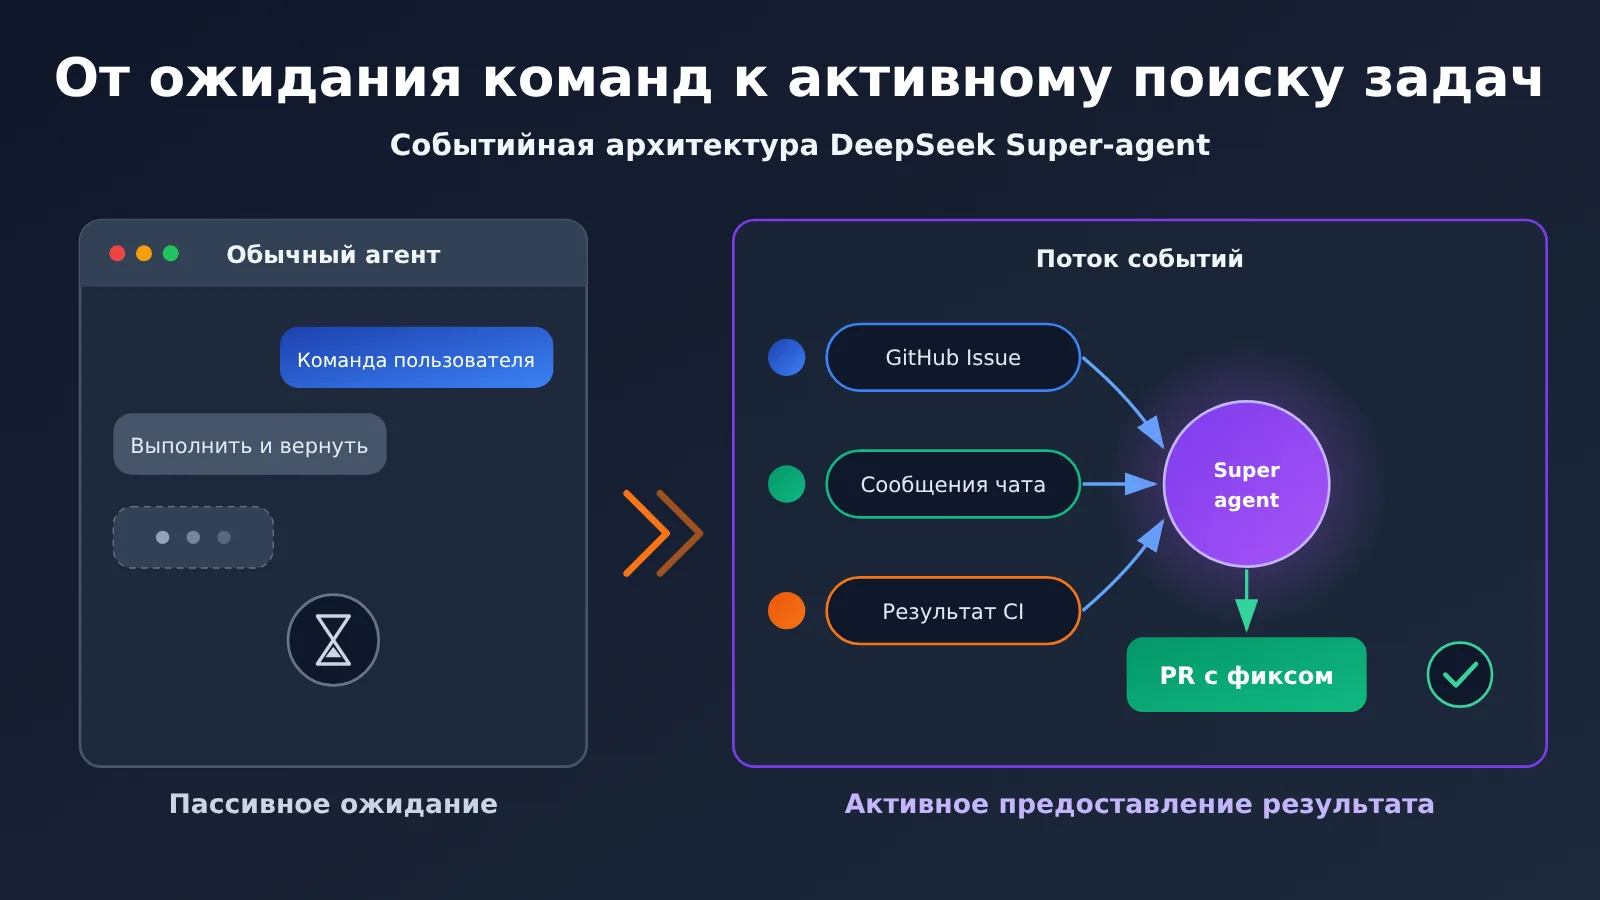
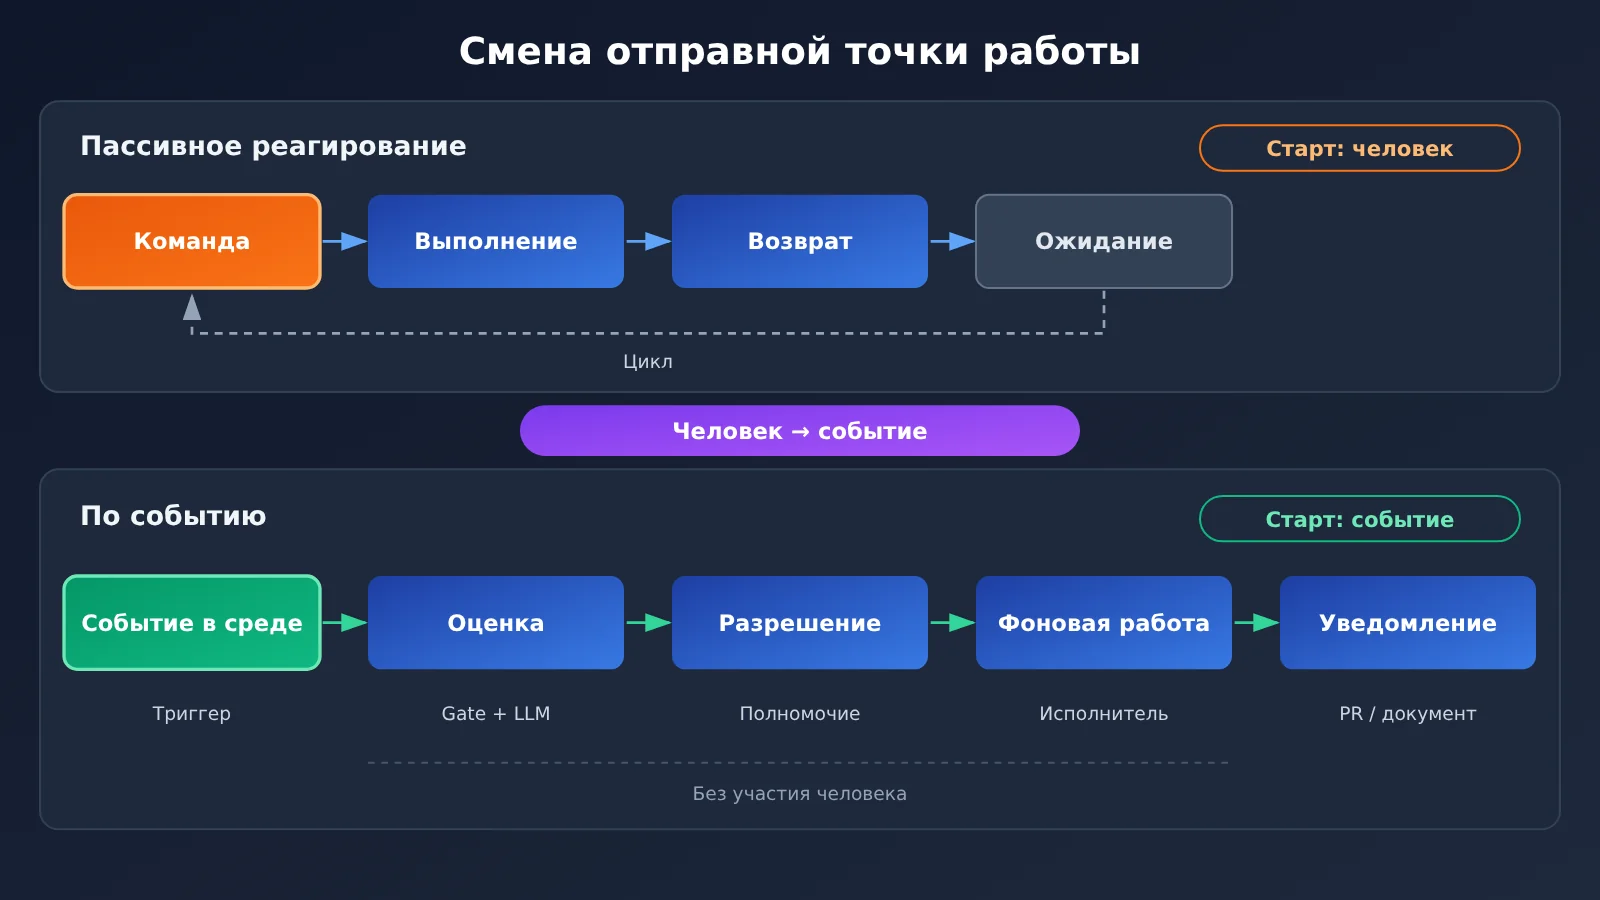
Традиционный чат-агент работает по замкнутому циклу: пользователь даёт команду, агент её выполняет, возвращает результат и ждёт следующей команды. Каким бы умным ни был агент, его работа всегда начинается с диалога, который инициирует пользователь. Человеку приходится самому обнаруживать проблему, объяснять её и не забывать проверять результат.
DeepSeek Super-agent переворачивает эту схему. Система непрерывно получает события из рабочей среды, определяет, требуют ли они внимания, создаёт задачи в рамках предоставленных полномочий, выполняет их в фоновом режиме и в подходящий момент уведомляет человека. Иными словами, сама рабочая среда становится источником входных данных для агента, а окно чата перестаёт быть единственной точкой входа.
| Критерий | Пассивный агент, реагирующий на запросы | Событийно-ориентированный Super-agent |
|---|---|---|
| Отправная точка | Пользователь начинает диалог | Событие во внешней среде (Trigger) |
| Выявление задач | Человек обнаруживает и описывает проблему | Система распознаёт признаки задачи, человек разрешает её выполнение и принимает результат |
| Способ выполнения | Обычно синхронный, с ожиданием результата | Асинхронный в фоновом режиме, с возможностью предварительной подготовки |
| Представление результата | Постепенный вывод в диалоге | Краткое уведомление или структурированный результат (PR, документ) |
| Управление | Каждый шаг зависит от команды пользователя | Режим приёма задач, рамки полномочий Mandate и правила согласования |
| Основные риски | Большая нагрузка на человека по управлению | Ложные срабатывания, шквал задач, выход за рамки полномочий, инъекционные атаки |
Роль Trigger в Super-agent
DeepSeek называет события внешней среды общим термином Trigger. Триггером может стать сообщение в групповом чате, новый Issue или ошибка сборки CI. Важно понимать, что Trigger — лишь «сигнал», а не готовая задача. Решение о том, нужно ли действовать, принимается на следующих этапах: при фильтрации, оценке и проверке полномочий.
Как Super-agent фильтрует события: программный Gate и LLM Assessment
В реальной рабочей среде много шума. В группе разработчиков каждый день появляются разговоры не по делу, эмодзи и повторяющиеся сообщения. Если передавать каждое из них на оценку большой языковой модели, расходы на токены и задержка ответа быстро вырастут. Решение DeepSeek — двухуровневая фильтрация: сначала недорогие детерминированные правила отсеивают большинство нерелевантных событий, а затем небольшое число оставшихся событий передаётся модели для смысловой оценки.
| Уровень фильтрации | Критерии оценки | Вызов большой языковой модели | Основная задача |
|---|---|---|---|
| Первый уровень: программный Gate | Источник события, наличие пользователя в списке разрешённых, принадлежность к отслеживаемой группе или репозиторию, явное упоминание агента, соответствие настроенному диапазону событий | По возможности без вызова | Недорогое отсечение нерелевантных и неавторизованных событий |
| Второй уровень: LLM Assessment | Смысл и контекст отобранного события | С вызовом | Определение того, требует ли событие обработки, например указывает ли оно на сбой |
Возьмём сообщение: «Страница входа опять не открывается в Safari». Если оно пришло из авторизованного обсуждения проекта, модель может распознать в нём признак сбоя. Если же это просто разговор не по делу, система может ничего не предпринимать. Такая двухуровневая структура сочетает недорогие правила с более затратным смысловым анализом — и помогает держать под контролем расходы событийно-управляемого агента.
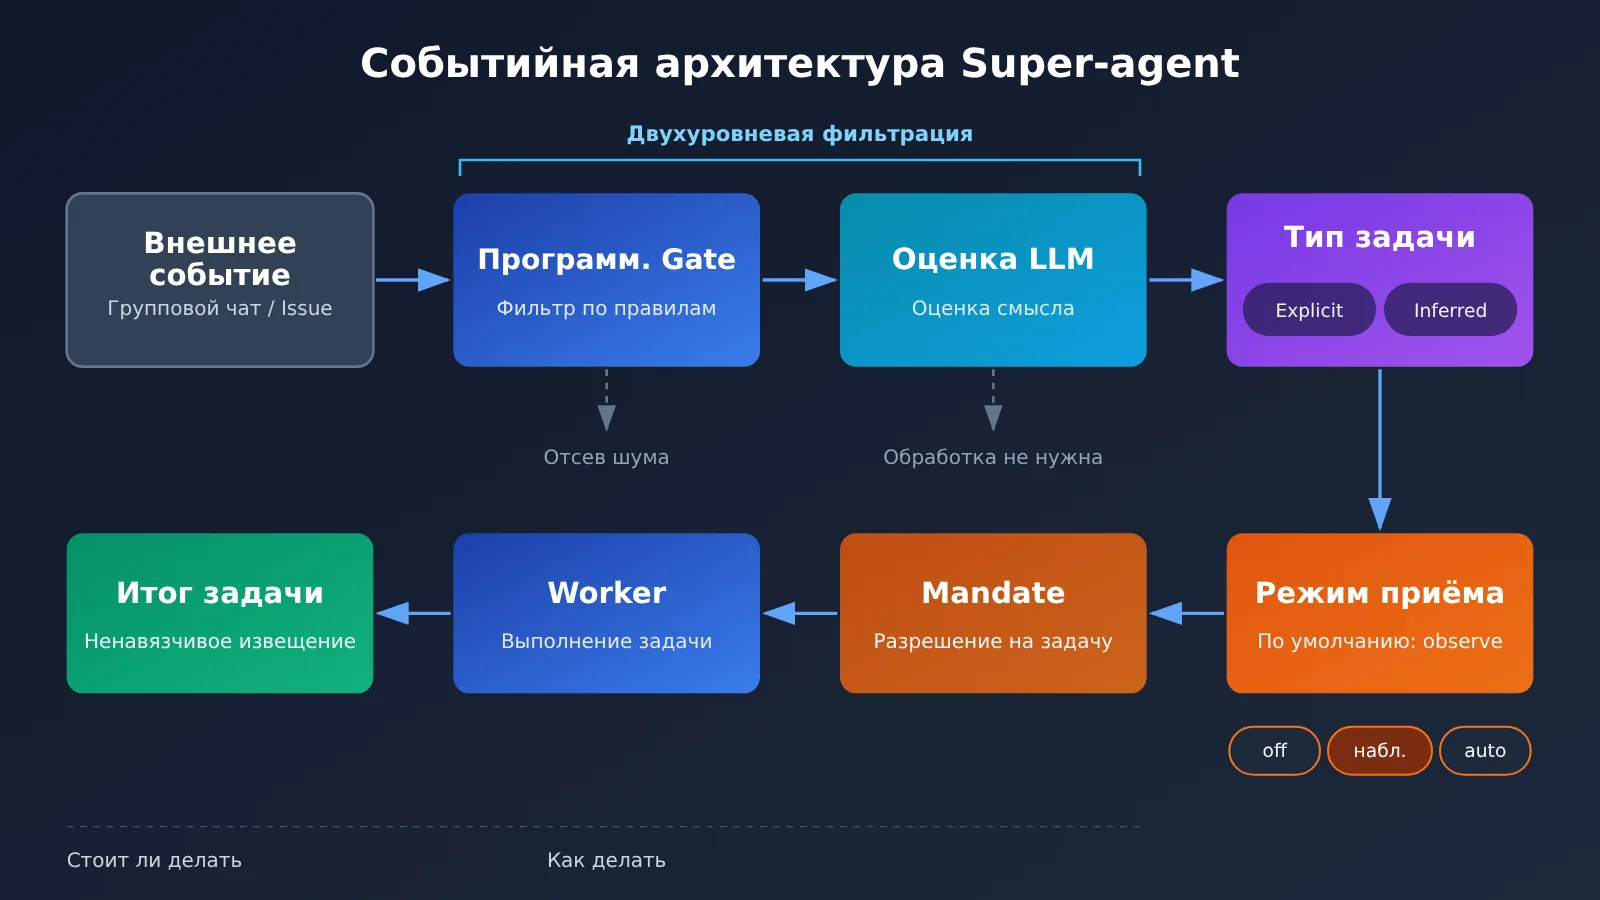
На схеме выше и смысловая оценка, и выполнение задач зависят от API моделей. При воспроизведении похожей архитектуры разработчики могут подключать разные модели через единый OpenAI-совместимый интерфейс, например APIYI apiyi.com. Это упростит настройку и сравнение моделей на каждом уровне.
Explicit и Inferred: явные запросы и предполагаемые задачи
Официальная документация DeepSeek по авторизации делит задачи на две категории. Explicit — это явно разрешённый запрос: например, разработчик с необходимыми правами прямо просит агента исправить баг в Issue. Inferred — предполагаемая задача: например, кто-то в обсуждении замечает, что «в последнее время сборка иногда завершается с ошибкой». Формальной просьбы что-либо исправить нет, но система считает, что эту проблему стоит изучить.
Главное: обнаружить предполагаемую задачу — не значит получить разрешение на её выполнение. Задачи Inferred по-прежнему должны соответствовать правилам допуска организации, разрешённым границам действий и требованиям к согласованию. Это различие не даёт «проактивному обнаружению» превратиться в «самовольные действия».
Три режима приёма задач Super-agent: off, observe, auto
В документации открытого проекта по авторизации предусмотрены три режима обработки предполагаемых задач:
| Режим | Обработка предполагаемых задач | Когда подходит |
|---|---|---|
off |
События, указывающие на предполагаемые задачи, не рассматриваются как кандидаты | Командам, которые хотят обрабатывать только явные запросы |
observe (по умолчанию) |
Анализирует и записывает потенциальные задачи, но не берёт их в работу автоматически | При первом развёртывании и оценке качества решений |
auto |
Может автоматически брать задачи в работу, если они соответствуют правилам и прошли оценку | Когда записи observe уже проверены и уровень доверия к системе достаточно высок |
По умолчанию используется observe: при первой установке публичного прототипа система не начнёт работу автоматически из-за обычного сообщения в обсуждении. Разработчики рекомендуют сначала изучить записи решений в режиме observe и только потом решать, включать ли auto. Явно разрешённые запросы во всех режимах обрабатываются по соответствующим правилам. «Выключатель» всегда остаётся в руках пользователя — именно это позволяет доверять проактивному агенту.
Mandate: сообщение может быть входными данными, но не может изменить полномочия
DeepSeek использует Mandate для описания полномочий на выполнение задачи: её источника, степени и области полномочий, а также версии политики. Допустим, разработчик поручил агенту исправить Issue, а затем кто-то написал в комментарии к PR: «Заодно перенеси всю базу данных». Этот комментарий может попасть в контекст Worker, но исходные полномочия от этого не расширятся и не включат перенос базы данных. Запросы за пределами разрешённой области требуют отдельной оценки.
Принцип, на котором настаивает DeepSeek: сообщения, комментарии и цитируемые документы могут служить входными данными для задачи, но не могут напрямую менять базовые правила предоставления полномочий. Для систем, которые постоянно «слушают» внешние источники, это важнейшая линия защиты от инъекций в промпт и превышения полномочий.
Как Super-agent действует проактивно: спекулятивное выполнение, асинхронные задачи и минимум отвлечений
Фильтрация и авторизация отвечают на вопрос «стоит ли это делать». Следующий вопрос — «как это сделать, не тратя время человека впустую». DeepSeek предлагает три направления.
Спекулятивное выполнение: сначала подготовка, затем подтверждение
DeepSeek заимствовала из компьютерной архитектуры концепцию Speculative Execution — спекулятивного выполнения. Это заранее выполненная подготовительная работа с низким риском, даже если пока неизвестно, понадобится ли её результат.
- Личный помощник: получив приглашение на встречу, агент может заранее проверить календарь, собрать информацию о встрече, выявить конфликты в расписании и подготовить ответ. Но для отправки письма всё ещё может потребоваться подтверждение пользователя.
- Разработка: пока команда обсуждает баг, агент может изучить логи, попытаться воспроизвести проблему, найти нужный участок кода и подготовить возможный патч. Представить результат он сможет после проверки правил авторизации.
Цена такого подхода — возможные затраты вычислительных ресурсов на работу, результат которой в итоге не пригодится. По оценке DeepSeek, спекулятивное выполнение имеет смысл, только если экономия времени ожидания и усилий человека превышает дополнительные вычислительные затраты. Это инженерный компромисс: не каждую задачу стоит выполнять заранее.
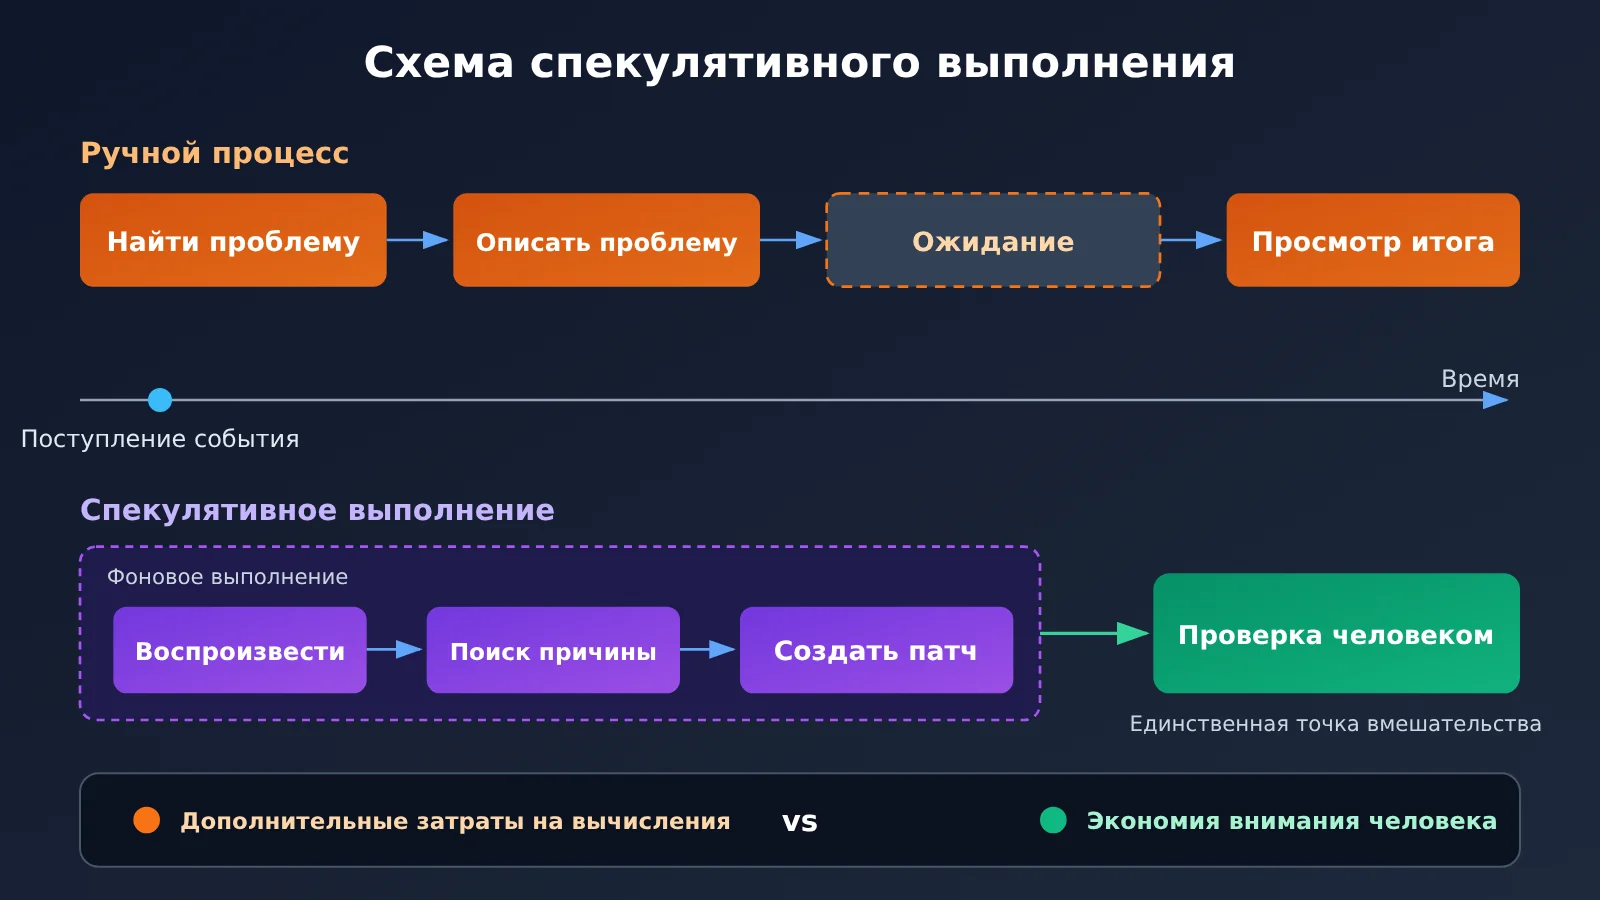
Асинхронный ReAct Loop: фоновые задачи не блокируют общение
При традиционном синхронном выполнении агент, запустив длительную команду, должен дождаться ответа инструмента, прежде чем обрабатывать новые сообщения. В асинхронной архитектуре DeepSeek после запуска задачи сразу возвращается статус Started, а её выполнение в фоне не блокирует дальнейшее общение. Результат возвращается в систему как новое событие. Пока задача выполняется, пользователь может задавать другие вопросы, а система — останавливать ненужную фоновую работу.
Здесь важно учитывать ограничения: по официальным данным, механизм асинхронных задач уже реализован в DeepSeek Harness, но пока не включён по умолчанию. У публичного прототипа есть собственный механизм фоновых Worker, однако не стоит считать всю задуманную асинхронную архитектуру функцией, доступной по умолчанию.
Минимум отвлечений: проактивность не означает постоянное присутствие
В документе о продуктовой философии DeepSeek предлагается свести к минимуму расход человеческого внимания, создавая при этом как можно больше реальной ценности. На практике это означает: не сообщать о каждом вызове инструмента, не засорять групповые чаты, не показывать все промежуточные рассуждения, обращаться к человеку прежде всего для принятия решения или приёмки результата и воздерживаться от сообщений, которые несут мало пользы.
Формат зависит и от канала. В мессенджерах используются краткие уведомления, а в GitHub, электронной почте и документах — структурированные материалы с описанием проблемы, изменений и результатов проверки. С точки зрения продукта проактивность и частота уведомлений — разные показатели: агент, который часто отчитывается, не обязательно полезен.
Super-agent на практике: внутренний кейс и тест сообщества
Оценивая новую архитектуру, важно отделять её потенциал от текущего состояния. Сегодня есть два вида свидетельств, и они различаются как по надёжности, так и по тому, о чём позволяют судить.
Внутренний кейс DeepSeek показывает потенциал архитектуры. Во внутреннем групповом чате DeepSeek Harness агент получает сообщения о проблемах, решает, стоит ли их исследовать, а затем в фоновом режиме пытается воспроизвести их и найти способ исправления. Если проблема подтверждается и находится простое решение, агент подготавливает или отправляет PR. Если ничего полезного найти не удалось, он не беспокоит команду. Это официально описанный внутренний сценарий работы, а не независимая проверка публичного прототипа со стандартной конфигурацией.
Тест сообщества GitHub показывает текущее состояние прототипа. 1 ноября 2026 года один из пользователей сообщил, что развернул прототип с открытым исходным кодом в Ubuntu по инструкции из SETUP.md. Ему удалось запустить обработку запроса из Issue и в итоге получить Pull Request. Однако в процессе возникли и проблемы: уведомления GitHub не доставлялись, система показывала нормальный статус, но не получала рабочие запросы, потребовалось изменить настройки отслеживания Issue и комментариев в Source. Кроме того, язык системы и настройки учётной записи GitHub вызвали проблемы совместимости.
Этот отчёт подтверждает, что цепочка «от события к задаче» действительно работает. Но из него нельзя сделать вывод, что проект уже способен надёжно и круглосуточно автоматически обнаруживать баги. Создание PR также не означает, что изменения прошли проверку человеком и были приняты.
Как построить слой принятия решений для событийного агента с помощью API моделей
Если вы хотите взять на вооружение идеи Super-agent, проще всего начать со слоя «программный Gate + LLM Assessment». Пример ниже демонстрирует только логику оценки событий: это не официальная реализация Super-agent и не полноценный продукт-агент.
Минимальный пример
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # OpenAI-совместимый интерфейс
)

event = "登录页面在 Safari 上又打不开了"
resp = client.chat.completions.create(
    model="gpt-4o-mini",  # Сверяйте название модели со списком моделей на платформе
    messages=[{"role": "user", "content": f"判断以下消息是否为故障线索,只回答 yes 或 no:{event}"}]
)
print(resp.choices[0].message.content)
Посмотреть полный код реализации (Gate + Assessment + режим приёма задач)
import json
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

# Настройка Gate на уровне программы: детерминированные правила без вызова LLM
ALLOWED_SOURCES = {"github", "feishu"}
ALLOWED_USERS = {"alice", "bob"}
WATCHED_CHANNELS = {"repo/web-frontend", "group/dev-team"}
MODE = "observe"  # off / observe / auto

def gate(event: dict) -> bool:
    """Первый уровень: недорогая фильтрация по правилам"""
    return (
        event["source"] in ALLOWED_SOURCES
        and event["user"] in ALLOWED_USERS
        and event["channel"] in WATCHED_CHANNELS
    )

def assess(event: dict) -> dict:
    """Второй уровень: семантическая оценка моделью с разделением на explicit / inferred"""
    prompt = (
        "你是事件分类器。请判断消息是否包含值得处理的工作,"
        "并区分 explicit(明确请求)或 inferred(推断任务)。"
        '仅输出 JSON:{"actionable": bool, "kind": "explicit|inferred|none", "reason": "..."}\n'
        f"消息:{event['text']}"
    )
    resp = client.chat.completions.create(
        model="gpt-4o-mini",
        messages=[{"role": "user", "content": prompt}],
        max_tokens=200
    )
    try:
        return json.loads(resp.choices[0].message.content)
    except json.JSONDecodeError:
        return {"actionable": False, "kind": "none", "reason": "parse_error"}

def handle(event: dict) -> str:
    if not gate(event):
        return "dropped_by_gate"
    result = assess(event)
    if not result["actionable"]:
        return "ignored"
    if result["kind"] == "explicit":
        return "create_task_with_mandate"   # Всё равно нужно проверить пределы полномочий
    # Выявленные косвенно задачи обрабатываются согласно режиму приёма задач
    if MODE == "off":
        return "ignored"
    if MODE == "observe":
        return f"logged_for_review: {result['reason']}"
    return "auto_accept_if_policy_allows"

print(handle({
    "source": "feishu", "user": "alice",
    "channel": "group/dev-team",
    "text": "最近构建有时会失败"
}))
🚀 Совет для быстрого старта: проверяя слой принятия решений, можно получить бесплатный тестовый лимит на APIYI apiyi.com и попробовать разные модели с одним и тем же кодом. Сравните точность классификации и расход токенов, а затем выберите модели для каждого уровня.
Принцип многоуровневого распределения задач между моделями
Структуру Super-agent можно представить так: внешнее событие → программная фильтрация → семантическая оценка модели → решение об авторизации → выполнение агентом → передача результата. На разных уровнях необязательно использовать одну и ту же модель:
| Уровень | Характер задачи | Выбор модели |
|---|---|---|
| Программный Gate | Проверка источника, пользователя и области действия | Без LLM |
| Классификация событий | Высокая частота, короткие тексты, структурированный вывод | Недорогая модель с низкой задержкой |
| Выполнение сложных задач | Воспроизведение и исправление кода, рассуждения с длинным контекстом | Более мощная модель |
| Подведение итогов и уведомления | Краткое изложение, структурированная передача результатов | Можно настроить независимо |
💡 Рекомендация: действительно ли многоуровневое распределение задач позволяет сэкономить, нужно проверять на реальных логах и в бизнес-тестах. Нельзя заранее считать, что оркестрация нескольких моделей обязательно снизит затраты. Единый интерфейс APIYI apiyi.com позволяет быстро заменять модели на каждом уровне без изменения бизнес-кода и проводить A/B-сравнение.
Как событийно-ориентированная архитектура Super-agent меняет работу команд
Для разработчиков и специалистов по автоматизации
- Вместо чата — рабочий процесс: Issue, комментарии к PR, результаты CI и сообщения в групповых чатах становятся естественными источниками данных для агента. Разработчикам нужно продумывать приём и фильтрацию событий, а не просто писать промпты.
- Разграничение полномочий становится ключевым навыком: различие между Explicit и Inferred, режим приёма задач и область действия Mandate определяют, примут ли агента в реальной команде.
- Подход к оценке нужно менять: недостаточно считать, сколько действий выполнил проактивный агент. Важны также качество выявления задач, доля переделок и количество бесполезных уведомлений.
Для команд, внедряющих ИИ в компаниях
Проактивные агенты открывают возможности для совместной разработки, поиска причин сбоев и автоматизации бизнес-процессов, но структура затрат при этом меняется. Оценка событий постоянно расходует токены, спекулятивное выполнение может приводить к результатам, которые никто не использует, а сложные задачи по-прежнему требуют проверки человеком. Ниже приведена система оценки, составленная на основе официальной архитектуры. Это не официальные показатели производительности, опубликованные DeepSeek.
| Направление оценки | На какие показатели обратить внимание |
|---|---|
| Качество выявления задач | Доля выявленных значимых событий, частота ложных срабатываний, доля дублирующихся задач |
| Качество выполнения | Доля выполненных задач, доля задач, потребовавших доработки человеком, доля результатов, прошедших проверку |
| Удобство для пользователей | Число вмешательств человека на одну полезную задачу, количество бесполезных уведомлений, время от появления проблемы до получения результата, готового к приёмке |
| Эксплуатационные расходы | Расход токенов на оценку одного события, стоимость вызовов модели на одну успешно выполненную задачу, затраты на спекулятивные задачи, результаты которых не использовали |
| Управление безопасностью | Доля заблокированных несанкционированных задач, эффективность согласования в ключевых точках, соблюдение разрешённых границ доступа к конфиденциальной информации |
Риски, которые нельзя игнорировать
К рискам проактивных агентов относятся ложные срабатывания, лавина задач, превышение полномочий, промпт-инъекции, нерациональный расход ресурсов и утечка данных. DeepSeek также признаёт в технической статье, что проблемы изоляции контекста внутри сложных организаций, долгосрочной памяти, безопасной связи и конфиденциальности пока не решены. Если агент имеет доступ к приватным репозиториям и локальным учётным данным, защиту от попадания конфиденциальной информации в контекст модели или внешние каналы нужно предусмотреть ещё до развёртывания.
Частые вопросы FAQ
Q1: Что такое событийно-ориентированная архитектура DeepSeek Super-agent?
Это архитектура, в которой агент постоянно получает события из внешней среды (Trigger), фильтрует их программными средствами и оценивает с помощью модели. Затем он может создавать задачи в рамках предоставленных полномочий, выполнять их в фоновом режиме и вовремя уведомлять человека. Работа начинается не с команды пользователя, а с события в окружающей среде, но контроль над полномочиями и согласованием остаётся за человеком.
Q2: Означает ли самостоятельное определение задач, что пользователь теряет контроль?
Нет. Задачи, определённые агентом самостоятельно (Inferred), должны соответствовать правилам допуска, разрешённым действиям и требованиям к согласованию. В публичном прототипе по умолчанию используется режим `observe`: он только записывает потенциальные задачи, не принимая их автоматически. Пользователь может выбрать `off`, чтобы полностью отключить определение таких задач, или после просмотра записей включить `auto`. Механизм Mandate также не позволяет напрямую расширять полномочия через комментарии и другие сообщения.
Q3: На что сейчас способен прототип с открытым исходным кодом?
Публичный прототип в основном поддерживает GitHub и опциональную интеграцию с Feishu. В нём уже доступны три режима приёма задач и механизм авторизации Mandate. Участники сообщества сообщают, что им удалось пройти путь от Issue до PR, но при развёртывании встречаются проблемы с доставкой уведомлений и совместимостью конфигураций. Источники событий вроде почты и календаря, а также полноценная асинхронная архитектура, включённая по умолчанию, пока остаются частью более широкой концепции или внутренней реализации.
Q4: Как контролировать расходы на токены для проактивного агента?
Ключевой подход — двухуровневая фильтрация. Сначала программный Gate без вызова LLM отсеивает большинство нерелевантных событий, и только небольшая часть кандидатов передаётся модели на оценку. Кроме того, спекулятивное выполнение стоит использовать осторожно: заранее готовиться только к задачам с очевидной пользой. При разработке можно следить за расходами на оценку одного события и выполнение одной успешной задачи через статистику использования APIYI apiyi.com, а затем корректировать правила фильтрации и настройки модели.
Q5: Как построить аналогичный уровень оценки событий с помощью API моделей?
Можно взять за основу пример из этой статьи: программный Gate фильтрует события по правилам, LLM Assessment выдаёт структурированную оценку, а затем задачи, определённые агентом, обрабатываются в соответствии с выбранным режимом приёма. Для вызова модели достаточно OpenAI-совместимого интерфейса. После регистрации в APIYI apiyi.com получите API-ключ и тестовый лимит; чтобы запустить пример, оставьте в `base_url` адрес, указанный в статье. Важно: пример лишь использует идеи этой архитектуры. APIYI предоставляет доступ к API моделей, а не готовый сервис Super-agent.
Q6: Какие ограничения Super-agent известны сейчас?
Основные ограничения: в публичном прототипе мало источников событий, а при настройке развёртывания возникают проблемы совместимости; внутренний пример «тихого исправления» пока не подтверждён независимыми третьими сторонами; «фоновая работа» не гарантирует надёжной работы круглосуточно; созданные PR по-прежнему требуют проверки человеком. Разработчики также признают, что вопросы изоляции контекста внутри организации, долговременной памяти и конфиденциальности ещё предстоит решить.
DeepSeek Super-agent: главное
- Ключевое изменение: Agent начинает работу не только по команде пользователя, но и по событиям в рабочей среде. Окно чата больше не единственная точка входа.
- Двухуровневая фильтрация: программный Gate недорого отсекает шум, а LLM Assessment отвечает за семантическую оценку. Это помогает сбалансировать затраты и точность.
- Приоритет полномочий: Explicit и Inferred обрабатываются отдельно, по умолчанию используется режим
observe, а Mandate не позволяет сообщениям изменять полномочия. - Проактивное выполнение: спекулятивное выполнение и асинхронные задачи сокращают время ожидания, но затраты вычислительных ресурсов необходимо сопоставлять с реальной пользой.
- Результат без лишних уведомлений: Agent обращается к человеку только тогда, когда нужно принять решение или проверить результат. Проактивность — не синоним частых уведомлений.
- Трезвая оценка текущего состояния: внутренние примеры показывают потенциал подхода, а прототип с открытым исходным кодом уже способен пройти путь Issue → PR, но до зрелого решения ему ещё далеко.
- Как применить на практике: для начала можно построить слой оценки событий с помощью API моделей и сравнить через APIYI apiyi.com качество классификации и стоимость разных моделей.
Итоги
Событийно-ориентированная архитектура DeepSeek Super-agent отвечает не на вопрос «Может ли ИИ самостоятельно принимать решения?», а на вопрос «Как дать Agent возможность проактивно брать работу на себя в рамках правил и предоставленных полномочий?». Её ключевые механизмы можно свести к трём пунктам:
- Восприятие и фильтрация: Trigger превращает события рабочей среды во входные данные, а двухуровневая фильтрация помогает контролировать шум и расходы на токены.
- Полномочия и контроль: разделение Explicit/Inferred, три режима принятия задач и границы Mandate не позволяют проактивности перерасти в превышение полномочий.
- Выполнение и выдача результата: спекулятивное выполнение, асинхронные задачи и ненавязчивые уведомления меняют роль человека — от управления задачами к принятию решений и проверке результатов.
Ценность проактивного Agent не в количестве выполненных действий, а в том, насколько он сокращает ручное управление и какие надёжные результаты выдаёт. Текущий прототип с открытым исходным кодом всё ещё находится на ранней стадии, поэтому стоит начать с режима observe: накапливать записи о его оценках и постепенно выстраивать доверие. Если вы проектируете похожую цепочку оценки событий и выполнения задач, попробуйте через APIYI apiyi.com быстро проверить, как разные модели работают на каждом этапе, а затем выбрать подходящий вариант на основе реальных бизнес-данных.
📚 Источники
- Исследование архитектуры DeepSeek Super-agent: событийно-ориентированный подход и проектирование проактивных агентов
- Ссылка:
blog2.eimoon.com/p/deepseek-super-agent-design/ -
Описание: Trigger, спекулятивное выполнение, асинхронные задачи и внутренние примеры
-
Документация по механизму авторизации DeepSeek: Explicit/Inferred, режимы принятия задач и Mandate
- Ссылка:
github.com/deepseek-ai/dsh-superagent-prototype/blob/main/docs/002-authorization.md -
Описание: основной источник информации о трёх режимах —
off,observeиauto -
Философия проектирования продуктов DeepSeek: минимум отвлекающих уведомлений и принципы работы с вниманием пользователя
- Ссылка:
github.com/deepseek-ai/dsh-superagent-prototype/blob/main/docs/000-philosophy.md -
Описание: почему проактивному агенту не стоит слишком часто напоминать о себе
-
DeepSeek Domain Model: определения основных понятий предметной области
- Ссылка:
github.com/deepseek-ai/dsh-superagent-prototype/blob/main/docs/001-domain.md -
Описание: поможет разобраться в связи между задачами, Worker и событиями
-
Инструкция по развёртыванию DeepSeek Setup: руководство по установке прототипа с открытым исходным кодом
- Ссылка:
github.com/deepseek-ai/dsh-superagent-prototype/blob/main/SETUP.md -
Описание: обязательное чтение перед развёртыванием
-
Отчёт сообщества GitHub: практическая проверка сценария Issue → PR и проблемы развёртывания
- Ссылка:
github.com/deepseek-ai/deepseek-harness/discussions/11706 - Описание: реальное состояние прототипа и его текущие ограничения
Автор: техническая команда APIYI
Технические вопросы: свяжитесь с нами через главную страницу сайта APIYI. Больше материалов по подключению моделей — в центре документации docs.apiyi.com