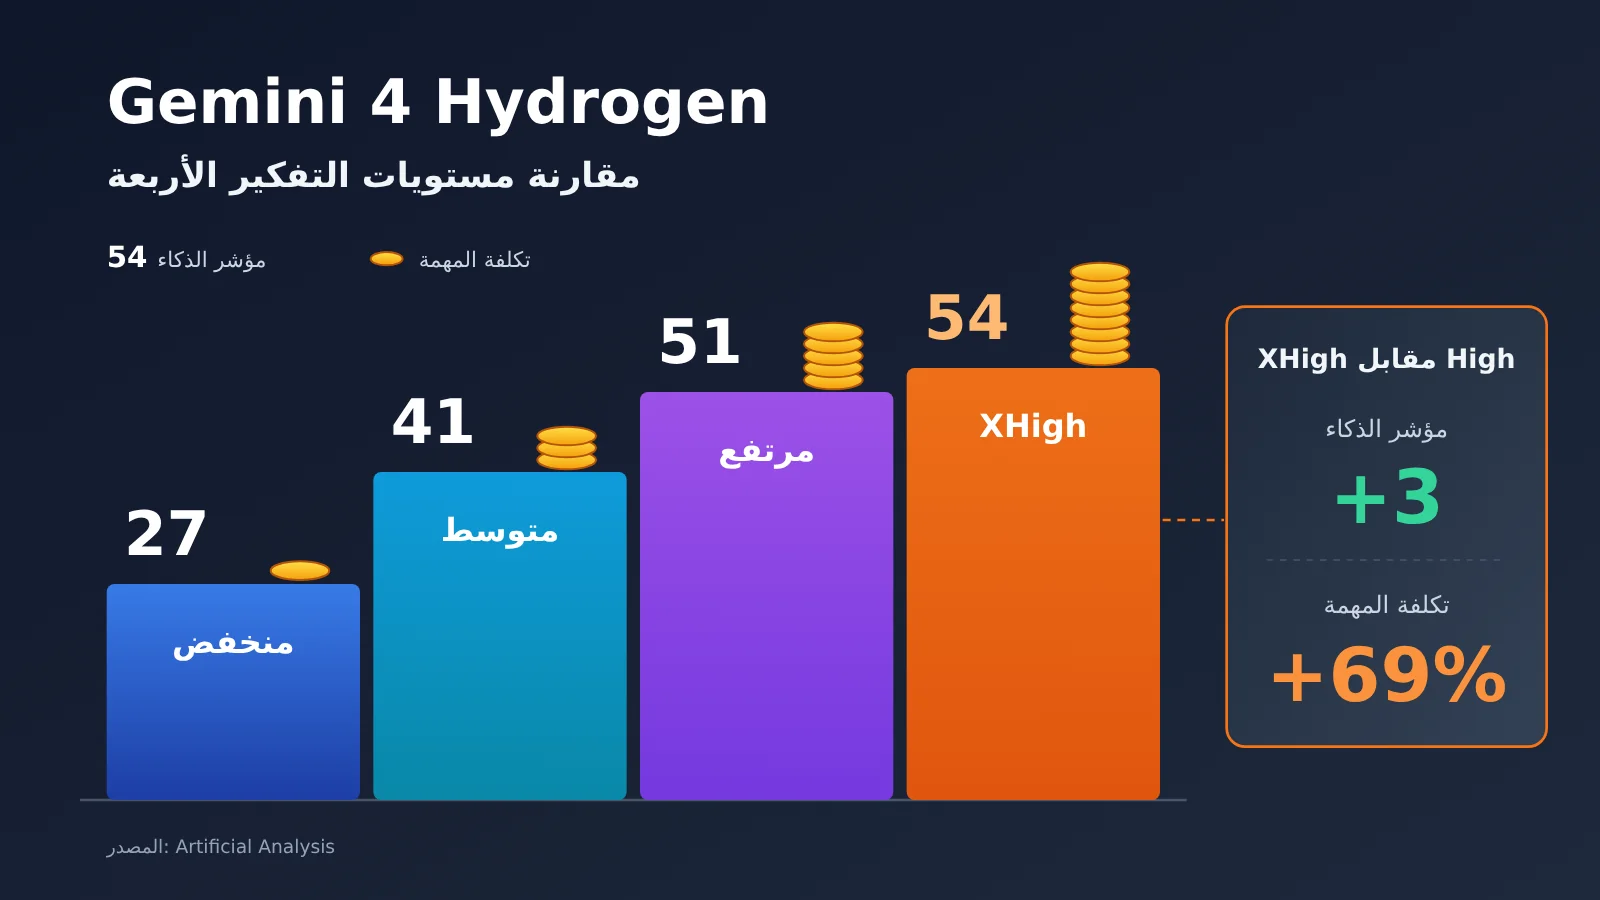
ملخص في جملة واحدة: تُظهر تقييمات Artificial Analysis للمستويات الأربعة أن الانتقال من High إلى XHigh في Gemini 4 Hydrogen لا يزيد مؤشر الذكاء إلا بمقدار 3 نقاط، بينما تزيد تكلفة مهمة التقييم بنحو 69%، لذا فإنه من الأنسب ضبط مستوى التفكير وفقًا لصعوبة المهمة.
أعلنت Google رسميًا في 12 نوفمبر 2026 عن إطلاق Gemini 4 Hydrogen، مع توفير أربع درجات تفكير: Low وMedium وHigh وXHigh. تستخدم المستويات الأربعة معرّف النموذج نفسه وسعر التوكن نفسه، لكن الدرجات والتكلفة وزمن الانتظار في تقييمات الطرف الثالث تتفاوت كثيرًا.
هذه ليست توصية من نوع «كلما ارتفع المستوى كان أفضل». يحسب هذا المقال العائد الحدّي لكل مستوى باستخدام بيانات التقييم المعيارية من Artificial Analysis، ويقدّم توصية واضحة بالمستوى المناسب وفقًا لنوع المهمة.
القيمة الأساسية: بعد قراءة هذا المقال، يمكنك تحديد المستوى الذي ينبغي أن تستخدمه في أعمالك، وكيف تستخدم المعامل thinking_level للتحكم في تكلفة التفكير.
مصطلحات يجب معرفتها قبل مقارنة مستويات التفكير الأربعة في Gemini 4 Hydrogen
- thinking_level: المعامل الذي يتحكم في عمق استدلال النموذج. يدعم Hydrogen أربع قيم: Low وMedium وHigh وXHigh.
- توكنات التفكير: التوكنات التي يستخدمها النموذج للاستدلال قبل تقديم الإجابة النهائية. وبحسب صفحة أسعار Google الرسمية، تُحتسب هذه التوكنات ضمن سعر الإخراج.
- Token: وحدة قياس معالجة النصوص والصور وغيرها من المعلومات، وتُفوتر API لكل مليون توكن.
- Harness: إطار اختبار ينظّم مدخلات النموذج، وينفّذ استدعاءات الأدوات، ويقيّم المهام. لا يمكن مقارنة النتائج المقاسة بواسطة Harness مختلفة مقارنة مباشرة.
- API: واجهة تتيح للبرامج استدعاء الخدمة. أمثلة الشفرة في هذا المقال تستخدم صيغة متوافقة مع OpenAI.
نفس Gemini 4 Hydrogen: لماذا يختلف الأداء كثيرًا بين المستويات الأربعة؟
Gemini 4 Hydrogen نموذج عالي الكفاءة أطلقته Google DeepMind، ويُستخدم أساسًا في البرمجة اليومية وتنفيذ مهام وكلاء AI، ومعرّف النموذج في API هو gemini-4-hydrogen. مستويات التفكير الأربعة ليست أربعة نماذج مختلفة، بل أربعة أعماق استدلال للنموذج نفسه. وقد حددت وثائق Google Cloud المهام الموصى بها لكل مستوى:
| مستوى التفكير | الاستخدام الموصى به رسميًا | عمق الاستدلال | هل هو الافتراضي؟ |
|---|---|---|---|
| Low | مهام بسيطة مثل التصنيف | سطحي | لا |
| Medium | البرمجة العادية | متوسط | لا (المستوى الافتراضي في 3.8 Flash) |
| High | وكيل AI متعدد الخطوات | عميق | ✅ الافتراضي في Hydrogen |
| XHigh | استدلال معقد وعميق | الأعمق | لا |
سعر المستويات الأربعة واحد… فلماذا تختلف الفاتورة؟
حتى 13 نوفمبر 2026، سعر الاستدعاء القياسي الرسمي من Google هو 1.50 دولار لكل مليون توكن إدخال و7.50 دولار لكل مليون توكن إخراج، من دون أي فرق بين المستويات الأربعة. الفرق يأتي من استهلاك التوكنات: كلما ارتفع المستوى، زادت توكنات التفكير التي يولّدها النموذج قبل الإجابة، وهذه التوكنات تُحتسب بسعر الإخراج.
لذا، “السعر الموحد” لا يعني “التكلفة نفسها لكل مهمة”. قد يولّد السؤال الواحد في XHigh محتوى تفكير يفوق High بأضعاف، وترتفع الفاتورة تبعًا لذلك. عند تقدير التكلفة لا يكفي النظر إلى طول الإجابة النهائية فقط، بل يجب احتساب الجزء الخفي من التفكير أيضًا.
بيانات اختبار Gemini 4 Hydrogen الفعلية بأربع درجات: المقارنة بين النتائج والتكلفة والسرعة
البيانات التالية مصدرها مؤسسة خارجية هي Artificial Analysis، وقد أُجري التقييم في يوم الإصدار نفسه. مؤشر الذكاء وتكلفة المهمة التقييمية ومتوسط الوقت المستغرق مستخرجة من Intelligence Index v5.0.1؛ أما زمن التأخير حتى أول توكن في الإجابة وإجمالي توكنات الإخراج فمصدرها لقطة شاشة للصفحة بتاريخ 13 نوفمبر 2026. كل ما يلي نتائج تقييم معياري من جهة خارجية، وليس قياسًا أجريناه على منصتنا.
| درجة التفكير | مؤشر الذكاء | متوسط التكلفة لكل مهمة | متوسط الوقت لكل مهمة | تأخير أول توكن في الإجابة | إجمالي توكنات الإخراج في التقييم الكامل |
|---|---|---|---|---|---|
| Low | 27 | $0.29 | 1.3 دقيقة | نحو 5.7 ثانية | 20.3 مليون |
| Medium | 41 | $0.80 | 3.7 دقيقة | نحو 11.8 ثانية | 54.4 مليون |
| High (الافتراضي) | 51 | $1.87 | 8.3 دقيقة | نحو 18.9 ثانية | 110 مليون |
| XHigh | 54 | $3.16 | 13.5 دقيقة | نحو 37.8 ثانية | 304 مليون |
لا تخلط بين المؤشرات الزمنية الثلاثة
يحتوي هذا الجدول على ثلاثة أنواع من المؤشرات، ولكل منها معنى مختلف:
- مؤشر الذكاء: درجة قدرة مركبة مبنية على عدة معايير، ولا تعبّر إلا عن المستوى النسبي داخل هذه المجموعة من التقييمات.
- متوسط الوقت لكل مهمة: مؤشر مرجّح يُحسب من عدد توكنات إخراج المهمة ومن سرعة الإخراج من البداية إلى النهاية، ويمثل حمل العمل في التقييم المعياري. فإذا سأل المستخدم سؤالاً بسيطًا، فلا يلزمه بالضرورة أن ينتظر 8.3 دقيقة.
- تأخير أول توكن في الإجابة: مدة الانتظار من إرسال الطلب حتى رؤية أول توكن في الإجابة، وهي تشمل مرحلة التفكير في نموذج الاستدلال، وهي المؤشر الذي يشعر به المستخدم أكثر من غيره في سيناريوهات المحادثة.
ويلاحظ من الجدول أن الفارق في الدرجات بين Medium وHigh (10 نقاط) أكبر بكثير من الفارق بين High وXHigh؛ فمع الاسم الواحد للنموذج، قد يتجاوز الفرق الفعلي في القدرة بين درجتين 20 نقطة. لذلك عند مقارنة Hydrogen بنموذج آخر، لا بد أولاً من التأكد من الدرجة التي يستخدمها الطرف الآخر.
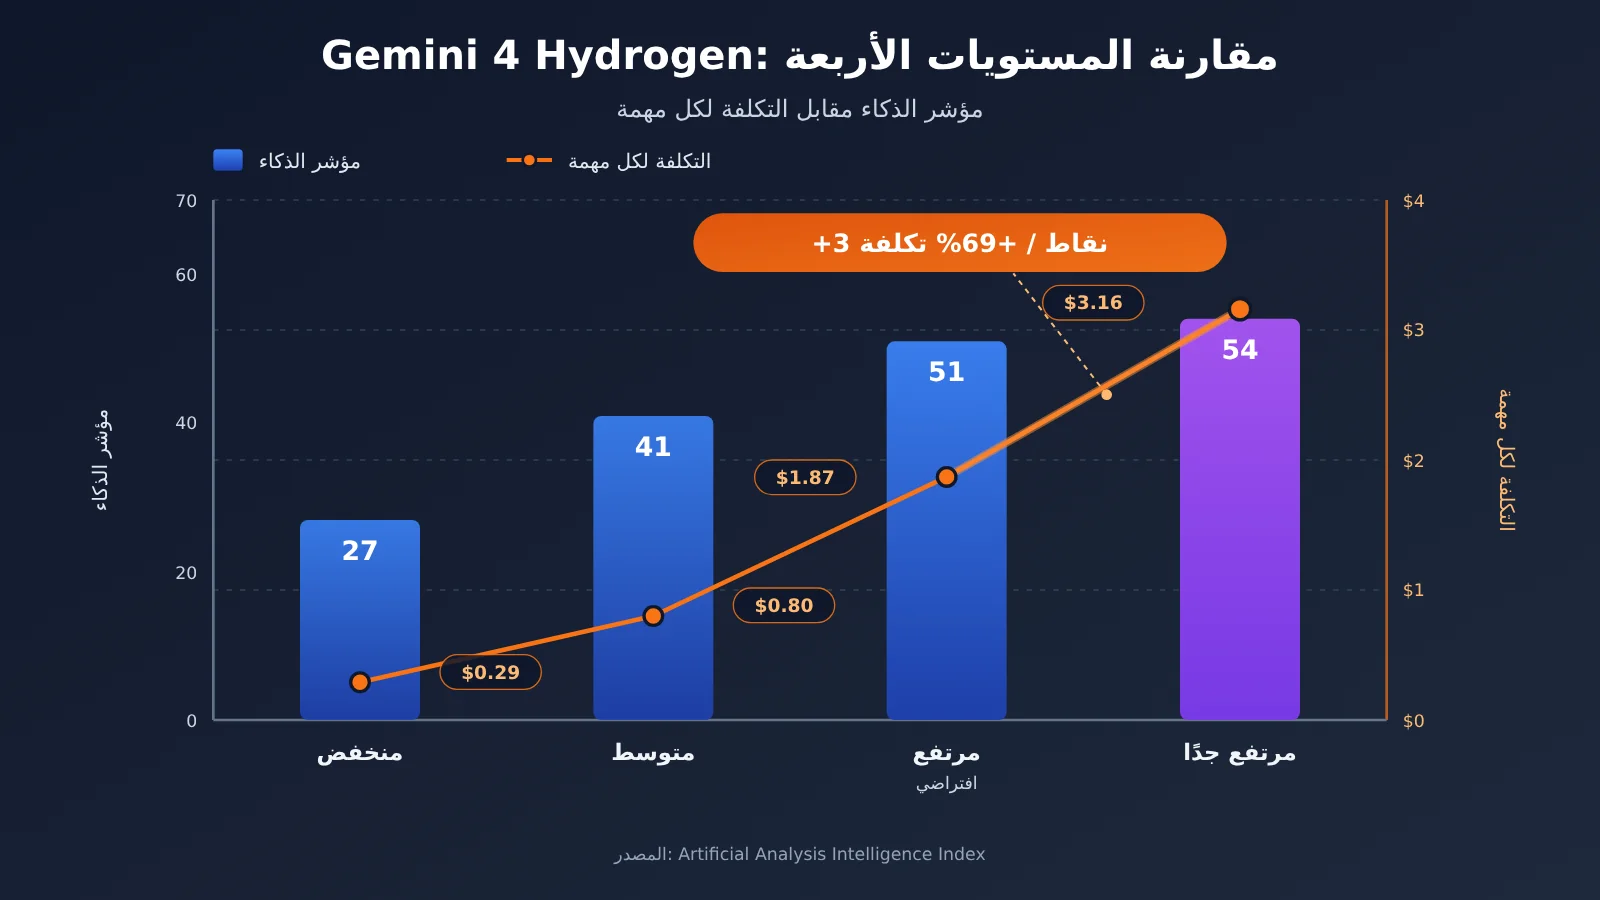
Gemini 4 Hydrogen XHigh يكلف 69% أكثر من High — فما الذي تحصل عليه مقابل هذا المبلغ فعلاً؟
عند مقارنة المستويات الأربعة زوجًا بزوج، يمكن معرفة العائد والتكلفة في كل مرة نرتقي فيها بمستوى. وقد حسب فريق التحرير نسب الزيادة في الجدول التالي بناءً على البيانات التي نشرتها Artificial Analysis.
| مسار الترقية | تغيّر مؤشر الذكاء | تغيّر تكلفة المهمة | تغيّر متوسط الوقت المستغرق | التكلفة الإضافية لكل نقطة واحدة إضافية |
|---|---|---|---|---|
| Low → Medium | +14 نقطة | +176% | +185% | نحو $0.036 |
| Medium → High | +10 نقاط | +134% | +124% | نحو $0.107 |
| High → XHigh | +3 نقاط | +69% | +63% | نحو $0.43 |
تناقص العائد: التكلفة الحدية لمستويات التفكير الأربعة في Hydrogen
عند الانتقال من High إلى XHigh، يرتفع مؤشر الذكاء من 51 إلى 54، أي بنسبة 5.9% تقريبًا؛ وترتفع تكلفة المهمة الواحدة من $1.87 إلى $3.16، ويزيد الوقت المستغرق من 8.3 دقيقة إلى 13.5 دقيقة، ويتضاعف زمن ظهور الإجابة الأولى من نحو 18.9 ثانية إلى نحو 37.8 ثانية. وإذا حسبنا «لكل نقطة إضافية واحدة»، فإن التكلفة الحدية لـ XHigh تبلغ نحو 12 ضعفًا مقارنة بـ Low → Medium.
والسبب الأساسي في ذلك هو حجم استهلاك الـ Token. ففي المستوى High ينتج الاختبار الكامل نحو 110 ملايين Token، بينما ينتج XHigh نحو 304 ملايين Token، أي نحو 2.76 ضعف الأول. لكن الفاتورة لم ترتفع 2.76 ضعفًا، لأن التكلفة الإجمالية تشمل أيضًا Token الإدخال، وحالة إصابة الذاكرة المؤقتة (cache hit)، وطريقة ترجيح مهام التقييم؛ لذا لا يمكن استنتاج التكلفة مباشرة من مضاعف Token الإخراج.
انخفاض المتوسط لا يعني أن العائد منخفض أيضًا في المهام المعقدة
مؤشر الذكاء هو نتيجة متوسط عدة مهام، وقد يأتي فرق النقاط الثلاث من حالتين: أن يكون أداء المستويين متطابقًا في معظم المهام، وأن يكون XHigh أفضل بوضوح في قلّة من المهام عالية الصعوبة. وفي مهام مثل الاستدلال العلمي، والبرهان الرياضي، وإعادة الهيكلة الكبيرة عبر عدة ملفات، وهي مهام «خطأ واحد فيها يعني خطأ النتيجة كلها»، قد يكون التفكير الإضافي الذي يقدمه XHigh هو ما يحدد نجاح المهمة من عدمه.
لذا فالصياغة الأدق هي: قيمة XHigh مقابل التكلفة منخفضة جدًا في المهام العادية، لكنه قد يكون ضروريًا في قلّة من المهام عالية الصعوبة. أما هل يستحق الأمر دفع 69% إضافية، فعليك التحقق من ذلك باستخدام عينة مهامك الخاصة، لا بالاكتفاء بالنظر إلى المتوسط.
🎯 توصية تقنية: يُنصح أولاً باختيار عينة من 20 إلى 50 مهمة حقيقية، وتشغيلها مرة بـ High ومرة بـ XHigh، ثم مقارنة معدل النجاح وتكلفة المهمة الواحدة. ويمكنك إجراء اختبار A/B عبر APIYI على apiyi.com باستخدام مفتاح API نفسه وتغيير المعاملات فقط، دون الحاجة إلى تعديل بنية كود العمل.
ما المهام المناسبة لكل مستوى من مستويات التفكير الأربعة في Gemini 4 Hydrogen؟
بناءً على توصيات Google الرسمية وبيانات التكلفة أعلاه، يمكن تقديم الاقتراحات التالية حسب صعوبة المهمة:
| نوع المهمة | المستوى الموصى به | أمثلة نموذجية | سبب الاختيار |
|---|---|---|---|
| التصنيف والاستخراج وتنظيم التنسيق | Low | تصنيف تذاكر الدعم، استخراج الحقول، تنسيق JSON، أسئلة وأجوبة بسيطة | أقل تكلفة، وزمن استجابة أول رمز نحو 5.7 ثانية، ومناسب للأحمال المتزامنة العالية |
| معالجة الأكواد والمحتوى المعتادة | Medium | كتابة دوال لملف واحد، إعادة صياغة النصوص، تلخيص المستندات، أتمتة الأعمال العامة | أعلى من Low بـ14 نقطة، والتكلفة لا تزال أقل من نصف تكلفة High |
| الوكيل متعدد الخطوات واستدعاء الأدوات | High | إصلاح الأخطاء عبر الملفات، استدعاء الأدوات بشكل متتابع، التحليل الشامل بعد الاسترجاع | المستوى الافتراضي الرسمي، وتوازن نسبي بين القدرة والتكلفة |
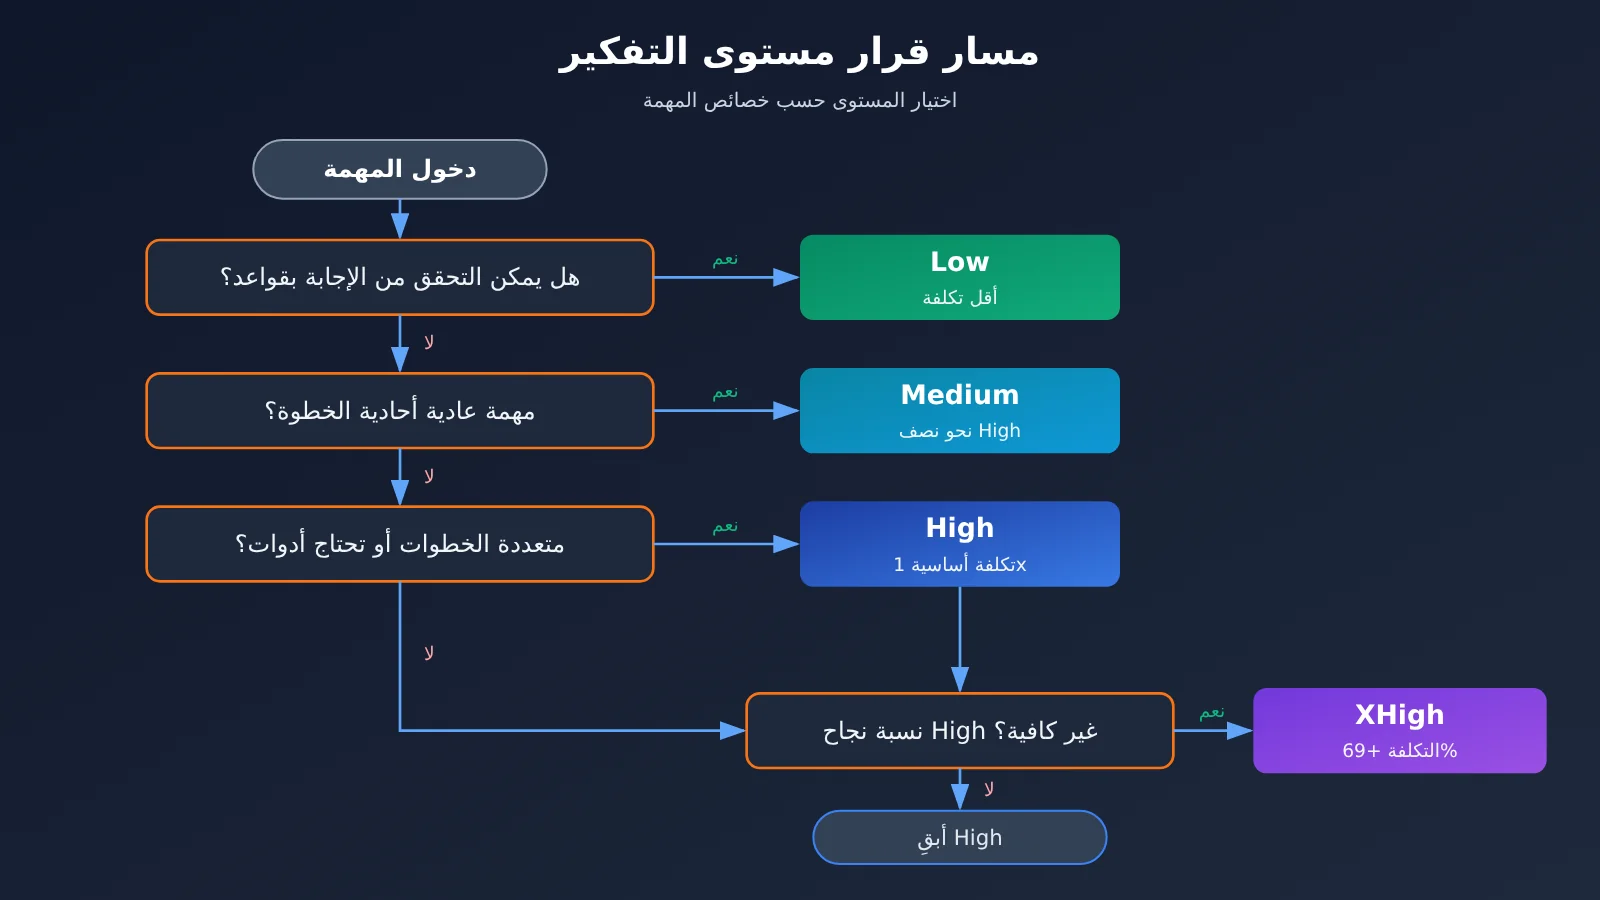
| الاستدلال عالي التعقيد | XHigh | الاستدلال العلمي، البراهين الرياضية، إعادة هيكلة مشاريع برمجية كبيرة | لا يُستخدم إلا عندما يكون معدل نجاح High غير كافٍ بوضوح |
الحالات المناسبة للمستويات المنخفضة في Hydrogen
يناسب Low وMedium المهام ذات الأهداف الواضحة والإجابات سهلة التحقق. مثل استخراج المبالغ والتواريخ من العقود، أو تصنيف ملاحظات المستخدمين إلى عشرة فئات؛ ففي مثل هذه المهام، حتى التفكير الإضافي لن يحسّن الدقة كثيرًا، بل سيزيد فقط من زمن التأخير والتكلفة. وفي السيناريوهات الحساسة لزمن استجابة أول رمز مثل الدردشة الفورية وإكمال البحث، فإن Low عند نحو 5.7 ثانية أفضل بوضوح من XHigh عند نحو 37.8 ثانية.
الحالات المناسبة للمستويات العالية في Hydrogen
High هو المستوى الافتراضي الذي حددته Google، ويناسب معظم سير عمل الوكلاء. لا تحتاج إلى الترقية إلى XHigh إلا عندما تظهر في المهمة حالة «فشل High بشكل متكرر، وتجاوزت تكلفة إعادة المحاولة تكلفة الترقية». جدير بالذكر أن بطاقة النموذج الرسمية من Google تذكر أيضًا أن مستويات التفكير العالية قد تزيد بشكل ملحوظ من الوقت والتكلفة، وقد يحدث تأخير أو انتهاء مهلة أحيانًا، لذا يجب إعداد استراتيجيات المهلة وإعادة المحاولة جيدًا للمهام ذات السلاسل الطويلة.
كيف يتحكم المطورون في تكلفة التفكير في Gemini 4 Hydrogen
المعامل thinking_level والقيم الافتراضية
يختار Hydrogen مستوى التفكير عبر المعامل thinking_level، وعند عدم تمريره تكون القيمة الافتراضية هي High. عند الانتقال من Gemini 3.8 Flash، هناك عدة نقاط يجب الانتباه إليها:
- القيمة الافتراضية في 3.8 Flash هي Medium، وبعد الانتقال سيؤدي عدم تمرير المعامل تلقائيًا إلى تغيّر المستوى إلى High، وقد ترتفع الفاتورة.
- لم يعد
thinking_budgetوMINIMALمدعومين، وسيؤدي استخدامهما إلى إرجاع HTTP 400. - سيتم تجاهل القيم المخصصة لكل من temperature وtop_p وtop_k.
- تتطلب استدعاءات الأدوات متعددة الجولات حفظ thought signatures وإرجاعها بشكل صحيح.
مثال مبسّط للغاية: استدعاء Hydrogen حسب المستوى
نستخدم أدناه الصيغة المتوافقة مع OpenAI للاستدعاء، ونمرّر مستوى التفكير عبر extra_body. قد تختلف الحقول التي تُمرِّر هذا المعامل من منصة إلى أخرى، والحقول الفعلية يُرجَع إليها في وثائق المنصة.
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # واجهة APIYI الموحّدة
)

resp = client.chat.completions.create(
    model="gemini-4-hydrogen",
    messages=[{"role": "user", "content": "把这条反馈分类:退款太慢"}],
    extra_body={"thinking_level": "low"}  # استخدام المستوى Low في التصنيف البسيط
)
print(resp.choices[0].message.content)
عرض الشفرة الكاملة: تصنيف المهمة حسب صعوبتها والترقية التلقائية للمستوى
import openai
from typing import Optional

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

# ربط أنواع المهام بالمستوى الافتراضي
LEVEL_MAP = {
    "classify": "low",
    "extract": "low",
    "content": "medium",
    "code": "medium",
    "agent": "high",
    "reasoning": "xhigh",
}
ESCALATE = {"low": "medium", "medium": "high", "high": "xhigh"}


def call_hydrogen(prompt: str, level: str) -> tuple[str, dict]:
    resp = client.chat.completions.create(
        model="gemini-4-hydrogen",
        messages=[{"role": "user", "content": prompt}],
        extra_body={"thinking_level": level},
    )
    usage = resp.usage.model_dump() if resp.usage else {}
    return resp.choices[0].message.content, usage


def run_task(prompt: str, task_type: str, validator=None,
             max_level: Optional[str] = "high") -> str:
    """نبدأ بالمستوى الأدنى، وإذا فشل التحقق نُرقّي المستوى تدريجيًا، وmax_level يحدّ أعلى مستوى مسموح"""
    level = LEVEL_MAP.get(task_type, "medium")
    while True:
        answer, usage = call_hydrogen(prompt, level)
        print(f"[{level}] usage={usage}")  # تسجيل الـ Token لحساب تكلفة المهمة الناجحة
        if validator is None or validator(answer):
            return answer
        if level == max_level or level not in ESCALATE:
            return answer
        level = ESCALATE[level]


result = run_task(
    prompt="提取订单号,只返回数字:订单 A-20261113-889 已发货",
    task_type="extract",
    validator=lambda s: s.strip().replace("-", "").isalnum(),
)
print(result)
🚀 البدء السريع: توفّر APIYI على apiyi.com واجهة متوافقة مع OpenAI، فيكفي مفتاح API واحد لاستدعاء النماذج الشائعة مثل Gemini وClaude وOpenAI. ويحصل المستخدم الجديد على حصة اختبار مجانية، وهي مناسبة لتجربة استراتيجية التصنيف حسب المستوى أعلاه قبل الإطلاق الفعلي.
استراتيجية التصنيف: ابدأ بالدرجة المنخفضة، وارفعها عند الفشل
النهج الموصى به هو «الدرجة المنخفضة افتراضيًا، والرفع عند الحاجة»: استخدم Low أو Medium بشكل ثابت للمهام البسيطة؛ وابدأ من High في المهام المعقدة، ولا ترفع إلى XHigh إلا عند فشل التحقق؛ وحدّد سقفًا أعلى للدرجة لكل نوع من المهام، لتجنّب الانفجار المفاجئ في التكلفة. هذا يتوافق مع فكرة Google في Antigravity Orchestrator بتوزيع العمل بين نماذج مختلفة، إلا أن ما نُعدّله هنا هو عمق تفكير النموذج نفسه.
قياس أثر تحسين درجات Hydrogen بأربعة مؤشرات
| مؤشر التحسين | طريقة الحساب | سبب الاهتمام |
|---|---|---|
| الدقة / معدل النجاح | عدد المهام التي اجتازت التحقق ÷ إجمالي المهام | يجب ألا تنخفض الجودة بشكل ملحوظ بعد خفض الدرجة |
| الزمن الكلي | إجمالي المدة من إرسال الطلب حتى الحصول على نتيجة قابلة للاستخدام، بما في ذلك إعادة المحاولة | زمن ظهور أول رمز ليس إلا جزءًا منه |
| استهلاك الرموز (Token) | رموز الإدخال + الإخراج (بما فيها التفكير) | تُحتسب رموز التفكير بسعر الإخراج |
| تكلفة المهمة الناجحة | إجمالي التكلفة ÷ عدد المهام الناجحة | الفشل المتكرر وإعادة المحاولة عند الدرجة المنخفضة قد يكون أكثر تكلفة من الدرجة الأعلى |
«تكلفة المهمة الناجحة» هي المؤشر الأقرب إلى التكلفة الفعلية. إذا كانت 30% من المهام عند Medium تحتاج إلى إعادة تشغيل، بينما ينجح High من المحاولة الأولى، فقد تكون تكلفة المهمة الناجحة عند High أقل في الواقع.
الأسئلة الشائعة FAQ
Q1: هل مستويات التفكير الأربعة في Gemini 4 Hydrogen تعني أربعة نماذج مختلفة؟
لا. المستويات الأربعة هي أعماق استدلال مختلفة للنموذج نفسه `gemini-4-hydrogen`، ويتم التبديل بينها عبر المعامل thinking_level. سعر الرمز (Token) واحد في جميع الحالات، والفرق يكمن في عدد رموز التفكير التي يولّدها النموذج.
Q2: XHigh يتفوق على High بثلاث نقاط فقط، فهل لا حاجة لاستخدامه إطلاقًا؟
لا يمكن فهم الأمر بهذه الطريقة. النقاط الثلاث هي متوسط الفرق عبر مهام متعددة، لكن في الاستدلال العلمي والبراهين الرياضية ومهام الهندسة الكبيرة قد يكون XHigh هو الفيصل بين إنجاز المهمة أو عدمه. بالنسبة للمهام العادية، تكون القيمة مقابل التكلفة في XHigh منخفضة، أما في قلة من المهام فائقة الصعوبة فقد يكون ضروريًا.
Q3: متوسط زمن High هو 8.3 دقيقة، فهل يعني ذلك أن كل سؤال يتطلب انتظارًا بهذا الطول؟
لا. الرقم 8.3 دقيقة هو الزمن المرجّح لمهام التقييم المعيارية لدى Artificial Analysis. أما في المحادثات العادية، فالأولى قياس زمن تأخر أول رمز في الإجابة، وهو نحو 18.9 ثانية في High و5.7 ثانية في Low، كما أن المدة الفعلية تعتمد أيضًا على طول المهمة.
Q4: ماذا يحدث إذا لم يُمرَّر thinking_level؟
سيُستخدم High افتراضيًا. المشاريع المنتقلة من Gemini 3.8 Flash (الذي افتراضيه Medium) إذا استمرت في استخدام الكود القديم دون تمرير المعامل، فسيرتفع مستوى التفكير تلقائيًا، وقد ترتفع التكلفة معه، لذا يُنصح بضبط المستوى صراحةً.
Q5: كيف أقارن بسرعة تأثير المستويات المختلفة على عملي الخاص؟
يُنصح بتجهيز مجموعة من عينات المهام الحقيقية، وتشغيلها بمستويات مختلفة، ثم إحصاء معدل النجاح وكمية الرموز المستهلكة:
1. سجّل في APIYI على apiyi.com واحصل على مفتاح API وحصة اختبار مجانية
2. استخدم الكود الوارد في هذا المقال، وعدّل قيمة `thinking_level`
3. اختر المستوى الأنسب بناءً على “تكلفة المهمة الناجحة”
Q6: ما المشكلات المعروفة في مستويات التفكير العالية في Hydrogen؟
تشير بطاقة نموذج Google إلى أن مستويات التفكير العالية قد تزيد بوضوح من الزمن والتكلفة، وقد يحدث تأخر أو انتهاء مهلة أحيانًا. إضافة إلى ذلك، أبلغ مستخدمون على Hacker News عن وجود تنفيذ مفرط في بعض مهام الوكيل (Agent). يُنصح بضبط مهلة زمنية وأعلى مستوى وشروط توقف للمهام الطويلة.
Q7: ما الخطأ الأكثر شيوعًا عند تقدير التكلفة بالرموز (Token)؟
الاعتماد فقط على عدد أحرف الإجابة النهائية في التقدير. رموز التفكير تُحتسب ضمن سعر الإخراج، ورموز الإخراج في التقييم الكامل لـ XHigh تبلغ نحو 2.76 ضعف نظيرتها في High. وإن الاطلاع على تفاصيل الاستخدام الفعلي في لوحة تحكم APIYI على apiyi.com أكثر موثوقية من التقدير اليدوي.
النقاط الرئيسية لمستويات التفكير الأربعة في Gemini 4 Hydrogen
- نفس النموذج بمستويات مختلفة: سعر الوحدة متساوٍ في المستويات الأربعة، لكن التكلفة الفعلية للمهمة تتحدد بحجم توكنات التفكير.
- العائد المتناقص واضح: الانتقال من High إلى XHigh يضيف 3 نقاط، بينما تزداد تكلفة مهام التقييم بنحو 69%.
- زمن التأخير يتضاعف: زمن الوصول إلى أول إجابة في XHigh يبلغ نحو 37.8 ثانية، أي ضعف High.
- الافتراضي هو High: عند الانتقال من 3.8 Flash، ستحتاج إلى ضبط المستوى صراحةً.
- اختر المستوى حسب الصعوبة: استخدم Low للتصنيف، وMedium للمهام العادية، وHigh لمهام Agent، ولا تستخدم XHigh إلا في المسائل الصعبة.
- انظر إلى تكلفة المهام الناجحة: احسب إعادة المحاولات أيضًا، حتى تتمكن من مقارنة التكلفة الحقيقية للمستويات المختلفة.
- تحقق باستخدام العينات: يمكنك مقارنة أداء المستويات الأربعة عبر مفتاح واحد على APIYI apiyi.com.
الخلاصة
الاستنتاجات الأساسية من مقارنة مستويات التفكير الأربعة في Gemini 4 Hydrogen:
- فجوة القدرات كبيرة: من 27 نقطة في Low إلى 54 نقطة في XHigh؛ أي أن القدرات تتضاعف تحت اسم النموذج نفسه.
- التكلفة الحدية تتصاعد: التكلفة الإضافية لكل نقطة إضافية ترتفع من نحو $0.036 عند الانتقال من Low إلى Medium إلى نحو $0.43 عند الانتقال من High إلى XHigh.
- XHigh يُستخدم عند الحاجة فقط: الفرق في متوسط الدرجات صغير، لكنه قد يبقى حاسمًا لعدد قليل من المهام عالية الصعوبة.
في العمل اليومي، يُنصح بضبط thinking_level صراحةً: استخدم مستوى منخفضًا للمهام البسيطة، وارفع المستوى في الخطوات المعقدة، واجعل تكلفة المهمة الناجحة هي المعيار النهائي.
نوصي بالتحقق السريع من أداء كل مستوى باستخدام عينات مهام حقيقية عبر APIYI apiyi.com؛ فالمنصة توفر واجهة متوافقة مع OpenAI وحصة اختبار مجانية.
📚 المراجع
- Artificial Analysis – صفحة تقييم Gemini 4 Hydrogen بالمستويات الأربعة: بيانات مؤشر الذكاء وتكلفة المهمة والوقت المستغرق وزمن التأخير
- الرابط:
artificialanalysis.ai/models/gemini-4-hydrogen-low - الرابط:
artificialanalysis.ai/models/gemini-4-hydrogen-medium - الرابط:
artificialanalysis.ai/models/gemini-4-hydrogen-high - الرابط:
artificialanalysis.ai/models/gemini-4-hydrogen -
ملاحظات: مصدر جميع بيانات المقارنة بين المستويات الأربعة في هذا المقال، وزمن التأخير مؤشر متغير
-
مدونة Google الرسمية – Introducing Gemini 4 Hydrogen: إعلان الإطلاق
- الرابط:
blog.google/innovation-and-ai/models-and-research/gemini-models/introducing-gemini-4-hydrogen/ -
ملاحظات: تموضع النموذج ونطاق قدراته وحالات الشركاء
-
دليل مطوري Google Cloud – Gemini 4 Hydrogen:
thinking_levelوملاحظات الترحيل - الرابط:
docs.cloud.google.com/gemini-enterprise-agent-platform/models/guides/gemini-4-hydrogen -
ملاحظات: الاستخدامات الموصى بها للمستويات الأربعة، والمستوى الافتراضي، والمعاملات غير المتوافقة
-
صفحة أسعار Google AI Studio: أسعار API الرسمية لنموذج Hydrogen
- الرابط:
aistudio.google.com/docs/pricing -
ملاحظات: أسعار أوضاع Standard وBatch وFlex وPriority، وقواعد فوترة رموز التفكير
-
بطاقة نموذج Google DeepMind: القيود وتقييم الأمان
- الرابط:
deepmind.google/models/model-cards/gemini-4-hydrogen/ - ملاحظات: مخاطر الوقت المستغرق عند مستوى التفكير العالي، ومشكلات معروفة مثل الرفض والهلوسة
المؤلف: الفريق التقني في APIYI
للتواصل التقني: يسعدنا أن تتواصل معنا عبر الصفحة الرئيسية لموقع APIYI الرسمي، للحصول على مزيد من المواد حول ربط نماذج سلسلة Gemini