ملاحظة المؤلف: في هذا المقال، فصلنا بيانات GPT-6.2 Sol و Claude Opus 5.5 المتعلقة بالدرجة الشاملة من الطرف الثالث، والأسعار الرسمية المعلنة، وأسعار قراءة التخزين المؤقت، وحالة التوافر على APIYI، لمساعدتك في اختيار النموذج حسب المهمة بدلًا من الاعتماد على درجة إجمالية واحدة.
أصدرت OpenAI في 17 نوفمبر 2026 نموذجَي GPT-6.2 Astra و GPT-6.2 Sol. وتستخدم فرق كثيرة Claude Opus 5.5 بالفعل، وتحتاج الآن إلى الحسم فيما إذا كانت ستنتقل من عدمه. يقارن هذا المقال بين GPT-6.2 Sol و Claude Opus 5.5، ويقدم توصيات من عدة جوانب: الدرجة الشاملة، والسعر المعلن، وقراءة التخزين المؤقت، والبروتوكولات، وإمكانية الاستدعاء حاليًا.
هذا ليس مقالًا يعلن من الأقوى ومن الأرخص. في المؤشر الشامل من الطرف الثالث، تبلغ الدرجة القصوى لـ Sol مستوى أدنى بدرجتين من الدرجة القصوى لـ Opus. ووفق الأسعار الرسمية المعلنة للسياق القصير، فإن أسعار الإدخال والإخراج وقراءة التخزين المؤقت لكل وحدة في Sol تبلغ نحو نصف نظيراتها في Opus. ينبغي النظر إلى هاتين الحقيقتين معًا؛ فاتخاذ قرار استنادًا إلى أي منهما منفردةً يبقى قرارًا ناقصًا.
القيمة الأساسية: بعد قراءة هذا المقال، ستعرف ما تبلغه كل من النموذجَين من درجة شاملة وسعر معلن وسعر قراءة التخزين المؤقت، وأي الأرقام مصدرها الإعلانات الرسمية وأيها قياسات من الطرف الثالث، وكذلك النموذج المتاح للاستدعاء الآن على APIYI.
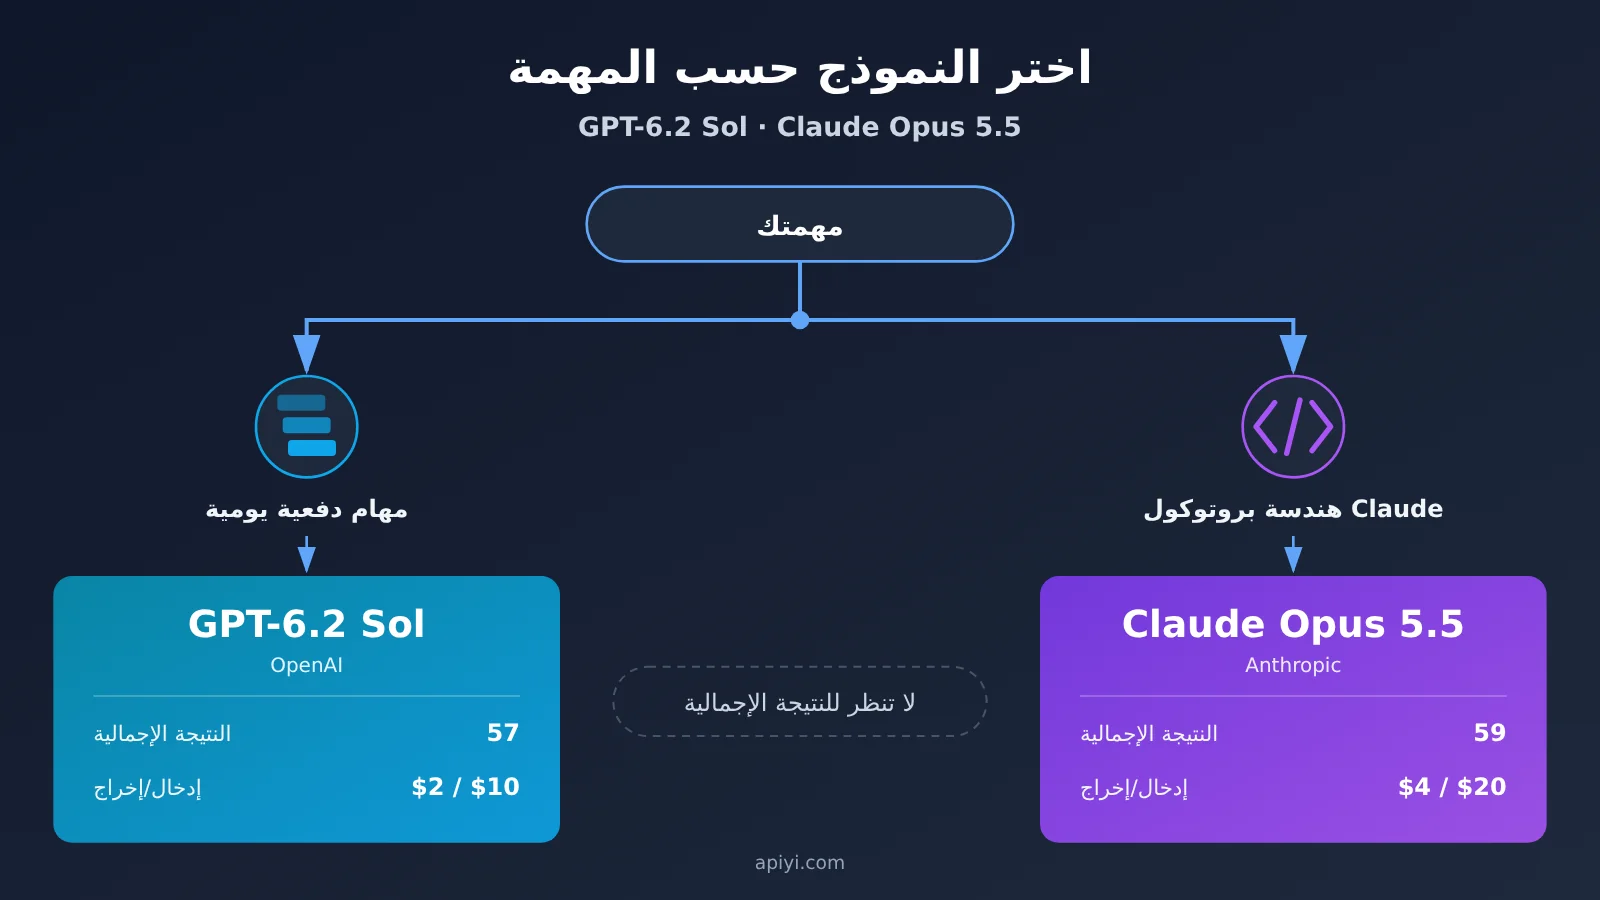
نظرة سريعة على الفروقات الجوهرية بين GPT-6.2 Sol و Claude Opus 5.5
نبدأ بوضع المجموعات الخمس من المعلومات الأكثر استخدامًا عند اختيار النموذج في جدول واحد. وقد أشرنا في كل صف إلى مصدر الأرقام، وستتناول الأقسام التالية كل بند بالتفصيل.
| بُعد المقارنة | GPT-6.2 Sol | Claude Opus 5.5 | مصدر الأرقام |
|---|---|---|---|
| المؤشر الشامل من طرف ثالث (أعلى مستوى استدلال) | 57 (مستوى Max) | 59 (أعلى مستوى) | Artificial Analysis، طرف ثالث |
| السعر المعلن للإدخال / الإخراج للسياق القصير | $2 / $10 | $4 / $20 | الأسعار الرسمية لكل نموذج، لكل مليون توكن |
| سعر قراءة الكاش | $0.10 | $0.20 | صفحة نماذج OpenAI؛ أما سعر Opus فهو منقول عن قائمة أسعار Anthropic |
| نافذة السياق / الحد الأقصى للإخراج | 1,050,000 / 128,000 | 1M / 128K | صفحات النماذج الرسمية والوثائق |
| الحالة الحالية على APIYI | غير مدرج بعد | مدرج بالفعل، claude-opus-5-5 |
القائمة الشاملة للنماذج وواجهة التسعير في APIYI |
درجة شاملة أقل بنقطتين وسعر معلن يقارب النصف: لماذا ننظر إليهما معًا؟
إذا نظرت إلى الدرجة الشاملة وحدها، فستفصل إلى أن «Opus أعلى»؛ وإذا نظرت إلى السعر المعلن وحده، فستفصل إلى أن «سعر Sol للوحدة أقل». كلا الاستنتاجين صحيح، لكن كليهما يروي نصف القصة فقط: فالدرجة الشاملة تعكس متوسط الأداء على مجموعة مهام مختلطة، والسعر المعلن يعكس تكلفة المليون توكن الواحد، بينما تتوقف فاتورتك الفعلية أيضًا على حجم التوكنات الذي يستهلكه كل مهمة.
إضافةً إلى ذلك، فإن فارق النقطتين مصدره اختبارات أجراها Artificial Analysis عند أعلى مستوى استدلال. وإذا كان عملك يعتمد على مستوى الاستدلال الافتراضي، أو كانت أنواع مهامك تختلف كثيرًا عن الفهارس المعتمدة في هذا الاختبار، فلن تنتقل هذه النقطتان بالضرورة إلى وضعك مباشرةً. لذلك فإن نهج هذه المقالة هو: توضيح الأرقام أولًا، ثم الاختيار وفق نوع المهمة.
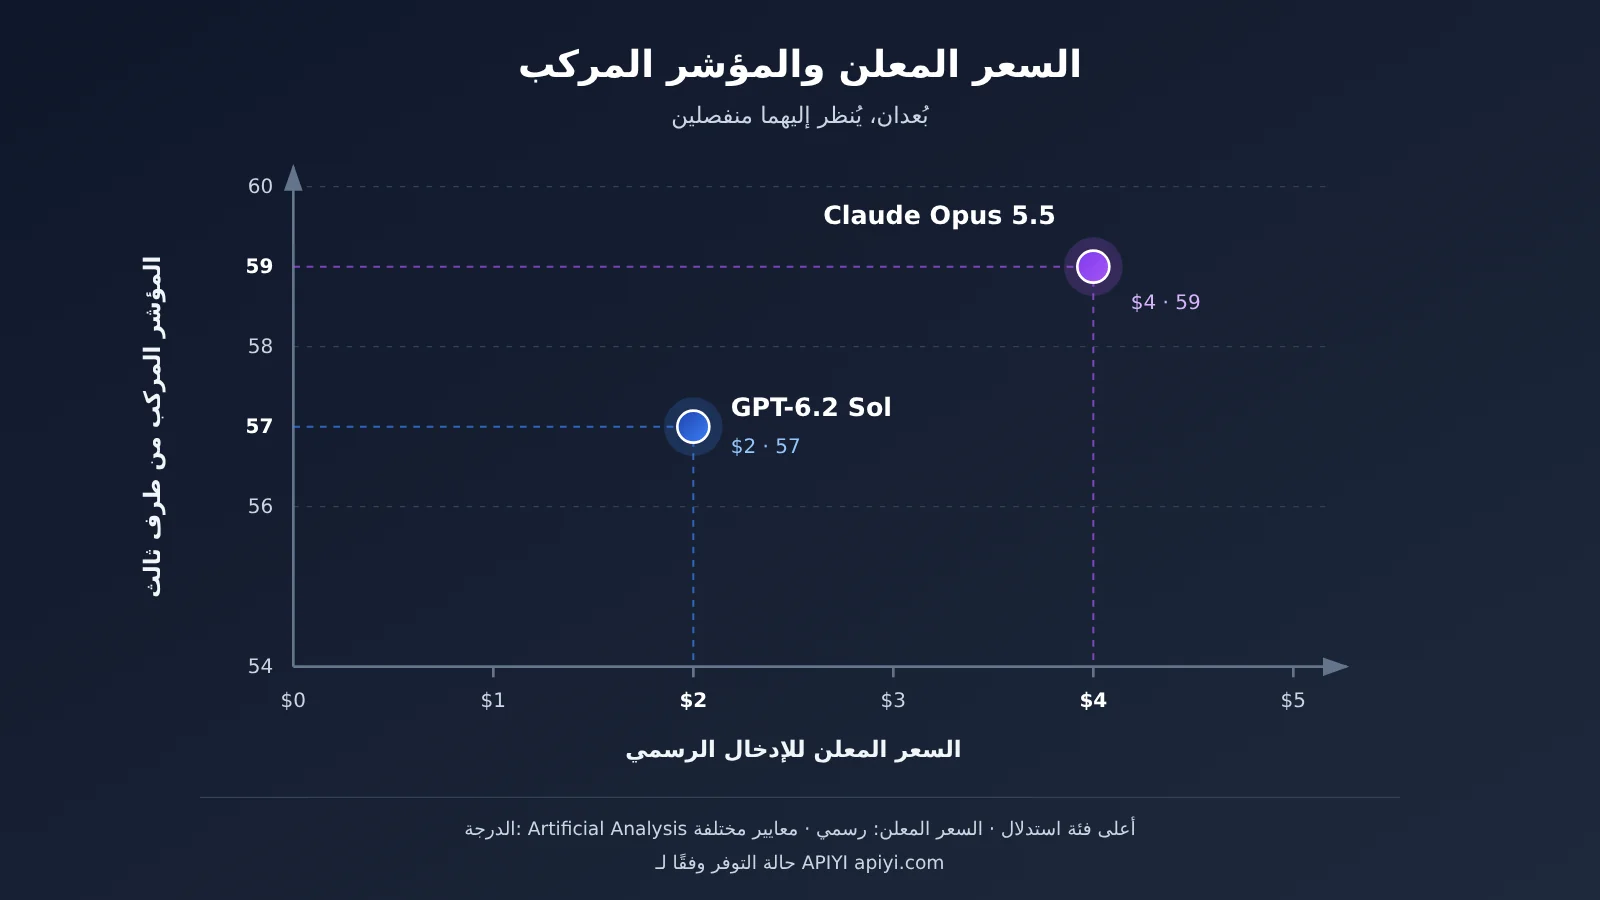
مقارنة الأسعار المعلنة وقراءة الذاكرة المؤقتة بين GPT-6.2 Sol وClaude Opus 5.5
السعر هو الجانب الأكثر عرضةً لسوء الفهم عند اختيار النموذج هذه المرة. يعرض الجدول التالي السعر الرسمي وسعر منصة APIYI في أعمدة منفصلة، وجميع الأرقام هي لكل مليون token، والافتراضي هو الفئة القياسية للسياق القصير.
| بند التسعير | السعر الرسمي لـ GPT-6.2 Sol | السعر الرسمي لـ Claude Opus 5.5 | Claude Opus 5.5 على APIYI | GPT-6.2 Sol على APIYI |
|---|---|---|---|---|
| الإدخال | $2 | $4 | $4 | غير متوفر بعد |
| الإخراج | $10 | $20 | $20 | غير متوفر بعد |
| قراءة الذاكرة المؤقتة | $0.10 | $0.20 | $0.2 | غير متوفر بعد |
| كتابة الذاكرة المؤقتة | $2.50 لمدة 30 دقيقة؛ $5 لمدة 12 ساعة | $5 لمدة 5 دقائق؛ $8 لمدة ساعة (وفق نقل قائمة الأسعار) | يُرجى الرجوع إلى قائمة المنصة | غير متوفر بعد |
| قاعدة الإدخال فائق الطول | رسوم إضافية على الطلب بأكمله عند تجاوز 272K | لم تغطه المصادر المرجعية | يُرجى الرجوع إلى قائمة المنصة | غير متوفر بعد |
السعر الرسمي المعلن لـ GPT-6.2 Sol في وضع السياق القصير هو $2 للإدخال و$10 للإخراج و$0.10 لقراءة الذاكرة المؤقتة، ويوضح بيان الإطلاق أنه حافظ على أسعار API token الخاصة بـ GPT-6.1 Sol. على منصة APIYI، لم يُدرج GPT-6.2 Sol بعد، وسنعمل على إدراجه في أقرب وقت ممكن؛ ويُرجى اعتماد قائمة الموديلات على المنصة مرجعًا لمعرفة الموديلات والأسعار.
السعر الرسمي المعلن لـ Claude Opus 5.5 هو $4 للإدخال و$20 للإخراج. أما قراءة الذاكرة المؤقتة بسعر $0.20 وسعر كتابة الذاكرة المؤقتة ($5 لمدة 5 دقائق و$8 لمدة ساعة) فهي منقولة من قائمة أسعار Anthropic، ويُرجى اعتماد صفحة Anthropic الرسمية فيما يخص سعر الكتابة. في الجدول الإجمالي لموديلات APIYI (وقت البيانات 2026-11-17 الساعة 15:54 بتوقيت UTC+8)، كلٌّ من claude-opus-5-5 وclaude-opus-5-5-thinking متوفران على المنصة، والأسعار المعلنة هي $4 / $20 / $0.2. يمكنك التحقق مباشرة من هذه البنود في قائمة الموديلات على APIYI عبر apiyi.com.
وتجدر الإشارة إلى أمر هام: الموديلان gpt-6.1-sol (بسعر $2 / $10 / $0.1) وgpt-6-sol (بسعر $2 / $10 / $0.2) الظاهران حاليًا في الجدول الإجمالي لـ APIYI ليسا من إصدار 6.2. لا يمكن اعتبار أسعارهما أسعارًا لـ GPT-6.2 Sol على المنصة، كما أنهما لا يعكسان قدرات الإصدار 6.2.
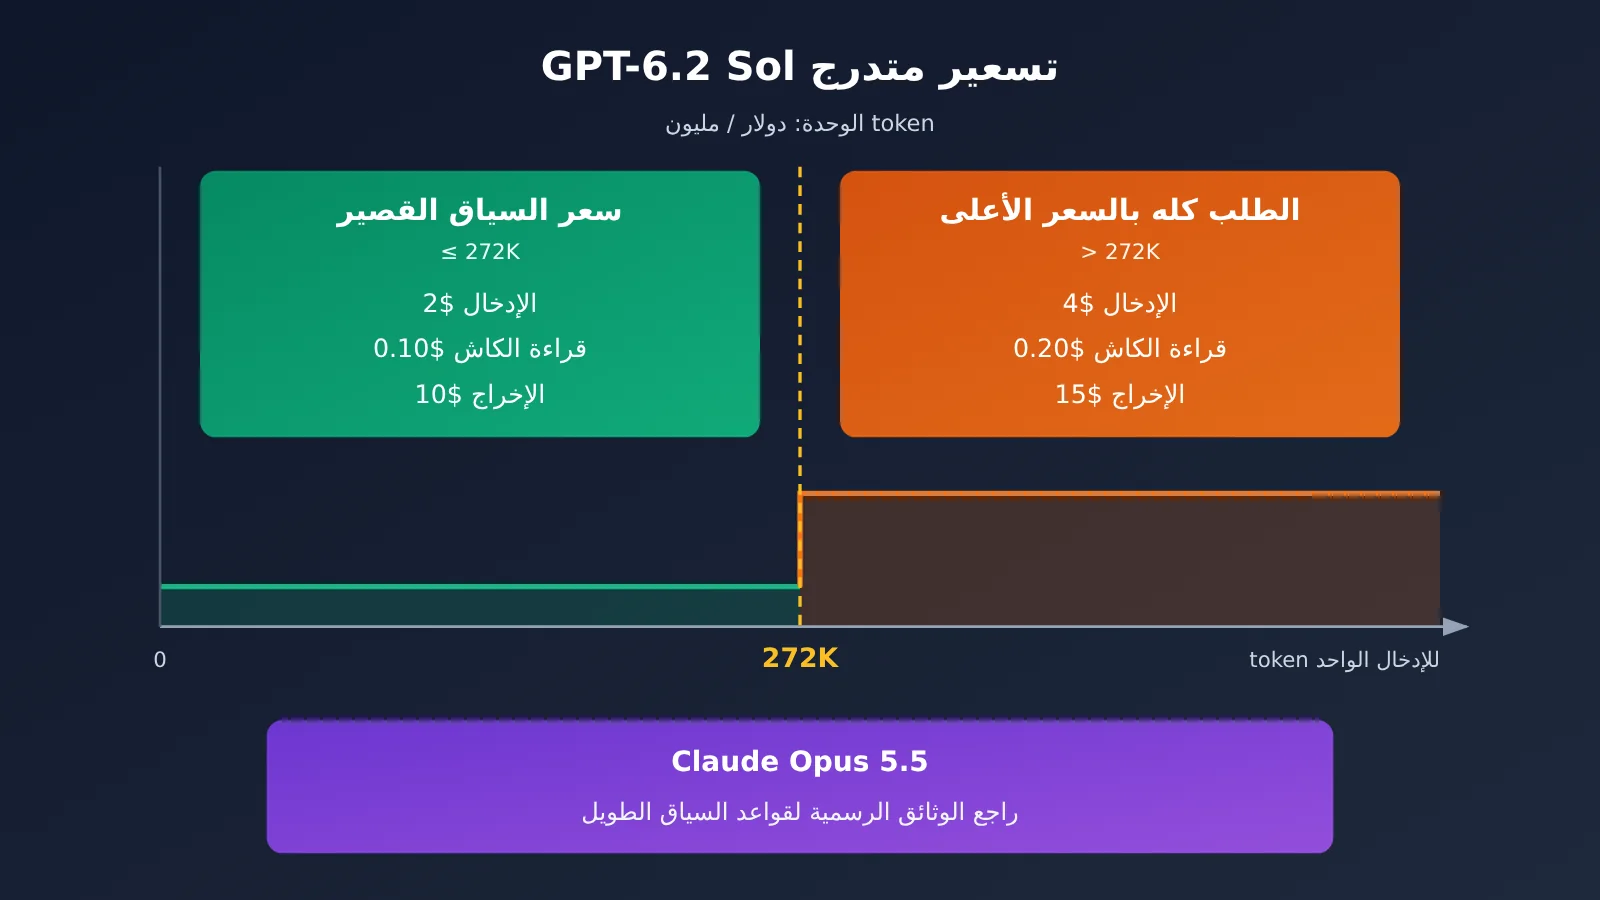
قواعد تسعير الطلب الكامل عند 272K في GPT-6.2 Sol
توضح صفحة النماذج لدى OpenAI أنه عندما يتجاوز إدخال الطلب الواحد 272 ألف توكن (token)، يتضاعف سعر الإدخال والذاكرة المؤقتة، ويُحسب الإخراج بمعدل 1.5 ضعف سعر السياق القصير، والأهم من ذلك أن الفاتورة بأكملها تُحسب بالسعر الجديد، وليس فقط الجزء الزائد عن هذا الحد. بالتحويل إلى Sol، يعني ذلك: الإدخال $4، وقراءة الذاكرة المؤقتة $0.20، والإخراج $15.
تؤثر هذه القاعدة كثيرًا في مهام المستندات الطويلة. إذا كانت طلباتك المعتادة تقترب غالبًا من حد 272K، فستتضاءل ميزة السعر المعلن “بنحو النصف” بشكل ملحوظ. أما ما إذا كان لدى Opus 5.5 قاعدة مماثلة للسياق الطويل، فلم تغطِّها المصادر المرجعية لهذه المقالة، لذا يُنصح بمراجعة وثائق Anthropic مباشرة قبل إجراء المقارنة.
إلى جانب ذلك، تُسعَّر خدمة Batch في Sol بنسبة 50% من السعر القياسي، بينما تكلف Fast ضعفَ السعر القياسي نفسه لطول السياق ذاته. أما Ultrafast فتساوي 3 أضعاف السعر القياسي حتى تاريخ 2027-02-28 (بتوقيت المحيط الهادئ)، وترتفع إلى 6 أضعاف اعتبارًا من 2027-03-01.
مثال توضيحي لتكلفة الطلب الواحد وفق الأسعار المعلنة
ولكي تكون الصورة أوضح، إليك حساب رياضي افتراضي بالكامل وفق الأسعار الرسمية المعلنة، ولا يمثل أي فاتورة فعلية. لنفترض أن طلبًا واحدًا يتضمن 100 ألف توكن إدخالًا و10 آلاف توكن إخراجًا دون استخدام الذاكرة المؤقتة: تكلفة Sol تقارب $0.20 + $0.10 = $0.30، بينما تقارب تكلفة Opus $0.40 + $0.20 = $0.60.
يستند هذا المثال إلى افتراضين: أن النموذجين يستهلكان العدد نفسه من التوكنات في المهمة نفسها، وأن الطلب لا يتجاوز 272K. أما في الاستخدام الفعلي، فيختلف استهلاك توكنات الاستدلال باختلاف النموذج ومستوى جهد الاستدلال وطبيعة المهمة، لذا فإن حساب التكلفة الحقيقية يتطلب تشغيل مهمتك الخاصة مرة واحدة أولًا ثم إجراء الحساب.
أرقام قدرات GPT-6.2 Sol و Claude Opus 5.5: مصدران يُقرآن كلٌّ على حدة
تأتي أرقام القدرات من مصدرين: أحدهما التقييمات المستقلة من Artificial Analysis، والآخر البيانات الرسمية ذاتية الإبلاغ الواردة في إعلانات OpenAI وصفحات النماذج. يختلف المصدران في المهام ومستويات الاستدلال ومعايير التكلفة، لذا سنعِرضهما أدناه كلًّا على حدة، من دون دمجهما في استنتاج واحد.
المؤشر الشامل من الجهة الخارجية Artificial Analysis (Intelligence Index v5.0.1)
| النموذج ومستوى الاستدلال | المؤشر الشامل | تكلفة المهمة الواحدة ضمن المؤشر الشامل | ملاحظات |
|---|---|---|---|
| GPT-6.2 Sol (Max) | 57 | $1.01 | أعلى بدرجتين من GPT-6.1 Sol |
| GPT-6.2 Sol (Xhigh) | 56 | غير مُدرجة على حدة | مصدر خارجي |
| GPT-6.2 Sol (High) | 55 | غير مُدرجة على حدة | مصدر خارجي |
| GPT-6.2 Sol (Medium) | 53 | غير مُدرجة على حدة | مصدر خارجي |
| GPT-6.2 Sol (Low) | 41 | غير مُدرجة على حدة | مصدر خارجي |
| Claude Opus 5.5 (أعلى مستوى) | 59 | غير مشمولة في مصادر هذه المقالة | من المقالة نفسها |
قيمة $1.01 الخاصة بـ Sol ليست سوى متوسط تكلفة إنجاز مهمة واحدة ضمن هذا المؤشر الشامل، وليست سعرًا موحدًا لكل المهام، ولا يمكن قسمتها على أرقام التكلفة الصادرة من مصادر أخرى. أما تكلفة المهمة الواحدة لـ Opus 5.5 ضمن هذا المؤشر فلم ترد في المراجع، ولن نجري أي تقدير بشأنها في هذه المقالة.
تقدم المقالة الخارجية نفسها أيضًا عدة نتائج تفصيلية تستحق الانتباه. فعلى مؤشر Coding Agent Index (مع Codex harness وبمستوى Max) جاء Sol أقل بثلاث درجات من GPT-6.1 Sol، ويعود السبب الرئيسي إلى تراجعه بمقدار 14 درجة في SWE-Atlas-QnA-AA، ما يجعله أكثر عرضة لإغفال الحقائق الأساسية. أما معدل الهلوسة في AA-Omniscience (بمستوى Max) فقد بلغ 55% لـ Sol. وفي المعاينة البحثية AA-Robotics v0.1 حصل Sol على 78. وهذه البنود التفصيلية لا تتضمن أرقامًا مقارنة لـ Opus 5.5، لذا لا تصلح إلا لفهم نقاط القوة والضعف في أداء Sol بذاته.
بيانات GPT-6.2 Sol المعلنة ذاتيًا من OpenAI
جميع الأرقام التالية مأخوذة من منشورات OpenAI الرسمية، وهي أرقام معلنة ذاتيًا، والنماذج المقارَن بها هي في معظمها نماذج OpenAI نفسها، وليست Claude Opus 5.5:
- FrontierCode 2.0 (من إنتاج Cognition، ويقيس ما إذا كان القائمون على الصيانة سيدمجون التعديلات المقدمة على مستودعات الأكواد الحقيقية): الفرق بين Sol وGPT-6.2 Astra أقل من 0.5 نقطة، بتكلفة تعادل الخُمس تقريبًا، وكلاهما يعمل على الفئة Max.
- LifeVal (مجموعة مهام يومية أنشأتها OpenAI بنفسها): سجّل Sol نتيجة أعلى من GPT-6 Astra، بتكلفة تعادل السُبع تقريبًا.
- GDPval v2 (تقييم داخلي رسمي): يتفوق Sol على GPT-6.1 Sol بفارق 5.3 نقطة.
- Elo في التقييم الأعمى البشري AA-3D (بالنقل عن المصدر الرسمي): سجّل Sol نتيجة 1259.
لماذا لا يمكن جمع مجموعتي الأرقام معًا
المؤشر المركّب الصادر عن طرف ثالث يُحسب بتشغيل مجموعة مهام ثابتة على أعلى مستوى استدلال، بينما الأرقام المعلنة ذاتيًا رسميًا هي في معظمها عبارات نسبية من نوع «كم يتجاوز الجيل السابق» و«كم تبلغ التكلفة من الأصل». فالأسس المعيارية ومستويات الاستدلال وطرق حساب التكلفة تختلف بين المجموعتين. ودمج «الدرجة المركّبة الأقل بنقطتين» مع «الاقتراب من Astra في أحد الاختبارات الرسمية» لن يمنحك استنتاجًا مفاده أن «Sol أقوى إجمالًا» أو أن «Opus أقوى إجمالًا».
أما القراءة الأكثر عملية فهي: الدرجة المركّبة من طرف ثالث تخبرك بالموقع التقريبي للنموذجين في المهام المختلطة العامة، بينما تخبرك الأرقام المعلنة ذاتيًا في أي السيناريوهات ركّزت OpenAI على تحسين Sol، مثل المهام اليومية ومهام دمج الأكواد. ويبقى في النهاية أداء النموذج في مهامك أنت هو المعيار الحاسم.
الفروقات في المواصفات والبروتوكولات بين GPT-6.2 Sol وClaude Opus 5.5
إلى جانب الدرجات والأسعار، غالبًا ما تكون طريقة الربط هي العامل الفعلي الذي يحدد إمكانية التبديل فورًا. يعرض الجدول التالي الفروقات في المواصفات ونقاط النهاية بين النموذجين.
| بند المواصفات | GPT-6.2 Sol | Claude Opus 5.5 |
|---|---|---|
| وسائط الإدخال | النص والصور (لا يدعم الصوت أو الفيديو) | لم تُفصَّل في المصادر المرجعية |
| نافذة السياق | 1,050,000 (الحد الأقصى للإدخال 922,000) | 1M |
| الحد الأقصى للمخرجات | 128,000 | 128K |
| تاريخ قطع المعرفة | 2026-06-01 | 2026-06 |
| قوة الاستدلال | يدعم رموز الاستدلال (token)؛ واجهة API لا تقبل ضبط effort على none | القيمة الافتراضية لـ effort هي medium |
| نقاط النهاية الرسمية | Chat Completions وResponses وBatch | Anthropic Messages |
| نقاط نهاية APIYI | لم تُطرح بعد | chat وmessages |
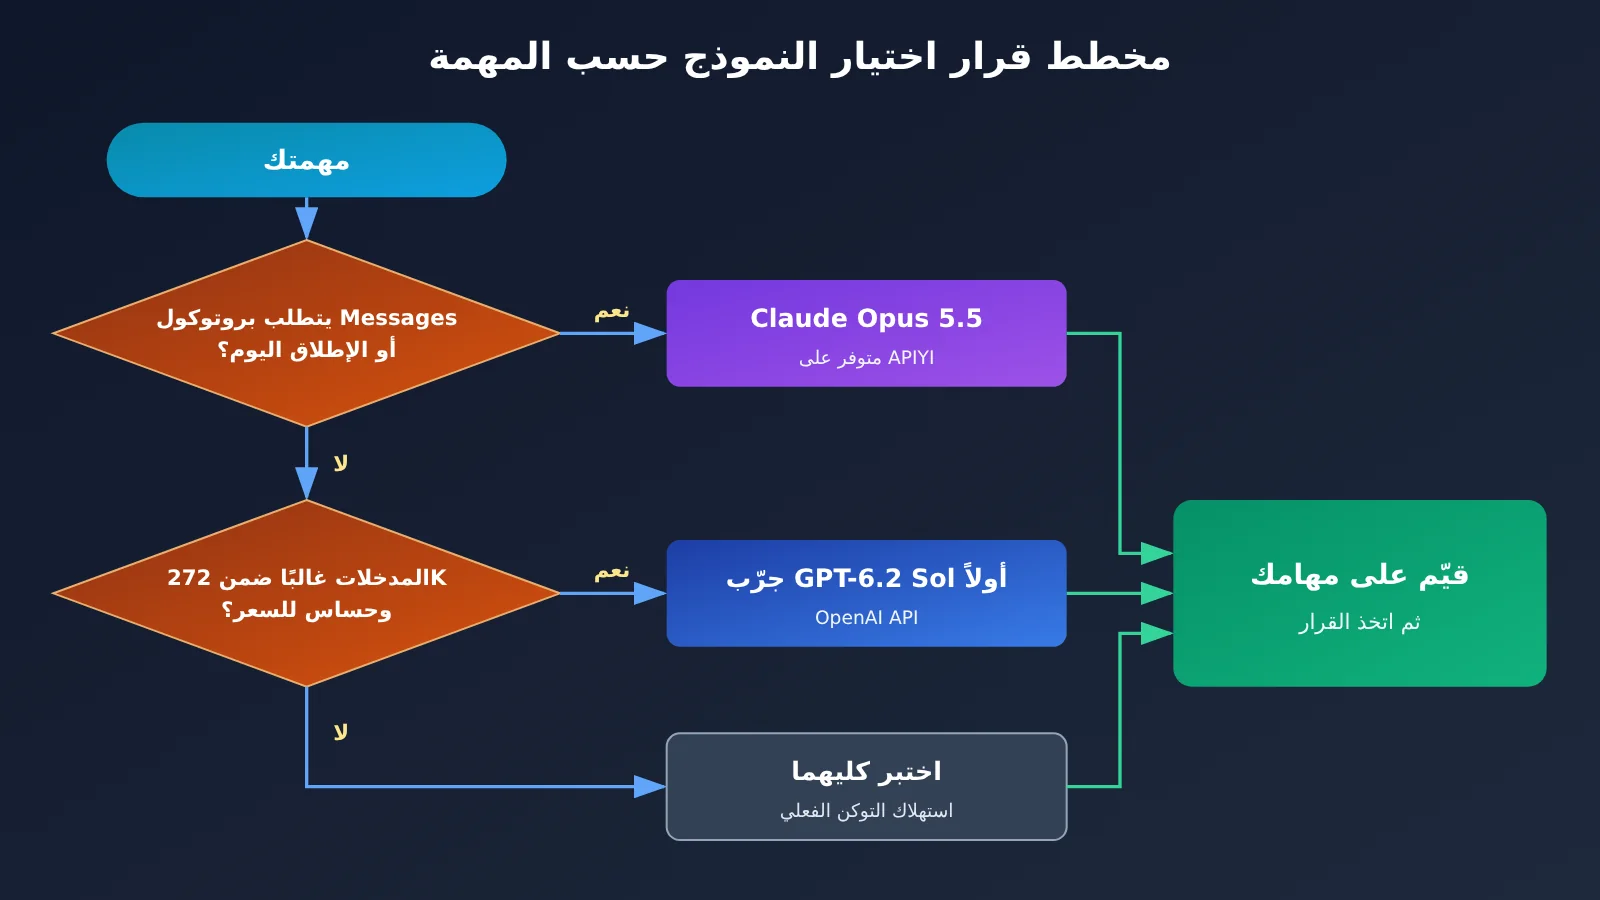
إذا كانت سلسلة أدواتك تعتمد على بروتوكول Messages الخاص بـ Claude، مثل Claude Code أو وكلاء Agent مبنيين على Anthropic SDK، فسيوفر لك Opus 5.5 على APIYI نقاط نهاية من النوعين معًا: chat وmessages، وتشمل المجموعات كلًا من ClaudeCode وClaude_Reverse وClaude_Enterprise وDefault وSVIP. بهذا لن يبقى على عاتقك في التبديل سوى تعديل base URL ومفتاح API.
أما GPT-6.2 Sol فيعتمد على بروتوكولي Chat Completions وResponses من OpenAI. وتوضح صفحة النموذج الرسمية صراحةً أن Realtime وAssistants والضبط الدقيق وتوليد الصور والفيديو والصوت كلها غير مدعومة، فهذه الفئات من الاحتياجات لا يمكن الاعتماد عليه في تلبيتها.
توصيات السيناريوهات لكل من GPT-6.2 Sol و Claude Opus 5.5
الاختيار بحسب المهمة أضمن من الاختيار بحسب الدرجة الإجمالية. سنشرح أدناه نوعين من السيناريوهات، ثم نختم بجدول واحد جامع.
السيناريوهات التي تختار فيها Claude Opus 5.5
- الحاجة إلى بروتوكول Claude: إذا كان كودك الحالي مبنيًا على Anthropic Messages أو يعتمد على أدوات مثل Claude Code، فإن تكلفة إعادة هندسة الكود للانتقال إلى بروتوكول آخر تفوق فارق السعر الوحدوي.
- الإطلاق اليوم: Opus 5.5 مدرج بالفعل على APIYI، فيمكنك الربط به فورًا دون انتظار طرح النموذج الجديد.
- الدرجة الإجمالية معيار حاسم: إذا كانت مهمتك قريبة من التقييمات الهجينة العامة، وكان فرق النقطتين عند أعلى فئة استدلال مؤثرًا فعليًا في نتائجك.
السيناريوهات التي تبدأ فيها بـ GPT-6.2 Sol
- المهام الدفعية اليومية الحساسة لسعر الوحدة: التسعير الرسمي لنافذة السياق القصيرة يعادل نحو نصف سعر Opus، وكذلك قراءة ذاكرة التخزين المؤقت، وهو ما يناسب السيناريوهات عالية التكرار وكثيفة إعادة استخدام الموجهات.
- أغلب الطلبات ضمن 272K: عندها فقط تحصل على سعر نافذة السياق القصيرة بثبات وتتجنب الرسوم الإضافية على الطلب بالكامل.
- أنت ضمن منظومة بروتوكول OpenAI أصلًا: عبر Responses أو Chat Completions، تكون تعديلات الترحيل في حدها الأدنى.
تجدر الإشارة إلى أن “البدء بـ Sol” لا يعني أن درجته الإجمالية أعلى؛ فالأرقام المنشورة من جهات خارجية تدل على العكس تمامًا. المقصود أن السيناريوهات الحساسة لسعر الوحدة والمهام اليومية تستحق تجربة Sol أولًا على مهامك الحقيقية.
| نوع المهمة | الخيار الأول | السبب الرئيسي | المنصات المتاحة |
|---|---|---|---|
| مهام هندسية على بروتوكول Claude Code / Messages | Claude Opus 5.5 | بروتوكول أصلي بلا حاجة للتعديل | APIYI apiyi.com، مدرج بالفعل |
| مهام إنتاجية تتطلب إطلاقًا فوريًا | Claude Opus 5.5 | متاح للاستدعاء حاليًا | APIYI، مدرج بالفعل |
| مهام يومية عالية التكرار مع إعادة استخدام ذاكرة التخزين المؤقت للموجهات | GPT-6.2 Sol | الأسعار الرسمية للمدخلات والمخرجات وقراءة ذاكرة التخزين المؤقت نحو النصف | OpenAI API؛ غير مدرج بعد على APIYI |
| مهام مستندات طويلة تتجاوز 272K | احسب التكلفة لكليهما حسب عدد الرموز (token) الفعلي | لدى Sol قاعدة رسوم إضافية على الطلب بالكامل | وفق قوائم النماذج في كل منصة |
| أسئلة وأجوبة حساسة لتفويت الحقائق الأساسية | ابدأ بتقييم مخصص | يتراجع Sol في SWE-Atlas-QnA-AA (أرقام خارجية) | وفق قوائم النماذج في كل منصة |
البدء السريع مع GPT-6.2 Sol وClaude Opus 5.5
النموذج الذي يمكن استدعاؤه مباشرة عبر APIYI حاليًا هو Claude Opus 5.5. وإليك خطوات الربط، وكلها تقتصر على تعديل الإعدادات دون الحاجة إلى أي تبعيات إضافية:
- سجّل في APIYI وأنشئ مفتاح API؛ فالمستخدمون الجدد يحصلون على رصيد اختبار مجاني.
- اضبط base URL الخاص بالعميل على
https://api.apiyi.com/v1، وهو عنوان واجهة متوافقة مع OpenAI. - أدخل اسم النموذج
claude-opus-5-5؛ وإذا احتجت إلى عملية تفكير صريحة، يمكنك استخدامclaude-opus-5-5-thinkingبدلًا منه. - إذا كنت تستخدم عميلًا بنمط Anthropic، فاعتمد مباشرة على نقطة النهاية messages؛ أما إذا كنت تستخدم OpenAI SDK فاستخدم نقطة النهاية chat.
- أجرِ جولة تقييم باستخدام 5 إلى 10 طلبات حقيقية من أعمالك، وسجّل عدد الـ tokens للمدخلات والمخرجات وإصابات ذاكرة التخزين المؤقت، ثم احسب تكلفة المهمة الواحدة وفق أسعار المنصة المعلنة: $4 / $20 / $0.2.
معرّف نموذج GPT-6.2 Sol هو gpt-6.2-sol، ويمكن رسميًا استدعاؤه عبر OpenAI API، كما أصبح متاحًا في ChatGPT Work وCodex لمشتركي الخطط Plus وPro وEnterprise وEdu. أما على APIYI، فالنموذج لم يُطرَح بعد، وسنعمل على إتاحته في أقرب وقت ممكن؛ مع العلم أن النماذج والأسعار المعتمدة هي الواردة في قائمة النماذج على المنصة. وقبل طرحه، نرجو ألا تستخدم gpt-6.1-sol بديلًا عنه في التقييم، فالاثنان ليسا النموذج نفسه.
🚀 البدء السريع: ننصحك أولًا بتشغيل
claude-opus-5-5عبر الرصيد المجاني على APIYI apiyi.com، مع تدوين استهلاك الـ tokens لمهامك. وبمجرد طرحgpt-6.2-sol، شغّل الجولة نفسها بالاعتماد على الطلبات ذاتها ونفس base URL مع تغيير اسم النموذج فقط، وبهذا تتمكن من مقارنة التكلفة والأداء بين الجانبين في جدول واحد.
توصيات لاتخاذ القرار بين GPT-6.2 Sol و Claude Opus 5.5
💡 توصية الاختيار: إذا كنت تريد بروتوكول Claude وتريد نموذجًا يمكن استدعاؤه فورًا اليوم، فاختر Claude Opus 5.5؛ أما إذا كنت تبحث عن نموذج للاستخدام اليومي بسعر رسمي أقل، فيمكنك التركيز على GPT-6.2 Sol، لكن لا تدّعِ أن نتيجته الإجمالية أعلى. وفي النهاية، قيّم النموذجين بمهامك الخاصة؛ فمن خلال الواجهة الموحدة من APIYI عبر apiyi.com، يمكن للنموذجين مشاركة كود استدعاء النموذج نفسه، وعند التبديل بينهما يكفي تغيير اسم النموذج فقط.
في التنفيذ الفعلي، هناك ثلاث نقاط تستحق الانتباه. أولًا، عند التقييم يجب مواءمة قوة الاستدلال بين النموذجين؛ فالنتيجة الإجمالية من الطرف الثالث مبنية على أعلى مستوى، بينما المستوى الافتراضي لـ Opus هو medium، وعند اختلاف المستويات ستتغير النتائج واستهلاك الـ tokens معًا. ثانيًا، في المهام التي تكون بادئة الموجه فيها ثابتة، يجب أخذ الذاكرة المؤقتة في الحسبان؛ فسعر قراءة الذاكرة المؤقتة متساوٍ لدى الطرفين ويبلغ جزءًا واحدًا من عشرين من سعر الإدخال، وعندما ترتفع نسبة الإصابة يتضخم الفارق في الفاتورة أو يتقلص. ثالثًا، بالنسبة لمهام المستندات الطويلة، لا بد من حساب الحالات التي تتجاوز 272K على حدة.
الأسئلة الشائعة (FAQ)
س1: ما مكانة كل من GPT-6.2 Sol و Claude Opus 5.5؟
GPT-6.2 Sol هو نموذج أطلقته OpenAI في 2026-11-17، يستقبل النصوص والصور كمدخلات ويُخرج نصوصًا، وتصل نافذة السياق لديه إلى 1,050,000، ويوصف رسميًا بأنه موجّه للمهام اليومية والعمل الحقيقي بكفاءة عالية. أما Claude Opus 5.5 فهو نموذج من Anthropic، بنافذة سياق تبلغ 1M وأقصى إخراج قدره 128K، وقوة الاستدلال الافتراضية لديه هي medium.
س2: أيهما أقوى: GPT-6.2 Sol أم Claude Opus 5.5؟
لا يوجد مجموع نقاط واحد يمكنه الإجابة عن هذا السؤال. ففي المؤشر الشامل من الطرف الثالث الصادر عن Artificial Analysis، سجّلت نسخة Sol في فئة Max نقاطًا قدرها 57، بينما سجّلت الفئة الأعلى من Opus 59 نقطة. وفي النتائج الرسمية المُبلَّغ عنها ذاتيًا، برز Sol في مشاريع مثل FrontierCode 2.0 وLifeVal، لكن المقارنة كانت أساسًا مع نماذج OpenAI نفسها. ننصح بتقييم النموذج وفق مهمتك الفعلية، لا بالاعتماد على المجموع الكلي عند الاختيار.
س3: هل يمكن استدعاء GPT-6.2 Sol حاليًا عبر APIYI؟
ليس بعد. فالقائمة الشاملة لنماذج APIYI (بتاريخ 2026-11-17 الساعة 15:54 بتوقيت UTC+8) وواجهة التسعير العامة لا تتضمنان `gpt-6.2-sol`. لم يُطرَح GPT-6.2 Sol على المنصة حتى الآن، وسنعمل على إتاحته في أقرب وقت ممكن؛ ويُعتمد في أسماء الطُرز والأسعار على قائمة نماذج المنصة.
س4: ما سعر Claude Opus 5.5 ونقاط النهاية الخاصة به على APIYI؟
كلا الطرازين `claude-opus-5-5` و`claude-opus-5-5-thinking` متاحان على المنصة، والأسعار المعلنة هي: $4 للمدخلات، و$20 للمخرجات، و$0.2 لقراءة ذاكرة التخزين المؤقت (لكل مليون token)، وتدعم نقاط النهاية كلاً من chat وmessages. يمكنك استدعاء النموذج باستخدام المفتاح نفسه من APIYI عبر apiyi.com، مع ضبط base URL على `https://api.apiyi.com/v1`.
س5: هل يمكن استخدام تكلفة المهمة الواحدة البالغة $1.01 لـ Sol مباشرة في حسابات التكلفة؟
لا. فقيمة $1.01 هي متوسط التكلفة التي قاستها Artificial Analysis ضمن مجموعة مهام المؤشر الشامل وفي فئة الاستدلال Max، وهي مخصصة لتلك المجموعة التقييمية فقط. وستختلف التكلفة في حالتك لأن طول مهامك واستهلاكها للاستدلال يختلفان. ولا تغطي بيانات هذه المقالة تكلفة المهمة الواحدة لـ Opus 5.5 ضمن هذا المؤشر نفسه، لذا لا يمكن استخدامها لقسمة التكلفة بين الطرفين.
س6: ما العلاقة بين GPT-6.2 Astra وSol، وهل يجب التفكير فيه أيضًا؟
Astra هو طراز آخر صدر ضمن الدفعة نفسها، والأسعار الرسمية للسياق القصير هي: $8 للمدخلات، و$0.40 لقراءة ذاكرة التخزين المؤقت، و$40 للمخرجات، وقد سجّل درجات أعلى من Sol في المؤشر الشامل من الطرف الثالث. على APIYI، لم يُطرَح GPT-6.2 Astra بعد، وسنعمل على إتاحته في أقرب وقت ممكن؛ ويُعتمد في أسماء الطُرز والأسعار على قائمة نماذج المنصة. تقارن هذه المقالة بين Sol وOpus 5.5، أما Astra فمستواه السعري يقع في فئة مختلفة عنهما.
س7: هل توجد نماذج أخرى بنطاق السعر نفسه يمكن المقارنة بها؟
يمكنك الاطلاع على Gemini 4 Carbon. أدرج APIYI النموذج `gemini-4-carbon` بالفعل على منصته، وتذكر صفحة النموذج أسعارًا تمهيدية: الإدخال $2، وقراءة ذاكرة التخزين المؤقت $0.1، والإخراج $10. انتبه إلى أن الأسعار الرسمية من Google ستتحول اعتبارًا من 2026-12-01 إلى إدخال $4 وإخراج $20 وقراءة ذاكرة التخزين المؤقت $0.20، ولم تذكر صفحة المنصة هذا التعديل السعري حتى الآن، لذا بعد 1 ديسمبر يُرجى الاعتماد على قائمة النماذج في APIYI على apiyi.com.
س8: ما هي القيود المعروفة في GPT-6.2 Sol؟
توضح صفحة النموذج الرسمية صراحة أنه لا يدعم إدخال الصوت أو الفيديو، ولا يدعم Realtime أو Assistants أو الضبط الدقيق (fine-tuning) أو توليد الصور أو النطق، كما لا تقبل واجهة API ضبط شدة الاستدلال على القيمة none. وتُظهر بيانات الأطراف الثالثة أن نتيجته في SWE-Atlas-QnA-AA أقل من GPT-6.1 Sol بـ 14 نقطة، وأنه أكثر عرضة لإغفال الحقائق الأساسية. كما أشار تقييم المواءمة الرسمي إلى أن سلسلة 6.2 أكثر ميلاً في اختبارين إلى عدم الإبلاغ عن مشكلات معيقة مثل غياب الملفات أو تعذر استخدام أدوات البحث.
النقاط الأساسية: GPT-6.2 Sol و Claude Opus 5.5 (Key Takeaways)
- النتيجة الإجمالية: في أعلى مستوى استدلال لدى الأطراف الثالثة، حقق Sol (Max) نقاط 57 مقابل 59 لـ Opus 5.5، بفارق نقطتين بينهما.
- الأسعار الرسمية: Sol بإدخال $2 وإخراج $10 وقراءة ذاكرة التخزين المؤقت $0.10؛ بينما Opus بـ $4 و$20 و$0.20.
- السياق الطويل: عندما يتجاوز الإدخال في الطلب الواحد على Sol حد 272K، يرتفع سعر الطلب بالكامل، حيث يتضاعف سعر الإدخال وذاكرة التخزين المؤقت ويصبح الإخراج 1.5 ضعف.
- فصل المعايير: تختلف المهام ومستويات الاستدلال بين ما تبلغ عنه الشركة رسميًا وتقييمات الأطراف الثالثة، فلا يمكن دمجها في استنتاج واحد.
- التوفر الحالي: Opus 5.5 متوفر بالفعل على منصة APIYI؛ أما Sol فلم يُدرج بعد، ويُرجى الاعتماد على قائمة النماذج على المنصة.
- منهجية الاختيار: اختر Opus إذا كنت تريد بروتوكول Claude والتوفر الفوري؛ أما للمهام اليومية الحساسة للسعر فقيّم Sol أولًا.
الخلاصة
يمكن تلخيص الاختيار بين GPT-6.2 Sol و Claude Opus 5.5 في ثلاث نقاط:
- انظر إلى الدرجات والأسعار معًا: الدرجة الشاملة لـ Sol وفقًا لتقييمات الطرف الثالث أقل بنقطتين، والسعر المعلن رسميًا للسياق القصير يبلغ نحو نصف سعر Opus، لكن أيًّا من هذين العاملين بمفرده لا يكفي لاتخاذ القرار.
- اختر بناءً على المهمة والبروتوكول: للمهام التي تعتمد على بروتوكول Claude وتتطلب الإطلاق فورًا، اختر Opus 5.5؛ أما المهام اليومية الحساسة لسعر الوحدة والتي تبقى طلباتها في الغالب ضمن حدود 272K، فيستحق Sol أن تبدأ به التقييم أولًا.
- احسب التكلفة على مهامك الخاصة: تكلفة المهمة الواحدة المُعلنة من الطرف الثالث تخص منهجية التقييم تلك فقط، أما التكلفة الحقيقية فتتوقف على استهلاكك من الرموز (tokens)، ومعدل الإصابة في الذاكرة المؤقتة (cache hit)، ومستوى الاستدلال الذي تستخدمه.
أكثر النهج عملية في هذه المرحلة هو بناء سير عمل التقييم باستخدام Opus 5.5 أولًا، ثم بعد أن يصبح Sol متاحًا، استكمال جولة مقارنة إضافية بالاعتماد على المجموعة نفسها من الطلبات. نوصي بالاستعانة بخدمة APIYI عبر apiyi.com لإدارة عدة نماذج في الوقت نفسه بمفتاح API واحد، إذ تكفي الحصة المجانية لإتمام جولة التحقق الأولى.
📚 المراجع
-
مقال الإصدار من OpenAI: ملاحظات إصدار GPT-6.2 Astra و Sol والتقييمات الرسمية المعلنة ذاتيًا
- الرابط:
openai.com/index/introducing-gpt-6-2-astra-sol - الوصف: ملخص التسعير، نطاق التوفر، والمقارنات الرسمية المعلنة ذاتيًا في البنود المختلفة
- الرابط:
-
صفحة النموذج gpt-6.2-sol على OpenAI: المواصفات ونقاط النهاية وقواعد التسعير الكاملة
- الرابط:
platform.openai.com/docs/models/gpt-6.2-sol - الوصف: سعر كتابة الذاكرة المؤقتة، قاعدة 272K للطلب الكامل، ومضاعفات التسعير Batch / Fast / Ultrafast
- الرابط:
-
بطاقة نظام OpenAI: تقييمات الأمان والمواءمة
- الرابط:
deploymentsafety.openai.com/gpt-6-2-astra-sol - الوصف: مستويات إطار الجاهزية ونتائج اختبارات المواءمة
- الرابط:
-
مقال التقييم من الطرف الثالث Artificial Analysis: نتائج Intelligence Index v5.0.1
- الرابط:
artificialanalysis.ai/articles/openai-has-the-2-model-in-the-intelligence-index-with-the-release-of-gpt-6-2-astra-and-gpt-6-2-sol - الوصف: الدرجات الشاملة لكل مستوى من مستويات الاستدلال، والمؤشرات الفرعية، والمقارنة مع أعلى مستوى في Opus 5.5
- الرابط:
-
صفحة النموذج GPT-6.2 Sol على Artificial Analysis: مؤشرات مثل تكلفة المهمة الواحدة
- الرابط:
artificialanalysis.ai/models/gpt-6-2-sol - الوصف: تكلفة المهمة الواحدة للمؤشر الشامل تبلغ $1.01 (مستوى Max)
- الرابط:
-
وثائق نماذج Claude: مواصفات Opus 5.5 والمقارنة مع الأسعار المعلنة رسميًا
- الرابط:
platform.claude.com/docs/en/models/fable-5-2/overview - الوصف: أسعار الإدخال والإخراج لـ Opus 5.5، ونافذة السياق، ومستوى الاستدلال الافتراضي
- الرابط:
الكاتب: الفريق التقني في APIYI
للتواصل التقني: يسعدنا تواصلكم معنا عبر الصفحة الرئيسية لموقع APIYI، ويمكن متابعة أحدث المعلومات عن النماذج والأسعار في الجدول الشامل للنماذج ضمن مركز الوثائق على docs.apiyi.com