作者注:本文基于 YC Paper Club Harness Night 的公开分享,整理一套可落地的模型评估方法,帮助团队分清分数差距究竟来自模型,还是来自 Harness。
同一个 Claude Opus,私有保留集上的最好成绩是 30%;放进 Prime Agent 后,公开分享中的成绩是 95.5%。如果只看排行榜,你可能会认为模型发生了质变,但这组数字首先提醒我们:模型评估比较的往往是整套系统,而不只是模型。
这不是一篇劝你放弃排行榜的文章,也不是在宣称 Harness 能让任何模型无限提分。本文未做独立复测,引用的成绩均来自 InfoQ 整理的演讲内容,重点是把其中的经验转换成可执行的评估流程。
核心价值:读完本文,你将学会用 6 个步骤设计模型与 Harness 的对照实验,判断分数差距来自哪里,并得出更可靠的选型结论。
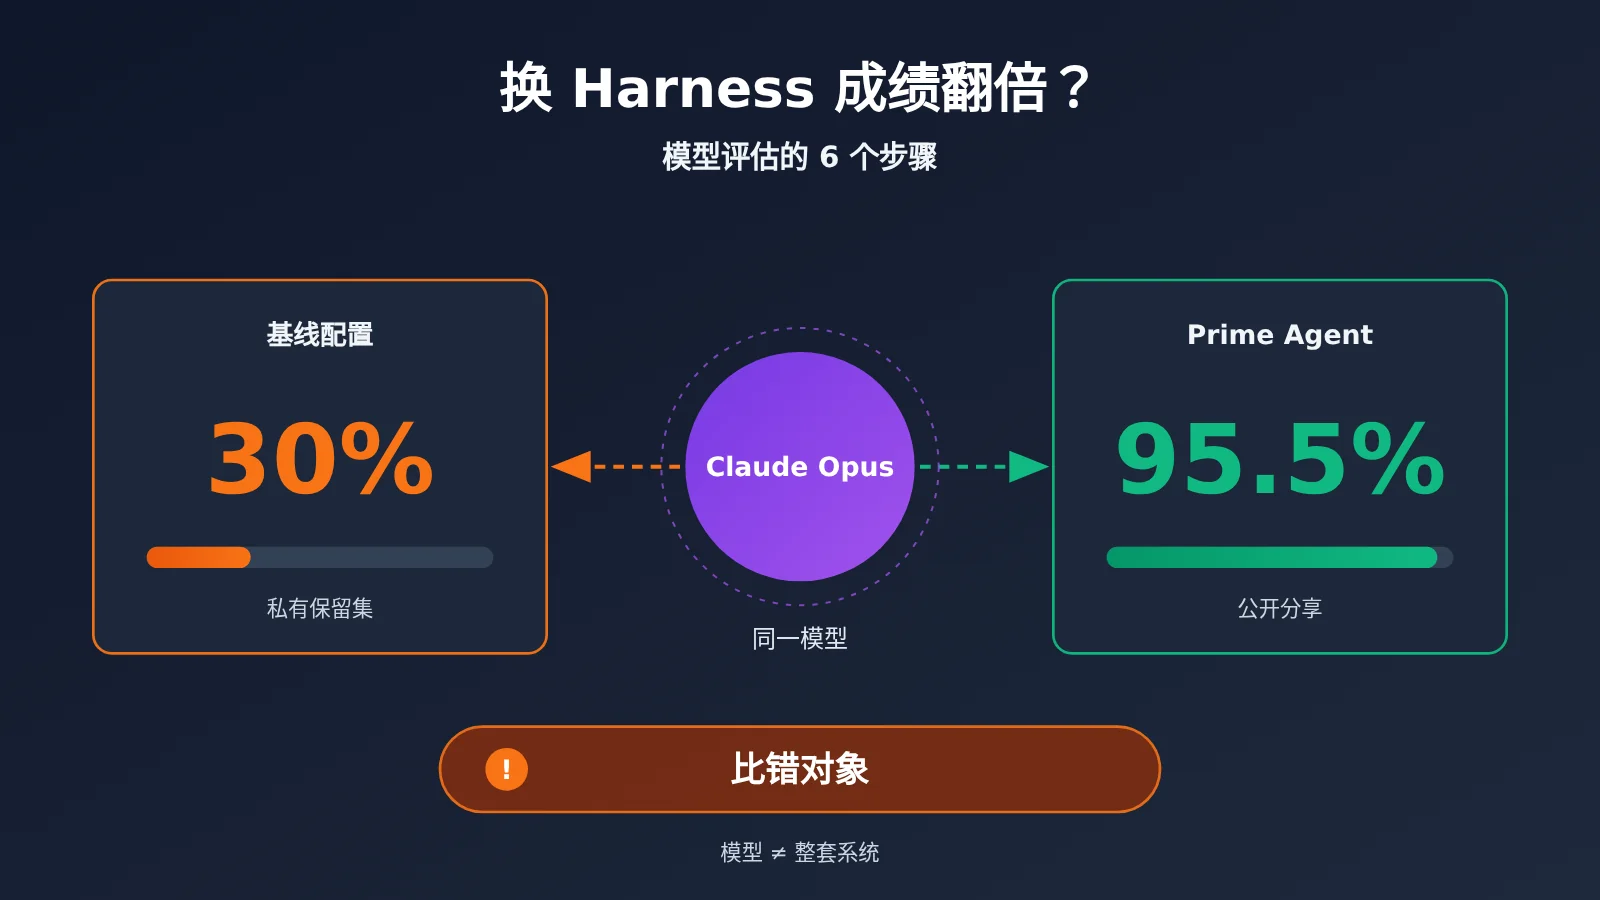
换 Harness 成绩翻倍:模型评估核心要点
Harness 是 LLM 与外部世界之间的一层系统,负责提供持久状态、工具和计算能力。Seth Karten 用了一个类比:裸 LLM 像图灵机,Harness 像能读写外部内存的冯·诺依曼计算机。评估一个 Agent 时,模型的推理能力和这层系统的表达力会同时影响结果。
下表列出分享中与 ARC-AGI 相关的部分公开数据。这些成绩来自不同模型、Harness 或评估配置,不能直接当作模型排名使用。
| 配置 | 公开成绩 | 阅读时要注意什么 |
|---|---|---|
| Claude Opus,私有保留集验证 | 最好成绩 30% | 这是分享中的基线,不代表所有运行条件 |
| Prime Agent + Opus | 95.5% | 资料未逐项披露它与基线的全部差异,不宜只归因于单一变量 |
| Prime Agent + GPT-5.6 Sol | 78% | 这是完成沙盒隔离后的成绩 |
| Prime Agent + GPT-5.6 Terra | 25.7% | 同一 Harness 下,不同模型的差距依然明显 |
| Nvidia AVO | 100% | 分享只给出结果,比较前还需要核对具体配置 |
Harness 与模型评估的关系
Prime Agent 把上下文分成三层:L1 是模型权重,L2 是活跃上下文和 REPL,L3 是文件系统这类调度状态。Harness 在层与层之间做压缩、增删改查和 refinement,作用接近缓存加垃圾回收。这意味着同一个模型换一套 Harness,能用到的记忆和计算能力都可能发生变化。
但这不代表模型不重要。Prime Agent 在 ARC-AGI 上表现突出,在 Oolong、Emulator Bench 等长周期评估中却主要是持平或略好,GPU 内核任务也大致持平。任务类型决定了 Harness 能放大多少差距,所以不能把某一项成绩外推到所有场景。
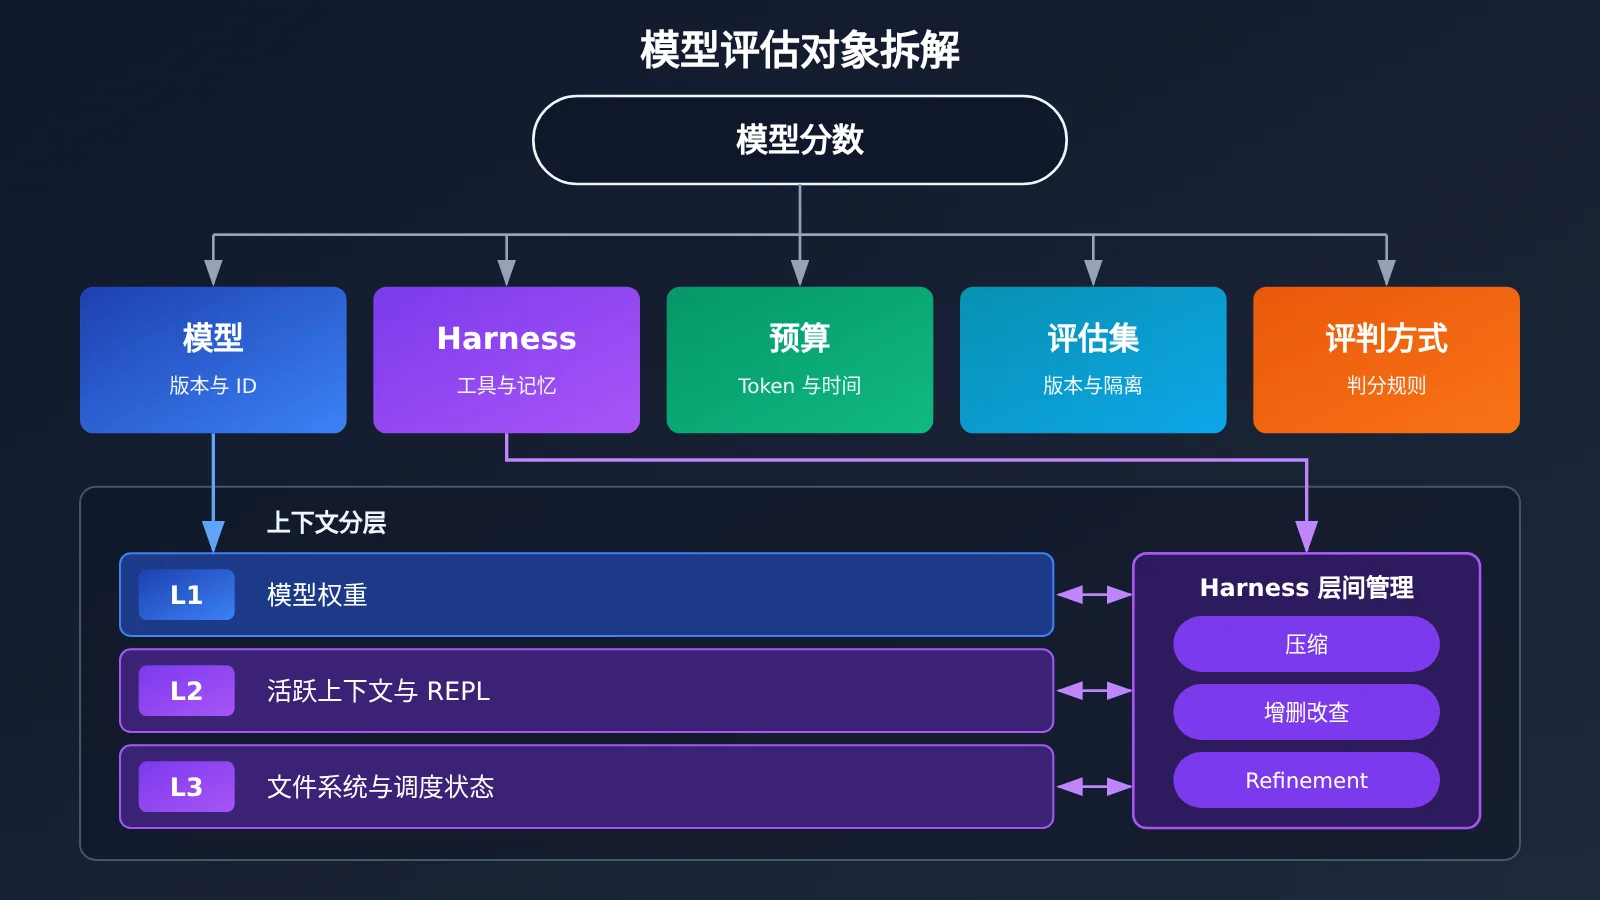
模型评估中最容易比错的 5 个变量
| 变量 | 常见的错误比较 | 应该记录什么 |
|---|---|---|
| 模型 | 只写系列名,不写具体版本 | 模型 ID、实际调用记录、回退或切换情况 |
| Harness | 把默认配置当成模型能力 | 工具、系统提示词、子 Agent、记忆和压缩机制 |
| 预算 | A 跑到平台期,B 提前停止 | Token、实际时间、费用、提前停止条件 |
| 评估集 | 拿公开集成绩对比私有集成绩 | 数据集版本、隔离方式、是否存在信息泄漏 |
| 评判方式 | 只让 LLM 判断修复或答案是否成功 | 判分规则、人工抽检比例、争议样本 |
实践建议:如果要在同一套评估流程中比较多个模型,可以通过 API易 apiyi.com 调用本文涉及的模型,减少接入差异。API易 兼容 OpenAI 与 Anthropic 接口格式,具体模型名称和接入方式请以 docs.apiyi.com 文档为准。
Harness 模型评估快速上手:6 个步骤
下面的流程适合模型选型、Agent 升级和内部基准测试。你不需要一开始就搭建庞大的评估平台,先把变量记录完整,再逐步增加任务和模型。
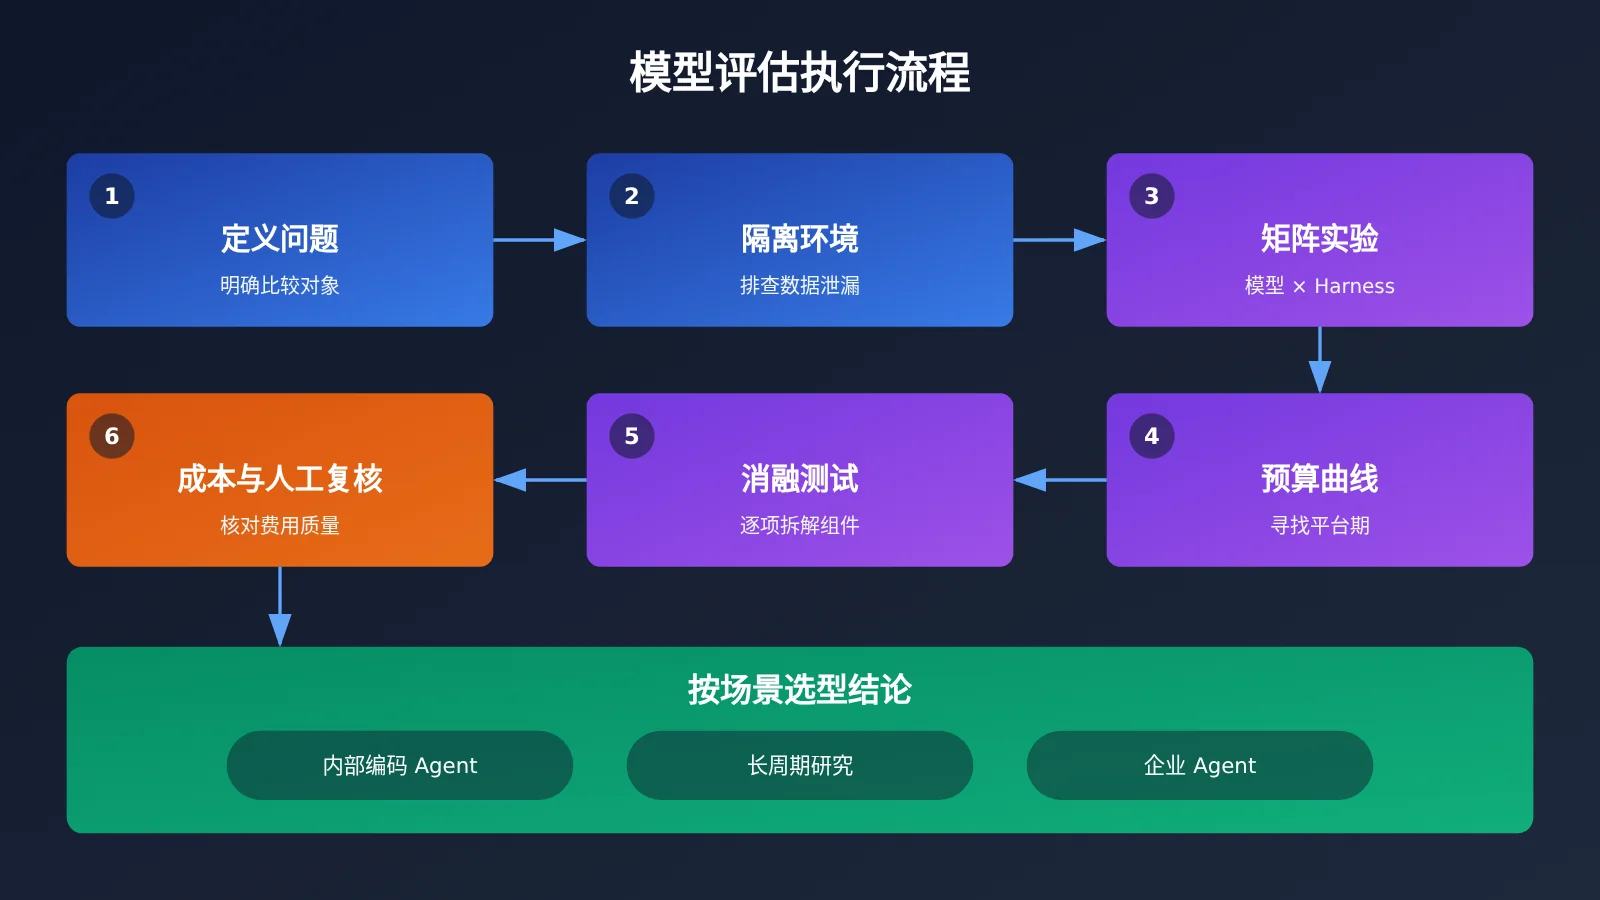
步骤 1:写清模型评估的比较对象
先用一句话定义实验问题,例如“在相同 Harness 和预算下,比较两个模型完成内部编码任务的能力”。如果问题写成“哪个 Agent 更好”,比较对象就是模型与 Harness 的组合,结论也不能写成“哪个模型更强”。
评估规格至少要固定 model、系统提示词、工具列表、max_tokens、最大轮数和总预算。如果 Harness 允许 Agent 自主选择运行时,还要记录每一步实际使用的模型。QM 的设计就允许 Agent 在遇到拒绝时切换到其他模型,此时最终分数已经不再属于单一模型。
步骤 2:隔离 Harness 评估环境和数据
Seth 曾把社区排行榜的系统提示词放进 Prime Agent,第一次运行得到 99.9%。他检查日志后发现自己在作弊,随后花了一天做沙盒隔离,GPT-5.6 Sol 的成绩变为 78%。高分不一定错误,但异常高分必须先查日志。
检查时重点看三件事:Agent 能否读到答案或历史结果,提示词是否包含评估集专属信息,工具调用是否超出了预定权限。对公开基准之外的任务,还要预留一组不参与调优的保留样本,防止提示词和 Harness 过拟合。
步骤 3:用“模型 × Harness”矩阵比较
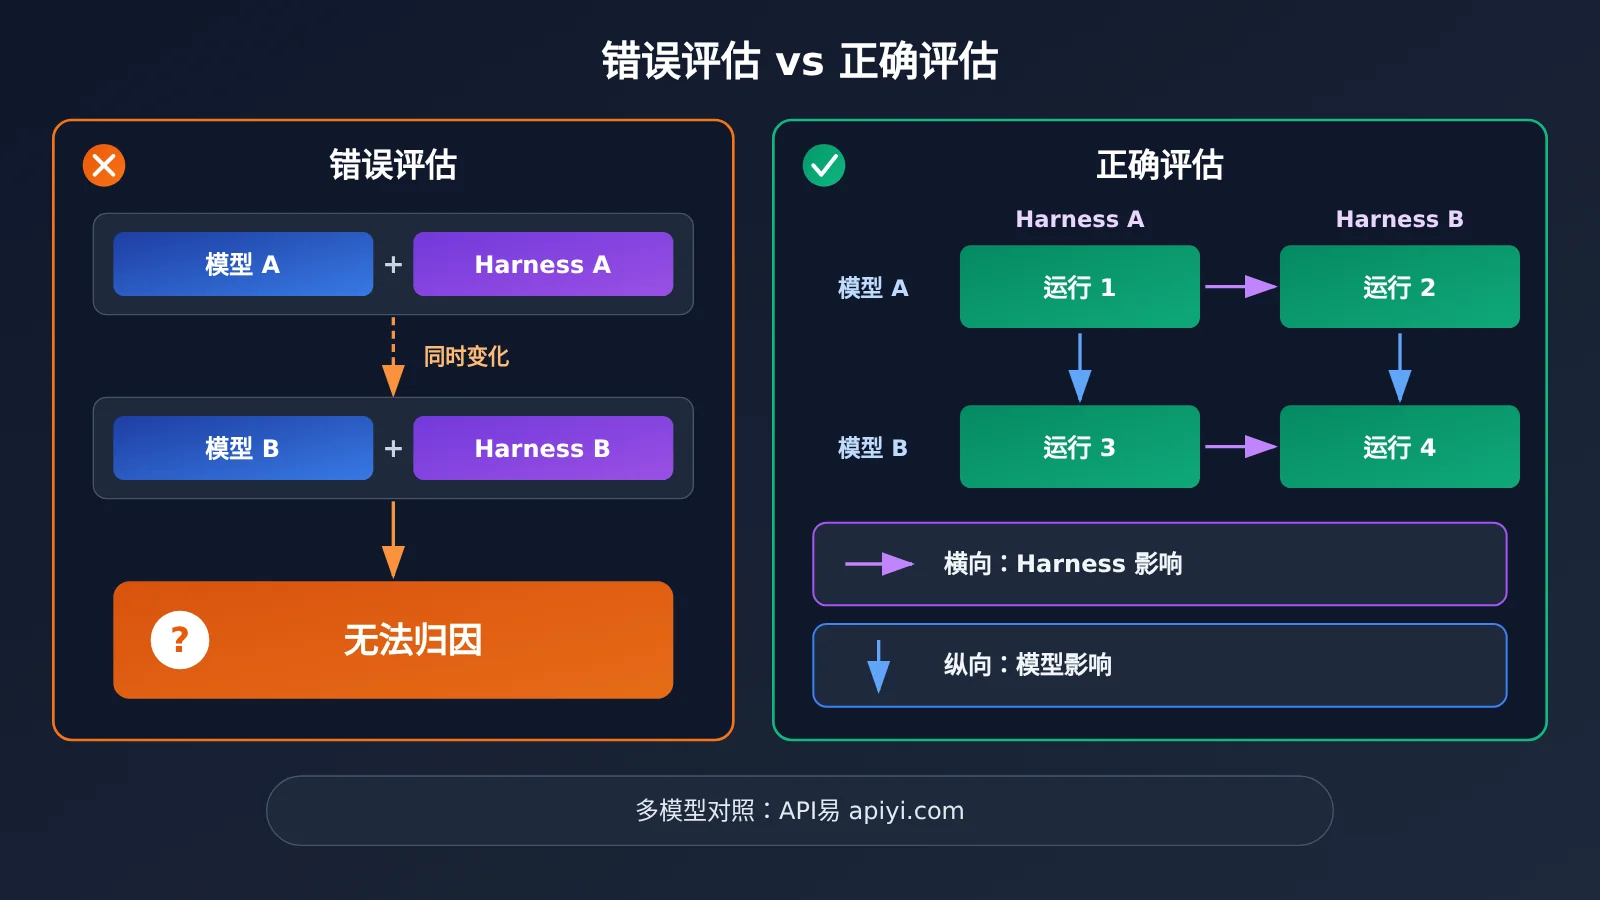
不要只跑“模型 A + Harness A”和“模型 B + Harness B”,因为两个变量同时变化后无法归因。最小方案是 2 × 2 矩阵:两个模型分别在两套 Harness 中运行,并保持任务集和预算一致。
| 矩阵结果 | 更可能的解释 | 下一步动作 |
|---|---|---|
| 换模型明显变化,换 Harness 变化小 | 当前任务更依赖模型能力 | 优先做模型选型 |
| 换 Harness 明显变化,换模型变化小 | 系统能力是主要瓶颈 | 优先改进工具和上下文管理 |
| 两者交叉影响明显 | 模型与 Harness 存在适配关系 | 按组合选型,不写单一排名 |
| 两者都无明显变化 | 任务太简单、太难或判分不敏感 | 重新设计评估集与指标 |
对照实验建议:矩阵实验需要频繁更换模型。你可以通过 API易 apiyi.com 使用统一的账号和接口配置调用不同模型,并在实验记录中保留模型 ID,方便后续追溯。
步骤 4:对齐预算并观察模型性能平台期
Seth 在分享中指出,如果一个模型跑得不够久,或者在预算耗尽后停止,而另一个模型继续工作,你既没有按相同支出比较,也隐藏了真实性能。更合理的做法是设置多个预算点,观察分数随 Token 或时间增长的曲线。
QM 团队的经验也说明了预算的重要性。他们发现 Agent 经常过早放弃,于是尝试“磨砺工具”:为目标设定预算,未达到实际时间或 Token 消耗前不允许放弃,研究输出因此变好。所以评估规格不仅要写预算上限,还要写清楚是否存在最低投入要求。
步骤 5:对 Harness 做消融测试
看到 Harness 带来提升后,下一步是找出提升来自哪项能力。Prime Agent 强调表达力,认为压缩、Python REPL、编程式子 Agent、状态访问和反馈机制都不应轻易移除,但在你的任务中,每项能力的实际贡献仍需测试。
做法是一次只关闭一项能力,例如关闭 REPL、关闭子 Agent 或关闭长期记忆,其他配置保持不变。如果关闭后分数基本不变,费用却明显下降,这项能力可能暂时不值得保留。自动研究这类高方差任务则要重复运行多轮,因为 Seth 也提到,这类任务很难直接归因到 Harness 或模型。
步骤 6:核算成本并加入人工复核
Seth 还提到,他用 Hermes Agent 跑评估时很快花掉了 5,000 美元,却没有看到明显提升,只能中断。这不代表 Hermes Agent 的能力上限,但足以说明成本性能比应当进入评估结论。最终报告建议同时列出成功率、完成时间、Token 消耗和单次成功成本。
计算费用时不要把价格写死在评估脚本的说明里。模型的输入输出单价、缓存价格和计费口径,请以 API易 价格页 https://docs.apiyi.com/models 的实际数据为准,并在报告中标注查询日期。
判分环节同样要保留人工抽检。QM 团队发现,让 LLM 评判修复结果时会出现“主角综合症”:它只看到大象的一部分,看不到整个系统。涉及业务流程时还要测试权限边界,因为 Agent 对社交情境的理解较差,特权信息可能泄漏到不该出现的上下文中。
如何用 API 落地模型评估矩阵
实际执行时,建议把评估拆成任务集、运行配置和结果记录三部分。这样更换模型或 Harness 时,只需要修改一个配置项,而不必重写整套流程。
| 配置项 | 建议记录内容 | 说明 |
|---|---|---|
| 接口格式 | OpenAI 兼容或 Anthropic 格式 | 不同格式的工具调用和消息结构可能不同,需要单独验证 |
| 接入地址与密钥 | base_url、环境变量名称 |
地址以 docs.apiyi.com 文档为准,密钥不要写入评估报告 |
| 运行参数 | model、max_tokens、最大轮数、重复次数 |
确保每次实验都能复现 |
| 费用口径 | 输入、输出、缓存和查询日期 | 以 API易 价格页 docs.apiyi.com/models 的实际数据为准 |
| 运行结果 | 分数、失败原因、Token、时长、调用日志 | 用于分析平台期和成本性能比 |
如果你的 Harness 同时支持两种接口,建议先用同一模型做一次格式对照。这样可以确认消息转换、工具定义和流式返回没有影响结果,避免把接入问题误判成模型能力差异。
接入提示:API易 提供本文涉及模型的 API 调用,兼容 OpenAI 与 Anthropic 接口格式。开始实验前,请在 docs.apiyi.com 核对当前可用模型和调用方式,再把模型 ID 写入评估规格。
常见问题 FAQ
Q1: 什么是模型评估中的 Harness?
Harness 是连接模型与外部世界的系统层,通常包括循环控制、上下文管理、工具、子 Agent、记忆和状态访问。它决定了模型能看到什么、能调用什么,以及能运行多久。
Q2: Harness 分数更高,能说明模型变强了吗?
不能。权重不变时,分数提升更可能说明系统释放了更多能力,或者配置更适合这个任务。如果 Harness、预算和模型同时变化,就无法单独归因,也可能是评估环境存在泄漏。
Q3: 什么时候需要重新做模型评估?
模型版本、系统提示词、工具权限、压缩策略或业务任务发生变化时,都应重新评估。Harness 领域迭代很快,本文数据来自 2026 年 11 月 InfoQ 发布的整理内容,后续成绩可能发生变化。
Q4: 这套模型评估方法适合哪些场景?
主要适合以下场景:
– **内部编码 Agent 选型**:比较模型和 Harness 组合的任务完成率。
– **长周期研究任务**:观察预算增加后的平台期和结果方差。
– **企业 Agent 上线前验证**:同时测试质量、成本和权限边界。
Q5: 如何快速接入多个模型进行 Harness 对比?
可以先确定评估任务和模型清单,再通过 API易 apiyi.com 接入。平台提供本文涉及模型的 API 调用,兼容 OpenAI 与 Anthropic 接口格式。具体模型 ID 和配置方法请查看 docs.apiyi.com 文档,并在实验中保持其他变量不变。
Q6: 评估报告中的模型价格应该怎么写?
建议只引用经过核实的价格数据,并写明查询日期。模型的输入输出单价、缓存价格和计费口径,都应以 API易 价格页 https://docs.apiyi.com/models 的实际数据为准,不要沿用旧表或估算值。
Q7: 这套 Harness 评估方法有哪些限制?
矩阵实验、重复运行和人工复核都会增加时间与费用。长周期任务的方差也可能很高,即使控制了主要变量,仍然难以精确归因。因此,它更适合用于支持决策,不应把一次结果当成绝对排名。
Harness 模型评估核心要点 Key Takeaways
- 先定义比较对象:分清比较的是模型,还是模型与 Harness 的组合。
- 异常高分先查日志:99.9% 的案例说明,隔离环境是评估的前提。
- 用矩阵拆开变量:通过 API易 接入多个模型,再做模型 × Harness 对照。
- 预算必须对齐:在多个预算点观察曲线,找到真实平台期。
- 消融定位贡献:一次关闭一项能力,确认提升来自哪里。
- 成本数据要核实:价格和计费口径以 API易 价格页为准。
- 保留人工判断:LLM 评判可能片面,权限风险也需要专门测试。
总结
“换 Harness 成绩就翻倍”值得重视,但它不应被简单理解为“模型不重要”。分享中的数据既展示了 Harness 的放大作用,也说明不同模型和任务之间仍有明显差距,可靠的结论必须建立在受控实验之上。
落地时可以优先记住三点:
- 评估对象要写清楚:记录模型、Harness、预算、评估集和评判方式。
- 实验设计要能归因:用矩阵实验和消融测试拆开变量,并隔离评估环境。
- 结论要面向场景:同时看平台期、成本性能比、人工复核结果和权限风险。
如果你准备验证自己的模型组合,可以通过 API易 apiyi.com 接入本文涉及的模型,再按照 docs.apiyi.com 文档完成配置。涉及费用测算时,请查阅 https://docs.apiyi.com/models 获取当前价格数据。
📚 参考资料
- InfoQ:同一个模型从 30 分到 95 分:拉开差距的不是模型,是 Harness
- 链接:
infoq.cn/article/C1C1DThg8z1Dy0rZAmLB -
说明: 本文引用的成绩、案例和设计观点均来自这篇整理文章。
-
YC Paper Club Harness Night 演讲视频
- 链接:
youtube.com/watch?v=n9xKblqyQ28 -
说明: 可查看 Prime Agent、OpenJarvis 和 QM 三场分享的完整语境。
-
API易 文档中心
- 链接:
docs.apiyi.com -
说明: 用于核对可用模型、接口格式和接入配置。
-
API易 模型价格页
- 链接:
docs.apiyi.com/models - 说明: 模型单价、缓存价格和计费口径均以此页面的实际数据为准。
作者:APIYI 技术团队
技术交流:如需了解模型接入方式,欢迎访问 API易 官网 apiyi.com,更多资料可查阅 docs.apiyi.com 文档中心。