作者注:基于一组 Agrumea Farm 官网复刻测试,从设计还原、交互要求、耗时与 API 等价成本 3 个维度对比 Gemini 4 Carbon、Claude Opus 5.5 与 GPT-6 Astra,并给出按场景选型和自行复测的方法。
把同一个品牌官网交给三款顶级模型分别复刻,结果会差多少?2026 年 11 月 11 日,独立评测作者 Pat Simmons(AI for Mortals)公开了一组测试。他让 Gemini 4 Carbon、Claude Opus 5.5 和 GPT-6 Astra 复刻意大利食品品牌 Agrumea Farm 的官网,并公开了作品、截图、提示词、运行时间和 API 等价成本。
这不是一份“看起来各有千秋”的折中分析。在这次任务里,三个维度的胜出者很明确:Carbon 成本最低,Astra 用时最短,Opus 获得了评测作者更高的质量评价。需要说明的是,每个模型只跑了一次,工具环境和测试日期也不同,因此这组结果不能直接推广成所有网页开发场景的排名。
核心价值:读完本文,你会知道这三套“模型 + 工具”工作流在效果、速度、成本上各自的优势,也能用文中的方法在自己的项目里重新验证。
先看原网站是什么样子——Carbon、Opus、Astra 同题复刻测试是怎么做的
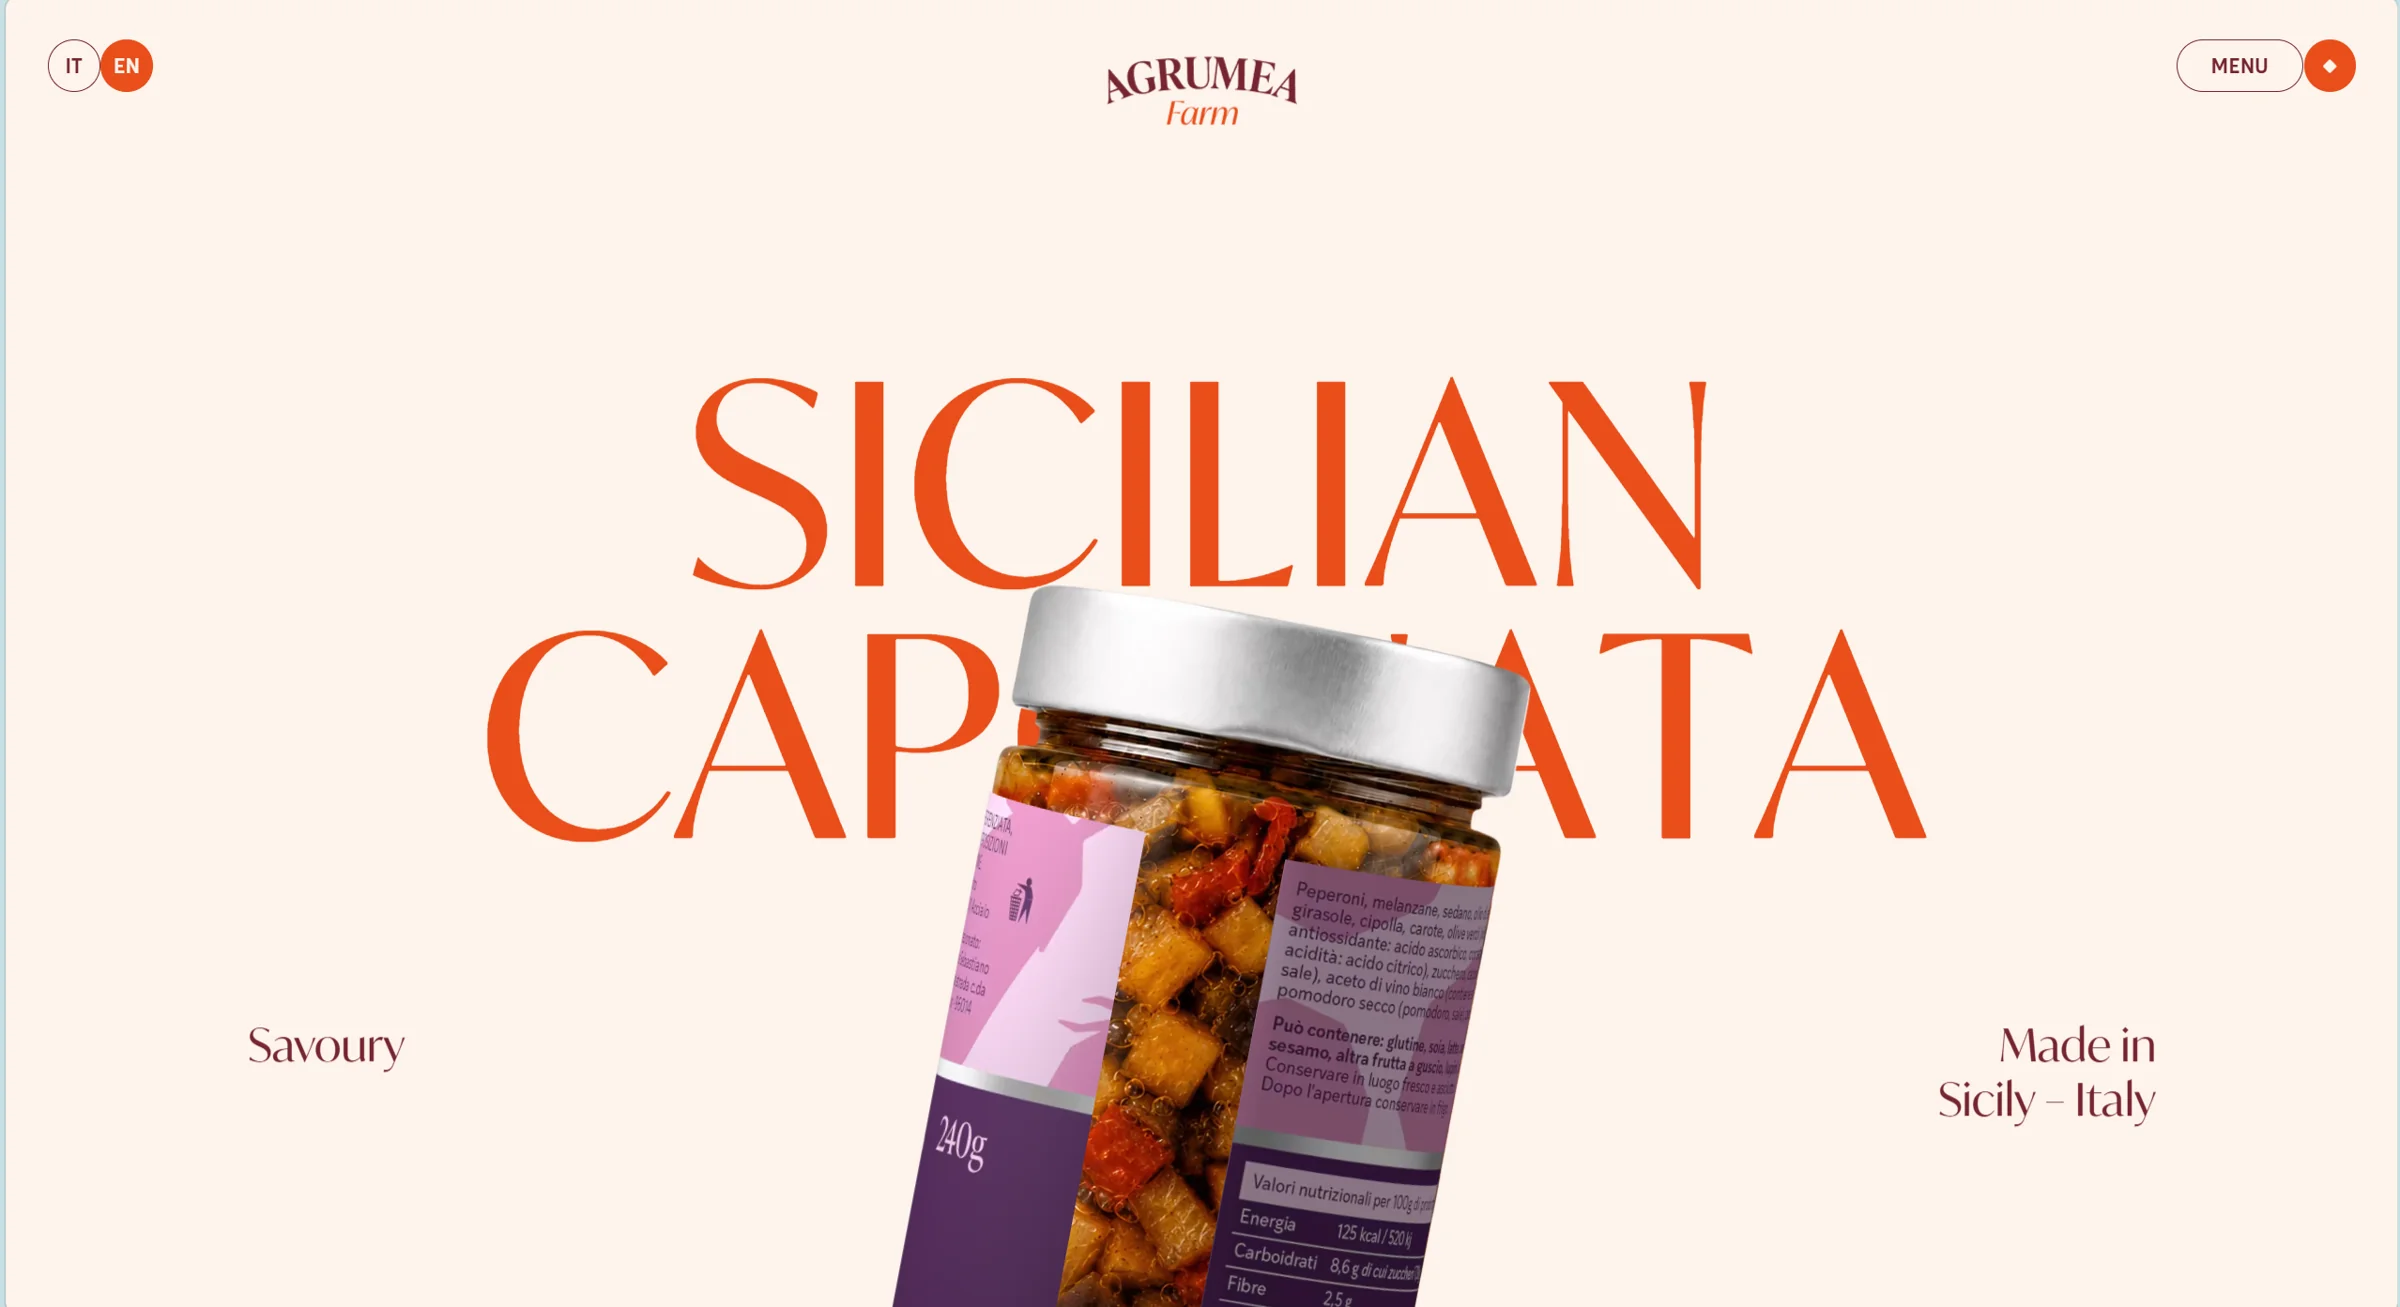
先了解测试条件,再看结果。这组测试的价值在于“同一网站、同一提示词、同一开发目标”,但它比较的是完整工作流,不是在实验室里单独隔离模型本体。
| 测试要素 | 具体设置 | 对结论的影响 |
|---|---|---|
| 测试对象 | Agrumea Farm 官网(英文版) | 比较的是设计还原能力,不是原创审美 |
| 任务要求 | 还原页面结构、视觉风格、3D 罐头轮播、滚动与拖动、加载动画、悬停动画、页面过渡 | 静态截图之外,交互也是质量指标 |
| 检查尺寸 | 桌面 1440×900,移动端 390×844 | 要求同时考虑响应式布局 |
| 验证方式 | 用浏览器读取样式并做视觉验证,保证网站可运行 | 浏览器自检能力会影响最终效果 |
| 工具环境 | Carbon 用 Google Antigravity,Opus 用 Claude Code,Astra 用 Codex,均为高推理设置 | 结果是模型与工具链共同作用的产物 |
| 运行次数与日期 | 每个模型只跑 1 次;Opus、Astra 在 11 月 6 日,Carbon 在 11 月 10 日至 11 日 | 存在单次波动和环境差异 |
Carbon、Opus、Astra 测试的三个关键前提
第一个前提是“复刻”而非“自由设计”。三个模型都要沿用原品牌的设计语言,所以比较的重点是还原度、细节和完成度。如果你的需求是从零做一套原创视觉,这组测试只能作为参考。
第二个前提是成本口径。文中所有金额都是评测作者根据模型定价和使用日志算出的 API 等价费用,并不是订阅套餐的实际扣款。如果你用包月工具跑同样的任务,账单形态会完全不同。
第三个前提是评测里其实有四个模型。作者还加入了 Claude Fable 5.2,它拿到了主观第一名。因此下文提到的“第 2、第 3、第 4 名”都是四模型排名。
图注说明:本文涉及的三张作品首屏截图均来源于 AI for Mortals / Pat Simmons,发布日期 2026-11-11,分别对应 Gemini 4 Carbon、Claude Opus 5.5 和 GPT-6 Astra 的复刻作品。
第一轮:Carbon、Opus、Astra 网页设计谁还原得更好
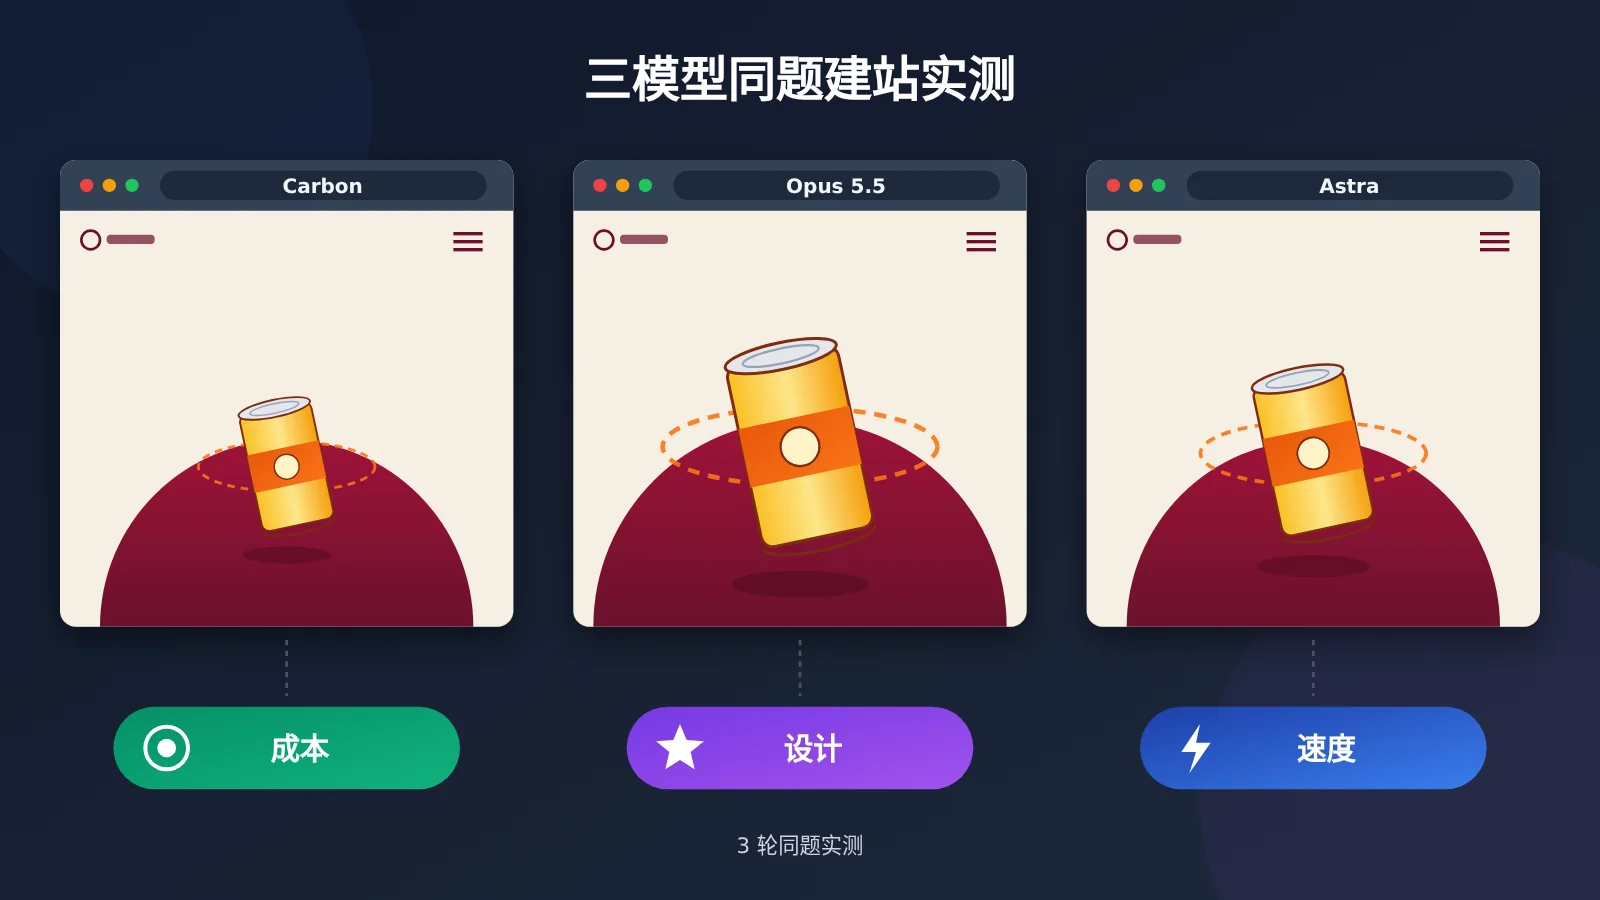
先看画面。从公开的首屏截图看,三份作品都抓住了原站的核心元素:米白色背景、悬浮的食品罐头、酒红色弧形背景、橙色环绕文字,以及顶部的品牌标志、语言切换和菜单按钮。也就是说,三者都没有交出那种跑偏的模板页面,差距集中在比例、层次和细节上。
下图从上到下,依次是opus5.5,astra,carbon的作品。
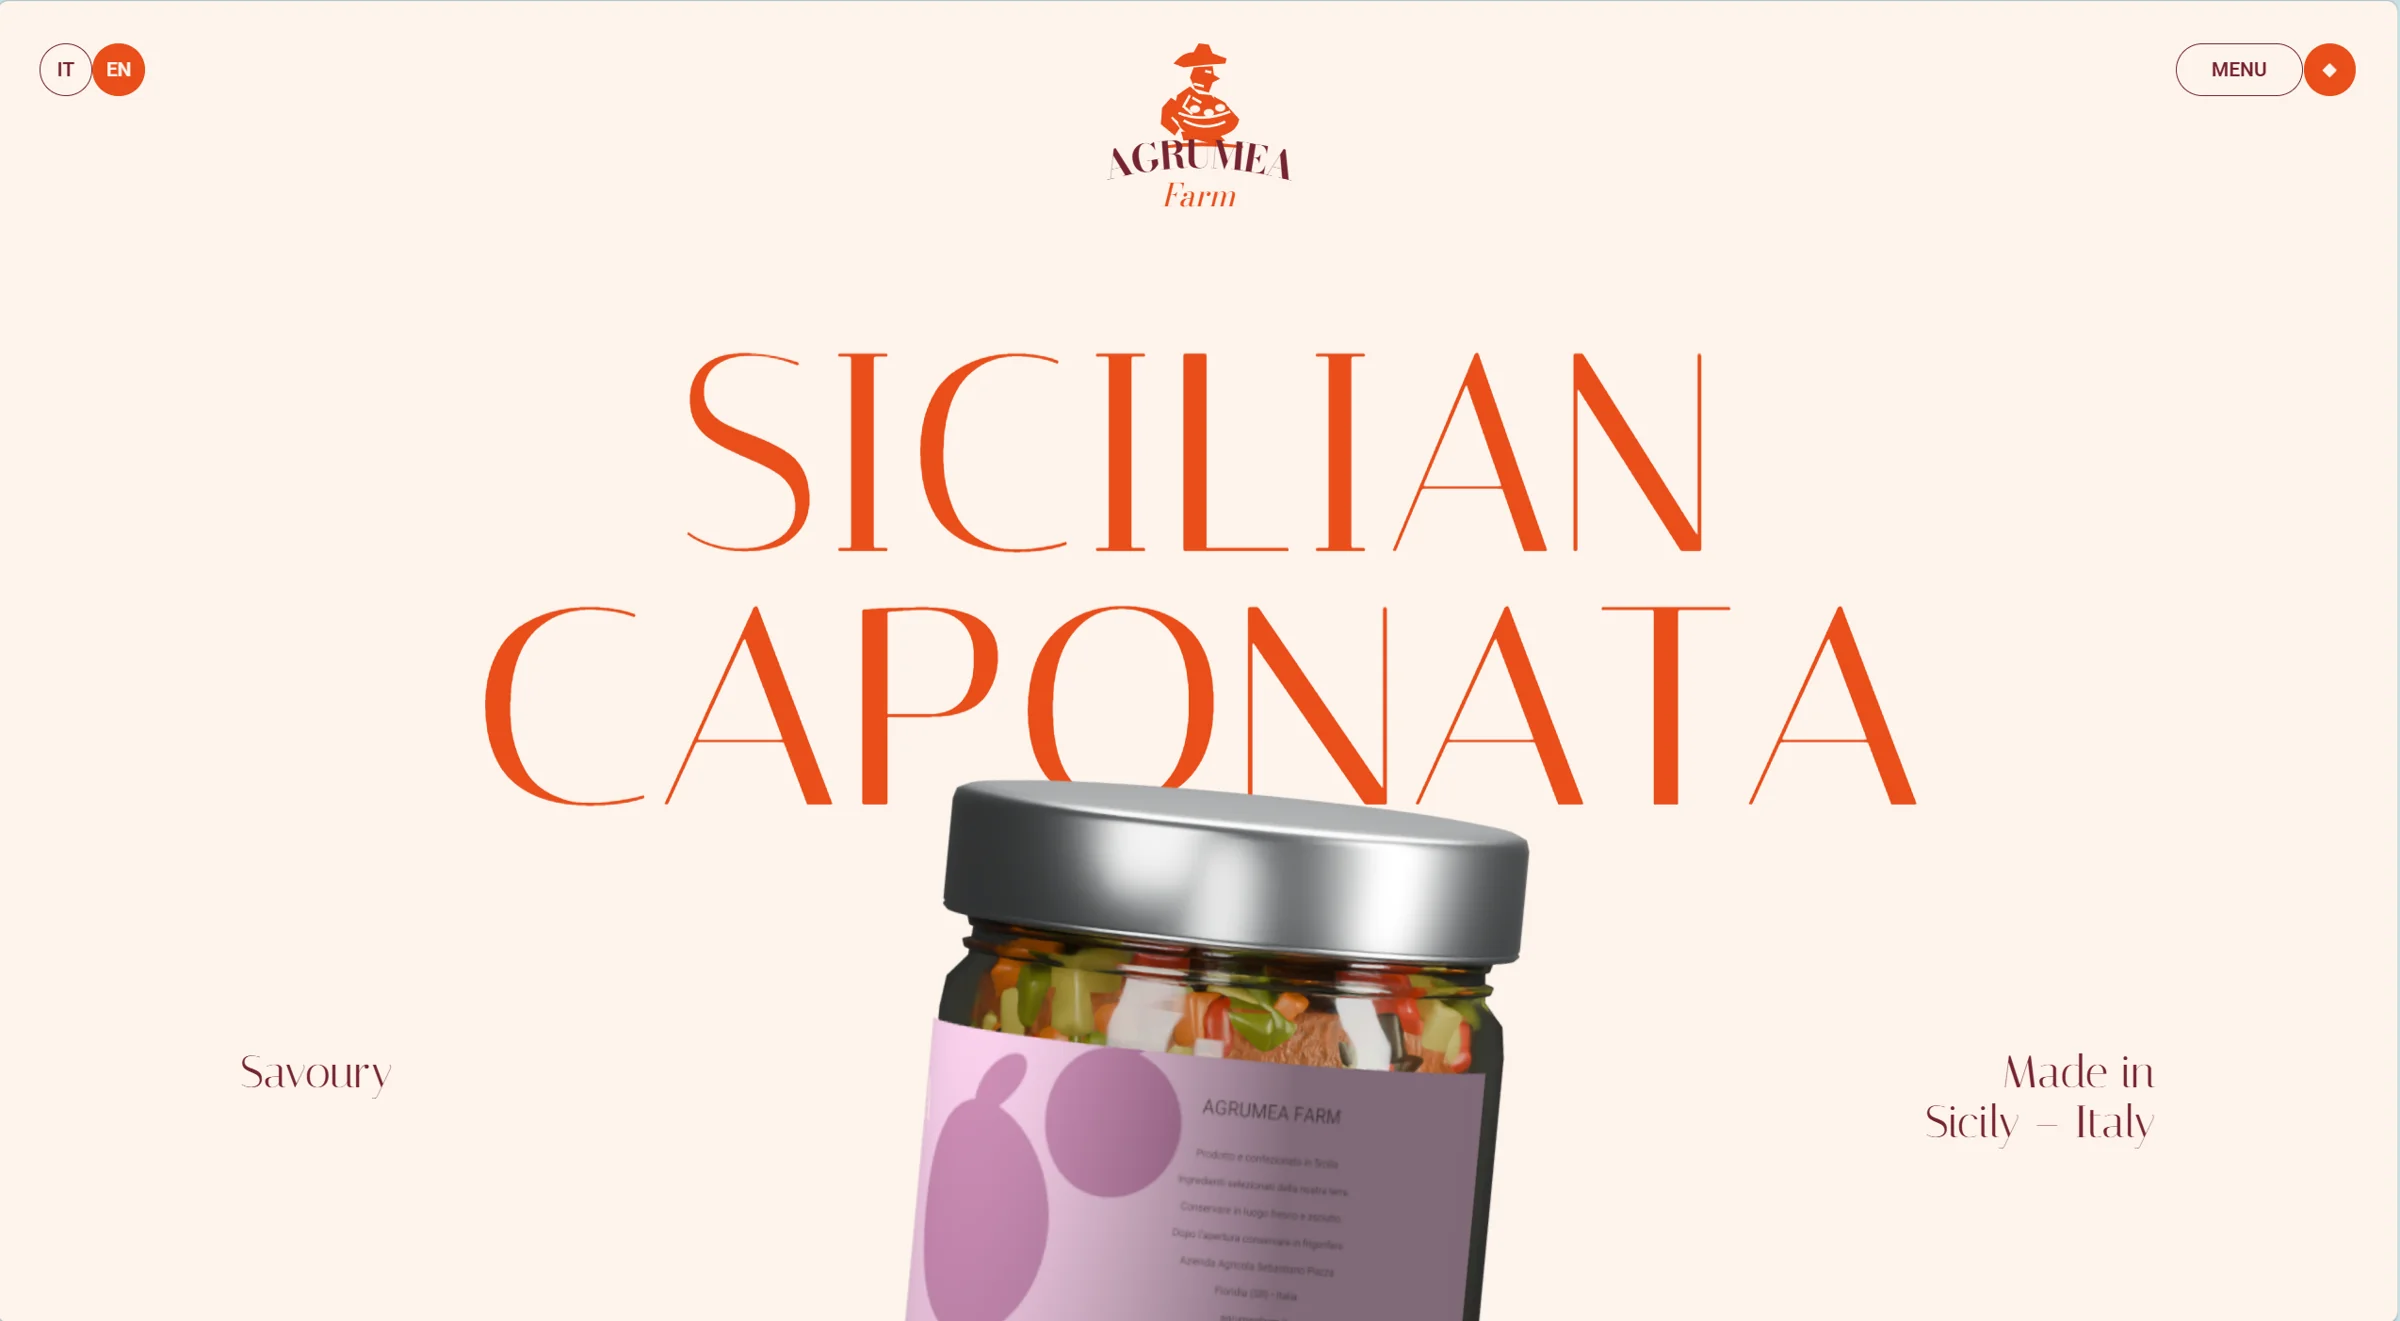
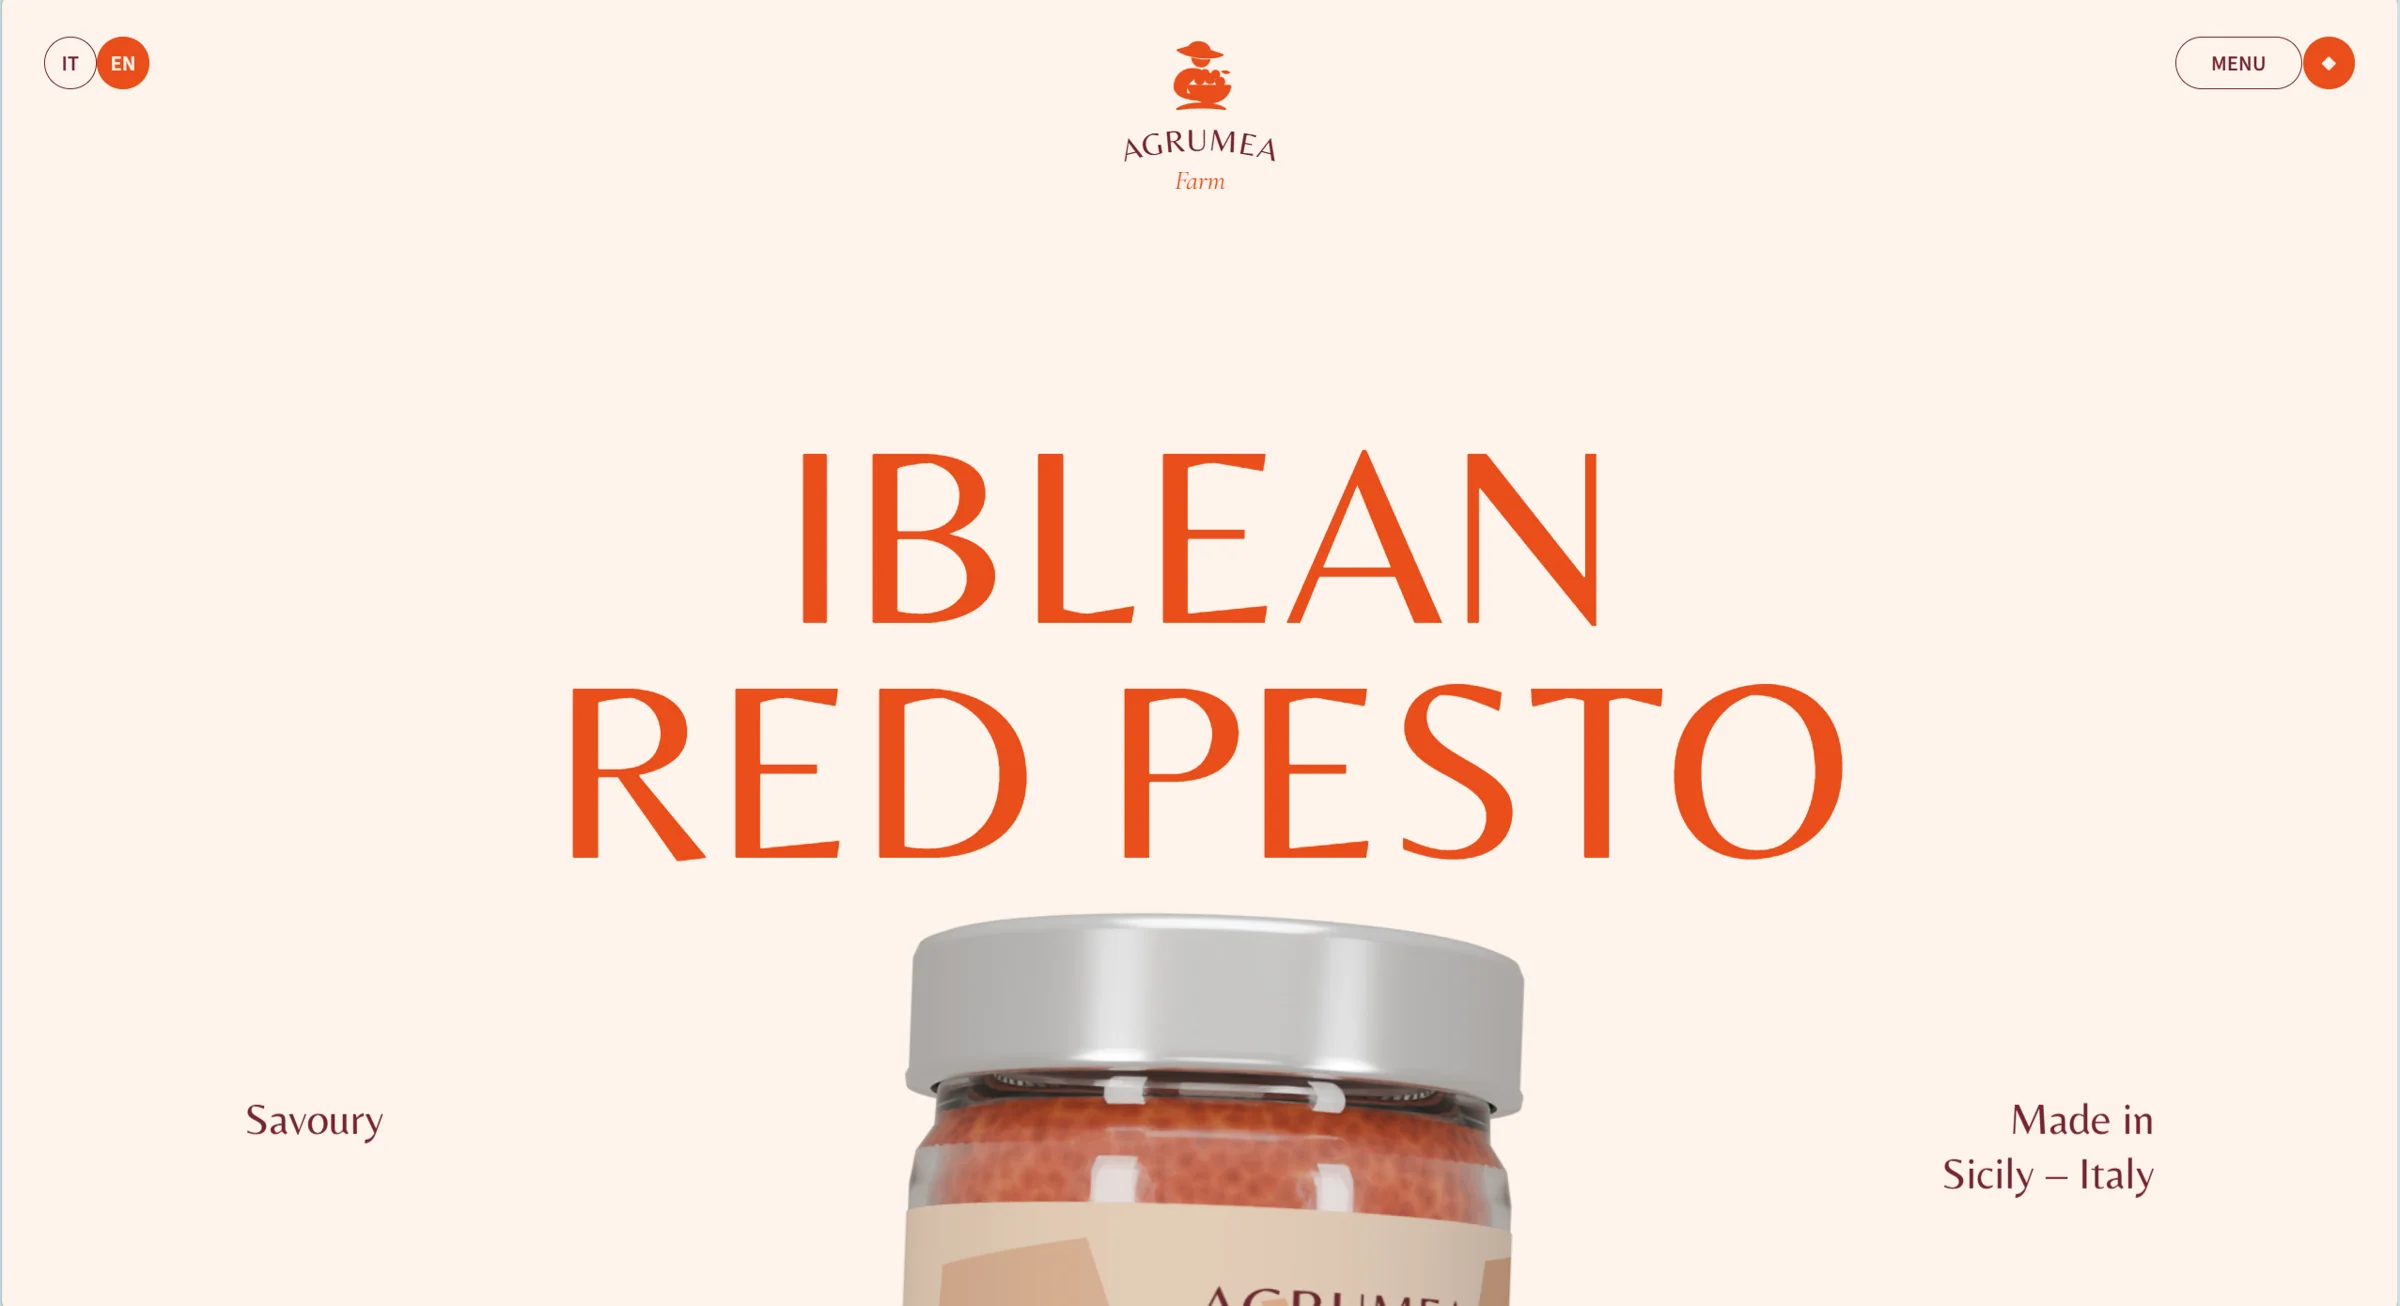
| 观察维度 | Gemini 4 Carbon | Claude Opus 5.5 | GPT-6 Astra |
|---|---|---|---|
| 首屏构图 | 留白较多,整体疏朗 | 产品主体更大,视觉冲击力强 | 排布完整,整体较紧凑 |
| 罐头比例 | 中央罐头相对偏小 | 罐头突出,是绝对视觉中心 | 视觉中心明确 |
| 背景与层次 | 弧形背景已还原 | 罐头与背景曲线的叠加关系更突出 | 层次完整 |
| 标签与文字 | 部分标签和文字细节较弱 | 标签、字体表现更丰富 | 罐头标签有明显图形装饰 |
| 作者主观名次(四模型) | 第 4 | 第 2 | 第 3 |
Opus 在设计还原上为什么更受认可
需要先把两类信息分开:表格前四行是对公开截图的视觉观察,最后一行才是评测作者的主观排名。作者在三个指定模型中最满意 Opus,其次是 Astra,最后是 Carbon。
从截图看,Opus 的优势主要在“品牌官网的主次关系”上。食品品牌官网的首屏核心是产品,Opus 把罐头做得更大,并让罐头和酒红色曲线形成明显的前后叠压,标签文字也更清晰。Carbon 的疏朗布局本身不算错,但罐头偏小、部分文字细节偏弱,在“还原度”这个评价标准下容易吃亏。
Astra 的表现介于两者之间。它的构图完整、视觉中心明确,罐头标签的装饰感也比较强,只是整体更紧凑。对复刻任务来说,“像不像原站”比“好不好看”更重要,这也解释了为什么三份作品都不差,名次却仍有明显先后。
第二轮:Carbon、Opus、Astra 的交互还原为什么不能只看截图
网站和设计稿最大的区别在于它需要“动起来”。原始任务明确要求还原 3D 产品罐头轮播、滚动和拖动交互、加载动画、悬停动画以及页面过渡。这些能力在静态截图里几乎看不出来,却直接决定了用户打开网站后的体验。
所以截图只能说明布局和视觉细节,不能证明交互功能已经完整实现。想判断 3D 罐头能不能顺畅拖动、悬停反馈是否自然、移动端会不会错位,需要打开三份公开的作品页面实际操作。本文不把截图当作交互测试结果,也不替原作者补充他没有给出的交互评分。
这一轮也说明了网页开发和静态图片生成的区别。一个模型可以画出漂亮的首屏,但要把 3D 轮播、滚动驱动的动画和响应式布局全部写进可运行的代码,还要处理加载顺序、性能和不同尺寸下的表现。评测要求“用浏览器读取样式并做视觉验证”,正是为了把“写完”变成“跑通”。
在实际项目里,可以按下面的顺序检查 AI 生成的网站:
- 先在 1440×900 和 390×844 两个尺寸下打开页面,确认布局没有溢出或重叠。
- 逐一触发拖动、滚动、悬停和页面切换,观察动画是否卡顿或失效。
- 打开浏览器控制台,检查是否有报错、资源加载失败或无限循环的动画。
- 最后再和原站或设计稿逐屏对比,记录视觉差异。
第三轮:Carbon、Opus、Astra 成本和耗时相差多少
这一轮最能体现三套工作流的差异。下面的数据全部来自原评测,成本为 API 等价费用。
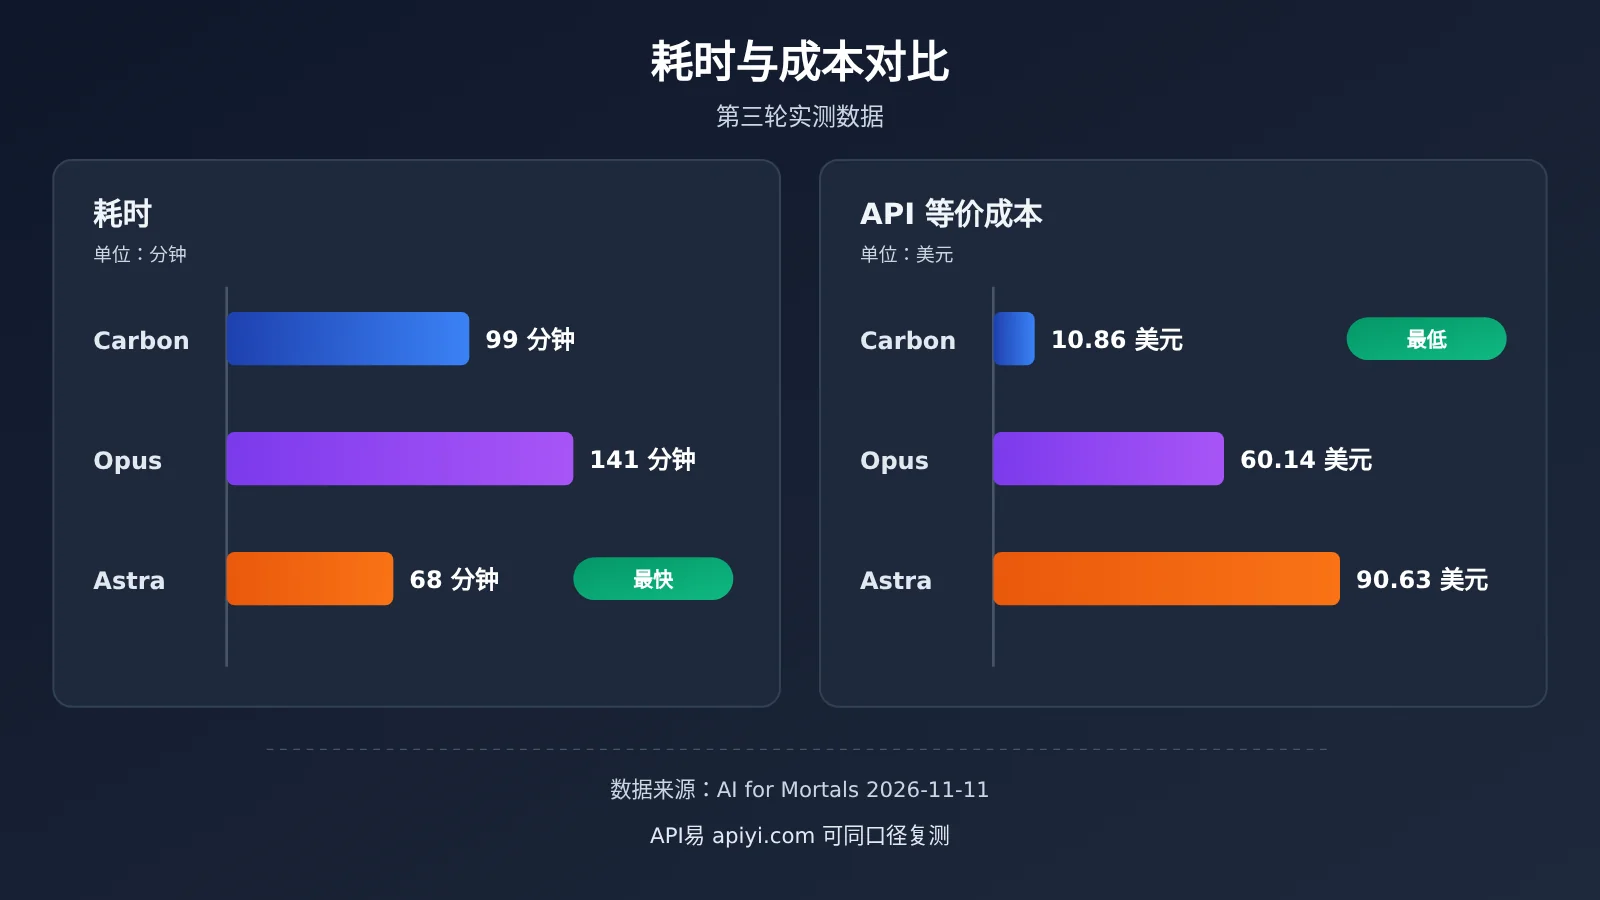
| 指标 | Gemini 4 Carbon | Claude Opus 5.5 | GPT-6 Astra |
|---|---|---|---|
| 耗时 | 99 分钟 | 141 分钟 | 68 分钟(最快) |
| API 等价成本 | 10.86 美元(最低) | 60.14 美元 | 90.63 美元 |
| 输入 Token | 2770 万 | 1.979 亿 | 7040 万 |
| 输出 Token | 43 万 | 48.3 万 | 21.1 万 |
| 每分钟等价成本(推算) | 约 0.11 美元 | 约 0.43 美元 | 约 1.33 美元 |
| 作者主观名次(四模型) | 第 4 | 第 2 | 第 3 |
Carbon、Opus、Astra 成本数据深度解读
Carbon 的 API 等价成本约为 Opus 的 18%、Astra 的 12%。如果你的工作方式是大量试错、反复迭代,这个差距会在多轮任务中被持续放大。Astra 用时 68 分钟,不到 Opus 的一半,适合对交付速度敏感的场景。Opus 用时最长、成本居中,换来的是作者在三者中最满意的作品。
表中有一个容易被忽略的现象:三者的输入 Token 都远远大于输出 Token。按表格数据推算,Carbon 的输入输出比约为 64:1,Opus 约为 410:1,Astra 约为 334:1。这和 Agent 式开发的特点有关:模型每一轮都要重新读取代码、样式、页面状态等上下文,真正“写出来”的代码只占很小一部分。Opus 的输入量接近 2 亿,说明它在这次任务里进行了大量的上下文往返。
另一个值得注意的点是,Token 数量和费用并不成正比。Astra 的输入 Token 只有 Opus 的三分之一左右,等价成本却更高,这说明单价、缓存计费等因素同样关键。评估成本时,不能只看谁用的 Token 少,而要按各模型实际的计费规则核算。本文不展开具体单价,相关数字请以各厂商官方价格页为准。
为什么 Carbon、Opus、Astra 同一提示词结果不同
同样的提示词跑出三种结果,原因不只在模型本身。在这组测试里,每个模型都运行在自家的开发工具中,模型能力、工具调用方式、浏览器自检机制和上下文管理共同决定了最终作品。
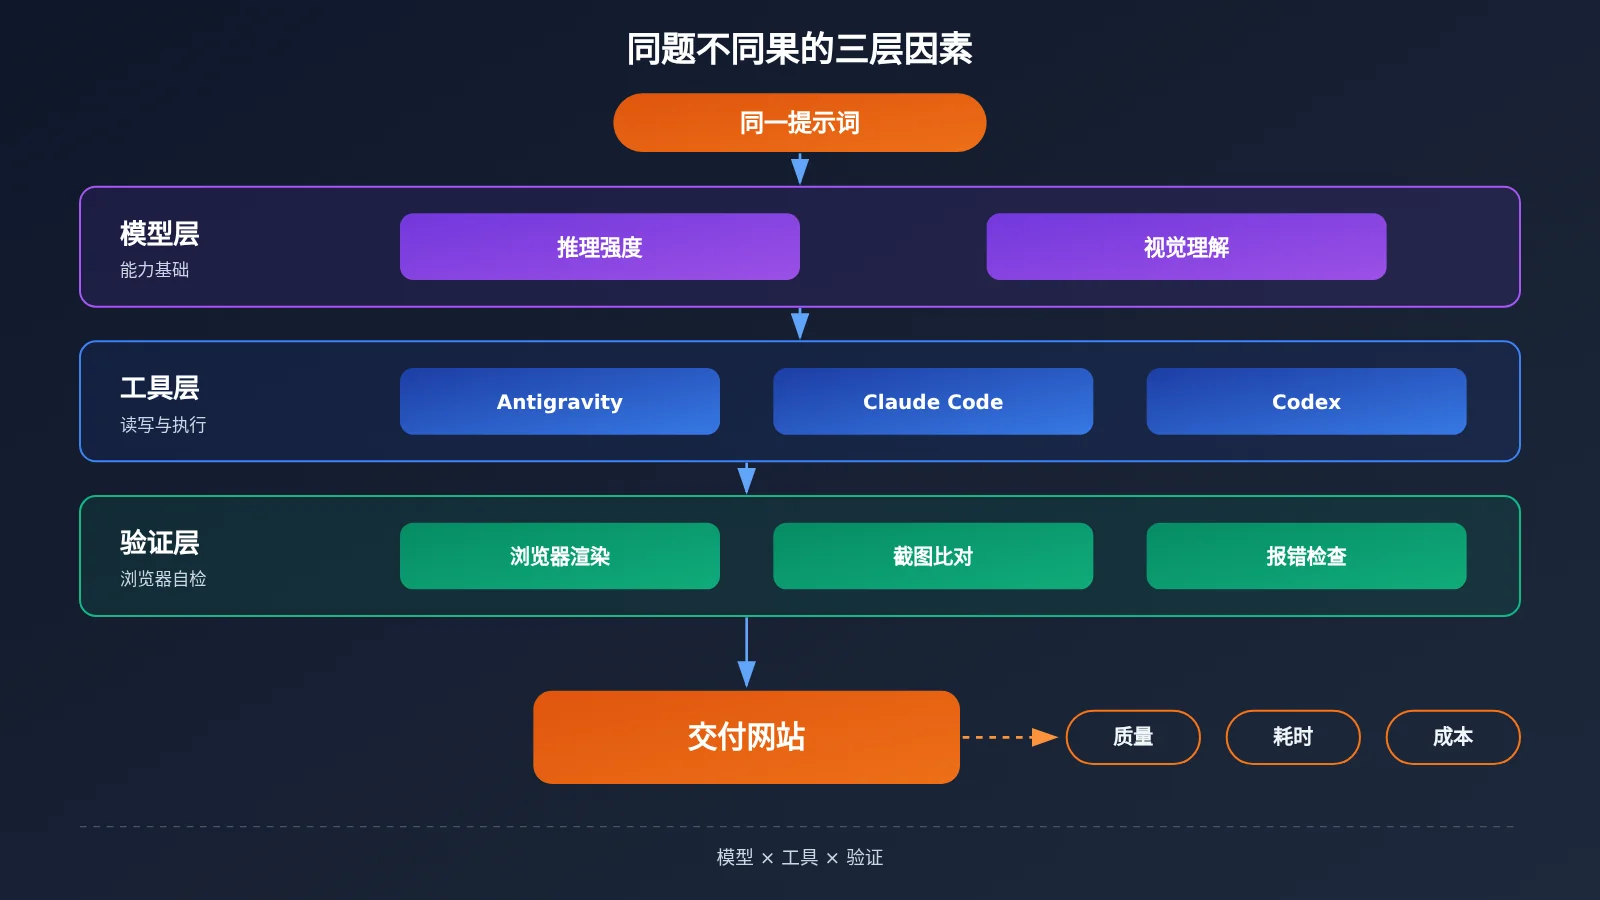
从官方资料看,三家对网页开发能力的强调点各有侧重:
- Google(Carbon + Antigravity):强调前端设计、浏览器验证、动态效果、复杂 3D 内容和多智能体开发,官方案例包括用两次提示词重新设计 Google Merchandise Store,以及用 Three.js 制作 3D 交互体验。
- OpenAI(Astra + Codex):在 Astra 的官方介绍中强调网站、应用和游戏的开发能力,以及生成后运行前端质量检查的工作流。
- Anthropic(Opus + Claude Code):官方资料未提供同题对照,但第三方 Proofyard/Woofocus 在 2026 年 10 月 24 日的测试中,用 Opus 5.5 完成了家具工作室主页的首版设计与修改,按 API 价格计算为 4.34 美元。该测试与本文的 Carbon、Astra 并非直接对照。
Carbon、Opus、Astra 榜单数据怎么看
除了单次实测,还可以参考多任务汇总的榜单。下表数据均标注了采集日期,Elo 分数取决于各平台的测试方法,跨榜单不能直接比较。
| 榜单(日期) | 测试类型 | Claude Opus 5.5 | GPT-6 Astra | Gemini 4 Carbon |
|---|---|---|---|---|
| Arena WebDev(2026-11-10) | 网页开发对战投票 | 1814(Max) | 1764(Max) | 1768(High,初步排名) |
| DesignArena 综合 Agentic 榜(2026-11-11) | 前端、全栈、游戏、移动端、办公文档等 | 1440(High),第 1 | 1385(Max),第 3 | 1291,第 7 |
在两个榜单中 Opus 都领先,这和本次复刻测试中作者的主观排序方向一致。Carbon 在 WebDev 榜和 Astra 非常接近,但在覆盖面更广的 DesignArena 综合榜上排名靠后。这说明“单页网页开发”和“复杂 Agent 设计任务”是不同的能力维度,选型时要对应自己的任务类型。
如何用 API 自行复测 Carbon、Opus、Astra
别人的单次测试只能作为起点,最可靠的依据是在自己的任务上跑一遍。下面的示例通过 OpenAI 兼容接口,把同一份提示词依次发给多个模型,并记录耗时和 Token 用量。需要注意,这只测量模型直接生成代码的环节,不包含原评测中 Antigravity、Claude Code、Codex 那样的多轮工具调用与浏览器自检。
极简示例
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # API易 OpenAI 兼容接口
)

resp = client.chat.completions.create(
    model="your-model-id",  # 以平台模型列表中的实际名称为准
    messages=[{"role": "user", "content": "输出一个单文件 HTML 食品品牌官网首屏,米白背景、居中悬浮产品罐头、酒红色弧形背景"}]
)
print(resp.choices[0].message.content[:500])
print(resp.usage)  # 查看输入、输出 Token
查看完整的多模型同题复测脚本
import time
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # 一个 Key 调用多家模型
)

# 模型 ID 以平台模型列表为准;价格单位为“美元 / 百万 Token”,请按官方价格页填写
MODELS = {
    "model-a": {"input_price": 0.0, "output_price": 0.0},
    "model-b": {"input_price": 0.0, "output_price": 0.0},
    "model-c": {"input_price": 0.0, "output_price": 0.0},
}

PROMPT = """请复刻一个食品品牌官网首屏,输出单文件 HTML:
1. 米白色背景,中央悬浮产品罐头,酒红色弧形背景,橙色环绕文字;
2. 顶部包含品牌标志、语言切换和菜单按钮;
3. 罐头支持鼠标拖动旋转,悬停时有缩放反馈;
4. 同时适配 1440x900 和 390x844 两种尺寸。
只输出完整代码。"""

def run(model: str, price: dict) -> dict:
    start = time.time()
    resp = client.chat.completions.create(
        model=model,
        messages=[{"role": "user", "content": PROMPT}],
    )
    elapsed = time.time() - start
    usage = resp.usage
    cost = (usage.prompt_tokens * price["input_price"]
            + usage.completion_tokens * price["output_price"]) / 1_000_000
    html = resp.choices[0].message.content
    with open(f"{model}.html", "w", encoding="utf-8") as f:
        f.write(html)
    return {
        "model": model,
        "seconds": round(elapsed, 1),
        "input_tokens": usage.prompt_tokens,
        "output_tokens": usage.completion_tokens,
        "api_equivalent_cost": round(cost, 4),
    }

if __name__ == "__main__":
    for name, price in MODELS.items():
        try:
            print(run(name, price))
        except Exception as e:
            print(name, "调用失败:", e)
脚本跑完后,会为每个模型生成一个 HTML 文件。接着按第二轮列出的四步清单,在浏览器里逐一检查布局、交互和控制台报错,再结合耗时和等价成本做判断。为了减少单次波动,建议每个模型至少跑三次。
🚀 快速上手建议:做同题对比时,最麻烦的往往是分别申请多家 Key、适配不同 SDK。推荐通过 API易 apiyi.com 完成这一步,一个 API Key 即可调用 OpenAI、Claude、Gemini 等主流模型,接口与 OpenAI 兼容,新用户还有免费测试额度,适合先用小样本跑通对比流程。
Carbon、Opus、Astra 场景推荐与决策建议
结合这次测试和榜单数据,可以按开发目标做初步筛选。下表的“依据”一栏尽量标明来源类型,便于你判断参考价值。
| 开发目标 | 优先考虑 | 依据 | 建议验证方式 |
|---|---|---|---|
| 调用成本敏感、需要大量探索和迭代 | Gemini 4 Carbon | 本次 API 等价成本最低(实测数据) | 多轮小任务累计成本对比 |
| 重视视觉还原、复杂交互和高完成度 | Claude Opus 5.5 | 作者主观评价三者中最佳,两个榜单均领先 | 逐屏还原度与交互验收 |
| 重视完成速度和执行效率 | GPT-6 Astra | 本次耗时最短(实测数据) | 相同任务计时 + 质量验收 |
| 不确定选哪个、想先摸底 | 三者同题小样本复测 | 单次测试不足以下结论 | 通过 API易 apiyi.com 统一接口批量对比 |
选择 Carbon 的场景
- 原型探索期:需要快速试多种页面方案,单次成本低意味着可以多跑几轮。
- 个人项目或预算有限的团队:在质量可接受的前提下,长期调用费用差距会很明显。
- 主力开发 + 人工把关:先用 Carbon 跑出初版,再由人或其他模型做收尾检查。
选择 Opus 的场景
- 品牌官网、营销落地页:对视觉还原和细节要求高,返工成本比调用成本更贵。
- 交互复杂的页面:3D 展示、拖动、滚动驱动动画较多时,更看重最终完成度。
选择 Astra 的场景
- 交付周期紧张:需要在较短时间内拿到可运行的完整页面。
- 重视前端 QA 流程:官方强调生成后的质量检查,适合把验收环节交给工作流。
💡 选择建议:这次测试给出的是一组真实工作流的横向观察,而不是绝对排名。最终的依据应当是:在你自己的相同任务下,哪个方案真正跑通了,花了多少钱和时间。我们建议通过 API易 apiyi.com 用同一份提示词做小规模复测,再决定主力模型。
常见问题 FAQ
Q1:Carbon、Opus、Astra 同题网站测试比的是什么?
比的是三套“模型 + 开发工具”工作流复刻 Agrumea Farm 官网的能力,包括页面结构、视觉风格、3D 罐头轮播、滚动拖动、加载与悬停动画、页面过渡和响应式布局。它衡量的是设计还原,而不是原创审美。
Q2:为什么 Carbon 最便宜,评测作者的排名却最靠后?
成本和质量是两个独立维度。Carbon 的输入 Token 最少、等价成本最低,但从截图看它的罐头比例偏小、部分文字细节较弱,在“还原度”标准下得分不占优势。便宜不等于差,只是在这次复刻任务里,作者更看重 Opus 的完成度。
Q3:这组测试是什么时候做的?结果会过时吗?
评测于 2026 年 11 月 11 日发布。Opus 和 Astra 的测试在 11 月 6 日完成,Carbon 的测试在 11 月 10 日至 11 日完成,正好对应 Carbon 在 11 月 10 日扩大开放。模型和工具迭代很快,建议把结论当作当前阶段的参考。
Q4:API 等价成本和订阅费用有什么区别?
API 等价成本是按 Token 用量和 API 单价估算的费用,反映模型的实际消耗;订阅费用是包月价格,按额度和刷新规则计算。同样一次任务,用包月工具可能只消耗部分额度,按量调用则会直接产生账单。选型时应按自己的实际计费方式核算。
Q5:如何用 API 快速对比这三类模型的网页开发效果?
可以参照本文的复测脚本:
1. 在 API易 apiyi.com 注册并获取 API Key 和免费测试额度;
2. 把 `base_url` 设为 `https://api.apiyi.com/v1`,在平台模型列表中确认要对比的模型名称;
3. 用同一份提示词依次调用,记录耗时、Token 用量,再在浏览器中验收生成的页面。
Q6:单次 API 调用能复现原评测的效果吗?
不能完全复现。原评测在 Antigravity、Claude Code、Codex 中运行,包含多轮文件读写和浏览器自检,耗时都在一小时以上。单次调用只测模型直接生成代码的能力,适合做初筛;如果要逼近原测试,需要搭建带浏览器验证的 Agent 流程。
Q7:这组测试有哪些局限?
主要有三点:每个模型只运行一次,存在偶然性;三者使用的工具环境和测试日期不同,无法隔离模型本体;排名来自作者的主观评价。此外,静态截图无法证明交互是否完整实现。因此它适合作为参考案例,不适合直接当作通用排名。
Carbon、Opus、Astra 核心要点 Key Takeaways
- 测试性质:同一官网复刻任务,三套工作流各运行一次,属于真实场景横向观察。
- 设计还原:作者在三者中最认可 Opus,其次 Astra,Carbon 排最后。
- 速度表现:Astra 用时 68 分钟最快,约为 Opus 的一半。
- 成本表现:Carbon 等价成本 10.86 美元,约为 Opus 的 18%、Astra 的 12%。
- 成本结构:Agent 开发以输入 Token 为主,单价与缓存规则同样决定账单。
- 榜单参考:Opus 在 Arena WebDev 和 DesignArena 综合榜上均领先,但榜单口径各不相同。
- 上手方式:通过 API易 apiyi.com 用一个 Key 做同题小样本复测,再确定主力模型。
总结
Carbon、Opus、Astra 做同一个网站的对比,核心结论有三点:
- 效果:在这次复刻任务中,Opus 的作品获得了评测作者最高的评价,产品主体和层次关系更突出。
- 速度:Astra 只用 68 分钟就完成了任务,适合交付周期紧张的项目。
- 成本:Carbon 的 API 等价成本远低于另外两者,适合高频迭代和预算敏感的场景。
三款模型都已具备完成高质量网页开发的能力,差别在于视觉还原、交互实现、耗时和成本之间的取舍。与其追问哪个模型绝对最强,不如明确自己的开发目标,在相同任务上实际跑一遍。推荐通过 API易 apiyi.com 用统一接口完成多模型复测,以实际跑通的作品和花费作为最终选型依据。
📚 参考资料
- Gemini 4 Carbon: No-Hype Full Review & Testing:Pat Simmons / AI for Mortals 同题网站复刻评测,2026-11-11
- 链接:
aiformortals.co/blog/gemini-4-carbon-review -
说明:本文测试设置、耗时、Token 与 API 等价成本数据的主要来源
-
三份复刻作品页面:Carbon、Opus 5.5、Astra 的公开作品
- 链接:
aiformortals.co/builds/agrumea-clone-gemini-4-carbon、aiformortals.co/builds/agrumea-clone-opus-5-5、aiformortals.co/builds/agrumea-clone-gpt-6-astra -
说明:可在浏览器中自行检查交互效果
-
Agrumea Farm 官网:测试对象原站
- 链接:
agrumeafarm.it/en -
说明:用于对照复刻还原度
-
Arena WebDev 榜单:网页开发对战投票榜
- 链接:
arena.ai/leaderboard/code/webdev -
说明:本文引用 2026-11-10 的数据
-
DesignArena 榜单:综合 Agentic 设计榜
- 链接:
designarena.ai/leaderboard -
说明:本文引用 2026-11-11 的数据,覆盖多类设计任务
-
Google 官方博客:Gemini 4 Carbon 开放公告
- 链接:
blog.google/innovation-and-ai/models-and-research/gemini-models/gemini-4-carbon-now-available/ -
说明:Carbon 在前端设计与浏览器验证方面的官方定位
-
OpenAI 官方介绍:GPT-6 Astra
- 链接:
openai.com/index/gpt-6-astra/ -
说明:Astra 的网页开发与前端 QA 工作流说明
-
Woofocus 测试:不同 Claude 模型的网页设计对比,2026-10-24
- 链接:
app.woofocus.com/blog/best-claude-model-for-web-design - 说明:Opus 5.5 设计与修改任务的补充参考,非三模型直接对照
作者:APIYI 技术团队
技术交流:欢迎在 API易 网站首页联系我们,更多接入资料可访问 docs.apiyi.com 文档中心