作者注:Claude Fable 5.2 对比 Claude Opus 5.5,标准价贵一倍,换来的是长时程、开放式任务上的明显提升,日常编码和知识工作仍可以留在 Opus 5.5。
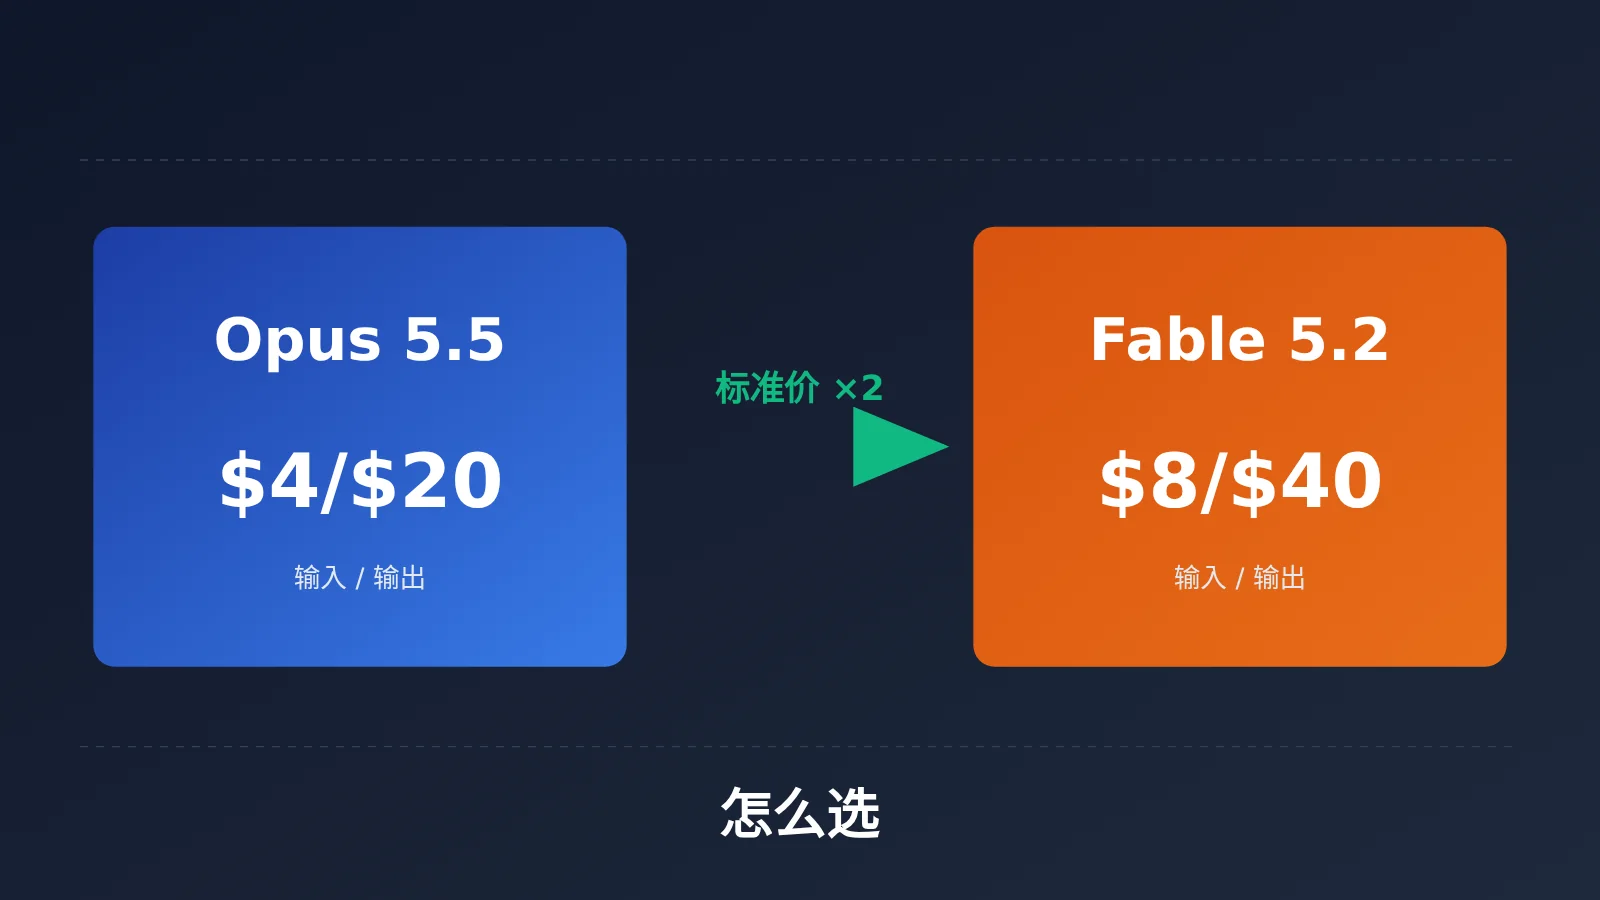
2026-11-09,Anthropic 发布了 Claude Fable 5.2。很多团队要做的决定很具体:默认模型要不要从 Opus 5.5 换成 Fable 5.2。本文先给结论:Fable 5.2 的标准价是 Opus 5.5 的 2 倍,但它不是每一项都赢,日常任务仍可以留在 Opus 5.5。
这不是一份各有千秋的折中分析。下文所有规格和价格都来自官方模型页和价目页,成绩来自 Anthropic 在 2026-11-09 的发布文里给出的那张表。价格和上架状态的查证时间是 2026-11-10,之后可能变化。
核心价值:读完本文,你会拿到一张按任务选模型的表,清楚多付的那一倍钱买到了什么,以及什么时候不该换。
Claude Fable 5.2 对比 Claude Opus 5.5:先看两边一样的地方
选模型前先排除不需要比的维度。按官方模型页 2026-11-10 的对比表,Fable 5.2 和 Opus 5.5 在硬规格上几乎完全一致,差别集中在价格、默认努力档和长任务能力上。
| 规格项 | Claude Fable 5.2 | Claude Opus 5.5 | 是否相同 |
|---|---|---|---|
| 上下文窗口 | 1M token | 1M token | 相同 |
| 最大输出(同步 Messages API) | 128K | 128K | 相同 |
| 知识截止 | 2026 年 6 月 | 2026 年 6 月 | 相同 |
| 自适应思考 | 常开,不能关 | 常开,不能关 | 相同 |
| 延迟档位 | Moderate | Moderate | 相同 |
| 输入 / 输出模态 | 文字和图片 / 文字 | 文字和图片 / 文字 | 相同 |
| Claude API 默认 effort | high | medium | 不同 |
这张表说明两件事。一是换模型不会多拿到上下文或输出长度,1M 在模型页的换算约为 55.5 万个词或 250 万个 Unicode 字符,这是官方的通用换算,不代表中文语料的实际容量。二是两边都不能关掉思考,想让模型少想,只能调 effort,不能靠提示词。更新说明特别写到,在 medium 及以上,Fable 5.2 不会因为一句“不要思考、直接答”就停止思考。
还有一个容易被忽略的差异。模型页写明,在 Message Batches API 上,Opus 5.5 等型号可以通过 beta 头把输出拉到 300K,但这份名单里没有 Fable 5.2。如果你的批量任务依赖超长输出,目前只能按 Opus 5.5 的能力来规划。
Claude Fable 5.2 的模型 ID 与定位
Fable 5.2 的官方模型 ID 如下:
- Claude API、Google Cloud、Microsoft Foundry、Claude Platform on AWS:
claude-fable-5-2 - Amazon Bedrock:
anthropic.claude-fable-5-2
同一天发布的还有 Claude Mythos 5.2。发布文写明,Fable 和 Mythos 是同一个底层模型,区别在于 Fable 带更强的网络安全和生物安全护栏,因此对所有用户开放;Mythos 只提供给通过生命科学或网络安全核验项目的组织。Mythos 不是第三个更强的型号,在你的选型里,它和 Fable 是同一档能力、不同的准入条件。
Claude Fable 5.2 对比 Claude Opus 5.5 价格:哪些是 2 倍,哪些不是
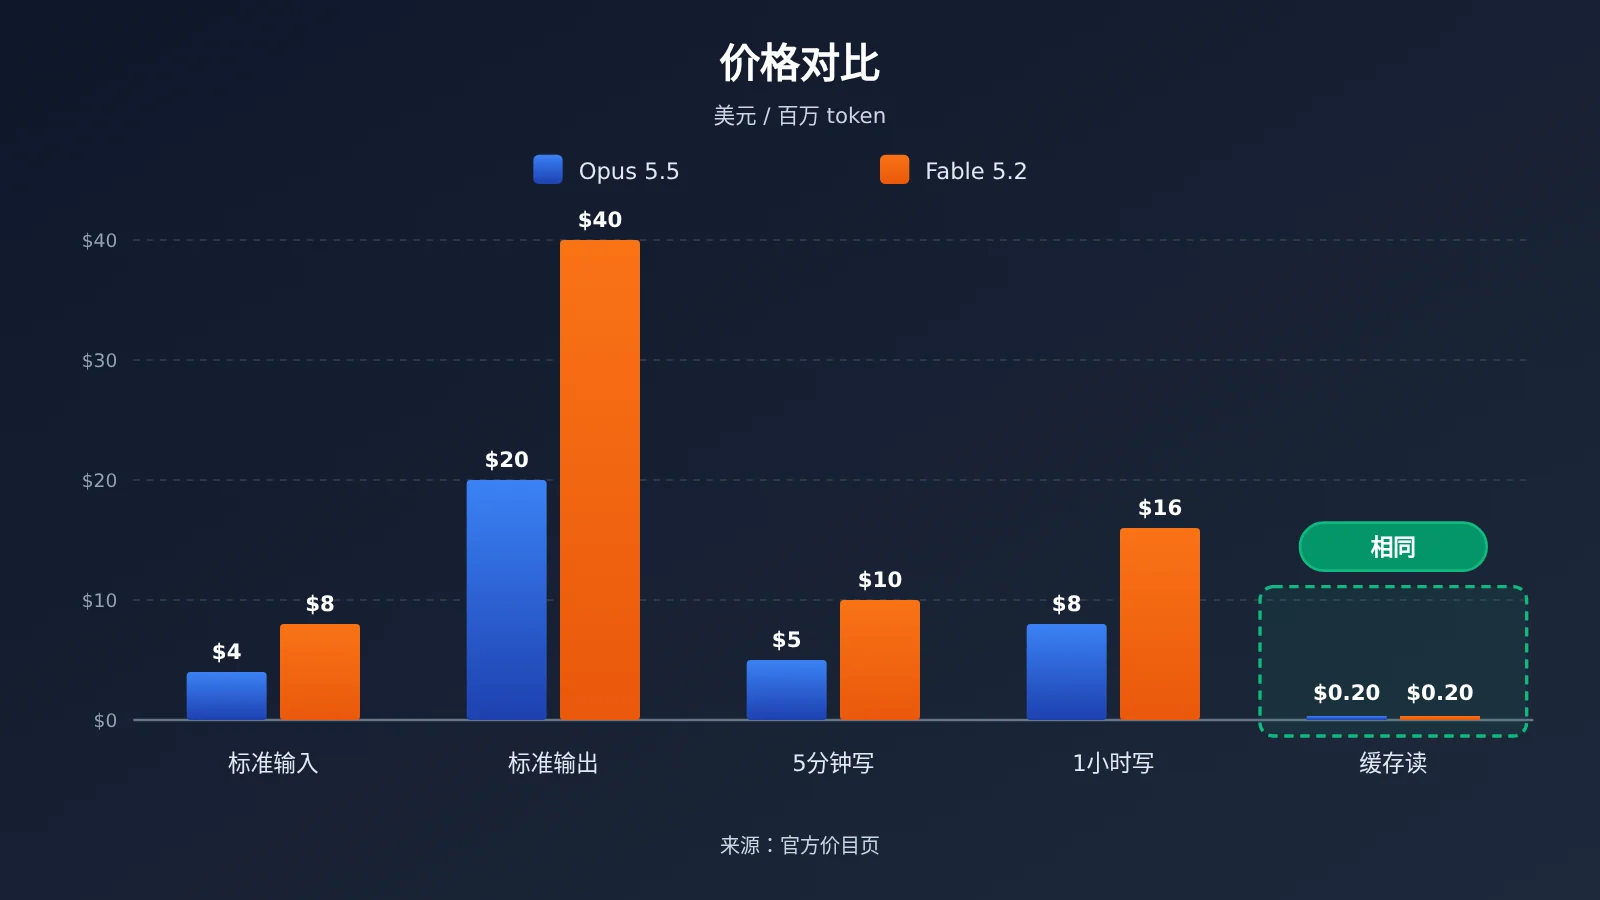
价格是最直观的差距。以下单位都是美元每百万 token,来自官方价目页、模型页和快速模式页。
| 计费项 | Claude Fable 5.2 | Claude Opus 5.5 | 倍数 |
|---|---|---|---|
| 标准输入 | $8 | $4 | 2 倍 |
| 标准输出 | $40 | $20 | 2 倍 |
| 5 分钟缓存写 | $10 | $5 | 2 倍 |
| 1 小时缓存写 | $16 | $8 | 2 倍 |
| 缓存读 | $0.20 | $0.20 | 相同 |
| 快速模式输入 / 输出 | $16 / $80 | $8 / $40 | 2 倍 |
| 批量(按批量 5 折计算) | $4 / $20 | $2 / $10 | 2 倍 |
缓存读是唯一不翻倍的一项,原因在计费规则:Fable 5.2 的缓存读按标准输入价的 2.5% 计,$8 × 0.025 = $0.20;Opus 5.5 按 5% 计,$4 × 0.05 = $0.20。所以如果你的业务是长系统提示词加高命中率的缓存,两者在缓存读部分的开销一样,总账差距会比 2 倍小,但输出和未命中的输入仍然是 2 倍。
另一个值得注意的点是,按批量 5 折计算,Fable 5.2 的批量价是输入 $4、输出 $20,正好等于 Opus 5.5 的标准价。对能接受异步返回的离线任务,用 Fable 批量替代 Opus 实时调用,单价持平。
Claude Fable 5.2 快速模式的计费细节
快速模式是同一个模型的更快推理配置,智能和能力不变,输出速度最高可到标准的 2.5 倍。使用时有几个细节要提前算进预算:
- Claude API 里用字段
speed,取值fast。 - Microsoft Foundry 上快速模式是另一个以
-fast结尾的模型 ID,请求里不要再带speed。 - 发布文列出的快速模式渠道是 Claude Code、Claude Platform、Google Cloud 和 Microsoft Foundry,没有列 Amazon Bedrock。
- 提示缓存的倍率叠加在快速模式价格之上,文档没有单列快速模式缓存价。按倍率推算,Fable 5.2 快速模式的缓存读约 $0.40、5 分钟写约 $20、1 小时写约 $32,这是推算值,不是官方单列价。
- 不同速度不共享提示缓存,从快速退回标准会造成一次缓存未命中。
和上一代比,Fable 5.1 的标准价是 $10 / $50,5.2 降了 20%。但和 Opus 5.5 比,它仍然是 2 倍。
Claude Fable 5.2 对比 Claude Opus 5.5 默认努力档:最容易比错的地方
很多团队对比两个模型时,直接拿默认配置跑一遍看账单。这在 Fable 5.2 和 Opus 5.5 之间会出问题,因为两边的默认努力档不一样。
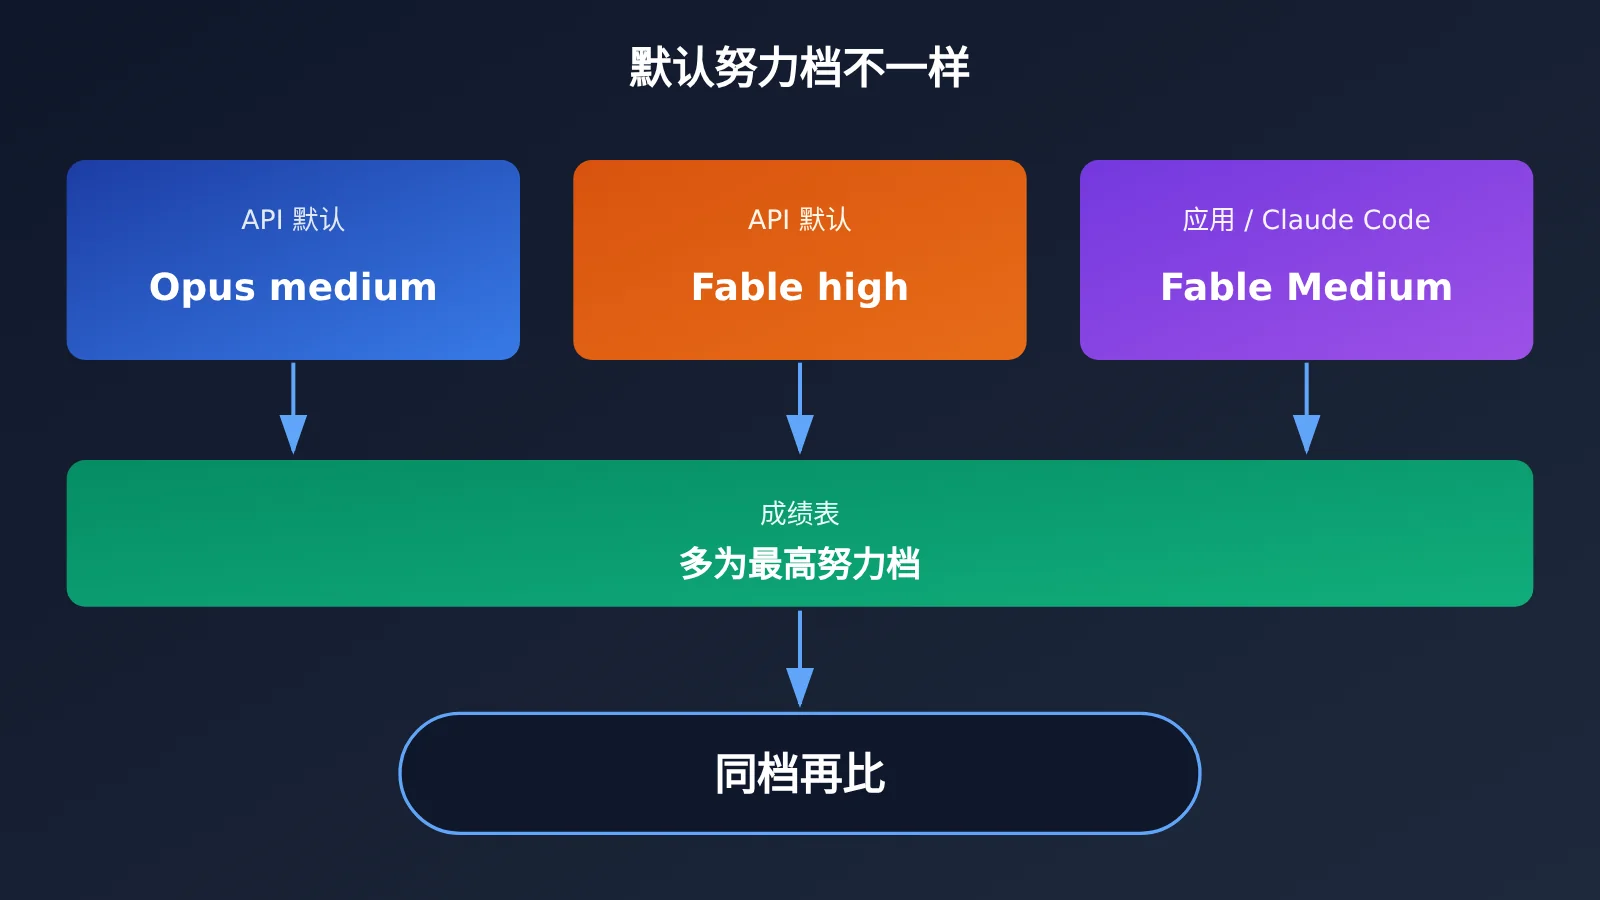
| 场景 | Claude Fable 5.2 默认 | Claude Opus 5.5 默认 | 说明 |
|---|---|---|---|
| Claude API | high | medium | 不改参数直接比,Fable 多花的不只是单价 |
| Claude 应用、Claude Code | Medium | 本文未核对 | 发布文的效率说法多在讲 Medium 和 High |
| 发布文成绩表 | 最高努力档(另注除外) | 最高努力档(另注除外) | 不是默认档的成绩 |
这意味着,API 上不改 effort 时,Fable 5.2 以 high 在跑,Opus 5.5 以 medium 在跑。单价已经是 2 倍,思考量还更大,账单差距可能明显超过 2 倍。要公平比较,应该把两边设成同一个努力档再看质量和花费。
发布文给出了一组同档对照:在 FrontierCode 2.0 上,High 努力的 Fable 5.2 约为 45.3%,Opus 5.5 最好成绩是 45.5%,Anthropic 说前者单任务成本大约是后者的一半。这句话只针对 FrontierCode 这一项,不能扩大理解为所有任务都便宜一半。它真正的提示是:Fable 5.2 不一定要开到最高档才有价值,适当降档可能拿到接近 Opus 最好成绩的结果。
Claude Fable 5.2 对比 Claude Opus 5.5 成绩:只看能改变选择的几行
以下数字都是 Anthropic 在 2026-11-09 的发布文里给出的,属于官方自报。Fable 5.2 和 Opus 5.5 除另注外是开着护栏、在各自最高努力档下的分数。
| 评测项 | Claude Fable 5.2 | Claude Opus 5.5 | 对选型的含义 |
|---|---|---|---|
| FrontierCode 2.0 | 49.1%(Xhigh) / 约 45.3%(High) | 45.5%(最高档) | 最高档领先,High 档持平 |
| FrontierSWE v2 | 69.9%(最高档) | 62.3%(最高档) | 复杂工程任务 Fable 明显领先 |
| OSWorld 2.1(离线集,部分) | 89.3%(最高档) | 87.2%(最高档) | 电脑操作差距很小 |
| RoboDojo Sim | 64.9%(内部运行,最高可用档) | 39.4%(最高档) | 机器人仿真差距最大 |
| Remote Labor Index | 41.3%(High) | 21.3%(最高档) | 长时程远程工作接近翻倍 |
| AA-Briefcase Elo | 1785(最高档) | 1800(最高档) | Opus 领先 |
几行数字放在一起看,结论比较清楚。在长时程、开放式的任务上,例如 Remote Labor Index 和 RoboDojo,Fable 5.2 的领先幅度很大;在 OSWorld 这类电脑操作任务上,差距只有两个多百分点;在 AA-Briefcase 的 Elo 列,Opus 5.5 反而更高(规则分那一列是 Fable 领先)。RoboDojo 的 64.9% 是 Anthropic 内部的运行结果,不是公开榜上的名次。
发布文里网络安全和蛋白设计相关的几行,例如 CyScenarioBench、CVE Rediscovery 和蛋白设计 24 小时,写的是 Mythos 5.2 的分数,对照的是无护栏的 Opus 5.5。这几行不能直接当成 Fable 对 Opus 的差距。
发布文里的长任务例子
发布文还给了几个长时程例子,用来说明 Fable 5.2 适合什么。一位工程师让 Fable 5.2 从空文件夹设计原型操作系统,协调超过 1000 个子代理、连续约 8 天,做出了能在笔记本上启动的系统。费马大定理形式化中,1000 个 Fable 5.2 代理用了 30 小时;同一套配置下,Opus 5.5 在 18 小时完成约 26%,30 小时后几乎不再前进,图注写明每个模型只跑了一次。
这些都是官方自述,不是独立复测。发布文引用的客户说法(如 Vercel、Jump Trading 的引语)也只是引语。它们指向同一个方向:差距主要体现在要跑数小时到数天、需要大量子代理协作的任务上。
Claude Fable 5.2 对比 Claude Opus 5.5 场景推荐:按任务选的表
发布文自己的建议是:大多数编码和知识工作先从 Opus 5.5 开始,再按难度往上到 Fable 或 Mythos,或者往下到 Sonnet 5.5、Haiku 5.5。结合价格和成绩,可以整理成下面这张表。
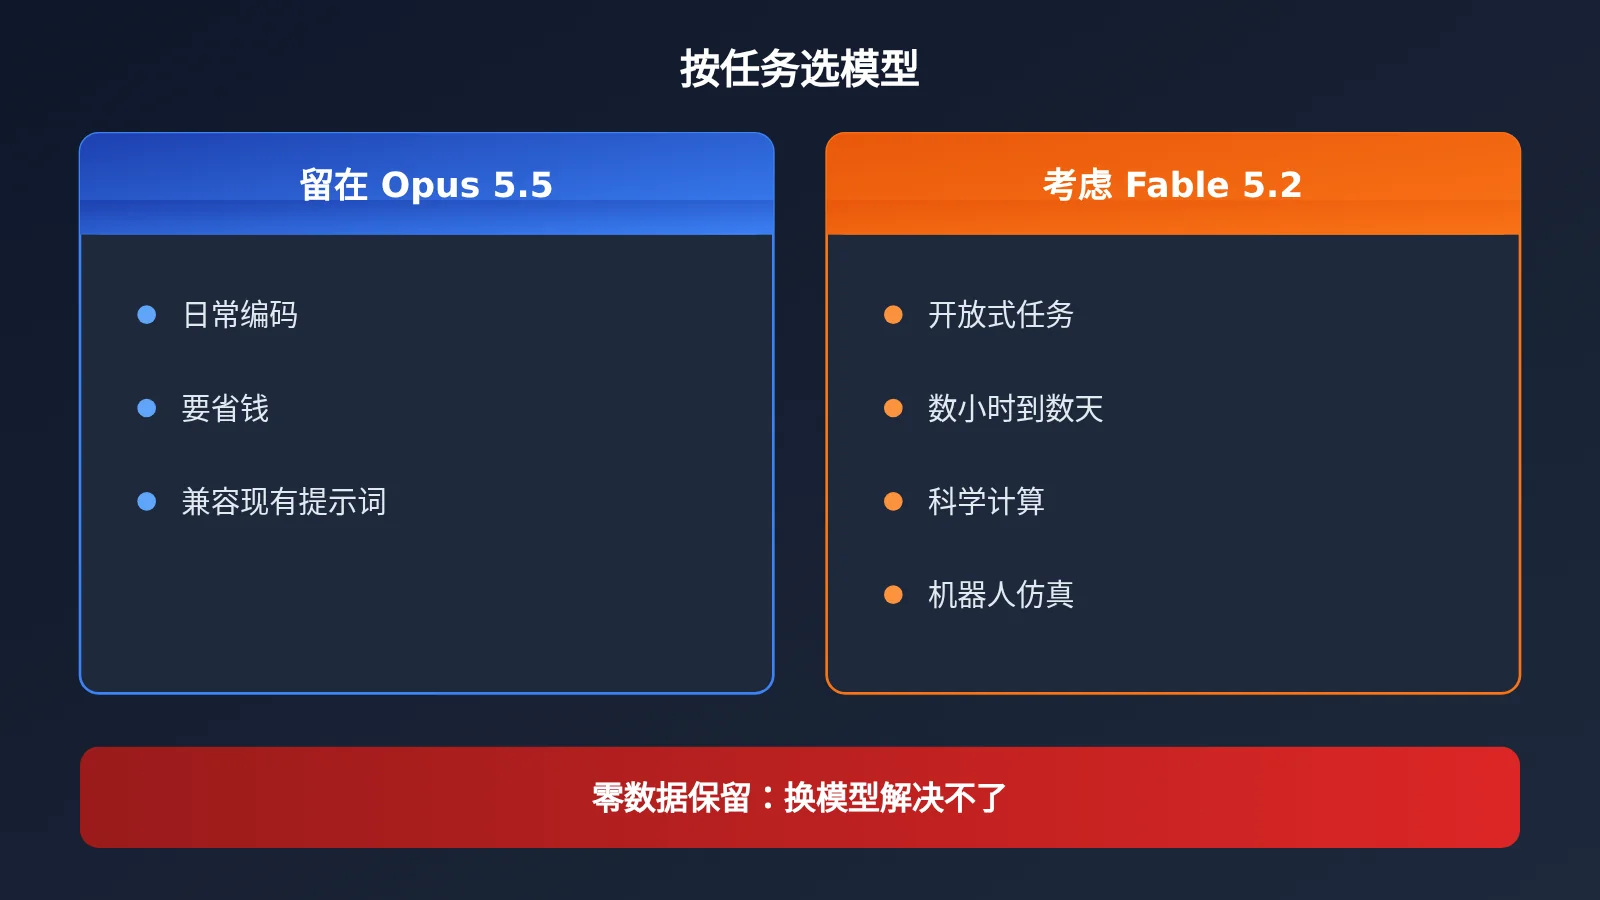
| 任务类型 | 推荐默认模型 | 理由 |
|---|---|---|
| 日常编码、代码审查、常规知识工作 | Opus 5.5 | 发布文建议从 Opus 起步,OSWorld 等差距小 |
| 预算敏感的大批量调用 | Opus 5.5 | 标准价、缓存写、快速模式都是一半 |
| 需要和现有 Opus 提示词、参数兼容 | Opus 5.5 | Fable 对部分参数会返回 400,见下文 |
| 开放式、跑数小时到数天的智能体任务 | Fable 5.2 | Remote Labor Index 41.3% 对 21.3% |
| 科学计算、形式化证明 | Fable 5.2 | Terminal-Bench-Science 74.6% 对 58.7% |
| 机器人仿真与控制 | Fable 5.2 | RoboDojo 64.9% 对 39.4% |
| 要求零数据保留 | 不能靠换模型解决 | Fable 5.2 默认保留 30 天,见下文 |
什么时候不该换到 Claude Fable 5.2
除了价格,还有几条兼容性限制会让迁移成本变高:
- 强制工具调用(
tool_choice为any或tool)会返回 400。 - 请求里带
temperature、top_p、top_k会返回 400,旧代码需要删掉这些字段。 - 保存思考对所有账号启用,修改更早轮次的内容会让思考块失效;Fable 5.2 的思考块只有 Fable 5.2 和 Mythos 5.2 能读。
- Fable 5.2 做执行者时,顾问也必须是 Fable 5.2 或 Mythos 5.2,不能混用 Opus。
- 和 AI 研发直接相关的能力(如加速器内核优化、改进大模型架构)被故意限制在约 Opus 5.5 的水平,少数主题会透明回退到 Opus 5。
- 长任务中模型有时一轮就停,留下待办清单或主动询问是否继续,low 努力下更常见,编排层要能处理这种情况。
数据保留也要单独说明。Fable 5.2 要求保留 30 天数据,除非 Anthropic 明确授权,否则不能走零数据保留;合格的企业客户在接入 Enterprise Frontier Safeguards 监控之前仍可零保留使用。Opus 5.5 的保留政策本文没有核对到,以你账户的数据政策为准。换到 Fable 5.2 不会带来零保留,反而可能多一条限制。
Claude Fable 5.2 对比 Claude Opus 5.5 决策建议:现在能调谁,谁还没上架
选好模型后,下一步是确认渠道上能不能调。截至 2026-11-10,在 API易 apiyi.com 查了两处:型号总表 docs.apiyi.com/models.md 和公开价格接口 api.apiyi.com/api/pricing(当天返回 283 个型号)。查询没有使用密钥做真实调用。
| 型号 | 是否已上架 | 列表价(输入 / 输出 / 缓存读) | 端点 |
|---|---|---|---|
claude-opus-5-5、claude-opus-5-5-thinking |
已上架 | $4 / $20 / $0.2 | chat、messages |
claude-fable-5-1、claude-fable-5-1-thinking |
已上架 | $10 / $50 / $0.25 | chat、messages |
claude-fable-5-2 |
未上架 | 暂无 | — |
| Mythos 系列 | 未上架 | 暂无 | — |
结合前面的结论,现阶段的落地方式比较直接:
- 日常默认模型:通过 API易 apiyi.com 调用
claude-opus-5-5,OpenAI 兼容接口的 base_url 为https://api.apiyi.com/v1,也可以走 messages 端点。 - 想先验证 Fable 系列在长任务上的表现:可以先用已上架的
claude-fable-5-1做流程验证,但它的列表价 $10 / $50 高于 Fable 5.2 的官方价,不适合用来估算 5.2 的成本。 claude-fable-5-2的预算:先按官方价 $8 / $40 做,不要用任何分组倍率去乘官方价来估算平台价。
总表上的美元是列表标价,实际扣费还会乘令牌分组倍率,以控制台账单为准。claude-fable-5-2 目前不在 API易 apiyi.com 的总表和价格接口里。我们会尽快推出此模型。型号与价格以平台型号列表为准。
常见问题 FAQ
Q1:Claude Fable 5.2 是不是所有计费项都比 Claude Opus 5.5 贵一倍?
不是。标准输入输出、5 分钟和 1 小时缓存写、快速模式都是 2 倍,但缓存读两边都是 $0.20。原因是 Fable 5.2 按输入价的 2.5% 计缓存读,Opus 5.5 按 5% 计。缓存命中率越高,总账差距越接近缓存读的部分,但输出部分始终是 2 倍。
Q2:默认努力档会不会让榜上的差距变小?
有可能。发布文成绩表除另注外用的是各模型的最高努力档,不是默认档。Claude API 上 Fable 5.2 默认 high、Opus 5.5 默认 medium,应用和 Claude Code 里 Fable 默认 Medium。在 FrontierCode 上,High 档的 Fable 约 45.3%,已和 Opus 最好的 45.5% 持平,Xhigh 档才到 49.1%。其他评测在默认档下的差距,发布文没有给出,不知道。
Q3:被护栏拦住后返回的内容,算不算 Claude Fable 5.2 的回答?
不算。被安全分类器拦住时,网络安全类改由 Opus 4.8 回答,生物类改由 Opus 5 回答;少数 AI 研发相关主题也会透明回退到 Opus 5。拒绝时 HTTP 状态是 200,`stop_reason` 为 `refusal`。输出之前就拒绝的情况,是否计费取决于拒绝类别,但都会占速率额度,具体哪一类不计费本文不知道。官方早期测试显示,Fable 5.2 的拦截比 Fable 5.1 少约 55%,这不是独立复测。
Q4:Claude Mythos 5.2 是不是比 Claude Fable 5.2 更强的型号?
不是。发布文写明两者是同一个底层模型,价格也相同,区别在于 Fable 带更强的网安和生物护栏、对所有用户开放,Mythos 只给通过核验项目的组织。发布文里网安和蛋白那几行是 Mythos 的分数,不能直接当成 Fable 的成绩。
Q5:现在怎么调用 Claude Opus 5.5,Fable 5.2 什么时候能用?
截至 2026-11-10,可以通过 API易 apiyi.com 调用 `claude-opus-5-5`,列表价 $4 / $20、缓存读 $0.2。`claude-fable-5-2` 尚未上架,上线时间以平台型号列表为准,预算建议先按官方价估算。
Q6:从 Opus 5.5 换到 Fable 5.2,能顺便拿到零数据保留吗?
不能。Fable 5.2 要求保留 30 天,除非 Anthropic 明确授权。有零保留需求的团队,应该先确认自己账户的数据政策,而不是指望换模型解决。
Claude Fable 5.2 对比 Claude Opus 5.5 核心要点 Key Takeaways
- 规格几乎一致:1M 上下文、128K 输出、2026 年 6 月知识截止,两边相同。
- 价格多数翻倍:标准、缓存写、快速模式都是 2 倍,只有缓存读同为 $0.20。
- 批量价有交叉:按批量 5 折计算,Fable 批量 $4 / $20 等于 Opus 标准价。
- 默认档不同:API 上 Fable 默认 high、Opus 默认 medium,同档再比才公平。
- 长任务差距大:Remote Labor Index、RoboDojo 上 Fable 领先明显,Elo 列 Opus 领先。
- 迁移有门槛:采样参数和强制工具会 400,思考块和顾问不能混用 Opus。
- 上架状态:API易 目前可调 Opus 5.5,Fable 5.2 未上架,预算先按官方价。
总结
Claude Fable 5.2 对比 Claude Opus 5.5,选型的核心是三点:
- 贵一倍换来的是长时程能力:开放式、要跑数小时到数天、科学计算和机器人仿真,Fable 5.2 的领先幅度足以覆盖价差。
- 日常任务不必换:日常编码、预算敏感和需要兼容现有提示词的场景,Opus 5.5 仍是更稳妥的默认模型,发布文自己也建议从 Opus 起步。
- 比较要同档:默认努力档不同,成绩表用的是最高档,直接拿默认配置比账单和质量都会失真。
比较务实的做法是,把 Opus 5.5 设为默认,在少数长任务上单独路由到 Fable 5.2,并在两边设同一努力档做小规模对照。Opus 5.5 现在就可以通过 API易 apiyi.com 接入,Fable 5.2 上架后按平台型号列表的价格再做正式成本核算。
作者:API易 技术团队
技术交流:型号上架与价格变动以 docs.apiyi.com 文档中心的型号列表为准