作者注:以 GPT-6 Astra 改写 Qwen3.5-0.8B 权重引发的争议为案例,用 6 个步骤拆解模型能力宣传,看懂基线、工具权限、评测设置与复现证据。
一条“前沿模型读懂并改写了另一个模型的权重,数学成绩从 7.9% 飙到 48.1%”的消息,足以刷屏整个 AI 圈。但不到一天,就有开发者发文反驳,国内媒体也以“MIT 神作被锤爆”为题跟进报道。本文借这场 Astra 修改 Qwen 权重之争,带你建立一套拆解模型能力宣传的可复用方法。
这不是一篇站队文章,我们不评判谁对谁错,而是逐层对照原始实验日志、作者表述与批评意见,把一次热点变成一份可以反复使用的核查清单。
核心价值:读完本文,你将学会用 6 个问题审视任何“模型能力突破”的宣传,在选型、汇报和技术判断时少踩坑。
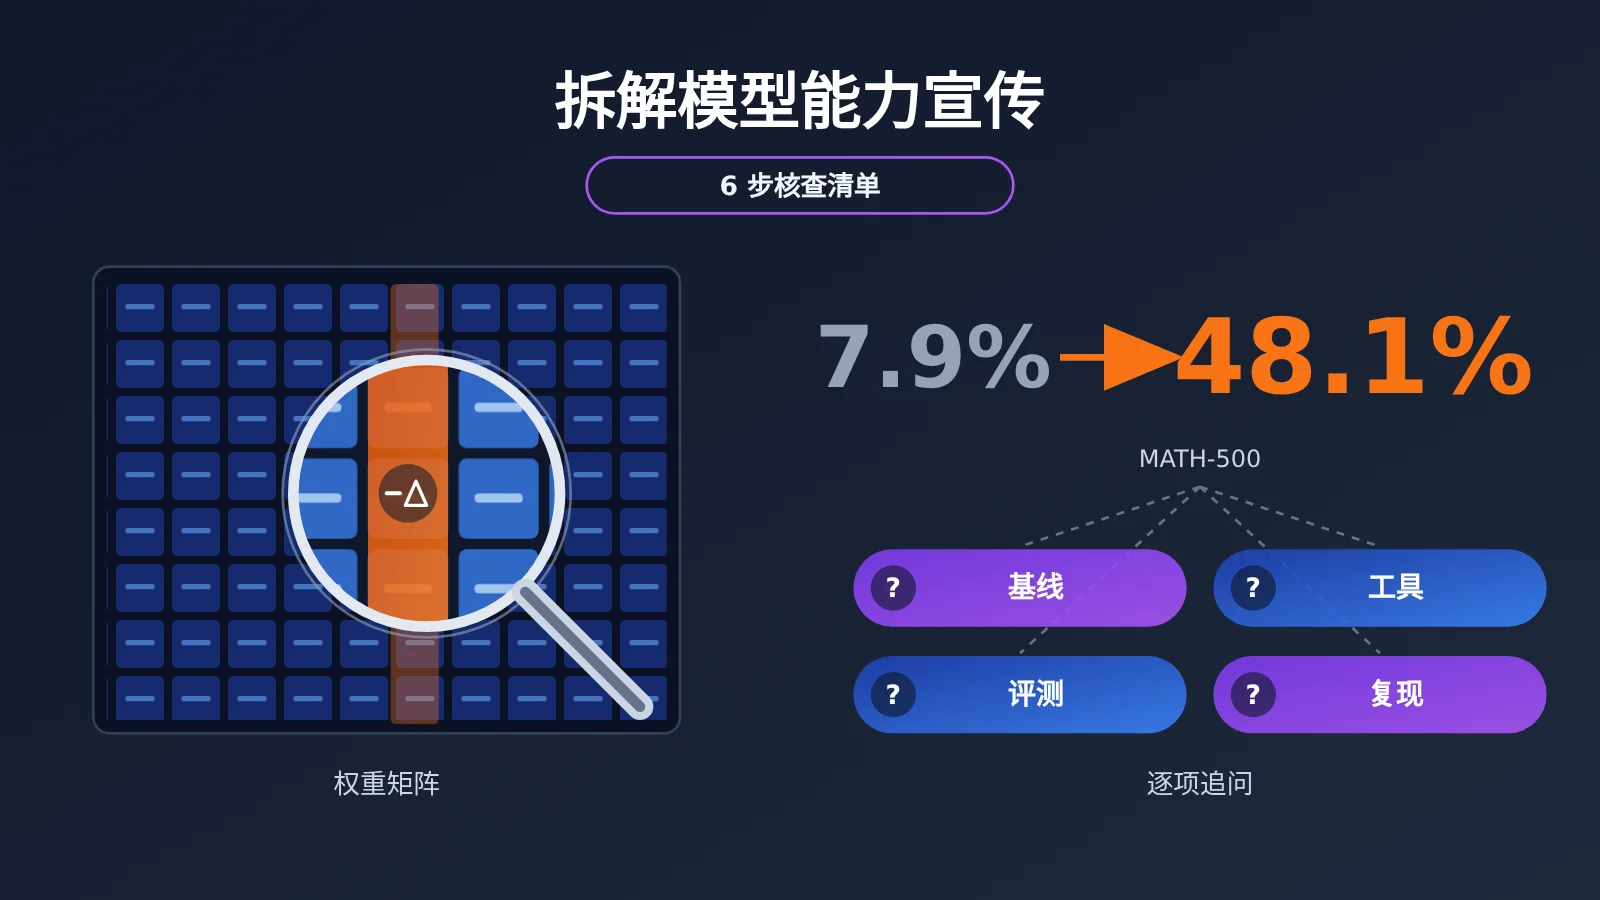
Astra 修改 Qwen 权重之争核心要点
先用一张表把事件的关键事实和争议点讲清楚,后面的方法论都围绕这些事实展开。
| 要点 | 说明 | 对拆解宣传的启发 |
|---|---|---|
| 研究来源 | MIT CSAIL 的 Rikiya Takehi、Jayden Teoh、Alex Zhang、Omar Khattab 于 2026 年 11 月 2 日发布博客 Sparks of Weight-Space Programming,并公开实验日志和修改后的模型 | 有没有公开日志,是判断可信度的第一道门槛 |
| 头条结果 | GPT-6 Astra 修改了 Qwen3.5-0.8B 约 8 亿权重中的 131,072 个(约 0.016%),MATH-500 从 7.9% 升至 48.1% | 百分比越惊人,越要追问基线为什么这么低 |
| 工具条件 | 该实验中 Astra 在加载了权重的 Python 环境里工作,最多可跑 50 批练习评测 | “读懂权重”和“写代码分析权重”是两回事 |
| 主要批评 | Matthew Honnibal 认为宣传把不同工具权限的实验合并成一个大结论;Sean Goedecke 认为 Qwen 修复本质是已有的 steering 技术 | 方法新不新,要和现有技术对照 |
| 反例 | 同样流程用在 Gemma 3 270M 上,MATH-500 从 6.8% 最多到 7.7%,作者自己也认为提升不成立 | 一个模型上有效,不代表能力可以泛化 |
Astra 修改 Qwen 权重的真实过程详解
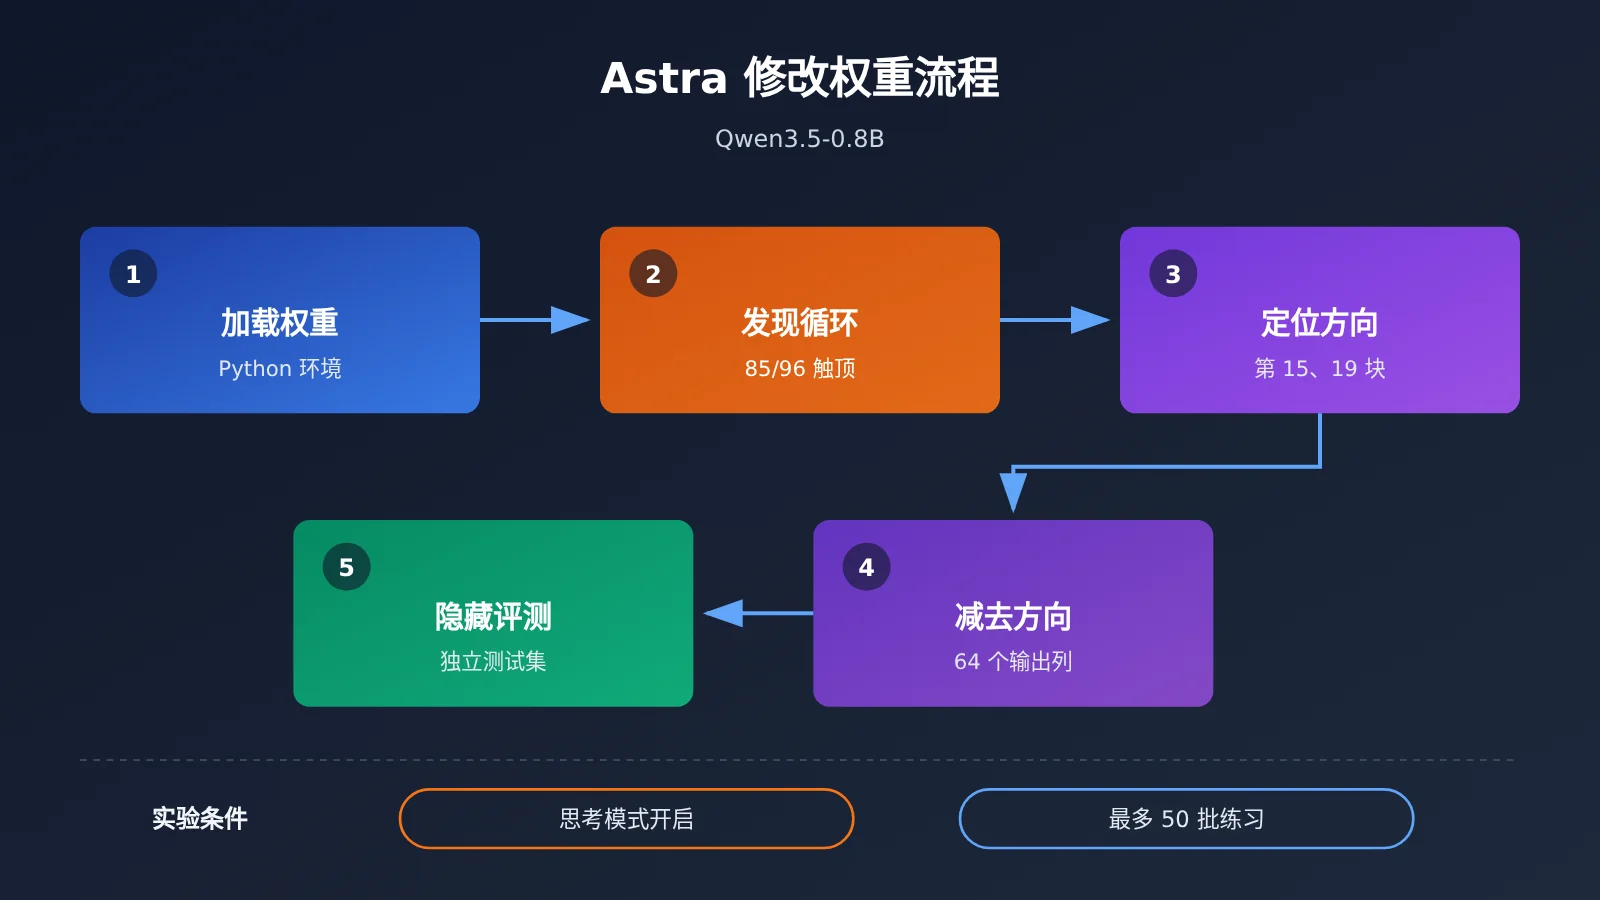
拆开实验细节会发现,事情远比“读权重提分”复杂。Qwen3.5-0.8B 在开启思考模式后存在严重的循环问题:Astra 检查的前 96 个练习答案里,有 85 个一直写到 32,768 token 上限也没给出答案,这一弱点在 Qwen 官方模型卡中早有说明。值得注意的是,该模型默认是非思考模式,实验特意开启了思考模式。
Astra 随后把循环行为追溯到第 15 和第 19 块前馈层写出的某个方向,并从每块的 64 个输出列中把这个方向减去。按实验 README 的记录,计划修改 131,072 个权重,按评测精度取整后实际改变的是 130,188 个。成功的这次运行共执行了 80 次 Python 代码,耗时 20.3 小时,其中包含 4.7 小时的服务中断。
拆解模型能力宣传快速上手:6 步核查清单
下面这套清单,是我们从 Astra 修改 Qwen 权重之争中提炼出来的。每一步都对应一个具体问题,适用于论文、发布会、跑分海报乃至厂商的产品文案。
第 1 步:先看基线和失败模式
任何“提升 X 个百分点”的说法,都要先问一句:原来为什么这么差?Qwen3.5-0.8B 的基线只有 7.9%,而同期有 93.0% 的 MATH-500 答案撞上了 token 上限。也就是说,模型很多时候不是不会做,而是根本没写完。
把下面这张表的最后一列和第一列对照看,结论就很清楚了:分数的大幅上升与“触顶率”的大幅下降几乎同步发生。
| Qwen3.5-0.8B 版本 | MATH-500 | GSM8K | IFEval | MATH-500 触顶比例 |
|---|---|---|---|---|
| 基础模型 | 7.9% | 13.8% | 21.0% | 93.0% |
| 编辑版,10 批练习 | 12.3% | 25.7% | 49.0% | 87.2% |
| 编辑版,25 批练习 | 14.1% | 25.1% | 39.9% | 86.4% |
| 编辑版,50 批练习 | 48.1% | 67.1% | 62.3% | 33.1% |
数据来源:Takehi 等人,MIT CSAIL,2026 年 11 月 2 日,思考模式开启。原文说明每个编辑版都是独立运行、编辑内容各不相同,头条的 131,072 权重编辑对应 50 批那一行。
第 2 步:再看模型手里有什么工具
这是 Honnibal 批评的核心。研究一共报告了 8 个实验和 1 个 Gemma 后续实验,但模型获得的条件差别很大:有的只给纯文本形式的原始权重、不给任何工具,有的给完整 Python 环境和多轮练习评测。把它们并列在“能读写权重”这一个结论下,读者很容易高估纯粹的“读懂”能力。
| 实验 | 网络规模 | Astra 获得的条件 | 结果 |
|---|---|---|---|
| 识别网络在玩哪个游戏 | 17,253 个权重 | 纯文本原始权重 | 4/4 正确 |
| 识别扩散模型画的形状 | 23,824 | 纯文本原始权重 | 3/3 正确 |
| 识别小语言模型的训练文本 | 720 万 | 中间层 + Python | 3/3 正确 |
| 修复卡住的驾驶策略 | 171,664 | 原始权重、场景描述、1 次失败记录 | 成功率 0% 到 100% |
| 从零编写 9×9 围棋网络 | 148 万 | Python,最多 50 次练习 | 胜过同规模 PPO 网络 |
| 找出谄媚模型 | 2.7 亿 | 先 Python,后加注意力模式 | 先失败,后 3/3 |
| 修复 Qwen 数学 | 8 亿 | Python,最多 50 批练习 | MATH-500 7.9% 到 48.1% |
| 提升 Gemma 数学 | 2.7 亿 | Python,最多 50 批练习 | 无确定提升(最多 0.9 个百分点) |
表格整理自 R&D World 对原研究的汇总,权限分类参考 Honnibal 的划分。一眼可见:纯文本读权重的实验都发生在几万参数量级的小网络上,真正动到 8 亿参数语言模型时,模型手里有的是一个人类机器学习工程师也会用的 Python 工作台。
第 3 步:对照已有技术判断“新不新”
Goedecke 指出,找到一个激活方向再从权重里减掉,本质上就是 steering(激活引导)这一成熟技术的应用。这并不否定结果的价值,但会改变结论的含义:值得关注的是“模型能自主完成一套标准的可解释性工程流程”,而不是“模型拥有了超人的读权重能力”。
第 4 步:检查评测设置是否被精心挑选
需要逐项确认的细节包括:是否改了默认推理模式、token 上限设多少、每次练习允许生成多少题(该实验每次调用最多生成 512 题,或检查最多 1,024 段文本的内部激活)、评测题是否与编辑过程隔离。原文提到评测题和结果在编辑期间对模型不可见,这是加分项;但开启思考模式恰好放大了 Qwen 的循环弱点,这一点也必须写进你的结论里。
第 5 步:寻找反例与边界
Gemma 3 270M 是这项研究里最有价值的一组数据。它本身很少循环,只有 8.5% 的答案触顶,而 Qwen 是 93%。同样的流程在 Gemma 上没有带来确定提升,作者自己的解读是:权重编辑可以清除遮蔽能力的障碍,却无法凭空添加模型本不具备的能力。一项宣传如果只给成功案例、不给失败案例,可信度要打折扣。
第 6 步:确认是否有独立复现
修改后模型的模型卡里,记录了 Hugging Face 的 akhaliq 用 ML Intern 做的独立复跑:覆盖全部 500 道 MATH-500 题、共 2,000 次生成,得分 51.0%,触顶比例 31.6%。独立复现与原结果基本一致,说明“分数确实上去了”是可靠的;争议集中在“如何解释这个分数”,而不是“分数是否造假”。
🎯 实践建议:读完宣传后,最好亲自用同一组题目对比几个模型的表现。API易 apiyi.com 提供 Claude Opus 5.5、Kimi K3.1 Pro、Qwen3.8 系列等模型的 API 调用,兼容 OpenAI 与 Anthropic 接口格式,方便你在同一套脚本里切换模型做交叉验证。接入说明见文档 docs.apiyi.com。
用核查清单对照 Astra 宣传与批评
把 6 步清单套回这场争议,可以得到一张“宣传说法 vs 核查结论”的对照表,这也是你日后写技术评估报告时可以直接沿用的格式。
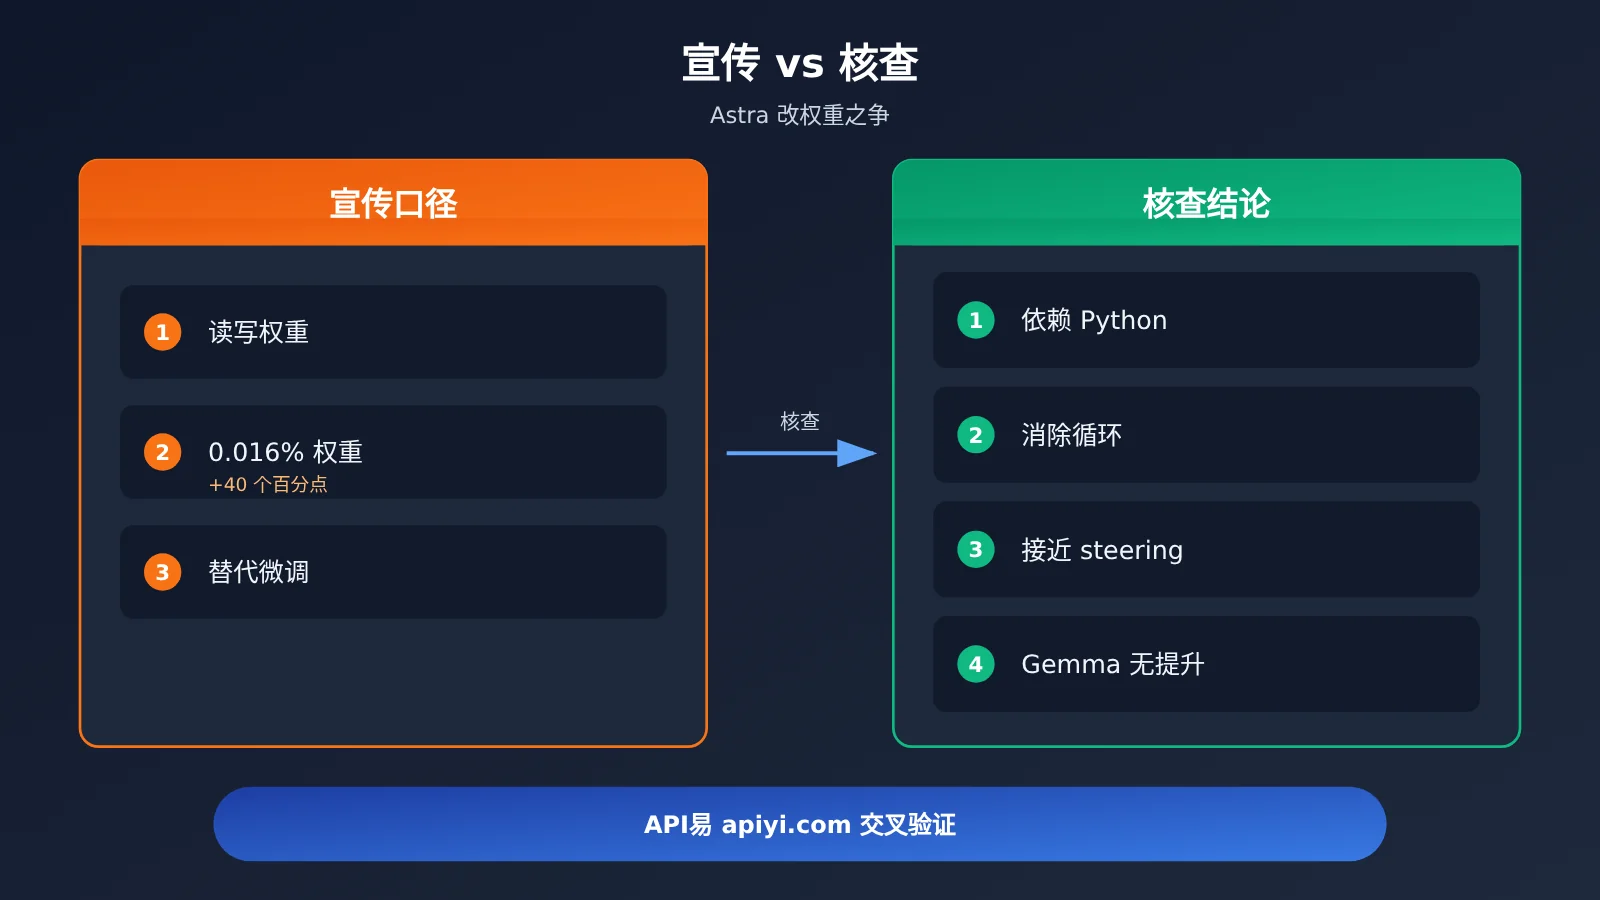
| 宣传口径 | 核查维度 | 核查结论 |
|---|---|---|
| Astra 能读懂神经网络权重 | 工具权限 | 小网络上纯文本可行,8 亿参数模型依赖 Python 分析 |
| 改 0.016% 权重提升 40 个百分点 | 基线与失败模式 | 提升主要来自循环问题缓解,触顶率从 93.0% 降到 33.1% |
| 开创权重空间编程 | 方法新颖性 | 核心操作接近已有的 steering 技术 |
| 可替代部分微调 | 泛化能力 | Gemma 上无确定提升,只能清除障碍、不能添加能力 |
| 结果真实可靠 | 独立复现 | 第三方复跑得到 51.0%,数值层面可信 |
竞品对标:如何看待同类能力宣传
GPT-6 Astra 此前已多次因跑分受到关注。ARC Prize 基金会 9 月在共享评测框架下给出了 ARC-AGI-3 上 62.7% 的成绩,OpenAI 也表示 Astra 达到了其 Critical 级网络安全能力阈值。这些数字同样适用本文清单:先问评测框架是共享的还是定制的,再问工具权限与运行次数。
Claude Opus 5.5 与 Kimi K3.1 Pro 在 R&D World 10 月 23 日的对比中被拿来与 Astra 同台比较。不同厂商的模型在各自擅长的任务上可能保持领先,但宣传口径往往采用对自己最有利的设置。相比之下,用同一份题目、同一套参数自己跑一遍,比任何海报都更有说服力。
💡 选型建议:如果你想在自己的业务题目上对比这些模型,可以先在 API易 apiyi.com 上用统一接口小规模试跑。需要说明的是,API易 目前暂未上线 GPT-6 Astra,我们会尽快上线;Claude Opus 5.5、Kimi K3.1 Pro 已可直接调用。
涉及模型的 API易 可用性与价格
下表价格全部以 API易 价格页 docs.apiyi.com/models 的实际数据为准,计费单位请以价格页标注为准;本文不引用任何第三方报价。
| 模型 | API易 模型名 | 输入价格 | 输出价格 | 缓存价格 | 可用状态 |
|---|---|---|---|---|---|
| Claude Opus 5.5 | claude-opus-5-5 | $4 | $20 | $0.2 | API易 已上线 |
| Claude Sonnet 5.5 | claude-sonnet-5-5 | $2 | $10 | $0.1 | API易 已上线 |
| Kimi K3.1 Pro | kimi-k3.1-pro | $2 | $10 | $0.2 | API易 已上线 |
| DeepSeek V4.1 Flash | deepseek-v4.1-flash | $0.3 | $1.2 | $0.006 | API易 已上线 |
| Qwen3.8 系列 | qwen3.8 系列 | 见价格页 | 见价格页 | 见价格页 | API易 已上线 |
| GPT-6 Astra | 无 | 无 | 无 | 无 | API易 目前暂未上线该模型,会尽快上线 |
| Qwen3.5-0.8B | 无 | 无 | 无 | 无 | API易 目前暂未上线该模型,会尽快上线 |
| Gemma 3 270M | 无 | 无 | 无 | 无 | API易 目前暂未上线该模型,会尽快上线 |
Qwen3.5-0.8B 与 Gemma 3 270M 是开放权重的小模型,研究中修改后的 Qwen 检查点也公开在 Hugging Face 上,想复现权重编辑本身,需要在本地加载权重;而做跨模型的能力对比,则更适合用云端 API。
常见问题 FAQ
Q1:Astra 修改 Qwen 权重到底是一项什么研究?
MIT CSAIL 团队测试 GPT-6 Astra 能否理解和改写其他神经网络的权重。头条实验中,Astra 改动 Qwen3.5-0.8B 约 0.016% 的权重,让 MATH-500 从 7.9% 提升到 48.1%,相关日志与模型均已公开。
Q2:批评者和作者的分歧到底在哪里?
分歧不在数据真假,而在解释。作者强调模型具备读写权重的能力;Honnibal 认为不同工具权限的实验被合并成一个大结论,Goedecke 认为 Qwen 修复属于已有的 steering 技术,核心工作是人类工程师也会写的 Python 分析。
Q3:这项研究什么时候发布,后续还有进展吗?
研究于 2026 年 11 月 2 日以博客形式发布,一天内即出现公开批评,Hacker News 上也有长篇讨论。作者表示正在构建衡量该能力的基准和评测框架,后续数据值得继续关注。
Q4:6 步核查清单适合哪些场景?
– **技术选型**:在采购或接入模型前,审视厂商跑分与宣传文案
– **研究阅读**:快速判断一篇论文的头条数字含金量
– **内部汇报**:向团队解释某项“突破”时,给出有边界的结论
– **内容写作**:撰写模型评测时避免被单一数字带偏
Q5:如何用 API 自己验证模型能力宣传?
最直接的办法是准备一份与你业务相近的题目集,固定推理模式和输出长度,在多个模型上各跑一遍。通过 API易 apiyi.com 可以用兼容 OpenAI 与 Anthropic 格式的统一接口调用 Claude Opus 5.5、Kimi K3.1 Pro、Qwen3.8 系列等模型,接入方式见 docs.apiyi.com,费用以 docs.apiyi.com/models 为准。
Q6:这项研究有哪些已知局限?
一是大模型实验依赖 Python 工具和多轮练习,并非纯粹“读懂”权重;二是提升主要来自缓解循环,且依赖开启思考模式;三是在 Gemma 上没有确定提升,说明无法凭空添加能力;四是用于自我改进等应用目前仍是作者提出的设想,尚未被证实。
Q7:研究中提到的智能体协作风险和 Astra 有关吗?
OpenAI 在 8 月 26 日披露的 Hugging Face 事件中,主要由内部研究模型 IM1 驱动,官方明确将 Astra 排除在该事件之外。“多智能体协作 + 权重编辑”的组合目前只是一种推测,并未被这项研究证明。
拆解模型能力宣传核心要点 Key Takeaways
- 先问基线:Qwen 基线低主要因为 93% 答案触顶,提分大多来自修复循环
- 再问工具:纯文本读权重只在小网络成立,大模型实验依赖 Python 环境
- 对照旧技术:Qwen 修复接近 steering,价值在于自主完成工程流程
- 审视评测设置:思考模式、token 上限、练习批次都会影响最终分数
- 寻找反例:Gemma 无确定提升,说明编辑只能清障碍、不能加能力
- 认可独立复现:第三方复跑 51.0%,数值可信但解读需谨慎
- 亲手验证:用 API易 apiyi.com 统一接口在自己的题目上交叉对比模型
总结
Astra 修改 Qwen 权重之争给我们的最大启发,不是某个模型强或弱,而是一项真实可复现的结果,同样可能被包装成超出证据范围的结论。拆解模型能力宣传的核心要点:
- 数字要配上失败模式:没有基线和触顶率,48.1% 本身说明不了太多
- 结论要配上条件:工具权限、推理模式、练习次数决定了结论的边界
- 成功要配上反例和复现:Gemma 反例与第三方复跑,共同界定了结果的真实含义
下一次再看到“某模型实现突破”的标题,不妨把这 6 个问题逐一过一遍,再用自己的数据跑一次。推荐通过 API易 apiyi.com 在同一套接口下对比多个模型,文档见 docs.apiyi.com,价格以 docs.apiyi.com/models 为准。
📚 参考资料
- 36氪报道:MIT神作被锤爆:Astra爆改Qwen权重?就吹吧
- 链接:
36kr.com/p/4056481264866438 -
说明:国内媒体对本次争议的中文报道
-
原始研究博客:Sparks of Weight-Space Programming
- 链接:
rikiyat.github.io/blog/weight-space-programming -
说明:MIT CSAIL 团队的原始实验描述
-
实验日志仓库:lm_understand-logs
- 链接:
github.com/RikiyaT/lm_understand-logs -
说明:包含 Qwen 实验 README 与各实验完整日志
-
Matthew Honnibal 的批评文章
- 链接:
honnibal.dev/blog/astra-read-write-misleading -
说明:从工具权限角度分析宣传口径
-
Sean Goedecke 的批评文章
- 链接:
seangoedecke.com/llms-are-not-superhuman-at-reading-and-writing-neural-network-weights -
说明:将 Qwen 修复与 steering 技术进行对照
-
修改后的 Qwen 模型卡
- 链接:
huggingface.co/RikiyaT/Qwen3.5-0.8B-weight-space-programming - 说明:包含第三方独立复跑结果
作者:APIYI 技术团队
技术交流:欢迎在 API易 apiyi.com 首页联系我们,更多接入资料可访问 docs.apiyi.com 文档中心